

Avec l'épuisement des adresses IPv4, de nombreux opérateurs de télécommunications ont dû organiser l'accès de leurs clients au réseau par le biais de la traduction d'adresses. Dans cet article, je vais expliquer comment obtenir des performances de niveau Carrier Grade NAT sur des serveurs classiques.
Un peu d'histoire
La question de l'épuisement de l'espace d'adresses IPv4 n'est plus nouvelle. À un certain moment, des listes d'attente sont apparues chez RIPE, puis des échanges ont vu le jour, où des blocs d'adresses étaient échangés et des contrats de location étaient conclus. Progressivement, les opérateurs de télécommunications ont commencé à fournir des services d'accès à Internet par le biais de la traduction d'adresses et de ports. Certains n'ont pas eu assez d'adresses pour attribuer une adresse « blanche » à chaque abonné, tandis que d'autres ont commencé à économiser de l'argent en renonçant à l'achat d'adresses sur le marché secondaire. Les fabricants de matériel réseau ont soutenu cette idée, car cette fonctionnalité nécessite généralement des modules d'extension supplémentaires ou des licences. Par exemple, chez Juniper, dans la gamme de routeurs MX (sauf les derniers MX104 et MX204), la réalisation de NAPT peut se faire sur une carte de service dédiée MS-MIC, sur le Cisco ASR1k, une licence CGN est requise, et sur le Cisco ASR9k — un module séparé A9K-ISM-100 avec la licence A9K-CGN-LIC. En somme, cette option a un coût non négligeable.
IPTables
La tâche d'exécuter le NAT ne nécessite pas de ressources de calcul spécialisées, elle peut être réalisée par des processeurs généralistes, comme ceux qui sont installés par exemple dans n'importe quel routeur domestique. À l'échelle d'un opérateur de télécommunications, ce problème peut être résolu en utilisant des serveurs classiques sous FreeBSD (ipfw/pf) ou GNU/Linux (iptables). Nous ne considérerons pas FreeBSD, car j'ai abandonné l'utilisation de ce système d'exploitation depuis assez longtemps, nous allons donc nous concentrer sur GNU/Linux.
Activer la traduction d'adresses n'est pas très compliqué. Il suffit d'écrire une règle dans iptables dans la table nat :
iptables -t nat -A POSTROUTING -s 100.64.0.0/10 -j SNAT --to - --persistent
Le système d'exploitation va charger le module nf_conntrack, qui surveillera toutes les connexions actives et effectuera les transformations nécessaires. Il y a plusieurs subtilités. Tout d'abord, étant donné qu'il s'agit de NAT à l'échelle d'un opérateur de télécommunications, il est nécessaire d'ajuster les timeouts, car avec les valeurs par défaut, la taille de la table de traductions augmentera rapidement jusqu'à des niveaux catastrophiques. Voici un exemple de paramètres que j'ai utilisés sur mes serveurs :
net.ipv4.ip_forward = 1
net.ipv4.ip_local_port_range = 8192 65535

net.netfilter.nf_conntrack_generic_timeout = 300
net.netfilter.nf_conntrack_tcp_timeout_syn_sent = 60
net.netfilter.nf_conntrack_tcp_timeout_syn_recv = 60
net.netfilter.nf_conntrack_tcp_timeout_established = 600
net.netfilter.nf_conntrack_tcp_timeout_fin_wait = 60
net.netfilter.nf_conntrack_tcp_timeout_close_wait = 45
net.netfilter.nf_conntrack_tcp_timeout_last_ack = 30
net.netfilter.nf_conntrack_tcp_timeout_time_wait = 120
net.netfilter.nf_conntrack_tcp_timeout_close = 10
net.netfilter.nf_conntrack_tcp_timeout_max_retrans = 300
net.netfilter.nf_conntrack_tcp_timeout_unacknowledged = 300
net.netfilter.nf_conntrack_udp_timeout = 30
net.netfilter.nf_conntrack_udp_timeout_stream = 60
net.netfilter.nf_conntrack_icmpv6_timeout = 30
net.netfilter.nf_conntrack_icmp_timeout = 30
net.netfilter.nf_conntrack_events_retry_timeout = 15
net.netfilter.nf_conntrack_checksum=0
Et deuxièmement, puisque par défaut la taille de la table de traductions n'est pas conçue pour fonctionner dans un environnement d'opérateur de télécommunications, elle doit être augmentée :
net.netfilter.nf_conntrack_max = 3145728
Il est également nécessaire d'augmenter le nombre de buckets pour la table de hachage, qui stocke toutes les traductions (c'est une option du module nf_conntrack) :
options nf_conntrack hashsize=1572864
Après ces manipulations simples, on obtient une construction fonctionnelle qui peut traduire un grand nombre d'adresses clients en un pool d'adresses externes. Cependant, la performance de cette solution laisse à désirer. Dans mes premières tentatives d'utilisation de GNU/Linux pour NAT (environ en 2013), j'ai pu atteindre une performance d'environ 7 Gbit/s avec 0,8 Mpps sur un serveur (Xeon E5-1650v2). Depuis, de nombreuses optimisations ont été apportées à la pile réseau du noyau GNU/Linux, et la performance d'un serveur sur le même matériel a pratiquement augmenté à 18-19 Gbit/s avec 1,8-1,9 Mpps (ce furent des valeurs limites), mais le besoin de volume de trafic traité par un seul serveur a augmenté beaucoup plus rapidement. En fin de compte, des schémas de répartition de la charge entre différents serveurs ont été élaborés, mais tout cela a augmenté la complexité de la configuration, de la maintenance et du maintien de la qualité des services fournis.
NFTables
Actuellement, une tendance populaire dans l'« empilement de paquets » est l'utilisation de DPDK et XDP. Ce sujet a suscité de nombreux articles, plusieurs présentations ont été réalisées, et des produits commerciaux sont apparus (par exemple, SKAT de VasExperts). Cependant, dans un contexte de ressources limitées pour les développeurs chez les opérateurs de télécommunications, créer soi-même une « solution » basée sur ces frameworks est assez problématique. Exploiter une telle solution par la suite sera beaucoup plus compliqué, notamment en ce qui concerne le développement d'outils de diagnostic. Par exemple, l'outil tcpdump standard avec DPDK ne fonctionnera pas simplement, et il ne « verra » pas non plus les paquets renvoyés sur les lignes à l'aide de XDP. Au milieu de toutes les discussions sur les nouvelles technologies de transfert de paquets vers l'espace utilisateur, sont restées inaperçues et Pablo Neira Ayuso, le mainteneur d'iptables, sur le développement de l'externalisation de flux dans nftables. Examinons ce mécanisme plus en détail.
L'idée principale est que si le routeur a traité des paquets d'une même session dans les deux sens du flux (la session TCP est passée à l'état ESTABLISHED), il n'est pas nécessaire de faire passer les paquets suivants de cette session par toutes les règles du pare-feu, car toutes ces vérifications se soldront de toute façon par la transmission du paquet pour un routage ultérieur. De plus, il n'est pas nécessaire de choisir un itinéraire — nous savons déjà à quel interface et à quel hôte envoyer les paquets dans le cadre de cette session. Il ne reste qu'à conserver cette information et à l'utiliser pour le routage à un stade précoce du traitement du paquet. Lors de l'exécution de NAT, il est également nécessaire de conserver des informations sur les modifications d'adresses et de ports effectuées par le module nf_conntrack. Oui, bien sûr, dans ce cas, divers analyseurs et d'autres règles de statistique d'information dans iptables ne fonctionneront plus, mais dans le cadre de la tâche d'un NAT distinct ou, par exemple, d'une frontière — ce n'est pas si important, car les services sont répartis sur différents appareils.
Configuration
Pour profiter de cette fonctionnalité, nous devons :
- Utiliser un noyau récent. Bien que cette fonctionnalité soit apparue pour la première fois dans le noyau 4.16, elle est restée assez « brute » pendant longtemps et provoquait régulièrement des kernel panic. Tout a été stabilisé vers décembre 2019, lorsque les noyaux LTS 4.19.90 et 5.4.5 ont été publiés.
- Réécrire les règles iptables au format nftables, en utilisant une version relativement récente de nftables. Cela fonctionne parfaitement avec la version 0.9.0.
Si le premier point est en principe clair, il ne faut pas oublier d'activer le module dans la configuration lors de la compilation (CONFIG_NFT_FLOW_OFFLOAD=m). Le deuxième point nécessite des explications. Les règles nftables sont décrites de manière très différente de celles d'iptables. aborde presque tous les aspects, il existe également des de règles d'iptables vers nftables. Je vais donc donner un exemple de configuration NAT et de flow offload. Une petite légende pour l'exemple : <i_if>, <o_if> — ce sont les interfaces réseau par lesquelles passe le trafic, il peut en réalité y en avoir plus de deux. <pool_addr_start>, <pool_addr_end> — l'adresse de début et de fin de la plage des adresses « blanches ».
La configuration NAT est très simple :
#! /usr/sbin/nft -f

table nat {
        chain postrouting {
                type nat hook postrouting priority 100;
                oif <o_if> snat to <pool_addr_start>-<pool_addr_end> persistent
        }
}
Avec le flow offload, c'est un peu plus compliqué, mais tout à fait compréhensible :
#! /usr/sbin/nft -f

table inet filter {
        flowtable fastnat {
                hook ingress priority 0
                devices = { <i_if>, <o_if> }
        }

        chain forward {
                type filter hook forward priority 0; policy accept;
                ip protocol { tcp , udp } flow offload @fastnat;
        }
}
Voilà, c'est toute la configuration. Maintenant, tout le trafic TCP/UDP ira dans la table fastnat et sera traité beaucoup plus rapidement.
Résultats
Pour illustrer à quel point c'est « beaucoup plus rapide », je joins une capture d'écran de la charge sur deux serveurs réels, avec la même configuration (Xeon E5-1650v2), réglés de la même manière, utilisant le même noyau Linux, mais exécutant NAT avec iptables (NAT4) et avec nftables (NAT5).
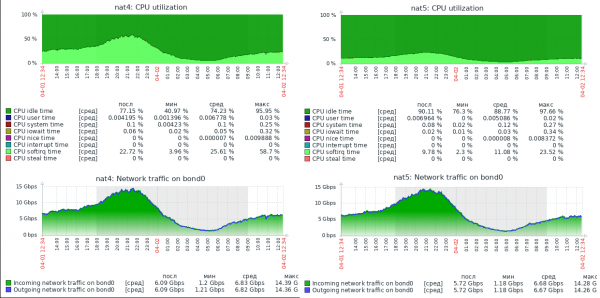
Sur la capture d'écran, il n'y a pas de graphique des paquets par seconde, mais dans le profil de charge de ces serveurs, la taille moyenne des paquets est d'environ 800 octets, donc les valeurs atteignent 1.5Mpps. Comme on peut le voir, la marge de performance du serveur avec nftables est énorme. À ce jour, ce serveur traite jusqu'à 30Gbit/s à 3Mpps et est clairement capable d'atteindre la limite physique du réseau à 40Gbps, tout en ayant des ressources CPU disponibles.
J'espère que ce matériel sera utile aux ingénieurs réseaux qui tentent d'améliorer la performance de leurs serveurs.
Source : habr.com
