

Sur quels principes repose un stockage de données idéal ?
Un accent sur la valeur commerciale et l'analyse sans code standard. Gestion du DWH comme une base de code : versioning, révision, tests automatisés et CI. Modularité, extensibilité, code source ouvert et communauté. Documentation utilisateur conviviale et visualisation des dépendances (Data Lineage).
Pour en savoir plus sur tout cela et sur le rôle de DBT dans l'écosystème Big Data & Analytics, bienvenue sous l'article.
Bonjour à tous
C'est Artemiy Kozyr à l'appareil. Cela fait plus de 5 ans que je travaille avec des entrepôts de données, me consacrant à la construction d'ETL/ELT, ainsi qu'à l'analyse des données et à la visualisation. Actuellement, je travaille chez , j'enseigne à l'OTUS dans le cours , et aujourd'hui je veux partager avec vous un article que j'ai écrit à l'approche du lancement d'un nouveau groupe pour le cours.
Aperçu
Le framework DBT concerne tout le T de l'acronyme ELT (Extract — Transform — Load).
Avec l'émergence de bases de données analytiques performantes et évolutives comme BigQuery, Redshift, Snowflake, il n'y a plus de sens à réaliser des transformations en dehors de l'entrepôt de données.
DBT ne télécharge pas de données à partir de sources, mais offre de nombreuses possibilités de travailler avec les données qui sont déjà chargées dans l'entrepôt (dans le stockage interne ou externe).
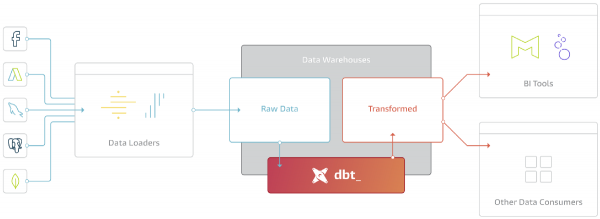
La principale fonction de DBT est de prendre le code, de le compiler en SQL et d’exécuter les commandes dans le bon ordre dans l’entrepôt.
Structure du projet DBT
Un projet est composé de deux types de répertoires et de fichiers :
- Modèle (.sql) — une unité de transformation exprimée par une requête SELECT
- Fichier de configuration (.yml) — paramètres, réglages, tests, documentation
À un niveau basique, le travail s'organise comme suit :
- L'utilisateur prépare le code des modèles dans n'importe quel IDE pratique
- À l'aide de la CLI, le lancement des modèles est appelé, DBT compile le code des modèles en SQL
- Le code SQL compilé est exécuté dans l'entrepôt dans l'ordre donné (graphe)
Voici à quoi peut ressembler un lancement depuis la CLI :
Tout est SELECT
C'est la fonctionnalité phare du framework Data Build Tool. En d'autres termes, DBT abstrait tout le code lié à la matérialisation de vos requêtes dans l'entrepôt (variations des commandes CREATE, INSERT, UPDATE, DELETE, ALTER, GRANT, …).
Tout modèle implique l'écriture d'une seule requête SELECT qui définit l'ensemble de données résultant.
La logique des transformations peut ainsi être multi-niveaux et consolider des données provenant de plusieurs autres modèles. Un exemple de modèle qui construira une vitrine des commandes (f_orders) :
{% set payment_methods = ['credit_card', 'coupon', 'bank_transfer', 'gift_card'] %}

with orders as (

   select * from {{ ref('stg_orders') }}

),

order_payments as (

   select * from {{ ref('order_payments') }}

),

final as (

   select
       orders.order_id,
       orders.customer_id,
       orders.order_date,
       orders.status,
       {% for payment_method in payment_methods -%}
       order_payments.{{payment_method}}_amount,
       {% endfor -%}
       order_payments.total_amount as amount
   from orders
       left join order_payments using (order_id)

)

select * from final
Que pouvons-nous voir d'intéressant ici ?
Tout d'abord : Utilisation des CTE (Common Table Expressions) — pour organiser et comprendre le code qui contient de nombreuses transformations et logique métier.
Deuxièmement : Le code du modèle — un mélange de SQL et de (langage de template).
L'exemple utilise une boucle for pour calculer le montant pour chaque méthode de paiement mentionnée dans l'expression set. Une fonction est également utilisée ref — la possibilité de référencer d'autres modèles à l'intérieur du code :
- Au moment de la compilation, ref cela sera transformé en un pointeur cible vers une table ou une vue dans le stockage,
- ref permettant de construire un graphique des dépendances des modèles.
C'est précisément qui ajoute presque des possibilités illimitées à DBT. Les plus fréquemment utilisées parmi elles :
- Instructions if / else — opérateurs de branchement
- Boucles for — cycles
- Variables — variables
- Macro — création de macros
Matérialisation : Table, Vue, Incrémental
La stratégie de matérialisation — une approche selon laquelle l'ensemble de données résultant du modèle sera enregistré dans le stockage.
En termes de base, cela signifie :
- Table — table physique dans le stockage
- Vue — vue, table virtuelle dans le stockage
Il existe également des stratégies de matérialisation plus complexes :
- Incrémental — chargement incrémental (de grandes tables de faits) ; les nouvelles lignes sont ajoutées, celles modifiées sont mises à jour, et les supprimées sont nettoyées.
- Éphémère — le modèle n'est pas matérialisé directement, mais participe en tant que CTE dans d'autres modèles.
- Toute autre stratégie que vous pouvez ajouter vous-même.
En plus des stratégies de matérialisation, s'ouvrent des possibilités d'optimisation pour des stockages spécifiques, par exemple :
- Snowflake: Tables transitoires, comportement de fusion, clustering de table, copie des autorisations, vues sécurisées.
- Redshift: Distkey, Sortkey (interleaved, compound), vues en liaison tardive.
- BigQuery: Partitionnement et clustering de table, comportement de fusion, cryptage KMS, étiquettes et tags.
- Spark: Format de fichier (parquet, csv, json, orc, delta), partition_by, clustered_by, buckets, stratégie_incrémentale
Actuellement, les stockages suivants sont supportés :
- Postgres
- Redshift
- BigQuery
- Snowflake
- Presto (partiellement)
- Spark (partiellement)
- Microsoft SQL Server (adaptateur communautaire)
Améliorons notre modèle :
- Rendons son remplissage incrémental (Incremental)
- Ajoutons des clés de segmentation et de tri pour Redshift
-- Configuration du modèle :
-- Remplissage incrémental, clé unique pour la mise à jour des enregistrements (unique_key)
-- Clé de segmentation (dist), clé de tri (sort)
{{
  config(
      materialized='incremental',
      unique_key='order_id',
      dist="customer_id",
      sort="order_date"
   )
}}

{% set payment_methods = ['credit_card', 'coupon', 'bank_transfer', 'gift_card'] %}

with orders as (

   select * from {{ ref('stg_orders') }}
   where 1=1
   {% if is_incremental() -%}
       -- Ce filtre sera appliqué uniquement pour l'exécution incrémentale
       and order_date >= (select max(order_date) from {{ this }})
   {%- endif %}

),

order_payments as (

   select * from {{ ref('order_payments') }}

),

final as (

   select
       orders.order_id,
       orders.customer_id,
       orders.order_date,
       orders.status,
       {% for payment_method in payment_methods -%}
       order_payments.{{payment_method}}_amount,
       {% endfor -%}
       order_payments.total_amount as amount
   from orders
       left join order_payments using (order_id)

)

select * from final
Graphe de dépendances des modèles
C'est aussi un arbre de dépendances. C'est aussi un DAG (Graphe Acyclique Dirigé).
DBT construit le graphe sur la base de la configuration de tous les modèles du projet, c'est-à-dire des références ref() à l'intérieur des modèles vers d'autres modèles. La présence d'un graphe permet de réaliser les choses suivantes :
- Exécution des modèles dans le bon ordre
- Parallélisation de la création des vitrines
- Exécution d'un sous-graphe arbitraire
Exemple de visualisation du graphe :
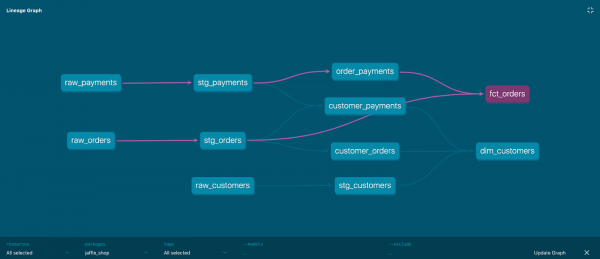
Chaque nœud du graphe est un modèle, les arêtes du graphe sont définies par l'expression ref.
Qualité des données et Documentation
En plus de la formation des modèles eux-mêmes, DBT permet de tester un certain nombre d'hypothèses (assertions) sur l'ensemble de données résultant, telles que :
- Non Nul
- Unique
- Intégrité de Référence — intégrité référentielle (par exemple, customer_id dans la table orders correspond à id dans la table customers)
- Correspondance avec une liste de valeurs acceptables
Il est possible d'ajouter ses propres tests (tests de données personnalisés), tels que, par exemple, le % de variation des revenus par rapport aux indicateurs d'il y a un jour, une semaine, un mois. Toute hypothèse formulée sous forme de requête SQL peut devenir un test.
Ainsi, il est possible de détecter dans les vitrines du stockage des variations indésirables et des erreurs dans les données.
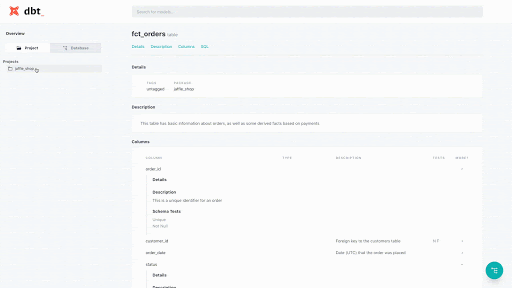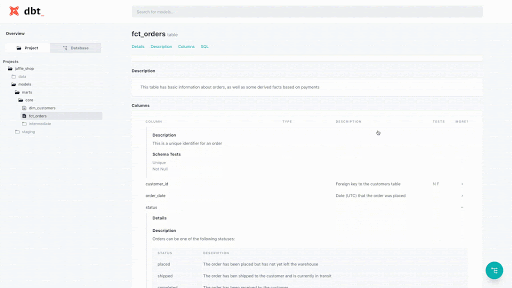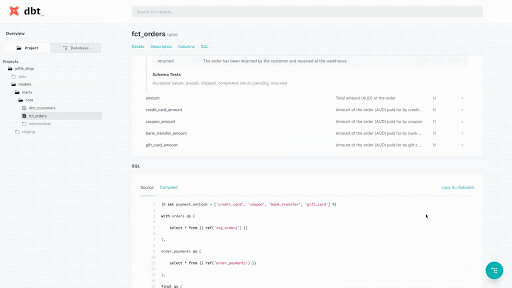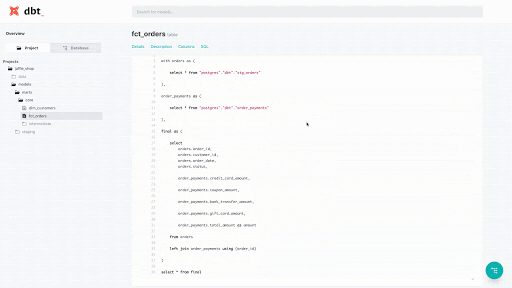
En ce qui concerne la documentation, DBT fournit des mécanismes pour ajouter, versionner et diffuser des métadonnées et des commentaires au niveau des modèles et même des attributs.
Voici à quoi ressemble l'ajout de tests et de documentation au niveau du fichier de configuration :
 - name: fct_orders
   description: Cette table contient des informations de base sur les commandes, ainsi que des faits dérivés basés sur les paiements
   columns:
     - name: order_id
       tests:
         - unique # vérification de l'unicité des valeurs
         - not_null # vérification de la présence de valeurs nulles
       description: C'est un identifiant unique pour une commande
     - name: customer_id
       description: Clé étrangère vers la table des clients
       tests:
         - not_null
         - relationships: # vérification de l'intégrité référentielle
             to: ref('dim_customers')
             field: customer_id
     - name: order_date
       description: Date (UTC) à laquelle la commande a été passée
     - name: status
       description: '{{ doc("orders_status") }}'
       tests:
         - accepted_values: # vérification des valeurs acceptées
             values: ['placed', 'shipped', 'completed', 'return_pending', 'returned']
Voici à quoi ressemble cette documentation sur le site Web généré :
Macros et Modules
L'objectif de DBT n'est pas seulement de devenir un ensemble de scripts SQL, mais de fournir aux utilisateurs des outils puissants et riches en fonctionnalités pour construire leurs propres transformations et diffuser ces modules.
Les macros sont des ensembles de constructions et d'expressions qui peuvent être appelées comme des fonctions à l'intérieur des modèles. Les macros permettent de réutiliser SQL entre les modèles et les projets conformément au principe d'ingénierie DRY (Don't Repeat Yourself).
Exemple de macro :
{% macro rename_category(column_name) %}
case
 when {{ column_name }} ilike  '%osx%' then 'osx'
 when {{ column_name }} ilike  '%android%' then 'android'
 when {{ column_name }} ilike  '%ios%' then 'ios'
 else 'other'
end as renamed_product
{% endmacro %}
Et son utilisation :
{% set column_name = 'product' %}
select
 product,
 {{ rename_category(column_name) }} -- appel de la macro
from my_table
DBT est fourni avec un gestionnaire de packages (packages), qui permet aux utilisateurs de publier et de réutiliser des modules et des macros individuels.
Cela signifie la possibilité de télécharger et d'utiliser des bibliothèques telles que :
- : gestion de Date/Heure, Clés de substitution, tests de schéma, Pivot/Dé-pivot et autres
- Modèles prêts à l'emploi pour des services tels que et
- Bibliothèques pour certains entrepôts de données, par exemple
- — Module pour la journalisation des opérations de DBT
La liste complète des packages est disponible sur .
Encore plus de fonctionnalités
Ici, je vais décrire quelques autres caractéristiques et implementations intéressantes que mon équipe et moi utilisons pour construire un entrepôt de données dans .
La séparation des environnements d'exécution DEV — TEST — PROD
Même au sein d'un même cluster DWH (au sein de différents schémas). Par exemple, avec l'expression suivante :
with source as (

   select * from {{ source('salesforce', 'users') }}
   where 1=1
   {%- if target.name in ['dev', 'test', 'ci'] -%}
       where timestamp >= dateadd(day, -3, current_date)
   {%- endif -%}

)
Ce code dit littéralement : pour les environnements dev, test, ci prends les données uniquement des 3 derniers jours et pas plus. Cela signifie que l'exécution dans ces environnements sera beaucoup plus rapide et nécessitera moins de ressources. Lorsqu'elle est exécutée dans l'environnement prod la condition de filtrage sera ignorée.
Matérialisation avec un codage alternatif des colonnes
Redshift est un SGBD en colonnes qui permet de définir des algorithmes de compression des données pour chaque colonne individuelle. Le choix des algorithmes optimaux peut réduire l'espace disque occupé de 20 à 50%.
Le macro exécutera la commande ANALYZE COMPRESSION, créera une nouvelle table avec les algorithmes de codage des colonnes recommandés, indiquant les clés de segmentation (dist_key) et de tri (sort_key), transférera les données dans cette table, et supprimera l'ancienne copie si nécessaire.
Signature du macro :
{{ compress_table(schema, table,
                 drop_backup=False,
                 comprows=none|Integer,
                 sort_style=none|compound|interleaved,
                 sort_keys=none|List,
                 dist_style=none|all|even,
                 dist_key=none|String) }}
Journalisation des exécutions de modèles
Pour chaque exécution de modèle, vous pouvez attacher des hooks (crochets) qui seront exécutés avant le lancement ou immédiatement après la création du modèle :
   pre-hook: "{{ logging.log_model_start_event() }}"
   post-hook: "{{ logging.log_model_end_event() }}"
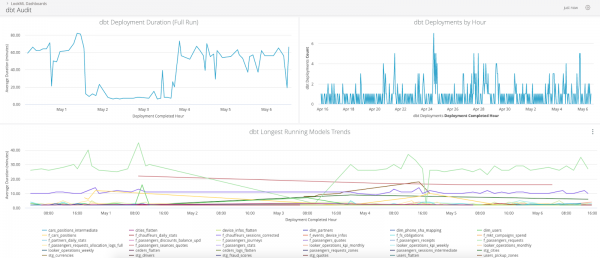
Le module de journalisation permettra d'enregistrer toutes les métadonnées nécessaires dans une table distincte, ce qui permettra par la suite d'effectuer un audit et d'analyser les points problématiques (goulots d'étranglement).
Voici à quoi ressemble le tableau de bord avec les données de journalisation dans Looker :
Automatisation de la maintenance de l'entrepôt
Si vous utilisez certaines extensions de fonctionnalité de l'entrepôt utilisé, comme les UDF (fonctions définies par l'utilisateur), la version des fonctions, la gestion des accès, et le déploiement automatisé des nouvelles versions peuvent être réalisées très facilement dans DBT.
Nous utilisons UDF sur Python pour calculer les valeurs de hachage, les domaines des adresses e-mail, et décoder les masques de bits (bitmask).
Exemple de macro qui crée un UDF dans n'importe quel environnement d'exécution (dev, test, prod) :
{% macro create_udf() -%}

  {% set sql %}
          CREATE OR REPLACE FUNCTION {{ target.schema }}.f_sha256(mes "varchar")
              RETURNS varchar
              LANGUAGE plpythonu
              STABLE
          AS $$
              import hashlib
              return hashlib.sha256(mes).hexdigest()
          $$
          ;
  {% endset %}

  {% set table = run_query(sql) %}

{%- endmacro %}
Chez Wheely, nous utilisons Amazon Redshift, qui est basé sur PostgreSQL. Pour Redshift, il est important de collecter régulièrement des statistiques sur les tables et de libérer de l'espace disque — les commandes ANALYZE et VACUUM, respectivement.
Pour cela, des commandes issues de la macro redshift_maintenance sont exécutées chaque nuit :
{% macro redshift_maintenance() %}

   {% set vacuumable_tables=run_query(vacuumable_tables_sql) %}

   {% for row in vacuumable_tables %}
       {% set message_prefix=loop.index ~ " of " ~ loop.length %}

       {%- set relation_to_vacuum = adapter.get_relation(
                                           database=row['table_database'],
                                           schema=row['table_schema'],
                                           identifier=row['table_name']
                                   ) -%}
       {% do run_query("commit") %}

       {% if relation_to_vacuum %}
           {% set start=modules.datetime.datetime.now() %}
           {{ dbt_utils.log_info(message_prefix ~ " Vacuuming " ~ relation_to_vacuum) }}
           {% do run_query("VACUUM " ~ relation_to_vacuum ~ " BOOST") %}
           {{ dbt_utils.log_info(message_prefix ~ " Analyzing " ~ relation_to_vacuum) }}
           {% do run_query("ANALYZE " ~ relation_to_vacuum) %}
           {% set end=modules.datetime.datetime.now() %}
           {% set total_seconds = (end - start).total_seconds() | round(2)  %}
           {{ dbt_utils.log_info(message_prefix ~ " Finished " ~ relation_to_vacuum ~ " in " ~ total_seconds ~ "s") }}
       {% else %}
           {{ dbt_utils.log_info(message_prefix ~ ' Skipping relation "' ~ row.values() | join ('"."') ~ '" as it does not exist') }}
       {% endif %}

   {% endfor %}

{% endmacro %}
DBT Cloud
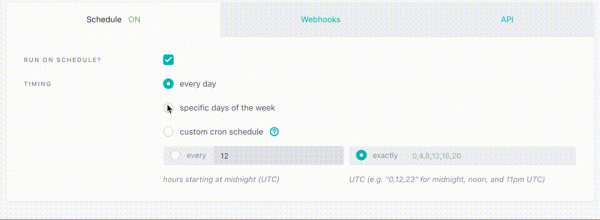
Il est possible d'utiliser DBT en tant que service (Managed Service). Inclus :
- Web IDE pour le développement de projets et de modèles
- Configuration des travaux et planification
- Accès simple et pratique aux logs
- Site Web avec la documentation de votre projet
- Intégration CI (Intégration Continue)
Conclusion
Préparer et consommer le DWH devient aussi agréable et bénéfique que de boire un smoothie. Le DBT se compose de Jinja, d'extensions personnalisées (modules), d'un compilateur, d'un moteur (executor) et d'un gestionnaire de paquets. En combinant ces éléments, vous obtenez un environnement de travail complet pour votre entrepôt de données. Il est peu probable qu'il existe aujourd'hui un meilleur moyen de gérer les transformations au sein de DWH.
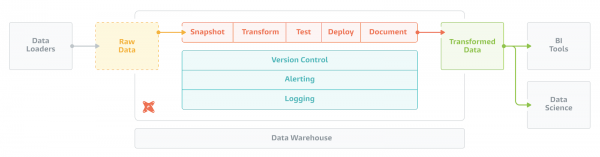
Les convictions suivies par les développeurs de DBT sont formulées comme suit :
- Le code, et non l'interface graphique, constitue la meilleure abstraction pour exprimer une logique analytique complexe.
- Le travail avec les données devrait s'adapter aux meilleures pratiques du développement logiciel (Software Engineering).
- L'infrastructure essentielle pour le travail avec les données doit être contrôlée par la communauté comme un logiciel open source.
- Non seulement les outils d'analyse, mais aussi le code deviendront de plus en plus patrimoine de la communauté Open Source.
Ces convictions fondamentales ont donné naissance à un produit utilisé aujourd'hui par plus de 850 entreprises, et elles constituent la base de nombreuses extensions intéressantes qui seront créées à l'avenir.
Pour ceux qui s'y intéressent, il existe un enregistrement vidéo d'un cours ouvert que j'ai donné il y a quelques mois dans le cadre d'un cours ouvert chez OTUS — .
En plus du DBT et des entrepôts de données, dans le cadre du cours Data Engineer sur la plateforme OTUS, mes collègues et moi donnons des cours sur une variété d'autres sujets pertinents et modernes :
- Concepts architecturaux des applications Big Data.
- Pratique avec Spark et Spark Streaming.
- Étude des méthodes et des outils de chargement des sources de données.
- Construction de vitrines analytiques dans le DWH.
- Concepts NoSQL : HBase, Cassandra, ElasticSearch.
- Principes de mise en place de la surveillance et de l'orchestration.
- Projet final : rassembler toutes les compétences sous le mentorat.
Liens :
- — Documentation officielle.
- — Article de synthèse d'un des auteurs de DBT.
- — YouTube, enregistrement du cours ouvert OTUS.
- — Prochain cours ouvert le 15 mai 2020.
- — OTUS.
- — Un regard sur l'avenir du travail avec les données et l'analyse.
- — Évolution de l'analyse et impact de l'Open Source.
- — Principes de mise en place d'un CI avec DBT.
- — Pratique, instructions étape par étape pour un travail autonome.
- — Github, code du projet pédagogique
Source : habr.com
