

Au cours de la pandémie actuelle de COVID-19, de nombreux problèmes ont surgi, sur lesquels les hackers ont joyeusement sauté. Des visières imprimées en 3D et des masques faits maison à la substitution d'un véritable appareil mécanique de ventilation assistée – ce flot d'idées a inspiré et réjoui les âmes. En même temps, il y a eu des tentatives d'avancer dans un autre domaine : dans la recherche visant à lutter directement contre le virus lui-même.
Apparemment, la meilleure approche pour stopper la pandémie actuelle et devancer toutes les suivantes est celle qui s'efforce de comprendre la source même du problème. Cette approche, du genre « connaîs ton ennemi », est prônée par le projet de calcul Folding@Home. Des millions de personnes se sont inscrites au projet et consacrent une partie de la puissance de calcul de leurs processeurs et GPU, créant ainsi le plus grand supercalculateur [distribué] de l'histoire.
Mais à quoi servent concrètement tous ces exaflops? Pourquoi investir une telle puissance de calcul dans ? Какая тут работает биохимия, зачем вообще белкам нужно укладываться? Вот краткий обзор фолдинга белков: что это, как он происходит и в чём его важность.
Pour commencer, la question la plus importante : pourquoi les protéines sont-elles nécessaires ?
Les protéines sont des structures vitales. Elles ne fournissent pas seulement des matériaux de construction pour les cellules, mais agissent également comme des enzymes catalytiques pour presque toutes les réactions biochimiques. Les protéines, qu'elles soient ou , se composent de longues chaînes , disposés dans un ordre spécifique. Les fonctions des protéines sont déterminées par les acides aminés présents à des emplacements particuliers de la protéine. Par exemple, si une protéine doit se lier à une molécule chargée positivement, le site de liaison doit être rempli d'acides aminés chargés négativement.
Pour comprendre comment les protéines obtiennent la structure qui détermine leur fonction, il faut passer en revue les bases de la biologie moléculaire et le flux d'information dans la cellule.
La production, ou des protéines commence par le processus de . Pendant la transcription, l'ADN en double hélice, qui contient l'information génétique de la cellule, se déroule partiellement, donnant accès aux bases azotées de l'ADN à l'enzyme appelée . La tâche de l'ARN polymérase est de créer une copie d'ARN, ou transcription, du gène. Cette copie du gène est appelée (ARNm) est une molécule simple, idéale pour contrôler les usines de protéines intracellulaires, , qui s'occupent de la production, ou de des protéines.
Les ribosomes agissent comme des dispositifs d'assemblage – ils capturent le modèle d'ARNm et l'associent à d'autres petits morceaux d'ARN, (ARNt). Chaque ARNt possède deux zones actives – une section de trois bases appelée , qui doit correspondre aux codons appropriés de l'ARNm, et un site pour lier un acide aminé spécifique à ce . Lors de la traduction, les molécules d'ARNt dans le ribosome essaient de se lier à l'ARNm par le biais des anticodons. En cas de succès, la molécule d'ARNt attache son acide aminé à celui précédent, formant un nouvel maillon dans la chaîne d'acides aminés codée par l'ARNm.
Cette séquence d'acides aminés constitue le premier niveau de hiérarchie structurelle de la protéine, c'est pourquoi on l'appelle sa . Toute la structure tridimensionnelle de la protéine et ses fonctions découlent directement de la structure primaire et dépendent des diverses propriétés de chacun des acides aminés et de leurs interactions entre eux. Sans ces propriétés chimiques et interactions entre acides aminés, resteraient des séquences linéaires sans structure tridimensionnelle. Cela se voit à chaque fois que l'on cuisine – ce processus entraîne la de la structure tridimensionnelle des protéines.
Liens à longue portée entre les parties des protéines
Le niveau suivant de la structure tridimensionnelle, qui dépasse la structure primaire, a été astucieusement nommé . Elle comprend des liaisons hydrogène entre acides aminés relativement proches. L'essence de ces interactions stabilisatrices se résume à deux éléments : et . L'hélice alpha forme une section de polypeptide étroitement enroulée, tandis que la feuille bêta constitue une zone lisse et large. Les deux formations possèdent des propriétés structurelles et fonctionnelles qui dépendent des caractéristiques des acides aminés qui les composent. Par exemple, si l'hélice alpha est principalement constituée d'acides aminés hydrophiles, comme ou , elle participera probablement à des réactions aquatiques.
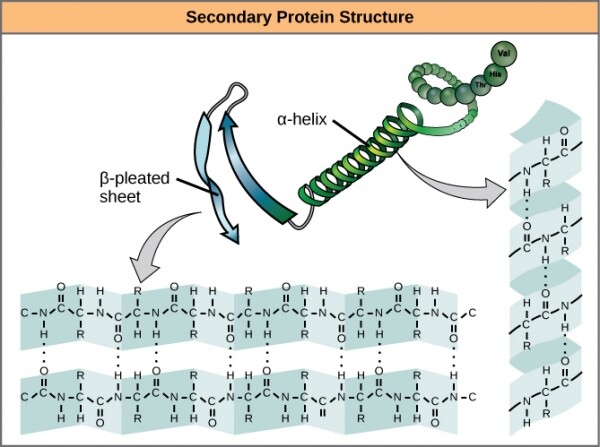
Les hélices alpha et les feuillets bêta dans les protéines. Des liaisons hydrogène se forment lors de l'expression des protéines.
Ces deux structures et leurs combinaisons forment le niveau suivant de la structure des protéines — . Contrairement aux simples fragments de la structure secondaire, la structure tertiaire est principalement influencée par l'hydrophobie. Au centre de la plupart des protéines se trouvent des acides aminés hautement hydrophobes, comme ou , et l'eau en est exclue en raison de la nature « grasse » des radicaux. Ces structures apparaissent souvent dans les protéines transmembranaires, intégrées dans la double couche lipidique entourant les cellules. Les zones hydrophobes des protéines restent thermodynamiquement stables à l'intérieur de la partie lipidique de la membrane, tandis que les zones hydrophiles des protéines sont exposées à l'environnement aquatique des deux côtés.
La stabilité des structures tertiaires est également assurée par des liaisons à longue portée entre les acides aminés. Un exemple classique de telles liaisons est le , qui se forme souvent entre deux radicaux cystéines. Si, dans un salon de coiffure, pendant la procédure de permanente d'un client, vous avez senti une odeur légèrement similaire à celle d'œufs pourris, c'était une dénaturation partielle de la structure tertiaire de la kératine contenue dans les cheveux, se produisant par la réduction des liaisons disulfure par des mélanges contenant du soufre .
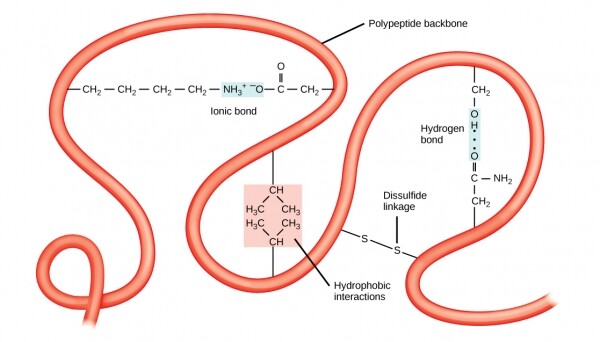
La structure tertiaire est stabilisée par des interactions à longue portée, telles que l'hydrophobie ou les liaisons disulfure.
Les liaisons disulfure peuvent se former entre dans une seule chaîne polypeptidique, ou entre des cystéines provenant de chaînes différentes. Les interactions entre différentes chaînes forment de la structure protéique. Un excellent exemple de structure quaternaire est dans votre sang. Chaque molécule d'hémoglobine est constituée de quatre globines identiques, des parties de protéines, chacune étant maintenue dans une position particulière à l'intérieur du polypeptide par des ponts disulfures, et est également liée à une molécule de hème contenant du fer. Les quatre globines sont reliées entre elles par des ponts disulfures intermoléculaires, et la molécule dans son ensemble peut se lier à plusieurs molécules d'air, jusqu'à quatre, et capable de les libérer au besoin.
Modélisation des structures à la recherche de traitements pour les maladies
Les chaînes polypeptidiques commencent à se plier dans leur forme finale pendant la traduction, lorsque la chaîne en croissance émerge du ribosome - un peu comme un fil en alliage à mémoire qui peut prendre des formes complexes lorsqu'il est chauffé. Cependant, comme toujours en biologie, tout cela n'est pas si simple.
Dans de nombreuses cellules, les gènes transcrits subissent une édition importante avant la traduction, modifiant considérablement la structure de base de la protéine par rapport à la séquence d'origine de bases du gène. Dans ce processus, les mécanismes de traduction recourent souvent à l'aide de chaperons moléculaires, des protéines qui se lient temporairement à la chaîne polypeptidique naissante, empêchant celle-ci de prendre toute forme intermédiaire qui ne leur permettrait pas de passer à la forme finale.
Tout cela pour dire que prédire la forme finale d'une protéine n'est pas une tâche triviale. Pendant des décennies, le seul moyen d'étudier la structure des protéines a été des méthodes physiques telles que la cristallographie rayons X. Ce n'est qu'à la fin des années 1960 que des chimistes biophysiques ont commencé à construire des modèles informatiques de repliement des protéines, se concentrant principalement sur la modélisation de la structure secondaire. Ces méthodes et leurs successeurs nécessitent d'énormes volumes de données d'entrée en plus de la structure primaire – par exemple, des tableaux d'angles de liaison des acides aminés, des listes d'hydrophobicité, des états chargés, et même la conservation de la structure et du fonctionnement sur des périodes temporelles évolutives – tout cela pour deviner à quoi ressemblera la protéine finale.
Les méthodes de calcul actuelles pour prédire la structure secondaire, fonctionnant notamment dans le réseau Folding@Home, atteignent environ 80 % de précision, ce qui est plutôt bon compte tenu de la complexité de la tâche. Les données obtenues par ces modèles de prédiction sur des protéines comme la protéine Spike du SARS-CoV-2 seront comparées aux données d'études physiques du virus. In fine, il sera possible d'obtenir la structure précise de la protéine et, peut-être, de comprendre comment le virus se fixe aux récepteurs. humain dans les voies respiratoires menant à l'intérieur du corps. Si nous parvenons à comprendre cette structure, nous pourrons probablement trouver des médicaments bloquant l'attachement et prévenant l'infection.
Les recherches sur le repliement des protéines sont au cœur de notre compréhension d'un grand nombre de maladies et d'infections, si bien que même lorsque nous utiliserons le réseau Folding@Home pour découvrir comment vaincre le COVID-19, dont la croissance explosive est observée dernièrement, ce réseau ne sera pas longtemps inoccupé. C'est un outil de recherche idéal pour l'étude des modèles protéiques à la base de dizaines de maladies liées à un mauvais repliement des protéines – par exemple, la maladie d'Alzheimer ou une forme de la maladie de Creutzfeldt-Jakob, souvent incorrectement appelée la maladie de la vache folle. Et quand un nouveau virus apparaîtra inévitablement, nous serons déjà prêts à reprendre la lutte.
Source : habr.com
