

Récemment, j'ai été confronté à une tâche plutôt atypique de configuration de routage pour MetalLB. Tout irait bien, car généralement MetalLB ne nécessite pas d'actions supplémentaires, mais dans notre cas, nous avons un cluster assez grand avec une configuration réseau plutôt simple.
Dans cet article, je vais expliquer comment configurer le routage basé sur l'origine et le routage basé sur des politiques pour le réseau externe de votre cluster.
Je ne vais pas m'attarder sur l'installation et la configuration de MetalLB, car je suppose que vous avez déjà une certaine expérience. Passons directement à l'essentiel, à savoir la configuration du routage. Nous avons donc quatre scénarios :
Scénario 1 : Quand la configuration n'est pas nécessaire
Examinons un cas simple.
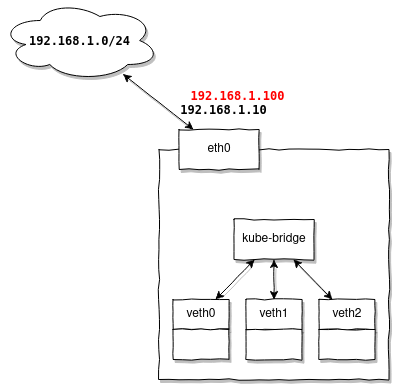
Aucune configuration de routage supplémentaire n'est nécessaire lorsque les adresses attribuées par MetalLB se trouvent dans la même sous-réseau que les adresses de vos nœuds.
Par exemple, vous avez une sous-réseau 192.168.1.0/24, il y a un routeur 192.168.1.1, et vos nœuds reçoivent les adresses : 192.168.1.10-30, alors pour MetalLB, vous pouvez configurer la plage 192.168.1.100-120 et être assuré qu'elles fonctionneront sans aucune configuration supplémentaire.
Pourquoi cela ? Parce que vos nœuds ont déjà des routes configurées :
# ip route
default via 192.168.1.1 dev eth0 onlink
192.168.1.0/24 dev eth0 proto kernel scope link src 192.168.1.10
Et les adresses de la même plage réutiliseront celles-ci sans aucun effort supplémentaire.
Scénario 2 : Quand une configuration supplémentaire est nécessaire
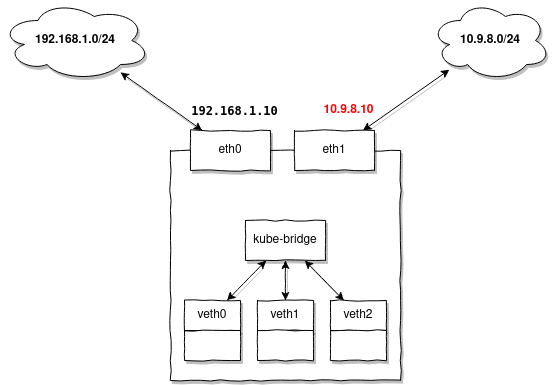
Vous devez configurer des routes supplémentaires chaque fois que vos nœuds n'ont pas de adresses IP ou de route vers la sous-réseau pour laquelle MetalLB attribue des adresses.
Laissez-moi expliquer cela un peu plus en détail. Chaque fois que MetalLB attribue une adresse, cela peut être comparé à une simple affectation du type :
ip addr add 10.9.8.7/32 dev loNotez que :
- a) L'adresse est attribuée avec un préfixe
/32c'est-à-dire que la route vers la sous-réseau ne sera pas ajoutée automatiquement (c'est juste une adresse) - b) L'adresse est attachée à n'importe quelle interface du nœud (par exemple, la boucle de retour). Il convient de mentionner ici une caractéristique de la pile réseau Linux. Peu importe sur quelle interface vous ajoutez l'adresse, le noyau traitera toujours les requêtes ARP et enverra des réponses ARP sur n'importe laquelle d'elles, ce comportement est considéré comme correct et, de plus, est assez largement utilisé dans un environnement dynamique comme Kubernetes.
Ce comportement peut être configuré, par exemple, en activant l'arp strict :
echo 1 > /proc/sys/net/ipv4/conf/all/arp_ignore
echo 2 > /proc/sys/net/ipv4/conf/all/arp_announce
Dans ce cas, les réponses ARP seront envoyées uniquement si l'interface contient explicitement une adresse IP spécifique. Ce paramètre est obligatoire si vous prévoyez d'utiliser MetalLB et que votre kube-proxy fonctionne en mode IPVS.
Cependant, MetalLB ne traite pas les requêtes ARP via le noyau, mais le fait lui-même dans l'espace utilisateur, donc cette option n'affectera pas le fonctionnement de MetalLB.
Revenons à notre tâche. Si la route pour les adresses attribuées sur vos nœuds n'existe pas, ajoutez-la à l'avance sur tous les nœuds :
ip route add 10.9.8.0/24 dev eth1Cas 3 : Quand un routage basé sur la source sera nécessaire
Vous devrez configurer le routage basé sur la source lorsque vous recevez des paquets via une passerelle distincte de celle par défaut, par conséquent, les paquets de réponse doivent également passer par cette même passerelle.
Par exemple, vous avez toujours le même sous-réseau 192.168.1.0/24 réservé pour vos nœuds, mais vous souhaitez attribuer des adresses externes à l'aide de MetalLB. Supposons que vous disposiez de plusieurs adresses issues du sous-réseau 1.2.3.0/24 situées dans le VLAN 100, et que vous souhaitez les utiliser pour accéder aux services Kubernetes de l'extérieur.
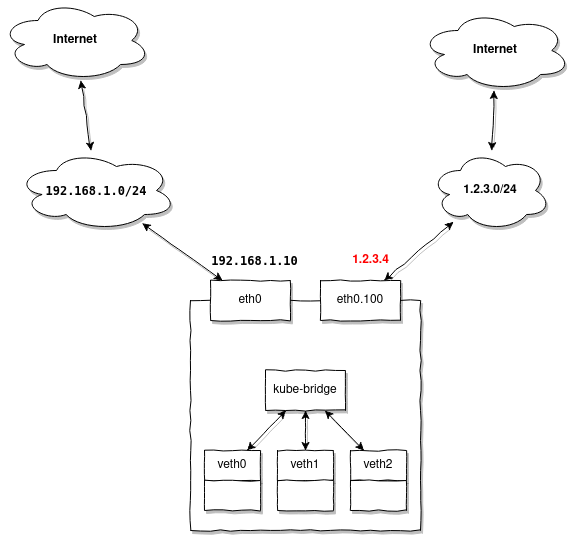
Lors de l'accès à 1.2.3.4 vous effectuerez des requêtes depuis un autre sous-réseau que 1.2.3.0/24 et attendrez une réponse. Le nœud qui est actuellement le maître pour l'adresse attribuée par MetalLB 1.2.3.4, recevra le paquet du routeur 1.2.3.1, mais la réponse doit obligatoirement retourner par le même chemin, via 1.2.3.1.
Puisque notre nœud a déjà une passerelle par défaut configurée 192.168.1.1, par défaut, la réponse ira vers celle-ci, et non vers 1.2.3.1, à travers laquelle nous avons reçu le paquet.
Comment gérer cette situation ?
Dans ce cas, vous devez préparer tous vos nœuds afin qu'ils soient prêts à servir des adresses externes sans configuration supplémentaire. Autrement dit, pour l'exemple ci-dessus, vous devez au préalable créer une interface VLAN sur le nœud :
ip link add link eth0 name eth0.100 type vlan id 100
ip link set eth0.100 up
Ensuite, ajoutez les routes :
ip route add 1.2.3.0/24 dev eth0.100 table 100
ip route add default via 1.2.3.1 table 100
Notez que nous ajoutons les routes dans une table de routage distincte 100 elle contiendra uniquement deux routes nécessaires pour envoyer le paquet de réponse via la passerelle 1.2.3.1, qui se trouve derrière l'interface eth0.100.
Maintenant, nous devons ajouter une simple règle :
ip rule add from 1.2.3.0/24 lookup 100qui indique explicitement : si l'adresse source du paquet se trouve dans 1.2.3.0/24, alors utilisez la table de routage 100. Nous avons déjà décrit le chemin qui l'enverra à travers 1.2.3.1
Cas 4 : Quand un routage basé sur les politiques est nécessaire
La topologie du réseau est comme dans l'exemple précédent, mais supposons que vous souhaitiez également avoir la possibilité d'accéder à des adresses externes du pool 1.2.3.0/24 depuis vos pods :
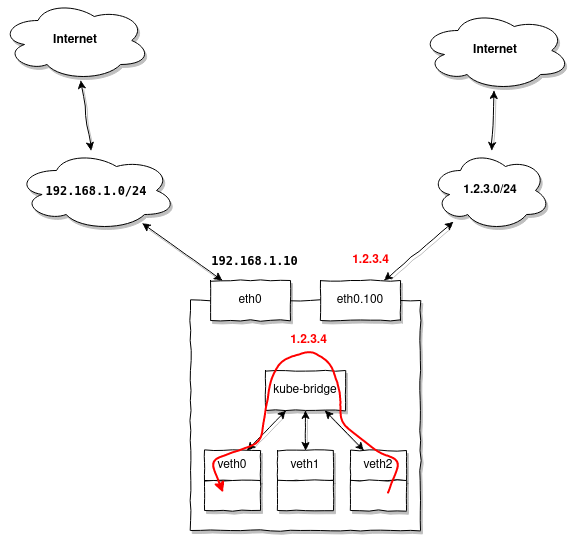
La particularité réside dans le fait que lorsqu'on accède à n'importe quelle adresse dans 1.2.3.0/24, le paquet de réponse arrivant sur le nœud et ayant une adresse source dans la plage 1.2.3.0/24 sera obéissant et envoyé à eth0.100, mais ce que nous voulons, c'est que Kubernetes le redirige vers notre premier pod, qui a généré la requête initiale.
Résoudre ce problème s'est avéré difficile, mais cela a été possible grâce au routage basé sur les politiques :
Pour mieux comprendre le processus, je vais donner un schéma bloqué de netfilter :
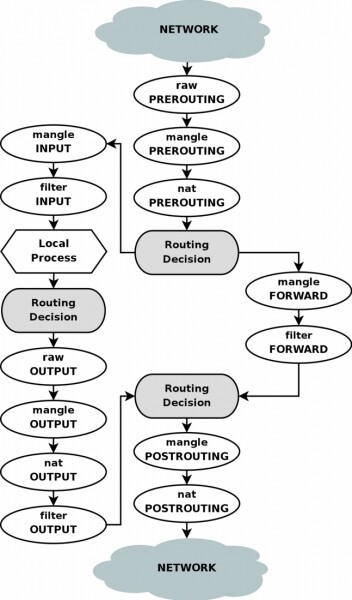
Pour commencer, comme dans l'exemple précédent, créons une table de routage supplémentaire :
ip route add 1.2.3.0/24 dev eth0.100 table 100
ip route add default via 1.2.3.1 table 100
Ajoutons maintenant quelques règles dans iptables :
iptables -t mangle -A PREROUTING -i eth0.100 -j CONNMARK --set-mark 0x100
iptables -t mangle -A PREROUTING -j CONNMARK --restore-mark
iptables -t mangle -A PREROUTING -m mark ! --mark 0 -j RETURN
iptables -t mangle -A POSTROUTING -j CONNMARK --save-mark
Ces règles vont marquer les connexions entrantes sur l'interface eth0.100, en étiquetant tous les paquets avec le tag 0x100, ce même tag sera également utilisé pour les réponses dans le cadre d'une même connexion.
Nous pouvons maintenant ajouter une règle de routage :
ip rule add from 1.2.3.0/24 fwmark 0x100 lookup 100C'est-à-dire que tous les paquets avec une adresse source 1.2.3.0/24 et un tag 0x100 devraient être routés en utilisant la table 100.
Ainsi, d'autres paquets reçus sur une autre interface ne seront pas soumis à cette règle, ce qui leur permettra d'être routés par les moyens standard de Kubernetes.
Il y a cependant un autre mais : Linux dispose d'un filtre de chemin inverse qui gâte tout et effectue une simple vérification : pour tous les paquets entrants, il modifie l'adresse source du paquet avec l'adresse de l'expéditeur et vérifie si le paquet peut sortir par la même interface par laquelle il a été reçu. Sinon, il le filtre.
Le problème est que dans notre cas, cela ne fonctionnera pas correctement, mais nous pouvons le désactiver :
echo 0 > /proc/sys/net/ipv4/conf/all/rp_filter
echo 0 > /proc/sys/net/ipv4/conf/eth0.100/rp_filter
Notez que la première commande contrôle le comportement global de rp_filter ; si elle n'est pas désactivée, la deuxième commande n'aura aucun effet. Cependant, les autres interfaces resteront avec rp_filter activé.
Pour ne pas restreindre complètement le fonctionnement du filtre, nous pouvons utiliser l'implémentation de rp_filter pour netfilter. En utilisant rpfilter en tant que module iptables, il est possible de configurer des règles assez flexibles, par exemple :
iptables -t raw -A PREROUTING -i eth0.100 -d 1.2.3.0/24 -j RETURN
iptables -t raw -A PREROUTING -i eth0.100 -m rpfilter --invert -j DROP
activer rp_filter sur l'interface eth0.100 pour toutes les adresses sauf 1.2.3.0/24.
Source : habr.com
