

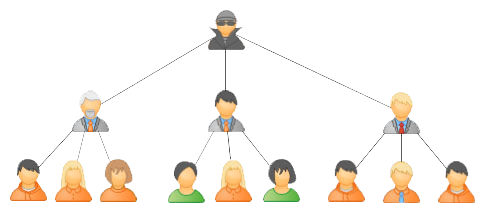
Dans les systèmes ERP complexes de nombreuses entités ont une nature hiérarchique, lorsque des objets homogènes sont organisés en un arbre de relations « parent - enfant » — cela concerne à la fois la structure organisationnelle de l'entreprise (toutes ces filiales, départements et groupes de travail), le catalogue de produits, les domaines de travail, et la géographie des points de vente,…
En réalité, il n'existe aucune , où il n'y a pas eu un minimum de hiérarchie. Mais même si vous ne travaillez pas « dans les affaires », vous pouvez néanmoins rencontrer facilement des relations hiérarchiques. Simplement, même votre arbre généalogique ou le plan d'étage d'un centre commercial représente une telle structure.
Il existe de nombreuses manières de stocker cet arbre dans une SGBD, mais aujourd'hui nous allons nous concentrer uniquement sur une option :
CREATE TABLE hier(
  id
    integer
      PRIMARY KEY
, pid
    integer
      REFERENCES hier
, data
    json
);

CREATE INDEX ON hier(pid); -- n'oublions pas que la clé étrangère ne sous-entend pas la création automatique d'un index, contrairement à la clé primaire.
Et pendant que vous scrutez la profondeur de l'arborescence, elle attend patiemment de voir à quel point vos méthodes de travail « naïves » avec cette structure s'avéreront [non] efficaces.
Examinons les tâches typiques qui se présentent, leur mise en œuvre en SQL et essayons d'améliorer leurs performances.
#1. Насколько глубока кроличья нора?
Pour être précis, considérons que cette structure reflétera la subordination des départements dans la structure de l'organisation : départements, divisions, secteurs, filiales, groupes de travail,… peu importe comment vous les appelez.
Commençons par générer notre 'arbre' de 10K éléments
INSERT INTO hier
WITH RECURSIVE T AS (
  SELECT
    1::integer id
  , '{1}'::integer[] pids
UNION ALL
  SELECT
    id + 1
  , pids[1:(random() * array_length(pids, 1))::integer] || (id + 1)
  FROM
    T
  WHERE
    id < 10000
)
SELECT
  pids[array_length(pids, 1)] id
, pids[array_length(pids, 1) - 1] pid
FROM
  T;
Commençons par la tâche la plus simple : trouver tous les employés qui travaillent dans un secteur particulier, ou en termes hiérarchiques — trouver tous les descendants d'un nœud. Et il serait également bon d'obtenir la « profondeur » du descendant… Tout cela peut être nécessaire, par exemple, pour construire un .
Tout irait bien si ces descendants n'avaient que quelques niveaux et étaient au nombre d'une dizaine. Mais si le nombre de niveaux dépasse 5 et que les descendants sont déjà des dizaines, cela peut poser des problèmes. Voyons comment s'écrivent (et fonctionnent) les variantes traditionnelles de la recherche "vers le bas dans l'arbre". Mais d'abord, déterminons quels nœuds seront les plus intéressants pour nos recherches.
Les plus «profonds» sous-arbres :
WITH RECURSIVE T AS (
  SELECT
    id
  , pid
  , ARRAY[id] path
  FROM
    hier
  WHERE
    pid IS NULL
UNION ALL
  SELECT
    hier.id
  , hier.pid
  , T.path || hier.id
  FROM
    T
  JOIN
    hier
      ON hier.pid = T.id
)
TABLE T ORDER BY array_length(path, 1) DESC;
id | pid | path
---------------------------------------------
7624 | 7623 | {7615,7620,7621,7622,7623,7624}
4995 | 4994 | {4983,4985,4988,4993,4994,4995}
4991 | 4990 | {4983,4985,4988,4989,4990,4991}
...Les plus «larges» sous-arbres :
...
SELECT
  path[1] id
, count(*)
FROM
  T
GROUP BY
  1
ORDER BY
  2 DESC;
id | count
------------
5300 | 30
450 | 28
1239 | 27
1573 | 25
Pour ces requêtes, nous avons utilisé un typique JOIN récursif:
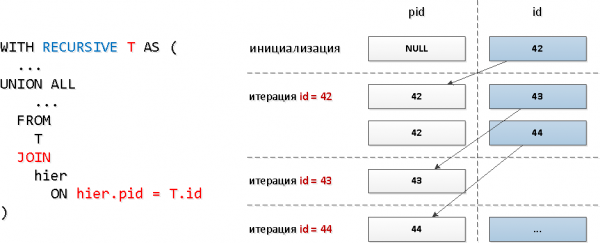
Évidemment, avec un tel modèle de requête le nombre d'itérations correspondra au nombre total de descendants (et ils sont plusieurs dizaines), et cela peut nécessiter des ressources assez substantielles, et par conséquent, du temps.
Vérifions sur le sous-arbre le plus "large" :
WITH RECURSIVE T AS (
  SELECT
    id
  FROM
    hier
  WHERE
    id = 5300
UNION ALL
  SELECT
    hier.id
  FROM
    T
  JOIN
    hier
      ON hier.pid = T.id
)
TABLE T; 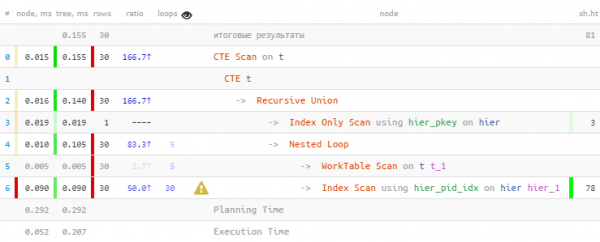
Comme nous l'avions prévu, nous avons trouvé toutes les 30 entrées. Mais cela nous a pris 60 % du temps total — parce que nous avons effectué 30 recherches dans l'index. Serait-il possible de faire moins ?
Lecture massifiée par l'index
Et avons-nous vraiment besoin de faire une requête distincte à l'index pour chaque nœud ? Apparemment, non — nous pouvons lire dans l'index tout de suite avec plusieurs clés en une seule requête à l'aide de = ANY(array).
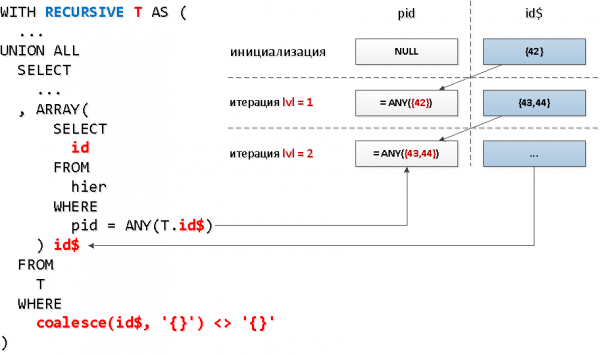
Et pour chaque groupe d'identifiants, nous pouvons prendre tous les ID trouvés à l'étape précédente pour les «nœuds». Cela signifie qu'à chaque étape suivante, nous allons chercher tous les descendants d'un certain niveau en même temps..
Seulement voilà, dans une sélection récursive, il n'est pas possible de se référer à lui-même dans une requête imbriquée, et nous devons bien récupérer uniquement ceux trouvés au niveau précédent... Il s'avère qu'une requête imbriquée sur l'ensemble de la sélection n'est pas possible, mais sur son champ spécifique, cela l'est. Et ce champ peut être un tableau — ce qui est exactement ce dont nous avons besoin pour l'utilisation. ALL.
Cela peut sembler un peu étrange, mais sur le schéma, c'est tout simple.
AVEC RECURSIVE T AS (
  SELECT
    ARRAY[id] id$
  FROM
    hier
  WHERE
    id = 5300
UNION ALL
  SELECT
    ARRAY(
      SELECT
        id
      FROM
        hier
      WHERE
        pid = ANY(T.id$)
    ) id$
  FROM
    T
  WHERE
    coalesce(id$, '{}')  '{}' -- condition de sortie de la boucle - tableau vide
)
SELECT
  unnest(id$) id
FROM
T; 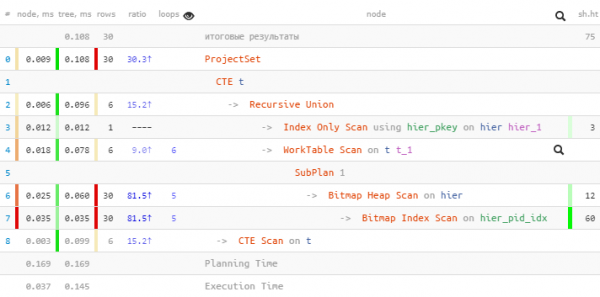
Et ici, le plus important n'est même pas gagner 1,5 fois en temps, mais le fait que nous avons moins extrait de buffers, puisque nous n'avons eu que 5 accès à l'index au lieu de 30 !
Un bonus supplémentaire est que, après le dénuement final, les identifiants resteront ordonnés par « niveaux ».
Indicateur de nœud
Une autre considération qui aidera à améliorer les performances — les « feuilles » ne peuvent pas avoir d'enfants, c'est-à-dire qu'il n'est pas nécessaire de chercher « en bas » pour elles. Dans notre tâche, cela signifie que si nous avons traversé la chaîne des départements et atteint un employé, il n'est plus nécessaire de chercher plus loin dans cette branche.
Introduisons dans notre tableau un boolean-champ, qui nous indiquera immédiatement si cet enregistrement spécifique dans notre arbre est un « nœud » — c'est-à-dire s'il peut avoir des descendants.
ALTER TABLE hier
  ADD COLUMN branch boolean;

UPDATE
  hier T
SET
  branch = TRUE
WHERE
  EXISTS(
    SELECT
      NULL
    FROM
      hier
    WHERE
      pid = T.id
    LIMIT 1
);
-- La requête a été exécutée avec succès : 3033 lignes modifiées en 42 ms.
Super ! Il s'avère que seulement un peu plus de 30 % de tous les éléments de l'arbre ont des descendants.
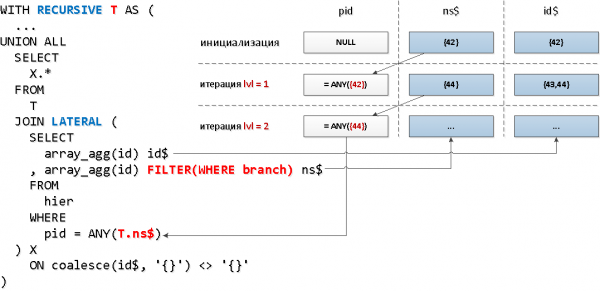
Appliquons maintenant une mécanique légèrement différente — des jointures avec la partie récursive via LATERAL, ce qui nous permettra de nous adresser immédiatement aux champs de la « table » récursive, et nous utiliserons la fonction agrégative avec une condition de filtrage sur l'indicateur de nœud pour réduire l'ensemble des clés :
WITH RECURSIVE T AS (
  SELECT
    array_agg(id) id$
  , array_agg(id) FILTER(WHERE branch) ns$
  FROM
    hier
  WHERE
    id = 5300
UNION ALL
  SELECT
    X.*
  FROM
    T
  JOIN LATERAL (
    SELECT
      array_agg(id) id$
    , array_agg(id) FILTER(WHERE branch) ns$
    FROM
      hier
    WHERE
      pid = ANY(T.ns$)
  ) X
    ON coalesce(T.ns$, '{}')  '{}'
)
SELECT
  unnest(id$) id
FROM
T; 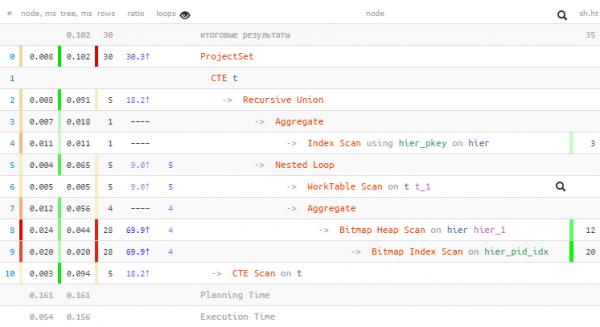
Nous avons pu réduire encore un accès à l'index et gagné plus de 2 fois en volume extrait.
#2. Вернемся к корням
Cet algorithme sera utile si vous devez rassembler des enregistrements pour tous les éléments « en remontant dans l'arbre », tout en conservant les informations sur quel feuille d'origine (et avec quels indicateurs) a conduit à son inclusion dans l'échantillon — par exemple, pour élaborer un rapport récapitulatif avec une agrégation sur les nœuds.
La suite doit être considérée uniquement comme un proof-of-concept, car la requête devient vraiment encombrante. Mais si elle domine votre base, il vaut la peine de réfléchir à l'utilisation de telles méthodes.
Commençons par quelques déclarations simples :
- Un même enregistrement dans la base vaut mieux être lu une seule fois.
- Les enregistrements de la base sont plus efficaces à lire en « lot », plutôt qu'un par un.
Essayons maintenant de construire la requête dont nous avons besoin.
Étape 1
Il est évident qu'à l'initialisation de la récursion (sans elle, ça ne fonctionne pas !), nous devrons lire les enregistrements des feuilles selon un ensemble d'identifiants source :
WITH RECURSIVE tree AS (
  SELECT
    rec -- c'est un enregistrement complet de la table
  , id::text chld -- c'est "l'ensemble" des feuilles sources qui ont conduit ici
  FROM
    hier rec
  WHERE
    id = ANY('{1,2,4,8,16,32,64,128,256,512,1024,2048,4096,8192}'::integer[])
UNION ALL
  ...
Si quelqu'un a trouvé étrange que « l'ensemble » soit stocké sous forme de chaîne, et non de tableau, il y a une explication simple. Pour les chaînes, il existe une fonction d'agrégation intégrée appelée string_agg, mais il n'en existe pas pour les tableaux. Bien qu'il soit facile de l'implémenter soi-même .
Étape 2
les regrouper , tout en préservant l'information sur les feuilles sources.Mais ici, trois problèmes nous attendent :
La partie « sous-récursive » de la requête ne peut pas contenir de fonctions d'agrégation avec
- L'appel à la « table » récursive ne peut pas se trouver dans une sous-requête imbriquée.
et ne doit pas contenir. - La requête dans la partie récursive ne peut pas contenir de CTE.
- Heureusement, tous ces problèmes sont assez faciles à contourner. Commençons par la fin.
Le CTE dans la partie récursive
fonctionne :
Voilà à quoi ne WITH RECURSIVE tree AS ( ... UNION ALL WITH T (...) SELECT ... )
Et de cette façon, ça marche — les parenthèses résolvent le problème !WITH RECURSIVE tree AS ( ... UNION ALL ( WITH T (...) SELECT ... ) )
Une requête imbriquée à la « table » récursiveHmm… L'appel à la CTE récursive ne peut pas être dans une requête imbriquée. Mais il peut être à l'intérieur d'une CTE ! Et la requête imbriquée peut déjà faire appel à cette CTE !
GROUP BY à l'intérieur de la récursion
C'est désagréable, mais… Nous avons un moyen simple de simuler GROUP BY avec
DISTINCT ON et des fonctions de fenêtre ! SELECT (rec).pid id , string_agg(chld::text, ',') chld FROM tree WHERE (rec).pid IS NOT NULL GROUP BY 1 -- ne fonctionne pas !
Mais de cette façon, ça marche !SELECT DISTINCT ON((rec).pid) (rec).pid id , string_agg(chld::text, ',') OVER(PARTITION BY (rec).pid) chld FROM tree WHERE (rec).pid IS NOT NULL
SÉLECTIONNER DISTINCT SUR((rec).pid)
  (rec).pid id
, string_agg(chld::text, ',') SUR(PARTITION PAR (rec).pid) chld
DE
  arbre
OÙ
  (rec).pid N'EST PAS NULL
Maintenant, nous voyons pourquoi l'ID numérique était transformé en texte — pour pouvoir les concaténer avec une virgule !
Étape 3
Il ne nous reste plus qu'à finaliser :
- nous examinons les enregistrements des « sections » selon l'ensemble des ID regroupés
- nous associons les sections extraites aux « ensembles » de feuilles sources
- nous « déployons » la ligne-ensemble à l'aide de
unnest(string_to_array(chld, ',')::integer[])
WITH RECURSIVE tree AS (
  SELECT
    rec
  , id::text chld
  FROM
    hier rec
  WHERE
    id = ANY('{1,2,4,8,16,32,64,128,256,512,1024,2048,4096,8192}'::integer[])
UNION ALL
  (
    WITH prnt AS (
      SELECT DISTINCT ON((rec).pid)
        (rec).pid id
      , string_agg(chld::text, ',') OVER(PARTITION BY (rec).pid) chld
      FROM
        tree
      WHERE
        (rec).pid IS NOT NULL
    )
    , nodes AS (
      SELECT
        rec
      FROM
        hier rec
      WHERE
        id = ANY(ARRAY(
          SELECT
            id
          FROM
            prnt
        ))
    )
    SELECT
      nodes.rec
    , prnt.chld
    FROM
      prnt
    JOIN
      nodes
        ON (nodes.rec).id = prnt.id
  )
)
SELECT
  unnest(string_to_array(chld, ',')::integer[]) leaf
, (rec).*
FROM
tree; 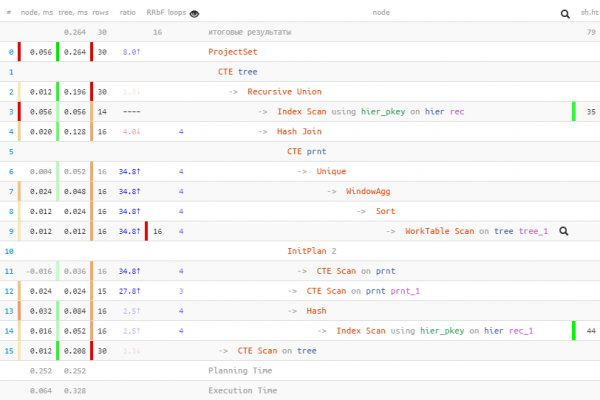
Source : habr.com
