

Je m'appelle Denis Rojkov, je suis responsable du développement logiciel chez « Gazinformservice », dans l'équipe produit. . La législation et les normes d'entreprise imposent certaines exigences en matière de sécurité des données. Personne ne veut que des tiers aient accès à des informations confidentielles, c'est pourquoi les questions suivantes sont essentielles pour tout projet : identification et authentification, gestion des accès aux données, garantie de l'intégrité des informations dans le système, enregistrement des événements de sécurité. C'est pourquoi je souhaite parler de certains points intéressants concernant la sécurité des SGBD.
Cet article a été préparé à partir d'une présentation lors de organisé par . Si vous ne voulez pas lire, vous pouvez regarder :
L'article sera divisé en trois parties :
- Comment protéger les connexions.
- Qu'est-ce qu'un audit des actions et comment enregistrer ce qui se passe du côté de la base de données et de sa connexion.
- Comment protéger les données au sein même de la base de données et quelles technologies sont disponibles pour cela.
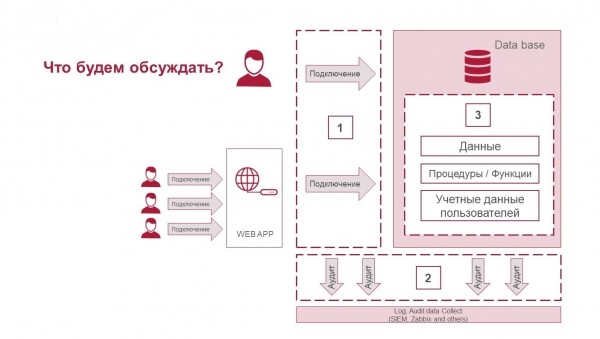
Les trois composantes de la sécurité des SGBD : protection des connexions, audit des actions et protection des données.
Protection des connexions
On peut se connecter à la base de données de manière directe ou indirecte via des applications web. En général, l'utilisateur du côté des affaires, c'est-à-dire la personne qui travaille avec le SGBD, n'interagit pas directement avec celui-ci.
Avant de parler de la protection des connexions, il est important de répondre aux questions cruciales qui déterminent comment les mesures de sécurité seront mises en place :
- un utilisateur commercial équivaut-il à un utilisateur du SGBD ;
- l'accès aux données du SGBD est-il assuré uniquement via une API que vous contrôlez, ou y a-t-il un accès direct aux tables ;
- le SGBD est-il isolé dans un segment protégé, qui interagit avec lui et comment ;
- utilise-t-on du pooling/proxy et des couches intermédiaires qui peuvent modifier les informations sur la manière dont la connexion est établie et qui utilise la base de données.
Voyons maintenant quels outils peuvent être utilisés pour protéger les connexions :
- Utilisez des solutions de type pare-feu de base de données. Un niveau de protection supplémentaire augmentera au minimum la transparence de ce qui se passe dans le SGBD, au maximum — vous pourrez fournir une protection supplémentaire des données.
- Utilisez des politiques de mots de passe. Leur application dépend de la manière dont votre architecture est construite. Dans tous les cas, un seul mot de passe dans le fichier de configuration de l'application web connectée à la base de données n'est pas suffisant pour assurer la protection. Il existe plusieurs outils de base de données permettant de contrôler que l'utilisateur et le mot de passe nécessitent une actualisation.
Pour en savoir plus sur les fonctionnalités d'évaluation des utilisateurs, vous pouvez consulter , ainsi que sur l'évaluation des vulnérabilités MS SQL. .
- Enrichissez le contexte de la session avec les informations nécessaires. Si la session est opaque, vous ne comprenez pas qui travaille dans la base de données, il est possible, dans le cadre de l'opération en cours, d'ajouter des informations sur qui fait quoi et pourquoi. Ces informations peuvent être vues dans l'audit.
- Configurez SSL si vous n'avez pas de séparation réseau entre la base de données et les utilisateurs finaux, qu'elle ne se trouve pas dans un VLAN séparé. Dans de tels cas, il est essentiel de protéger le canal entre le consommateur et la base de données elle-même. Des outils de protection existent également parmi les open source.
Quel impact cela aura-t-il sur les performances de la base de données?
Examinons, à l'aide de PostgreSQL, comment SSL affecte la charge CPU, augmente les temps de réponse et réduit le TPS, sans gaspiller trop de ressources lorsque cela est activé.
Nous chargeons PostgreSQL en utilisant pgbench — c'est un programme simple pour exécuter des tests de performance. Il exécute plusieurs fois une séquence de commandes, éventuellement dans des sessions parallèles de la base de données, puis calcule la vitesse moyenne des transactions.
Test 1 sans SSL et avec SSL — une connexion est établie à chaque transaction :
pgbench.exe --connect -c 10 -t 5000 "host=192.168.220.129 dbname=taskdb user=postgres sslmode=require
sslrootcert=rootCA.crt sslcert=client.crt sslkey=client.key"
vs
pgbench.exe --connect -c 10 -t 5000 "host=192.168.220.129 dbname=taskdb user=postgres"Test 2 sans SSL et avec SSL — toutes les transactions sont effectuées dans une seule connexion :
pgbench.exe -c 10 -t 5000 "host=192.168.220.129 dbname=taskdb user=postgres sslmode=require
sslrootcert=rootCA.crt sslcert=client.crt sslkey=client.key"
vs
pgbench.exe -c 10 -t 5000 "host=192.168.220.129 dbname=taskdb user=postgres"Autres paramètres:
facteur d'échelle : 1
mode de requête : simple
nombre de clients : 10
nombre de threads : 1
nombre de transactions par client : 5000
nombre de transactions réellement traitées : 50000/50000
Résultats des tests:
PAS DE SSL
SSL
Une connexion est établie à chaque transaction
latence moyenne
171,915 ms
187,695 ms
tps y compris l'établissement des connexions
58.168112
53.278062
tps excluant l'établissement des connexions
64.084546
58.725846
CPU
24%
28%
Toutes les transactions sont effectuées dans une seule connexion
latence moyenne
6,722 ms
6,342 ms
tps y compris l'établissement des connexions
1587.657278
1576.792883
tps excluant l'établissement des connexions
1588.380574
1577.694766
CPU
17%
21%
Avec de faibles charges, l'impact du SSL est comparable à l'erreur de mesure. Si le volume des données transférées est très important, la situation peut être différente. Si nous établissons une connexion pour chaque transaction (ce qui est rare, car généralement la connexion est partagée entre les utilisateurs), et qu'il y a un grand nombre de connexions/déconnexions, l'impact peut être légèrement plus important. Cela signifie que des risques de réduction de performance peuvent exister, cependant, la différence n'est pas assez significative pour renoncer à la protection.
Notez qu'il y a une grande différence si l'on compare les modes de fonctionnement : vous travaillez dans le cadre d'une seule session ou de différentes sessions. C'est compréhensible : des ressources sont nécessaires pour créer chaque connexion.
Nous avons eu un cas où nous avons connecté Zabbix en mode de confiance, donc sans vérifier md5, l'authentification n'était pas nécessaire. Ensuite, le client a demandé d'activer le mode d'authentification md5. Cela a provoqué une charge importante sur le CPU, et la performance a chuté. Nous avons cherché des solutions d'optimisation. Une des solutions potentielles au problème est de mettre en place une restriction réseau, de créer des VLAN distincts pour la base de données, d'ajouter des paramètres pour savoir qui se connecte et d'où, et de supprimer l'authentification. Il est également possible d'optimiser les paramètres d'authentification pour réduire les coûts lors de l'activation de l'authentification, mais dans l'ensemble, l'utilisation de différentes méthodes d'authentification affecte la performance et nécessite de prendre en compte ces facteurs lors de la conception de la puissance de calcul des serveurs (hardware) pour la base de données.
Conclusion : dans certaines solutions, même de petits détails sur l'authentification peuvent avoir un impact significatif sur le projet, et il est regrettable que cela ne devienne apparent qu'à la mise en production.
Audit des actions
L'audit peut ne pas concerner uniquement la base de données. L'audit consiste à obtenir des informations sur ce qui se passe dans différents segments. Cela peut être un pare-feu de base de données ou le système d'exploitation sur lequel la base de données est construite.
Dans les bases de données commerciales de niveau Enterprise, l'audit fonctionne bien, tandis que dans les solutions open source, ce n'est pas toujours le cas. Voici ce qui est disponible dans PostgreSQL :
- journal par défaut — journalisation intégrée ;
- extensions : pgaudit — si la journalisation par défaut ne suffit pas, vous pouvez utiliser des paramètres spécifiques qui répondent à certaines tâches.
Complément au rapport dans la vidéo :
«L'enregistrement de base des opérateurs peut être effectué avec un outil de journalisation standard en définissant log_statement = all.
Ceci est acceptable pour le suivi et d'autres types d'utilisation, mais cela ne fournit pas le niveau de détail généralement nécessaire pour un audit.
Il ne suffit pas d'avoir une liste de toutes les opérations effectuées sur la base de données.
Il doit également être possible de retrouver des déclarations spécifiques qui intéressent l'auditeur.
L'outil de journalisation standard montre ce que l'utilisateur a demandé, tandis que pgAudit se concentre sur les détails de ce qui s'est passé lorsque la base de données exécutait la requête.
Par exemple, l'auditeur peut vouloir s'assurer qu'une table spécifique a été créée dans une fenêtre de maintenance documentée.
Cela peut sembler une tâche simple pour un audit de base et grep, mais que faire si vous vous retrouvez avec quelque chose comme cet exemple (délibérément déroutant) :
DO $$
BEGIN
EXECUTE 'CREATE TABLE import' || 'ant_table (id INT)';
END $$;
La journalisation standard vous donnera ceci :
LOG: instruction : DO $$
BEGIN
EXECUTE 'CREATE TABLE import' || 'ant_table (id INT)';
END $$;
Il semble que pour trouver la table d'intérêt, une certaine connaissance du code sera nécessaire dans les cas où les tables sont créées dynamiquement.
Ce n'est pas idéal, car il serait préférable de rechercher simplement par nom de table.
C'est là que pgAudit sera utile.
Pour la même entrée, il produira cette sortie dans le journal :
AUDIT: SESSION,33,1,FONCTION,DO,,,«DO $$
BEGIN
EXECUTE 'CREATE TABLE import' || 'ant_table (id INT)';
END $$;"
AUDIT: SESSION,33,2,DDL,CREATE TABLE,TABLE,public.important_table,CREATE TABLE important_table (id INT)
Non seulement le bloc DO est enregistré, mais également le texte complet de CREATE TABLE avec le type d'instruction, le type d'objet et le nom complet, ce qui facilite la recherche.
Lors de la journalisation des instructions SELECT et DML, pgAudit peut être configuré pour enregistrer une entrée distincte pour chaque relation référencée dans l'instruction.
Aucun parsing n'est nécessaire pour trouver toutes les instructions concernant une table spécifique ()».
Quel impact cela aura-t-il sur les performances de la base de données?
Faisons des tests avec l'activation de l'audit complet et voyons ce que cela donnera sur la performance de PostgreSQL. Nous activerons la journalisation maximale de la base de données pour tous les paramètres.
Dans le fichier de configuration, nous ne changeons presque rien, l'important étant d'activer le mode debug5 pour obtenir un maximum d'informations.
postgresql.conf
log_destination = 'stderr'
logging_collector = on
log_truncate_on_rotation = on
log_rotation_age = 1d
log_rotation_size = 10MB
log_min_messages = debug5
log_min_error_statement = debug5
log_min_duration_statement = 0
debug_print_parse = on
debug_print_rewritten = on
debug_print_plan = on
debug_pretty_print = on
log_checkpoints = on
log_connections = on
log_disconnections = on
log_duration = on
log_hostname = on
log_lock_waits = on
log_replication_commands = on
log_temp_files = 0
log_timezone = 'Europe/Moscow'
Sur la base de données PostgreSQL avec les paramètres 1 CPU, 2,8 GHz, 2 Go de RAM, 40 Go de HDD, nous réalisons trois tests de charge, en utilisant les commandes :
$ pgbench -p 3389 -U postgres -i -s 150 benchmark
$ pgbench -p 3389 -U postgres -c 50 -j 2 -P 60 -T 600 benchmark
$ pgbench -p 3389 -U postgres -c 150 -j 2 -P 60 -T 600 benchmark
Résultats des tests :
Sans journalisation
Avec journalisation
Temps total de remplissage de la base de données
43,74 s
53,23 s
RAM
24%
40%
CPU
72%
91%
Test 1 (50 connexions)
Nombre de transactions en 10 minutes
74169
32445
Transactions/s
123
54
Délai moyen
405 ms
925 ms
Test 2 (150 connexions sur 100 possibles)
Nombre de transactions en 10 minutes
81727
31429
Transactions/s
136
52
Délai moyen
550 ms
1432 ms
Concernant les tailles
Taille de la base de données
2251 Mo
2262 Mo
Taille des journaux de la base de données
0 Mo
4587 Mo
En fin de compte : un audit complet n'est pas très bénéfique. Les données provenant de l'audit vont avoir un volume équivalent à celui des données dans la base de données elle-même, voire plus. Ce volume de journalisation généré lors de l'utilisation de la base de données est un problème courant en production.
Regardons d'autres paramètres :
- La vitesse ne change pas beaucoup : sans journalisation — 43,74 s, avec journalisation — 53,23 s.
- Les performances en RAM et CPU vont diminuer, car un fichier d'audit doit être créé. Cela est également visible en production.
Avec l'augmentation du nombre de connexions, il est évident que les indicateurs vont légèrement se dégrader.
Dans les entreprises, l'audit est encore plus complexe :
- il y a beaucoup de données ;
- l'audit est nécessaire non seulement via syslog dans SIEM, mais aussi dans des fichiers : au cas où il y aurait un problème avec syslog, un fichier proche de la base doit enregistrer les données ;
- pour l'audit, un espace de stockage séparé est nécessaire, afin de ne pas surcharger les disques I/O, car cela prend beaucoup de place ;
- il arrive que les employés en charge de la sécurité de l'information exigent des normes de conformité, comme GOST, pour une identification conforme.
Restriction d'accès aux données
Examinons les technologies utilisées pour protéger les données et y accéder dans les bases de données commerciales et open source.
Qu'est-ce qui peut être utilisé en général :
- Chiffrement et obfuscation des procédures et fonctions (Wrapping) — c'est-à-dire des outils distincts qui rendent le code lisible illisible. Cependant, il ne peut pas être modifié ou refactorisé en arrière. Cette approche est parfois nécessaire, au minimum, du côté de la base de données — la logique des restrictions de licence ou la logique d'autorisation est chiffrée précisément au niveau des procédures et fonctions.
- La restriction de visibilité des données par ligne (RLS) signifie que différents utilisateurs voient la même table, mais avec des lignes différentes, c'est-à-dire que certaines informations ne peuvent pas être affichées au niveau des lignes pour certains utilisateurs.
- L'édition des données affichées (Masking) consiste à faire en sorte que les utilisateurs d'une colonne de la table voient soit les données, soit uniquement des étoiles. Ainsi, pour certains utilisateurs, l'information sera masquée. La technologie détermine quelles informations montrer à quel utilisateur en fonction de son niveau d'accès.
- La séparation des accès Security DBA/Application DBA/DBA concerne principalement la restriction d'accès à la base de données elle-même, ce qui permet de séparer les employés de la sécurité des administrateurs de bases de données et des administrateurs d'applications. Dans les solutions open source, il existe peu de technologies, alors qu'il y en a beaucoup dans les bases de données commerciales. Elles sont nécessaires lorsqu'il y a de nombreux utilisateurs ayant accès aux serveurs en question.
- Restriction d'accès aux fichiers au niveau du système de fichiers. Il est possible de délivrer des droits, des privilèges d'accès à des répertoires, de sorte que chaque administrateur n'ait accès qu'aux données nécessaires.
- L'accès mandaté et le nettoyage de la mémoire sont des technologies rarement mises en œuvre.
- Le chiffrement de bout en bout des bases de données signifie le chiffrement côté client avec gestion des clés côté serveur.
- Chiffrement des données. Par exemple, le chiffrement au niveau des colonnes consiste à utiliser un mécanisme qui chiffre une colonne spécifique de la base.
Comment cela impacte-t-il les performances de la base de données ?
Prenons l'exemple du chiffrement par colonne dans PostgreSQL. Il existe un module pgcrypto, qui permet de stocker des champs sélectionnés sous forme chiffrée. Cela est utile lorsque seule la valeur de certaines données est importante. Pour lire des champs chiffrés, le client transmet la clé de déchiffrement, le serveur déchiffre les données et les renvoie au client. Sans clé, personne ne peut agir sur vos données.
Nous allons effectuer un test avec pgcrypto.. Créons une table avec des données chiffrées et une autre avec des données normales. Ci-dessous les commandes pour créer les tables, la toute première ligne contient une commande utile : la création de l'extension avec l'enregistrement de la base de données :
CREATE EXTENSION pgcrypto;
CREATE TABLE t1 (id integer, text1 text, text2 text);
CREATE TABLE t2 (id integer, text1 bytea, text2 bytea);
INSERT INTO t1 (id, text1, text2)
VALUES (generate_series(1,10000000), generate_series(1,10000000)::text, generate_series(1,10000000)::text);
INSERT INTO t2 (id, text1, text2) VALUES (
generate_series(1,10000000),
encrypt(cast(generate_series(1,10000000) AS text)::bytea, 'key'::bytea, 'bf'),
encrypt(cast(generate_series(1,10000000) AS text)::bytea, 'key'::bytea, 'bf'));
Ensuite, nous allons essayer de faire une sélection de données dans chaque table et observer les temps d'exécution.
Sélection de la table sans fonction de chiffrement:
psql -c "timing" -c "select * from t1 limit 1000;" "host=192.168.220.129 dbname=taskdb
user=postgres sslmode=disable" > 1.txt
Le chronomètre est lancé.
id | text1 | text2
——+——-+——-
1 | 1 | 1
2 | 2 | 2
3 | 3 | 3
…
997 | 997 | 997
998 | 998 | 998
999 | 999 | 999
1000 | 1000 | 1000
(1000 lignes)
Temps : 1,386 ms
Sélection de la table avec fonction de chiffrement :
psql -c "timing" -c "select id, decrypt(text1, 'key'::bytea, 'bf'),
decrypt(text2, 'key'::bytea, 'bf') from t2 limit 1000;"
"host=192.168.220.129 dbname=taskdb user=postgres sslmode=disable" > 2.txt
Le chronomètre est lancé.
id | decrypt | decrypt
——+—————+————
1 | x31 | x31
2 | x32 | x32
3 | x33 | x33
…
999 | x393939 | x393939
1000 | x31303030 | x31303030
(1000 lignes)
Temps : 50,203 ms
Résultats des tests:
Sans chiffrement
Pgcrypto (déchiffrer)
Sélection de 1000 lignes
1,386 ms
50,203 ms
CPU
15%
35%
RAM
+5%
Le chiffrement impacte fortement la performance. On remarque que le temps a augmenté, car les opérations de déchiffrement des données chiffrées (et le déchiffrement est généralement entouré par votre logique) nécessitent des ressources considérables. Donc, l'idée de chiffrer toutes les colonnes contenant des données peut entraîner une baisse de performance.
Cependant, le chiffrement n'est pas une solution miracle résolvant tous les problèmes. Les données déchiffrées et la clé de déchiffrement, lors du déchiffrement et du transfert des données, se trouvent sur le serveur. Par conséquent, les clés peuvent être interceptées par quiconque a un accès complet au serveur de base de données, comme un administrateur système.
Quand une clé est utilisée pour toute une colonne pour tous les utilisateurs (même si ce n'est pas pour tous, mais pour un ensemble restreint de clients), ce n'est pas toujours une bonne chose. C'est pourquoi on a commencé à mettre en place un chiffrement de bout en bout, des options de chiffrement des données du côté client et serveur ont été étudiées dans les SGBD, et on voit apparaître ces fameux systèmes de gestion de clés — des produits séparés qui assurent la gestion des clés du côté du SGBD.

Moyens de sécurité dans les SGBD commerciaux et open source
Fonctions
Type
Politique de mot de passe
Audit
Protection du code source des procédures et fonctions
RLS
Chiffrement
Oracle
Commercial
+
+
+
+
+
MsSql
Commercial
+
+
+
+
+
Commercial
+
+
+
+
extensions
PostgreSQL
Gratuit
extensions
extensions
—
+
extensions
MongoDb
Gratuit
—
+
—
—
Disponible uniquement dans MongoDB Enterprise
Le tableau n'est pas du tout complet, mais la situation est la suivante : dans les produits commerciaux, les questions de sécurité sont traitées depuis longtemps, tandis que dans l'open source, on utilise généralement des surcouches pour la sécurité, manquant souvent de nombreuses fonctionnalités et devant parfois ajouter des éléments. Par exemple, les politiques de mots de passe — dans PostgreSQL, il existe de nombreuses extensions différentes (, , , , ), qui mettent en œuvre des politiques de mot de passe, mais à mon avis, aucun ne couvre tous les besoins du segment d'entreprise local.
Que faire si rien de ce qu'il faut n'est disponible ?? Например, хочется использовать определенную СУБД, в которой нет функций, которые требует заказчик.
On peut alors utiliser des solutions tierces qui fonctionnent avec différentes SGBD, comme « Crypto DB » ou « Garda DB ». En ce qui concerne les solutions du segment local, ils connaissent mieux les normes GOST que dans l'open source.
La deuxième option consiste à écrire soi-même ce dont vous avez besoin, à mettre en œuvre l'accès aux données et le chiffrement au niveau des procédures dans l'application. Cependant, cela sera plus compliqué avec GOST. Mais dans l'ensemble, vous pouvez masquer les données comme il se doit, les stocker dans la SGBD, puis les récupérer et les déchiffrer comme nécessaire, directement au niveau de l'application. Pensez dès le début à la façon dont vous allez protéger ces algorithmes dans l'application. À notre avis, cela doit être fait au niveau de la SGBD, car cela fonctionnera plus rapidement.
Cette présentation a été prononcée pour la première fois à par Mail.ru Cloud Solutions. Voird'autres présentations et abonnez-vous aux annonces des événements sur Telegram. .
Suggestions de lecture supplémentaires:
- .
- .
Source : habr.com
