

Chez Citymobil, nous utilisons la base de données MySQL comme principal stockage des données permanentes. Nous avons plusieurs clusters de bases de données pour différents services et objectifs.
La disponibilité continue du maître est un indicateur critique de la fonctionnalité de l'ensemble du système et de ses différentes parties. La récupération automatique du cluster en cas de panne du maître réduit considérablement le temps de réponse aux incidents et le temps d'arrêt du système. Dans cet article, je vais examiner le schéma de haute disponibilité (HA) du cluster MySQL basé sur et les adresses IP virtuelles (VIP).
Solution HA basée sur VIP
Je vais d'abord expliquer brièvement ce qu'est notre système de stockage de données.
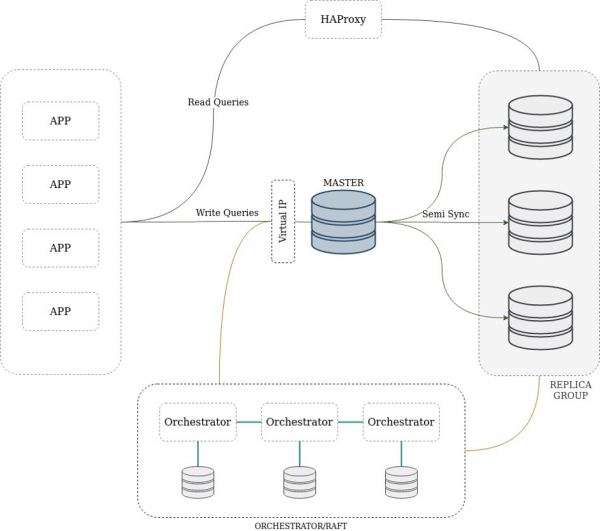
Nous utilisons un schéma classique de réplication avec un seul maître accessible en écriture et de nombreuses répliques utilisées uniquement pour la lecture. Le cluster peut contenir un maître intermédiaire — un nœud qui est à la fois une réplique et un maître pour d'autres. Les clients accèdent aux répliques via HAProxy, ce qui permet de répartir uniformément la charge et de se développer facilement. L'utilisation de HAProxy est due à des raisons historiques, et nous sommes actuellement en train de migrer vers ProxySQL.
La réplication est effectuée en mode semi-synchrone basé sur GTID. Cela signifie qu'au moins une réplique doit enregistrer la transaction dans le journal avant qu'elle ne soit considérée comme réussie. Ce mode de réplication offre un équilibre optimal entre performance et intégrité des données en cas de défaillance du nœud principal. En général, tous les changements sont transmis du maître aux répliques à l'aide de Row Based Replication (RBR), mais certains nœuds peuvent avoir mixed binlog format.
L'orchestrateur met régulièrement à jour l'état de la topologie du cluster, analyse les informations reçues et, en cas de problème, peut déclencher le processus de récupération automatique. Le développeur est responsable de ce processus, car il peut être implémenté de différentes manières : basé sur VIP, DNS, en utilisant des services de découverte ou des mécanismes faits maison.
Un des moyens simples de récupérer le maître en cas de panne est d'utiliser des adresses VIP flottantes.
Voici ce que vous devez savoir sur cette solution avant de continuer :
- Le VIP est une adresse IP qui n'est pas liée à une interface réseau physique spécifique. En cas de défaillance d'un nœud ou lors de travaux planifiés, nous pouvons basculer le VIP sur une autre ressource avec un temps d'arrêt minimal.
- La libération et l'attribution d'une adresse IP virtuelle sont des opérations peu coûteuses et rapides.
- Pour travailler avec un VIP, un accès au serveur par SSH est nécessaire, ou l'utilisation d'outils spécialisés, par exemple,
keepalived.
Examinons les problèmes possibles avec notre maître et envisageons comment le mécanisme de restauration automatique devrait fonctionner.
La connectivité réseau avec le maître est perdue, ou il y a un problème au niveau du matériel, et le serveur est inaccessible.
- L'orchestrateur met à jour la topologie du cluster, chaque réplique signale l'inaccessibilité du maître. L'orchestrateur lance le processus de sélection d'une réplique appropriée pour devenir le nouveau maître et commence la restauration.
- Nous essayons de retirer le VIP de l'ancien maître — sans succès.
- La réplique passe au rôle de maître. La topologie est reconstruite.
- Nous ajoutons une nouvelle interface réseau avec un VIP. Comme nous n'avons pas pu retirer le VIP, nous lançons en arrière-plan l'envoi périodique de requêtes gratuitous ARP. Ce type de requête/réponse permet de mettre à jour la table de correspondance des adresses IP et MAC sur les commutateurs connectés, en avisant ainsi de la relocation de notre VIP. Cela minimise la probabilité de
split brainlors du retour de l'ancien maître. - Toutes les nouvelles connexions sont immédiatement redirigées vers le nouveau maître. Les anciennes connexions échouent, entraînant des reprises d'appels à la base de données au niveau de l'application.
Le serveur fonctionne normalement, il y a eu une défaillance au niveau de la SGBD.
L'algorithme est similaire au cas précédent : mise à jour de la topologie et lancement du processus de restauration. Étant donné que le serveur est accessible, nous libérons avec succès le VIP sur l'ancien maître, le transférons sur le nouveau et envoyons plusieurs requêtes ARP. Le retour possible de l'ancien maître ne doit pas affecter le cluster reconstruit et le fonctionnement de l'application.
Autres problèmes
La défaillance des répliques ou des maîtres intermédiaires ne conduit pas à des actions automatiques et nécessite une intervention manuelle.
L'interface réseau virtuelle est toujours ajoutée temporairement, c'est-à-dire qu'après le redémarrage du serveur, la VIP n'est pas automatiquement attribuée. Chaque instance de la base de données démarre par défaut en mode lecture seule, l'orchestérateur bascule automatiquement le nouveau maître en mode écriture et essaie de définir lecture seule sur l'ancien maître. Ces actions visent à réduire la probabilité split brain.
Des problèmes peuvent survenir lors du processus de récupération, qu'il convient également de signaler via l'interface utilisateur de l'orchestérateur en plus des outils de monitoring standard. Nous avons étendu l'API REST en ajoutant cette possibilité ( est actuellement en cours d'examen).
Le schéma général de la solution HA est présenté ci-dessous.
Choix du nouveau maître
L'orchestérateur est assez intelligent et essaie de choisir comme nouveau maître selon les critères suivants :
- le retard de la réplique par rapport au maître ;
- la version de MySQL du maître et de la réplique ;
- le type de réplication (RBR, SBR ou mixte) ;
- la localisation dans un ou plusieurs centres de données ;
- la présence
GTID errant— transactions qui ont été effectuées sur la réplique et qui sont absentes sur le maître ; - des règles de sélection utilisateur sont également prises en compte.
Chaque réplique n'est pas un candidat idéal pour devenir maître. Par exemple, la réplique peut être utilisée pour des sauvegardes de données, ou le serveur peut avoir une configuration matérielle plus faible. L'orchestérateur permet des règles manuelles grâce auxquelles vous pouvez définir vos préférences de sélection des candidats, des plus préférés aux plus ignorés.
Temps de réponse et de récupération
En cas d'incident, il est important de minimiser le temps d'arrêt du système, nous allons donc examiner les paramètres MySQL qui influent sur la construction et la mise à jour de la topologie du cluster par l'orchestérateur :
- — le nombre de secondes pendant lesquelles la réplique attend la réception de nouvelles données ou d'un signal heartbeat du maître, avant que la connexion ne soit considérée comme perdue et qu'un reconnection soit effectuée. Plus la valeur est faible, plus la réplique sera capable de déterminer rapidement que la connexion avec le maître est rompue. Nous fixons cette valeur à 5 secondes.
- — nombre de secondes entre les tentatives de reconnection. En cas de problèmes réseau, une valeur basse de ce paramètre permettra une reconnexion rapide et évitera le lancement du processus de récupération du cluster. La valeur recommandée est de 1 seconde.
MASTER_RETRY_COUNT— nombre maximal de tentatives de reconnexion.MASTER_HEARTBEAT_PERIOD— intervalle en secondes après lequel le maître envoie un signal de heartbeat. Par défaut, il est égal à la moitié de la valeurslave_net_timeout.
Paramètres de l'orchestre :
DelayMasterPromotionIfSQLThreadNotUpToDate— s'il est égal àtrue, alors le rôle de maître ne sera pas appliqué au réplique candidate tant que le fil SQL de la réplique n'a pas exécuté toutes les transactions non appliquées du Relay Log. Nous utilisons cette option pour ne pas perdre de transactions lors de retards de toutes les répliques candidates.InstancePollSeconds— fréquence de construction et de mise à jour de la topologie.RecoveryPollSeconds— fréquence d'analyse de la topologie. En cas de détection d'un problème, la récupération de la topologie est lancée. C'est, égale à 1 seconde.
Chaque nœud du cluster est interrogé par l'orchestre une fois toutes les InstancePollSeconds secondes. En cas de détection d'un problème, l'état du cluster est forcé, puis une décision finale est prise sur l'exécution de la récupération. En expérimentant avec divers paramètres de BD et d'orchestre, nous avons réussi à réduire la durée de réponse et de récupération à 30 secondes.
Stand de test
Nous avons commencé le test de l'architecture HA par le développement d'un et son déploiement ultérieur dans les environnements de test et de production. L'environnement local est entièrement automatisé sur la base de Docker et permet d'expérimenter avec la configuration de l'orchestre et du réseau, de mettre à l'échelle le cluster de 2-3 serveurs à plusieurs dizaines et de mener des exercices dans un environnement sécurisé.
Lors des exercices, nous choisissons l'une des méthodes d'émulation de problème : tirer instantanément le maître avec kill -9, arrêter le processus en douceur et arrêter le serveur (docker-compose stop), simuler des problèmes de réseau avec iptables -j REJECT ou iptables -j DROP. Nous nous attendons à ces résultats :
- l'orchestre détectera les problèmes avec le maître et mettra à jour la topologie en moins de 10 secondes ;
- la procédure de récupération démarrera automatiquement : la configuration réseau changera, le rôle de maître passera à la réplique, la topologie sera reconstruite ;
- le nouveau maître sera disponible pour l'écriture, les répliques vivantes ne seront pas perdues pendant le processus de reconstruction;
- les données commenceront à être écrites sur le nouveau maître et à être répliquées;
- le temps total de rétablissement sera de 30 secondes maximum.
Comme vous le savez, le système peut se comporter différemment dans les environnements de test et de production en raison de la configuration différente du matériel et du réseau, des variations de charge synthétique et réelle, etc. C'est pourquoi nous organisons périodiquement des exercices en conditions réelles, vérifiant comment le système se comporte en cas de perte de connectivité réseau ou de dégradation de certaines de ses parties. À l'avenir, nous souhaitons construire une infrastructure complètement identique pour les deux environnements et automatiser ses tests.
Conclusions
Le bon fonctionnement du nœud principal du système de stockage de données est l'un des objectifs principaux de l'équipe SRE et des opérations. La mise en œuvre d'un orchestrateur et d'une solution HA basée sur VIP a permis d'obtenir les résultats suivants :
- détection fiable des problèmes de topologie du cluster de bases de données;
- réponse automatique et rapide aux incidents liés au maître, ce qui réduit le temps d'arrêt du système.
Cependant, la solution a ses limites et inconvénients :
- l'évolutivité du schéma HA sur plusieurs centres de données nécessitera la présence d'un réseau L2 unique entre eux;
- avant d'attribuer le VIP au nouveau maître, nous devons le libérer sur l'ancien. Le processus est séquentiel, ce qui augmente le temps de rétablissement;
- libérer le VIP nécessite un accès SSH au serveur, ou tout autre moyen d'appeler des procédures distantes. Étant donné que le serveur ou la base de données rencontre des problèmes ayant entraîné le processus de récupération, nous ne pouvons pas être sûrs que la libération du VIP se déroulera avec succès. Cela pourrait conduire à l'apparition de deux serveurs avec la même adresse IP virtuelle et à des problèmes.
split brain.
Pour éviter split brain, on peut utiliser la méthode (« Shoot The Other Node In The Head »), qui isole ou déconnecte complètement le nœud problématique. Il existe d'autres moyens de mettre en œuvre la haute disponibilité d'un cluster : combinaison de VIP et DNS, découverte de services et services proxy, réplication synchrone et d'autres méthodes, qui ont leurs inconvénients et avantages.
J'ai parlé de notre approche pour créer un cluster MySQL résilient. Il est facile à mettre en œuvre et offre un niveau de fiabilité acceptable dans les conditions actuelles. Au fur et à mesure que l'ensemble du système et l'infrastructure évoluent, cette approche évoluera sans aucun doute.
Source : habr.com
