

De la rédaction du blog Google : Vous êtes-vous déjà demandé comment les ingénieurs de Google Cloud Technical Solutions (TSE) traitent vos demandes d'assistance technique ? Les ingénieurs de l'assistance technique TSE sont chargés d'identifier et de résoudre les problèmes signalés par les utilisateurs. Certains de ces problèmes sont assez simples, mais il arrive parfois qu'une demande nécessite l'attention de plusieurs ingénieurs. Dans cet article, l'un des membres de TSE nous parlera d'un problème particulièrement épineux de sa récente pratique — . Au cours de ce récit, nous verrons comment les ingénieurs ont réussi à résoudre la situation et ce qu'ils ont appris en corrigeant l'erreur. Nous espérons que cette histoire vous éclairera non seulement sur un bogue profondément enraciné, mais vous donnera également un aperçu des processus impliqués lors de la soumission d'une demande d'assistance à Google Cloud.
Le dépannage est à la fois une science et un art. Tout commence par l'élaboration d'une hypothèse sur la cause d'un comportement anormal du système, qui est ensuite mise à l'épreuve. Cependant, avant de formuler une hypothèse, nous devons clairement définir et articuler le problème. Si la question est trop vague, vous devrez l'analyser en profondeur ; c'est là que réside l'« art » du dépannage.
Dans le contexte de Google Cloud, ces processus sont considérablement compliqués, car Google Cloud s'efforce de garantir la confidentialité de ses utilisateurs. De ce fait, les ingénieurs TSE n'ont ni accès pour modifier vos systèmes, ni la possibilité d'examiner les configurations aussi largement que le font les utilisateurs. Par conséquent, pour tester une de nos hypothèses, nous (les ingénieurs) ne pouvons pas modifier rapidement le système.
Certains utilisateurs pensent que nous résoudrons tout comme des mécaniciens dans un garage, et nous envoient simplement l'id de la machine virtuelle, alors qu'en réalité, le processus se déroule sous forme de conversation : collecte d'informations, élaboration et confirmation (ou réfutation) d'hypothèses, et finalement, la résolution du problème repose sur la communication avec le client.
Le problème examiné
Aujourd'hui, nous avons une histoire avec une fin heureuse. L'une des raisons du succès de la résolution de l'affaire proposée réside dans la description très détaillée et précise du problème. Ci-dessous, vous pouvez voir une copie du premier ticket (modifiée pour cacher des informations confidentielles) :
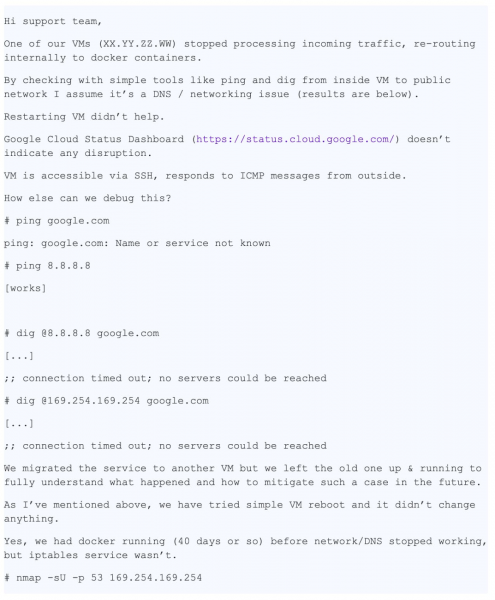
Ce message contient beaucoup d'informations utiles pour nous :
- Une machine virtuelle spécifique a été indiquée
- Le problème lui-même est mentionné — le DNS ne fonctionne pas
- Il est précisé où le problème se manifeste — VM et conteneur
- Les étapes que l'utilisateur a suivies pour identifier le problème sont énumérées
La demande a été enregistrée comme « P1 : Impact Critique — Service Inutilisable en production », ce qui signifie une surveillance continue de la situation 24/7 selon le schéma « Follow the Sun » (vous pouvez lire plus à propos des ), en la transférant d'une équipe de support technique à une autre à chaque changement de fuseau horaire. En gros, au moment où le problème est arrivé à notre équipe à Zurich, il avait déjà fait le tour du globe. D'ici là, l'utilisateur avait pris des mesures pour atténuer les conséquences, mais craignait que la situation ne se reproduise en production, car la cause principale n'avait toujours pas été identifiée.
Au moment où le ticket est arrivé à Zurich, nous avions déjà les informations suivantes :
- Contenu
/etc/hosts - Contenu
/etc/resolv.conf - Sortie
iptables-save - Fichier collecté par l'équipe
ngrepfichier pcap
Avec ces données, nous étions prêts à passer à la phase d'« enquête » et de dépannage.
Nos premiers pas
Tout d'abord, nous avons vérifié les journaux et l'état du serveur de métadonnées et nous nous sommes assurés qu'il fonctionnait correctement. Le serveur de métadonnées répond à l'adresse IP 169.254.169.254 et, entre autres, il est responsable du contrôle des noms de domaine. Nous avons également vérifié que le pare-feu fonctionnait correctement avec la VM et ne bloquait pas les paquets.
C'était un problème étrange : le test nmap a invalidé notre hypothèse principale sur la perte de paquets UDP, donc nous avons mentalement formulé plusieurs autres options et méthodes de vérification :
- Les paquets disparaissent-ils de manière sélective ? => Vérifiez les règles iptables
- N'est-ce pas trop petit ? => Проверить вывод
ip a show - Le problème concerne-t-il uniquement les paquets UDP ou également les TCP ? => Exécuter
dig +tcp - Les paquets générés par dig sont-ils renvoyés ? => Exécuter
tcpdump - Le libdns fonctionne-t-il correctement ? => Exécuter
stracepour tester le transfert des paquets dans les deux sens
À ce stade, nous avons décidé d'appeler l'utilisateur pour dépanner en direct.
Au cours de l'appel, nous parvenons à vérifier plusieurs éléments :
- Après plusieurs vérifications, nous excluons les règles iptables de la liste des causes.
- Nous vérifions les interfaces réseau et les tables de routage, et nous vérifions à nouveau la conformité de la MTU.
- Nous découvrons que
dig +tcp google.comfonctionne comme prévu, maisdig google.com(UDP) ne fonctionne pas. - En exécutant
tcpdumpil fonctionne toujours.dig, nous découvrons que les paquets UDP sont retournés. - Nous exécutons
strace dig google.comet nous voyons comment dig appelle correctementsendmsg()etrecvms(),mais le second échoue par timeout.
Malheureusement, la fin du service arrive et nous devons transmettre le problème au prochain fuseau horaire. Cependant, cette demande a suscité l'intérêt au sein de notre équipe, et un collègue propose de créer un paquet DNS source avec le module Python scrapy.
from scapy.all import *

answer = sr1(IP(dst="169.254.169.254")/UDP(dport=53)/DNS(rd=1,qd=DNSQR(qname="google.com")),verbose=0)
print ("169.254.169.254", answer[DNS].summary())
Ce fragment crée un paquet DNS et envoie une requête au serveur de métadonnées.
L'utilisateur exécute le code, la réponse DNS est renvoyée, et l'application la reçoit, ce qui confirme l'absence de problème au niveau réseau.
Après un nouveau « voyage autour du monde », la demande revient à notre équipe, et je la prends entièrement en charge, pensant qu'il serait plus pratique pour l'utilisateur que la demande ne continue pas à tourner en rond.
Pendant ce temps, l'utilisateur accepte gentiment de fournir une image système. C'est une très bonne nouvelle : la possibilité de tester le système moi-même accélère considérablement le dépannage, car je n'ai plus besoin de demander à l'utilisateur d'exécuter des commandes, de m'envoyer les résultats et de les analyser, je peux tout faire moi-même !
Mes collègues commencent à me jalouser un peu. Au déjeuner, nous discutons de la demande, mais personne n'a d'idée sur ce qui se passe. Heureusement, l'utilisateur lui-même a déjà pris des mesures pour atténuer les conséquences et n'est pas pressé, donc nous avons le temps d'analyser le problème. Et comme nous avons une image, nous pouvons effectuer tous les tests qui nous intéressent. Super !
Revenons un pas en arrière.
L'une des questions les plus populaires lors des entretiens pour un poste d'ingénieur système est : « Que se passe-t-il lorsque vous pinguez ?» Вопрос шикарный, так как кандидату необходимо описать пусть от оболочки до пользовательского пространства, до ядра системы и далее к сети. Я улыбаюсь: иногда вопросы с интервью оказываются полезны и в реальной жизни…
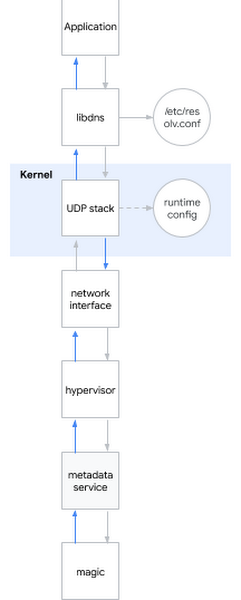
Je décide d'appliquer cette question des ressources humaines au problème actuel. En gros, lorsque vous essayez de résoudre un nom DNS, ce qui se passe est le suivant :
- L'application appelle une bibliothèque système, par exemple libdns
- libdns vérifie la configuration du système pour savoir vers quel serveur DNS elle doit se connecter (sur le diagramme, c'est 169.254.169.254, le serveur de métadonnées)
- libdns utilise des appels système pour créer un socket UDP (SOCK_DGRAM) et transmettre des paquets UDP avec des requêtes DNS dans les deux sens
- Via l'interface sysctl, il est possible de configurer la pile UDP au niveau du noyau
- Le noyau interagit avec le matériel pour transmettre des paquets sur le réseau via l'interface réseau
- L'hyperviseur intercepte et transmet le paquet au serveur de métadonnées lors d'un contact
- Le serveur de métadonnées détermine le nom DNS avec sa magie et renvoie une réponse de la même manière
Rappelons quelles hypothèses nous avons déjà examinées :
Hypothèse : Les bibliothèques sont corrompues
- Test 1 : exécuter strace dans le système, vérifier que dig appelle les bonnes fonctions système
- Résultat : les appels système sont corrects
- Test 2 : utiliser srapy pour voir si nous pouvons déterminer des noms en contournant les bibliothèques système
- Résultat : nous le pouvons
- Test 3 : exécuter rpm -V sur le paquet libdns et md5sum des fichiers de la bibliothèque
- Résultat : le code de la bibliothèque est totalement identique à celui dans le système d'exploitation fonctionnel
- Test 4 : monter l'image du système racine de l'utilisateur sur une VM sans ce comportement, exécuter chroot, voir si DNS fonctionne
- Résultat : DNS fonctionne correctement
Conclusion basée sur les tests : le problème n'est pas dans les bibliothèques
Hypothèse : Une erreur dans les réglages DNS est présente
- Test 1 : vérifier tcpdump et observer si les paquets DNS sont correctement envoyés et retournés après le lancement de dig
- Résultat : les paquets sont correctement transmis
- Test 2 : vérifier à nouveau sur le serveur
/etc/nsswitch.confet/etc/resolv.conf - Résultat : tout est correct
Conclusion basée sur les tests : le problème n'est pas dans la configuration DNS
Hypothèse : le noyau est endommagé
- Test : installer un nouveau noyau, vérifier la signature, redémarrer
- Résultat : comportement similaire
Conclusion basée sur les tests : le noyau n'est pas endommagé
Hypothèse : comportement incorrect du réseau utilisateur (ou de l'interface réseau de l'hyperviseur)
- Test 1 : vérifier les paramètres du pare-feu
- Résultat : le pare-feu laisse passer les paquets DNS à la fois sur l'hôte et sur GCP
- Test 2 : intercepter le trafic et suivre la bonne transmission et le retour des requêtes DNS
- Résultat : tcpdump confirme la réception des paquets de réponse par l'hôte
Conclusion basée sur les tests : le problème n'est pas dans le réseau
Hypothèse : le serveur de métadonnées ne fonctionne pas
- Test 1 : vérifier les journaux du serveur de métadonnées pour des anomalies
- Résultat : il n'y a pas d'anomalies dans les journaux
- Test 2 : contourner le serveur de métadonnées via
dig @8.8.8.8 - Résultat : la résolution échoue même sans utiliser le serveur de métadonnées
Conclusion basée sur les tests : le problème ne vient pas du serveur de métadonnées
Résultat : nous avons testé tous les sous-systèmes sauf les paramètres d'exécution !
Plongée dans les paramètres d'exécution du noyau
Pour configurer le noyau, vous pouvez utiliser les options de la ligne de commande (grub) ou l'interface sysctl. J'ai jeté un œil à /etc/sysctl.conf et imaginez, j'ai découvert plusieurs paramètres personnalisés. Sentant que j'avais attrapé quelque chose, j'ai éliminé tous les paramètres non réseau ou non-tcp, me laissant avec une poignée de paramètres net.core. Ensuite, je me suis dirigé là où les VM ont les autorisations d'hôte et j'ai commencé à appliquer les réglages d'une à une depuis la VM cassée, jusqu'à ce que je tombe sur le coupable :
net.core.rmem_default = 2147483647Voilà, la configuration DNS qui casse tout ! J'ai trouvé l'outil du crime. Mais pourquoi cela se produit-il ? J'avais encore besoin d'un mobile.
La configuration de la taille de base des paquets DNS se fait via net.core.rmem_default. La valeur typique varie autour de 200 Ko, cependant, si votre serveur reçoit de nombreux paquets DNS, vous pouvez augmenter la taille du tampon. Si au moment de l'arrivée d'un nouveau paquet, le tampon est plein, par exemple parce que l'application ne le traite pas assez rapidement, vous commencerez à perdre des paquets. Notre client a bien fait d'augmenter la taille du tampon car il craignait des pertes de données, étant donné qu'il utilisait une application de collecte de métriques via des paquets DNS. La valeur qu'il a définie était la maximale possible : 231-1 (si vous définissez 231, le noyau retourne « ARGUMENT INVALID »).
Tout à coup, j'ai réalisé pourquoi nmap et scapy fonctionnaient correctement : ils utilisaient des sockets bruts ! Les sockets bruts diffèrent des sockets normaux : ils contournent iptables et ne sont pas mis en mémoire tampon !
Mais pourquoi un « tampon trop grand » pose-t-il des problèmes ? Cela ne fonctionne manifestement pas comme prévu.
À ce stade, j'ai pu reproduire le problème sur plusieurs noyaux et de nombreuses distributions. Le problème se manifestait déjà sur le noyau 3.x et se manifestait maintenant aussi sur le noyau 5.x.
En effet, en exécutant
sysctl -w net.core.rmem_default=$((2**31-1))le DNS cessait de fonctionner.
J'ai commencé à rechercher des valeurs opérationnelles à l'aide d'un simple algorithme de recherche binaire et j'ai découvert qu'avec 2147481343, le système fonctionnait. Cependant, ce nombre était pour moi une suite de chiffres sans signification. J'ai suggéré au client d'essayer ce nombre, et il a répondu que le système fonctionnait avec google.com, mais qu'il continuait à donner une erreur avec d'autres domaines. J'ai donc poursuivi mon enquête.
J'ai installé , un outil que j'aurais dû utiliser plus tôt : il montre précisément où un paquet entre dans le noyau. La fonction udp_queue_rcv_skbétait en cause. J'ai téléchargé le code source du noyau et ajouté quelques pour suivre où le paquet pénètre exactement. J'ai rapidement découvert la condition nécessaire, et pendant un certain temps, je l'ai simplement regardée, car c'est alors que tout a enfin pris sens : 231-1, un nombre sans signification, un domaine non fonctionnel... Le problème était un morceau de code dans if__udp_enqueue_schedule_skb if (rmem > (size + sk->sk_rcvbuf)) goto uncharge_drop;:
Notez quermem
est de type intest de type u16 (int non signé de 16 bits) et stocke la taille du paquettaillesk->sk_rcybufest de type int et stocke la taille du tampon qui est selon la définition égale à la valeur danssk_rcvbufnet.core.rmem_default
Lorsque approche 231, la somme de la taille du paquet peut entraîner un débordement entier L'erreur est corrigée de manière triviale : en la castant en ).
. J'ai appliqué le correctif et redémarré le système, après quoi le DNS a de nouveau fonctionné. unsigned intLe goût de la victoire
J'ai envoyé mes découvertes au client et envoyé le
patch du noyau à la LKML. Je suis satisfait : chaque pièce du puzzle s'est assemblée en un tout, je peux expliquer exactement pourquoi nous avons observé ce que nous avons observé, et surtout, nous avons pu trouver une solution au problème grâce à notre collaboration ! De l'éditeur du blog Google : Avez-vous déjà été curieux de savoir comment les ingénieurs des solutions techniques Google Cloud (TSE) traitent vos demandes au support technique ?
🥇Histoire des paquets DNS manquants du support Google Cloud | ProHoster
Source : habr.com
