

Si vous êtes comme la plupart des gens, vous utilisez probablement des ressources fonctionnant en dehors de votre cluster. Vous pourriez utiliser l'API Taleo pour envoyer des messages texte ou analyser des images à l'aide de l'API Google Cloud Vision.
Si vous utilisez le même point d'extrémité endpoint — le point de réception des requêtes côté serveur dans tous vos environnements et que vous ne prévoyez pas de déplacer vos serveurs vers Kubernetes, il est tout à fait normal d'avoir le endpoint du service directement dans votre code. Cependant, il existe de nombreux autres scénarios possibles. Dans cette série « Meilleures pratiques Kubernetes », vous apprendrez à utiliser les mécanismes intégrés de Kubernetes pour la découverte de services à la fois à l'intérieur et à l'extérieur du cluster.
Un exemple courant de service externe serait une base de données fonctionnant en dehors du cluster Kubernetes. Contrairement à des bases de données cloud comme Google Cloud Data Store ou Google Cloud Spanner, qui utilisent un point d'extrémité unique pour tous les types d'accès, la plupart des bases de données ont des points d'extrémité distincts pour différentes situations.
Une bonne pratique pour l'utilisation de bases de données traditionnelles comme MySQL et MongoDB consiste généralement à se connecter à différents composants pour différents environnements. Vous pouvez avoir une machine plus grande pour les données de production et une machine plus petite pour l'environnement de test. Chacune d'elles aura sa propre adresse IP ou nom de domaine, mais vous ne voudrez certainement pas modifier votre code en passant d'un environnement à l'autre. Donc, au lieu de coder en dur ces adresses, vous pouvez utiliser le service intégré de Kubernetes pour découvrir des services externes via DNS, tout comme pour les services Kubernetes natifs.
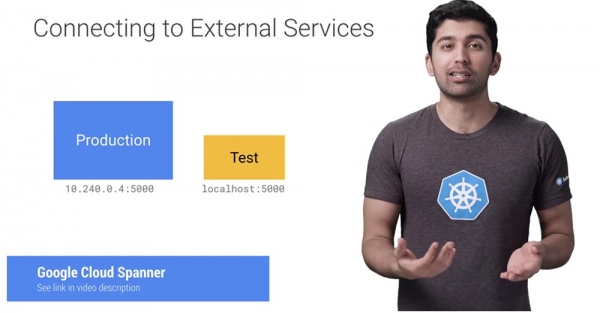
Supposons que vous exécutiez une base de données MongoDB sur Google Compute Engine. Vous serez bloqué dans ce monde hybride jusqu'à ce que vous parveniez à la transférer dans un cluster.
Heureusement, vous pouvez utiliser des services statiques Kubernetes pour vous faciliter un peu la vie. Dans cet exemple, j'ai créé un serveur MongoDB en utilisant Google Cloud Launcher. Puisqu'il est situé dans le même réseau (ou VPC du cluster Kubernetes), l'accès se fait via une adresse IP interne haute performance.
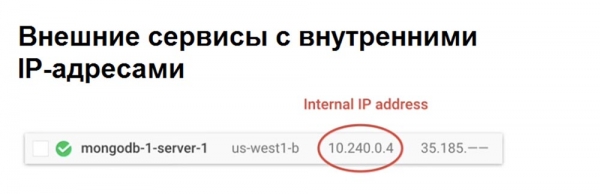
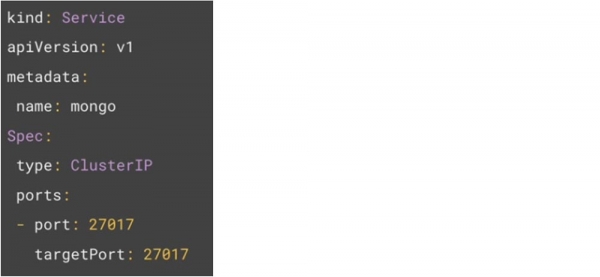
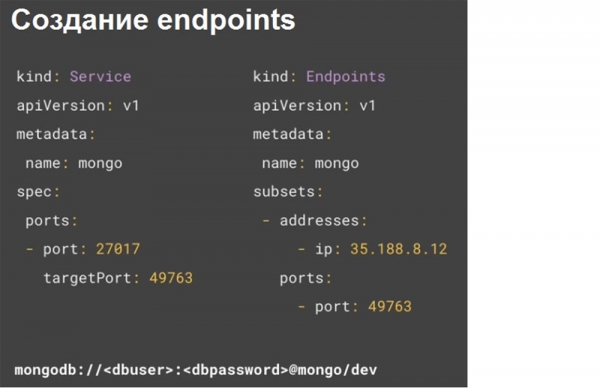
Dans Google Cloud, c'est la configuration par défaut, donc vous n'avez rien à configurer. Maintenant que vous avez une adresse IP, la première étape consiste à créer un service. Vous remarquerez qu'il n'y a pas de sélecteurs de pods pour ce service. En d'autres termes, nous avons créé un service qui ne saura pas où envoyer le trafic. Cela permettra de créer manuellement un objet endpoint qui recevra le trafic de ce service.
L'exemple de code suivant montre que les points de terminaison définissent l'adresse IP pour la base de données, en utilisant le même nom mongo que celui du service.
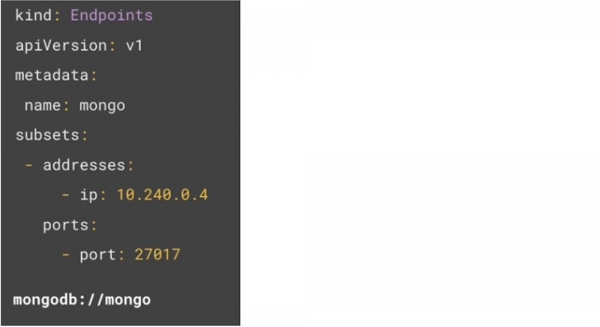
Kubernetes utilisera toutes les adresses IP pour trouver les points de terminaison, comme s'ils étaient des pods Kubernetes ordinaires, donc vous pouvez maintenant accéder à la base de données avec une simple chaîne de connexion au nom mongodb://mongo mentionné ci-dessus. Il n'est pas du tout nécessaire d'utiliser des adresses IP dans votre code.
Si à l'avenir les adresses IP changent, vous pouvez simplement mettre à jour les points de terminaison avec la nouvelle adresse IP, et vos applications n'auront pas besoin d'être modifiées d'une manière ou d'une autre.
Si vous utilisez une base de données hébergée par un tiers, il est probable que les propriétaires de l'hébergement vous aient fourni un identifiant de ressource URI unifié pour la connexion. Donc, si on vous a donné une adresse IP, vous pouvez simplement utiliser la méthode précédente. Cet exemple montre que j'ai deux bases de données MongoDB hébergées sur l'hôte mLab.
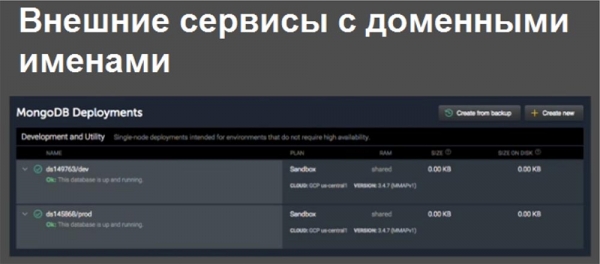
L'une d'elles est la base de données des développeurs, et l'autre est la base de données de production. Les chaînes de connexion pour ces bases de données ressemblent aux suivantes : mLab vous fournit un URI dynamique et un port dynamique. Comme vous pouvez le voir, ils sont différents.
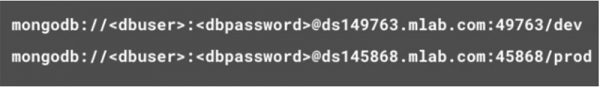
Pour s'abstraire de cela, utilisons Kubernetes et connectons-nous à la base de données des développeurs. Vous pouvez créer un nom de service externe Kubernetes, ce qui vous fournira un service statique qui redirigera le trafic vers le service externe.
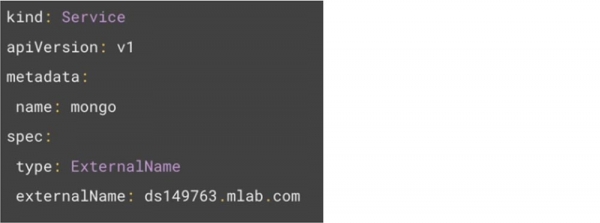
Ce service effectuera une simple redirection CNAME au niveau du noyau, ce qui aura un impact minimal sur les performances. Grâce à cela, vous pouvez utiliser une chaîne de connexion plus simple.

Cependant, comme le nom externe utilise une redirection CNAME, il ne peut pas exécuter de réaffectation de ports. Par conséquent, cette solution ne s'applique qu'aux ports statiques et ne peut pas être utilisée avec des ports dynamiques. Cependant, le niveau gratuit mLab Free Tier attribue par défaut un numéro de port dynamique à l'utilisateur, et vous ne pouvez pas le modifier. Cela signifie que pour dev et prod, vous avez besoin de chaînes de connexion différentes. Le problème est qu'il faudra coder en dur le numéro de port. Alors, comment faire fonctionner la réaffectation des ports ?
La première étape consiste à obtenir l'adresse IP à partir de l'URI. Si vous exécutez la commande nslookup, le nom d'hôte ou un ping sur l'URI, vous pouvez obtenir l'adresse IP de la base de données. Si le service retourne plusieurs adresses IP, toutes ces adresses peuvent être utilisées dans les points de terminaison de l'objet.
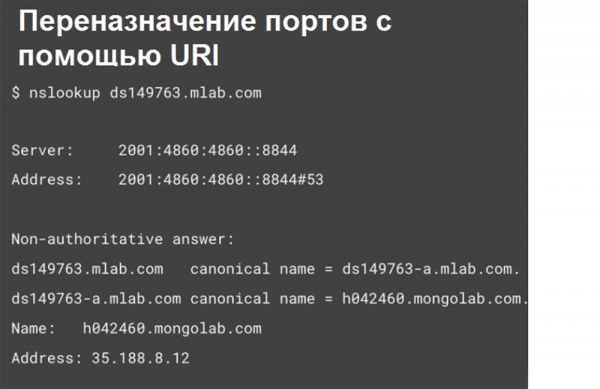
Il est important de se rappeler que les adresses IP des URI peuvent changer sans préavis, il est donc assez risqué de les utiliser en production. Avec une telle adresse IP, vous pouvez vous connecter à une base de données distante sans spécifier le port. Ainsi, le service Kubernetes exécute très efficacement la réaffectation des ports.
Le mapping, ou la correspondance des ressources externes avec les internes, vous permet d'utiliser ces services de manière flexible à l'intérieur du cluster à l'avenir tout en minimisant les efforts de refactoring. Cela facilite également la gestion et offre une compréhension des services externes utilisés par votre entreprise.
La suite arrivera très bientôt…
Un peu de publicité 🙂
Merci de rester avec nous. Aimez-vous nos articles ? Voulez-vous voir plus de contenu intéressant ? Soutenez-nous en passants une commande ou en nous recommandant à des amis, , un équivalent unique des serveurs d'entrée de gamme, conçu pour vous : (options disponibles avec RAID1 et RAID10, jusqu'à 24 cœurs et jusqu'à 40 Go DDR4).
Dell R730xd deux fois moins cher dans le data center Equinix Tier IV à Amsterdam ? Uniquement chez nous aux Pays-Bas ! Dell R420 — 2x E5-2430 2.2GHz 6C 128Go DDR3 2x960Go SSD 1Gbps 100To — à partir de 99 $ ! Lisez sur
Source : habr.com
