

Un élément crucial dans le fonctionnement des systèmes distribués est la gestion des pannes. Kubernetes facilite cela en utilisant des contrôleurs qui surveillent l'état de votre système et redémarrent les services qui ont cessé de fonctionner. Cependant, Kubernetes peut également forcer l'arrêt de vos applications pour garantir la viabilité globale du système. Dans cette série, nous examinerons comment aider Kubernetes à accomplir son travail plus efficacement et à réduire le temps d'arrêt des applications.
Avant l'adoption des conteneurs, la plupart des applications fonctionnaient sur des machines virtuelles ou physiques. Si une application échouait ou se bloquait, il fallait beaucoup de temps pour terminer la tâche en cours et redémarrer le programme. Dans le pire des cas, quelqu'un devait résoudre ce problème manuellement pendant la nuit, à des heures peu pratiques. Si une tâche importante était exécutée sur seulement 1 ou 2 machines, une telle panne était totalement inacceptable.
C'est pourquoi, au lieu d'un redémarrage manuel, on a commencé à utiliser la surveillance au niveau des processus pour redémarrer automatiquement l'application en cas de plantage. Si le programme échouait, le processus de surveillance saisissait le code de sortie et redémarrait le serveur. Avec l'apparition de systèmes comme Kubernetes, ce type de réponse aux pannes a simplement été intégré dans l'infrastructure.
Kubernetes utilise une boucle d'événements « observation – correction des différences – action » pour s'assurer que les ressources restent opérationnelles en passant des conteneurs aux nœuds eux-mêmes.
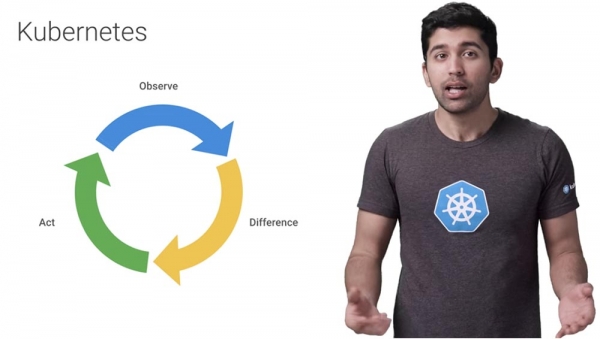
Cela signifie que vous n'avez plus besoin de lancer manuellement la surveillance des processus. Si une ressource échoue à passer le contrôle de santé, Kubernetes lui fournira simplement automatiquement un remplacement. Parallèlement, Kubernetes fait beaucoup plus que simplement surveiller les pannes de vos applications. Il peut créer plus de copies de l'application pour fonctionner sur plusieurs machines, mettre à jour l'application ou exécuter plusieurs versions de votre application en même temps.
Il existe donc de nombreuses raisons pour lesquelles Kubernetes peut interrompre un conteneur parfaitement sain. Par exemple, si vous mettez à jour votre déploiement, Kubernetes arrêtera lentement les anciennes pods tout en lançant de nouvelles. Si vous arrêtez un nœud, Kubernetes mettra fin à tous les pods sur ce nœud. Enfin, si un nœud manque de ressources, Kubernetes désactivera tous les pods pour libérer ces ressources.
Il est donc très important que votre application se termine avec un impact minimal sur l'utilisateur final et un temps de récupération réduit. Cela signifie qu'avant de s'arrêter, elle doit sauvegarder toutes les données nécessaires, fermer toutes les connexions réseau, terminer le travail restant et effectuer d'autres tâches urgentes.
En pratique, cela signifie que votre application doit être capable de gérer le message SIGTERM – le signal d'arrêt du processus qui est le signal par défaut de l'utilitaire kill dans les systèmes d'exploitation de la famille Unix. Lorsqu'elle reçoit ce message, l'application doit s'arrêter.
Après que Kubernetes ait décidé de terminer un pod, une série d'événements se produit. Examinons chaque étape que Kubernetes suit lors de l'arrêt d'un conteneur ou d'un pod.
Supposons que nous voulions terminer l'un des pods. À ce moment-là, il cessera de recevoir un nouveau trafic – les conteneurs en cours d'exécution dans le pod ne seront pas affectés, mais tout nouveau trafic sera bloqué.
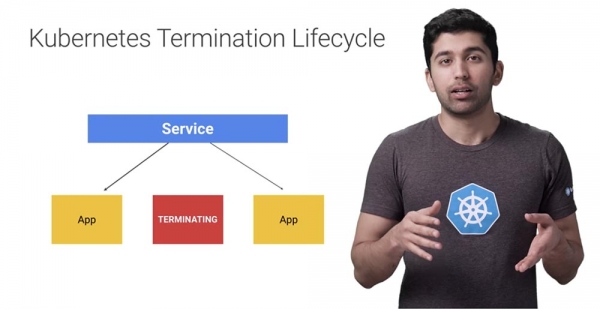
Examinons le hook preStop – c'est une commande spéciale ou une requête HTTP envoyée aux conteneurs dans le pod. Si votre application ne s'arrête pas correctement en recevant SIGTERM, vous pouvez utiliser preStop pour effectuer un arrêt approprié.
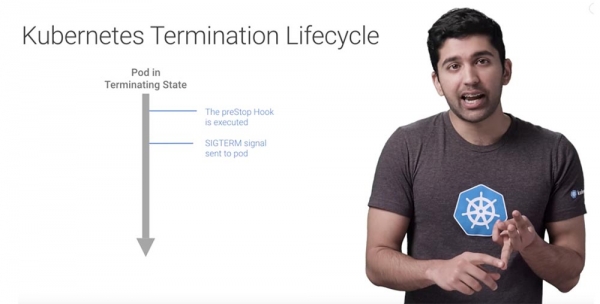
La plupart des programmes terminent correctement leur exécution lorsqu'ils reçoivent le signal SIGTERM, mais si vous utilisez un code tiers ou un système que vous ne pouvez pas contrôler entièrement, le hook preStop est un excellent moyen d'appeler un arrêt élégant sans modifier l'application.
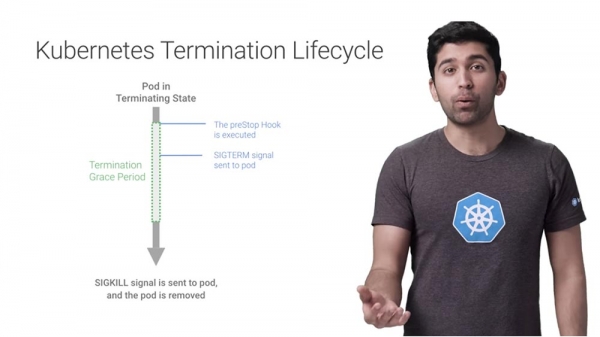
Après l'exécution de ce hook, Kubernetes enverra un signal SIGTERM aux conteneurs du pod, les informant qu'ils vont bientôt être arrêtés. À réception de ce signal, votre code passera au processus de désactivation. Ce processus peut inclure l'arrêt de toute connexion persistante, comme une connexion à une base de données ou un flux WebSocket, la sauvegarde de l'état actuel, etc.
Même si vous utilisez un hook preStop, il est très important de vérifier ce qui se passe dans votre application lorsque vous lui envoyez un signal SIGTERM, comment elle se comporte afin que les événements ou les changements de fonctionnement système entraînés par l'arrêt du pod ne vous surprennent pas.
À ce stade, avant de prendre d'autres mesures, Kubernetes attendra pendant une durée spécifiée, appelée terminationGracePeriodSecond, ou période de désactivation gracieuse à la réception du signal SIGTERM.
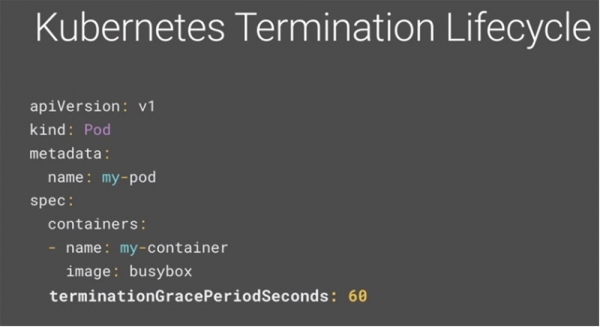
Par défaut, cette période est de 30 secondes. Il est important de noter qu'elle se déroule en parallèle avec le hook preStop et le signal SIGTERM. Kubernetes n'attendra pas la fin du hook preStop et du SIGTERM — si votre application se termine avant la fin de la période de terminationGracePeriod, Kubernetes passera immédiatement à l'étape suivante. Donc, vérifiez que la valeur de cette période en secondes n'est pas inférieure au temps requis pour un arrêt correct du pod, et si elle dépasse 30s, augmentez-la au besoin dans le YAML. Dans l'exemple donné, elle est de 60s.
Enfin, la dernière étape — si les conteneurs continuent de fonctionner après la terminationGracePeriod, ils enverront un signal SIGKILL et seront systématiquement supprimés. À ce moment, Kubernetes nettoiera également tous les autres objets du pod.
Kubernetes arrête les pods pour de nombreuses raisons, donc assurez-vous que dans tous les cas, votre application se termine correctement afin d'assurer le bon fonctionnement du service.
Un peu de publicité 🙂
Merci de rester avec nous. Aimez-vous nos articles ? Voulez-vous voir plus de contenu intéressant ? Soutenez-nous en passants une commande ou en nous recommandant à des amis, , un équivalent unique des serveurs d'entrée de gamme, conçu pour vous : (options disponibles avec RAID1 et RAID10, jusqu'à 24 cœurs et jusqu'à 40 Go DDR4).
Dell R730xd deux fois moins cher dans le data center Equinix Tier IV à Amsterdam ? Uniquement chez nous aux Pays-Bas ! Dell R420 — 2x E5-2430 2.2GHz 6C 128Go DDR3 2x960Go SSD 1Gbps 100To — à partir de 99 $ ! Lisez sur
Source : habr.com
