

Introduction
 «Il faut courir de toutes ses forces juste pour rester au même endroit,
et pour aller quelque part, il faut courir au moins deux fois plus vite !»
(c) Alice au pays des merveilles
Il y a quelque temps, on m'a demandé de donner une conférence aux analystes de notre entreprise sur le thème de la conception de modèles de données, car en restant longtemps sur des projets (parfois plusieurs années), nous perdons de vue ce qui se passe autour dans le monde des technologies de l'information. Dans notre entreprise (les choses sont ainsi faites), de nombreux projets n'utilisent pas de bases de données NoSQL (du moins pour l'instant), c'est pourquoi dans ma conférence, j'y ai consacré une attention particulière en prenant HBase comme exemple et j'ai tenté d'orienter l'exposé vers ceux qui n'ont jamais travaillé avec. En particulier, j'ai illustré certaines caractéristiques de la conception du modèle de données avec un exemple que j'ai lu il y a quelques années . En analysant des exemples, je comparais plusieurs options de solution au même problème pour mieux transmettre aux auditeurs les idées principales.
Récemment, «par manque de mieux» je me suis posé la question (les longs week-ends de mai en mode confinement s'y prêtent particulièrement), à quel point les théorisations seraient-elles conformes à la pratique ? C'est ainsi qu'est née l'idée de cet article. Un développeur qui travaille avec NoSQL depuis un certain temps ne tirera peut-être rien de nouveau (et peut donc tout de suite faire défiler la moitié de l'article). Mais pour les analystes, qui n'ont pas encore beaucoup travaillé avec NoSQL, je pense qu'il sera utile d'obtenir des notions de base sur les spécificités de la conception des modèles de données pour HBase.
Analyse de l'exemple
À mon avis, avant de commencer à utiliser des bases de données NoSQL, il est nécessaire de bien réfléchir et de peser le pour et le contre. Souvent, la tâche peut probablement être résolue avec des SGBD relationnels traditionnels. Il est donc préférable de ne pas utiliser NoSQL sans raisons substantielles. Si la décision d'utiliser une base de données NoSQL a cependant été prise, il convient de noter que les approches de conception sont quelque peu différentes ici. En particulier, certaines peuvent sembler inhabituelles à ceux qui n'ont eu affaire qu'aux SGBD relationnels (selon mes observations). Dans le monde « relationnel », nous commençons généralement par modéliser le domaine concerné et ensuite, si nécessaire, nous effectuons la dénormalisation du modèle. En NoSQL, nous devons immédiatement prendre en compte les scénarios prévus pour le traitement des données et dénormaliser les données dès le départ. En outre, il existe plusieurs autres différences, qui seront expliquées ci-dessous.
Considérons le problème « synthétique » suivant, avec lequel nous allons travailler à l'avenir :
Il est nécessaire de concevoir une structure de stockage pour la liste des amis des utilisateurs d'un réseau social abstrait. Pour simplifier, supposons que tous les liens sont unidirectionnels (comme sur Instagram, et non sur LinkedIn). La structure doit permettre efficacement :
- De répondre à la question de savoir si l'utilisateur A lit l'utilisateur B (schéma de lecture)
- De permettre l'ajout / la suppression des liens en cas d'abonnement / désabonnement de l'utilisateur A à l'utilisateur B (schéma de modification des données)
Bien sûr, il existe de nombreuses façons de résoudre ce problème. Dans une base de données relationnelle classique, nous aurions probablement simplement créé une table de liens (peut-être typée, si, par exemple, il est nécessaire de stocker un groupe d'utilisateurs : famille, travail, etc., auquel ce « ami » appartient), et pour optimiser la vitesse d'accès, nous aurions ajouté des index / du partitionnement. Il est probable que la table finale ressemblerait à ceci :
user_id
friend_id
Vassya
Petya
Vassya
Olya
ici et ci-après, pour des raisons de clarté et de meilleure compréhension, je vais indiquer des noms au lieu d'ID
Dans le cas d'HBase, nous savons que :
- la recherche efficace, sans entraînement de table complète, est possible uniquement par clé
- C'est pourquoi écrire des requêtes SQL familières pour ce type de bases de données est une mauvaise idée ; techniquement, vous pouvez effectivement envoyer une requête SQL avec des joins et d'autres logiques dans HBase à partir d'Impala, mais à quel point cela sera-t-il efficace…
C'est pourquoi nous devons utiliser l'ID de l'utilisateur comme clé. Une première pensée concernant « où et comment stocker les ID des amis ? » peut être l'idée de les stocker dans des colonnes. Cette option est la plus évidente et, disons, « naïve » ressemblera à peu près à cela (appelons-la Option 1 (par défaut), pour y faire référence par la suite) :
RowKey
Colonnes
Vassya
1 : Petya
2 : Olya
3 : Dasha
Petya
1 : Masha
2 : Vasya
Ici, chaque ligne correspond à un utilisateur du réseau. Les colonnes ont des noms : 1, 2, … — correspondant au nombre d’amis, et les ID des amis sont stockés dans les colonnes. Il est important de noter que chaque ligne aura un nombre différent de colonnes. Dans l'exemple ci-dessus, une ligne a trois colonnes (1, 2 et 3), tandis qu'une autre n’en a que deux (1 et 2) — ici nous avons exploité les deux propriétés d'HBase qui n'existent pas dans les bases de données relationnelles :
- la capacité de changer dynamiquement la composition des colonnes (ajouter un ami -> ajouter une colonne, supprimer un ami -> supprimer une colonne)
- des lignes différentes peuvent avoir des compositions de colonnes variées
Vérifions notre structure pour voir si elle répond aux exigences de la tâche :
- Lecture des données: pour comprendre si Vasya est abonné à Olya, nous devrons lire toute la ligne par la clé RowKey = « Vasya » et parcourir les valeurs des colonnes jusqu'à « rencontrer » Olya. Ou parcourir toutes les valeurs des colonnes, « ne pas rencontrer » Olya et renvoyer une réponse False ;
- Modification des données : ajout d'un ami: pour cette tâche, nous devrons également lire toute la ligne par la clé RowKey = « Vasya », afin de compter le nombre total de ses amis. Ce nombre total d'amis est nécessaire pour déterminer le numéro de la colonne où l'ID du nouvel ami doit être écrit.
- Modification des données : suppression d'un ami:
- Il est nécessaire de lire toute la ligne par la clé RowKey = « Vasya » et de parcourir les colonnes pour trouver celle où l'ami supprimé est inscrit ;
- Ensuite, après avoir supprimé un ami, nous devons « décaler » toutes les données d'une colonne afin d'éviter des « ruptures » dans leur numérotation.
Évaluons maintenant dans quelle mesure ces algorithmes que nous devrons mettre en œuvre du côté de « l'application conditionnelle » seront efficaces en utilisant Nous désignerons la taille de notre réseau social hypothétique par n. Alors, le nombre maximal d'amis qu'un utilisateur peut avoir est (n-1). Nous pouvons ignorer ce (-1) pour nos objectifs, car dans le cadre de l'utilisation de la notation O, cela est insignifiant.
- Lecture des données: il est nécessaire de lire toute la ligne et d'examiner toutes ses colonnes en limite. Ainsi, la borne supérieure des coûts sera d'environ O(n).
- Modification des données : ajout d'un ami: pour déterminer le nombre d'amis, il faut parcourir toutes les colonnes de la ligne, puis insérer une nouvelle colonne => O(n).
- Modification des données : suppression d'un ami:
- De même que pour l'ajout – il faut en limite parcourir toutes les colonnes => O(n).
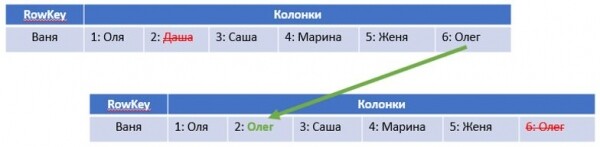
- Après la suppression des colonnes, nous devons les « décaler ». Si nous réalisons cela « de manière directe », il faudra encore jusqu'à (n-1) opérations. Mais ici et par la suite, dans la partie pratique, nous appliquerons une autre approche, qui réalisera un « pseudo-décalage » en un nombre fixe d'opérations – c'est-à-dire qu'il prendra un temps constant, indépendamment de n. Ce temps constant (pour être précis, O(2)) peut être ignoré par rapport à O(n). Cette approche est illustrée sur l'image ci-dessous : nous copions simplement les données de la « dernière » colonne dans celle dont nous devons supprimer les données, puis nous supprimons la dernière colonne :

En tout, dans tous les scénarios, nous avons obtenu une complexité de calcul asymptotique O(n).
Vous avez sûrement remarqué que nous devons presque toujours lire toute la ligne dans la base, et ce, dans deux cas sur trois, juste pour parcourir toutes les colonnes et compter le nombre total d'amis. Par conséquent, pour essayer d'optimiser, nous pouvons ajouter une colonne « count », dans laquelle nous stockons le nombre total d'amis de chaque utilisateur du réseau. Dans ce cas, nous pouvons éviter de lire toute la ligne entièrement pour compter le nombre total d'amis, et lire seulement une colonne « count ». L'essentiel est de ne pas oublier de mettre à jour « count » lors des manipulations de données. Ainsi, nous obtenons une amélioration. Option 2 (count) :
RowKey
Colonnes
Vassya
1 : Petya
2 : Olya
3 : Dasha
count : 3
Petya
1 : Masha
2 : Vasya
count : 2
Comparé à la première option :
- Lecture des données: pour obtenir la réponse à la question « Est-ce que Vasya lit Olya ? » rien n'a changé => O(n).
- Modification des données : ajout d'un ami: Nous avons simplifié l'insertion d'un nouvel ami, car nous n'avons plus besoin de lire toute la ligne et de passer en revue ses colonnes, mais nous pouvons simplement récupérer la valeur de la colonne «count» et ainsi déterminer immédiatement le numéro de colonne pour insérer un nouvel ami. Cela réduit la complexité de calcul à O(1)
- Modification des données : suppression d'un ami: Lors de la suppression d'un ami, nous pouvons également utiliser cette colonne pour réduire le nombre d'opérations d'entrée-sortie lors du «déplacement» des données d'une cellule vers la gauche. Cependant, la nécessité de parcourir les colonnes à la recherche de celle à supprimer demeure, donc => O(n)
- D'autre part, lors de la mise à jour des données, nous devons également mettre à jour la colonne «count» à chaque fois, mais cela prend un temps constant, qui peut être négligé dans le cadre de la notation O.
Dans l'ensemble, l'option 2 semble légèrement plus optimale, mais c'est plutôt une «évolution plutôt qu'une révolution». Pour faire une «révolution», nous aurons besoin de Option 3 (col).
Inversons tout : attribuons à la colonne le nom d'identifiant de l'utilisateur! Ce qui sera enregistré dans la colonne elle-même n'est plus d'importance pour nous, cela peut être le chiffre 1 (en fait, on peut y stocker par exemple un groupe «famille/amis/etc.»). Cette approche peut surprendre un «non-initié» qui n'a pas d'expérience avec des bases de données NoSQL, mais elle permet d'utiliser le potentiel d'HBase dans cette tâche de manière beaucoup plus efficace :
RowKey
Colonnes
Vassya
Petya: 1
Olya: 1
Dasha: 1
Petya
Masha: 1
Vasya: 1
Ici, nous obtenons plusieurs avantages. Pour les comprendre, analysons la nouvelle structure et évaluons la complexité de calcul :
- Lecture des données: pour répondre à la question de savoir si Vasya est abonné à Olya, il suffit de lire une seule colonne «Olya» : si elle existe, la réponse est True, sinon elle est False => O(1)
- Modification des données : ajout d'un ami: Ajout d'un ami : il suffit d'ajouter une nouvelle colonne «ID d'ami» => O(1)
- Modification des données : suppression d'un ami: il suffit de supprimer la colonne «ID d'ami» => O(1)
Comme nous le voyons, un avantage significatif de ce modèle de stockage est que dans tous les scénarios nécessaires, nous n'opérons qu'avec une seule colonne, évitant ainsi d'extraire toute la ligne de la base et encore moins de parcourir toutes les colonnes de cette ligne. Nous pourrions nous arrêter là, mais...
On peut se préoccuper et aller encore un peu plus loin dans l'optimisation des performances et la réduction des opérations d'entrée-sortie lors de l'accès à la base de données. Que se passerait-il si l'on stockait toutes les informations concernant la relation directement dans la clé de la ligne ? C’est-à-dire faire une clé composite de type userID.friendID ? Ainsi, il ne serait même pas nécessaire de lire les colonnes de la ligne.Option 4 (ligne)):
RowKey
Colonnes
Vassia.Petya
Petya: 1
Vassia.Olia
Olya: 1
Vassia.Dasha
Dasha: 1
Petya.Masha
Masha: 1
Petya.Vassia
Vasya: 1
Il est évident que l'évaluation de tous les scénarios de manipulation des données dans cette structure sera également O(1), tout comme dans l'option précédente. La différence avec l'option 3 résidera uniquement dans l'efficacité des opérations d'entrée-sortie dans la base de données.
Et enfin, la dernière "jolie touche". Il est facile de voir qu'avec l'option 4, la clé de la ligne aura une longueur variable, ce qui peut potentiellement affecter les performances (rappelons que HBase stocke les données sous forme d'ensemble d'octets et que les lignes dans les tables sont triées par clé). De plus, nous avons un séparateur qui peut nécessiter un traitement dans certains scénarios. Pour éliminer cet impact, on peut utiliser des hachages de userID et friendID, et comme les deux hachages auront une longueur fixe, on peut simplement les concaténer sans séparateur. Ainsi, les données dans la table apparaîtront comme ceci :Option 5 (hachage)):
RowKey
Colonnes
dc084ef00e94aef49be885f9b01f51c01918fa783851db0dc1f72f83d33a5994
Petya: 1
dc084ef00e94aef49be885f9b01f51c0f06b7714b5ba522c3cf51328b66fe28a
Olya: 1
dc084ef00e94aef49be885f9b01f51c00d2c2e5d69df6b238754f650d56c896a
Dasha: 1
1918fa783851db0dc1f72f83d33a59949ee3309645bd2c0775899fca14f311e1
Masha: 1
1918fa783851db0dc1f72f83d33a5994dc084ef00e94aef49be885f9b01f51c0
Vasya: 1
Il est évident que la complexité algorithmique du travail avec une telle structure, selon les scénarios que nous examinons, sera la même que pour l'option 4 – c'est-à-dire O(1).
En résumé, regroupons toutes nos évaluations de complexité algorithmique dans un tableau :
Ajout d'un ami
Vérification d'ami
Suppression d'ami
Option 1 (par défaut)
O(n)
O(n)
O(n)
Option 2 (compte)
O(1)
O(n)
O(n)
Option 3 (colonne)
O(1)
O(1)
O(1)
Option 4 (ligne)
O(1)
O(1)
O(1)
Option 5 (hachage)
O(1)
O(1)
O(1)
Il est évident que les options 3 à 5 semblent être les plus préférables et théoriquement garantissent l'exécution de tous les scénarios nécessaires de manipulation des données en temps constant. Dans le contexte de notre tâche, il n'y a pas d'exigence explicite pour obtenir la liste de tous les amis de l'utilisateur, mais dans la pratique, en tant que bon analyste, il serait judicieux de "prévoir" qu'une telle tâche pourrait surgir et ainsi "préparer le terrain". C'est pourquoi j'ai une préférence pour l'option 3. Cependant, il est tout à fait possible que dans un projet réel, cette demande ait déjà été résolue par d'autres moyens, donc sans une vue d'ensemble de la tâche, il vaut mieux éviter de tirer des conclusions définitives.
Préparation de l'expérience
Les réflexions théoriques susmentionnées souhaiteraient être vérifiées à la pratique – c'était l'objectif de cette idée née lors de longs week-ends. Pour cela, il est nécessaire d'évaluer la vitesse de fonctionnement de notre "application hypothétique" dans tous les scénarios décrits d'utilisation de la base, ainsi que l'augmentation de ce temps avec la croissance de la taille du réseau social (n). Le paramètre cible qui nous intéresse et que nous allons mesurer au cours de l'expérience est le temps que l'"application hypothétique" met pour exécuter une "opération commerciale". Par "opération commerciale", nous entendons l'une des suivantes :
- Ajout d'un nouvel ami
- Vérification si l'utilisateur A est un ami de l'utilisateur B
- Suppression d'un ami
Ainsi, en tenant compte des exigences définies dans l'énoncé initial, le scénario de vérification se dessine comme suit :
- Enregistrement des données. Générer aléatoirement un réseau de taille n. Pour se rapprocher davantage du "monde réel", le nombre d'amis de chaque utilisateur sera également une variable aléatoire. Mesurer le temps nécessaire à notre "application hypothétique" pour enregistrer toutes les données générées dans HBase. Ensuite, diviser le temps obtenu par le nombre total d'amis ajoutés – ainsi nous obtiendrons le temps moyen pour une "opération commerciale".
- Lecture des données. Pour chaque utilisateur, établir une liste de « personnalités » pour lesquelles il faut vérifier si l'utilisateur est abonné ou non. La longueur de la liste est égale au nombre d'amis de l'utilisateur, la moitié des amis vérifiés devant donner une réponse « Oui », et l'autre moitié « Non ». La vérification doit être effectuée de manière à alterner les réponses « Oui » et « Non » (c'est-à-dire qu'à chaque second cas, nous devrons parcourir toutes les colonnes de la ligne pour les variantes 1 et 2). Le temps total de vérification est ensuite divisé par le nombre d'amis vérifiés pour obtenir le temps moyen de vérification d'un sujet.
- Suppression des données. Supprimer tous les amis de l'utilisateur. L'ordre de suppression doit être aléatoire (c'est-à-dire « mélanger » la liste initiale utilisée pour l'enregistrement des données). Le temps total de vérification est ensuite divisé par le nombre d'amis supprimés pour obtenir le temps moyen de vérification par suppression.
Les scénarios doivent être exécutés pour chacun des 5 modèles de données et pour différentes tailles de réseaux sociaux, afin de voir comment le temps change avec leur croissance. Dans le cadre d'un n relation dans le réseau, la liste des utilisateurs à vérifier doit, évidemment, rester la même pour les 5 modèles.
Pour une meilleure compréhension, voici un exemple de données générées pour n= 5. Le « générateur » écrit produit en sortie trois dictionnaires d'ID :
- le premier – pour l'insertion
- le deuxième – pour la vérification
- le troisième – pour la suppression
{0: [1], 1: [4, 5, 3, 2, 1], 2: [1, 2], 3: [2, 4, 1, 5, 3], 4: [2, 1]} # au total 15 amis

{0: [1, 10800], 1: [5, 10800, 2, 10801, 4, 10802], 2: [1, 10800], 3: [3, 10800, 1, 10801, 5, 10802], 4: [2, 10800]} # au total 18 sujets vérifiés

{0: [1], 1: [1, 3, 2, 5, 4], 2: [1, 2], 3: [4, 1, 2, 3, 5], 4: [1, 2]} # au total 15 amis
Comme on peut le remarquer, tous les ID supérieurs à 10 000 dans le dictionnaire pour la vérification sont justement ceux qui donneront délibérément une réponse False. L'insertion, la vérification et la suppression des « amis » sont effectuées exactement dans l'ordre indiqué dans le dictionnaire.
L'expérience a été réalisée sur un ordinateur portable tournant sous Windows 10, où une base HBase était exécutée dans un conteneur Docker, et un autre conteneur exécutait Python avec Jupyter Notebook. Deux cœurs CPU et 2 Go de mémoire vive ont été alloués au Docker. Toute la logique, tant pour l'émulation du fonctionnement d'une « application conditionnelle » que pour l'« enveloppe » de génération de données de test et de mesure du temps, a été écrite en Python. La bibliothèque utilisée pour travailler avec HBase était , pour le calcul des hachages (MD5) pour l'option 5 — hashlib
En tenant compte de la puissance de calcul du laptop spécifique, il a été expérimentalement choisi de lancer pour n = 10, 30, … 170 – lorsque le temps total d'exécution d'un cycle complet de test (tous les scénarios pour toutes les options pour tous les n) était encore raisonnable et tenait dans la durée d'une tasse de thé (en moyenne 15 minutes).
Il convient de faire une remarque ici, que dans cette expérience nous n'évaluons pas d'abord les chiffres absolus de performance. Même la comparaison relative de deux options différentes peut ne pas être tout à fait correcte. Nous nous intéressons ici spécifiquement à la nature du changement du temps en fonction de n, car compte tenu de la configuration ci-dessus du « banc d'essai », obtenir des estimations temporelles « purgées » de l'influence de facteurs aléatoires et d'autres est très difficile (et de toute façon, cette tâche n'était pas envisagée).
Le résultat de l'expérience
Le premier test – comment change le temps nécessaire pour remplir la liste d'amis. Le résultat – sur le graphique ci-dessous.
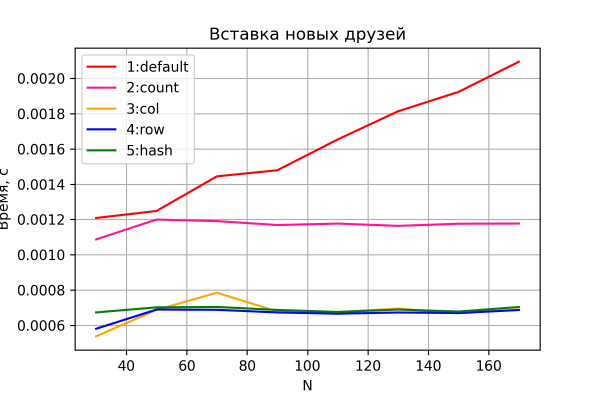
Les options 3-5 montrent comme prévu un temps de « transaction commerciale » pratiquement constant, indépendamment de l'augmentation de la taille du réseau et une différence de performance indiscernable.
L'option 2 montre également une performance constante, mais légèrement inférieure, étant pratiquement deux fois moins performante par rapport aux options 3-5. Cela ne peut que réjouir, car cela correspond à la théorie – dans cette option, le nombre d'opérations d'entrée-sortie dans/en HBase est en effet deux fois plus élevé. Cela peut servir de preuve indirecte que notre banc d'essai fournit en principe une précision acceptable.
L'option 1 s'avère également, comme prévu, la plus lente et présente une augmentation linéaire du temps, proportionnelle à la taille du réseau, pour ajouter un ami.
Voyons maintenant les résultats du deuxième test.
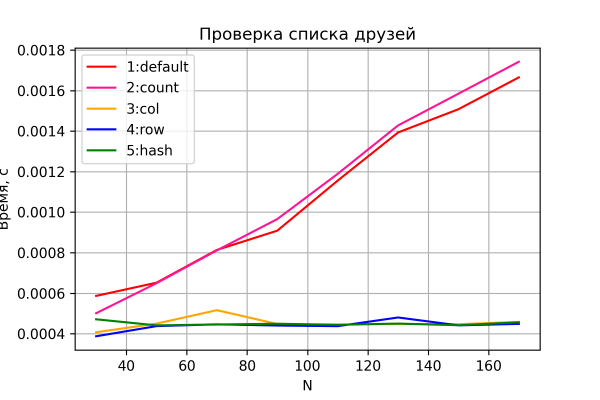
Les options 3-5 se comportent comme prévu – un temps constant, indépendant de la taille du réseau. Les options 1 et 2 montrent une augmentation linéaire du temps avec la taille du réseau et une performance comparable. Notamment, l'option 2 s'avère légèrement plus lente – apparemment en raison de la nécessité de lire et de traiter la colonne supplémentaire « count », ce qui devient plus visible avec l'augmentation de n. Cependant, je préfère ne pas tirer de conclusions, car la précision de cette comparaison est relativement faible. De plus, les relations (quelle option, 1 ou 2, est plus rapide) variaient d'un lancement à l'autre (tout en conservant la nature de la dépendance et "allant nez à nez").
Et enfin, le dernier graphique – le résultat des tests de suppression.
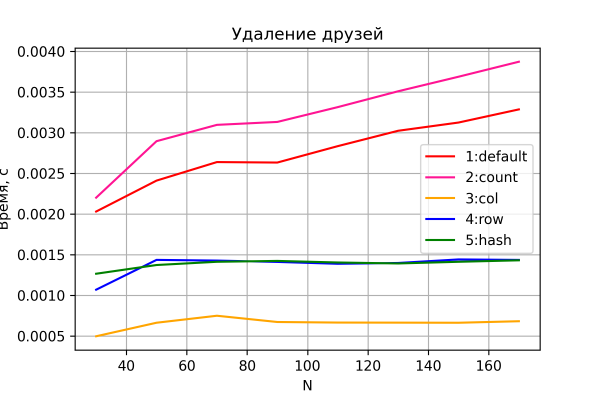
Ici, encore une fois, sans surprises. Les options 3-5 effectuent la suppression en temps constant.
De plus, ce qui est intéressant, c'est que les options 4 et 5, contrairement aux scénarios précédents, montrent une performance légèrement inférieure à celle de l'option 3. Apparemment, l'opération de suppression de lignes est plus coûteuse que l'opération de suppression de colonnes, ce qui est logiquement cohérent.
Les options 1 et 2, comme prévu, montrent une augmentation linéaire du temps. En même temps, l'option 2 est constamment plus lente que l'option 1 – en raison de l'opération d'entrée-sortie supplémentaire pour le "service" de la colonne count.
Conclusions générales de l'expérience :
- Les options 3-5 démontrent une plus grande efficacité, car elles tirent parti des avantages d'HBase ; leur performance varie les unes par rapport aux autres de manière constante et n'est pas affectée par la taille du réseau.
- La différence entre les options 4 et 5 n'a pas été observée. Cela ne signifie pas pour autant que l'option 5 ne doit pas être utilisée. Il est tout à fait probable que le scénario expérimental utilisé, tenant compte des caractéristiques techniques de la plateforme de test, n'ait pas permis de la mettre en évidence.
- La nature de la croissance du temps nécessaire à l'exécution des « opérations commerciales » avec les données a globalement confirmé les hypothèses théoriques obtenues précédemment pour toutes les options.
Épilogue
Les expériences brutales menées ne doivent pas être interprétées comme une vérité absolue. De nombreux facteurs n'ont pas été pris en compte et ont déformé les résultats (ces fluctuations sont particulièrement visibles sur les graphiques avec un petit nombre de nœuds). Par exemple, la vitesse d'exécution de Thrift, utilisée par Happybase, le volume et la façon dont la logique que j'ai écrite en Python a été implémentée (je ne prétends pas que le code est écrit de manière optimale et utilise efficacement toutes les capacités de chaque composant), peut-être les particularités du cache de HBase, l'activité en arrière-plan de Windows 10 sur mon ordinateur portable, etc. Dans l'ensemble, on peut considérer que toutes les conclusions théoriques se sont montrées valables expérimentalement. Du moins, il n'a pas été possible de les réfuter de manière aussi directe.
En conclusion, des recommandations à tous ceux qui commencent à concevoir des modèles de données dans HBase : abstraire de l'expérience passée avec des bases de données relationnelles et garder à l'esprit les « commandements » :
- Lors de la conception, partons de la tâche et des modèles de manipulation des données, et non du modèle du domaine concerné.
- Accès efficace (sans scan complet de la table) – uniquement par clé.
- Dénormalisation.
- Différentes lignes peuvent contenir différentes colonnes.
- Composition dynamique des colonnes.
Source : habr.com
