

Bonjour, Habr ! Ces derniers mois, nous avons vécu une situation très intéressante, et je voudrais partager notre histoire d'extensibilité de l'infrastructure. Pendant ce temps, SberMarket a vu ses commandes quadrupler et a lancé le service dans 17 nouvelles villes. L'explosion de la demande de livraison de produits a nécessité l'extension de notre infrastructure. Lisez ci-dessous pour découvrir les conclusions les plus intéressantes et utiles.
Je m'appelle Dima Bobylev, je suis le directeur technique de SberMarket. Comme c'est le premier article de notre blog, je vais dire quelques mots sur moi et sur l'entreprise. L'automne dernier, j'ai participé à un concours de jeunes leaders de Runet. Pour le concours, j sur la façon dont nous voyons chez SberMarket la culture interne et l'approche au développement du service. Bien que je n'aie pas réussi à gagner le concours, j'ai cependant formulé pour moi les principaux principes de développement de l'écosystème IT.
Lors de la gestion d'une équipe, il est important de comprendre et de trouver un équilibre entre ce dont l'entreprise a besoin et les besoins de chaque développeur spécifique. Actuellement, SberMarket connaît une croissance de 13 fois d'une année sur l'autre, ce qui a un impact sur le produit, nécessitant une augmentation constante des volumes et des cadences de développement. Malgré cela, nous consacrons suffisamment de temps aux développeurs pour une analyse préliminaire et une rédaction de code de qualité. L'approche formulée aide non seulement à créer un produit fonctionnel, mais également à son extensibilité et à son développement ultérieurs. En conséquence de cette croissance, SberMarket est déjà devenu un leader parmi les services de livraison de produits : nous livrons quotidiennement environ 18 000 commandes par jour, alors qu'au début février, il y en avait environ 3 500.
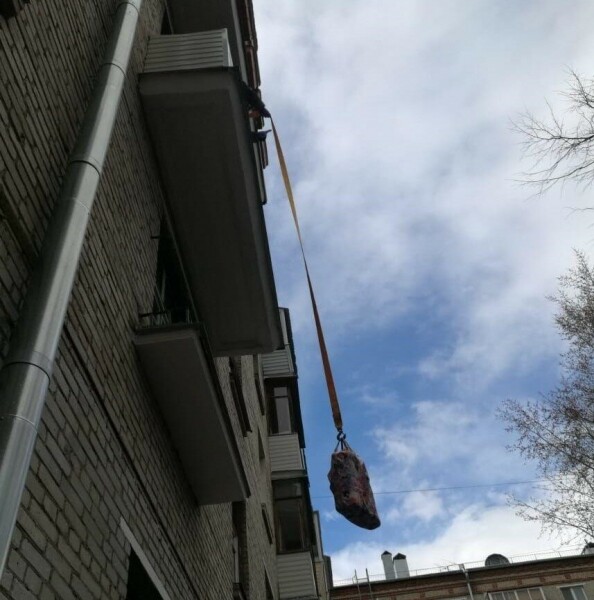
Un jour, un client a demandé à un coursier de SberMarket de lui livrer des produits de manière sans contact — directement sur son balcon.
Mais passons aux choses concrètes. Au cours des derniers mois, nous avons activement travaillé sur l'extension de l'infrastructure de notre entreprise. Ce besoin était dû à des facteurs externes et internes. En parallèle avec l'augmentation de notre base de clients, le nombre de magasins connectés est passé de 90 au début de l'année à plus de 200 à la mi-mai. Bien sûr, nous étions préparés, ayant réservé l'infrastructure principale et prévu la possibilité d'une scalabilité verticale et horizontale de toutes les machines virtuelles hébergées dans le cloud de Yandex. Cependant, la pratique a montré : « Tout ce qui peut mal tourner, tournera mal ». Aujourd'hui, je souhaite partager les situations les plus intéressantes qui se sont produites durant ces semaines. J'espère que notre expérience vous sera utile.
Slave en pleine préparation opérationnelle
Avant même le début de la pandémie, nous avons constaté une augmentation du nombre de demandes sur nos serveurs backend. La tendance à commander des produits avec livraison à domicile a commencé à prendre de l'ampleur, et avec l'introduction des premières mesures de confinement liées à la COVID-19, la charge augmentait de manière dramatique tout au long de la journée. Il est devenu nécessaire de décharger rapidement les serveurs master de la base de données principale et de transférer une partie des demandes de lecture sur les serveurs répliques (slave).
Nous nous étions déjà préparés à cette étape, et pour ce manœuvre, 2 serveurs slave étaient déjà en service. Ils étaient principalement utilisés pour les tâches de batch générant des flux d'information pour l'échange de données avec nos partenaires. Ces processus créaient une charge supplémentaire et avaient été justement mis « de côté » quelques mois plus tôt.
Étant donné que la réplication se faisait sur le Slave, nous suivions le principe que les applications ne pouvaient interagir avec eux qu'en mode lecture seule. Le Plan de Récupération après Sinistre stipulait qu'en cas de catastrophe, nous pouvions simplement monter un Slave à la place du Master et rediriger toutes les demandes d'écriture et de lecture vers le Slave. Cependant, nous souhaitions également utiliser les répliques pour les besoins du département d'analyse, c'est pourquoi les serveurs n'avaient pas été entièrement transférés en statut lecture seule, chaque hôte ayant son propre ensemble d'utilisateurs, et certains disposaient de droits d'écriture pour conserver les résultats intermédiaires des calculs.
Jusqu'à un certain niveau de charge, nous avons pu utiliser le maître à la fois pour les écritures et les lectures lors du traitement des requêtes http. Mi-mars, juste au moment où Sbermarket a décidé de passer complètement au télétravail, nous avons connu une augmentation exponentielle des RPS. De plus en plus de nos clients ont commencé à s'isoler ou à travailler depuis chez eux, ce qui a eu un impact sur nos indicateurs de charge.
La performance du « maître » devenait insuffisante, nous avons donc commencé à déplacer certaines des requêtes de lecture les plus lourdes vers une réplique. Pour diriger les requêtes d'écriture vers le maître et les lectures vers le slave, nous avons utilisé la gemme ruby «». Nous avons créé un utilisateur spécial avec le suffixe _readonly sans droits d'écriture. Cependant, en raison d'une erreur de configuration sur l'un des hôtes, certaines requêtes d'écriture ont été envoyées au serveur esclave au nom d'un utilisateur qui avait les droits appropriés.
Le problème ne s'est pas manifesté immédiatement, car la charge accrue a augmenté le retard des slaves. L'incohérence des données a été constatée le matin, lorsque, après les importations nocturnes, les slaves n'ont pas « rattrapé » le maître. Nous avons mis cela sur le compte de la forte charge du service lui-même et des importations liées au lancement de nouveaux magasins. Mais fournir des données avec un retard de plusieurs heures était inacceptable, et nous avons basculé les processus vers le deuxième slave analytique, car il disposait de ressources plus importantes et n'était pas chargé de requêtes de lecture (ce que nous avons utilisé pour expliquer l'absence de retard de réplication).deLorsque nous avons compris les raisons de la « dérive » du slave principal, le slave analytique était déjà hors service pour la même raison. Malgré la présence de deux serveurs supplémentaires vers lesquels nous avions prévu de transférer la charge en cas de défaillance du maître, en raison d'une erreur malheureuse, il s'est avéré qu'à un moment critique, nous n'en avions aucun.
Mais comme nous avons non seulement effectué un dump de la base de données (la restauration à ce moment-là prenait environ 5 heures), mais aussi un snapshot du serveur maître, nous avons réussi à lancer la réplique en deux heures. Cependant, après cela, nous avons dû faire face à l'application du journal de réplication pendant une période prolongée (car le processus se déroule en mode mono-thread, mais cela est une autre histoire).
Mais comme nous avons fait non seulement un dump de la base de données (la restauration à ce moment-là prenait environ 5 heures), mais aussi un snapshot du serveur maître, nous avons réussi à relancer la réplique en deux heures. Cependant, après cela, nous avons dû appliquer le journal de réplication pendant une période prolongée (car le processus se déroule en mode monocœur, mais c'est une toute autre histoire).
Conclusion : Après un tel incident, il est devenu clair qu'il fallait abandonner la pratique de la restriction des écritures pour les utilisateurs et déclarer le serveur en mode lecture seule. Avec une telle approche, on peut être assuré que les répliques seront disponibles au moment critique.
L'optimisation même d'une seule requête lourde peut « redonner vie » à la base de données.
Bien que nous mettions constamment à jour le catalogue sur le site, les requêtes que nous avons transférées sur les serveurs esclaves affichaient un léger retard par rapport au serveur maître. Le temps pris pour détecter et résoudre le problème des esclaves « soudainement hors course » dépassait le « seuil psychologique » (durant ce temps, une mise à jour des prix pouvait avoir lieu, et les clients auraient vu des données obsolètes), ce qui nous a contraints à rediriger toutes les requêtes vers le serveur principal de la base de données. En conséquence, le site fonctionnait lentement... mais au moins fonctionnait. Et pendant que l'esclave se rétablissait, nous n'avions d'autre choix que l'optimisation.
Alors que les serveurs esclaves se rétablissaient, chaque minute passait lentement, le maître restait surchargé, et nous avons concentré tous nos efforts sur l'optimisation des tâches actives selon la « règle de Pareto » : nous avons sélectionné les TOP-requêtes générant la majorité de la charge et avons commencé à effectuer des réglages. Cela se faisait en temps réel.
Un effet intéressant était que MySQL, chargé à bloc, réagissait même à une légère amélioration des processus. L'optimisation de quelques requêtes, qui n'assuraient que 5 % de la charge totale, a déjà montré une réduction significative de l'utilisation du CPU. En conséquence, nous avons réussi à garantir une réserve de ressources acceptable pour le fonctionnement du maître avec la base de données et à obtenir le temps nécessaire pour récupérer les répliques.
Conclusion : Même une petite optimisation permet de « survivre » à une surcharge pendant plusieurs heures. C'est précisément ce qu'il nous a fallu pour le temps de récupération des serveurs avec les répliques. À propos, nous discuterons de l'aspect technique de l'optimisation des requêtes dans l'un de nos prochains articles. Donc, abonnez-vous à notre blog si cela peut vous être utile.
Organisez la surveillance de la disponibilité des services partenaires.
Nous traitons les commandes des clients, et donc nos services interagissent constamment avec des API tierces — il s'agit de passerelles pour l'envoi de SMS, de plateformes de paiement, de systèmes de routage, de géocodeurs, des services de la FNS et de nombreux autres systèmes. Et lorsque la charge a commencé à augmenter rapidement, nous avons commencé à rencontrer les limites API de nos services partenaires, auxquelles nous n'avions même pas pensé auparavant.
Un dépassement inattendu des quotas des services partenaires peut entraîner un temps d'arrêt pour le vôtre. De nombreuses API bloquent les clients qui dépassent les limites, et dans certains cas, un excès de requêtes peut surcharger la production chez le partenaire.
Par exemple, au moment de l'augmentation du nombre de livraisons, les services d'accompagnement ne parvenaient pas à gérer les tâches de distribution et de détermination des parcours. En conséquence, des commandes étaient passées, mais le service qui créait le parcours ne fonctionnait pas. Il faut dire que nos logisticiens ont réalisé l'impossible dans ces conditions, et l'interaction claire de l'équipe a aidé à compenser les pannes temporaires des services. Mais un tel volume de demandes n'est pas réaliste à traiter manuellement en permanence, et au bout d'un certain temps, nous serions confrontés à une rupture inacceptable entre les commandes et leur exécution.
Un certain nombre de mesures organisationnelles ont été mises en place et le travail coordonné de l'équipe nous a permis de gagner du temps, pendant que nous négociions de nouveaux termes et attendions la modernisation des services de certains partenaires. Il existe d'autres API qui offrent une grande robustesse et des tarifs exorbitants en cas de trafic élevé. Par exemple, au début, nous utilisions une API cartographique connue pour déterminer l'adresse du point de livraison. Mais à la fin du mois, nous avons reçu une facture rondelette de près de 2 millions de roubles. Après cela, nous avons décidé de le remplacer rapidement. Je ne vais pas faire de publicité, mais je dirai que nos dépenses ont largement diminué.
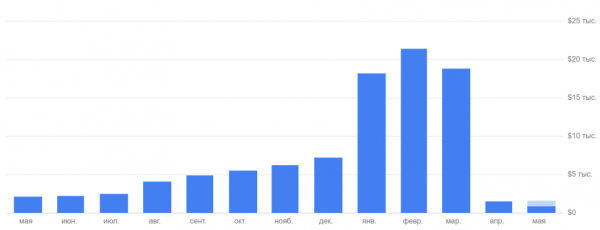
Conclusion : Il est impératif de surveiller les conditions de travail de tous les services partenaires et de les garder à l'esprit. Même si aujourd'hui il semble qu'ils disposent d'une «large marge», cela ne signifie pas que demain ils ne deviendront pas un obstacle à la croissance. Et bien sûr, il est préférable de s'accorder à l'avance sur les conditions financières des demandes accrues au service.
Il arrive parfois que «» (c) ne soit pas utile
Nous sommes habitués aux « goulets d'étranglement » dans la base de données principale ou sur les serveurs d'applications, mais lors de la mise à l'échelle, des problèmes peuvent survenir là où on ne les attend pas. Pour la recherche en texte intégral sur le site, nous utilisons le moteur Apache Solr. Avec l'augmentation de la charge, nous avons constaté une diminution du temps de réponse, et l'utilisation du processeur du serveur atteignait déjà 100 %. Quoi de plus simple — nous allons donner plus de ressources au conteneur avec Solr.
Au lieu d'une augmentation de performance attendue, le serveur s'est simplement « éteint ». Il se chargeait immédiatement à 100 % et répondait encore plus lentement. Au départ, nous avions 2 cœurs et 2 Go de RAM. Nous avons décidé de faire ce qui aide généralement — nous avons donné au serveur 8 cœurs et 32 Go. Tout est devenu beaucoup pire (comment et pourquoi exactement — nous en parlerons dans un autre billet).
En quelques jours, nous avons compris les subtilités de cette question et avons atteint une performance optimale avec 8 cœurs et 32 Go. Cette configuration permet encore aujourd'hui de continuer à augmenter la charge, ce qui est très important, car la croissance ne concerne pas uniquement le nombre de clients, mais aussi le nombre de magasins connectés — en 2 mois, leur nombre a doublé.
Conclusion : Les méthodes standard comme « ajouter plus de matériel » ne fonctionnent pas toujours. Ainsi, lors de la mise à l'échelle de tout service, il est crucial de bien comprendre comment il utilise les ressources et de tester à l'avance son fonctionnement dans de nouvelles conditions.
Stateless — la clé d'une mise à l'échelle horizontale simple.
Dans l'ensemble, notre équipe adhère à l'approche bien connue : les services ne doivent pas avoir d'état interne (stateless) et doivent être indépendants de l'environnement d'exécution. Cela nous a permis de faire face à l'augmentation de la charge par une mise à l'échelle horizontale simple. Mais nous avions un service d'exception — le gestionnaire de tâches de fond prolongées. Il s'occupait de l'envoi d'emails et de SMS, du traitement des événements, de la génération de flux, de l'importation des prix et des stocks, du traitement des images. Il se trouvait que ce service dépendait d'un stockage de fichiers local et qu'il n'existait qu'en un seul exemplaire.
Lorsque le nombre de tâches dans la file d'attente du processeur a augmenté (ce qui est naturellement survenu avec l'augmentation du nombre de commandes), la performance de l'hôte, sur lequel étaient hébergés le processeur et le stockage de fichiers, est devenue un facteur limitant. En conséquence, la mise à jour de l'assortiment et des prix, ainsi que l'envoi de notifications aux utilisateurs et de nombreuses autres fonctions critiques, se sont retrouvées bloquées dans la file d'attente. L'équipe Ops a rapidement migré le stockage de fichiers vers un stockage en réseau de type S3, ce qui nous a permis de mettre en place plusieurs machines puissantes pour que le processeur de tâches en arrière-plan puisse être évolutif.
Conclusion : La règle Stateless doit être respectée pour tous les composants sans exception, même si l'on pense « qu'ici, cela ne posera pas de problème ». Mieux vaut passer un peu de temps à bien organiser le fonctionnement de tous les systèmes que de devoir réécrire du code à la hâte et de réparer un service subissant une surcharge.
7 principes pour une croissance intensive
Malgré la disponibilité de puissances supplémentaires, au cours de notre croissance, nous avons rencontré plusieurs obstacles. Pendant cette période, le nombre de commandes a augmenté de plus de 4 fois. Nous livrons maintenant plus de 17 000 commandes par jour dans 62 villes et prévoyons d'élargir encore notre zone géographique — au premier semestre 2020, le lancement du service est attendu dans toute la Russie. Afin de faire face à la charge croissante, en tenant compte des leçons déjà apprises, nous avons identifié 7 principes de base pour travailler dans des conditions de croissance constante :
- Gestion des incidents. Nous avons créé un tableau dans Jira, où chaque incident est reflété sous forme de ticket. Cela aidera à prioriser effectivement et à exécuter les tâches liées à l'incident. Après tout, il n'est pas vraiment effrayant de faire des erreurs — ce qui est effrayant, c'est de répéter les mêmes erreurs. Dans les cas où les incidents se reproduisent avant que nous puissions corriger la cause, une procédure d'action doit être prête, car pendant une forte charge, il est important de réagir instantanément.
- Surveillance nécessaire pour tous les éléments de l'infrastructure sans exception. C'est grâce à cela que nous avons pu prévoir l'augmentation de la charge et choisir correctement les «goulots d'étranglement» à prioriser pour l'élimination. En cas de forte charge, tout ce à quoi vous n'avez pas pensé risque de tomber en panne ou de commencer à ralentir. C'est pourquoi il est préférable de créer de nouvelles alertes immédiatement après les premiers incidents, afin de les surveiller et de les anticiper.
- Alertes appropriées sont tout simplement nécessaires en cas d'augmentation rapide de la charge. Premièrement, elles doivent signaler ce qui est réellement tombé en panne. Deuxièmement, il ne doit pas y avoir trop d'alertes, car une surabondance d'alertes non critiques mène à l'ignorance de toutes les notifications.
- Les applications doivent être sans état. Nous avons constaté qu'il ne doit pas y avoir d'exceptions à cette règle. Une indépendance totale par rapport à l'environnement d'exécution est nécessaire. Vous pouvez stocker des données partagées dans une base de données ou, par exemple, directement dans S3. Mieux encore, suivez les règles. Lors d'une augmentation rapide des temps, il n'y a tout simplement pas de temps pour optimiser le code, et il faudra gérer la charge par une augmentation directe des ressources de calcul et un redimensionnement horizontal.
- Quotas et performances des services externes. Lors d'une forte croissance, le problème peut survenir non seulement dans votre infrastructure, mais aussi dans le service externe. Ce qui est frustrant, c'est que cela se produit non pas à cause d'une défaillance, mais en raison de l'atteinte des quotas ou des limites. Ainsi, les services externes doivent évoluer aussi bien que vous.
- Séparez les processus et les files d'attente. C'est très utile lorsque l'un des passerelles rencontre un blocage. Nous ne rencontrerions pas de retard dans le transfert de données si les files d'attente de l'envoi des SMS ne gênaient pas l'échange de notifications entre les systèmes d'information. Et le nombre de travailleurs serait plus facile à augmenter s'ils fonctionnaient séparément.
- Réalités financières. Lorsque la croissance des flux de données est explosive, il n'y a pas de temps pour réfléchir aux tarifs et aux abonnements. Mais il faut y penser, surtout si vous êtes une petite entreprise. Une facture importante peut être émise par le propriétaire de n'importe quelle API, ainsi que par votre fournisseur d'hébergement. Il faut donc lire les contrats attentivement.
Conclusion
Avec quelques pertes, nous avons traversé cette étape et aujourd'hui, nous nous efforçons de respecter tous les principes identifiés, chaque machine ayant la possibilité d'augmenter facilement sa performance par un facteur de 4, afin de faire face à des imprévus.
Dans les prochains articles, nous partagerons notre expérience sur l'analyse de la baisse de performance dans Apache Solr, ainsi que sur l'optimisation des requêtes et comment la collaboration avec la FNS aide l'entreprise à économiser de l'argent. Abonnez-vous à notre blog pour ne rien manquer et faites-nous savoir dans les commentaires si vous avez rencontré des problèmes similaires lors d'une augmentation de trafic.
Seuls les utilisateurs enregistrés peuvent participer au sondage. , s'il vous plaît.
Avez-vous déjà rencontré un ralentissement ou une chute de service lors d'une forte augmentation de charge due à :
55,6%L'incapacité d'ajouter rapidement des ressources de calcul10
16,7%Les limites de l'infrastructure du fournisseur d'hébergement3
33,3%Les limites des API tierces6
27,8%La violation des principes stateless de vos applications5
88,9%Le manque d'optimisation du code de vos propres services16
18 utilisateurs ont voté. 6 utilisateurs se sont abstenus.
Source : habr.com
