

Bonjour à tous ! Nous avons de bonnes nouvelles, en juin, OTUS relance à nouveau un cours , c'est pourquoi nous partageons traditionnellement avec vous du matériel utile.
Si vous êtes confronté à toute cette histoire de microservices sans aucun contexte, vous pouvez légitimement la trouver un peu étrange. Décomposer une application en fragments reliés par un réseau implique nécessairement d'ajouter des modes de résilience complexes dans le système distribué résultant.
Bien que cette approche implique de diviser en de multiples services indépendants, l'objectif final va bien au-delà de simplement faire fonctionner ces services sur des machines différentes. Il s'agit ici de l'interaction avec le monde environnant, qui est lui aussi fondamentalement distribué. Pas au sens technique, mais plutôt dans le sens d'un écosystème composé de nombreuses personnes, équipes, programmes, et chacune de ces parties doit, d'une manière ou d'une autre, remplir son rôle.
Les entreprises, par exemple, représentent un ensemble de systèmes distribués qui, ensemble, contribuent à atteindre un certain objectif. Nous avons ignoré ce fait pendant des décennies, essayant d'atteindre une intégration en transférant des fichiers par FTP ou en utilisant des outils d'intégration d'entreprise, tout en nous concentrant sur nos propres objectifs isolés. Mais avec l'arrivée des services, tout a changé. Les services nous ont aidés à voir au-delà de l'horizon et à percevoir un monde de programmes interdépendants qui travaillent ensemble. Cependant, pour réussir, il est nécessaire de concevoir et de comprendre deux mondes fondamentalement différents : le monde extérieur, où nous vivons dans un écosystème de nombreux autres services, et notre monde personnel, intérieur, où nous régnons seuls.
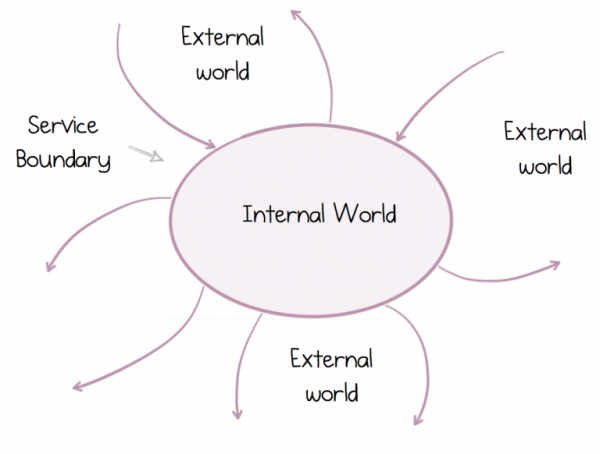
Ce monde distribué diffère de celui dans lequel nous avons grandi et auquel nous sommes habitués. Les principes de la construction d'une architecture monolithique traditionnelle ne tiennent pas la route. Par conséquent, comprendre correctement ces systèmes est plus qu'un simple exercice de création d'un joli schéma sur un tableau blanc ou une belle preuve de concept. Il s'agit de faire en sorte qu'un tel système fonctionne avec succès sur le long terme. Heureusement, les services existent depuis un certain temps, bien qu'ils prennent différentes formes. ils sont toujours pertinents, même agrémentés de Docker, Kubernetes et légèrement ébouriffés par des barbes de hipsters.
Aujourd'hui, nous allons examiner comment les règles ont changé, pourquoi nous devons repenser notre approche des services et des données qu'ils échangent entre eux, et pourquoi cela nécessite des outils complètement différents.
L'encapsulation ne sera pas toujours votre amie.
Les microservices peuvent fonctionner indépendamment les uns des autres. C'est cette caractéristique qui leur confère leur plus grande valeur. Cette même propriété permet aux services de se développer et de croître. Pas tant en termes de mise à l'échelle jusqu'à des quadrillions d'utilisateurs ou des pétaoctets de données (bien qu'ils puissent également aider dans ce cas), mais en termes de mise à l'échelle du point de vue des personnes, car les équipes et les organisations continuent de croître.
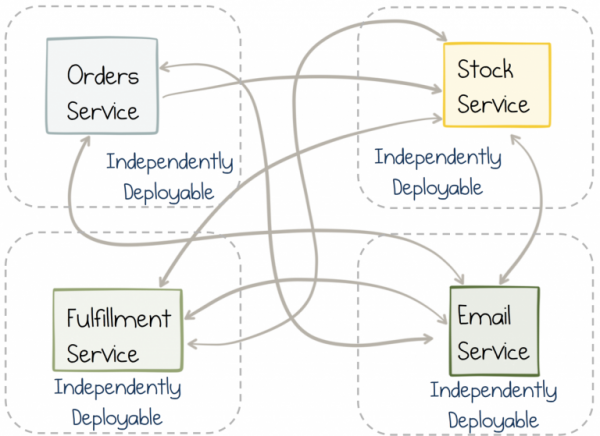
Cependant, l'indépendance est une arme à double tranchant. C'est-à-dire qu'un service peut fonctionner facilement et sans effort. Mais si une fonction à l'intérieur du service nécessite d'engager un autre service, alors finalement, nous devons apporter des modifications aux deux services presque simultanément. Dans un monolithe, cela est facile, vous effectuez simplement le changement et le déployez en production, mais dans le cas de la synchronisation des services indépendants, il y aura plus de problèmes. La coordination entre les équipes et les cycles de publication détruit la flexibilité.
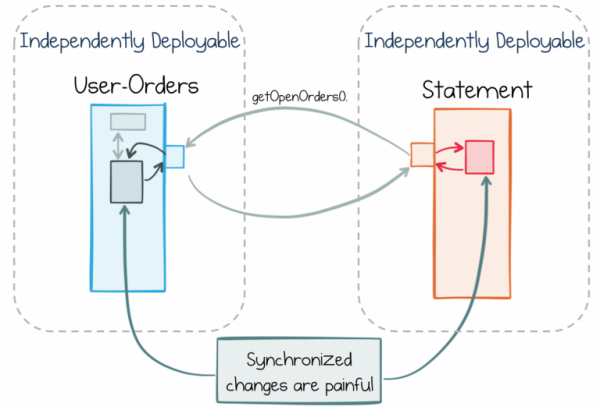
Dans le cadre de l'approche standard, les changements transversaux frustrants sont simplement évités, en séparant clairement les fonctionnalités entre les services. Un service d'authentification unique peut en être un bon exemple. Il a un rôle clairement défini qui le distingue des autres services. Cette séparation nette signifie que dans un monde où les exigences changeantes affectent les services environnants, le service d'authentification unique aura peu de chances de changer. Il existe dans un contexte strictement limité.
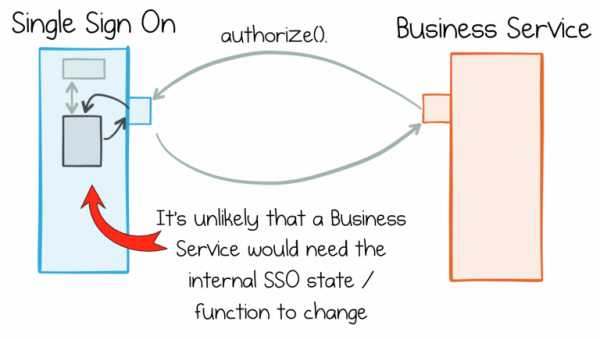
Le problème est que dans le monde réel, les services commerciaux ne peuvent pas maintenir une séparation des rôles toujours claire. Par exemple, ces mêmes services commerciaux travaillent dans une large mesure avec des données provenant d'autres services similaires. Si vous êtes impliqué dans le commerce en ligne, le traitement des flux de commandes, du catalogue de produits ou des informations sur les utilisateurs deviendra une exigence pour de nombreux services. Chacun des services nécessitera un accès à ces données pour fonctionner.
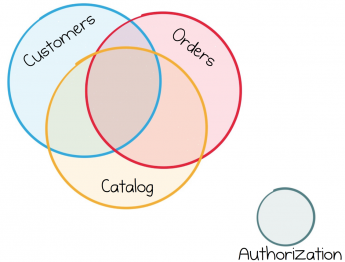
La plupart des services commerciaux utilisent les mêmes flux de données, ce qui entraîne des interconnexions inévitables dans leur fonctionnement.
Nous avons donc atteint un point crucial dont il convient de parler. Alors que les services fonctionnent bien pour les composants d'infrastructure qui opèrent de manière relativement isolée, la plupart des services commerciaux se retrouvent étroitement liés.
Dichotomie des données
Des approches axées sur les services existent peut-être déjà, mais il y a encore peu d'informations sur la façon d'échanger de gros volumes de données entre les services.
Le problème principal est que les données et les services sont indissociables. D'une part, l'encapsulation nous encourage à masquer les données afin que les services puissent être séparés les uns des autres, facilitant leur croissance et leurs évolutions ultérieures. D'autre part, nous devons être capables de partager librement et de gérer des données communes, comme n'importe lesquelles d'autres. Il s'agit d'être capable de commencer à travailler immédiatement, aussi librement que dans n'importe quel autre système d'information.
Cependant, les systèmes d'information ont peu à voir avec l'encapsulation. En fait, c'est même l'inverse. Les bases de données font tout ce qu'elles peuvent pour donner accès aux données qu'elles contiennent. Elles sont fournies avec une interface déclarative puissante qui permet de modifier les données selon vos besoins. Cette fonctionnalité est essentielle lors des études préliminaires, mais pas pour gérer la complexité croissante d'un service en évolution constante.
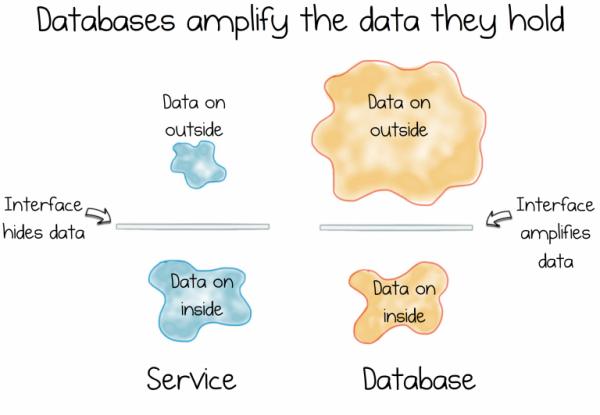
Et c'est ici que se pose le dilemme. La contradiction. La dichotomie. En effet, les systèmes d'information visent à fournir des données, tandis que les services visent à masquer.
Ces deux forces sont fondamentales. Elles constituent la base de la plupart de notre travail, se battant constamment pour dominer les systèmes que nous créons.
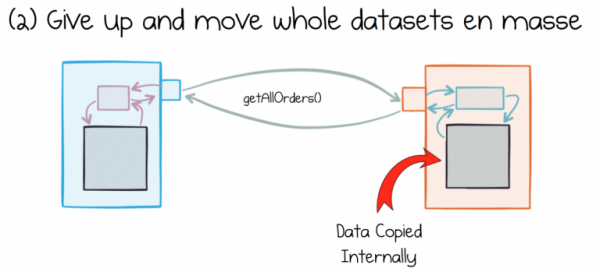
À mesure que les systèmes de services croissent et évoluent, nous observons différentes manifestations des conséquences de la dichotomie des données. Soit l'interface du service se développe, offrant un ensemble de fonctionnalités de plus en plus large, et commence à ressembler à une base de données maison très particulière, soit nous ressentons de la frustration et mettons en œuvre une manière d'extraire ou de déplacer massivement des ensembles de données entiers d'un service à un autre.
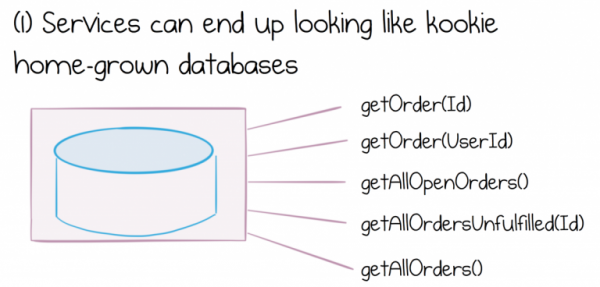
En retour, créer quelque chose qui ressemble à une base de données maison très particulière engendrera toute une série de problèmes. Nous n'allons pas entrer dans les détails de ce qui est dangereux à propos de shared database, simplement dire qu'elle représente des difficultés d'ingénierie et d'opérations significatives et coûteuses Pire encore, les volumes de données exacerbent les problèmes de frontières des services. Plus il y a de données partagées à l'intérieur d'un service, plus l'interface deviendra complexe et plus il sera difficile de fusionner des ensembles de données provenant de différents services.
Une approche alternative consistant à extraire et à déplacer des ensembles de données entiers a aussi ses propres problèmes. L'approche courante à cette question semble être l'extraction simple et le stockage d'un ensemble de données complet, puis son stockage local dans chaque service consommateur.
Le problème est que différents services interprètent les données qu'ils consomment de manière différente. Ces données sont toujours à portée de main. Elles changent et sont traitées localement. Assez rapidement, elles cessent d'avoir quoi que ce soit en commun avec les données de la source.
Plus les copies sont mutables, plus les données vont diverger avec le temps.
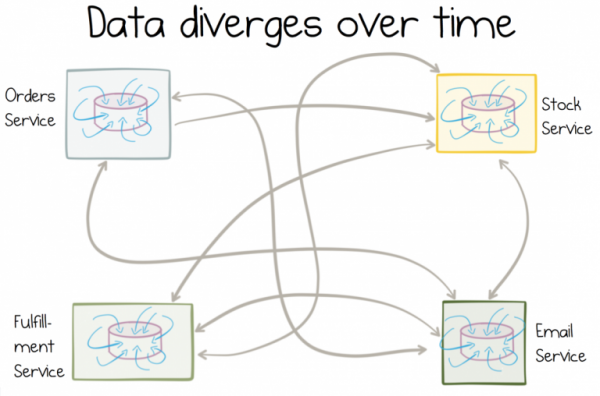
Pire encore, ces données sont difficiles à corriger rétrospectivement (
MDM Pour trouver une solution à ce problème concernant les données partagées, il faut penser différemment. Elles doivent devenir des objets de premier plan dans les architectures que nous construisons.
Pat Helland appelle ces données des « externes », et c'est une caractéristique très importante. Nous avons besoin d'encapsulation pour ne pas révéler l'architecture interne du service, mais nous devons faciliter l'accès des services aux données partagées afin qu'ils puissent effectuer leur travail correctement.
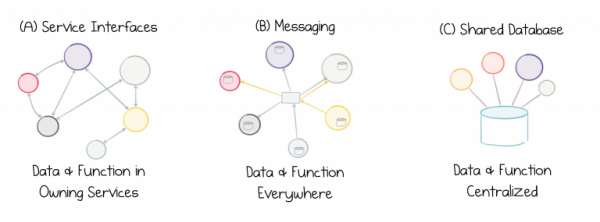
Le problème est qu'aucun des approches actuelles n'est pertinente, car ni les interfaces de service, ni l'échange de messages, ni la base de données partagée ne proposent de bonne solution pour travailler avec des données externes. Les interfaces de service sont mal adaptées pour le partage de données à grande échelle. L'échange de messages déplace des données mais ne conserve pas leur historique, donc avec le temps, les données se détériorent. Les bases de données partagées se concentrent trop sur un seul point, ce qui limite l'avancement. Nous coincions inévitablement dans un cycle d'incapacité des données :
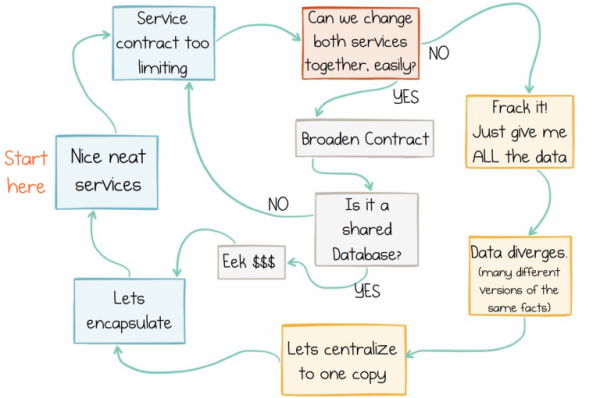
Cycle d'incapacité des données
Flux : approche décentralisée des données et des services
Idéalement, nous devons changer notre approche quant à la manière dont les services travaillent avec des données communes. Actuellement, toute approche se heurte à la dichotomie mentionnée ci-dessus, car il n'existe pas de solution magique que l'on pourrait généreusement saupoudrer pour qu'elle disparaisse. Toutefois, nous pouvons repenser le problème et parvenir à un compromis.
Ce compromis implique un certain degré de centralisation. Nous pouvons tirer parti du mécanisme de journaux distribués, car il permet des flux évolutifs et fiables. Il est maintenant nécessaire que les services puissent se connecter et travailler avec ces flux communs, mais nous souhaitons éviter des services centraux complexes qui réalisent ce traitement. Par conséquent, la meilleure option est d'intégrer le traitement des flux dans chaque service consommateur. Ainsi, les services pourront combiner des ensembles de données provenant de différentes sources et travailler avec eux comme ils le souhaitent.
Une des manières d'atteindre une telle approche est d'utiliser une plateforme de streaming. Il existe de nombreuses options, mais aujourd'hui nous allons nous concentrer sur Kafka, car son traitement des flux d'état permet de résoudre efficacement le problème présenté.
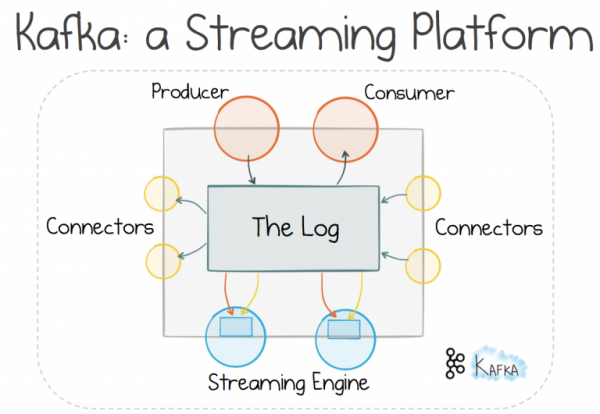
L'utilisation du mécanisme de journalisation distribuée nous permet de suivre un chemin balisé et d'utiliser l'échange de messages pour travailler avec. . On pense qu'une telle approche offre une meilleure scalabilité et segmentation que le mécanisme « requête-réponse », car elle donne le contrôle du flux au destinataire plutôt qu'à l'expéditeur. Cependant, tout dans cette vie a un coût, et ici vous aurez besoin d'un courtier. Mais pour les grandes systèmes, ce compromis en vaut la peine (contrairement à vos applications web typiques).
Si le courtier est responsable de la journalisation distribuée plutôt que d'un système de messagerie traditionnel, il est possible de tirer parti de fonctionnalités additionnelles. Le transport peut être mis à l'échelle linéaire presque aussi bien qu'un système de fichiers distribué. Les données peuvent être stockées dans les journaux assez longtemps, ce qui nous donne non seulement un échange de messages, mais aussi un stockage d'informations. Un stockage évolutif sans crainte d'obtenir un état global modifiable.
On peut ensuite utiliser un mécanisme de traitement de flux avec état pour ajouter des outils de base de données déclaratifs aux services consommateurs. C'est une pensée très importante. Tant que les données sont stockées dans des flux communs, auxquels tous les services peuvent accéder, l'agrégation et le traitement effectués par le service sont privés. Ils se retrouvent isolés dans un contexte strictement limité.
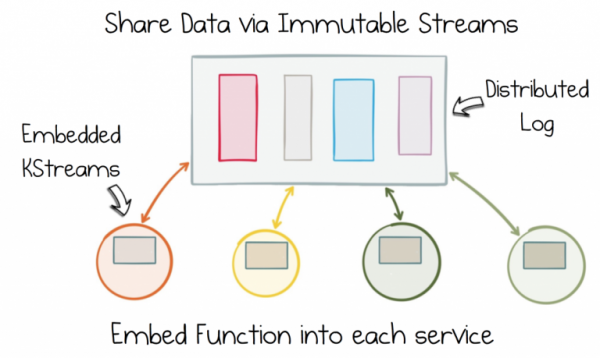
Éliminez la dichotomie des données en divisant le flux d'états immuables. Ajoutez ensuite cette fonctionnalité à chaque service grâce au traitement de flux avec état.
Ainsi, si votre service doit travailler avec des commandes, un catalogue de produits, des stocks, il aura un accès complet : vous serez le seul à décider quelles données amalgamer, où les traiter et comment elles doivent évoluer dans le temps. Bien que les données soient partagées, leur manipulation est totalement décentralisée. Elle s'effectue à l'intérieur de chaque service, dans un monde où tout se passe selon vos règles.
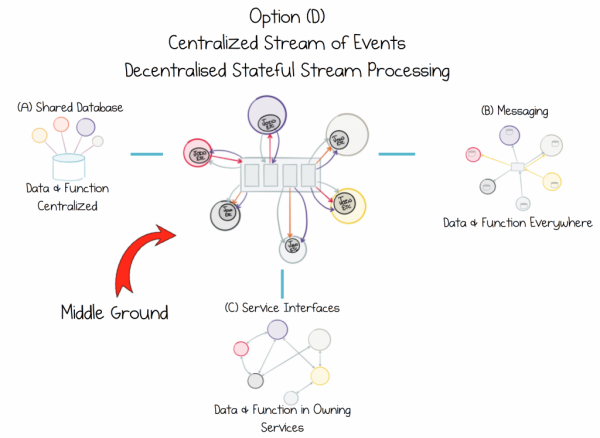
Partagez les données de manière à ne pas compromettre leur intégrité. Encapsulez la fonction, et non la source, dans chaque service où elle est nécessaire.
Il arrive que des données doivent être transférées en masse. Parfois, un service nécessite un ensemble historique local de données dans le moteur de base de données choisi. L'essentiel est que l'on peut garantir qu'en cas de besoin, une copie peut être restaurée à partir de la source grâce à un appel au mécanisme de journalisation distribuée. Les connecteurs dans Kafka s'acquittent très bien de cette tâche.
Ainsi, l'approche examinée aujourd'hui présente plusieurs avantages :
- Les données sont utilisées sous forme de flux partagés, qui peuvent être conservés longtemps dans les journaux, et le mécanisme de gestion des données partagées est intégré dans chaque contexte spécifique, permettant aux services de fonctionner facilement et rapidement. De cette façon, il est possible d'équilibrer la dichotomie des données.
- Les données provenant de services divers peuvent facilement être regroupées. Cela simplifie l'interaction avec les données partagées et élimine le besoin de maintenir des ensembles de données locaux dans la base de données.
- Le traitement d'événements avec état ne fait que mettre en cache les données, tandis que la source de vérité reste les journaux partagés, donc le problème de la détérioration des données au fil du temps est moins aigu.
- En essence, les services sont pilotés par les données, ce qui signifie qu'en dépit de la croissance continue des volumes de données, les services peuvent toujours réagir rapidement aux événements commerciaux.
- Les problèmes de scalabilité reposent sur le courtier, et non sur les services. Cela réduit considérablement la complexité de la rédaction des services, car il n'est pas nécessaire de se soucier de la scalabilité.
- L'ajout de nouveaux services ne nécessite pas de modifier les anciens, facilitant ainsi la connexion de nouveaux services.
Comme vous pouvez le voir, c'est plus qu'un simple REST. Nous avons obtenu un ensemble d'outils qui permet de travailler avec des données partagées de manière décentralisée.
Dans l'article d'aujourd'hui, tous les aspects n'ont pas été couverts. Nous devons encore déterminer comment équilibrer la méthode « requête-réponse » et la méthode orientée événements. Mais nous nous pencherons là-dessus la prochaine fois. Il y a des sujets à approfondir, comme pourquoi le traitement d'événements avec état est si avantageux. Nous en parlerons dans le troisième article. Il existe également d'autres constructions puissantes dont nous pouvons bénéficier si nous y recourons, comme . Cela change les règles du jeu pour les systèmes d'affaires distribués, car cette structure assure des garanties de transactions pour de manière évolutive. C'est ce dont il sera question dans le quatrième article. Et enfin, nous devrons passer en revue les détails de la mise en œuvre de ces principes.
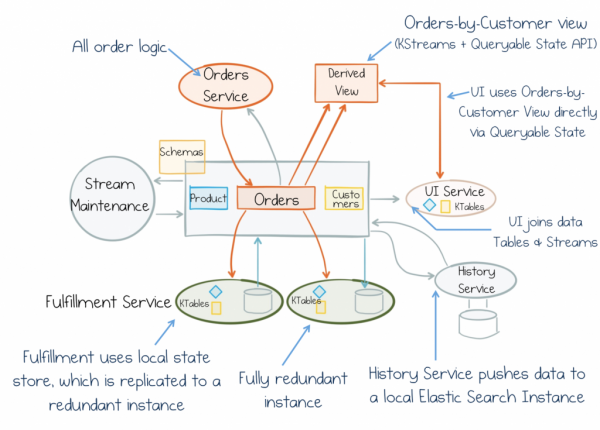
Mais pour l'instant, souvenez-vous simplement de ce qui suit : la dichotomie des données est la force avec laquelle nous sommes confrontés lors de la création de services d'affaires. Et nous devons en prendre conscience. L'objectif est de renverser toute la situation et de considérer les données partagées comme des objets de première classe. Le traitement des flux d'état offre un compromis unique pour cela. Il évite les « composants God » centralisés qui freinent le progrès. De plus, il garantit la rapidité, l'évolutivité et la résilience des pipelines de streaming de données et les intègre dans chaque service. Ainsi, nous pouvons nous concentrer sur un flux de conscience commun auquel tout service peut se connecter et avec lequel il peut travailler. Les services deviennent donc plus évolutifs, interchangeables et autonomes. Par conséquent, ils auront non seulement une bonne apparence sur les tableaux de marqueurs et lors de la validation des hypothèses, mais fonctionneront et évolueront pendant des décennies.
Source : habr.com
