

Ce printemps, nous avons déjà discuté de certains sujets introductifs, tels que et . Dans le deuxième, nous avons même promis de continuer à explorer les performances des différentes topologies multi-disques dans ZFS. C'est un système de fichiers de prochaine génération qui est actuellement déployé partout : depuis à .
Eh bien, aujourd'hui est le jour parfait pour découvrir ZFS, chers lecteurs curieux. Sachez simplement, qu' selon l'estimation modeste du développeur OpenZFS Matt Arons, « c'est vraiment compliqué ».
Mais avant d'arriver aux chiffres - et ils viendront, je te le promets - sur toutes les options de la configuration à huit disques ZFS, il faut parler de comment comment ZFS stocke réellement les données sur le disque.
Zpool, vdev et device
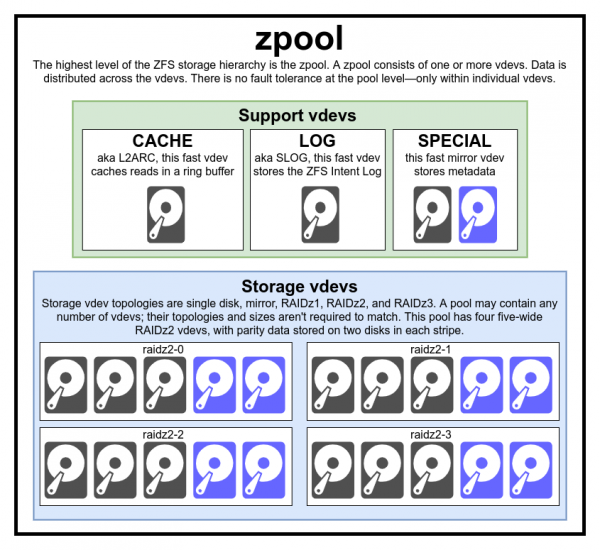
Ce schéma de pool complet comprend trois vdev auxiliaires, un pour chaque classe, et quatre pour RAIDz2.
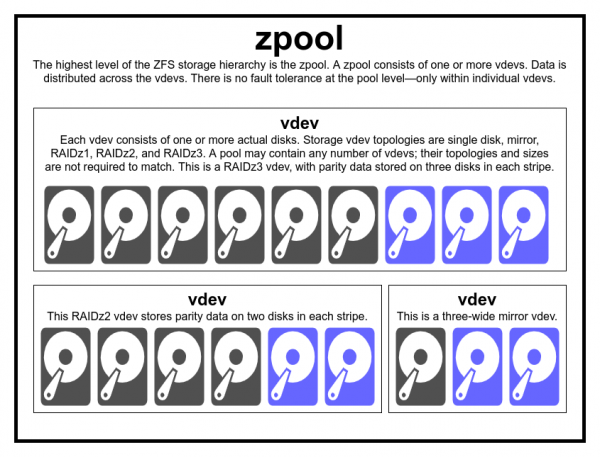
Il n'y a généralement pas de raison de créer un pool à partir de types et tailles vdev incompatibles - mais si vous le souhaitez, rien ne vous en empêche.
Pour vraiment comprendre le système de fichiers ZFS, il faut examiner attentivement sa structure réelle. Tout d'abord, ZFS combine les niveaux de gestion des volumes traditionnels et du système de fichiers. Deuxièmement, il utilise un mécanisme transactionnel de copie à l'écriture. Ces caractéristiques signifient que le système est structurellement très différent des systèmes de fichiers et des ensembles RAID ordinaires. Le premier ensemble de blocs de construction essentiels à comprendre est : le pool de stockage (zpool), le dispositif virtuel (vdev) et le dispositif réel (device).
zpool
Le pool de stockage zpool est la structure supérieure de ZFS. Chaque pool contient un ou plusieurs dispositifs virtuels. À son tour, chacun d'eux contient un ou plusieurs dispositifs réels (device). Les pools virtuels sont des blocs autonomes. Un ordinateur physique peut contenir deux ou plusieurs pools distincts, mais chaque pool est entièrement indépendant des autres. Les pools ne peuvent pas partager des dispositifs virtuels.
La redondance de ZFS se trouve au niveau des dispositifs virtuels, et non au niveau des pools. Au niveau des pools, il n'y a absolument aucune redondance - si un dispositif vdev ou un vdev spécial est perdu, alors tout le pool est également perdu.
Les pools de stockage modernes peuvent survivre à la perte de cache ou de journal d'un dispositif virtuel, bien qu'ils puissent perdre une petite quantité de données en attente si le journal vdev est perdu pendant une coupure de courant ou un échec système.
Il existe une idée reçue selon laquelle les « bandes de données » (stripes) ZFS sont écrites sur l'ensemble du pool. C'est faux. Zpool n'est pas du tout un RAID0, c'est plutôt un avec un mécanisme de répartition complexe et variable.
En grande partie, les écritures sont réparties entre les dispositifs virtuels disponibles en fonction de l'espace libre disponible, de sorte qu'en théorie, tous seront remplis en même temps. Dans les versions ultérieures de ZFS, l'utilisation actuelle du vdev est prise en compte ; si un dispositif virtuel est nettement plus chargé qu'un autre (par exemple, à cause d'une forte charge de lecture), il sera temporairement omis pour l'écriture, malgré un taux d'espace libre élevé.
Le mécanisme de détermination de l'utilisation, intégré dans les méthodes modernes de répartition des écritures ZFS, peut réduire la latence et augmenter le débit pendant les périodes de charge exceptionnellement élevée, mais cela ne fait pas carte blanche pour le mélange involontaire de disques durs lents et de SSD rapides dans un même pool. Un tel pool inégal fonctionnera quand même à la vitesse du périphérique le plus lent, c'est-à-dire comme s'il était entièrement constitué de ces dispositifs.
vdev
Chaque pool de stockage se compose d'un ou plusieurs dispositifs virtuels (device virtuel, vdev). À son tour, chaque vdev comprend un ou plusieurs dispositifs physiques. La plupart des dispositifs virtuels sont utilisés pour le simple stockage de données, mais il existe plusieurs classes auxiliaires de vdev, y compris CACHE, LOG et SPECIAL. Chacun de ces types de vdev peut avoir l'une des cinq topologies : dispositif unique (single-device), RAIDz1, RAIDz2, RAIDz3 ou miroir (mirror).
RAIDz1, RAIDz2 et RAIDz3 sont des variantes spéciales de ce que les anciens appelleraient RAID à double parité (diagonale). Les chiffres 1, 2 et 3 se réfèrent au nombre de blocs de parité alloués à chaque stripe de données. Au lieu de disques distincts pour assurer la parité, les dispositifs RAIDz répartissent cette parité de manière semi-égalitaire sur les disques. Un ensemble RAIDz peut perdre autant de disques qu'il a de blocs de parité ; s'il en perd un de plus, il tombe en panne et emporte avec lui le pool de stockage.
Dans les dispositifs virtuels miroir (mirror vdev), chaque bloc est stocké sur chaque dispositif dans le vdev. Bien que les miroirs doubles (two-wide) soient les plus courants, un miroir peut avoir n'importe quel nombre d'appareils — dans de grandes installations, pour améliorer les performances de lecture et la tolérance aux pannes, des miroirs triples sont souvent utilisés. Un miroir vdev peut survivre à toute panne tant qu'au moins un appareil dans le vdev continue de fonctionner.
Les vdev simples sont par nature dangereux. Un tel dispositif virtuel ne survivra à aucune panne — et s'il est utilisé comme stockage ou vdev spécial, sa panne entraînera la destruction de l'ensemble du pool. Soyez ici très, très prudent.
Les dispositifs virtuels CACHE, LOG et SPECIAL peuvent être créés selon n'importe laquelle des topologies mentionnées ci-dessus — mais rappelez-vous que la perte d'un dispositif virtuel SPECIAL signifie la perte du pool, il est donc fortement recommandé d'adopter une topologie redondante.
dispositif
C'est probablement le terme le plus facile à comprendre dans ZFS — c'est littéralement un dispositif de bloc à accès aléatoire. N'oubliez pas que les dispositifs virtuels se composent d'appareils distincts, et que le pool est constitué de dispositifs virtuels.
Les disques — magnétiques ou à état solide — sont les dispositifs de bloc les plus courants utilisés comme éléments de construction du vdev. Cependant, tout appareil avec un descripteur dans /dev convient — de sorte que des ensembles RAID matériels complets peuvent être utilisés comme dispositifs distincts.
Un simple fichier brut est l'un des dispositifs de bloc alternatifs les plus importants à partir desquels un vdev peut être construit. Les pools de test à partir de sont un moyen très pratique de vérifier les commandes du pool et de voir combien d'espace est disponible dans le pool ou le dispositif virtuel de cette topologie.
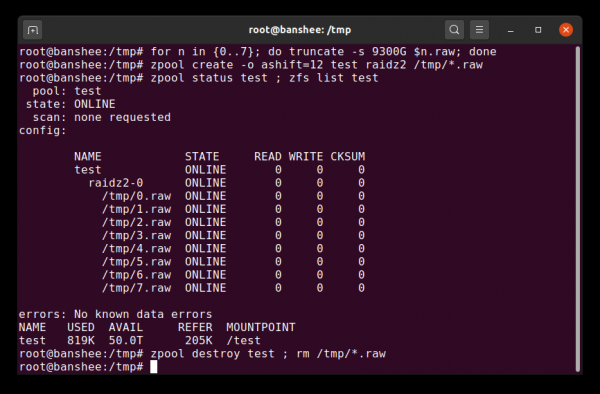
Vous pouvez créer un pool de test à partir de fichiers dispersés en quelques secondes, mais n'oubliez pas de supprimer ensuite l'ensemble du pool et ses composants.
Supposons que vous souhaitiez configurer un serveur avec huit disques et que vous prévoyez d'utiliser des disques de 10 To (~9300 Go) - mais vous n'êtes pas sûr de la topologie qui correspond le mieux à vos besoins. Dans l'exemple ci-dessus, nous construisons un pool de test à partir de fichiers dispersés en quelques secondes - et nous savons maintenant qu'un vdev RAIDz2 composé de huit disques de 10 To offre 50 To d'espace utile.
Une autre catégorie particulière de dispositifs est l'élément SPARE (de secours). Les dispositifs de remplacement à chaud, contrairement aux dispositifs normaux, appartiennent à l'ensemble du pool et non à un seul dispositif virtuel. Si un vdev dans le pool échoue et qu'un dispositif de secours est connecté et disponible, il se joindra automatiquement au vdev défaillant.
Après avoir été connecté au vdev défaillant, le dispositif de secours commence à recevoir des copies ou des reconstructions des données qui devraient se trouver sur le dispositif manquant. Dans un RAID traditionnel, cela s'appelle la reconstruction, alors que dans ZFS, c'est ce qu'on appelle « la reconstruction de redondance ».
Il est important de noter que les dispositifs de secours ne remplacent pas définitivement les dispositifs défaillants. Ils ne constituent qu'un remplacement temporaire pour réduire le temps pendant lequel le vdev est dégradé. Une fois que l'administrateur a remplacé le dispositif défaillant du vdev, la reconstruction de redondance s'effectue sur ce dispositif permanent, et le SPARE se détache du vdev pour revenir à un rôle de secours pour l'ensemble du pool.
Jeux de données, blocs et secteurs
Le prochain ensemble de blocs de construction à comprendre dans notre parcours à travers ZFS concerne moins le matériel que la manière dont les données elles-mêmes sont organisées et stockées. Nous allons ici omettre quelques niveaux - comme le metaslab - pour ne pas alourdir les détails tout en préservant la compréhension de la structure globale.
Jeu de données (dataset)
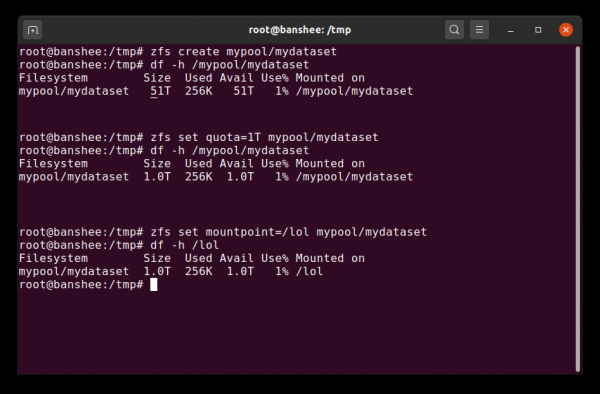
Lorsque nous créons pour la première fois un jeu de données, il affiche tout l'espace disponible dans le pool. Nous définissons ensuite une quota et modifions le point de montage. Magie !
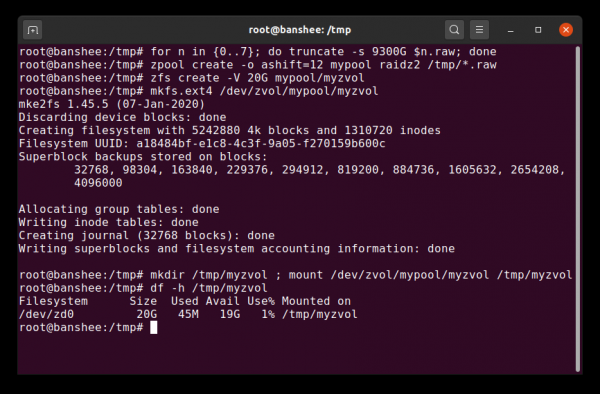
Le Zvol est essentiellement un jeu de données dépourvu de sa couche de système de fichiers, que nous remplaçons ici par un système de fichiers normal comme ext4.
Un jeu de données ZFS est environ équivalent à un système de fichiers monté standard. Comme un système de fichiers traditionnel, à première vue, il semble être « simplement un autre dossier ». Mais tout comme les systèmes de fichiers montés ordinaires, chaque jeu de données ZFS a son propre ensemble de propriétés fondamentales.
Tout d'abord, un jeu de données peut avoir un quota attribué. Si vous configurez zfs set quota=100G nom_du_pool/nom_du_dataset, vous ne pourrez pas écrire dans le dossier monté /poolname/datasetname plus de 100 Go.
Avez-vous remarqué la présence – et l'absence – de barres obliques au début de chaque ligne ? Chaque jeu de données a sa propre place à la fois dans la hiérarchie ZFS et dans la hiérarchie de montage du système. Dans la hiérarchie ZFS, il n'y a pas de barre oblique devant – vous commencez par le nom du pool, puis le chemin d'un jeu de données à l'autre. Par exemple, pool/parent/enfant pour un jeu de données nommé enfant sous le jeu de données parent parent dans un pool au nom créatif pool.
Par défaut, le point de montage d'un jeu de données sera équivalent à son nom dans la hiérarchie ZFS, avec une barre oblique au début – le pool nommé pool sera monté comme /pool, le jeu de données parent sera monté dans /pool/parent, et le jeu de données enfant enfant sera monté dans /pool/parent/child. Cependant, le point de montage système d'un jeu de données peut être modifié.
Si nous spécifions zfs set mountpoint=/lol pool/parent/enfant, alors le jeu de données pool/parent/enfant sera monté dans le système comme /lol.
En plus des jeux de données, nous devons mentionner les volumes (zvols). Un volume est environ équivalent à un jeu de données, sauf qu'il ne contient pas réellement de système de fichiers - c'est simplement un dispositif bloqué. Vous pouvez, par exemple, créer zvol avec le nom mypool/myzvol, puis le formater avec un système de fichiers ext4, et ensuite monter ce système de fichiers – maintenant vous avez un système de fichiers ext4, mais avec le support de toutes les fonctionnalités de sécurité de ZFS ! Cela peut sembler absurde sur un seul ordinateur, mais cela a beaucoup plus de sens en tant que backend lors de l'exportation d'un dispositif iSCSI.
Blocs
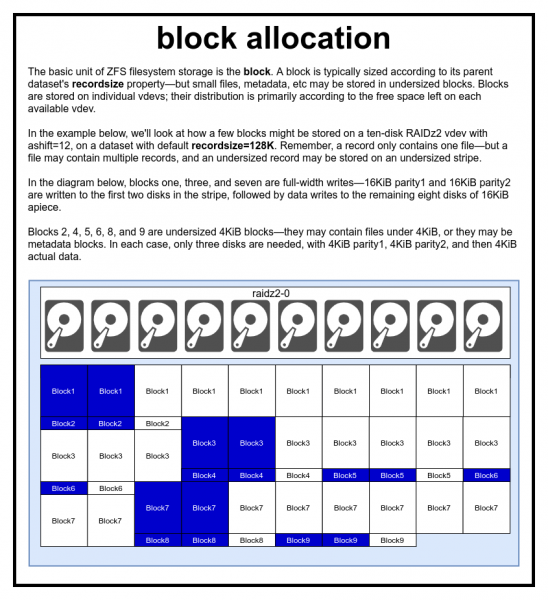
Un fichier est représenté par un ou plusieurs blocs. Chaque bloc est stocké sur un dispositif virtuel. La taille du bloc est généralement égale au paramètre recordsize, mais peut être réduite à 2^ashift, si elle contient des métadonnées ou un petit fichier.
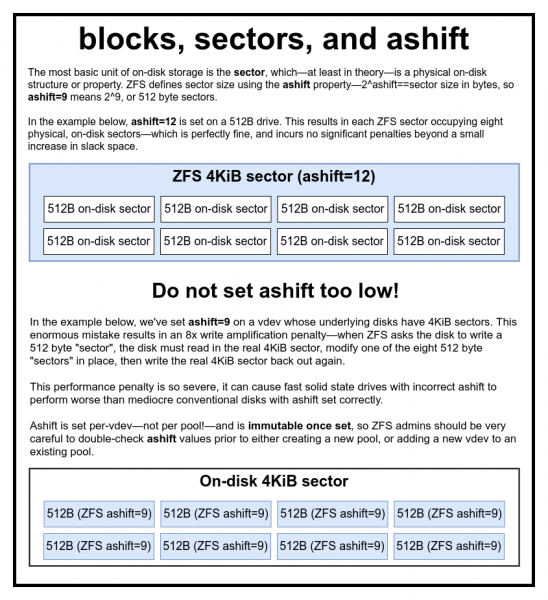
Nous ne plaisantons vraiment pas sur l'énorme perte de performances si vous définissez un ashift trop petit. vraiment не шутим по поводу огромного ущерба производительности, если установить слишком маленький ashift
Dans le pool ZFS, toutes les données, y compris les métadonnées, sont stockées dans des blocs. La taille maximale d'un bloc pour chaque ensemble de données est déterminée par la propriété recordsize (taille d’enregistrement). La taille d'enregistrement peut varier, mais cela ne changera pas la taille ou la position de n'importe quel bloc qui a déjà été écrit dans l’ensemble de données - elle n'agit que pour les nouveaux blocs au fur et à mesure qu'ils sont écrits.
Si rien d'autre n'est précisé, la taille d'enregistrement par défaut actuelle est de 128 Ko. C'est une sorte de compromis imparfait, où les performances ne seront pas idéales mais pas non plus horribles dans la plupart des cas. Recordsize peut être fixé à n'importe quelle valeur entre 4K et 1M (avec des réglages supplémentaires recordsize peut être fixé à des valeurs encore plus élevées, mais cela n’est généralement pas une bonne idée).
Chaque bloc ne fait référence qu'aux données d'un seul fichier - vous ne pouvez pas caser deux fichiers différents dans un même bloc. Chaque fichier est constitué d'un ou plusieurs blocs, selon la taille. Si la taille du fichier est inférieure à la taille d'enregistrement, il sera enregistré dans un bloc plus petit - par exemple, un bloc avec un fichier de 2 Ko occupera seulement un secteur de 4 Ko sur le disque.
Si un fichier est suffisamment grand et nécessite plusieurs blocs, alors toutes les entrées avec ce fichier auront une taille recordsize - y compris la dernière entrée, dont la majeure partie peut s'avérer .
Les volumes zvol n'ont pas de propriété recordsize - à la place, ils ont une propriété équivalente volblocksize.
Secteurs
Le dernier, et le plus fondamental des blocs de construction - le secteur. C'est la plus petite unité physique qui peut être écrite ou lue à partir du dispositif de base. Pendant des décennies, la plupart des disques utilisaient des secteurs de 512 octets. Récemment, la plupart des disques sont configurés avec des secteurs de 4 Ko, et certains - en particulier les SSD - utilisent des secteurs de 8 Ko ou même plus.
Dans le système ZFS, il existe une propriété qui permet de définir manuellement la taille du secteur. Cette propriété ashift. Il est quelque peu déroutant que ashift soit une puissance de deux. Par exemple, ashift=9 signifie une taille de secteur de 2^9, soit 512 octets.
ZFS interroge le système d'exploitation pour obtenir des détails sur chaque périphérique de bloc lorsqu'il est ajouté à un nouveau vdev, et théoriquement établit automatiquement ashift de manière appropriée en fonction de ces informations. Malheureusement, de nombreux disques mentent sur leur taille de secteur pour maintenir la compatibilité avec Windows XP (qui était incapable de comprendre les disques avec d'autres tailles de secteurs).
Cela signifie qu'il est fortement conseillé à l'administrateur ZFS de connaître la véritable taille de secteur de ses dispositifs et de l'établir manuellement. ashift. Si un ashift trop petit est configuré, le nombre d'opérations de lecture/écriture augmente de manière astronomique. Par exemple, écrire des « secteurs » de 512 octets dans un véritable secteur de 4 Ko nécessite d'écrire le premier « secteur », puis de lire le secteur de 4 Ko, de le modifier avec le second « secteur » de 512 octets, de l'écrire à nouveau dans un nouveau secteur de 4 Ko, et ainsi de suite pour chaque écriture.
Dans le monde réel, cette pénalité impacte les disques SSD Samsung EVO, pour lesquels doit être appliqué ashift=13, mais ces SSD mentent sur leur taille de secteur, c'est pourquoi par défaut, il est configuré ashift=9. Si un administrateur système expérimenté ne modifie pas ce paramètre, alors ce SSD fonctionne plus lentement comme un HDD magnétique classique.
En revanche, pour une taille trop grande, ashift il n'y a pratiquement aucune pénalité. Il n'y a pas de réelle diminution de performance, et l'augmentation de l'espace inutilisé est négligeable (ou égale à zéro lorsqu'une compression est activée). Par conséquent, nous recommandons vivement même aux disques qui utilisent réellement des secteurs de 512 octets de définir ashift=12 ou même ashift=13, afin de se projeter sereinement dans l'avenir.
La propriété ashift est établi pour chaque dispositif virtuel vdev, et non pour le pool, comme beaucoup le pensent à tort — et il ne peut pas être modifié après son installation. Si vous le modifiez accidentellement ashift lors de l'ajout d'un nouveau vdev au pool, vous avez irrémédiablement contaminé ce pool avec un dispositif à faible performance et, en général, il n'y a pas d'autre solution que de détruire le pool et de recommencer tout depuis le début. Même la suppression du vdev ne sauvera pas de la mauvaise configuration. ashift!
Le mécanisme de copie à l'écriture
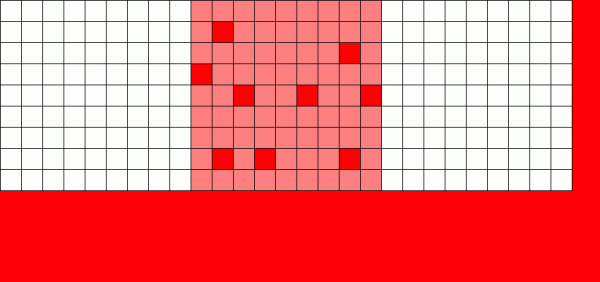
Si un système de fichiers classique doit réécrire des données, il modifie chaque bloc là où il se trouve.
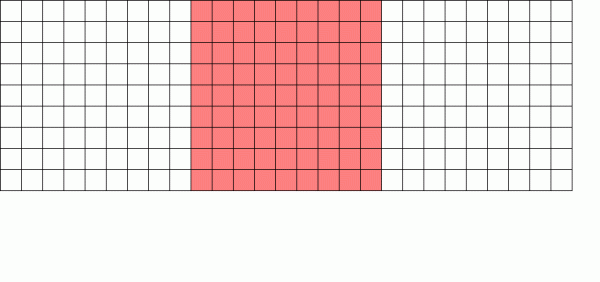
Le système de fichiers avec copie à l'écriture enregistre une nouvelle version du bloc, puis débloque l'ancienne version.
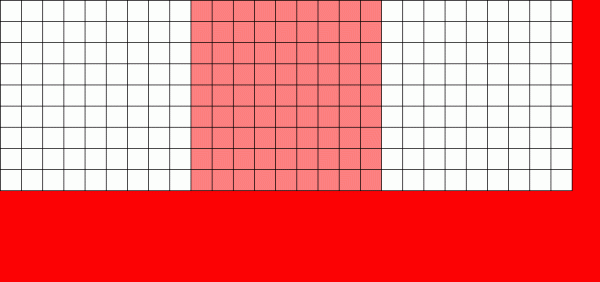
De manière abstraite, si l'on ignore l'emplacement physique réel des blocs, notre « comète de données » se simplifie en un « ver de données » qui se déplace de gauche à droite sur la carte de l'espace disponible.
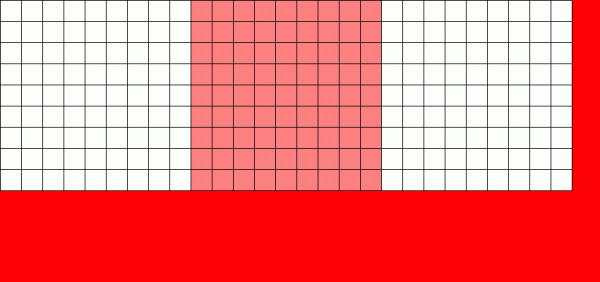
Nous pouvons maintenant avoir une bonne idée de la façon dont fonctionnent les instantanés de copie à l'écriture — chaque bloc peut appartenir à plusieurs instantanés et sera conservé tant que tous les instantanés associés ne seront pas détruits.
Le mécanisme de copie à l'écriture (Copy on Write, CoW) est la base fondamentale de ce qui rend ZFS si incroyable comme système. Le concept principal est simple : si vous demandez à un système de fichiers traditionnel de modifier un fichier, il fera exactement ce que vous avez demandé. Si vous demandez à un système de fichiers avec copie à l'écriture de faire la même chose, il va dire « d'accord » — mais il mentira.
Au lieu de cela, le système de fichiers avec copie à l'écriture enregistre une nouvelle version du bloc modifié, puis met à jour les métadonnées du fichier pour rompre le lien avec l'ancien bloc et établir un lien avec le nouveau bloc que vous venez d'enregistrer.
La déconnexion de l'ancien bloc et la liaison du nouveau se fait en une seule opération, de sorte qu'elle ne peut pas être interrompue — si vous coupez l'alimentation après que cela se soit produit, vous avez une nouvelle version du fichier, et si vous coupez l'alimentation plus tôt, vous avez l'ancienne version. Dans tous les cas, il n'y aura pas de conflits dans le système de fichiers.
La copie à l'écriture dans ZFS se produit non seulement au niveau du système de fichiers, mais aussi au niveau de la gestion des disques. Cela signifie que ZFS n'est pas sujet à l'effet de trou d'écriture () — un phénomène où une tranche a seulement été partiellement enregistrée avant un crash du système, entraînant des dommages au tableau après le redémarrage. Ici, la tranche s'écrit de manière atomique, vdev est toujours cohérent, et .
ZIL : journal des intentions de ZFS.
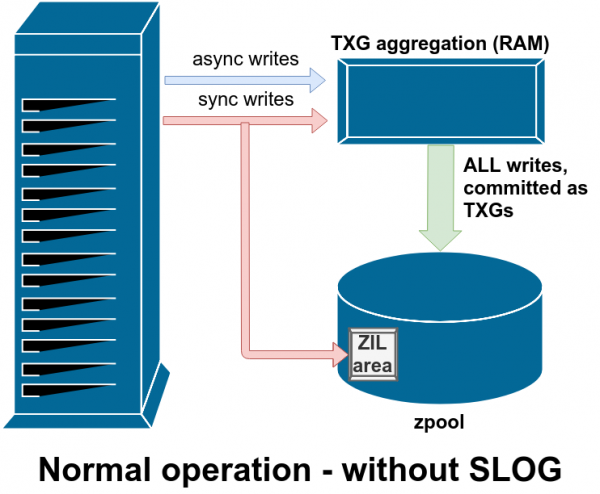
Le système ZFS gère les écritures synchrones de manière particulière — il les sauvegarde temporairement mais immédiatement dans le ZIL, avant de les enregistrer de manière permanente avec les écritures asynchrones.
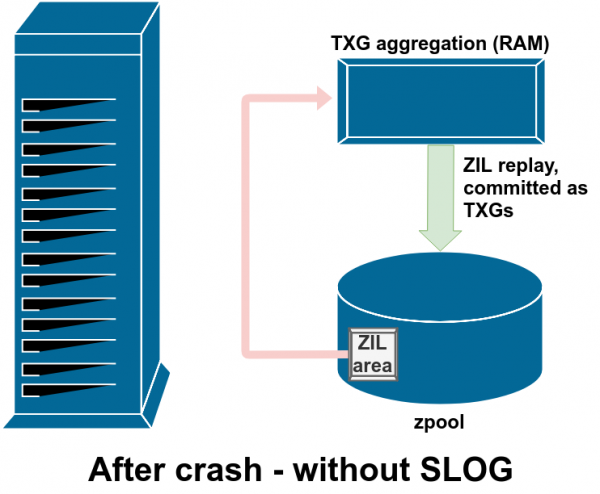
En général, les données enregistrées dans le ZIL ne sont jamais lues à nouveau. Mais cela est possible après un crash du système.
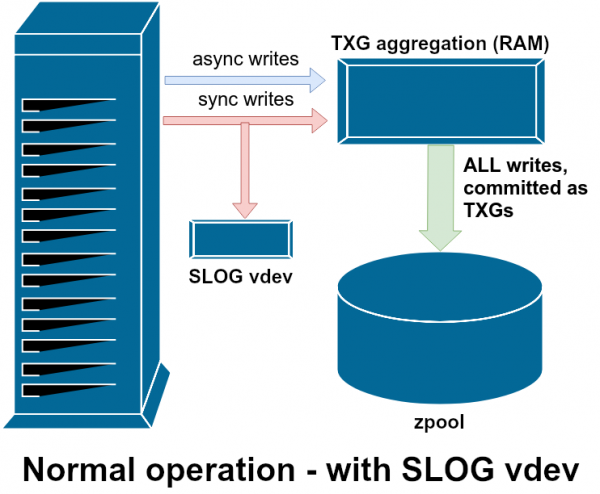
SLOG, ou dispositif LOG secondaire, est simplement un vdev spécial — et de préférence très rapide — où le ZIL peut être stocké séparément du stockage principal.
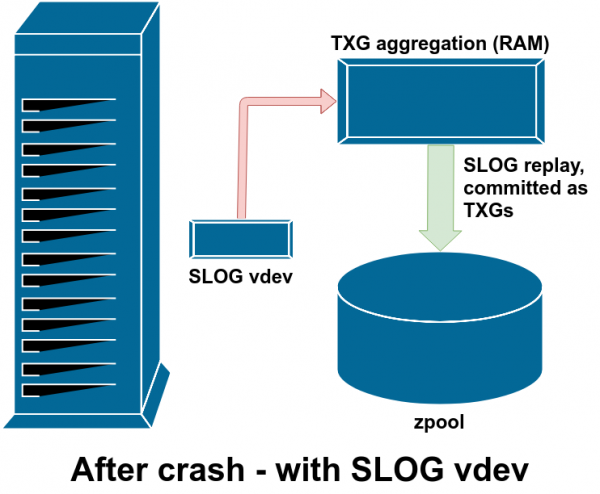
Après une panne, toutes les données non enregistrées dans le ZIL sont reproduites — dans ce cas, le ZIL se trouve sur SLOG, donc elles sont reproduites exactement à partir de là.
Il existe deux catégories principales d'opérations d'écriture — synchrones (sync) et asynchrones (async). Pour la plupart des charges de travail, la grande majorité des opérations d'écriture sont asynchrones — le système de fichiers permet de les agréger et de les renvoyer par paquets, réduisant la fragmentation et augmentant considérablement la bande passante.
Les écritures synchrones sont tout autre chose. Lorsque l'application demande une écriture synchrone, elle dit au système de fichiers : « Tu dois l'enregistrer dans la mémoire non volatile. en ce moment, et tant que ce n'est pas fait, je ne peux rien faire d'autre. » Par conséquent, les écritures synchrones doivent être immédiatement enregistrées sur le disque — et si cela augmente la fragmentation ou réduit la bande passante, tant pis.
ZFS gère les écritures synchrones différemment des systèmes de fichiers traditionnels — au lieu de les injecter immédiatement dans le stockage standard, ZFS les enregistre dans une zone de stockage spéciale appelée journal d'intentions ZFS — ZFS Intent Log, ou ZIL. L'astuce est que ces écritures également restent en mémoire, agrégeant ensemble les requêtes d'écriture asynchrones normales, pour être ensuite vidées dans le stockage comme des TXG (groupes de transactions, Transaction Groups) tout à fait normaux.
Dans un fonctionnement normal, le ZIL est écrit et jamais relu. Lorsque, après quelques instants, les écritures du ZIL sont enregistrées dans le stockage principal sous forme de TXG normales depuis la mémoire vive, elles sont détachées du ZIL. La seule fois où quelque chose est lu dans le ZIL, c'est lors de l'importation du pool.
Si une défaillance de ZFS se produit — défaillance du système d'exploitation ou coupure de courant — alors que des données sont présentes dans le ZIL, ces données seront lues lors de la prochaine importation du pool (par exemple, lors du redémarrage d'un système après une panne). Tout ce qui se trouve dans le ZIL sera lu, agrégé en groupes TXG, enregistré dans le stockage principal, puis détaché du ZIL au cours du processus d'importation.
L'une des classes auxiliaires de vdev s'appelle LOG ou SLOG, un dispositif secondaire LOG. Son unique tâche est de fournir au pool un vdev séparé et, de préférence, beaucoup plus rapide, avec une très haute résistance à l'écriture, pour stocker le ZIL, au lieu de stocker le ZIL sur le vdev principal. Le ZIL lui-même se comporte de la même manière, quelle que soit sa localisation de stockage, mais si le vdev avec LOG présente une très haute performance d'écriture, les écritures synchrones se produiront plus rapidement.
Ajouter un vdev avec LOG au pool ne peut en aucun cas améliorer la performance des écritures asynchrones – même si vous forcez toutes les écritures dans le ZIL avec zfs set sync=always, elles resteront toutefois liées au stockage principal dans le TXG de la même manière et au même rythme que sans journal. La seule amélioration directe des performances est le délai des écritures synchrones (puisqu'une vitesse de journal plus élevée accélère l'exécution des opérations. sync).
Cependant, dans un environnement qui nécessite déjà un grand nombre d'écritures synchrones, un vdev LOG peut indirectement accélérer l'écriture asynchrone et la lecture sans cache. Le déchargement des écritures ZIL sur un vdev LOG distinct signifie moins de concurrence pour les IOPS dans le stockage primaire, ce qui améliore dans une certaine mesure la performance de toutes les opérations de lecture et d'écriture.
Snapshots
Le mécanisme de Copy-on-Write est également une base nécessaire pour les snapshots atomiques de ZFS et la réplication asynchrone incrémentielle. Dans un système de fichiers actif, il existe un arbre de pointeurs marquant toutes les écritures avec les données actuelles – lorsque vous faites un snapshot, vous faites simplement une copie de cet arbre de pointeurs.
Lorsqu'une écriture est réécrite dans un système de fichiers actif, ZFS écrit d'abord une nouvelle version du bloc dans l'espace inutilisé. Il détache ensuite l'ancienne version du bloc du système de fichiers actuel. Mais si un snapshot fait référence à l'ancien bloc, il reste inchangé. L'ancien bloc ne sera en fait pas récupéré comme espace libre tant que tous les snapshots faisant référence à ce bloc n'auront pas été détruits !
Réplique
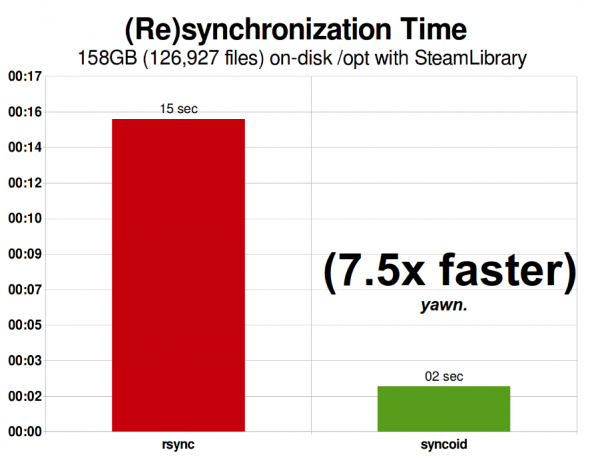
Ma bibliothèque Steam en 2015 occupait 158 GiB et comprenait 126 927 fichiers. C'est assez proche de la situation optimale pour rsync – la réplication ZFS sur le réseau était « seulement » 750 % plus rapide.
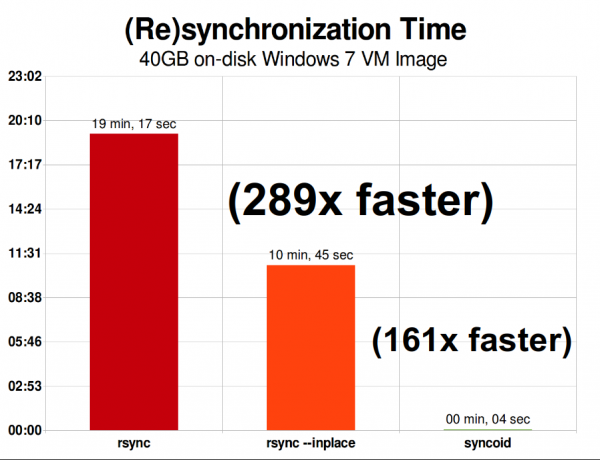
Dans le même réseau, la réplication d'un fichier image de machine virtuelle Windows 7 de 40 Go est une toute autre histoire. La réplication ZFS est 289 fois plus rapide que rsync, ou « seulement » 161 fois plus rapide si vous êtes assez averti pour appeler rsync avec l'option —inplace.
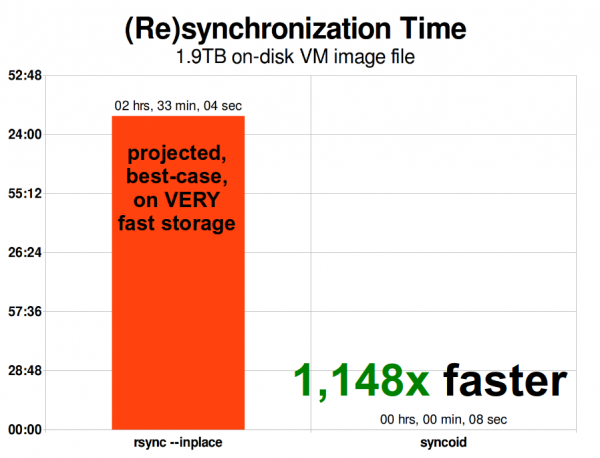
Lorsque l'image de la machine virtuelle est mise à l'échelle, les problèmes de rsync s'échelonnent avec elle. Une taille de 1,9 To n'est pas si grande pour une image de machine virtuelle moderne, mais elle est suffisamment grande pour que la réplication ZFS soit 1148 fois plus rapide que rsync, même avec l'argument rsync —inplace.
Une fois que vous comprendrez comment fonctionnent les instantanés, il ne sera pas difficile de saisir l'essence de la réplication. Puisque l'instantané est simplement un arbre de pointeurs sur des enregistrements, il en découle que lorsque nous faisons un zfs send d'un instantané, nous envoyons à la fois cet arbre et tous les enregistrements associés. Lorsque nous transférons ce zfs send dans zfs receive vers l'objet cible, il enregistre à la fois le contenu réel des blocs et l'arbre de pointeurs qui pointent vers ces blocs dans le jeu de données cible.
Les choses deviennent encore plus intéressantes avec le deuxième zfs send. Maintenant, nous avons deux systèmes, chacun contenant poolname/datasetname@1, et vous prenez un nouvel instantané poolname/datasetname@2. Ainsi, dans le pool source, vous avez datasetname@1 et datasetname@2, tandis que dans le pool cible, il y a pour l'instant seulement le premier instantané. datasetname@1.
Puisque nous avons un instantané commun entre la source et la cible, nous pouvons faire datasetname@1incrémental par-dessus. Lorsque nous disons au système zfs send zfs send -i poolname/datasetname@1 poolname/datasetname@2 , il compare les deux arbres de pointeurs. Tous les pointeurs qui existent uniquement dans, font évidemment référence à de nouveaux blocs, donc nous aurons besoin du contenu de ces blocs. @2Sur le système distant, le traitement incrémental
est tout aussi simple. D'abord, nous écrivons tous les nouveaux enregistrements inclus dans le flux send , puis nous ajoutons les pointeurs vers ces blocs. Voilà, nous avons senddans le nouveau système! @2 La réplication incrémentale asynchrone ZFS est une énorme amélioration par rapport aux méthodes antérieures qui ne reposaient pas sur des instantanés, comme rsync. Dans les deux cas, seules les données modifiées sont transférées, mais rsync doit d'abord
lire toutes les données des deux côtés pour vérifier la somme et la comparer. À l'inverse, la réplication ZFS ne lit rien d'autre que les arbres de pointeurs, et tout bloc qui n'est pas présenté dans l'instantané commun. lire с диска все данные с обеих сторон, чтобы проверить сумму и сравнить её. В отличие от этого, репликация ZFS не считывает ничего, кроме деревьев указателей — и любых блоков, которые не представлены в общем снапшоте.
Compression intégrée
Le mécanisme de copie à l'écriture simplifie également le système de compression intégrée. Dans un système de fichiers traditionnel, la compression pose des problèmes : l'ancienne version et la nouvelle version des données modifiées se trouvent dans le même espace.
Si l'on considère un fragment de données au milieu d'un fichier, qui commence sa vie comme un mégaoctet de zéros à partir de 0x00000000 et ainsi de suite, il est très facile de le compresser en un seul secteur sur le disque. Mais que se passera-t-il si nous remplaçons ce mégaoctet de zéros par un mégaoctet de données non compressibles, telles que JPEG ou un bruit pseudo-aléatoire ? Étonnamment, ce mégaoctet de données nécessitera non pas un, mais 256 secteurs de 4 Ko, alors qu'à cet endroit, un seul secteur est réservé sur le disque.
ZFS n'a pas ce problème, car les enregistrements modifiés sont toujours écrits dans l'espace inutilisé : le bloc d'origine occupe seulement un secteur de 4 Ko, et le nouvel enregistrement prendra 256, mais ce n'est pas un problème : le fragment récemment modifié du "milieu" du fichier serait écrit dans l'espace inutilisé, peu importe s'il a changé de taille ou non, donc pour ZFS, c'est une situation tout à fait normale.
La compression intégrée de ZFS est désactivée par défaut, et le système propose des algorithmes modulaires — actuellement, parmi eux LZ4, gzip (1-9), LZJB et ZLE.
- LZ4 — c'est un algorithme de compression en flux, offrant une compression et une décompression extrêmement rapides et un gain de performance pour la plupart des cas d'utilisation — même sur des CPU assez lents.
- GZIP — un algorithme respecté, connu et apprécié de tous les utilisateurs de systèmes Unix. Il peut être implémenté avec des niveaux de compression de 1 à 9, avec une augmentation du taux de compression et de l'utilisation du CPU à mesure que l'on se rapproche du niveau 9. L'algorithme convient bien à tous les cas d'utilisation textuels (ou autres très compressibles), mais provoque souvent des problèmes de CPU — utilisez-le avec prudence, surtout à des niveaux plus élevés.
- LZJB — l'algorithme original dans ZFS. Il est obsolète et ne devrait plus être utilisé, LZ4 le surpasse dans tous les domaines.
- ZLE — encodage de niveau zéro, Zero Level Encoding. Il ne modifie pas les données normales, mais compresse de grandes séquences de zéros. Utile pour des ensembles de données complètement non compressibles (par exemple, JPEG, MP4 ou d'autres formats déjà compressés), car il ignore les données non compressibles, mais compresse l'espace inutilisé dans les enregistrements finaux.
Nous recommandons la compression LZ4 pour quasiment tous les cas d'utilisation ; la pénalité de performance lors de la rencontre de données non compressibles est très faible, et remarquable la performance pour des données typiques est significativement améliorée. La copie d'une image de machine virtuelle pour une nouvelle installation du système d'exploitation Windows (OS fraîchement installé, sans données à l'intérieur) avec compression=lz4 s'est faite 27 % plus rapidement que avec compression=none, sur .
ARC — Adaptive Replacement Cache
ZFS est le seul système de fichiers moderne connu qui utilise son propre mécanisme de mise en cache de lecture, et ne dépend pas du cache de pages de l'OS pour stocker des copies des blocs récemment lus en RAM.
Bien que son cache ne soit pas sans problèmes — ZFS ne peut pas répondre à de nouvelles demandes d'allocation de mémoire aussi rapidement que le noyau, donc un nouvel appel malloc() pour l'allocation de mémoire peut échouer s'il nécessite de la RAM actuellement occupée par l'ARC. Mais il y a de bonnes raisons d'utiliser ce cache, du moins pour le moment.
Tous les systèmes d'exploitation modernes connus, y compris MacOS, Windows, Linux et BSD, utilisent un algorithme LRU (Least Recently Used) pour implémenter le cache de pages. C'est un algorithme primitif qui « remonte » le bloc mis en cache « dans la file d'attente » après chaque lecture et « pousse » les blocs « vers le bas de la file d'attente » lorsque cela est nécessaire pour ajouter de nouveaux manques de cache (blocs qui devaient être lus à partir du disque et non du cache).
En général, cet algorithme fonctionne correctement, mais dans les systèmes avec de grands ensembles de données, LRU peut facilement mener à du thrashing — une éviction de blocs souvent nécessaires pour libérer de l'espace pour des blocs qui ne seront plus jamais relus à partir du cache.
— un algorithme beaucoup moins naïf, qui peut être considéré comme un cache « pondéré ». Après chaque lecture d'un bloc en cache, il devient un peu « plus lourd » et il devient plus difficile de l'évincer — et même après éviction, le bloc est suivi pendant une période donnée. Un bloc qui a été évincé mais qui doit ensuite être relu dans le cache deviendra également « plus lourd ».
Le résultat final de tout cela est un cache avec un taux de réussite (hit ratio) beaucoup plus élevé — le rapport entre les hits dans le cache (lecture effectuée depuis le cache) et les misses (lecture depuis le disque). C'est une statistique extrêmement importante — non seulement les hits dans le cache sont servis à des vitesses bien supérieures, mais les misses dans le cache peuvent également être servies plus rapidement, car plus il y a de hits dans le cache, moins il y a de requêtes parallèles au disque et moins il y a de latence pour les misses restantes qui doivent être servies depuis le disque.
Conclusion
Après avoir étudié la sémantique de base de ZFS — comment fonctionne la copie à l'écriture, ainsi que les relations entre les pools de stockage, les dispositifs virtuels, les blocs, les secteurs et les fichiers — nous sommes prêts à discuter de la performance réelle avec des chiffres concrets.
Dans la prochaine partie, nous allons examiner la performance réelle des pools avec des vdev en miroir et RAIDz, l'un par rapport à l'autre, ainsi qu'en comparaison avec les topologies RAID traditionnelles du noyau Linux que nous avons explorées. .
Au départ, nous voulions ne considérer que les bases — les propres topologies de ZFS — mais après autant nous serons prêts à parler d'un paramétrage et d'un réglage avancés de ZFS, y compris l'utilisation de types de vdev auxiliaires, tels que L2ARC, SLOG et Special Allocation.
Source : habr.com
