

Il y a six mois — un service public pour PostgreSQL.
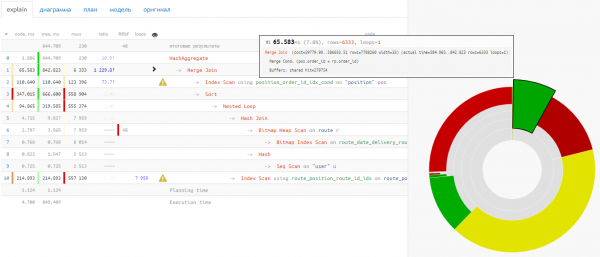
Au cours des mois écoulés, nous avons fait une présentation à PGConf.Russia 2020 sur l'accélération des requêtes SQL Et maintenant, nous sommes prêts à vous parler des nouvelles fonctionnalités que vous pouvez utiliser.
Support de différents formats de plans
Le plan du journal, avec la requête
Nous sélectionnons directement dans la console tout le bloc, à partir de la ligne avec
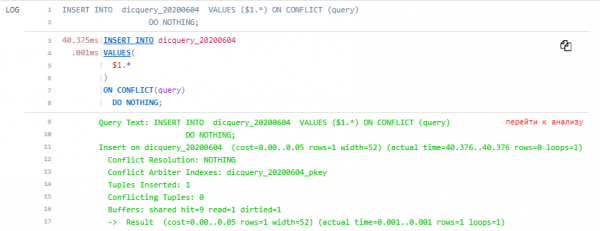
Query Text , en incluant tous les espaces devant :Query Text: INSERT INTO dicquery_20200604 VALUES ($1.*) ON CONFLICT (query) DO NOTHING; Insertion dans dicquery_20200604 (coût=0.00..0.05 lignes=1 largeur=52) (temps réel=40.376..40.376 lignes=0 boucles=1) Résolution des conflits : RIEN Index de conflit : dicquery_20200604_pkey Tuples insérés : 1 Tuples en conflit : 0 Tampons : partagé hit=9 lu=1 sali=1 -> Résultat (coût=0.00..0.05 lignes=1 largeur=52) (temps réel=0.001..0.001 lignes=1 boucles=1)
… et nous collons tout ce qui a été copié directement dans le champ pour le plan, sans rien séparer :
En sortie, nous obtenons en bonus au plan analysé également un
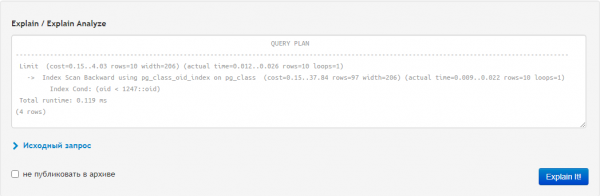
onglet « contexte » , où notre requête est présentée dans toute sa splendeur :JSON et YAML
EXPLAIN (ANALYZE, BUFFERS, FORMAT JSON) SELECT * FROM pg_class;
"[
  {
    "Plan": {
      "Node Type": "Seq Scan",
      "Parallel Aware": false,
      "Relation Name": "pg_class",
      "Alias": "pg_class",
      "Startup Cost": 0.00,
      "Total Cost": 1336.20,
      "Plan Rows": 13804,
      "Plan Width": 539,
      "Actual Startup Time": 0.006,
      "Actual Total Time": 1.838,
      "Actual Rows": 10266,
      "Actual Loops": 1,
      "Shared Hit Blocks": 646,
      "Shared Read Blocks": 0,
      "Shared Dirtied Blocks": 0,
      "Shared Written Blocks": 0,
      "Local Hit Blocks": 0,
      "Local Read Blocks": 0,
      "Local Dirtied Blocks": 0,
      "Local Written Blocks": 0,
      "Temp Read Blocks": 0,
      "Temp Written Blocks": 0
    },
    "Planning Time": 5.135,
    "Triggers": [
    ],
    "Execution Time": 2.389
  }
]"
Que ce soit avec des guillemets externes, comme les copie pgAdmin, ou sans — nous mettons dans le même champ, au final — c'est magnifique :Visualisation avancée
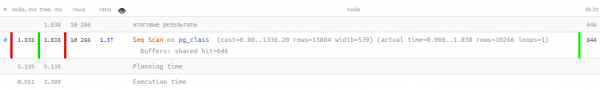
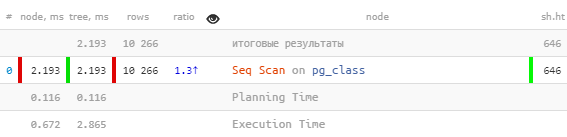
Temps de planification / Temps d'exécution
Maintenant, il est plus clair où est passé le temps supplémentaire lors de l'exécution de la requête :
Temps d'E/S
Parfois, on doit faire face à la situation où, dans le plan, il semble qu'il n'y avait pas trop de ressources lues/écrites, mais le temps d'exécution est anormalement long.
Ici, il faut dire : "
Oh, peut-être que ce moment-là, le disque sur le serveur était trop chargé, donc il y a eu beaucoup de temps de lecture !" Mais ce n'est pas très précis…" Mais ce n'est pas vraiment précis..."
Mais cela peut être déterminé de manière absolument fiable. En effet, parmi les options de configuration du serveur PG, il y a :
Il permet de mesurer le temps des opérations d'entrée/sortie. Ce paramètre est désactivé par défaut, car il nécessite de demander en continu l'heure actuelle au système d'exploitation, ce qui peut considérablement ralentir le fonctionnement sur certaines plates-formes. Pour évaluer le coût de la mesure du temps sur votre plate-forme, vous pouvez utiliser l'outil pg_test_timing. Les statistiques d'entrée/sortie peuvent être obtenues via la vue pg_stat_database, dans la sortie d'EXPLAIN (lorsque le paramètre BUFFERS est utilisé) et via la vue pg_stat_statements.
Ce paramètre peut également être activé dans le cadre d'une session locale :
SET track_io_timing = TRUE;Eh bien, maintenant vient le meilleur — nous avons appris à comprendre et à représenter ces données en tenant compte de toutes les transformations de l'arbre d'exécution :
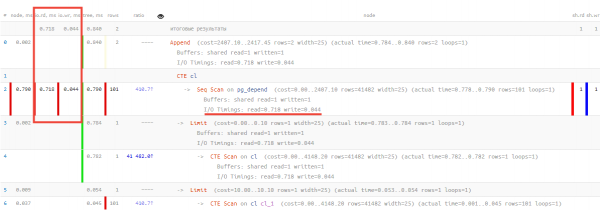
On peut ainsi remarquer que sur 0.790 ms de temps d'exécution, 0.718 ms ont été consacrées à la lecture d'une seule page de données, 0.044 ms à son écriture, et il n'a fallu que 0.028 ms pour toute autre activité utile !
L'avenir avec PostgreSQL 13
Vous pouvez consulter l'intégralité des nouveautés dans , et nous allons nous concentrer spécifiquement sur les changements dans les plans.
Planning buffers
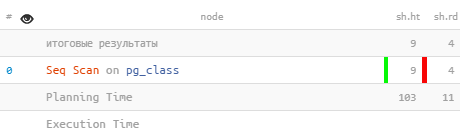
La prise en compte des ressources allouées au planificateur trouve également son reflet dans un autre patch, ne se rapportant pas à pg_stat_statements. EXPLAIN avec l'option BUFFERS indiquera le nombre de buffers utilisés lors de l'étape de planification :
 Seq Scan on pg_class (actual rows=386 loops=1)
   Buffers: shared hit=9 read=4
 Planning Time: 0.782 ms
   Buffers: shared hit=103 read=11
 Execution Time: 0.219 ms
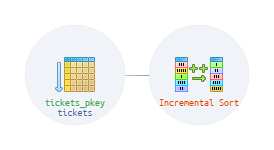
Tri incrémentiel
Dans les cas où un tri est nécessaire sur plusieurs clés (k1, k2, k3…), le planificateur peut désormais tirer parti du fait que les données sont déjà triées selon certaines des premières clés (par exemple, k1 et k2). Dans ce cas, il n'est pas nécessaire de trier toutes les données à nouveau, mais de les diviser en groupes séquentiels avec des valeurs k1 et k2 identiques, et de "trier" en fonction de la clé k3.
Ainsi, l'ensemble du tri se divise en plusieurs tris séquentiels de plus petite taille. Cela réduit la mémoire nécessaire et permet également de fournir les premières données plus tôt, avant l'achèvement complet de tout le tri.
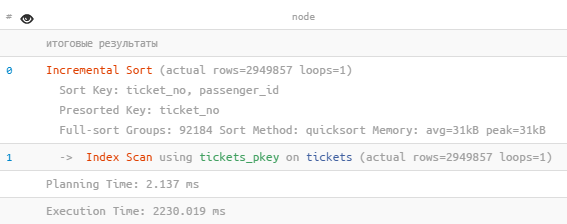
 Tri incrémental (lignes actuelles=2949857 boucles=1)
   Clé de tri : ticket_no, passenger_id
   Clé pré-triée : ticket_no
   Groupes de tri complet : 92184 Méthode de tri : quicksort Mémoire : avg=31kB peak=31kB
   -> Scan d'index utilisant tickets_pkey sur tickets (lignes actuelles=2949857 boucles=1)
 Temps de planification : 2.137 ms
 Temps d'exécution : 2230.019 ms
Améliorations UI/UX
Captures d'écran, elles sont partout !
Maintenant, chaque onglet a la possibilité de rapidement prendre une capture d'écran de l'onglet dans le presse-papiers sur toute la largeur et la profondeur de l'onglet — « viseur » en haut à droite:
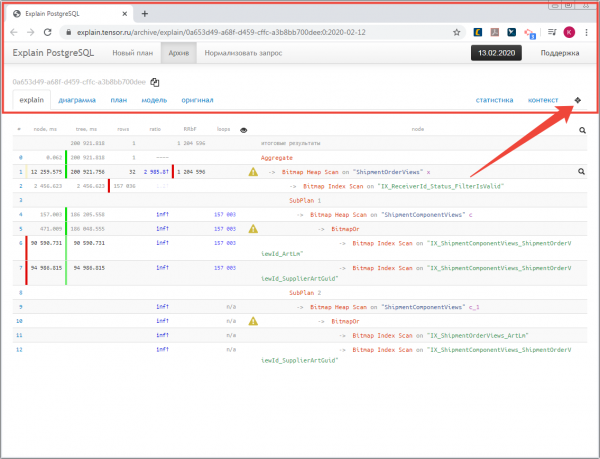
En fait, la plupart des images pour cette publication ont été obtenues de cette manière.
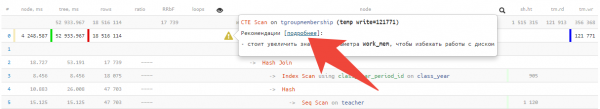
Recommandations sur les nœuds
Non seulement elles sont devenues plus nombreuses, mais on peut aussi , en suivant le lien :
Suppression de l'archive
Certains ont vraiment demandé d'ajouter la possibilité de supprimer « complètement » même les plans non publiés dans l'archive — s'il vous plaît, il suffit de cliquer sur l'icône correspondante :
Eh bien, n'oublions pas que nous avons un , où vous pouvez écrire vos commentaires et suggestions.
Source : habr.com
