

Décryptage de la présentation de 2015 par Alexey Lesovskiy "Plongée dans les statistiques internes de PostgreSQL"
Avertissement de l'auteur de la présentation : Je note que cette présentation date de novembre 2015 — plus de 4 ans se sont écoulés et beaucoup de temps a passé. La version examinée dans cette présentation, 9.4, n'est plus supportée. Au cours des 4 dernières années, 5 nouvelles versions ont été publiées, avec de nombreuses nouveautés, améliorations et modifications concernant les statistiques et une partie du contenu est devenue obsolète et non pertinente. Au fil de la revue, j'ai essayé de marquer ces endroits pour ne pas induire le lecteur en erreur. Je n'ai pas réécrit ces sections, elles sont nombreuses et cela donnerait finalement une présentation complètement différente.
Le SGBD PostgreSQL est un mécanisme vaste, composé de nombreuses sous-systèmes, dont le fonctionnement harmonieux dépend directement de la performance du SGBD. En cours d'exploitation, des statistiques et des informations sur le fonctionnement des composants sont collectées, ce qui permet d'évaluer l'efficacité de PostgreSQL et de prendre des mesures pour améliorer la performance. Cependant, cette information est très abondante et présentée de manière assez simplifiée. Le traitement et l'interprétation de ces informations peuvent parfois être des tâches tout sauf triviales, et le "zoo" d'outils et d'utilitaires peut facilement déstabiliser même un DBA avancé.
Bonjour ! Je m'appelle Alexey. Comme l'a dit Ilya, je vais parler de la statistique de PostgreSQL.
Statistiques d'activité de PostgreSQL. PostgreSQL dispose de deux statistiques. La statistique d'activité, dont il sera question, et la statistique du planificateur sur la distribution des données. Je vais parler précisément de la statistique d'activité de PostgreSQL, qui nous permet de juger de la performance et de chercher à l'améliorer.
Je vais expliquer comment utiliser efficacement les statistiques pour résoudre divers problèmes que vous rencontrez ou pourriez rencontrer.
Qu'est-ce qui ne sera pas abordé dans la présentation ? Je ne vais pas traiter des statistiques du planificateur, car c'est un sujet distinct pour une autre présentation sur la manière dont les données sont stockées dans la base et comment le planificateur de requêtes perçoit les caractéristiques qualitatives et quantitatives de ces données.
Et il n'y aura pas d'examens d'outils, je ne vais pas comparer un produit à un autre. Il n'y aura aucune publicité. Écartons cela.
Je veux vous montrer que l'utilisation des statistiques est bénéfique. C'est nécessaire. Les utiliser n'est pas effrayant. Nous aurons simplement besoin d'un SQL standard et de connaissances de base en SQL.
Nous allons parler de la sélection des statistiques pour résoudre des problèmes.
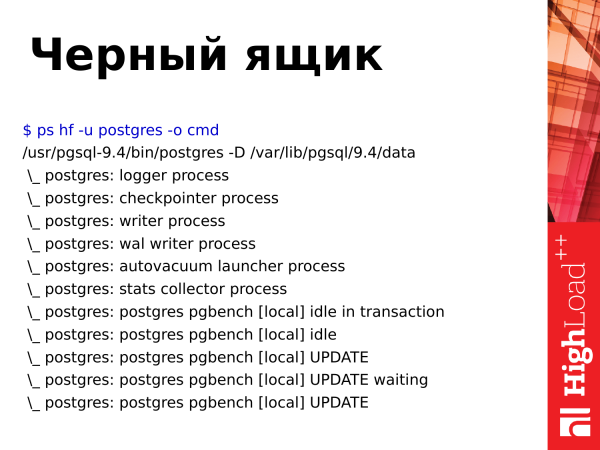
Si nous regardons PostgreSQL et exécutons une commande dans le système d'exploitation pour voir les processus, nous verrons une "boîte noire". Nous verrons certains processus qui font quelque chose, et grâce à leur nom, nous pouvons avoir une idée de ce qu'ils font. Mais en réalité, c'est une boîte noire, nous ne pouvons pas y jeter un coup d'œil.
Nous pouvons observer la charge du processeur dans top, nous pouvons vérifier l'utilisation de la mémoire à l'aide d'outils système, mais nous ne pourrons pas regarder à l'intérieur de PostgreSQL. Pour cela, nous avons besoin d'autres outils.
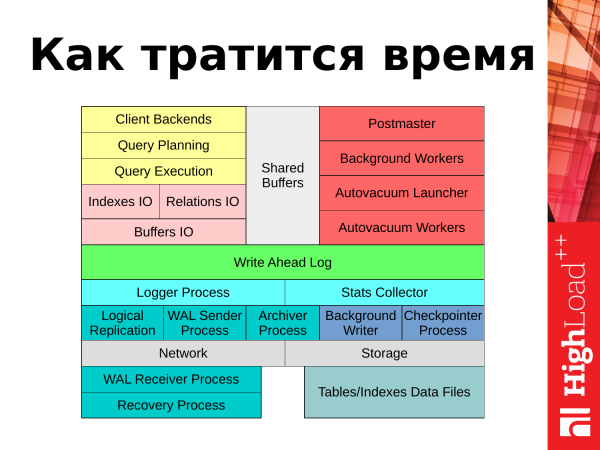
Et en continuant, je vais expliquer où le temps est dépensé. Si nous imaginons PostgreSQL sous la forme d'un schéma, nous serons en mesure de répondre à la question de savoir où le temps est dépensé. Il y a deux aspects : le traitement des requêtes clients venant des applications et les tâches en arrière-plan que PostgreSQL exécute pour maintenir son bon fonctionnement.
Si nous commençons à examiner à partir du coin supérieur gauche, nous pouvons suivre comment les requêtes des clients sont traitées. Une requête arrive de l'application et, pour continuer, une session cliente est ouverte. La requête est transmise au planificateur. Le planificateur construit le plan de la requête. Celui-ci est ensuite envoyé pour exécution. Il y a un certain I/O bloc de données lié aux tables et aux index. Les données nécessaires sont lues des disques dans la mémoire dans une zone spéciale appelée "shared buffers". Les résultats de la requête, s'il s'agit de mises à jour ou de suppressions, sont enregistrés dans le journal des transactions dans le WAL. Certaines informations statistiques sont consignées dans le journal ou dans le collecteur de statistiques. Et le résultat de la requête est renvoyé au client. Après cela, le client peut tout répéter avec une nouvelle requête.
Qu'en est-il des tâches en arrière-plan et des processus en arrière-plan ? Nous avons plusieurs processus qui assurent le bon fonctionnement et maintiennent la base de données en mode opérationnel normal. Ces processus seront également abordés dans la présentation : autovacuum, checkpointer, processus liés à la réplication, background writer. Je vais traiter chacun d'eux au fur et à mesure de la présentation.
Quels problèmes y a-t-il avec les statistiques ?
- Il y a beaucoup d'informations. PostgreSQL 9.4 offre 109 métriques pour consulter les données statistiques. Cependant, si la base de données contient de nombreuses tables, schémas ou bases, toutes ces métriques devront être multipliées par le nombre correspondant de tables et de bases. Cela signifie qu'il y a encore plus d'informations. Il est donc très facile de s'y noyer.
- Le problème suivant est que les statistiques sont présentées sous forme de compteurs. Si nous regardons ces statistiques, nous verrons des compteurs qui augmentent constamment. Et si beaucoup de temps s'est écoulé depuis la dernière réinitialisation des statistiques, nous verrons des valeurs de plusieurs milliards. Et cela ne nous dit rien.
- Il n'y a pas d'historique. Si vous avez eu une panne, quelque chose qui s'est produit il y a 15-30 minutes, vous ne pourrez pas utiliser les statistiques pour voir ce qui s'est passé à ce moment-là. C'est un problème.
- L'absence d'un outil intégré dans PostgreSQL est un problème. Les développeurs du noyau ne fournissent aucun utilitaire. Ils n'ont rien de tel. Ils fournissent simplement des statistiques dans la base. Utilisez-le, faites-en des requêtes, faites ce que vous voulez.
- Comme il n'y a pas d'outil intégré dans PostgreSQL, cela entraîne un autre problème. De nombreux outils tiers existent. Chaque entreprise ayant un minimum de compétences essaie d'écrire son propre programme. Au final, la community dispose de nombreux outils pour travailler avec les statistiques. Certains outils offrent certaines fonctionnalités, d'autres n'en possèdent pas, ou proposent de nouvelles fonctionnalités. La situation se dessine alors, où il faut utiliser deux, trois ou quatre outils qui se chevauchent et possèdent différentes fonctions. C'est très désagréable.
Que faut-il en conclure ? Il est important de savoir comment obtenir des statistiques directement, afin de ne pas dépendre des programmes, ou d'améliorer soi-même ces programmes : ajouter des fonctionnalités pour en tirer ses propres bénéfices.
Des connaissances de base en SQL sont nécessaires. Pour obtenir des données à partir des statistiques, vous devez écrire des requêtes SQL, c'est-à-dire que vous devez savoir comment créer des sélections et des jointures.
Les statistiques nous proposent plusieurs éléments. Ils peuvent être classés en catégories.
- La première catégorie concerne les événements qui se produisent dans la base de données. C'est lorsque quelque chose se produit dans la base : une requête, un accès à une table, un autovacuum, des commits, tout cela constitue des événements. Les compteurs correspondants à ces événements s'incrémentent. Nous pouvons suivre ces événements.
- La deuxième catégorie concerne les propriétés des objets tels que les tables et les bases. Ils ont des propriétés. C'est la taille des tables. Nous pouvons suivre la croissance des tables et des indices. Nous pouvons observer les changements dynamiques.
- Et la troisième catégorie est le temps consacré à un événement. Une requête est un événement. Elle a sa propre mesure de durée spécifique. Voici lorsqu'elle a débuté, ici quand elle s'est terminée. Nous pouvons le suivre. Cela inclut le temps de lecture d'un bloc depuis le disque ou d'écriture. Ces choses-là sont également suivies.
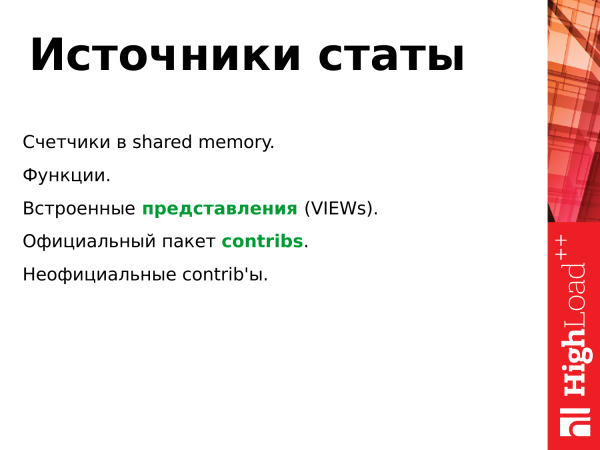
Les sources des statistiques sont présentées comme suit :
- Dans la mémoire partagée (shared buffers), il y a un segment pour accueillir des données statistiques, et il y a ces compteurs qui s'incrémentent constamment lorsque certains événements se produisent ou que certaines situations apparaissent dans le fonctionnement de la base de données.
- Tous ces compteurs ne sont pas accessibles à l'utilisateur et même pas à l'administrateur. Ce sont des éléments de bas niveau. Pour y accéder, PostgreSQL fournit une interface sous forme de fonctions SQL. Nous pouvons effectuer des sélections avec ces fonctions et obtenir une métrique (ou un ensemble de métriques).
- Cependant, l'utilisation de ces fonctions n'est pas toujours pratique, c'est pourquoi ces fonctions constituent la base des vues (VIEWs). Ce sont des tables virtuelles qui fournissent des statistiques pour un sous-système particulier ou pour un ensemble d'événements dans la base de données.
- Ces vues intégrées (VIEWs) constituent l'interface principale de l'utilisateur pour travailler avec les statistiques. Elles sont disponibles par défaut sans configuration supplémentaire, vous pouvez les utiliser immédiatement, voir et extraire des informations à partir d'elles. Il existe également des contribs. Les contribs sont officielles. Vous pouvez installer le paquet postgresql-contrib (par exemple, postgresql94-contrib), charger le module nécessaire dans la configuration, spécifier des paramètres pour celui-ci, redémarrer PostgreSQL et vous pouvez l'utiliser. (Remarque. Selon la distribution, dans les dernières versions, le paquet contrib fait partie du paquet principal.).
- Il existe des contrib non officiels. Ils ne sont pas inclus dans la distribution standard de PostgreSQL. Ils doivent être soit compilés, soit installés en tant que bibliothèque. Les options peuvent varier selon l'inventivité du développeur de ce contrib non officiel.
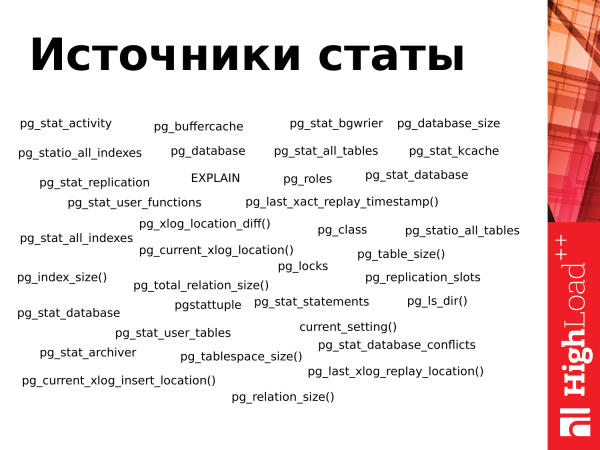
Cette diapositive présente toutes les vues (VIEWs) et certaines des fonctions disponibles dans PostgreSQL 9.4. Comme nous le voyons, il y en a beaucoup. Il est assez facile de s'y perdre si vous êtes confronté à cela pour la première fois.
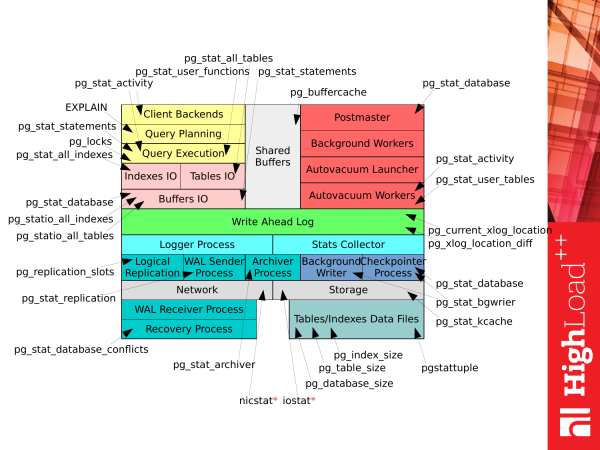
Cependant, si nous prenons l'image précédente Comment le temps est dépensé sur PostgreSQL et que nous le comparons avec cette liste, nous obtenons une telle image. Chaque vue (VIEWs) ou chaque fonction peut être utilisée à des fins spécifiques pour obtenir des statistiques pertinentes lorsque PostgreSQL est en fonctionnement. Nous pouvons déjà obtenir des informations sur le fonctionnement du sous-système.
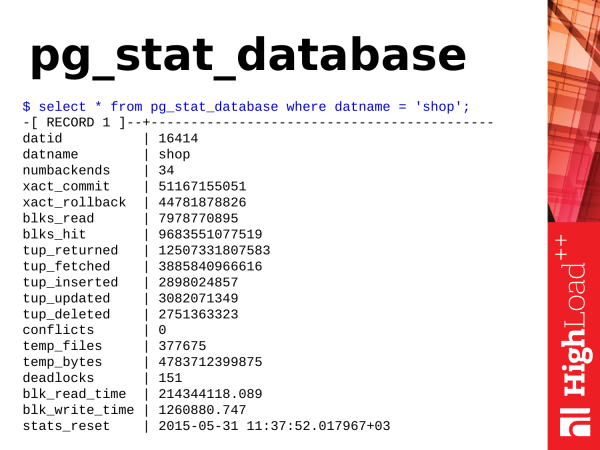
La première chose que nous examinerons est pg_stat_database. Comme nous le voyons, il s'agit d'une vue. Elle contient beaucoup d'informations. Des informations très variées. Et elle fournit des connaissances très utiles sur ce qui se passe dans la base de données.
Que pouvons-nous en tirer d'utile ? Commençons par les choses les plus simples.
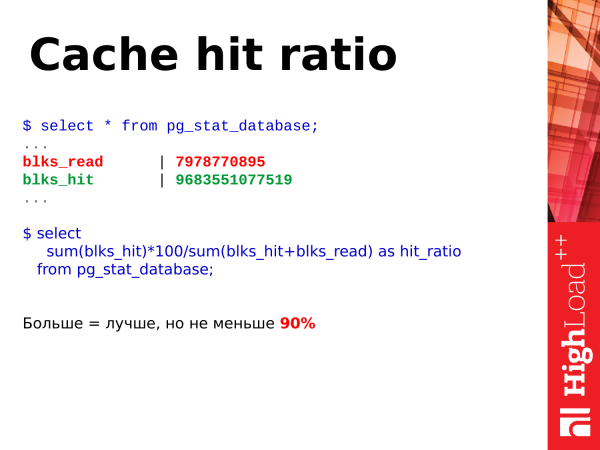
select
sum(blks_hit)*100/sum(blks_hit+blks_read) as hit_ratio
from pg_stat_database;
La première chose que nous pouvons examiner est le pourcentage de hits en cache. Le pourcentage de hits en cache est une métrique utile. Il permet d'évaluer combien de données sont récupérées à partir du cache des buffers partagés et combien sont lues depuis le disque.
Il est évident que plus notre taux de hit en cache est élevé, mieux c'est. Nous évaluons cette métrique en pourcentage. Par exemple, si notre ratio de hits en cache dépasse 90 %, c'est bon. S'il descend en dessous de 90 %, cela signifie que nous n'avons pas assez de mémoire pour maintenir la "tête" chaude des données en mémoire. Et pour utiliser ces données, PostgreSQL doit accéder au disque, ce qui est plus lent que si les données étaient lues depuis la mémoire. Il faut alors envisager d'augmenter la mémoire : soit augmenter les buffers partagés, soit ajouter de la mémoire physique (RAM).
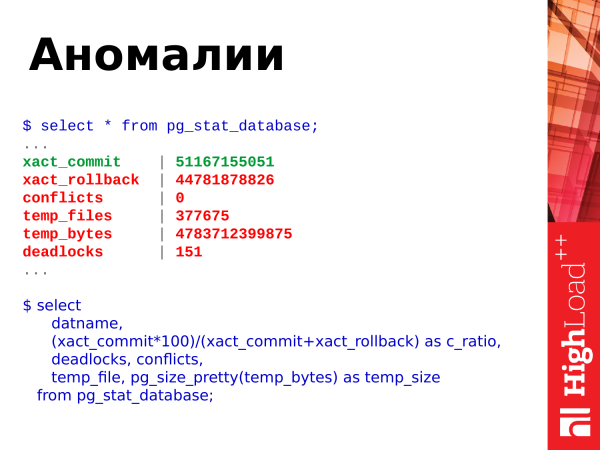
select
datname,
(xact_commit*100)/(xact_commit+xact_rollback) as c_ratio,
deadlocks, conflicts,
temp_file, pg_size_pretty(temp_bytes) as temp_size
from pg_stat_database;
Que peut-on encore tirer de cette vue ? Nous pouvons examiner les anomalies survenant dans la base. Que montre-t-elle ? Il y a des commits, des rollbacks, la création de fichiers temporaires, leur taille, des deadlocks et des conflits.
Nous pouvons profiter de cette requête. Ce SQL est assez simple. Et nous pouvons voir ces données de notre côté.
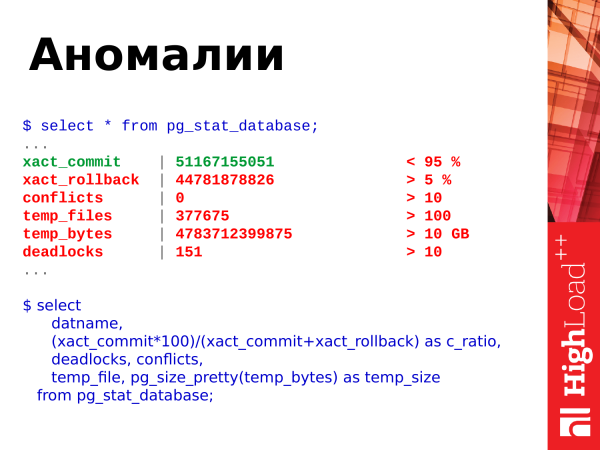
Et ici, nous avons directement les valeurs seuils. Nous regardons le ratio entre commits et rollbacks. Les commits – ce sont des confirmations de transaction réussies. Les rollbacks – ce sont des annulations, c'est-à-dire qu'une transaction a réalisé un certain travail, a sollicité la base de données, a effectué des calculs, puis a échoué, et les résultats de la transaction sont rejetés. Un nombre croissant de rollbacks est mauvais. Il faut donc les éviter et corriger le code pour que cela ne se produise pas.
Les conflits sont liés à la réplication. Il est également nécessaire de les éviter. Si vous avez des requêtes qui s'exécutent sur une réplique et qu'il y a des conflits, vous devez analyser ces conflits, voir ce qui se passe. Vous pouvez trouver des détails dans les journaux. Et il faut résoudre les situations conflictuelles pour que les requêtes de l'application fonctionnent sans erreur.
Les deadlocks sont aussi une mauvaise situation. Lorsque des requêtes se battent pour des ressources, une requête accède à une ressource et prend un verrou, tandis qu'une autre requête accède à une deuxième ressource et prend également un verrou. Ensuite, les deux requêtes accèdent l'une à l'autre pour libérer le verrou. C'est aussi un problème. Ils doivent être résolus au niveau de la réécriture des applications et de la sérialisation de l'accès aux ressources. Et si vous constatez que vos deadlocks augmentent constamment, vous devez examiner les détails dans les journaux, analyser les situations qui se présentent et voir où est le problème.
Les fichiers temporaires sont également problématiques. Lorsque la requête d'un utilisateur manque de mémoire pour stocker des données temporaires, elle crée un fichier sur le disque. Et toutes les opérations qu'elle aurait pu effectuer dans le tampon temporaire en mémoire commencent à s'exécuter sur le disque. C'est lent. Cela augmente le temps d'exécution de la requête. Et le client qui a envoyé la requête à PostgreSQL recevra une réponse un peu plus tard. Si toutes ces opérations sont exécutées en mémoire, Postgres répondra beaucoup plus rapidement et le client devra attendre moins longtemps.
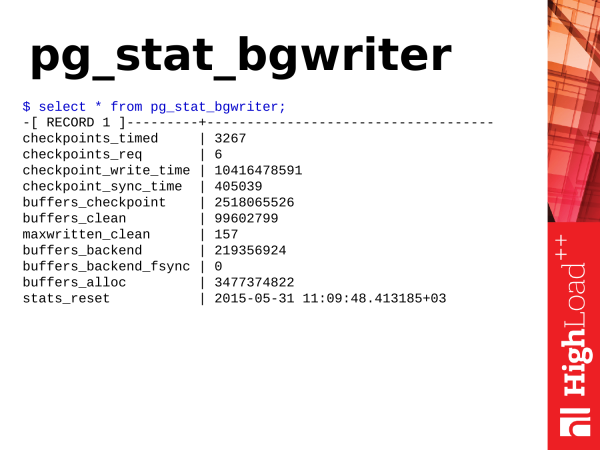
Pg_stat_bgwriter est une vue qui décrit le fonctionnement de deux sous-systèmes en arrière-plan de PostgreSQL : checkpointer et background writer.
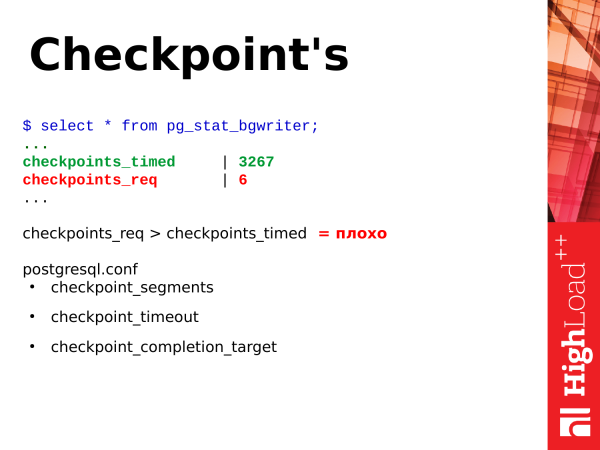
Tout d'abord, examinons les points de contrôle, dits checkpoints. checkpoints. Qu'est-ce qu'un point de contrôle ? Un point de contrôle est une position dans le journal des transactions qui indique que toutes les modifications de données enregistrées dans le journal ont été synchronisées avec les données sur le disque. Le processus peut être long, en fonction de la charge de travail et des paramètres, et consiste principalement à synchroniser les pages sales dans les tampons partagés avec les fichiers de données sur le disque. Pourquoi cela est-il nécessaire ? Si PostgreSQL devait constamment accéder au disque pour en extraire et y écrire des données à chaque fois, cela serait lent. C'est pourquoi PostgreSQL dispose d'un segment de mémoire dont la taille dépend des paramètres de configuration. Postgres place dans cette mémoire des données opérationnelles pour un traitement ultérieur ou une restitution sur demande. En cas de requêtes de modification de données, celles-ci sont modifiées, et nous obtenons deux versions des données. L'une est en mémoire, l'autre est sur le disque. Il est donc nécessaire de synchroniser ces données périodiquement. Nous devons synchroniser ce qui a été modifié en mémoire sur le disque. Ceci est nécessaire pour le checkpoint.
Le checkpoint parcourt les tampons partagés, marque les pages sales comme étant nécessaires pour le checkpoint. Il effectue ensuite un second passage dans les tampons partagés. Et les pages qui ont été marquées pour le checkpoint sont alors synchronisées. Ainsi, la synchronisation des données avec le disque est effectuée.
Il existe deux types de points de contrôle. Un checkpoint se produit selon un délai. C'est un checkpoint utile et bon – checkpoint_timed. Et il y a les checkpoints à la demande – checkpoint required. Ce type de point de contrôle se produit lorsque nous avons des écritures de données très importantes. Nous avons enregistré un grand nombre de journaux de transactions. PostgreSQL estime qu'il doit synchroniser tout cela le plus rapidement possible, effectuer un point de contrôle et continuer.
Et si vous avez regardé les statistiques pg_stat_bgwriter et constaté que vous avez checkpoint_req beaucoup plus élevé que checkpoint_timed, cela n'est pas bon. Pourquoi est-ce mauvais ? Cela signifie que PostgreSQL est constamment sous pression pour écrire des données sur le disque. Le checkpoint à intervalles réguliers est moins stressant et s'effectue selon un calendrier interne, s'étalant ainsi dans le temps. PostgreSQL a la possibilité de faire des pauses dans son fonctionnement et de ne pas solliciter le système de disques. Cela est bénéfique pour PostgreSQL. Et les requêtes exécutées pendant le checkpoint ne souffriront pas de la sollicitation du système de disques.
Et pour le réglage du checkpoint, il y a trois paramètres :
checkpoint_segments.checkpoint_timeout.checkpoint_completion_target.
Ils permettent de réguler le fonctionnement des points de contrôle. Mais je ne vais pas m'attarder sur eux. Leur influence est déjà un sujet à part.
Attention : La version 9.4 évoquée dans le rapport n'est plus d'actualité. Dans les versions modernes de PostgreSQL, le paramètre checkpoint_segments a été remplacé par les paramètres min_wal_size et max_wal_size.
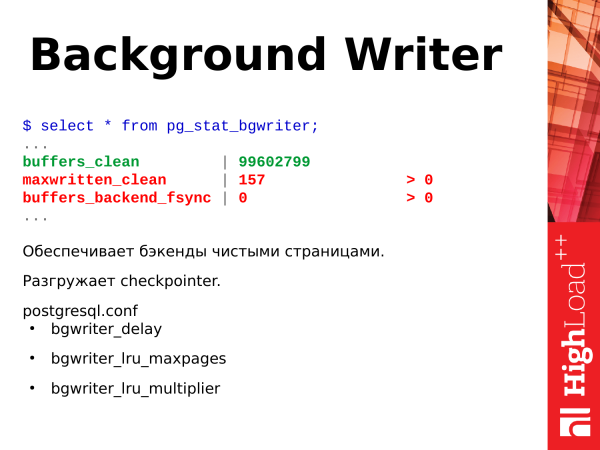
Le sous-système suivant est le writer de fond — background writer. Que fait-il ? Il fonctionne en continu dans une boucle infinie. Il scanne les pages dans les buffers partagés et les pages sales qu'il trouve, il les écrase sur le disque. Ainsi, il aide le checkpointer à faire moins de travail lors de l'exécution des points de contrôle.
À quoi sert-il encore ? Il répond aux besoins en pages propres dans les buffers partagés si elles sont nécessaires (en grande quantité et immédiatement) pour le placement des données. Supposons qu'il se produise une situation où des pages propres sont nécessaires pour exécuter une requête et elles sont déjà présentes dans les buffers partagés. PostgreSQL backend les prend simplement et les utilise, il n'a pas besoin de nettoyer lui-même quoi que ce soit. Mais si, par malheur, il n'y a pas de telles pages, le backend suspend son travail et commence à rechercher des pages à écraser sur le disque pour les utiliser — ce qui affecte négativement le temps d'exécution de la requête en cours. Si vous voyez que votre paramètre max_written_clean est élevé, cela signifie que le writer de fond ne parvient pas à faire son travail et qu'il faut augmenter les paramètres bgwriter_lru_maxpages, pour qu'il puisse faire plus de travail lors d'un cycle, nettoyer plus de pages.
Et un autre indicateur très utile – c'est buffers_backend_fsync. Les backends ne font pas de fsync car c'est lent. Ils transmettent le fsync au-dessus de la pile d'E/S au checkpointer. Le checkpointer a sa propre file d'attente, il traite périodiquement les fsync et synchronise les pages en mémoire avec les fichiers sur le disque. Si la file d'attente du checkpointer est grande et remplie, le backend est contraint de faire lui-même un fsync, ce qui ralentit le travail du backend, c'est-à-dire que le client recevra une réponse plus tard que nécessaire. Si vous constatez que cette valeur est supérieure à zéro, c'est déjà un problème etil faut prêter attention aux réglages du writer de fond et également évaluer les performances du sous-système de disque. il est nécessaire de prêter attention aux réglages de l'écrivain de fond et d'évaluer également la performance du sous-système de disque.
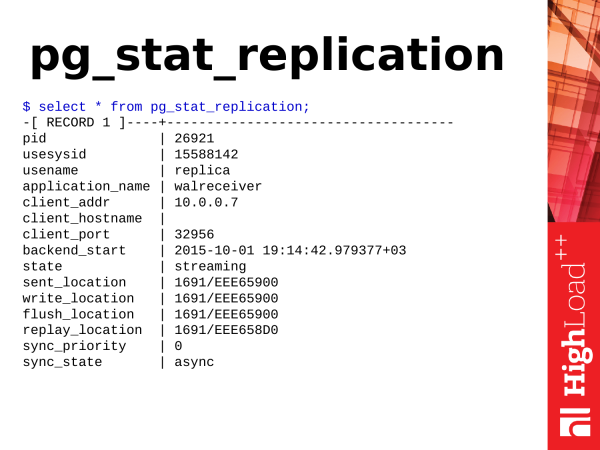
Attention : _Le texte suivant décrit les représentations statistiques liées à la réplication. La plupart des noms de représentations et de fonctions ont été renommés dans Postgres 10. L'essentiel des renommages était axé sur le remplacement xlog sur wal et location sur lsn dans les noms des fonctions/représentations, etc. Un exemple précis, la fonction pg_xlog_location_diff() a été renommée en pg_wal_lsn_diff()._
Ici aussi, nous avons beaucoup de choses. Mais nous n'aurons besoin que des points liés à la location.
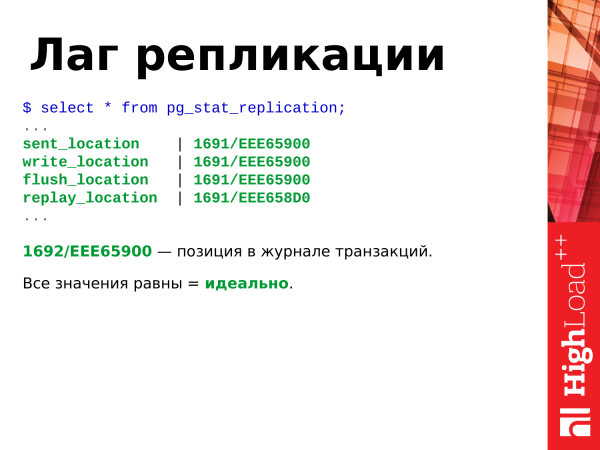
Si nous voyons que toutes les valeurs sont égales, c'est une option idéale et la réplique ne prend pas de retard sur le maître.
Cette position hexadécimale est la position dans le journal des transactions. Elle augmente constamment si la base a une certaine activité : insertions, suppressions, etc.
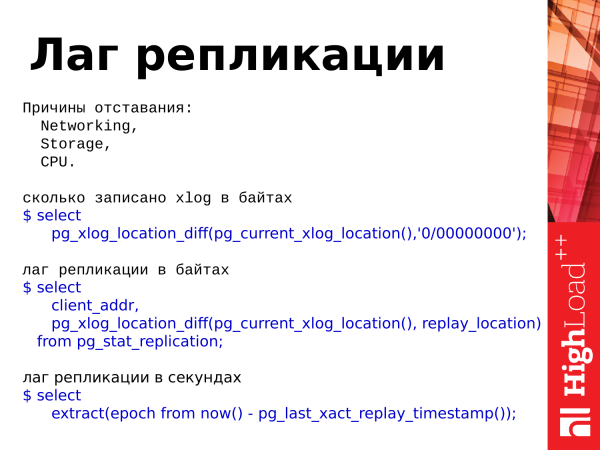
combien de xlog est enregistré en octets
$ select
pg_xlog_location_diff(pg_current_xlog_location(),'0/00000000');
retard de réplication en octets
$ select
client_addr,
pg_xlog_location_diff(pg_current_xlog_location(), replay_location)
from pg_stat_replication;
retard de réplication en secondes
$ select
extract(epoch from now() - pg_last_xact_replay_timestamp());
Si ces choses diffèrent, cela signifie qu'il y a un certain retard. Le retard est le décalage de la réplique par rapport au maître, c'est-à-dire que les données diffèrent entre les serveurs.
Il y a trois raisons au décalage :
- C'est le sous-système de disque qui ne parvient pas à écrire la synchronisation des fichiers.
- Ce sont d'éventuelles erreurs réseau, ou une surcharge réseau, lorsque les données n'arrivent pas à la réplique à temps et ne peuvent pas être reproduites.
- Et le processeur. Le processeur, c'est un cas très rare. Et j'ai vu ça deux ou trois fois, mais cela peut aussi arriver.
Et voici trois requêtes qui nous permettent d'utiliser les statistiques. Nous pouvons évaluer combien est enregistré dans notre journal des transactions. Il existe une fonction pg_xlog_location_diff et nous pouvons évaluer le retard de réplication en octets et en secondes. Nous utilisons également la valeur de cette vue (VIEWs) pour cela.
Remarque : _Au lieu de pg_xlog_locationdiff(), nous pouvons utiliser l'opérateur de soustraction et soustraire une location de l'autre. C'est pratique.
Avec le retard en secondes, il y a un point à noter. Si aucune activité ne se produit sur le maître, la transaction a eu lieu il y a environ 15 minutes et aucune activité n'est présente, si nous regardons ce retard sur la réplique, nous verrons un retard de 15 minutes. Il faut en tenir compte. Cela peut être déroutant lorsque vous examinez ce retard.
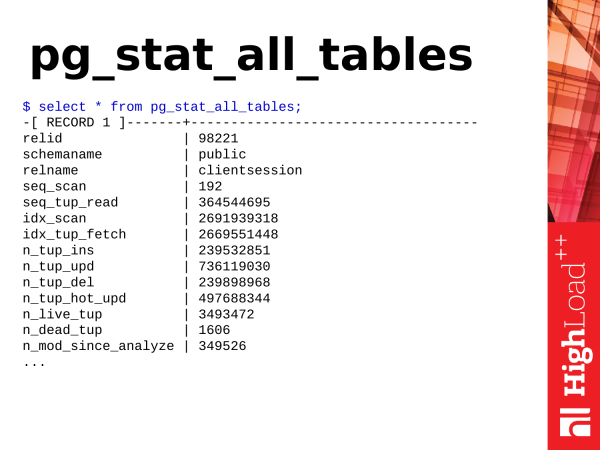
Pg_stat_all_tables – une autre vue utile. Elle montre des statistiques sur les tables. Lorsqu'il y a une certaine activité ou des actions sur nos tables dans la base de données, nous pouvons obtenir ces informations via cette vue.
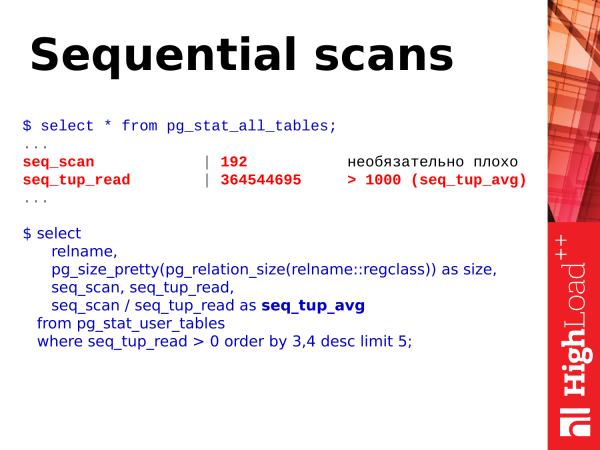
select
relname,
pg_size_pretty(pg_relation_size(relname::regclass)) as size,
seq_scan, seq_tup_read,
seq_scan / seq_tup_read as seq_tup_avg
from pg_stat_user_tables
where seq_tup_read > 0 order by 3,4 desc limit 5;
La première chose que nous pouvons examiner, ce sont les scans séquentiels sur la table. Le nombre après ces passages n'est pas nécessairement mauvais et ne signifie pas que nous devons déjà agir.
Cependant, il existe une deuxième métrique – seq_tup_read. Cela représente le nombre de lignes retournées par un scan séquentiel. Si le nombre moyen dépasse 1 000, 10 000, 50 000, 100 000, alors cela indique peut-être qu'il serait nécessaire de créer un index quelque part pour que les accès passent par l'index, ou d'optimiser les requêtes utilisant ces scans séquentiels pour éviter cela.
Un exemple simple – supposons qu'une requête avec un OFFSET et LIMIT importants soit en cours. Par exemple, 100 000 lignes sont scannées dans la table et ensuite 50 000 lignes nécessaires sont récupérées, tandis que les lignes précédemment scannées sont abandonnées. C'est aussi un mauvais cas. De telles requêtes doivent être optimisées. Ici, voici une requête SQL simple pour examiner et évaluer les chiffres obtenus.
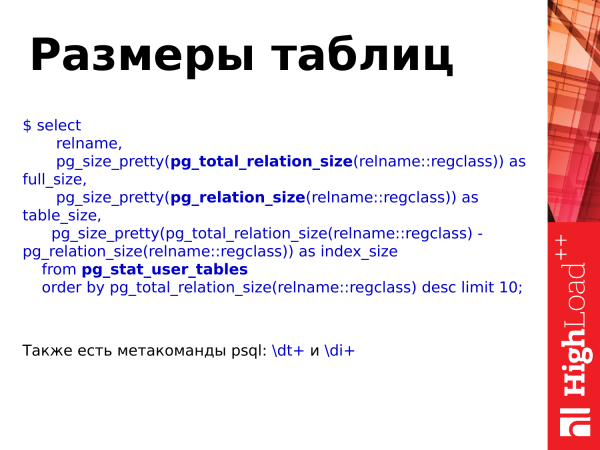
select
relname,
pg_size_pretty(pg_total_relation_size(relname::regclass)) as
full_size,
pg_size_pretty(pg_relation_size(relname::regclass)) as
table_size,
pg_size_pretty(pg_total_relation_size(relname::regclass) -
pg_relation_size(relname::regclass)) as index_size
from pg_stat_user_tables
order by pg_total_relation_size(relname::regclass) desc limit 10;
Les tailles des tables peuvent également être obtenues via cette table et des fonctions supplémentaires. pg_total_relation_size(), pg_relation_size().
En fait, il existe des métacommandes dt et di, que vous pouvez utiliser dans PSQL pour examiner les tailles des tables et des index.
Cependant, l'utilisation des fonctions nous permet de voir les tailles des tables en tenant compte des index ou sans en tenir compte et de faire des évaluations sur la croissance de la base de données, c'est-à-dire comment elle croît, avec quelle intensité, et tirer des conclusions sur l'optimisation des tailles.
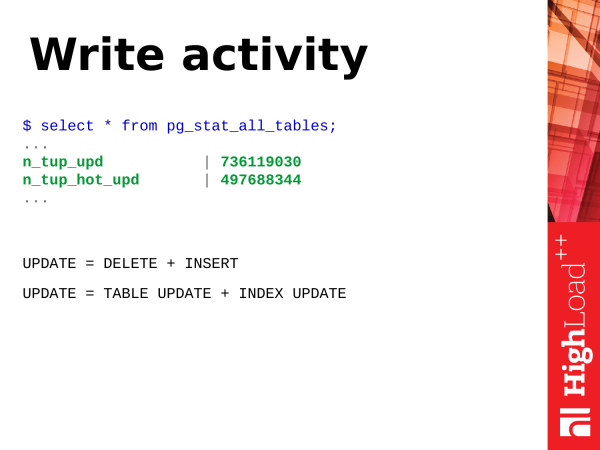
Activité d'écriture. Qu'est-ce qu'une écriture ? Examinons l'opération UPDATE – l'opération de mise à jour des lignes dans la table. En fait, update consiste en deux opérations (voire plus). Il s'agit de l'insertion d'une nouvelle version de la ligne et de la marque de l'ancienne version de la ligne comme obsolète. Par la suite, un autovacuum viendra nettoyer ces versions obsolètes de lignes et marquer cet espace comme disponible pour une réutilisation.
De plus, update ne signifie pas seulement mettre à jour la table. Il s'agit aussi de mettre à jour les index. Si votre table a beaucoup d'index, lors d'un update, tous les index impliquant des champs mis à jour dans la requête devront également être mis à jour. Ces index contiendront également des versions obsolètes de lignes qui devront être nettoyées.
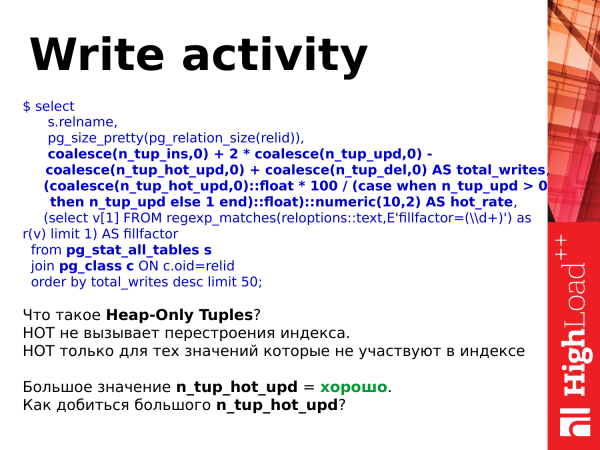
select
s.relname,
pg_size_pretty(pg_relation_size(relid)),
coalesce(n_tup_ins,0) + 2 * coalesce(n_tup_upd,0) -
coalesce(n_tup_hot_upd,0) + coalesce(n_tup_del,0) AS total_writes,
(coalesce(n_tup_hot_upd,0)::float * 100 / (case when n_tup_upd > 0
then n_tup_upd else 1 end)::float)::numeric(10,2) AS hot_rate,
(select v[1] FROM regexp_matches(reloptions::text,E'fillfactor=(\d+)') as
r(v) limit 1) AS fillfactor
from pg_stat_all_tables s
join pg_class c ON c.oid=relid
order by total_writes desc limit 50;
Et de par son design, UPDATE – ce sont des opérations lourdes. Mais elles peuvent être allégées. Il existe des mises à jour légères. Elles ont été introduites dans PostgreSQL version 8.3. Et qu'est-ce que c'est ? C'est un update léger qui ne nécessite pas de reconstruire les index. C'est-à-dire que nous avons mis à jour un enregistrement, mais en même temps, seule l'enregistrement sur la page (appartenant à la table) a été mise à jour, tandis que les index pointent toujours vers le même enregistrement sur la page. Il y a une logique de fonctionnement intéressante ici, lorsque le vacuum arrive, il reconstruit ces chaînes. légères et tout continue de fonctionner sans mise à jour des index, et tout se fait avec moins de consommation de ressources.
Et quand vous avez n_tup_hot_upd élevé, c'est très bien. Cela signifie que les mises à jour légères prédominent et que cela revient moins cher en termes de ressources et tout fonctionne parfaitement.
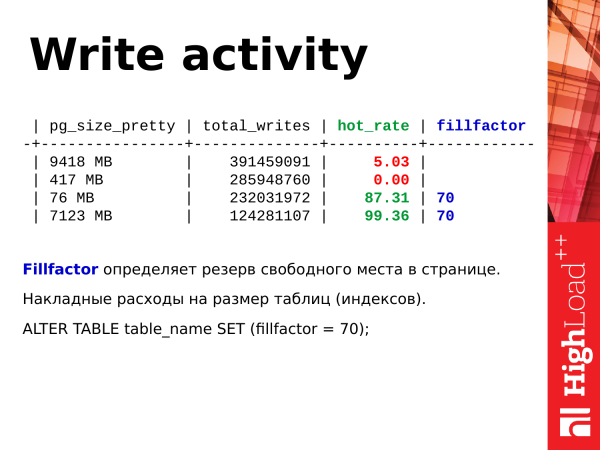
ALTER TABLE table_name SET (fillfactor = 70);Comment augmenter le volume des mises à jour légères? Nous pouvons utiliser le fillfactor. Il détermine la taille de l'espace libre réservé lors du remplissage d'une page dans la table via des INSERT. Lorsque des insertions sont insérées dans la table, elles remplissent complètement la page, sans laisser d'espace vide. Ensuite, une nouvelle page est allouée. Les données sont à nouveau remplies. Et ce comportement par défaut se traduit par un fillfactor = 100 %.
Nous pouvons définir un fillfactor à 70 %. C'est-à-dire qu'à chaque insertion, une nouvelle page est allouée, mais seulement 70 % de cette page est remplie. Il reste donc 30 % en réserve. Lorsqu'il sera nécessaire de faire une mise à jour, celle-ci se produira très probablement sur la même page, et la nouvelle version de la ligne sera placée sur cette même page, ce qui permettra un hot_update. Ainsi, l'écriture dans les tables est facilitée.
select c.relname,
current_setting('autovacuum_vacuum_threshold') as av_base_thresh,
current_setting('autovacuum_vacuum_scale_factor') as av_scale_factor,
(current_setting('autovacuum_vacuum_threshold')::int +
(current_setting('autovacuum_vacuum_scale_factor')::float * c.reltuples))
as av_thresh,
s.n_dead_tup
from pg_stat_user_tables s join pg_class c ON s.relname = c.relname
where s.n_dead_tup > (current_setting('autovacuum_vacuum_threshold')::int
+ (current_setting('autovacuum_vacuum_scale_factor')::float * c.reltuples));
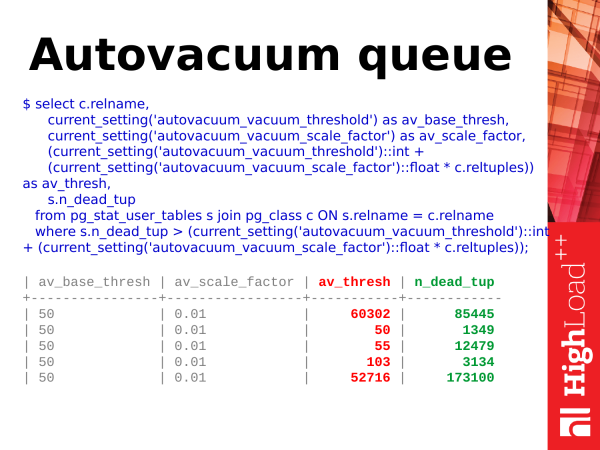
File d'attente de l'autovaccum. L'autovaccum est un sous-système pour lequel il y a très peu de statistiques dans PostgreSQL. Nous pouvons uniquement voir dans pg_stat_activity combien de vaccums sont en cours à ce moment-là. Cependant, il est très difficile de comprendre combien de tables sont en attente.
Remarque : Depuis la version Postgres 10, la situation concernant le suivi des autovacuums s'est considérablement améliorée — une vue pg_stat_progress a été ajoutée.vacuum, ce qui simplifie considérablement la surveillance de l'autovaccum.
Nous pouvons utiliser cette requête simplifiée. Et nous pouvons voir quand un vacuum doit être effectué. Mais, quand et comment le vacuum doit-il se mettre en marche ? Voici ces anciennes versions de lignes, dont j'ai parlé plus tôt. Une mise à jour a eu lieu, une nouvelle version de ligne a été insérée. Une version obsolète de la ligne est apparue. Dans la table pg_stat_user_tables , il existe ce paramètre n_dead_tup. Il indique le nombre de lignes "mortes". Et dès que le nombre de lignes mortes dépasse un certain seuil, un autovaccum sera lancé pour cette table.
Et comment ce seuil est-il calculé ? Il s'agit d'un rapport pourcentage précis par rapport au nombre total de lignes dans la table. Il existe un paramètre autovacuum_vacuum_scale_factor. Il définit le rapport en pourcentage. Supposons 10 % + un seuil de base additionnel de 50 lignes. Et que se passe-t-il ? Lorsque nous avons plus de lignes mortes que "10 % + 50" par rapport à toutes les lignes de la table, alors nous mettons la table en autovacuum.
select c.relname,
current_setting('autovacuum_vacuum_threshold') as av_base_thresh,
current_setting('autovacuum_vacuum_scale_factor') as av_scale_factor,
(current_setting('autovacuum_vacuum_threshold')::int +
(current_setting('autovacuum_vacuum_scale_factor')::float * c.reltuples))
as av_thresh,
s.n_dead_tup
from pg_stat_user_tables s join pg_class c ON s.relname = c.relname
where s.n_dead_tup > (current_setting('autovacuum_vacuum_threshold')::int
+ (current_setting('autovacuum_vacuum_scale_factor')::float * c.reltuples));
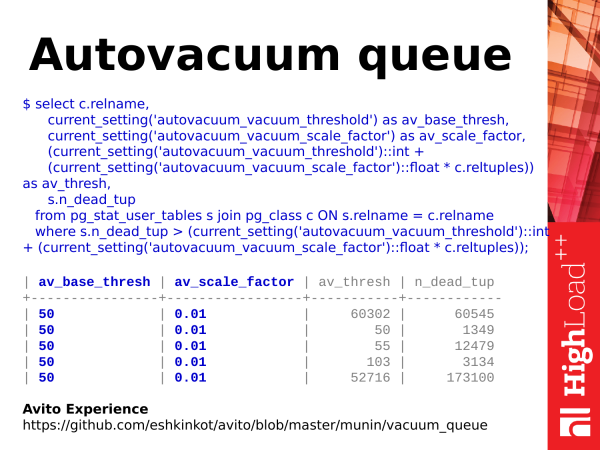
Cependant, il y a un point à considérer. Les seuils de base pour les paramètres av_base_thresh et et av_scale_factor peuvent être assignés individuellement. Ainsi, le seuil ne sera pas global, mais individuel pour le tableau. Par conséquent, pour effectuer le calcul, il faut utiliser des astuces et des stratagèmes. Si cela vous intéresse, vous pouvez consulter l'expérience de nos collègues d'Avito (le lien sur la diapositive n'est plus valide et a été mis à jour dans le texte).
Ils ont écrit pour , qui prend en compte ces éléments. Il s'agit d'un document de deux pages. Mais il calcule correctement et permet d'évaluer efficacement où nous avons besoin de beaucoup de vide pour les tableaux, et où il y en a peu.
Que pouvons-nous faire à ce sujet ? Si nous avons une grande file d'attente et que l’autovacuum ne s’en sort pas, nous pouvons augmenter le nombre de workers du vide, ou simplement rendre le vide plus agressif, afin qu'il s'active plus tôt et traite le tableau par petits morceaux. Ainsi, la file d'attente diminuera. — L'essentiel ici est de surveiller la charge sur les disques, car le vide n'est pas gratuit, bien que l'avènement des dispositifs SSD/NVMe ait rendu ce problème moins visible.
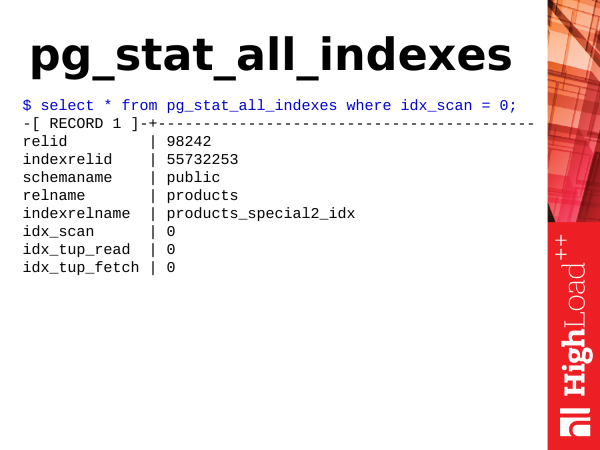
Pg_stat_all_indexes – c'est la statistique des index. Elle est réduite. Et nous pouvons obtenir des informations sur l'utilisation des index. Par exemple, nous pouvons déterminer quels index sont superflus.
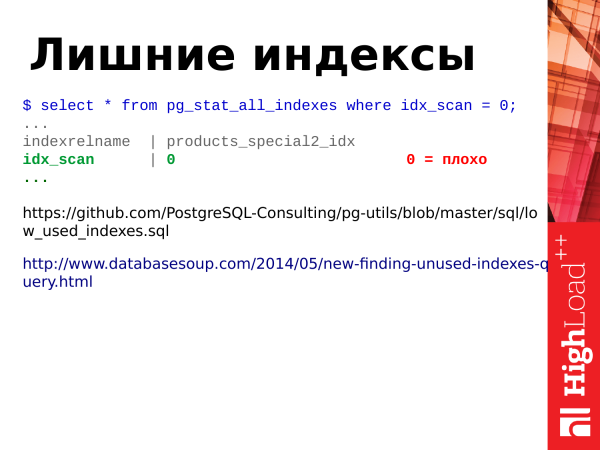
Comme je l'ai déjà dit, la mise à jour – ce n'est pas seulement la mise à jour des tableaux, mais aussi la mise à jour des index. Par conséquent, si nous avons beaucoup d’index sur un tableau, lors de la mise à jour des lignes dans le tableau, les index des champs indexés doivent également être mis à jour, et si nous avons des index inutilisés, qui n'ont pas de scans d'index, alors ils pèsent comme un ballast. Il faut s'en débarrasser. Pour cela, nous avons besoin du champ idx_scan. Nous examinons simplement le nombre de scans d'index. S'il y a zéro scan pour les index pendant une période de stockage de statistiques relativement longue (au moins 2-3 semaines), alors ce sont probablement de mauvais index, nous devons nous en débarrasser.
Remarque : Lors de la recherche d'index inutilisés dans le cas de clusters de réplication en flux, il est nécessaire de vérifier tous les nœuds du cluster, car la statistique n'est pas globale, et si l'index n'est pas utilisé sur le maître, il peut être utilisé sur les répliques (s'il y a une charge là-bas).
Deux liens :
Il s'agit d'exemples de requêtes plus avancées sur la manière de rechercher des index inutilisés.
Le deuxième lien est une demande assez intéressante. Il repose sur une logique complexe. Je vous le recommande pour en prendre connaissance.
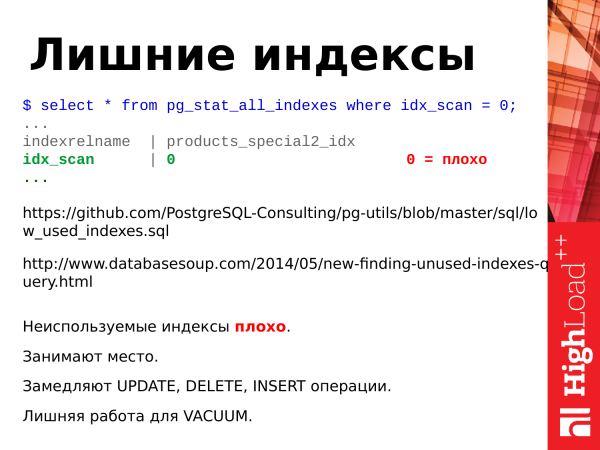
Que doit-on résumer au sujet des index encore ?
Les index inutilisés, c'est mauvais.
Ils occupent de l'espace.
Ils ralentissent les opérations de mise à jour.
C'est un travail supplémentaire pour le vide.
Si nous supprimons les index inutilisés, cela ne pourra qu'améliorer la base.
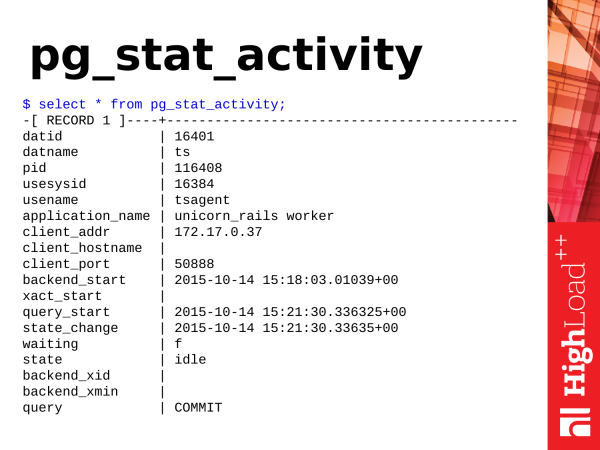
La présentation suivante est pg_stat_activity. C'est l'équivalent de l'outil ps, mais pour PostgreSQL. Si psvous examinez les processus du système d'exploitation avec 'top', alors pg_stat_activity cela montrera l'activité à l'intérieur de PostgreSQL.
Que pouvons-nous en tirer d'utile ?
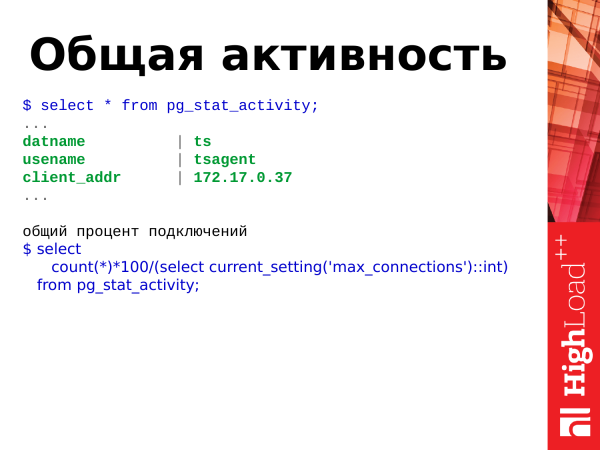
select
count(*)*100/(select current_setting('max_connections')::int)
from pg_stat_activity;
Nous pouvons observer l'activité générale, ce qui se passe dans la base. Nous pouvons faire un nouveau déploiement. Tout a explosé, de nouvelles connexions ne sont plus acceptées, des erreurs apparaissent dans l'application.
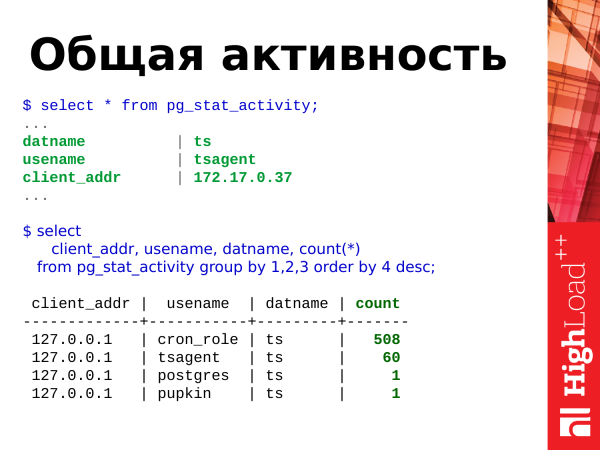
select
client_addr, usename, datname, count(*)
from pg_stat_activity group by 1,2,3 order by 4 desc;
Nous pouvons exécuter cette requête et voir le pourcentage total de connexions par rapport à la limite maximale de connexions, et voir qui occupe le plus de connexions. Dans ce cas précis, nous voyons que l'utilisateur cron_role a ouvert 508 connexions. Et quelque chose s'est passé avec lui. Il faut s'en occuper et vérifier. Il est tout à fait possible que ce soit un nombre anormal de connexions.
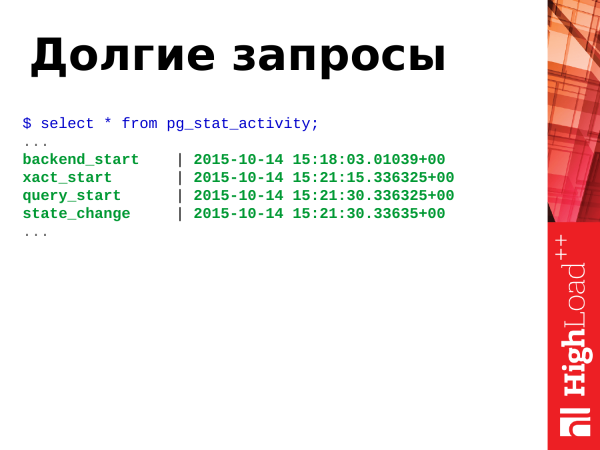
Si nous avons une charge OLTP, les requêtes doivent s'exécuter rapidement, très rapidement, et il ne doit pas y avoir de longues requêtes. Cependant, si des requêtes longues apparaissent, cela ne pose pas de problème à court terme, mais à long terme, les longues requêtes nuisent à la base, elles augmentent l'effet de bloat des tables, lorsqu'il y a fragmentation des tables. Il faut se débarrasser à la fois du bloat et des longues requêtes.
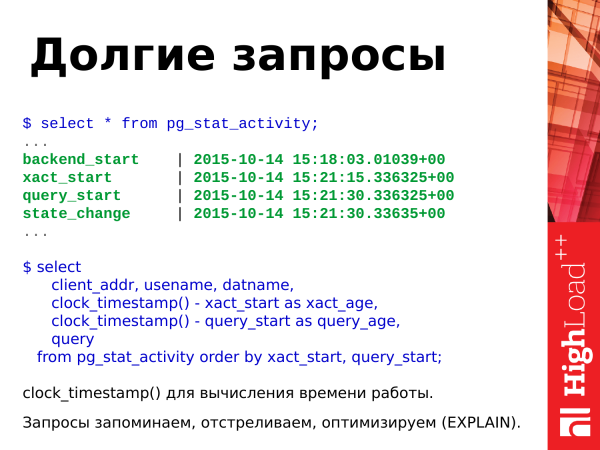
select
client_addr, usename, datname,
clock_timestamp() - xact_start as xact_age,
clock_timestamp() - query_start as query_age,
query
from pg_stat_activity order by xact_start, query_start;
Notez : avec cette requête, nous pouvons identifier les longues requêtes et transactions. Nous utilisons la fonction clock_timestamp() pour définir la durée d'exécution. Les longues requêtes que nous avons trouvées, nous pouvons les mémoriser, exécuter explain, examiner les plans et essayer d'optimiser. Nous terminons les longues requêtes actuelles et continuons à avancer.
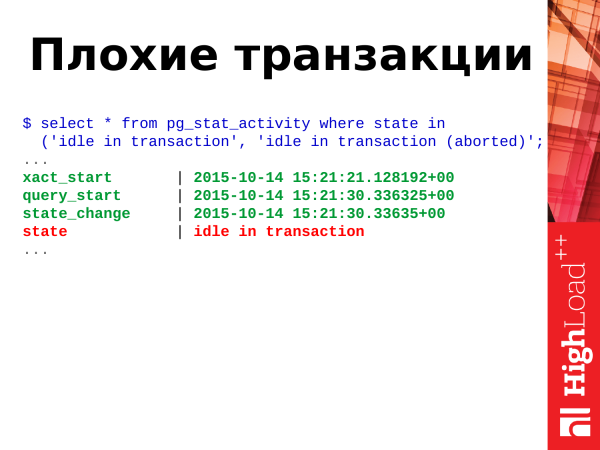
select * from pg_stat_activity where state in
('idle in transaction', 'idle in transaction (aborted)';
Les mauvaises transactions sont celles dont l'état est idle in transaction et idle in transaction (aborted).
Que signifie cela ? Les transactions peuvent avoir plusieurs états. Et l'un de ces états peut être atteint à tout moment. Pour définir les états, nous avons un champ state dans cette vue. Et nous l'utilisons pour déterminer l'état.
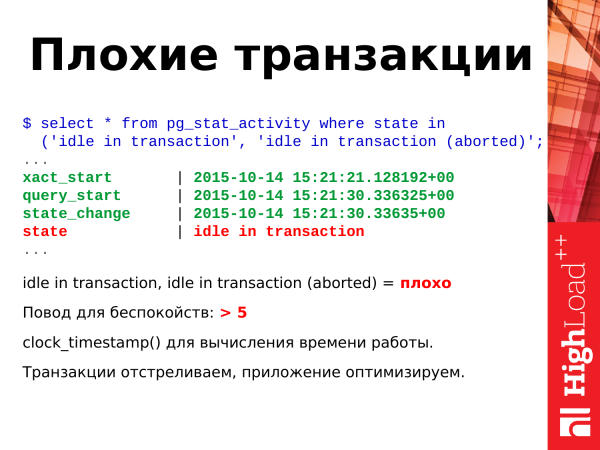
select * from pg_stat_activity where state in
('idle in transaction', 'idle in transaction (aborted)';
Et, comme je l'ai dit précédemment, ces deux états idle in transaction et idle in transaction (aborted) – c'est problématique. Qu'est-ce que cela signifie ? C'est lorsque l'application a ouvert une transaction, a effectué certaines actions et s'est ensuite éloignée. La transaction est restée ouverte. Elle est suspendue, rien ne se passe, elle occupe une connexion, bloque les lignes modifiées et augmente potentiellement le bloat des autres tables en raison de l'architecture du moteur de transactions de Postgres. Et de telles transactions doivent également être supprimées car elles sont nuisibles dans tous les cas.
Si vous constatez qu'il y en a plus de 5-10-20 dans votre base, il est temps de vous en préoccuper et de commencer à faire quelque chose.
Ici, nous utilisons également pour le calcul du temps clock_timestamp(). Nous supprimons les transactions, nous optimisons l'application.
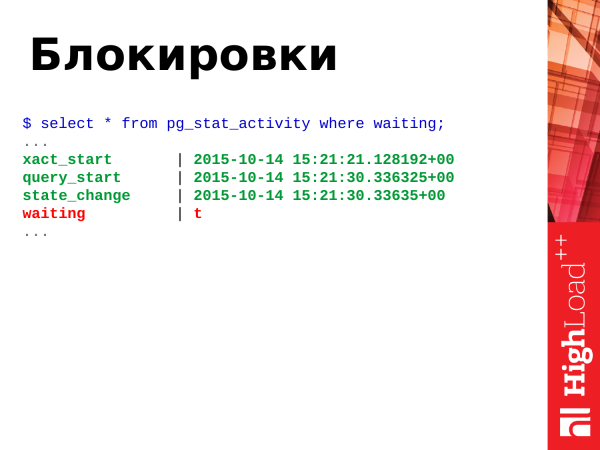
Comme je l'ai mentionné précédemment, les verrous se produisent lorsque deux ou plusieurs transactions se battent pour une ou plusieurs ressources. Pour cela, nous disposons d'un champ waiting avec une valeur booléenne true ou faux.
True – cela signifie que le processus est en attente, il faut faire quelque chose. Lorsque le processus est en attente, cela signifie que le client qui a initié ce processus attend aussi. Le client dans le navigateur attend également.
Attention : _À partir de la version Postgres 9.6, le champ waiting a été supprimé et à sa place, deux champs plus informatifs ont été ajoutés wait_event_type et wait_event._
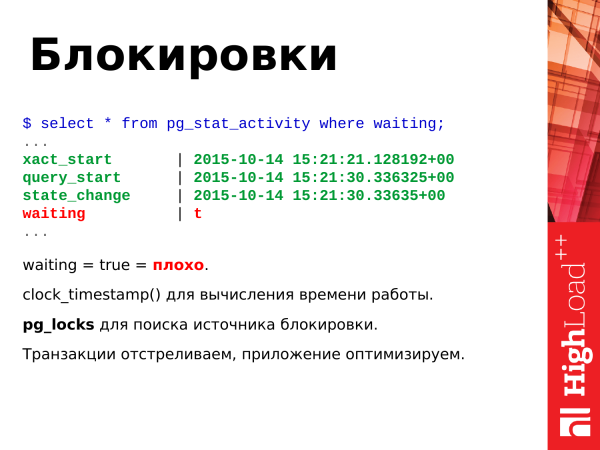
Que faire ? Si vous voyez true pendant longtemps, cela signifie qu'il faut se débarrasser de ces requêtes. Nous supprimons simplement ces transactions. Nous faisons savoir aux développeurs qu'ils doivent optimiser pour éviter de se battre pour les ressources. Ensuite, les développeurs optimisent l'application pour éviter que cela ne se produise.
Et le dernier, mais potentiellement non fatal, cas est l'apparition de deadlocks. Deux transactions ont mis à jour deux ressources, puis en font à nouveau appel, mais aux ressources opposées. Dans ce cas, PostgreSQL prend et supprime la transaction pour que l'autre puisse continuer son travail. C'est une situation d'impasse et elle ne se résout pas d'elle-même. Par conséquent, PostgreSQL est contraint de prendre des mesures extrêmes.
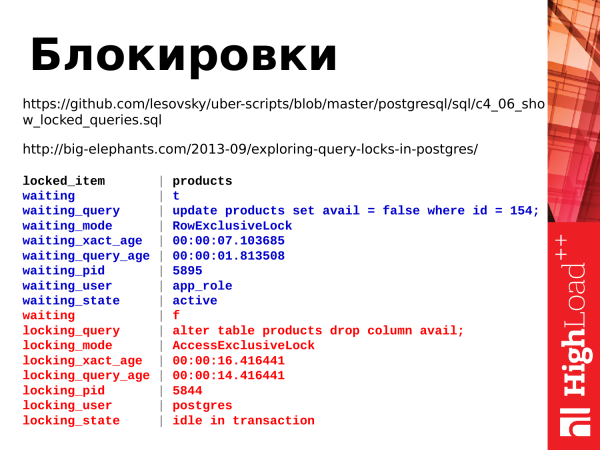
Et voici deux requêtes qui permettent de suivre les verrous. Nous utilisons la vue pg_locks, qui permet de suivre les blocages lourds.
Et le premier lien – c'est le texte de la requête elle-même. Il est assez long.
Et le deuxième lien – c'est un article sur les locks. Il est utile à lire, il est très intéressant.
Alors, que voyons-nous ? Nous voyons deux requêtes. Une transaction avec ALTER TABLE – c'est une transaction bloquante. Elle a démarré, mais n'est pas terminée et l'application qui a lancé cette transaction s'occupe de d'autres choses ailleurs. Et la deuxième requête – update. Elle attend que l'alter table se termine pour continuer son travail.
C'est ainsi que nous pouvons déterminer qui a verrouillé qui, maintenir, et nous pouvons ensuite en discuter.
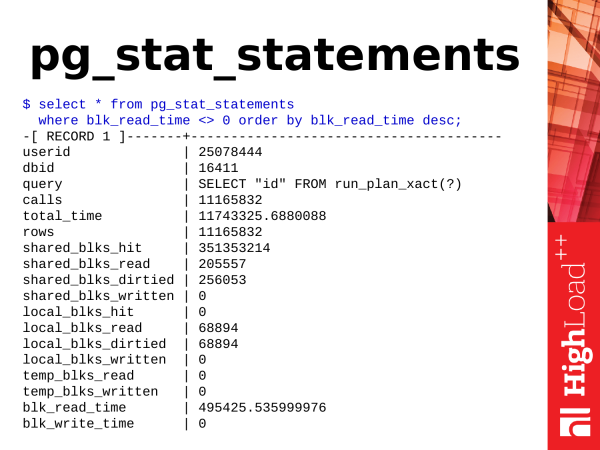
Le prochain module – c'est pg_stat_statements. Comme je l'ai déjà dit, c'est un module. Pour l'utiliser, il faut charger sa bibliothèque dans la configuration, redémarrer PostgreSQL, installer le module (avec une seule commande) et ensuite nous aurons une nouvelle vue.
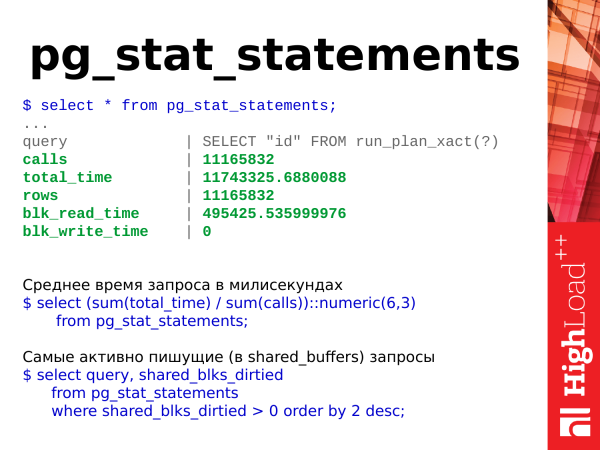
Temps moyen de la requête en millisecondes
$ select (sum(total_time) / sum(calls))::numeric(6,3)
from pg_stat_statements;

Les requêtes qui écrivent le plus activement (dans shared_buffers)
$ select query, shared_blks_dirtied
from pg_stat_statements
where shared_blks_dirtied > 0 order by 2 desc;
Que pouvons-nous en tirer ? En termes simples, nous pouvons prendre le temps moyen d'exécution de la requête. Si le temps augmente, cela signifie que PostgreSQL répond lentement et qu'il faut entreprendre quelques actions.
Nous pouvons voir les transactions d'écriture les plus actives dans la base de données, qui modifient des données dans les buffers partagés. Voyons qui met à jour ou supprime des données.
Et nous pouvons juste regarder diverses statistiques sur ces requêtes.
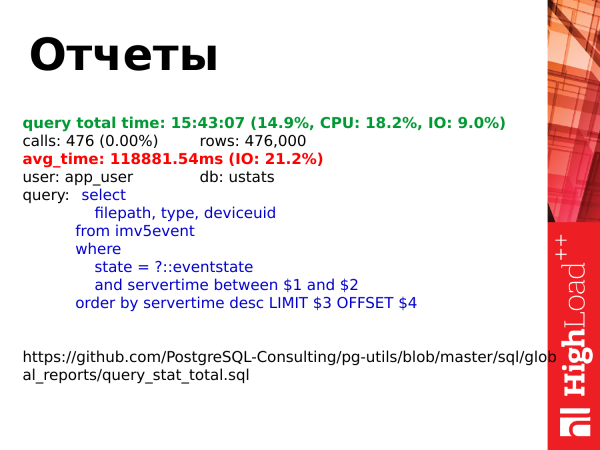
Nous pg_stat_statements pour construire des rapports. Nous réinitialisons les statistiques une fois par jour. Nous les accumulons. Avant la réinitialisation des statistiques, nous construisons un rapport. Voici le lien vers le rapport. Vous pouvez le consulter.
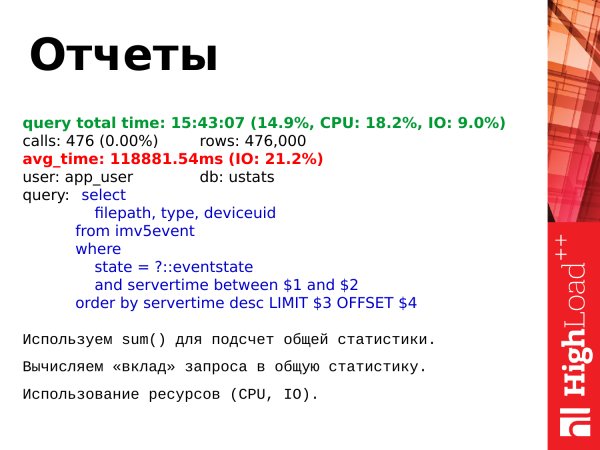
Que faisons-nous ? Nous calculons les statistiques globales de toutes les requêtes. Ensuite, pour chaque requête, nous calculons sa contribution individuelle à cette statistique globale.
Et que pouvons-nous examiner ? Nous pouvons voir le temps total d'exécution de toutes les requêtes d'un type particulier par rapport à toutes les autres requêtes. Nous pouvons examiner les ressources CPU et d'entrée-sortie par rapport à l'ensemble. Et déjà optimiser ces requêtes. Nous construisons le top des requêtes selon ce rapport et nous obtenons déjà matière à réflexion sur ce qu'il faut optimiser.
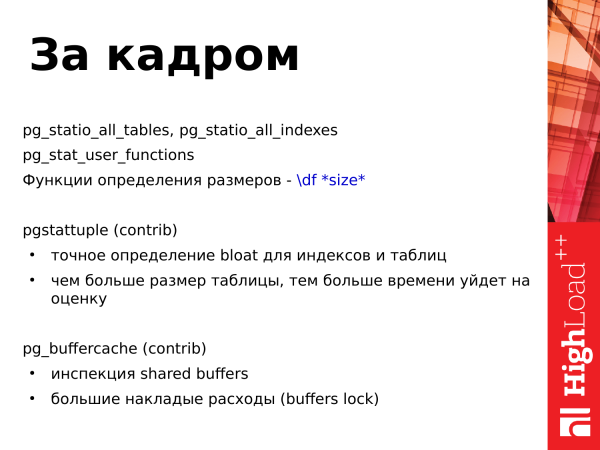
Qu'est-ce qui nous reste en arrière-plan ? Il reste encore quelques présentations que je n'ai pas examinées, car le temps est limité.
Oui pgstattuple – c'est aussi un module supplémentaire du package standard contribs. Il permet d'évaluer le gonflement des tables, c'est-à-dire la fragmentation des tables. Et si la fragmentation est importante, il faut la supprimer, utiliser différents outils. Et la fonction pgstattuple fonctionne longtemps. Plus il y a de tables, plus elle mettra de temps à s'exécuter.
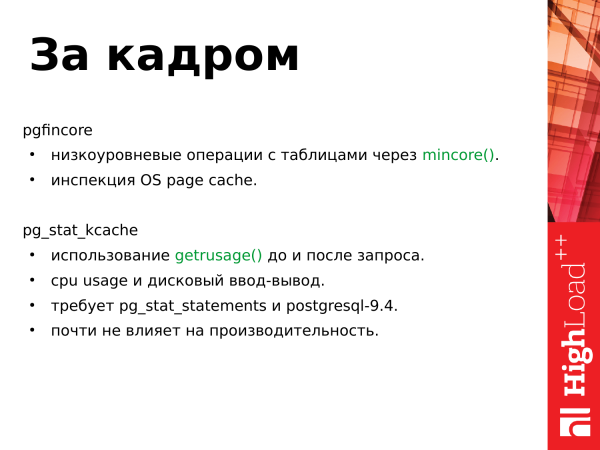
Le prochain contrib est pg_buffercache. Il permet d'inspecter les buffers partagés : à quel point les pages sont utilisées intensivement et pour quelles tables. Et il permet simplement de jeter un œil dans les buffers partagés et d'évaluer ce qui s'y passe.
Le prochain module – c'est pgfincore. Il permet d'effectuer des opérations à bas niveau sur les tables via l'appel système mincore(), c'est-à-dire qu'il permet de charger une table dans les buffers partagés ou de l'en sortir. Il permet, entre autres, d'inspecter le cache de pages du système d'exploitation, c'est-à-dire quelle place notre table occupe dans le cache de pages, dans les buffers partagés, et permet de simplement évaluer la charge de la table.
Le module suivant est pg_stat_kcache. Il utilise également l'appel système getrusage(). Et il l'exécute avant et après l'exécution de la requête. Et dans les statistiques obtenues, il permet d'évaluer combien notre requête a coûté en entrée-sortie disque, c'est-à-dire les opérations avec le système de fichiers, et examine l'utilisation du processeur. Cependant, le module est encore jeune (ahem) et pour fonctionner, il nécessite PostgreSQL 9.4 et pg_stat_statements, que j'ai mentionné précédemment.
Savoir utiliser les statistiques est utile. Vous n'avez pas besoin de programmes externes. Vous pouvez jeter un œil vous-même, voir, faire quelque chose, exécuter.
Utiliser les statistiques n'est pas difficile, c'est du SQL ordinaire. Vous avez préparé votre requête, l'avez composée, l'avez envoyée, avez regardé.
Les statistiques aident à répondre aux questions. Si vous avez des questions, vous vous référez aux statistiques - vous regardez, tirez des conclusions, analysez les résultats.
Et expérimentez. Il y a beaucoup de requêtes, beaucoup de données. Vous pouvez toujours optimiser une requête existante. Vous pouvez créer votre propre version d'une requête qui vous convient mieux que l'original et l'utiliser.
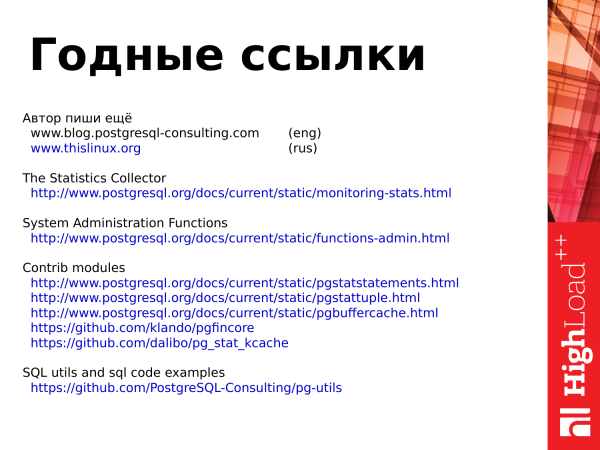
Liens
Liens utiles qui ont été mentionnés dans l'article, dont j'ai basé ma présentation.
L'auteur écrit encore
(eng)
Le collecteur de statistiques
Fonctions d'administration système
Modules contrib
Outils SQL et exemples de code SQL
Merci à tous pour votre attention !
Source : habr.com
