

Commande propose L'ingénieur Rahul Bhatia de Clairvoyant discute des formats de fichiers dans les grandes données, des fonctions les plus courantes des formats Hadoop et du format à utiliser.
Pourquoi différents formats de fichiers sont nécessaires
Un goulot d'étranglement significatif dans la performance des applications supportant HDFS, comme MapReduce et Spark, est le temps de recherche, de lecture et d'écriture des données. Ces problèmes sont amplifiés par les difficultés de gestion de grands ensembles de données, surtout si nous n'avons pas un schéma fixe, mais plutôt un schéma évolutif ou s'il y a des limitations au stockage.
Le traitement des grandes données augmente la charge sur le sous-système de stockage — Hadoop stocke les données de façon redondante pour atteindre la tolérance aux pannes. En plus des disques, le processeur, le réseau, le système d'entrée-sortie, etc., subissent également une charge élevée. À mesure que le volume des données augmente, le coût de leur traitement et stockage augmente également.
Différents formats de fichiers dans ont été conçus pour résoudre précisément ces problèmes. Le choix du bon format de fichier peut offrir des avantages substantiels :
- Temps de lecture plus rapide.
- Temps d'écriture plus rapide.
- Fichiers partageables.
- Support de l'évolution des schémas.
- Support avancé de la compression.
Certains formats de fichiers sont destinés à un usage général, d'autres à des cas d'utilisation plus spécifiques, et certains sont développés en tenant compte de caractéristiques particulières des données. Ainsi, le choix est en effet assez vaste.
Format de fichier Avro
Pour de sérialisation de données utilise largement Avro — c'est un format de stockage de données basé sur des lignes, c'est-à-dire textuel, dans Hadoop. Il stocke le schéma au format JSON, facilitant sa lecture et son interprétation par n'importe quel programme. Les données elles-mêmes sont enregistrées dans un format binaire, compact et efficace.
Le système de sérialisation Avro est neutre par rapport aux langages. Les fichiers peuvent être traités par différents langages, notamment C, C++, C#, Java, Python et Ruby.
Une caractéristique clé d'Avro est son support robuste des schémas de données qui évoluent avec le temps, c'est-à-dire qui subissent des changements. Avro comprend les modifications de schéma — suppression, ajout ou modification de champs.
Avro prend en charge une variété de structures de données. Par exemple, il est possible de créer un enregistrement contenant un tableau, un type énuméré et un sous-enregistrement.
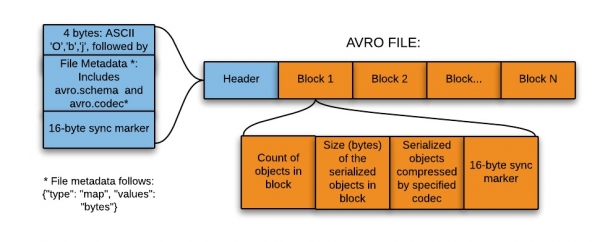
Ce format est idéal pour l'écriture dans une zone de transition du data lake (lac de données) (, ou data lake — une collection d'instances pour stocker différents types de données en complément des sources de données elles-mêmes).
Ainsi, pour l'écriture dans la zone d'atterrissage du lac de données, ce format convient le mieux pour les raisons suivantes :
- Les données de cette zone sont généralement lues dans leur intégralité pour un traitement ultérieur par les systèmes en aval — et le format basé sur les lignes est dans ce cas plus efficace.
- Les systèmes en aval peuvent facilement extraire les schémas des tables à partir des fichiers — il n'est pas nécessaire de stocker les schémas séparément dans un méta-stockage externe.
- Tout changement dans le schéma source est facilement géré (évolution du schéma).
Format de fichiers Parquet
Parquet est un format de fichier open source pour Hadoop, qui stocke des structures de données imbriquées au format colonne plat..
Comparé à l'approche traditionnelle basée sur les lignes, Parquet est plus efficace en termes de stockage et de performance.
Cela est particulièrement utile pour les requêtes qui lisent certaines colonnes d'une table large (avec de nombreuses colonnes). Grâce au format de fichiers, seules les colonnes nécessaires sont lues, minimisant ainsi les entrées/sorties.
Une petite digression-explication: pour mieux comprendre le format de fichier Parquet dans Hadoop, examinons ce qu'est un format basé sur les colonnes — c'est-à-dire en colonnes. Dans ce format, des valeurs homogènes de chaque colonne sont stockées ensemble.
, l'enregistrement comprend les champs ID, Name et Department. Dans ce cas, toutes les valeurs de la colonne ID seront stockées ensemble, tout comme les valeurs de la colonne Name, et ainsi de suite. La table aura un aspect approximatif :
ID
Nom
Department
1
emp1
d1
2
emp2
d2
3
emp3
d3
Dans le format ligne, les données seraient enregistrées comme suit :
1
emp1
d1
2
emp2
d2
3
emp3
d3
Dans le format de fichiers en colonne, les mêmes données seraient enregistrées ainsi :
1
2
3
emp1
emp2
emp3
d1
d2
d3
Le format en colonnes est plus efficace lorsque vous devez interroger plusieurs colonnes d'une table. Il ne lira que les colonnes nécessaires, car elles sont adjacentes. Ainsi, les opérations d'entrée/sortie sont minimisées.
Par exemple, vous n'avez besoin que de la colonne NAME. Dans le , chaque enregistrement dans l'ensemble de données doit être chargé, analysé par champs, puis les données NAME extraites. Le format en colonnes permet d'accéder directement à la colonne Name, car toutes les valeurs pour cette colonne sont stockées ensemble. Il n'est pas nécessaire de balayer tout l'enregistrement.
Ainsi, le format colonne améliore les performances des requêtes, car il nécessite moins de temps de recherche pour accéder aux colonnes requises et réduit le nombre d'opérations d'entrée-sortie, en ne lisant que les colonnes nécessaires.
Une des caractéristiques uniques est qu'il peut stocker des données avec des structures imbriquées. Cela signifie que dans un fichier Parquet, même les champs imbriqués peuvent être lus séparément sans avoir besoin de lire tous les champs dans la structure imbriquée. Pour le stockage de structures imbriquées, Parquet utilise un algorithme de déchiquetage et d'assemblage.
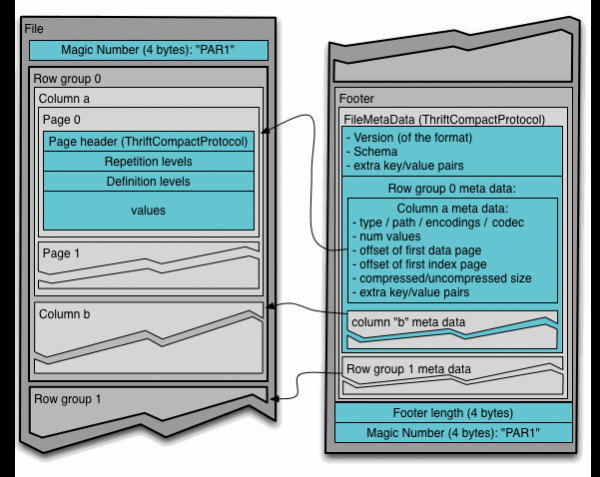
Pour comprendre le format de fichier Parquet dans Hadoop, il est nécessaire de connaître les termes suivants :
- Groupe de lignes (row group) : une division logique horizontale des données en lignes. Un groupe de lignes se compose d'un fragment de chaque colonne dans un ensemble de données.
- Fragment de colonne (column chunk) : un fragment d'une colonne spécifique. Ces fragments de colonnes résident dans un groupe de lignes donné et seront toujours contigus dans le fichier.
- Page (page) : les fragments de colonnes sont divisés en pages, enregistrées consécutivement. Les pages ont un en-tête commun, ce qui permet de sauter les lectures non nécessaires.
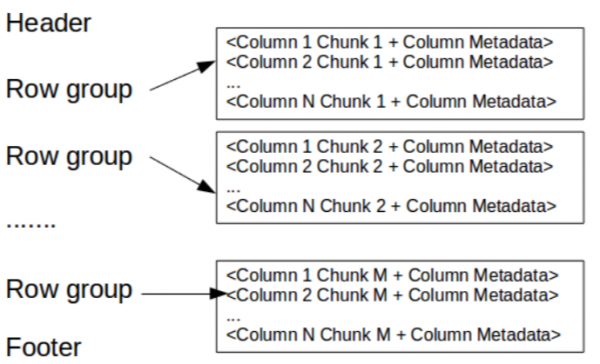
Ici, l'en-tête contient simplement un nombre magique PAR1 (4 octets), qui identifie le fichier comme un fichier au format Parquet.
Dans le pied de page, il est écrit :
- Métadonnées du fichier, qui contiennent les coordonnées de démarrage des métadonnées de chaque colonne. Lors de la lecture, il est d'abord nécessaire de lire les métadonnées du fichier pour trouver tous les fragments de colonnes d'intérêt. Ensuite, les fragments de colonnes doivent être lus de manière séquentielle. Les métadonnées incluent également la version du format, le schéma et d'éventuelles paires clé-valeur supplémentaires.
- Longueur des métadonnées (4 octets).
- Nombre magique PAR1 (4 octets).
Le format de fichiers ORC
Format de fichiers optimisé en ligne-colonne (Optimized Row Columnar, ) propose un moyen très efficace de stocker des données et a été conçu pour surmonter les limitations des autres formats. Il stocke les données de manière parfaitement compacte, permettant de sauter les détails non nécessaires - tout en ne nécessitant pas de construire de grands index complexes ou maintenus manuellement.
Les avantages du format ORC :
- Un fichier à la sortie de chaque tâche, ce qui réduit la charge sur le NameNode.
- Support des types de données Hive, y compris DateTime, les types décimaux et les types de données complexes (struct, list, map et union).
- Lecture simultanée d'un même fichier par différents processus RecordReader.
- Possibilité de diviser les fichiers sans scanner à la recherche de marqueurs.
- Estimation de l'allocation maximale possible de la mémoire heap pour les processus de lecture/écriture en fonction des informations dans le pied de page du fichier.
- Les métadonnées sont stockées dans un format binaire de sérialisation Protocol Buffers, qui permet d'ajouter et de supprimer des champs.
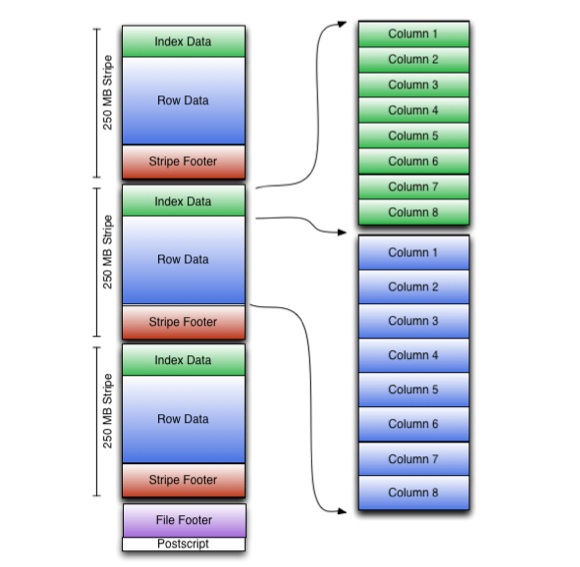
ORC stocke des collections de lignes dans un seul fichier, et au sein de la collection, les données de ligne sont stockées au format colonne.
Le fichier ORC stocke des groupes de lignes appelés bandes (stripes) ainsi que des informations complémentaires dans le pied de page du fichier. Le post-scriptum à la fin du fichier contient les paramètres de compression et la taille du pied de page compressé.
Par défaut, la taille d'une bande est de 250 Mo. Grâce à des bandes de cette taille, la lecture depuis HDFS est effectuée de manière plus efficace : en grands blocs continus.
Le pied de page du fichier contient une liste des bandes dans le fichier, le nombre de lignes par bande et le type de données de chaque colonne. Il y a également la valeur résultante de count, min, max et sum pour chaque colonne.
Le pied de page de la bande contient un répertoire des emplacements de flux.
Les données de ligne sont utilisées lors de la recherche dans les tables.
Les données d'index incluent les valeurs minimales et maximales pour chaque colonne et les positions des lignes dans chaque colonne. Les index ORC sont utilisés uniquement pour sélectionner des bandes et des groupes de lignes, et non pour répondre aux requêtes.
Comparaison des différents formats de fichiers
Avro par rapport à Parquet
- Avro est un format de stockage en ligne, tandis que Parquet stocke les données au format colonne.
- Parquet est mieux adapté aux requêtes analytiques, c'est-à-dire que les opérations de lecture et de requête de données sont beaucoup plus efficaces que l'écriture.
- Les opérations d'écriture dans Avro sont plus efficaces que dans Parquet.
- Avro gère plus mûrement l'évolution des schémas. Parquet ne prend en charge que l'ajout de schémas, tandis qu'Avro met en œuvre une évolution multifonctionnelle, c'est-à-dire l'ajout ou la modification de colonnes.
- Parquet est idéal pour interroger un sous-ensemble de colonnes dans une table à plusieurs colonnes. Avro convient aux opérations ETL où nous interrogeons toutes les colonnes.
ORC par rapport à Parquet
- Parquet stocke mieux les données imbriquées.
- ORC est mieux adapté à la poussée de prédicats (predicate pushdown).
- ORC prend en charge les propriétés ACID.
- ORC comprime mieux les données.
Suggestions de lecture supplémentaires:
- .
- .
- .
Source : habr.com
