

À l'automne 2019, l'équipe iOS de Mail.ru Cloud a connu un événement tant attendu. La base de données principale pour le stockage persistant de l'état de l'application est devenue assez exotique pour le monde mobile. (LMDB). Dans cet article, nous vous proposons un aperçu détaillé en quatre parties. Tout d'abord, parlons des raisons de ce choix non trivial et difficile. Ensuite, nous examinerons les trois piliers de l'architecture LMDB : les fichiers mappés en mémoire, l'arbre B+- et l'approche copy-on-write pour implémenter la transactionalité et la multi-versioning. Enfin, pour finir en beauté, une partie pratique. Nous verrons comment concevoir et réaliser un schéma de base de données avec plusieurs tables, y compris l'indexation, sur une API key-value de bas niveau.
Contenu
3.1.
3.2.
3.3.
4.1.
4.2.
4.3.
1. Motivation de l'implémentation
Un jour, vers 2015, nous avons décidé de mesurer à quelle fréquence l'interface de notre application buguait. Nous ne l'avons pas fait par simple curiosité. Nous avions reçu de plus en plus de plaintes disant que parfois l'application ne répondait plus aux actions de l'utilisateur : les boutons ne réagissaient pas, les listes ne défilaient pas, etc. Concernant la mécanique des mesures, je travaille chez AvitoTech, donc je ne présente ici que des ordres de grandeur.
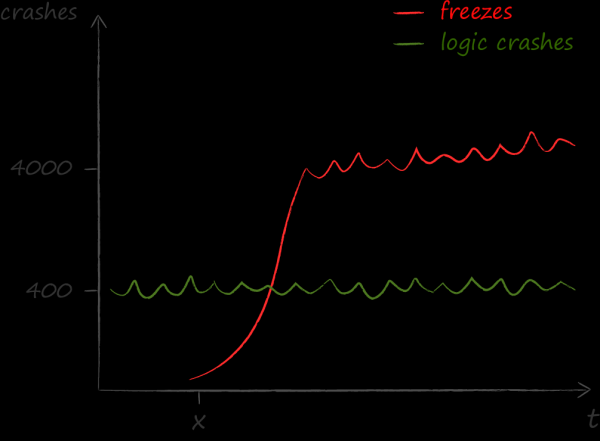
Les résultats des mesures ont été un véritable choc. Il s'est avéré qu'il y avait beaucoup plus de problèmes causés par des gels que par d'autres raisons. Avant cette réalisation, le principal indicateur technique de qualité était l'absence de crash, mais après, l'accent vers l'absence de gel.
En construisant et en effectuant et de leurs causes, il est devenu évident que le principal ennemi était la lourde logique métier, s'exécutant dans le thread principal de l'application. La réaction naturelle à cette situation était un désir ardent de la répartir sur des threads de travail. Pour résoudre ce problème de manière systématique, nous avons eu recours à une architecture multithread basée sur des acteurs légers. J'ai consacré dans le Twitter collectif et . Dans le cadre de ce récit, je souhaite souligner les aspects de la solution qui ont influencé le choix de la base de données.
Le modèle d'acteur de l'organisation du système suppose que la multi-threading devient sa seconde essence. Les objets de ce modèle aiment franchir les frontières des threads. Et ils le font non pas de temps en temps et ici ou là, mais pratiquement en permanence et partout.
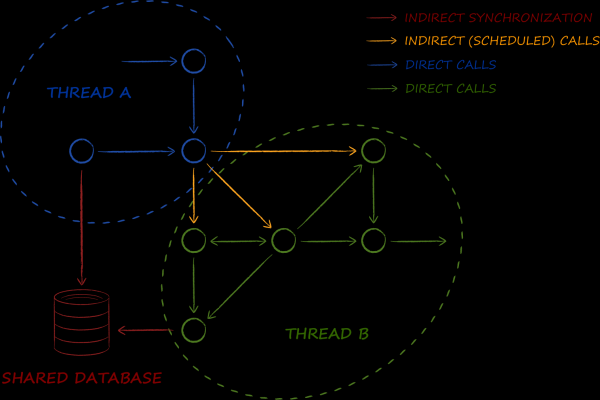
La base de données est l'un des composants fondamentaux du schéma présenté. Sa tâche principale est de mettre en œuvre le macro-modèle. . Dans le monde de l'entreprise, elle est utilisée pour organiser la synchronisation des données entre les services, tandis que dans le cas de l'architecture d'acteur, elle le fait entre les threads. Ainsi, nous avons besoin d'une telle base de données, dont le travail dans un environnement multi-thread n'entraîne même pas de difficultés minimales. En particulier, cela signifie que les objets obtenus de celle-ci doivent être au minimum sûrs pour les threads, et idéalement immuables. Comme on le sait, les derniers peuvent être utilisés simultanément depuis plusieurs threads sans avoir recours à aucune forme de verrouillage, ce qui a des impacts positifs sur les performances.
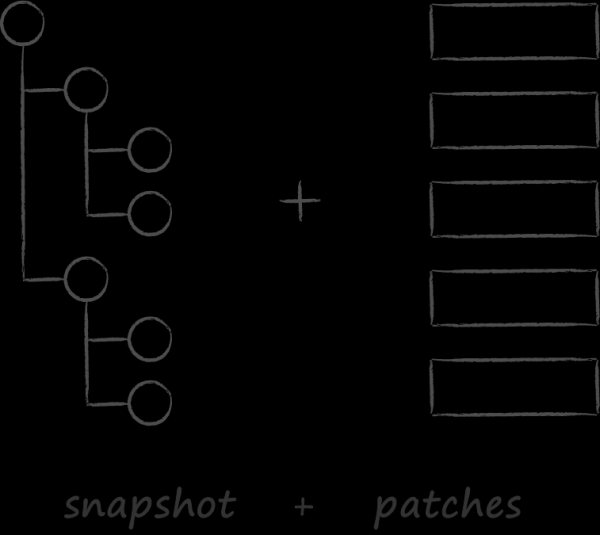 Un autre facteur significatif qui a influencé le choix de la base de données est notre API cloud. Elle a été inspirée par l'approche de synchronisation adoptée par git. Tout comme celui-ci, nous visons à , ce qui est plus que pertinent pour les clients cloud. On supposait qu'ils téléchargeraient une seule fois l'état complet du cloud, puis la synchronisation se ferait dans la grande majorité des cas par le biais de l'application des changements. Malheureusement, cette possibilité est encore à l'état théorique, et en pratique, les clients n'ont pas encore appris à travailler avec les patchs. Il y a plusieurs raisons objectives à cela, que nous laisserons de côté pour ne pas prolonger l'introduction. Actuellement, il est bien plus intéressant de discuter des leçons importantes de ce qui se passe quand l'API a dit « A », mais son consommateur n'a pas dit « B ».
Ainsi, si vous imaginez git, qui, lors de l'exécution de la commande pull, au lieu d'appliquer des patches à l'instantané local, compare son état complet à celui du serveur, vous aurez une idée assez précise de la manière dont la synchronisation se déroule dans les clients cloud. Il n'est pas difficile de deviner qu'il est nécessaire d'allouer en mémoire deux arbres DOM contenant des métadonnées sur tous les fichiers serveur et locaux pour réaliser cela. Cela signifie que si un utilisateur stocke 500 000 fichiers dans le cloud, il doit recréer et détruire deux arbres avec 1 million de nœuds. Et chaque nœud est un agrégat contenant un graphe de sous-objets. Dans ce contexte, les résultats du profilage étaient attendus. Il s'est avéré que même sans tenir compte de l'algorithmique de fusion, la simple procédure de création et de destruction subséquente d'un grand nombre de petits objets coûte cher. La situation est aggravée par le fait que l'opération de synchronisation de base est intégrée dans un grand nombre de scénarios utilisateurs. En conséquence, nous notons un second critère important dans le choix d'une base de données : la possibilité de réaliser des opérations CRUD sans allocation dynamique d'objets.
D'autres exigences sont plus traditionnelles et leur liste complète est la suivante.
- Filtrage de la sécurité des threads.
- Multiprocessing. Cela est dicté par le désir d'utiliser la même instance de base de données pour synchroniser l'état non seulement entre les threads, mais aussi entre l'application principale et les extensions iOS.
- Possibilité de représenter les entités stockées sous la forme d'objets immuables.
- Absence d'allocations dynamiques dans le cadre des opérations CRUD.
- Support des propriétés de base des transactions : atomicité, consistance, isolation et durabilité.
- Vitesse sur les cas les plus populaires.
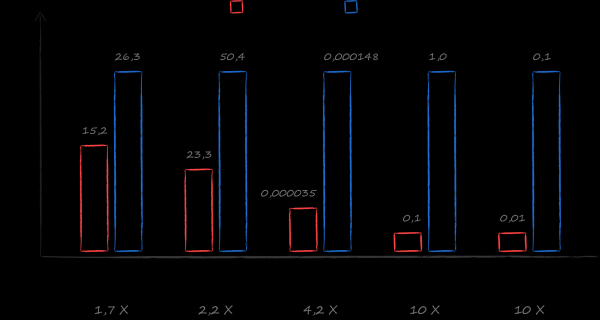
Un bon choix avec cet ensemble d'exigences est et reste SQLite. Cependant, dans le cadre de l'exploration d'alternatives, je suis tombé sur un livre Sous sa direction, un benchmark a été créé pour comparer la vitesse de travail avec différentes bases de données dans le cadre de scénarios cloud réels. Le résultat a dépassé les attentes les plus optimistes. Pour les cas les plus populaires — obtenir un curseur sur une liste triée de tous les fichiers et une liste triée de tous les fichiers pour un répertoire donné — LMDB s'est avéré 10 fois plus rapide que SQLite. Le choix est devenu évident.
2. Positionnement de LMDB
LMDB est une petite bibliothèque (seulement 10K lignes) qui met en œuvre la couche fondamentale la plus basse des bases de données — le stockage.
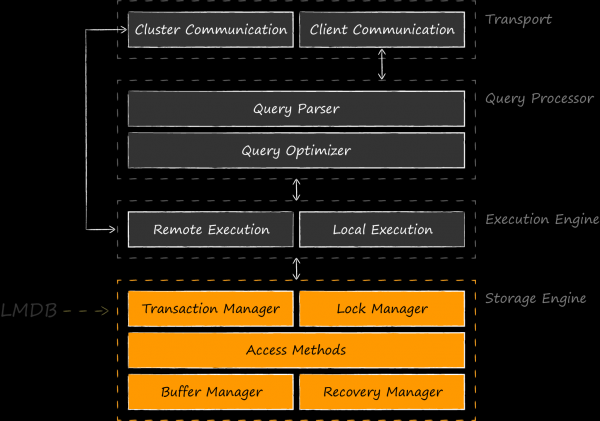
Le schéma ci-dessus montre qu'il n'est pas tout à fait correct de comparer LMDB à SQLite, qui met également en œuvre des niveaux plus élevés, de la même manière qu'il ne serait pas juste de comparer SQLite à Core Data. En tant que concurrents à part entière, il serait plus équitable de citer des moteurs de stockage équivalents — BerkeleyDB, LevelDB, Sophia, RocksDB, etc. Il existe même des projets où LMDB est utilisé comme composant du moteur de stockage pour SQLite. Le premier de ces essais a été réalisé en 2012 l'auteur de LMDB . , qui s'est avéré si intrigant que son initiative a été reprise par des passionnés de l'OSS et a trouvé sa continuité sous le nom de En janvier 2020, l'auteur de ce projet, Den Shearer, l'a présenté lors de LinuxConfAu.
LMDB est principalement utilisé comme moteur pour les bases de données applicatives. La bibliothèque doit son existence aux développeurs , qui étaient très insatisfaits de BerkeleyDB comme base de leur projet. En s'appuyant sur la humble bibliothèque Howard Chu a pu créer l'une des alternatives les plus populaires aujourd'hui. Il a consacré son très bon discours à cette histoire ainsi qu'à la structure interne de LMDB . Un bon exemple de conquête du stockage a été partagé par Leonid Yuriev (aka ) de Positive Technologies lors de son discours à Highload 2015 . Dans celui-ci, il parle de LMDB dans le contexte d'une tâche similaire de mise en œuvre de ReOpenLDAP, et LevelDB a fait l'objet d'une critique comparative. À la suite de cette mise en œuvre, Positive Technologies a même créé un fork en pleine expansion , avec des fonctionnalités, des optimisations et des .
. LMDB est souvent utilisé également comme stockage tel quel. Par exemple, le navigateur Mozilla Firefox pour un certain nombre de besoins, et, à partir de la version 9, Xcode LMDB à SQLite pour le stockage des index.
Le moteur s’est révélé dans le monde du développement mobile. On peut trouver des traces de son utilisation le client iOS pour Telegram. LinkedIn est allé encore plus loin en choisissant LMDB comme stockage par défaut pour son propre cadre de mise en cache de données, Rocket Data, comme dans son article en 2016.
LMDB lutte avec succès pour une place au soleil dans le créneau laissé libre par BerkeleyDB après son passage sous le contrôle d’Oracle. La bibliothèque est appréciée pour sa rapidité et sa fiabilité, même par rapport à ses homologues. Comme on le sait, il n'y a pas de repas gratuits, et il y a lieu de souligner le compromis auquel il faudra faire face en choisissant entre LMDB et SQLite. Le schéma ci-dessus montre clairement comment la rapidité accrue est atteinte. Premièrement, nous ne payons pas pour des couches d'abstraction supplémentaires au-dessus du stockage sur disque. Il va de soi que dans une bonne architecture, on ne peut pas éviter de telles couches, et elles apparaîtront inévitablement dans le code de l'application, mais elles seront beaucoup plus légères. Elles ne comprendront pas de fonctionnalités non nécessaires pour l'application concernée, comme le support des requêtes en SQL. Deuxièmement, il est possible d’optimiser le mapping des opérations applicatives sur les requêtes au stockage sur disque. Alors que SQLite part de besoins moyens d’une application ordinaire, vous, en tant que développeur applicatif, êtes bien conscient des scénarios de charge principaux. Une solution plus performante impliquera un coût accru tant pour le développement de la solution initiale que pour son support ultérieur.
3. Les trois piliers de LMDB
En regardant LMDB d’un point de vue global, il est temps de plonger plus profondément. Les trois sections suivantes seront consacrées à l’analyse des principaux piliers sur lesquels repose l’architecture du stockage :
- Fichiers mappés en mémoire comme mécanisme d'accès au disque et de synchronisation des structures de données internes.
- Arbre B+ comme organisation de la structure des données stockées.
- Copy-on-write comme approche pour garantir les propriétés ACID des transactions et la multi-versioning.
3.1. Pilier n°1. Fichiers mappés en mémoire
Les fichiers mappés en mémoire constituent un élément architectural si important qu'ils figurent même dans le nom du stockage. Les questions de mise en cache et de synchronisation d'accès à l'information stockée sont entièrement laissées à l'operating system. LMDB ne contient aucun cache interne. C'est une décision consciente de l'auteur, car lire les données directement à partir des fichiers mappés permet de contourner de nombreux obstacles dans la mise en œuvre du moteur. Ci-dessous, je présente une liste non exhaustive de certains d'entre eux.
- Le maintien de la cohérence des données dans le stockage lors de son utilisation par plusieurs processus devient la responsabilité de l'operating system. La section suivante examine cette mécanique en détail avec des illustrations.
- L'absence de caches libère entièrement LMDB des frais généraux liés aux allocations dynamiques. La lecture des données consiste en fait à positionner un pointeur à la bonne adresse dans la mémoire virtuelle et rien de plus. Cela semble fantastique, mais dans le code source du stockage, tous les appels à salloc sont concentrés dans la fonction de configuration du stockage.
- L'absence de caches signifie également qu'il n'y a pas de verrous liés à la synchronisation de leur accès. Les lecteurs, dont il peut exister un nombre quelconque à un moment donné, ne rencontrent aucun mutex sur leur chemin vers les données. Cela permet d'obtenir une vitesse de lecture avec une évolutivité linéaire idéale par rapport au nombre de CPU. Dans LMDB, seules les opérations de modification sont synchronisées. À un moment donné, il ne peut y avoir qu'un seul écrivain.
- Un minimum de logique de mise en cache et de synchronisation débarrasse le code des types d'erreurs très complexes liés au travail en environnement multithread. À la conférence Usenix OSDI 2014, deux études intéressantes sur les bases de données ont été présentées : et . On peut y trouver des informations sur la fiabilité sans précédent de LMDB, ainsi que sur sa mise en œuvre pratiquement impeccable des propriétés ACID des transactions, surpassant ce que l'on trouve dans SQLite.
- Le minimalisme de LMDB permet au code de sa représentation machine d'être entièrement placé dans le cache L1 du processeur, avec les caractéristiques de vitesse qui en découlent.
Malheureusement, sur iOS, la gestion des fichiers mappés en mémoire n'est pas aussi simple qu'on le souhaiterait. Pour discuter plus consciemment des inconvénients qui y sont associés, il est nécessaire de se rappeler les principes généraux de la mise en œuvre de ce mécanisme dans les systèmes d'exploitation.
Informations générales sur les fichiers mappés en mémoire
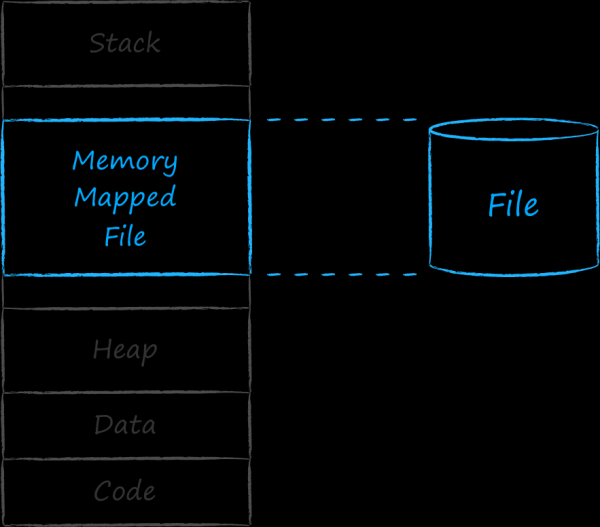 Chaque application exécutée est associée par le système d'exploitation à une entité appelée processus. À chaque processus, un intervalle d'adresses contiguës est attribué, dans lequel il place tout ce dont il a besoin pour fonctionner. Dans les adresses les plus basses se trouvent les sections contenant le code et les données et ressources hardcodées. Ensuite, il y a un bloc d'espace d'adresses dynamiques qui s'élève, bien connu sous le nom de heap. Il contient des adresses d'entités qui apparaissent au cours de l'exécution du programme. En haut se trouve la zone mémoire utilisée par la pile de l'application. Celle-ci croît et se rétrécit, en d'autres termes, sa taille a également une nature dynamique. Pour que la pile et le heap ne se gênent pas, ils sont séparés par les deux extrémités de l'espace d'adresses. Entre les deux sections dynamiques en haut et en bas, il y a un vide. Le système d'exploitation utilise les adresses dans cette zone intermédiaire pour associer au processus diverses entités. En particulier, il peut associer un ensemble contigu d'adresses à un fichier sur le disque. Ce fichier est appelé fichier mappé en mémoire.
L'espace d'adresses alloué au processus est immense. Théoriquement, le nombre d'adresses est limité uniquement par la taille du pointeur, déterminée par la taille du système. Si la mémoire physique était directement mappée 1 à 1, alors le premier processus mangerait toute la RAM, et il ne pourrait être question de multitâche.
Cependant, d'après notre expérience, nous savons que les systèmes d'exploitation modernes peuvent exécuter simultanément autant de processus que nécessaire. Cela est possible parce qu'ils n'attribuent aux processus qu'une grande quantité de mémoire sur le papier, et en réalité, ils ne chargent dans la mémoire physique principale que la partie qui est nécessaire ici et maintenant. C'est pourquoi la mémoire associée à un processus est appelée mémoire virtuelle.
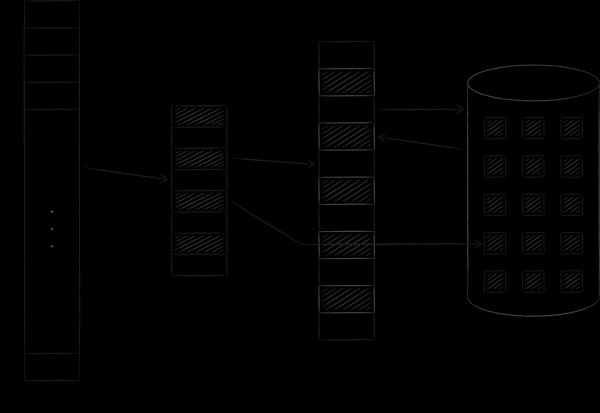
Le système d'exploitation organise la mémoire virtuelle et physique sous forme de pages de taille définie. Dès qu'une page de mémoire virtuelle est demandée, le système d'exploitation la charge en mémoire physique et établit une correspondance entre elles dans une table spéciale. Si aucun emplacement libre n'est disponible, l'une des pages précédemment chargées est copiée sur le disque, et la page demandée prend sa place. Cette procédure, à laquelle nous reviendrons bientôt, s'appelle l'échange (swapping). L'illustration ci-dessous montre le processus décrit. La page A avec l'adresse 0 a été chargée et placée à l'adresse 4 en mémoire principale. Ce fait est reflété dans la table des correspondances à la cellule numéro 0.
L'histoire est exactement la même avec les fichiers affichés en mémoire. Logiquement, ils sont censés être continus et entièrement placés dans l'espace d'adressage virtuel. Cependant, ils entrent en mémoire physique page par page et uniquement sur demande. La modification de ces pages est synchronisée avec le fichier sur le disque. Ainsi, il est possible d'exécuter des opérations d'entrée/sortie de fichiers simplement en travaillant avec des octets en mémoire : toutes les modifications seront automatiquement transférées par le noyau du système d'exploitation vers le fichier d'origine.
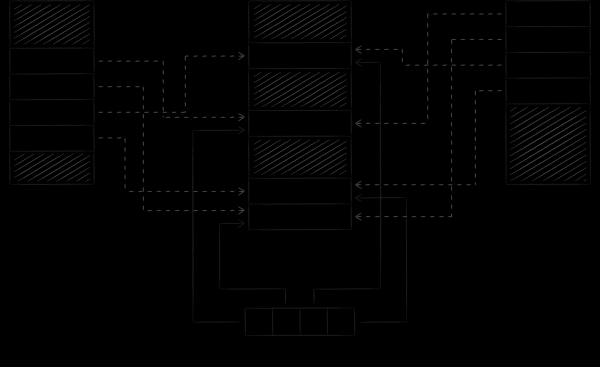
L'image ci-dessous montre comment LMDB synchronise son état lorsqu'il travaille avec une base de données depuis différents processus. En mappant la mémoire virtuelle de différents processus sur le même fichier, de facto, nous obligeons le système d'exploitation à synchroniser transitivement certains blocs de leurs espaces d'adresses, que LMDB consulte.
Un point important est que LMDB modifie par défaut le fichier de données via le mécanisme d'appel système write, tandis que le fichier lui-même est mappé en mode lecture seule. Cette approche a deux conséquences importantes.
La première conséquence est commune à tous les systèmes d'exploitation. Elle consiste à ajouter une protection contre la corruption involontaire de la base de données par un code incorrect. Comme nous le savons, les instructions exécutables d'un processus peuvent accéder aux données depuis n'importe quel endroit de son espace d'adresses. En même temps, comme nous venons de le rappeler, le mappage d'un fichier en mode lecture-écriture signifie que n'importe quelle instruction peut également le modifier. Si cela se produit par erreur, par exemple en essayant réellement de réécrire un élément de tableau à un index inexistant, cela peut entraîner une modification accidentelle du fichier mappé à cette adresse, ce qui entraînera la corruption de la base de données. Si le fichier est mappé en mode lecture seule, alors tenter de modifier l'espace d'adresses correspondant entraînera une fermeture inattendue du programme avec un signal SIGSEGV, et le fichier restera intact.
La deuxième conséquence est déjà spécifique à iOS. Ni l'auteur ni aucune autre source ne la mentionnent explicitement, mais sans elle, LMDB ne serait pas utilisable dans ce système d'exploitation mobile. La prochaine section lui est dédiée.
La spécificité des fichiers mappés en mémoire sous iOS
En 2018, lors de la WWDC, il y avait une excellente présentation . Elle explique qu'en iOS, toutes les pages situées dans la mémoire physique appartiennent à l'un des 3 types : dirty, compressed et clean.
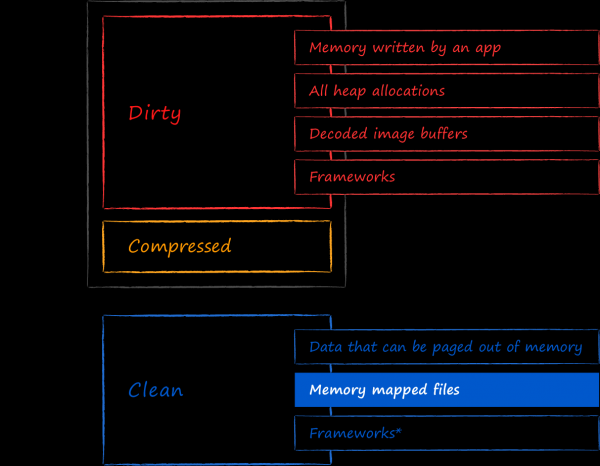
La mémoire propre est un ensemble de pages qui peuvent être sans douleur déplacées de la mémoire physique. Les données qu'elles contiennent peuvent être rechargées à partir de leurs sources initiales si nécessaire. Les fichiers mappés en lecture seule tombent précisément dans cette catégorie. iOS n'a pas peur de décharger à tout moment les pages mappées vers des fichiers de la mémoire, car elles sont garantis d'être synchronisées avec le fichier sur le disque.
La mémoire dirty comprend toutes les pages modifiées, peu importe où elles se trouvaient à l'origine. En particulier, les fichiers mappés en mémoire qui ont été modifiés par l'écriture dans la mémoire virtuelle qui leur est associée seront également classés ainsi. En ouvrant LMDB avec le drapeau MDB_WRITEMAP, après avoir apporté des modifications, vous pourrez le constater personnellement.
Une fois que l'application commence à utiliser trop de mémoire physique, iOS compresse ses pages dirty. La quantité de mémoire occupée par les pages dirty et compressées constitue ce que l'on appelle l'empreinte mémoire de l'application. Lorsqu'elle atteint un certain seuil, le démon système OOM killer intervient et termine le processus de manière forcée. C'est ce qui distingue iOS des systèmes d'exploitation de bureau. Contrairement à ces derniers, la réduction de l'empreinte mémoire par l'échange de pages de la mémoire physique vers le disque n'est pas prévue dans iOS. Les raisons en sont incertaines. Peut-être que le processus de déplacement intensif des pages vers le disque et vice versa est trop énergivore pour les appareils mobiles, ou qu'iOS économise les ressources de réécriture des cellules sur les disques SSD, ou encore que les concepteurs étaient insatisfaits de la performance globale du système, où tout est constamment échangé. Quoi qu'il en soit, le fait est là.
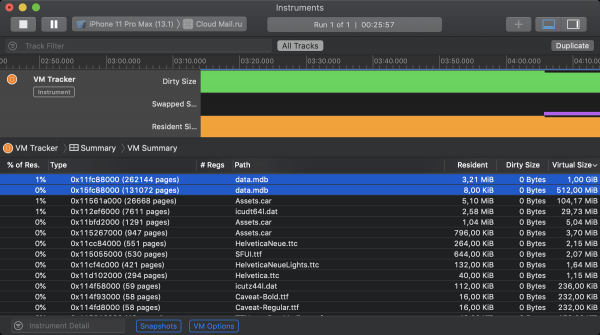
La bonne nouvelle, déjà mentionnée précédemment, est que LMDB n'utilise pas par défaut le mécanisme mmap pour mettre à jour les fichiers. Cela signifie que les données affichées sont classées par iOS comme mémoire propre et n'augmentent pas l'empreinte mémoire. On peut s'en rendre compte grâce à un outil Xcode appelé VM Tracker. Dans la capture d'écran ci-dessous, on peut voir l'état de la mémoire virtuelle de l'application iOS Obcloud pendant son fonctionnement. Lors du démarrage, deux instances de LMDB ont été initialisées. La première a été autorisée à mapper son fichier sur 1GiB de mémoire virtuelle, la deuxième sur 512MiB. Bien que les deux magasins occupent une certaine quantité de mémoire résidente, aucun d'eux ne contribue à la taille dirty.
Et maintenant, parlons des mauvaises nouvelles. Grâce au mécanisme d'échange dans les systèmes d'exploitation de bureau 64 bits, chaque processus peut occuper autant d'espace d'adresse virtuelle que l'espace libre sur le disque dur le permet pour son potentiel d'échange. Le remplacement de l'échange par la compression dans iOS réduit radicalement le maximum théorique. Maintenant, tous les processus actifs doivent tenir dans la mémoire principale (c'est-à-dire la RAM), et ceux qui ne peuvent pas sont terminés de manière forcée. Cela est mentionné dans le passage précédent. , ainsi que dans En conséquence, iOS limite strictement la taille de la mémoire accessible pour l'allocation via mmap. Voici On peut examiner les limites empiriques des volumes de mémoire alloués sur différents dispositifs à l'aide de cet appel système. Sur les modèles de smartphones iOS les plus modernes, on a accès à 2 Go, tandis que les versions haut de gamme de l'iPad en proposent 4. En pratique, il faut se concentrer sur les modèles d'entrée de gamme pris en charge, où la situation est assez morose. Pire encore, en examinant l'état de la mémoire de l'application dans le VM Tracker, on peut constater que LMDB n'est pas la seule à prétendre à la mémoire mappée. D'importants morceaux sont pris par les allocateurs systèmes, les fichiers de ressources, les frameworks pour le traitement d'images et d'autres prédateurs moins gros.
À l'issue des expérimentations dans le Cloud, nous avons abouti aux valeurs compromettantes suivantes pour la mémoire allouée à LMDB : 384 mégaoctets pour les dispositifs 32 bits et 768 pour les dispositifs 64 bits. Après avoir épuisé ce volume, toutes les opérations de modification commencent à se terminer avec le code MDB_MAP_FULL. Nous observons ces erreurs dans notre surveillance, mais leur fréquence est suffisamment faible pour qu'à ce stade, elles puissent être négligées.
Une raison non évidente de la consommation excessive de mémoire par le stockage peut être liée aux transactions de longue durée. Pour comprendre comment ces deux phénomènes sont liés, examinons les deux autres piliers de LMDB.
3.2. Pilier n°2. L'arbre B+
Pour émuler des tables au-dessus d'un stockage clé-valeur, il est nécessaire que son API comprenne les opérations suivantes :
- Insertion d'un nouvel élément.
- Recherche d'un élément avec une clé donnée.
- Suppression d'un élément.
- Itération sur des intervalles de clés dans l'ordre de leur tri.
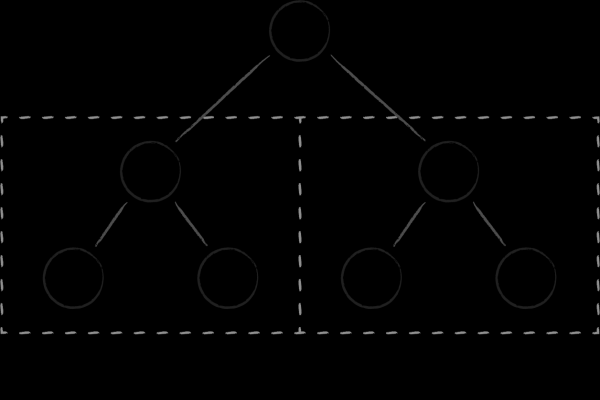 La structure de données la plus simple, qui permet d'implémenter facilement les quatre opérations, est l'arbre binaire de recherche. Chaque nœud représente une clé, divisant ainsi tous les sous-ensembles de clés filles en deux sous-arbres. À gauche se trouvent celles qui sont inférieures au parent, et à droite celles qui sont supérieures. L'obtention d'un ensemble de clés ordonné est réalisée par l'un des parcours classiques de l'arbre.
Les arbres binaires présentent deux défauts fondamentaux qui les empêchent d'être efficaces en tant que structures de données sur disque. D'une part, leur degré de équilibrage est imprévisible. Il existe un risque considérable de se retrouver avec des arbres où la hauteur des différentes branches peut varier fortement, ce qui dégrade nettement la complexité algorithmique de la recherche par rapport à ce qui est attendu. D'autre part, l'abondance de liens entre les nœuds prive les arbres binaires de leur localité en mémoire. Des nœuds proches (en termes de liens entre eux) peuvent se retrouver sur des pages complètement différentes dans la mémoire virtuelle. En conséquence, même pour une simple traversée de plusieurs nœuds adjacents dans l'arbre, il peut être nécessaire de visiter un nombre comparable de pages. Cela pose problème même lorsque l'on considère l'efficacité des arbres binaires en tant que structures de données en mémoire, car la rotation constante des pages dans le cache du processeur est un luxe coûteux. Lorsque l'on parle de charger fréquemment des pages liées aux nœuds depuis le disque, la situation devient carrément .
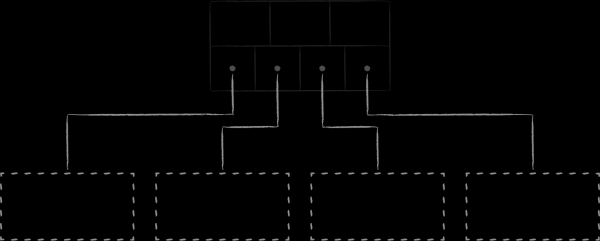 Les arbres B, étant une évolution des arbres binaires, résolvent les problèmes mentionnés dans le paragraphe précédent. Tout d'abord, ils sont auto-équilibrés. Deuxièmement, chaque nœud divise plusieurs enfants clés non pas en 2, mais en M sous-ensembles ordonnés, où M peut être assez grand, de l'ordre de plusieurs centaines, voire milliers.
Grâce à cela :
- Chaque nœud contient un grand nombre de clés déjà ordonnées et les arbres deviennent très plats.
- L'arbre acquiert la propriété de localité d'allocation en mémoire, car des clés proches par leur valeur se retrouvent naturellement côte à côte sur le même nœud ou des nœuds adjacents.
- Le nombre de nœuds intermédiaires diminue lors de la descente dans l'arbre lors d'une opération de recherche.
- Le nombre de nœuds cibles lus lors des requêtes de plage diminue, car chacun d'eux contient déjà un grand nombre de clés ordonnées.
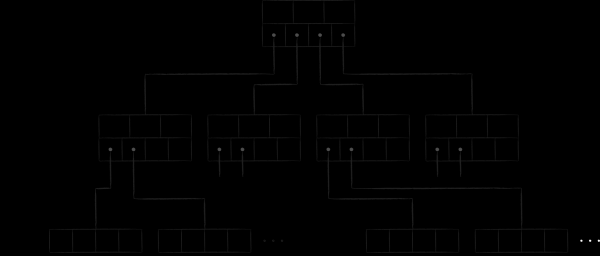
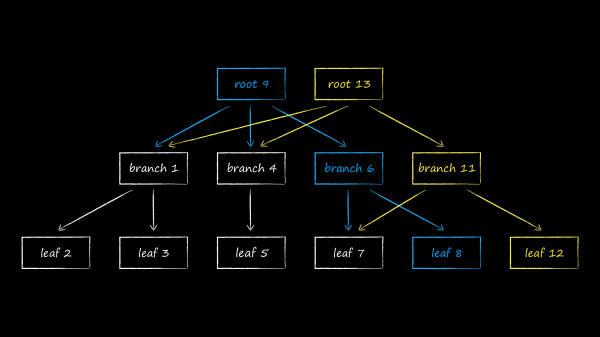
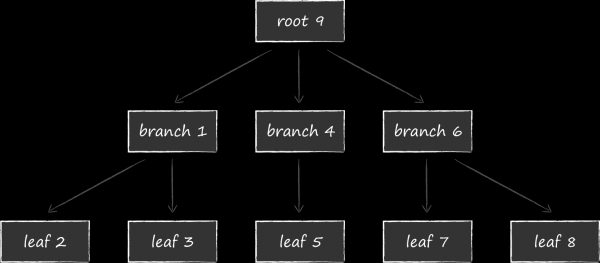
Dans LMDB, une des variantes de l'arbre B appelée arbre B+ est utilisée pour stocker les données. Le schéma ci-dessus illustre trois types de nœuds qui y figurent :
- À la pointe se trouve la racine (root). Elle matérialise elle-même rien d'autre que le concept de la base de données dans le stockage. À l'intérieur d'une instance LMDB, il est possible de créer plusieurs bases de données, partageant entre elles un espace d'adresses virtuel mappé. Chacune d'elles commence par sa propre racine.
- Au niveau le plus bas se trouvent les feuilles (leaf). Ce sont elles qui contiennent exclusivement les paires clé-valeur stockées dans la base de données. À propos, c'est là que réside la particularité des arbres B+. Contrairement à un arbre B classique qui stocke les parties value dans les nœuds de tous les niveaux, la variation B+ ne les stocke qu'au niveau le plus bas. En prenant en compte ce fait, nous appellerons désormais le sous-type de l'arbre utilisé dans LMDB simplement un arbre B.
- Entre la racine et les feuilles se situent 0 niveaux techniques ou plus avec des nœuds de navigation (branch). Leur tâche est de diviser l'ensemble trié des clés entre les feuilles.
Physiquement, les nœuds sont des blocs de mémoire de longueur prédéfinie. Leur taille est un multiple de la taille des pages mémoire dans le système d'exploitation, dont nous avons discuté plus haut. Ci-dessous est affichée la structure d'un nœud. Dans l'en-tête se trouve des métadonnées, dont la plus évidente pour l'exemple est le contrôle de la somme. Ensuite, viennent les informations sur les offsets où se trouvent les cellules de données. Les données peuvent être soit des clés, dans le cas des nœuds de navigation, soit des paires clé-valeur entières dans le cas des feuilles. Vous pouvez en savoir plus sur la structure des pages dans le document .
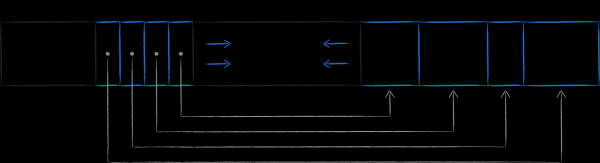
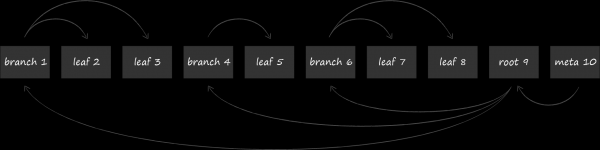
Une fois que nous avons compris le contenu interne des nœuds de page, nous allons simplifier la représentation de l'arbre B de LMDB comme suit.
Les pages avec des nœuds sont disposées consécutivement sur le disque. Les pages avec des numéros plus élevés sont situées plus près de la fin du fichier. La soi-disant page méta (meta page) contient des informations sur les offsets par lesquels il est possible de trouver les racines de tous les arbres. Lors de l'ouverture d'un fichier, LMDB scanne le fichier page par page de la fin vers le début à la recherche d'une page méta valide, et c'est par son intermédiaire qu'il trouve les bases de données existantes.
Maintenant que nous avons une compréhension de la structure logique et physique de l'organisation des données, nous pouvons passer à l'examen du troisième pilier de LMDB. C'est grâce à lui que toutes les modifications du stockage se produisent de manière transactionnelle et isolée les unes des autres, donnant à la base de données dans son ensemble la propriété de la multi-version.
3.3. Pilier n°3. Copy-on-write
Certaines opérations avec les B-arbres impliquent une série de modifications dans ses nœuds. Un exemple est l'ajout d'une nouvelle clé dans un nœud qui a déjà atteint sa capacité maximale. Dans ce cas, il est nécessaire, tout d'abord, de diviser le nœud en deux, et ensuite d'ajouter un lien vers le nouveau nœud fils détaché dans son parent. Cette procédure est potentiellement très dangereuse. Si, pour une raison quelconque (plantage, coupure de courant, etc.), seule une partie des changements de la série est effectuée, l'arbre restera dans un état incohérent.
Une des solutions traditionnelles pour garantir la résilience d'une base de données aux pannes consiste à ajouter à côté du B-arbre une structure de données supplémentaire sur disque : le journal des transactions, également connu sous le nom de write-ahead log (WAL). C'est un fichier dans lequel l'opération supposée est écrite strictement avant la modification du B-arbre lui-même. Ainsi, si une corruption des données est détectée lors de l'autodiagnostic, la base de données consulte le journal pour se remettre en ordre.
LMDB, en tant que mécanisme de résilience aux pannes, a choisi une autre méthode appelée copy-on-write. Son essence est que, au lieu de mettre à jour les données sur une page existante, elle la copie entièrement et toutes les modifications sont ensuite effectuées sur la copie.
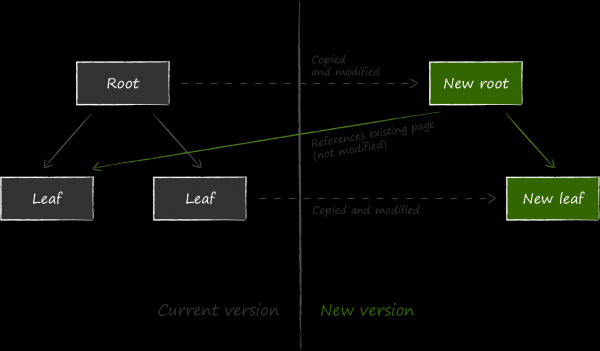
Ensuite, pour que les données mises à jour soient accessibles, il est nécessaire de modifier le lien vers le nœud devenu actuel dans le parent par rapport à lui. Étant donné que cela nécessite également de modifier le parent, celui-ci est également copié au préalable. Le processus se poursuit récursivement jusqu'à la racine. En dernier, les données sur la page de méta sont modifiées.
Si, par malheur, pendant la procédure de mise à jour, il y a une terminaison imprévue du processus, soit une nouvelle méta-page ne sera pas créée, soit elle ne sera pas enregistrée sur le disque jusqu'à la fin, et sa somme de contrôle sera incorrecte. Dans l'un de ces deux cas, les nouvelles pages seront inaccessibles et les anciennes ne seront pas affectées. Cela libère LMDB de la nécessité de maintenir un journal d'écriture en avant pour assurer la cohérence des données. De facto, la structure de stockage des données sur le disque décrite ci-dessus assume également cette fonction. L'absence explicite d'un journal de transactions est l'une des caractéristiques de LMDB, garantissant une haute vitesse de lecture des données.
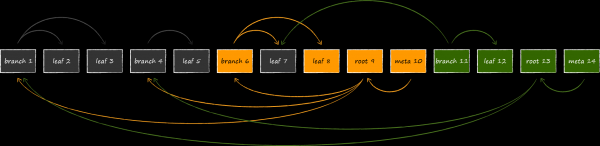
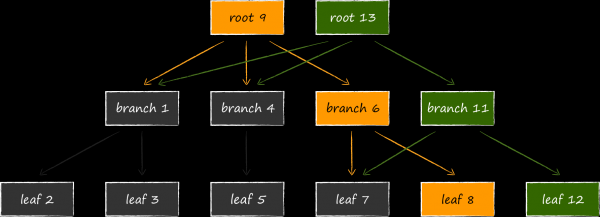
La structure résultante appelée B-tree append-only garantit naturellement l'isolation des transactions et la multi-version. Dans LMDB, chaque transaction ouverte est associée à la racine de l'arbre actuelle. Tant que la transaction n'est pas terminée, les pages de l'arbre qui lui est lié ne seront jamais modifiées ou réutilisées pour de nouvelles versions des données. Ainsi, il est possible de travailler indéfiniment avec le même ensemble de données qui était valide au moment de l'ouverture de la transaction, même si le stockage continue à être activement mis à jour. C'est l'essence de la multi-version, qui fait de LMDB une source de données idéale pour tous nos bien-aimés UICollectionView. En ouvrant une transaction, il n'est pas nécessaire d'augmenter la mémoire utilisée par l'application en extrayant rapidement les données actuelles dans une structure in-memory, craignant de se retrouver à court. Cette particularité distingue positivement LMDB de SQLite, qui ne peut pas se vanter d'une isolation aussi totale. En ouvrant deux transactions dans ce dernier et en supprimant une certaine entrée dans le cadre de l'une d'elles, cette même entrée ne pourra plus être récupérée non plus dans le cadre de la seconde transaction restante.
L'envers du décor est une consommation potentiellement beaucoup plus importante de la mémoire virtuelle. La diapositive montre à quoi ressemblera la structure de la base de données si elle est modifiée simultanément avec 3 transactions de lecture ouvertes, regardant différentes versions de la base de données. Comme LMDB ne peut pas réutiliser les nœuds accessibles depuis les racines liées aux transactions en cours, le stockage n'a d'autre choix que de placer en mémoire une quatrième racine et de cloner à nouveau les pages modifiables sous elle.
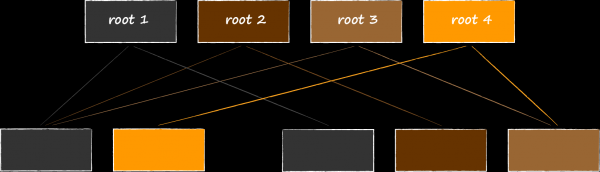
Il est utile de se remémorer la section sur les fichiers mappés en mémoire. Bien que le coût supplémentaire de la mémoire virtuelle ne devrait pas trop nous inquiéter, car il n'affecte pas l'empreinte mémoire de l'application. Cependant, il a été noté qu'iOS est très avare dans son allocation, et nous ne pouvons pas, comme sur un serveur ou un bureau, offir à LMDB une région de 1 To sans nous soucier de cette particularité. Il est donc préférable de rendre la durée de vie des transactions aussi courte que possible.
4. Conception du schéma de données au-dessus de l'API clé-valeur
Nous commencerons l'analyse de l'API par un examen des abstractions de base fournies par LMDB : environnement et bases de données, clés et valeurs, transactions et curseurs.
Remarque sur les extraits de code
Toutes les fonctions de l'API publique de LMDB renvoient le résultat de leur opération sous forme de code d'erreur, mais dans tous les extraits suivants, la vérification de celui-ci a été omise au profit de la concision. Dans la pratique, nous avons utilisé notre propre wrapper C++ , où les erreurs se matérialisent sous forme d'exceptions C++.
Comme moyen le plus rapide de connecter LMDB au projet pour iOS ou macOS, je propose ma CocoaPod .
4.1. Abstractions de base
Environnement (environment)
Structure MDB_env est le réceptacle de l'état interne de LMDB. La famille de fonctions avec le préfixe mdb_env permet de configurer certaines de ses propriétés. Dans le cas le plus simple, l'initialisation du moteur se déroule comme suit.
mdb_env_create(env);
mdb_env_set_map_size(*env, 1024 * 1024 * 512)
mdb_env_open(*env, path.UTF8String, MDB_NOTLS, 0664);Dans l'application Cloud Mail.ru, nous n'avons modifié les valeurs par défaut que pour deux paramètres.
Le premier d'entre eux est la taille de l'espace d'adressage virtuel, sur lequel le fichier de stockage est mappé. Malheureusement, même sur le même appareil, la valeur spécifique peut varier considérablement d'un lancement à l'autre. Pour tenir compte de cette particularité d'iOS, la taille maximale du stockage est déterminée dynamiquement. En commençant par une certaine valeur, elle est ensuite réduite de moitié jusqu'à ce que la fonction mdb_env_open ne retourne un résultat différent de ENOMEM. En théorie, il existe aussi l'approche inverse : d'abord allouer un minimum de mémoire au moteur, puis, en cas d'erreurs MDB_MAP_FULL, l'augmenter. Cependant, cela est beaucoup plus compliqué. La raison en est que la procédure de réallocation de mémoire (remap) via la fonction mdb_env_set_map_size invalide toutes les entités (curseurs, transactions, clés et valeurs) obtenues précédemment du moteur. Tenir compte de ce tournant des événements dans le code compliquera considérablement sa structure. Si, néanmoins, la mémoire virtuelle est très précieuse pour vous, cela pourrait être une raison d'explorer un fork qui a pris beaucoup d'avance, , où parmi les caractéristiques annoncées figure "ajustement automatique de la taille de la base de données à la volée."
Le second paramètre, dont la valeur par défaut ne nous a pas convenu, régule la mécanique de la sécurité des threads. Malheureusement, au moins dans iOS 10, il y a des problèmes de prise en charge du stockage local des threads. Pour cette raison, dans l'exemple ci-dessus, le stockage est ouvert avec le drapeau MDB_NOTLS. De plus, il était également nécessaire le wrapper C++ , afin de supprimer les variables avec cet attribut.
Bases de données
La base de données est une instance distincte d'un arbre B, dont nous avons parlé ci-dessus. Son ouverture se fait dans le cadre d'une transaction, ce qui peut sembler un peu étrange au départ.
MDB_txn *txn;
MDB_dbi dbi;
mdb_txn_begin(env, NULL, MDB_RDONLY, &txn);
mdb_dbi_open(txn, NULL, MDB_CREATE, &dbi);
mdb_txn_abort(txn);En effet, une transaction dans LMDB est une entité de stockage, et non d'une base de données particulière. Ce concept permet des opérations atomiques sur les entités présentes dans différentes bases de données. En théorie, cela ouvre la possibilité de modéliser des tables sous forme de bases différentes, mais pour ma part, j'ai choisi une autre voie, décrite en détail ci-dessous.
Clés et valeurs
Structure MDB_val modélise à la fois la clé et la valeur. Le stockage n'a aucune idée de leur sémantique. Pour lui, quelque chose ou autre chose n'est qu'un tableau d'octets d'une taille donnée. La taille maximale de la clé est de 512 octets.
typedef struct MDB_val {
size_t mv_size;
void *mv_data;
} MDB_val;À l'aide du comparateur, le stockage ordonne les clés par ordre croissant. Si vous ne remplacez pas le vôtre, le par défaut sera utilisé, qui les trie octet par octet dans l'ordre lexicographique.
Transactions
Le mécanisme des transactions est décrit en détail dans , donc ici je vais brièvement répéter leurs principales propriétés :
- Support de toutes les propriétés de base : atomicité, cohérence, isolation et durabilité. Je ne peux pas m'empêcher de noter qu'il existe un bug concernant la durabilité sur macOS et iOS, corrigé dans MDBX. Vous pouvez en lire plus dans leurs .
- L'approche multi-thread est décrite par le schéma « écrivain unique / lecteurs multiples ». Les écrivains se bloquent mutuellement, mais ne bloquent pas les lecteurs. Les lecteurs ne bloquent ni les écrivains ni entre eux.
- Prise en charge des transactions imbriquées.
- Support de la multi-version.
La multi-version dans LMDB est si bonne que je veux la démontrer en action. Le code ci-dessous montre que chaque transaction fonctionne avec la version de la base de données qui était actuelle au moment de son ouverture, étant complètement isolée de tous les changements ultérieurs. L'initialisation du stockage et l'ajout d'un enregistrement de test ne présentent rien d'intéressant, donc ces rituels sont laissés sous spoiler.
Ajout d'un enregistrement de test
MDB_env *env;
MDB_dbi dbi;
MDB_txn *txn;

mdb_env_create(&env);
mdb_env_open(env, ".\/testdb", MDB_NOTLS, 0664);

mdb_txn_begin(env, NULL, 0, &txn);
mdb_dbi_open(txn, NULL, 0, &dbi);
mdb_txn_abort(txn);

char k = 'k';
MDB_val key;
key.mv_size = sizeof(k);
key.mv_data = (void *)&k;

int v = 997;
MDB_val value;
value.mv_size = sizeof(v);
value.mv_data = (void *)&v;

mdb_txn_begin(env, NULL, 0, &txn);
mdb_put(txn, dbi, &key, &value, MDB_NOOVERWRITE);
mdb_txn_commit(txn);
MDB_txn *txn1, *txn2, *txn3;
MDB_val val;
// Ouvrant 2 transactions, chacune d'elles regardant
// la version de la base de données avec une seule entrée.
mdb_txn_begin(env, NULL, 0, &txn1); // lecture-écriture
mdb_txn_begin(env, NULL, MDB_RDONLY, &txn2); // lecture seule
// Dans le cadre de la première transaction, supprimons l'entrée existante de la base de données.
mdb_del(txn1, dbi, &key, NULL);
// Validons la suppression.
mdb_txn_commit(txn1);
// Ouvrons une troisième transaction, qui regarde
// la version actuelle de la base de données, où l'entrée n'existe déjà plus.
mdb_txn_begin(env, NULL, MDB_RDONLY, &txn3);
// Assurons-nous que l'entrée correspondant à la clé recherchée n'existe déjà plus.
assert(mdb_get(txn3, dbi, &key, &val) == MDB_NOTFOUND);
// Terminons la transaction.
mdb_txn_abort(txn3);
// Vérifions que dans le cadre de la deuxième transaction, ouverte au moment
// de l'existence de l'entrée dans la base de données, elle est toujours accessible par la clé.
assert(mdb_get(txn2, dbi, &key, &val) == MDB_SUCCESS);
// Vérifions que pour la clé, nous avons reçu des données valides et non pas des déchets.
assert(*(int *)val.mv_data == 997);
// Terminons la transaction, travaillant malgré tout avec une base de données obsolète mais cohérente.
mdb_txn_abort(txn2);Je recommande en option d'essayer de faire le même tour avec SQLite et de voir ce qui en résulte.
La multi-versionnalité apporte des avantages très agréables dans la vie des développeurs iOS. Grâce à cette propriété, il est facile et sans contrainte de réguler la vitesse de mise à jour de la source de données pour les formulaires d'écran, en fonction de l'expérience utilisateur. Par exemple, prenons une fonctionnalité de l'application Mail.ru appelée chargement automatique de contenu depuis la galerie multimédia système. Avec une bonne connexion, le client peut ajouter plusieurs photos sur le serveur par seconde. Si après chaque chargement, nous actualisons UICollectionView le contenu multimédia dans le nuage de l'utilisateur, on peut oublier les 60 fps et le défilement fluide pendant ce processus. Pour prévenir des mises à jour fréquentes de l'écran, il faut d'une manière ou d'une autre limiter la vitesse de changement des données sous-jacentes. UICollectionViewDataSource.
Si une base de données ne prend pas en charge la version multiple et ne permet de travailler qu'avec l'état actuel, pour créer un instantané stable des données, il est nécessaire de le copier soit dans une structure de données en mémoire, soit dans une table temporaire. Chacune de ces approches est très coûteuse. Dans le cas d'un stockage en mémoire, nous avons des coûts en mémoire liés au stockage des objets construits, et des coûts en temps associés aux transformations ORM excessives. Quant à la table temporaire, c'est un plaisir encore plus coûteux, qui n'a de sens que dans des cas non triviaux.
La multi-versionnalité de LMDB résout la tâche de maintien d'une source de données stable de manière très élégante. Il suffit d'ouvrir une transaction et voilà - tant que nous ne la terminons pas, l'ensemble de données est garanti fixé. La logique de sa vitesse de mise à jour est désormais entièrement entre les mains de la couche de présentation, avec l'absence totale de frais généraux significatifs.
Curseurs
Les curseurs fournissent un mécanisme pour l'itération ordonnée sur les paires clé-valeur en parcourant l'arbre B. Sans eux, il serait impossible de modéliser efficacement des tables dans la base de données, que nous allons examiner.
4.2. Modélisation des tables
La propriété d'ordre des clés permet de construire des abstractions de haut niveau comme une table au-dessus des abstractions de base. Illustrons ce processus avec un exemple de la table principale d'un client cloud, qui cache des informations sur tous les fichiers et dossiers de l'utilisateur.
Schéma de la table
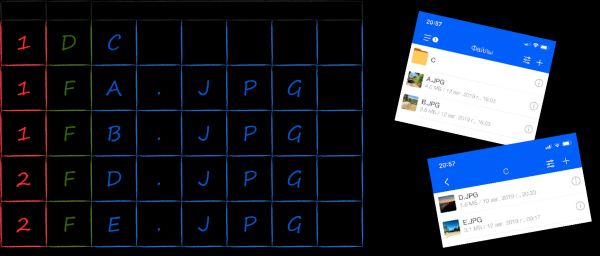
Un des scénarios fréquents pour lesquels la structure de la table avec un arbre de dossiers doit être conçue est la sélection de tous les éléments situés à l'intérieur d'un répertoire donné. Un bon modèle d'organisation des données pour des requêtes efficaces de ce type est . Pour le mettre en œuvre au-dessus d'un stockage clé-valeur, il est nécessaire de trier les clés des fichiers et des dossiers de manière à les regrouper en fonction de leur appartenance au répertoire parent. De plus, pour afficher le contenu du répertoire d'une manière familière pour l'utilisateur de Windows (d'abord les dossiers, puis les fichiers, et les deux triés par ordre alphabétique), il est nécessaire d'inclure dans la clé les champs supplémentaires correspondants.
L'image ci-dessous montre comment, en fonction de la tâche donnée, la représentation des clés peut apparaître sous la forme d'un tableau d'octets. Au début, les octets avec l'identifiant du répertoire parent (rouges) sont placés, puis ceux avec le type (verts), et enfin, ceux avec le nom (bleus). En étant triés par le comparateur par défaut de LMDB dans l'ordre lexicographique, ils sont organisés de la manière requise. L'itération séquentielle des clés avec le même préfixe rouge nous donne les valeurs qui leur sont associées dans l'ordre dans lequel elles doivent être affichées dans l'interface utilisateur (à droite), sans nécessiter de traitement supplémentaire.
Sérialisation des clés et des valeurs
Dans le monde, de nombreux méthodes de sérialisation d'objets ont été inventées. Étant donné que nous n'avions d'autre exigence que la vitesse, nous avons choisi celle qui était la plus rapide — le dump de la mémoire occupée par une instance de la structure de langage C. Ainsi, la clé d'un élément de répertoire peut être modélisée par la structure suivante NodeKey.
typedef struct NodeKey {
EntityId parentId;
uint8_t type;
uint8_t nameBuffer[256];
} NodeKey;Pour sauvegarder NodeKey dans le stockage, il faut positionner le pointeur vers les données à l'adresse de début de la structure, et leur taille peut être calculée avec la fonction MDB_val sizeof MDB_val serialize(NodeKey * const key) { return MDB_val { .mv_size = sizeof(NodeKey), .mv_data = (void *)key }; }.
Dans le premier chapitre sur les critères de sélection d'une base de données, j'ai mentionné la minimisation des allocations dynamiques dans le cadre des opérations CRUD comme un facteur de choix important. Le code de la fonctionserialize montre comment, dans le cas de LMDB, on peut complètement éviter celles-ci lors de l'insertion de nouvelles entrées dans la base de données. Le tableau d'octets en provenance du serveur est d'abord transformé en structures de pile, puis elles sont trivialement dumpées dans le stockage. Étant donné qu'il n'y a également pas d'allocations dynamiques à l'intérieur de LMDB, on peut obtenir une situation incroyable selon les normes iOS — n'utiliser que de la mémoire de pile pour travailler avec des données tout au long de leur parcours depuis le réseau jusqu'au disque ! Ordonnancement des clés par un comparateur binaire
Ordonnancement des clés par un comparateur binaire
L'ordre des clés est défini par une fonction spéciale appelée comparateur. Comme le moteur ne connaît pas la sémantique des octets qu'il contient, le comparateur par défaut n'a d'autre choix que d'ordonner les clés par ordre lexicographique en procédant à une comparaison octet par octet. L'utiliser pour trier des structures est semblable à se raser avec une hache. Néanmoins, dans des cas simples, je trouve cette méthode acceptable. L'alternative est décrite un peu plus bas, et je noterai ici quelques pièges éparpillés sur ce chemin.
La première chose à garder à l'esprit est la représentation en mémoire des types de données primitifs. Ainsi, sur tous les appareils Apple, les variables entiers sont stockées au format . Cela signifie que l'octet le moins significatif se trouve à gauche, et il n'est pas possible de trier les entiers en utilisant leur comparaison octet par octet. Par exemple, tenter de le faire avec un ensemble de nombres de 0 à 511 produira le résultat suivant.
// value (hex dump)
000 (0000)
256 (0001)
001 (0100)
257 (0101)
...
254 (fe00)
510 (fe01)
255 (ff00)
511 (ff01)
Pour résoudre ce problème, les entiers doivent être stockés dans la clé dans un format adapté au comparateur par octets. Les fonctions de la famille hton* (notamment htons pour les nombres à deux octets de l'exemple).
Le format de représentation des chaînes en programmation est, comme on le sait, une véritable . Si la sémantique des chaînes et le codage utilisé pour leur représentation en mémoire supposent qu'un symbole peut occuper plus d'un octet, alors l'idée d'utiliser le comparateur par défaut doit être abandonnée immédiatement.
Deuxième chose à garder à l'esprit : des champs de la structure par le compilateur. En raison de cela, des octets avec des valeurs indésirables peuvent se former en mémoire entre les champs, ce qui casse bien sûr le tri par octets. Pour éliminer les valeurs indésirables, il faut soit déclarer les champs dans un ordre strictement défini, en gardant à l'esprit les règles d'alignement, soit utiliser dans la déclaration de la structure l'attribut packed.
Ordonnancement des clés par un comparateur externe
La logique de comparaison des clés peut se révéler trop complexe pour un comparateur binaire. L'une des nombreuses raisons en est la présence de champs techniques à l'intérieur des structures. Je vais illustrer leur apparition par l'exemple de la clé que nous connaissons déjà pour un élément de répertoire.
typedef struct NodeKey {
EntityId parentId;
uint8_t type;
uint8_t nameBuffer[256];
} NodeKey;Malgré sa simplicité, il consomme dans la grande majorité des cas trop de mémoire. Le tampon pour le nom occupe 256 octets, bien que les noms de fichiers et de dossiers dépassent rarement 20 à 30 caractères en moyenne.
Une des techniques standard pour optimiser la taille d'une entrée consiste à la ``couper'' à sa taille réelle. L'idée est que le contenu de tous les champs de longueur variable est stocké dans le tampon à la fin de la structure, et leur longueur est conservée dans des variables séparées. Conformément à cette approche, la clé NodeKey se transforme comme suit.
typedef struct NodeKey {
EntityId parentId;
uint8_t type;
uint8_t nameLength;
uint8_t nameBuffer[256];
} NodeKey;Ensuite, lors de la sérialisation, la taille des données spécifiée n'est pas celle de la structure entière, mais la taille de tous les champs de longueur fixe plus la taille de la partie réellement utilisée du tampon. MDB_val serialize(NodeKey * const key) { return MDB_val { .mv_size = sizeof(NodeKey), .mv_data = (void *)key }; } MDB_val serialize(NodeKey * const key) { return MDB_val { .mv_size = offsetof(NodeKey, nameBuffer) + key->nameLength, .mv_data = (void *)key }; }
En conséquence du refactoring effectué, nous avons réalisé une économie significative de l'espace occupé par les clés. Cependant, en raison du champ techniquenameLength , le compareur binaire par défaut n'est plus adapté pour comparer les clés. Si nous ne le remplaçons pas par notre propre, la longueur du nom sera un facteur plus prioritaire lors du tri que le nom lui-même.LMDB permet d'assigner à chaque base de données sa propre fonction de comparaison des clés. Cela se fait à l'aide de la fonction
mdb_set_compare strictement avant l'ouverture. Pour des raisons évidentes, il ne peut pas être changé durant toute la vie de la base de données. En entrée, le compareur reçoit deux clés au format binaire, et en sortie, il renvoie le résultat de la comparaison : moins (-1), plus (1) ou égales (0). Le pseudocode pour ressemble à ceci. NodeKey int compare(MDB_val * const a, MDB_val * const b) { NodeKey * const aKey = (NodeKey * const)a->mv_data; NodeKey * const bKey = (NodeKey * const)b->mv_data; return // ... }
Tant que toutes les clés dans la base de données sont du même type, le miisement inconditionnel de leur représentation binaire au type de la structure de clé appliquée est légal. Il y a un petit détail, mais il sera discuté un peu plus bas dans la section "Lecture des entrées".Sérialisation des valeurs
Sérialisation des valeurs
Les clés des enregistrements stockés dans LMDB fonctionnent de manière extrêmement intensive. Leur comparaison se fait dans le cadre de toute opération applicative, et la vitesse du comparateur influe sur les performances de l'ensemble de la solution. Dans un monde idéal, un comparateur binaire par défaut suffirait pour comparer les clés, mais si l'on doit utiliser son propre comparateur, alors la procédure de désérialisation des clés doit être aussi rapide que possible.
La valeur partie d'un enregistrement (la valeur) n'intéresse pas particulièrement la base de données. Sa transformation de la représentation binaire en objet se produit seulement lorsque le code applicatif en a besoin, par exemple, pour l'afficher à l'écran. Comme cela arrive relativement rarement, les exigences de vitesse pour cette procédure ne sont pas si critiques, et dans sa mise en œuvre, nous sommes beaucoup plus libres de nous concentrer sur la commodité. Par exemple, pour la sérialisation des métadonnées sur les fichiers non chargés, nous utilisons NSKeyedArchiver.
NSData *data = serialize(object);
MDB_val value = {
.mv_size = data.length,
.mv_data = (void *)data.bytes
};Cependant, il y a des cas où la performance a tout de même de l'importance. Par exemple, pour la sauvegarde des métadonnées de la structure de fichiers d'un cloud utilisateur, nous utilisons toujours le même dump mémoire des objets. La particularité de la tâche de formation de leur représentation sérialisée est le fait que les éléments du répertoire sont modélisés par une hiérarchie de classes.
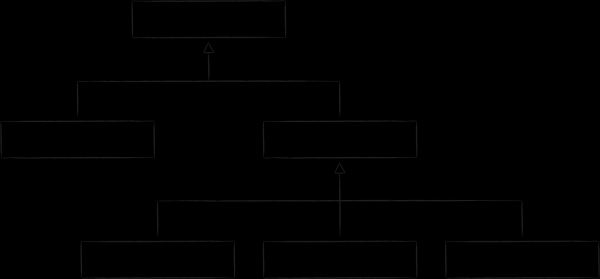
Pour sa mise en œuvre en langage C, les champs spécifiques des héritiers sont placés dans des structures séparées, et leur lien avec la base est établi par un champ de type union. Le contenu actuel de l'union est défini par un attribut technique type.
typedef struct NodeValue {
EntityId localId;
EntityType type;
union {
FileInfo file;
DirectoryInfo directory;
} info;
uint8_t nameLength;
uint8_t nameBuffer[256];
} NodeValue;Ajout et mise à jour des enregistrements
Les clés et valeurs sérialisées peuvent être ajoutées au stockage. Pour cela, la fonction est utilisée mdb_put.
// key и value имеют тип MDB_val
mdb_put(..., &key, &value, MDB_NOOVERWRITE);Lors de la configuration de l'entrepôt, il est possible de permettre ou d'interdire le stockage de plusieurs enregistrements avec la même clé. Si la duplication des clés est interdite, lors de l'insertion d'un enregistrement, il est possible de déterminer si la mise à jour d'un enregistrement existant est autorisée ou non. Si le remplacement ne peut se produire qu'en raison d'une erreur dans le code, il est possible de se prémunir contre cela en spécifiant un indicateur. NOOVERWRITE.
Lecture des enregistrements
La fonction conçue pour lire les enregistrements dans LMDB est mdb_get. Si la paire clé-valeur a déjà été présentée avec des structures dumppées, cette procédure se présente comme suit.
NodeValue * const readNode(..., NodeKey * const key) {
MDB_val rawKey = serialize(key);
MDB_val rawValue;
mdb_get(..., &rawKey, &rawValue);
return (NodeValue * const)rawValue.mv_data;
}Le listing présenté montre comment la sérialisation via le dump de structures permet de se débarrasser des allocations dynamiques non seulement lors de l'écriture, mais aussi lors de la lecture des données. Le pointeur obtenu de la fonction mdb_get regarde précisément à l'adresse de la mémoire virtuelle où la base de données stocke la représentation binaire de l'objet. En réalité, nous obtenons une sorte d'ORM, fournissant pratiquement gratuitement une vitesse de lecture des données très élevée. Malgré toute la beauté de cette approche, il est important de se rappeler plusieurs caractéristiques associées.
- Pour une transaction en lecture seule, le pointeur vers la structure-valeur restera garanti valide tant que la transaction n'est pas terminée. Comme mentionné précédemment, les pages de l'arbre B où l'objet est situé, grâce au principe de copy-on-write, restent inchangées tant qu'elles sont référencées par au moins une transaction. D'un autre côté, dès que la dernière transaction qui leur est associée se termine, les pages peuvent être réutilisées pour de nouvelles données. Si les objets doivent survivre à la transaction qui les a engendrés, ils devront néanmoins être copiés.
- Pour une transaction en lecture-écriture, le pointeur vers la structure-valeur obtenue ne sera valide que jusqu'à la première opération de modification (écriture ou suppression de données).
- Bien que la structure
NodeValuene soit pas complète, mais tronquée (voir la section « Ordonnancement des clés par un comparateur externe »), on peut facilement accéder à ses champs via le pointeur. L'essentiel est de ne pas le déréférencer ! - En aucun cas, il ne faut modifier la structure via le pointeur obtenu. Tous les changements doivent être effectués uniquement par la méthode
mdb_put. Cependant, même avec tout le désir de le faire, cela ne sera pas possible, car la zone mémoire où cette structure réside est mappée en mode lecture seule. - Remapper le fichier dans l'espace d'adressage du processus dans le but, par exemple, d'augmenter la taille maximale de stockage à l'aide de la fonction
mdb_env_set_map_sizeannule complètement toutes les transactions ainsi que les entités associées en général et les pointeurs vers les objets lus en particulier.
Enfin, une autre caractéristique est si sournoise que sa révélation ne peut tout simplement pas se résumer à un autre point. Dans le chapitre sur l'arbre B, j'ai présenté un schéma de la disposition de ses pages en mémoire. Cela implique que l'adresse du début du tampon contenant les données sérialisées peut être complètement arbitraire. En raison de cela, le pointeur vers celles-ci, obtenu dans la structure MDB_val et converti en pointeur vers la structure, se révèle en général non aligné. En même temps, les architectures de certaines puces (dans le cas d'iOS, c'est armv7) exigent que l'adresse de toute donnée soit un multiple de la taille d'un mot machine ou, en d'autres termes, du bit des systèmes (pour armv7, c'est 32 bits). En d'autres termes, une opération comme *(int *foo)0x800002 est équivalente à une fuite et entraîne une exécution avec le verdict EXC_ARM_DA_ALIGN. On peut éviter un sort aussi malheureux de deux manières.
La première consiste à copier les données à l'avance dans une structure manifestement alignée. Par exemple, avec un comparateur personnalisé, cela se traduira comme suit.
int compare(MDB_val * const a, MDB_val * const b) {
    NodeKey aKey, bKey;
    memcpy(&aKey, a->mv_data, a->mv_size);
    memcpy(&bKey, b->mv_data, b->mv_size);
    return // ...
}
Un chemin alternatif consiste à informer à l'avance le compilateur que les structures contenant la clé et la valeur peuvent ne pas être alignées grâce à l'attribut aligned(1). Sur ARM, un effet similaire peut être obtenu également avec l'attribut packed. Étant donné qu'il favorise également l'optimisation de l'espace occupé par la structure, je trouve cette méthode préférable, bien que cela ait pour conséquence d'augmenter le coût des opérations d'accès aux données.
typedef struct __attribute__((packed)) NodeKey {
    uint8_t parentId;
    uint8_t type;
    uint8_t nameLength;
    uint8_t nameBuffer[256];
} NodeKey;
Requêtes de plage
Pour itérer sur un groupe d'enregistrements dans LMDB, une abstraction de curseur est prévue. Nous allons voir comment travailler avec cela en prenant l'exemple de la table des métadonnées du cloud utilisateur que nous connaissons déjà.
Dans le cadre de l'affichage de la liste des fichiers dans un répertoire, il est nécessaire de trouver toutes les clés associées à ses fichiers et dossiers enfants. Dans les sections précédentes, nous avons trié les clés NodeKey de telle sorte qu'elles soient d'abord ordonnées par l'identifiant du répertoire parent. Ainsi, la tâche technique d'obtenir le contenu d'un dossier se résume à positionner le curseur à la limite supérieure du groupe de clés avec un préfixe donné, puis à itérer jusqu'à la limite inférieure.
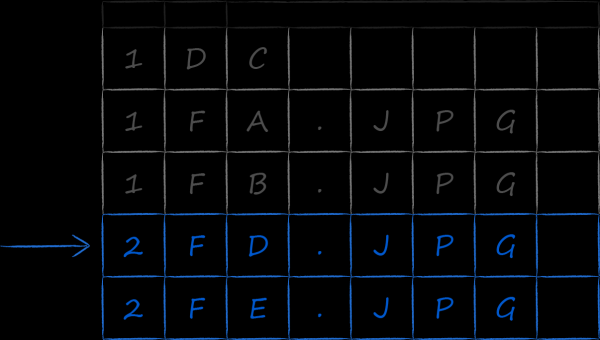
La limite supérieure peut être trouvée "de manière brute" par une recherche séquentielle. Pour cela, le curseur est placé au début de toute la liste des clés dans la base de données et s'incrémente jusqu'à ce qu'il rencontre une clé avec l'identifiant du répertoire parent. Cette approche présente deux inconvénients évidents :
- La complexité linéaire de la recherche, alors qu'il est connu que dans les arbres en général et dans l'arbre B en particulier, cela peut être effectué en logarithmique.
- On ramène inutilement en mémoire principale toutes les pages précédant celle recherchée, ce qui est extrêmement coûteux.
Heureusement, l'API LMDB prévoit un moyen efficace de positionnement initial du curseur. Pour cela, il faut former une clé dont la valeur sera nécessairement inférieure ou égale à la clé située à la limite supérieure de l'intervalle. Par exemple, concernant la liste de l'image ci-dessus, nous pouvons créer une telle clé, où le champ parentId sera égal à 2, tandis que tous les autres seront remplis de zéros. Cette clé partiellement remplie est entrée dans la fonction mdb_cursor_get avec l'opération MDB_SET_RANGE.
NodeKey upperBoundSearchKey = {
.parentId = 2,
.type = 0,
.nameLength = 0
};
MDB_val value, key = serialize(upperBoundSearchKey);
MDB_cursor *cursor;
mdb_cursor_open(..., &cursor);
mdb_cursor_get(cursor, &key, &value, MDB_SET_RANGE);Si la limite supérieure du groupe de clés est trouvée, nous itérons ensuite sur celle-ci jusqu'à ce que nous rencontrions soit une clé différente parentId, soit que les clés s'épuisent complètement.
do {
rc = mdb_cursor_get(cursor, &key, &value, MDB_NEXT);
// traitement...
} while (MDB_NOTFOUND != rc && // vérifier la fin de la table
IsTargetKey(key)); // vérifier la fin du groupe de clésCe qui est agréable, c'est que lors de l'itération avec mdb_cursor_get, nous obtenons non seulement la clé, mais aussi la valeur. Si, pour remplir les conditions de sélection, il est nécessaire de vérifier également les champs dans la partie valeur de l'enregistrement, ils sont tout à fait accessibles sans démarches supplémentaires.
4.3. Modélisation des relations entre les tables
À ce stade, nous avons réussi à examiner tous les aspects de la conception et du travail avec une base de données à table unique. On peut dire qu'une table est un ensemble d'enregistrements triés, composés de paires clé-valeur similaires. Si l'on représente la clé sous la forme d'un rectangle et la valeur qui lui est associée sous la forme d'un parallélépipède, cela donne un schéma visuel de la base de données.

Cependant, dans la vie réelle, il est rare de pouvoir se contenter d'un cadre aussi restreint. Souvent, une base de données doit, premièrement, comporter plusieurs tables et, deuxièmement, effectuer des sélections dans un ordre différent de celui de la clé primaire. Les questions de leur création et de leur liaison entre elles sont consacrées à cette dernière section.
Tables d'index
Dans l'application cloud, il existe une section « Galerie ». Elle affiche le contenu multimédia de tout le cloud, trié par date. Pour une mise en œuvre optimale de cette sélection, il est nécessaire de créer une nouvelle table à côté de la table principale, avec un nouveau type de clés. Celle-ci contiendra un champ avec la date de création du fichier, qui servira de critère principal de tri. Comme les nouvelles clés se réfèrent aux mêmes données que les clés de la table principale, elles sont appelées des clés d'index. Dans l'image ci-dessous, elles sont mises en évidence en orange.
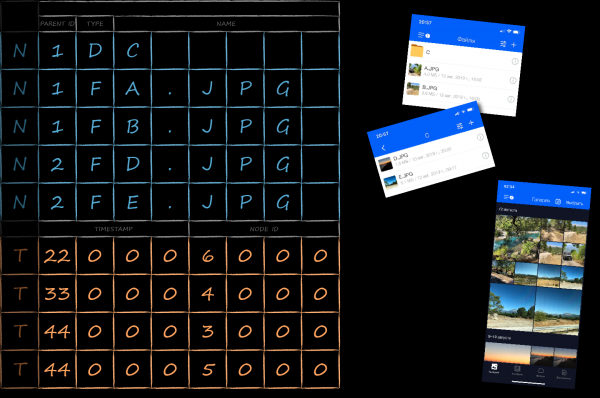
Pour séparer les clés des différentes tables au sein d'une même base de données, un champ technique supplémentaire tableId a été ajouté à toutes. En faisant de ce champ le plus prioritaire pour le tri, nous obtiendrons un groupement des clés d'abord par tables, puis à l'intérieur des tables, selon nos propres règles.
La clé d'index pointe vers les mêmes données que la clé primaire. Implémenter directement cette propriété via une association avec une copie de la partie valeur de la clé primaire est inefficace sous plusieurs angles :
- En termes d'espace occupé, étant donné que les métadonnées peuvent être assez riches.
- En termes de performance, car lors de la mise à jour des métadonnées, il faudra réécrire sur deux clés.
- En termes de support de code, dès que nous oublions de mettre à jour les données pour l'une des clés, nous obtenons un bogue difficile à cerner d'incohérence des données dans le stockage.
Nous allons maintenant examiner comment éliminer ces lacunes.
Organisation des relations entre les tables
Pour relier une table d'index à la table principale, le modèle suivant est bien adapté « clé comme valeur ». Comme son nom l'indique, dans ce modèle, une copie de la valeur de la clé primaire sert de partie valeur de l'enregistrement indexé. Cette approche annule tous les inconvénients mentionnés ci-dessus liés au stockage d'une copie de la partie valeur de l'enregistrement primaire. Le seul inconvénient est qu'il faut effectuer 2 requêtes dans la base de données au lieu d'une pour obtenir la valeur par la clé d'index. Le schéma résultant de la base de données apparaît comme suit.
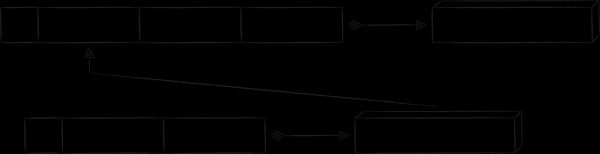
Un autre modèle d'organisation des relations entre les tables est « clé redondante ». Son principe réside dans l'ajout d'attributs supplémentaires à la clé, qui ne sont pas nécessaires pour le tri, mais pour recréer la clé associée. Dans l'application Cloud de Mail.ru, il existe de réels exemples de son utilisation, cependant, pour éviter une immersion profonde dans le contexte de frameworks iOS spécifiques, je vais donner un exemple fictif, mais plus compréhensible.
Dans les clients mobiles cloud, il existe une page qui affiche tous les fichiers et dossiers auxquels l'utilisateur a donné accès à d'autres personnes. Étant donné qu'il y a relativement peu de ces fichiers, et qu'il y a beaucoup d'informations spécifiques concernant la publicité (qui a accès, avec quels droits, etc.), il ne serait pas rationnel d'alourdir la partie valeur de l'enregistrement dans la table principale. Cependant, si l'on souhaite afficher ces fichiers hors ligne, il est nécessaire de les stocker quelque part. Une solution naturelle consiste à créer une table séparée à cet effet. Dans le schéma ci-dessous, sa clé a le préfixe « P », et l'espace réservé « propname » peut être remplacé par une valeur plus spécifique « information publique ».
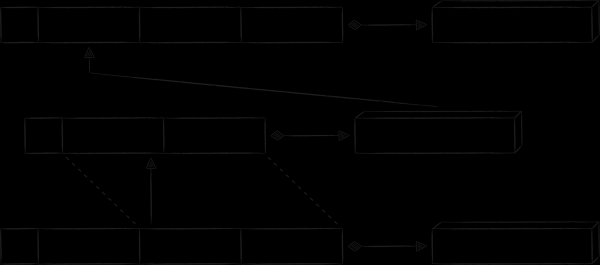
Toutes les métadonnées uniques, pour lesquelles une nouvelle table a été créée, sont transférées dans la partie valeur de l'enregistrement. En même temps, il n'est pas souhaitable de dupliquer les données sur les fichiers et les dossiers qui sont déjà stockées dans la table principale. Au lieu de cela, des données redondantes sous forme de champs « node ID » et « timestamp » sont ajoutées à la clé « P ». Grâce à elles, il est possible de construire une clé d'index, permettant d'obtenir la clé primaire, et enfin d'accéder aux métadonnées du nœud.
Conclusion
Nous évaluons positivement les résultats de l'implémentation de LMDB. Après cela, le nombre de plantages de l'application a diminué de 30%.
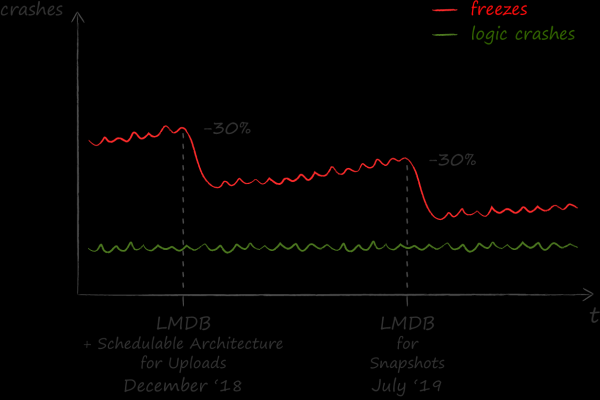
Les résultats du travail effectué ont trouvé un écho au-delà de l'équipe iOS. Actuellement, l'un des principaux sections « Fichiers » de l'application Android a également commencé à utiliser LMDB, et d'autres parties sont en cours. Le langage C, dans lequel le stockage clé-valeur est implémenté, a été un bon soutien pour créer initialement un cadre d'application multiplateforme en C++. Un générateur de code a été utilisé pour une connexion transparente de la bibliothèque C++ résultante avec le code natif en Objective-C et Kotlin. de Dropbox, mais c'est une histoire complètement différente.
Source : habr.com
