

Note de traduction.: les auteurs de cet article sont des ingénieurs d'une petite entreprise tchèque, pipetail. Ils ont réussi à compiler une liste remarquable de [problèmes et de malentendus parfois banals, mais toujours] si pertinents, liés à l'exploitation de clusters Kubernetes.
Au fil des ans d'utilisation de Kubernetes, nous avons eu l'occasion de travailler avec de nombreux clusters (gérés et non gérés, sur GCP, AWS et Azure). Avec le temps, nous avons remarqué que certaines erreurs se reproduisent constamment. Cependant, il n'y a rien de honteux là-dedans : nous avons nous-mêmes commis la plupart d'entre elles !
Cet article compile les erreurs les plus courantes, ainsi que des indications sur la manière de les corriger.
1. Ressources : demandes et limites
Ce point mérite certainement la plus grande attention et la première place sur la liste.
La demande CPU est généralement soit complètement non spécifiée, soit a une valeur très faible (pour pouvoir héberger autant de pod' s que possible sur chaque nœud). De ce fait, les nœuds se retrouvent surchargés. Lorsqu'il y a une forte charge, les capacités processeur du nœud sont complètement utilisées et une charge de travail spécifique ne reçoit que ce qu'elle a « demandé » par le biais du throttling CPU. Cela entraîne de plus grands délais dans l'application, des délais d'expiration et d'autres conséquences désagréables. (Pour plus de détails, consultez notre récente traduction : «» — note du trad.)
BestEffort (extrêmement ne recommandé) :
resources: {}Demande CPU extrêmement basse (extrêmement ne recommandé) :
   resources:
      Requests:
        cpu: "1m"
D'autre part, avoir une limite CPU peut entraîner des ralentissements injustifiés des pod's, même si le processeur du nœud n'est pas complètement chargé. Encore une fois, cela peut entraîner une augmentation des délais. Les débats continuent autour du paramètre quota CFS CPU dans le noyau Linux et du throttling CPU en fonction des limites établies, ainsi que de la désactivation de la quota CFS... Malheureusement, les limites CPU peuvent causer plus de problèmes qu'elles ne sont capables d'en résoudre. Pour en savoir plus, consultez le lien ci-dessous.
Suralimentation (overcommitting) de mémoire peut entraîner des problèmes encore plus graves. L'atteinte de la limite CPU entraîne des ralentissements, tandis que l'atteinte de la limite de mémoire entraîne le « kill » du pod. Avez-vous déjà observé OOMkill? Да, речь идет именно о нем.
Souhaitez-vous minimiser la probabilité de cet événement ? Ne répartissez pas des volumes excessifs de mémoire et utilisez le Guaranteed QoS (Quality of Service), en établissant la demande de mémoire égale à la limite (comme dans l'exemple ci-dessous). Pour plus d'informations, lisez la (ingénieur principal chez Zalando).
Burstable (probabilité plus élevée d'être OOMkilled) :
   resources:
      requests:
        memory: "128Mi"
        cpu: "500m"
      limits:
        memory: "256Mi"
cpu: 2Guaranteed:
   resources:
      requests:
        memory: "128Mi"
        cpu: 2
      limits:
        memory: "128Mi"
        cpu: 2
Qu'est-ce qui pourrait potentiellement aider à la configuration des ressources ?
Avec metrics-server vous permet de voir la consommation actuelle des ressources CPU et l'utilisation de la mémoire par les pods (et les conteneurs à l'intérieur). Vous l'utilisez probablement déjà. Exécutez simplement les commandes suivantes :
kubectl top pods
kubectl top pods --containers
kubectl top nodes
Cependant, ils ne montrent que l'utilisation actuelle. Vous pouvez obtenir une idée approximative de l'ordre de grandeur, mais en fin de compte, vous aurez besoin de l'historique des métriques au fil du temps (pour répondre à des questions telles que : « Quelle a été la charge CPU maximale ? », « Quelle a été la charge hier matin ? » — etc.). Pour cela, vous pouvez utiliser Prometheus, DataDog et d'autres outils. Ils récupèrent simplement les métriques du metrics-server et les stockent, permettant à l'utilisateur de les interroger et de créer des graphiques correspondants.
d'installer l'automatiser ce processus. Il suit l'historique de l'utilisation du processeur et de la mémoire et ajuste les nouvelles demandes et limites en fonction de ces informations.
Une utilisation efficace des capacités de calcul n'est pas une tâche facile. C'est comme jouer constamment à Tetris. Si vous payez trop pour des ressources de calcul avec une consommation moyenne faible (disons, ~10 %), nous vous recommandons de jeter un œil aux produits basés sur AWS Fargate ou Virtual Kubelet. Ils sont construits sur un modèle de facturation serverless / pay-per-usage, ce qui peut s'avérer moins cher dans ces conditions.
2. Liveness et readiness probes
Par défaut, les vérifications d'état liveness et readiness dans Kubernetes ne sont pas activées. Et il arrive parfois qu'on oublie de les activer…
Mais comment peut-on encore initier le redémarrage d'un service en cas d'erreur non récupérable ? Et comment le répartiteur de charge sait-il qu'un pod est prêt à recevoir du trafic ? Ou qu'il peut gérer plus de trafic ?
Ces probes sont souvent confondues :
- Vivacité — la vérification de « vivacité », qui redémarre le pod en cas de fermeture anormale ;
- Préparation — vérification de disponibilité, qui, en cas d'échec, déconnecte le pod du service Kubernetes (ce qui peut être vérifié avec
kubectl get endpoints) et le trafic vers celui-ci n'est pas traité jusqu'à ce qu'une vérification réussisse.
Ces deux vérifications S'EXÉCUTENT PENDANT TOUT LE CYCLE DE VIE DU POD. C'est très important.
Il est courant de croire que les probes de disponibilité ne sont lancées qu'au démarrage pour que le chargeur puisse savoir que le pod est prêt (Prêt) et peut commencer à traiter le trafic. Cependant, c'est juste une des manières de les utiliser.
Une autre consiste à savoir si le trafic vers le pod est excessif et le surcharge (ou si le pod effectue des calculs gourmands en ressources). Dans ce cas, le contrôle de disponibilité aide à alléger la charge sur le pod et à le "refroidir".Une réussite de la vérification de disponibilité à l'avenir permet d'augmenter à nouveau la charge sur le pod.Dans ce cas (en cas d'échec de la probe de disponibilité), l'échec de la vérification de vivacité serait très contre-productif. Pourquoi redémarrer un pod qui est sain et qui travaille dur ?
C'est pourquoi, dans certains cas, ne pas avoir de vérifications du tout est mieux que de les activer avec des paramètres mal configurés. Comme mentionné précédemment, si la vérification de vivacité copie la vérification de disponibilité, vous êtes en grand danger. Une option possible serait de configurer , et Les deux types de vérifications ne doivent pas échouer en cas d'échec des dépendances communes, sinon cela entraînera un échec en cascade de tous les pods. En d'autres termes,
ne vous nuisez pas à vous-même. .
Il y a de fortes chances que vous ayez des services HTTP dans votre cluster que vous souhaitez exposer au monde extérieur.
Si vous ouvrez le service comme
type: LoadBalancer , son contrôleur (selon le fournisseur de services) fournira et coordonnera un LoadBalancer externe (ne fonctionnant pas nécessairement sur L7, mais plutôt sur L4), ce qui peut avoir une incidence sur les coûts (adresse IPv4 statique externe, puissance de calcul, facturation à la seconde) en raison de la nécessité de créer un grand nombre de ces ressources.Dans ce cas, il est beaucoup plus logique d'utiliser un seul LoadBalancer externe, en ouvrant les services comme
type: NodePort. Ou mieux encore, déployer quelque chose commenginx-ingress-controller traefik ou ), qui sera l'uniqueNodePort. NodePort un endpoint lié à un équilibreur de charge externe, et va acheminer le trafic dans le cluster à l'aide de ingress-ressources Kubernetes.
D'autres (micro)services internes au cluster interagissant entre eux peuvent « communiquer » à l'aide de services de type ClusterIP et du mécanisme intégré de découverte de services via DNS. Ne pas utiliser leurs DNS/IP publics, car cela peut affecter la latence et augmenter les coûts des services cloud.
4. Autoscaling du cluster sans tenir compte de ses spécificités
Lors de l'ajout ou de la suppression de nœuds dans le cluster, il ne faut pas se fier à certaines métriques de base comme l'utilisation du CPU sur ces nœuds. La planification d'un pod doit tenir compte de nombreux contraintes, telles que l'affinité des pods/nœuds, les taints et tolerations, les demandes de ressources, QoS, etc. L'utilisation d'un autoscaler externe, ne tenant pas compte de ces nuances, peut entraîner des problèmes.
Imaginez qu'un pod doit être planifié, mais toutes les ressources CPU disponibles sont demandées/occupées et le pod se retrouve bloqué dans l'état Pending. L'autoscaler externe voit la charge CPU actuelle moyenne (et non la demandée) et n'initie pas l'extension (scale-out) — n'ajoute pas un autre nœud. En conséquence, ce pod ne sera pas planifié.
En revanche, la réduction de l'échelle (scale-in) — la suppression d'un nœud du cluster — est toujours plus difficile à mettre en œuvre. Imaginez que vous avez un pod stateful (avec un stockage persistent connecté). Les volumes persistents appartiennent généralement à une zone de disponibilité spécifique et ne sont pas répliqués dans la région. Ainsi, si l'autoscaler externe supprime un nœud avec ce pod, le planificateur ne pourra pas planifier ce pod sur un autre nœud, car cela ne peut être fait que dans la zone de disponibilité où se trouve le stockage persistent. Le pod restera bloqué dans l'état Pending.
Dans la communauté Kubernetes, le est très populaire. Il fonctionne dans le cluster, prend en charge les API des principaux fournisseurs de services cloud, tient compte de toutes les contraintes et sait s'adapter dans les cas mentionnés ci-dessus. Il est également capable d'effectuer un scale-in tout en respectant toutes les contraintes établies, économisant ainsi de l'argent (qui autrement serait dépensé pour des ressources non sollicitées).
5. Négliger les capacités IAM/RBAC
Attention à ne pas utiliser d'utilisateurs IAM avec des secrets permanents pour machines et applications. Organisez un accès temporaire en utilisant des rôles et des comptes de service (service accounts).
Nous rencontrons souvent des problèmes où les clés d'accès (et les secrets) se retrouvent 'hardcodés' dans la configuration de l'application, ainsi qu'un manque de rotation des secrets malgré l'accès à Cloud IAM. Utilisez des rôles IAM et des comptes de service au lieu d'utilisateurs lorsque cela est approprié.
Oubliez kube2iam et passez directement aux rôles IAM pour les comptes de service (comme cela est décrit dans Štěpán Vraný):
apiVersion: v1
kind: ServiceAccount
metadata:
  annotations:
    eks.amazonaws.com/role-arn: arn:aws:iam::123456789012:role/my-app-role
  name: my-serviceaccount
  namespace: default
Une annotation. Ce n'est pas si compliqué, n'est-ce pas ?
De plus, ne donnez pas aux comptes de service et aux profils d'instance des privilèges admin et cluster-admin, s'ils n'en ont pas besoin. Cela est un peu plus compliqué à mettre en œuvre, surtout dans RBAC K8s, mais cela vaut définitivement la peine.
6. Ne comptez pas sur l'anti-affinité automatique pour les pods
Imaginez que vous avez trois répliques d'un certain déploiement sur un nœud. Le nœud tombe et toutes les répliques avec lui. Situation désagréable, n'est-ce pas ? Mais pourquoi toutes les répliques étaient-elles sur un seul nœud ? Kubernetes ne devrait-il pas garantir une haute disponibilité (HA) ?!
Hélas, l'ordonnanceur Kubernetes ne respecte pas de son propre chef les règles de coexistence séparée (anti-affinity) pour les pods. Ils doivent être explicitement définis :
// опущено для краткости
      labels:
        app: zk
// опущено для краткости
      affinity:
        podAntiAffinity:
          requiredDuringSchedulingIgnoredDuringExecution:
            - labelSelector:
                matchExpressions:
                  - key: "app"
                    operator: In
                    values:
                    - zk
              topologyKey: "kubernetes.io/hostname"
Voilà. Maintenant, les pods seront programmés sur différents nœuds (cette condition n'est vérifiée qu'au moment de la planification, pas de leur fonctionnement — d'où le requiredDuringSchedulingIgnoredDuringExecution).
Ici, nous parlons de podAntiAffinity sur différents nœuds : topologyKey: "kubernetes.io/hostname", — et non pas de différentes zones de disponibilité. Pour réaliser une véritable HA, il faudra approfondir le sujet.
7. Ignorer les PodDisruptionBudgets
Imaginez que vous avez une charge de travail de production dans un cluster Kubernetes. Il est parfois nécessaire de mettre à jour les nœuds et le cluster lui-même (ou de les retirer de l'exploitation). Le PodDisruptionBudget (PDB) est une sorte d'accord de garantie de maintenance entre les administrateurs du cluster et les utilisateurs.
Le PDB permet d'éviter les interruptions de service causées par un manque de nœuds :
apiVersion: policy/v1beta1
kind: PodDisruptionBudget
metadata:
  name: zk-pdb
spec:
  minAvailable: 2
  selector:
    matchLabels:
      app: zookeeper
Dans cet exemple, en tant qu'utilisateur du cluster, vous informez les administrateurs : « Hé, j'ai un service zookeeper, et peu importe ce que vous faites, j'aimerais que 2 répliques de ce service soient toujours disponibles. »
Vous pouvez en lire plus à ce sujet .
8. Plusieurs utilisateurs ou environnements dans un même cluster
Espaces de noms Kubernetes (namespaces) ne fournissent pas une isolation forte.
Il est courant de croire que si une charge non-prod est déployée dans un espace de noms et une charge prod dans un autre, elles n'influenceront pas l'une l'autre… Cependant, un certain niveau d'isolation peut être atteint grâce à des requêtes / limitations de ressources, à la mise en place de quotas, ou à l'affectation de priorityClass. Une certaine isolation « physique » dans le plan de données est assurée par des affinities, tolerations, taints (ou nodeselectors), mais une telle séparation est assez difficile à mettre en œuvre.
Ceux qui doivent combiner ces deux types de charges de travail dans un même cluster devront composer avec cette complexité. En revanche, si cette nécessité n'existe pas et que vous êtes en mesure de créer un autre cluster (disons, dans le cloud public), il est préférable de le faire. Cela permettra d'atteindre un niveau d'isolation beaucoup plus élevé.
9. externalTrafficPolicy: Cluster
Nous constatons souvent que tout le trafic entrant dans le cluster passe par un service de type NodePort, pour lequel la politique par défaut est externalTrafficPolicy: Cluster. Cela signifie que NodePort il est ouvert sur chaque nœud du cluster, et vous pouvez en utiliser n'importe quel pour interagir avec le service souhaité (ensemble de pod).
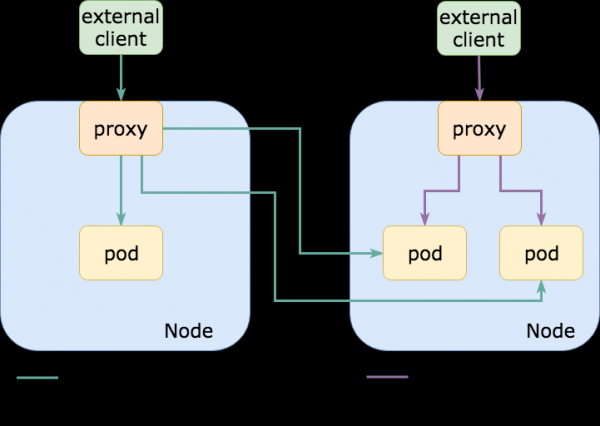
Toutefois, les véritables pod associés au service NodePort mentionné ci-dessus se trouvent généralement uniquement sur un certain sous-ensemble de ces nœuds. En d'autres termes, si je me connecte à un nœud qui n'a pas le pod souhaité, il va rediriger le trafic vers un autre nœud, ajoutant une étape de transit (hop) et augmentant la latence (si les nœuds sont dans différentes zones de disponibilité / centres de données, la latence peut être assez élevée ; de plus, les coûts de trafic sortant augmenteront).
D'un autre côté, si pour un service Kubernetes une politique est définie externalTrafficPolicy: Local, alors le NodePort n'est ouvert que sur les nœuds où les pod nécessaires sont effectivement en cours d'exécution. Lors de l'utilisation d'un équilibreur de charge externe vérifiant l'état (healthchecking) des endpoints (comme le fait AWS ELB), il enverra le trafic uniquement vers les nœuds nécessaires., ce qui aura un impact positif sur les latences, les besoins de calcul, les factures de egress (et le bon sens le dicte également).
Il est fort probable que vous utilisiez déjà quelque chose comme ), qui sera l'unique ou traefik comme point final NodePort (ou LoadBalancer, qui utilise également NodePort) pour le routage du trafic HTTP ingress, et activer cette option peut réduire considérablement la latence pour de telles requêtes.
Dans vous pouvez en apprendre davantage sur externalTrafficPolicy, ses avantages et inconvénients.
10. Ne vous attachez pas aux clusters et ne abusez pas du control plane
Autrefois, les serveurs étaient souvent appelés par des noms propres : , HAL9000 et Colossus… Aujourd'hui, ils ont été remplacés par des identifiants générés aléatoirement. Cependant, l'habitude est restée, et maintenant les noms propres sont attribués aux clusters.
C'est une histoire typique (basée sur des faits réels) : tout a commencé avec une preuve de concept, donc le cluster avait un nom fier testing… Des années ont passé, et il est TOUJOURS utilisé en production, et tout le monde a peur de le toucher.
Il n'y a rien d'amusant à ce que les clusters deviennent des animaux de compagnie, c'est pourquoi nous recommandons de les supprimer de temps en temps, tout en s'exerçant à la récupération après sinistre (cela peut aider avec — n.d.t.)). De plus, il serait bon de s'occuper aussi de la couche de gestion (control plane). Avoir peur de la toucher n'est pas un bon signe. Etcd est mort ? Les gars, vous êtes vraiment dans le pétrin !
D'un autre côté, il ne faut pas trop s'y attacher. Avec le temps la couche de gestion peut devenir lente. Cela est probablement dû à un grand nombre d'objets créés sans rotation (situation courante lors de l'utilisation de Helm avec les paramètres par défaut, ce qui empêche la mise à jour de son état dans les configmaps/secrets — en conséquence, des milliers d'objets s'accumulent dans la couche de gestion) ou à une édition constante des objets kube-api (pour le dimensionnement automatique, pour CI/CD, pour le monitoring, les logs d'événements, les contrôleurs, etc.).
De plus, nous recommandons de vérifier les accords SLA/SLO avec le fournisseur de Kubernetes géré et de prêter attention aux garanties. Le fournisseur peut garantir la disponibilité de la couche de gestion (ou de ses sous-composants), mais pas la latence des requêtes p99 que vous lui envoyez. En d'autres termes, on peut introduire kubectl get nodes, et la réponse ne sera reçue que dans 10 minutes, et cela ne constituera pas une violation des conditions du contrat de service.
11. Bonus : utilisation de la balise latest
C'est déjà un classique. Récemment, nous rencontrons cette technique moins souvent, car beaucoup, ayant appris par l'expérience, ont cessé d'utiliser la balise :latest et ont commencé à verrouiller (pin) les versions. Hourra !
ECR ; nous vous recommandons de découvrir cette caractéristique remarquable.
Résumé
Ne vous attendez pas à ce que tout fonctionne d'un simple coup de baguette magique : Kubernetes n'est pas une panacée. Une mauvaise application (et pourrait même devenir encore pire). La négligence conduira à une complexité excessive, un fonctionnement lent et tendu de la couche de contrôle. De plus, vous risquez de vous retrouver sans stratégie de récupération en cas de sinistre. Ne comptez pas sur Kubernetes pour assurer l'isolation et la haute disponibilité 'out of the box'. Prenez le temps de rendre votre application vraiment cloud native.
Vous pouvez découvrir les expériences malheureuses de diverses équipes dans de Henning Jacobs.
Ceux qui souhaitent compléter la liste des erreurs mentionnées dans cet article peuvent nous contacter sur Twitter (, ).
P.S. de l'auteur
Lisez aussi dans notre blog :
- «»;
- «»;
- «» (aperçu et vidéo de la présentation) ;
- «».
Source : habr.com
