

Netflix — leader du marché de la télévision par Internet — est une entreprise qui a créé et qui développe activement ce segment. Netflix est connu non seulement pour son vaste catalogue de films et de séries, accessible presque de n'importe quel coin du globe et sur tout appareil avec un écran, mais aussi pour son infrastructure fiable et sa culture d'ingénierie unique.
Un exemple concret de l'approche de Netflix en matière de développement et de maintenance de systèmes complexes a été présenté lors de DevOops 2019 par — directeur du développement chez Netflix. Diplômé de la faculté de VMI de l'Université d'État de Nijni Novgorod, Sergueï est l'un des premiers ingénieurs d'Open Connect — l'équipe CDN de Netflix. Il a construit des systèmes de surveillance et d'analyse des données vidéo, a lancé le service populaire d'évaluation de la vitesse de connexion Internet FAST.com et, ces dernières années, a travaillé à l'optimisation des requêtes Internet afin que l'application Netflix fonctionne aussi rapidement que possible pour les utilisateurs.
La présentation a reçu les meilleurs avis des participants à la conférence et nous avons préparé pour vous une version écrite.
Dans cette présentation, Sergueï a expliqué en détail
- ce qui influence la latence des requêtes Internet entre le client et le serveur;
- comment réduire cette latence;
- comment concevoir, maintenir et surveiller des systèmes résilients aux pannes;
- comment atteindre des résultats dans des délais serrés et avec un risque minimal pour l'entreprise;
- comment analyser les résultats et apprendre de ses erreurs.
Les réponses à ces questions sont nécessaires non seulement à ceux qui travaillent dans de grandes entreprises.
Les principes et techniques présentés doivent être connus et pratiqués par quiconque développe et maintient des produits Internet.
Ensuite — le récit du speaker.
L'importance de la vitesse de l'Internet
La vitesse des requêtes Internet est directement liée aux affaires. Considérons le secteur du shopping : l'entreprise Amazon en 2009 , qu'un retard de 100 ms entraîne une perte de 1 % des ventes.
Il y a de plus en plus d'appareils mobiles, et par conséquent de sites et d'applications mobiles. Si votre page met plus de 3 secondes à se charger, vous perdez environ la moitié de vos utilisateurs. Depuis , Google prend en compte la vitesse de chargement de votre page dans les résultats de recherche : plus la page est rapide, plus sa position dans Google est élevée.
La vitesse de connexion est également importante dans les organisations financières, où le retard est critique. En 2015, l'entreprise Hibernia Networks un câble entre New York et Londres coûtant 400 millions de dollars, afin de réduire le temps de latence entre les villes de 6 ms. Imaginez, 66 millions de dollars pour 1 ms de réduction de latence !
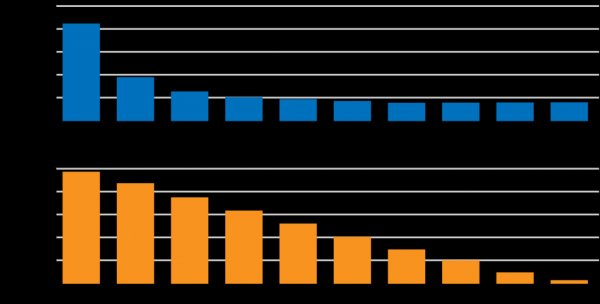
Selon , une connexion supérieure à 5 Mbit/s n'affecte plus directement la vitesse de chargement d'un site web standard. Cependant, il existe une dépendance linéaire entre la latence de connexion et la vitesse de chargement des pages :
Cependant, Netflix n'est pas un produit standard. L'impact de la latence et de la vitesse sur l'utilisateur est un domaine d'analyse et de développement actif. Il y a le chargement de l'application et le choix du contenu, qui dépendent de la latence, mais le chargement des éléments statiques et le streaming dépendent également de la vitesse de connexion. L'analyse et l'optimisation des facteurs clés influençant la qualité du service pour l'utilisateur est un domaine actif de développement pour plusieurs équipes chez Netflix. L'un des objectifs est de réduire la latence des requêtes entre les appareils Netflix et l'infrastructure cloud.
Dans ce rapport, nous allons nous concentrer sur la réduction de la latence (latency) en prenant l'exemple de l'infrastructure de Netflix. Nous examinerons de manière pratique comment aborder les processus de conception, de développement et d'exploitation de systèmes distribués complexes tout en passant du temps sur l'innovation et les résultats, et non sur le diagnostic des problèmes opérationnels et des pannes.
À l'intérieur de Netflix
Des milliers de dispositifs différents prennent en charge les applications Netflix. Leur développement est entrepris par quatre équipes différentes, qui créent des versions distinctes du client pour Android, iOS, TV et navigateurs web. Nous consacrons également beaucoup d'efforts à améliorer et à personnaliser l'interface utilisateur. Pour cela, nous exécutons des centaines de tests A/B en parallèle.
La personnalisation est soutenue par des centaines de microservices dans le cloud AWS, fournissant des données personnalisées pour l'utilisateur, la gestion des requêtes, la télémétrie, le Big Data et l'encodage. La visualisation du trafic est la suivante :
À gauche se trouve le point d'entrée, puis le trafic est réparti entre plusieurs centaines de microservices, soutenus par différentes équipes backend.
Un autre composant important de notre infrastructure est le CDN Open Connect, qui livre du contenu statique—vidéos, images, code pour les clients, etc.—jusqu'à l'utilisateur final. Le CDN est situé sur des serveurs personnalisés (OCA - Open Connect Appliance). À l'intérieur, se trouvent des ensembles de disques SSD et HDD fonctionnant sous un FreeBSD optimisé, avec NGINX et un ensemble de services. Nous concevons et optimisons les composants matériels et logiciels afin que ce serveur CDN puisse envoyer le plus de données possible aux utilisateurs.
Le « mur » de ces serveurs au point d'échange de trafic Internet (Internet eXchange - IX) se présente comme suit :
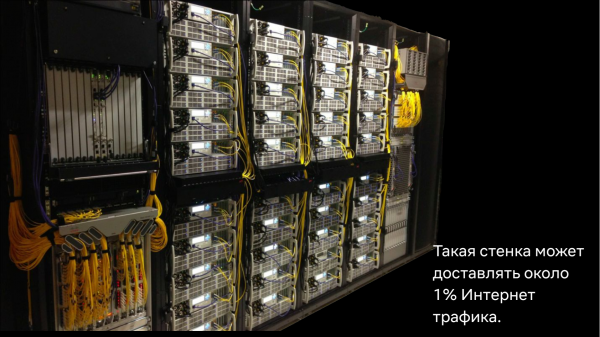
L'Internet Exchange permet aux fournisseurs d'accès Internet et aux fournisseurs de contenu de se « connecter » les uns aux autres pour un échange de données plus direct sur Internet. Il existe environ 70 à 80 points Internet Exchange dans le monde, où nos serveurs sont installés, et nous nous occupons nous-mêmes de leur installation et de leur maintenance :
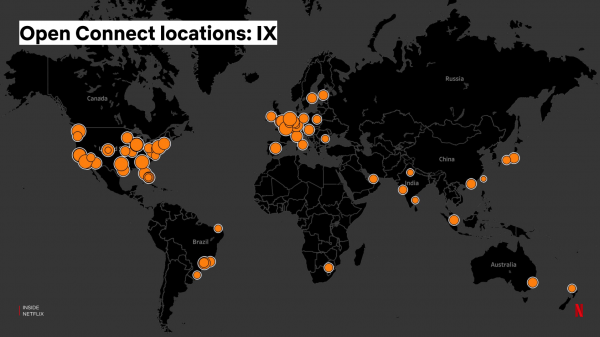
De plus, nous fournissons également des serveurs directement aux fournisseurs d'accès Internet, qui les installent dans leur réseau, améliorant ainsi la localisation du trafic Netflix et la qualité du streaming pour les utilisateurs :
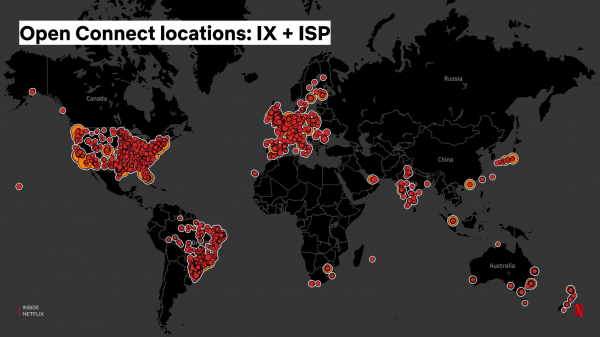
L'ensemble des services AWS est responsable de l'acheminement des requêtes vidéo des clients vers les serveurs CDN, ainsi que de la configuration même de ces serveurs—mise à jour du contenu, du code logiciel, des paramètres, etc. Pour cela, nous avons également construit un backbone network qui relie les serveurs des points Internet Exchange à AWS. Le backbone network est un réseau mondial de câbles en fibre optique et de routeurs, que nous pouvons concevoir et configurer en fonction de nos besoins.
Selon , notre infrastructure CDN livre aux heures de pointe environ ⅛ du trafic Internet mondial et ⅓ du trafic en Amérique du Nord, où Netflix existe depuis le plus longtemps. Ce sont des chiffres impressionnants, mais pour moi, l'un des accomplissements les plus étonnants est que l'ensemble du système CDN est développé et maintenu par une équipe de moins de 150 personnes.
À l'origine, l'infrastructure CDN était conçue pour la livraison de données vidéo. Cependant, avec le temps, nous avons réalisé que nous pouvions également l'utiliser pour optimiser les requêtes dynamiques des clients vers le cloud AWS.
Sur l'accélération de l'Internet
Aujourd'hui, Netflix compte 3 régions AWS, et la latence des requêtes vers le cloud dépendra de la distance entre le client et la région la plus proche. Nous avons aussi de nombreux serveurs CDN qui sont utilisés pour la livraison de contenu statique. Existe-t-il un moyen d'utiliser cette infrastructure pour accélérer les requêtes dynamiques ? Malheureusement, ces requêtes ne peuvent pas être mises en cache, car les API sont personnalisées et chaque résultat est unique.
Créons un proxy sur le serveur CDN et commençons à acheminer le trafic à travers lui. Cela sera-t-il plus rapide ?
Matériel
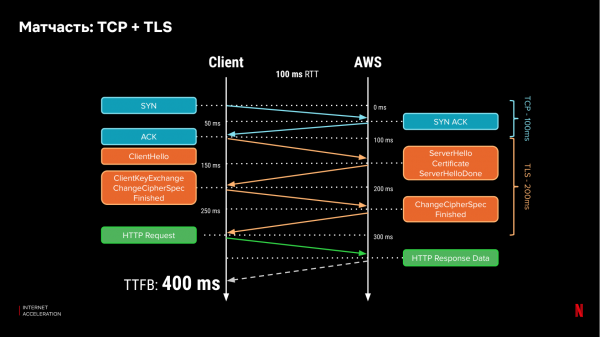
Rappelons-nous comment fonctionnent les protocoles réseau. Aujourd'hui, la majorité du trafic sur Internet utilise HTTPS, qui dépend des protocoles de bas niveau TCP et TLS. Pour que le client se connecte au serveur, il effectue un handshake, et pour établir une connexion sécurisée, le client doit échanger des messages avec le serveur trois fois, plus au moins une fois de plus pour transmettre des données. Avec une latence d'un échange (RTT) de 100 ms, nous aurons besoin de 400 ms pour obtenir le premier bit de données :
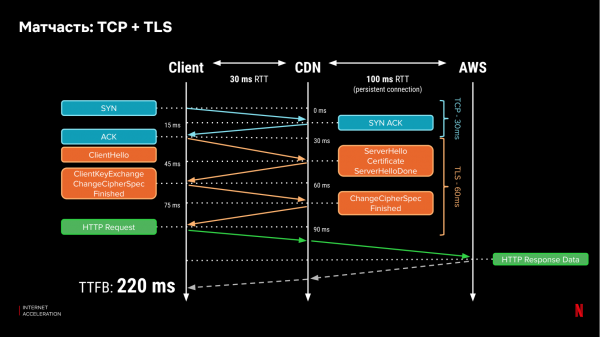
Si nous plaçons les certificats sur le serveur CDN, nous pouvons considérablement réduire le temps de « handshake » entre le client et le serveur, à condition que le CDN soit plus proche. Supposons que la latence vers le serveur CDN soit de 30 ms. Alors, pour obtenir le premier bit, il faudra déjà 220 ms :
Mais les avantages ne s'arrêtent pas là. Une fois la connexion établie, TCP augmente la congestion de la fenêtre (la quantité d'informations qu'il peut transmettre sur cette connexion en parallèle). Si un paquet de données est perdu, les implémentations classiques du protocole TCP (comme TCP New Reno) réduisent la « fenêtre » ouverte de moitié. L'augmentation de la congestion de la fenêtre, et la vitesse de sa récupération après une perte dépendront à nouveau de la latence (RTT) vers le serveur. Si cette connexion ne passe que par le serveur CDN, cette récupération sera plus rapide. De plus, la perte de paquets est un phénomène standard, surtout pour les réseaux sans fil.
La bande passante Internet peut diminuer, surtout pendant les heures de pointe à cause du trafic des utilisateurs, ce qui peut entraîner des « embouteillages ». Il n'existe cependant pas de moyen sur Internet pour donner la priorité à certaines requêtes par rapport à d'autres. Par exemple, donner la priorité aux requêtes légères et sensibles à la latence par rapport aux « lourds » flux de données qui saturent le réseau. Toutefois, dans notre cas, la présence d'un réseau backbone propre nous permet de le faire sur une partie du chemin de la requête - entre le CDN et le cloud, et nous pouvons le configurer entièrement. Nous pouvons faire en sorte que de petits paquets sensibles à la latence soient prioritaires, tandis que les gros flux de données passent un peu plus tard. Plus le CDN est proche du client, plus l'efficacité est grande.
De plus, les protocoles de niveau application (niveau 7 du modèle OSI) influencent également la latence. De nouveaux protocoles, comme HTTP/2, permettent d'optimiser la performance des requêtes parallèles. Cependant, nos clients de Netflix possèdent des appareils anciens ne supportant pas ces nouveaux protocoles. Tous les clients ne peuvent pas être mis à jour ou configurés de manière optimale. Entre le proxy du CDN et le cloud, nous avons un contrôle total et la possibilité d'utiliser des protocoles et des configurations nouveaux et optimaux. La partie inefficace avec les anciens protocoles n'agira que entre le client et le serveur CDN. De plus, nous pouvons réaliser le multiplexage des requêtes sur une connexion déjà établie entre le CDN et le cloud, améliorant ainsi l'utilisation de la connexion au niveau TCP.
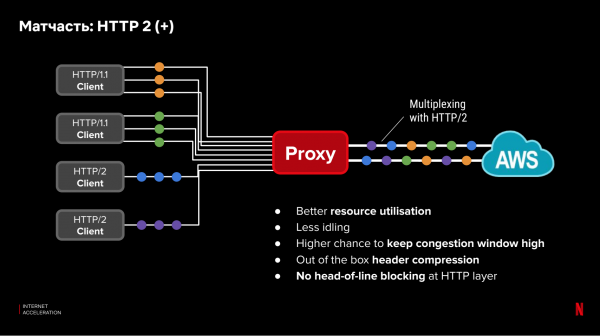
Mesurons
Bien que la théorie promette des améliorations, nous ne nous précipitons pas pour lancer le système en production. Au lieu de cela, nous devons d'abord prouver que l'idée fonctionnera dans la pratique. Pour cela, il est nécessaire de répondre à plusieurs questions :
- Vitesse: le proxy sera-t-il plus rapide ?
- Fiabilité: sera-t-il plus sujet aux pannes ?
- Complexité: comment s'intégrer aux applications ?
- Coût: quel est le coût de déploiement d'une infrastructure supplémentaire ?
Examinons en détail notre approche pour évaluer le premier point. Les autres se traitent de manière similaire.
Pour analyser la vitesse des requêtes, nous souhaitons obtenir des données pour tous les utilisateurs, ne pas passer trop de temps en développement et ne pas casser la production. Pour cela, plusieurs approches existent :
- RUM, ou mesure passive des requêtes. Nous mesurons le temps d'exécution des requêtes actuelles des utilisateurs et assurons une couverture complète des utilisateurs. Le désavantage est un signal pas très stable en raison de nombreux facteurs, comme la taille variable des requêtes, le temps de traitement sur le serveur et le client. De plus, il n'est pas possible de tester une nouvelle configuration sans impact sur la production.
- Tests en laboratoire. Serveurs et infrastructure spéciaux imitant des clients. Grâce à eux, nous effectuons les tests nécessaires. Cela nous permet d'avoir un contrôle total sur les résultats des mesures et un signal clair. Cependant, il n'y a pas de couverture complète des dispositifs et des emplacements des utilisateurs (surtout avec un service à l'échelle mondiale et prenant en charge des milliers de modèles de dispositifs).
Comment combiner les avantages des deux méthodes ?
Notre équipe a trouvé une solution. Nous avons écrit un petit morceau de code — un essai — que nous avons intégré dans notre application. Les essais nous permettent d'effectuer des tests réseau entièrement contrôlés depuis nos dispositifs. Cela fonctionne comme suit :
- Peu après le chargement de l'application et l'achèvement des activités initiales, nous lançons nos essais.
- Le client fait une demande au serveur et reçoit une "recette" de test. La recette est une liste d'URL auxquelles il faut faire une requête HTTP(s). En outre, la recette configure les paramètres des requêtes : délais entre les requêtes, volume de données demandées, en-têtes HTTP(s), etc. Par ailleurs, nous pouvons tester plusieurs recettes différentes en parallèle — lors de la demande de configuration, nous déterminons aléatoirement quelle recette délivrer.
- Le temps de démarrage de l'essai est choisi pour ne pas entrer en conflit avec l'utilisation active des ressources réseau par le client. En substance, un moment est sélectionné où le client n'est pas actif.
- Après avoir reçu la recette, le client effectue des requêtes sur chacune des URL, en parallèle. La requête pour chaque adresse peut être répétée — les fameux "pulses". Lors du premier pulse, nous mesurons le temps nécessaire pour établir la connexion et télécharger les données. Lors du second pulse, nous mesurons le temps de chargement des données via la connexion déjà établie. Avant le troisième, nous pouvons imposer un délai et mesurer la vitesse d'établissement d'une reconnexion, etc.
Lors du test, nous mesurons tous les paramètres que le dispositif peut obtenir :
- le temps de requête DNS ;
- le temps d'établissement de la connexion TCP ;
- le temps d'établissement de la connexion TLS ;
- le temps de réception du premier octet de données ;
- le temps total de chargement ;
- le code d'état du résultat.
- À la fin de chaque pulse, l'échantillon télécharge les résultats de toutes les mesures pour l'analyse.
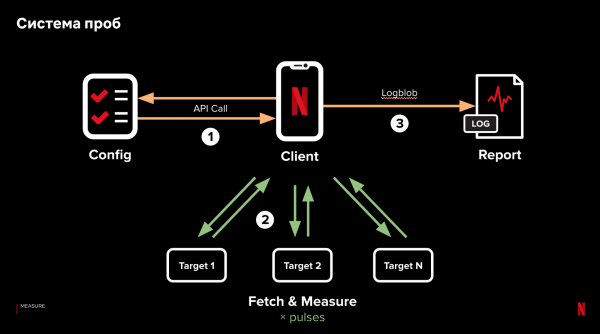
Les points clés sont la dépendance minimale à la logique côté client, le traitement des données côté serveur et la mesure des requêtes parallèles. Ainsi, nous avons la possibilité d'isoler et de tester l'influence de divers facteurs sur la performance des requêtes, de les varier dans un même scénario et d'obtenir des résultats venant de clients réels.
Cette infrastructure s'est révélée utile non seulement pour analyser la performance des requêtes. Actuellement, nous avons 14 scénarios actifs, plus de 6000 échantillons par seconde, recueillant des données du monde entier et couvrant tous les dispositifs. Si Netflix devait acheter un service similaire à des entreprises tierces, cela coûterait des millions de dollars par an, avec une couverture bien inférieure.
Nous testons la théorie en pratique : prototype
Avec un tel système, nous avons pu évaluer l'efficacité d'un proxy CDN sur la latence des requêtes. Maintenant, nous devons :
- créer un prototype de proxy ;
- déployer le prototype sur un CDN ;
- déterminer comment diriger les clients vers le proxy sur un serveur CDN spécifique ;
- comparer les performances avec les requêtes AWS sans proxy.
L'objectif est d'évaluer aussi rapidement que possible l'efficacité de la solution proposée. Pour mettre en œuvre le prototype, nous avons choisi Go, grâce à la disponibilité de bonnes bibliothèques réseau. Sur chaque serveur CDN, nous avons installé le prototype de proxy sous forme de binaire statique, afin de minimiser les dépendances et de simplifier l'intégration. Dans la mise en œuvre initiale, nous avons utilisé au maximum les composants standards et quelques petites modifications pour le pooling de connexions HTTP/2 et le multiplexage de requêtes.
Pour équilibrer entre les régions AWS, nous avons utilisé une base de données géographique DNS, la même que celle utilisée pour équilibrer les clients. Pour choisir le serveur CDN pour le client, nous utilisons TCP Anycast pour les serveurs dans Internet Exchange (IX). Dans cette configuration, nous utilisons une adresse IP pour tous les serveurs CDN, tandis que le client sera dirigé vers le serveur CDN avec le plus petit nombre de sauts IP. Sur les serveurs CDN installés chez les fournisseurs d'accès Internet (FAI), nous n'avons pas le contrôle sur le routeur pour configurer TCP Anycast, donc nous appliquons , selon laquelle les clients sont dirigés vers les fournisseurs d'accès Internet pour le streaming vidéo.
Ainsi, nous avons trois types de chemins pour la requête : dans le cloud via Internet ouvert, via un serveur CDN dans l'IX ou via un serveur CDN situé chez le fournisseur d'accès Internet. Notre objectif est de comprendre quel chemin est le meilleur, et quel est l'avantage du proxy, par rapport à la manière dont les requêtes sont dirigées en production. Pour cela, nous utilisons un système de tests comme suit :
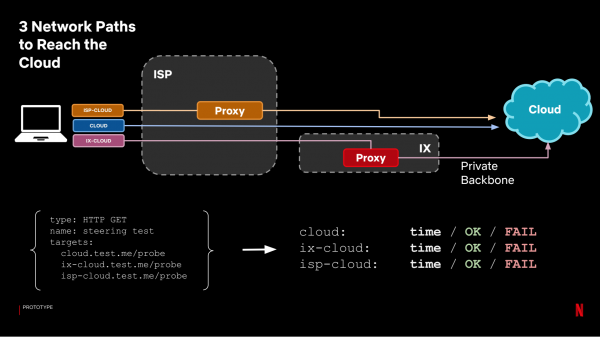
Chacun des chemins devient une cible distincte, et nous regardons le temps que nous avons obtenu. Pour l'analyse, nous regroupons les résultats des proxies en un seul groupe (en choisissant le meilleur temps entre le proxy IX et le proxy ISP) et les comparons avec le temps des requêtes dans le cloud sans proxy :
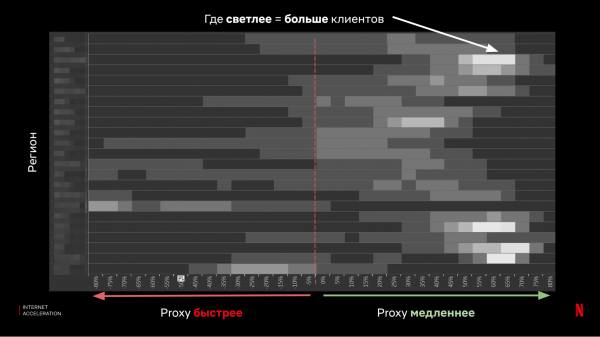
Comme on peut le voir, les résultats sont ambigus — dans la plupart des cas, le proxy offre une bonne accélération, mais il y a aussi un nombre suffisant de clients pour lesquels la situation se détériorerait considérablement.
En fin de compte, nous avons fait plusieurs choses importantes :
- Nous avons évalué la performance attendue des requêtes des clients dans le cloud via le proxy CDN.
- Nous avons obtenu des données de véritables clients, de tous types d'appareils.
- Nous avons compris que la théorie ne s'est pas confirmée à 100 % et que la proposition initiale de proxy CDN ne fonctionnera pas pour nous.
- Nous n'avons pas pris de risques — nous n'avons pas modifié les configurations de production pour les clients.
- Nous n'avons rien cassé.
Prototype 2.0
Ainsi, nous retournons au tableau noir et recommençons le processus.
L'idée est que, au lieu de 100 % de proxy, pour chaque client, nous définissons le chemin le plus rapide et dirigeons les requêtes vers celui-ci — c'est ce qu'on appelle le client steering.
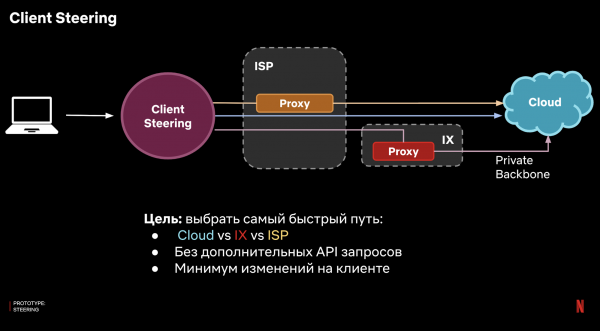
Comment la mettre en œuvre ? Nous ne pouvons pas utiliser la logique côté serveur, car l'objectif est de se connecter à ce serveur. Il faut donc le faire d'une manière ou d'une autre côté client. L'idéal serait de le réaliser avec un minimum de logique complexe pour éviter de devoir résoudre des problèmes d'intégration avec de nombreuses plateformes client.
La réponse est l'utilisation de DNS. Dans notre cas, nous avons notre propre infrastructure DNS, et nous pouvons configurer une zone de domaine pour laquelle nos serveurs seront autoritatifs. Cela fonctionne comme suit :
- Le client effectue une requête au serveur DNS en utilisant l'hôte, par exemple api.netflix.com.
- La requête arrive sur notre serveur DNS
- Le serveur DNS connaît le chemin le plus rapide pour ce client et fournit l'adresse IP correspondante.
Il y a une complexité supplémentaire dans la solution : les fournisseurs DNS autoritatifs ne voient pas l'adresse IP du client et ne peuvent considérer que l'adresse IP du résolveur récursif utilisé par le client.
En fin de compte, notre résolveur autoritatif doit prendre des décisions non pas pour un client individuel, mais pour un groupe de clients en fonction du résolveur récursif.
Pour résoudre ce problème, nous utilisons les mêmes échantillons, nous agrégeons les résultats de mesure des clients pour chaque résolveur récursif et décidons où diriger ce groupe - à travers un proxy via IX en utilisant TCP Anycast, à travers un proxy ISP ou directement dans le cloud.
Nous obtenons ainsi un système :
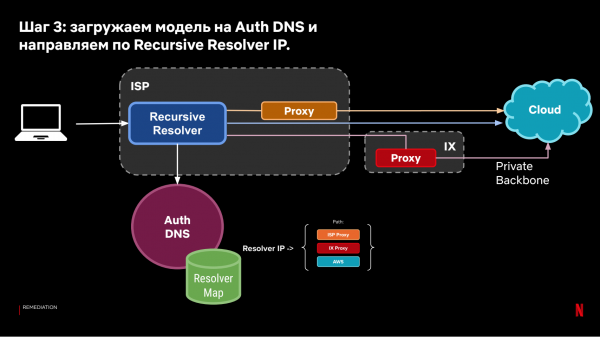
Le modèle de DNS steering obtenu permet de diriger les clients sur la base des observations historiques de la vitesse des connexions des clients au cloud.
Encore une fois, la question est de savoir dans quelle mesure cette approche sera efficace ? Pour répondre, nous utilisons à nouveau notre système d'échantillonnage. Ainsi, nous configurons une configuration de mise à jour, où une des cibles suit la direction du DNS steering, l'autre se dirige directement vers le cloud (production actuelle).
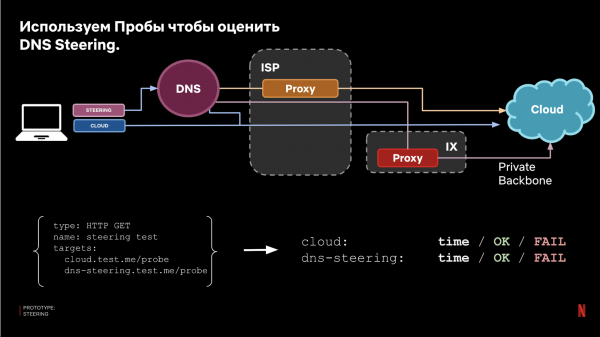
En définitive, nous comparons les résultats et obtenons une évaluation de l'efficacité :
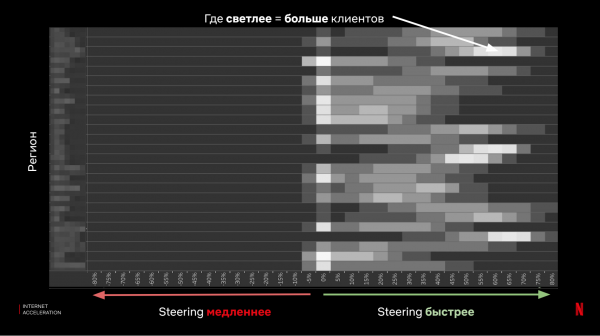
Finalement, nous avons appris plusieurs choses importantes :
- Nous avons évalué la performance attendue des requêtes des clients vers le cloud en utilisant DNS Steering.
- Nous avons obtenu des données de véritables clients, de tous types d'appareils.
- Nous avons prouvé l'efficacité de l'idée proposée.
- Nous n'avons pas pris de risques — nous n'avons pas modifié les configurations de production pour les clients.
- Nous n'avons rien cassé.
Maintenant, sur la partie complexe - nous lançons en production.
Le plus facile est maintenant derrière nous : nous avons un prototype fonctionnel. La partie difficile consiste désormais à déployer la solution pour tout le trafic de Netflix, à la rendre opérationnelle pour 150 millions d'utilisateurs, des milliers d'appareils, des centaines de microservices et des produits et infrastructures en constante évolution. Les serveurs de Netflix reçoivent des millions de requêtes par seconde, et il est facile de casser le service par une action inattentive. Parallèlement, nous souhaitons rediriger dynamiquement le trafic à travers des milliers de serveurs CDN, sur Internet, où tout change et se casse constamment au pire moment.
Et avec tout cela, l'équipe compte 3 ingénieurs responsables du développement, du déploiement et de la maintenance complète du système.
C'est pourquoi nous allons maintenant parler d'un sommeil calme et sain.
Comment poursuivre le développement sans passer tout son temps à maintenir ? Notre approche repose sur 3 principes :
- Nous réduisons le potentiel d'ampleur des pannes (blast radius).
- Nous nous préparons aux surprises - nous nous attendons à ce que quelque chose casse, malgré les tests et l'expérience personnelle.
- Dégradation progressive (graceful degradation) - si quelque chose ne fonctionne pas, cela doit être réparé automatiquement, même de manière moins efficace.
Il s'est avéré que, dans notre cas, avec cette approche du problème, nous pouvons trouver une solution simple et efficace et simplifier considérablement la maintenance du système. Nous avons compris que nous pouvions ajouter un petit morceau de code dans le client et surveiller les erreurs des requêtes réseau causées par des problèmes de connexion. En cas d'erreurs réseau, nous effectuons un fallback directement dans le cloud. Cette solution n'exige pas d'efforts significatifs de la part des équipes clientes, mais réduit considérablement les risques de pannes inattendues et de surprises pour nous.
Évidemment, malgré le fallback, nous suivons tout de même une discipline stricte durant le développement :
- Test des échantillons.
- Tests A/B ou Canaries.
- Déploiement progressif (progressive rollout).
Pour les échantillons, l'approche a été décrite - les changements sont d'abord testés à l'aide d'une recette configurée.
Pour les tests canary, nous avons besoin de paires de serveurs comparables, sur lesquelles nous pouvons comparer le fonctionnement du système avant et après les modifications. Pour ce faire, à partir de nos nombreux sites CDN, nous faisons un échantillon de paires de serveurs qui reçoivent un trafic comparable :
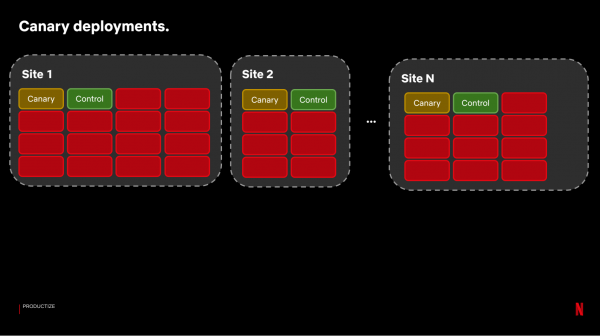
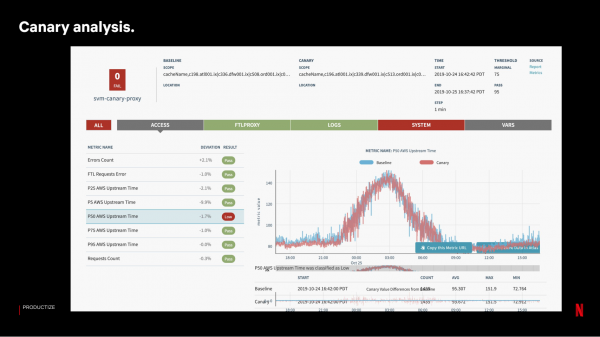
Ensuite, nous déployons la version modifiée sur les serveurs Canary. Pour évaluer les résultats, nous exécutons un système qui compare environ 100 à 150 métriques à partir d'un échantillon de serveurs de contrôle :
Si le test Canary est réussi, nous procédons au déploiement de manière progressive, par vagues. Sur chaque site, nous ne mettons pas à jour les serveurs simultanément — la perte d'un site entier en cas de problème a un impact plus significatif sur le service pour les utilisateurs que la perte d'une quantité équivalente de serveurs, mais à différents endroits.
Dans l'ensemble, l'efficacité et la sécurité de cette approche dépendent de la quantité et de la qualité des métriques recueillies. Pour notre système d'accélération des requêtes, nous collectons des métriques provenant de tous les composants possibles :
- des clients — le nombre de sessions et de requêtes, les taux de secours ;
- proxy — les statistiques concernant le nombre et le temps des requêtes ;
- DNS — le nombre et les résultats des requêtes ;
- cloud edge — le nombre et le temps de traitement des requêtes dans le cloud.
Tout cela est intégré dans un pipeline unique, et, selon les besoins, nous décidons quelles métriques envoyer pour l'analyse en temps réel, et lesquelles vers Elasticsearch ou Big Data pour un diagnostic plus détaillé.
Surveillance
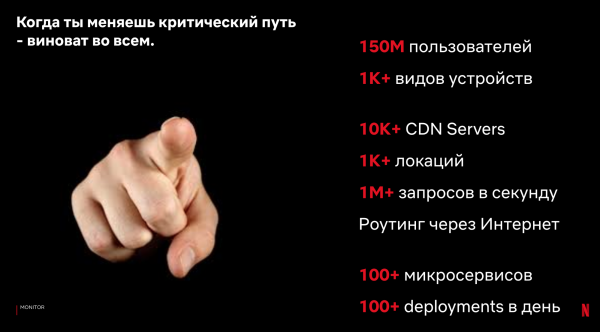
Dans notre cas, nous apportons des modifications sur le chemin critique des requêtes entre le client et le serveur. L'ensemble des différents composants sur le client, le serveur et le chemin à travers Internet est immense. Les modifications sur le client et le serveur se produisent en permanence — en raison du travail de dizaines d'équipes et des changements naturels dans l'écosystème. Nous sommes au milieu — lors du diagnostic des problèmes, il y a une forte probabilité que nous y soyons impliqués. Par conséquent, nous devons comprendre clairement comment définir, collecter et analyser les métriques pour une localisation rapide des problèmes.
Idéalement — un accès complet à tous les types de métriques et filtres en temps réel. Mais il y a beaucoup de métriques, donc le coût devient une question. Dans notre cas, nous segmentons les métriques et les outils de développement de la manière suivante :
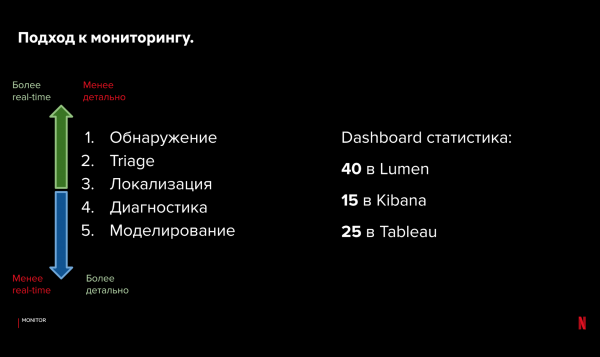
Pour la détection et le triage des problèmes, nous utilisons notre propre système en temps réel à code source ouvert et — pour la visualisation. Il stocke des métriques agrégées en mémoire, est fiable et s'intègre à un système d'alerte. Pour la localisation et le diagnostic, nous avons accès aux journaux d'Elasticsearch et Kibana. Pour l'analyse statistique et la modélisation, nous utilisons les big data et la visualisation dans Tableau.
Il semble qu'il soit très difficile de travailler avec une telle approche. Cependant, grâce à une organisation hiérarchique des métriques et des outils, nous pouvons rapidement analyser le problème, déterminer le type de problème, puis approfondir les métriques détaillées. En moyenne, nous mettons environ 1 à 2 minutes pour identifier la source de la panne. Ensuite, nous travaillons déjà avec une équipe spécifique sur le diagnostic — cela peut prendre de dizaines de minutes à plusieurs heures.
Même si le diagnostic est rapide, nous ne voulons pas que cela se produise souvent. Idéalement, nous ne devrions recevoir des alertes critiques que lorsque cela a un impact significatif sur le service. Pour notre système d'accélération des requêtes, nous n'avons que 2 alertes qui nous notifieront :
- pourcentage de Client Fallback — évaluation du comportement des clients;
- pourcentage d'erreurs Probe — données de stabilité des composants réseau.
Ces alertes critiques surveillent si le système fonctionne pour la majorité des utilisateurs. Nous regardons combien de clients ont utilisé le fallback s'ils n'ont pas pu bénéficier de l'accélération des requêtes. En moyenne, nous avons moins d'une alerte critique par semaine, bien que de nombreux changements surviennent dans le système. Pourquoi cela nous suffit-il ?
- Il existe un fallback client si notre proxy ne fonctionne pas.
- Il y a un système de steering automatique qui réagit aux problèmes.
Parlons davantage de ce dernier. Notre système de probes et notre système de détection automatique du chemin optimal pour les requêtes clients vers le cloud permettent de gérer automatiquement certains problèmes.
Revenons à notre configuration des probes et aux 3 catégories de chemins. Au-delà du temps de chargement, nous pouvons aussi observer la simple livraison. Si les données ne peuvent pas être chargées, en examinant les résultats sur différents chemins, nous pouvons déterminer où et quoi s'est cassé, et si nous pouvons le réparer automatiquement en changeant le chemin de la requête.
Exemples :
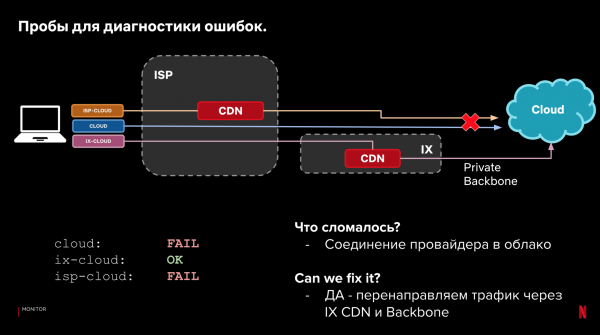
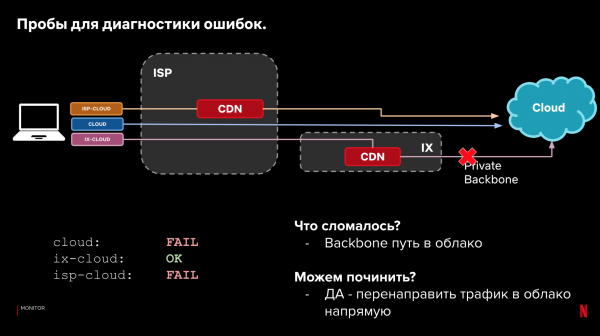
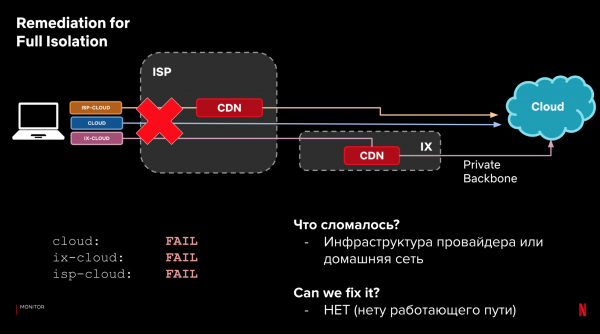
Ce processus peut être automatisé. L'intégrer dans le système de steering. Et l'apprendre à réagir aux problèmes de performance et de fiabilité. Si quelque chose commence à se casser — réagir, s'il existe une meilleure option. Dans ce cas, la réaction instantanée n'est pas critique, grâce au fallback sur les clients.
Ainsi, les principes de support du système peuvent être formulés de la manière suivante :
- nous réduisons l'ampleur des pannes;
- nous collectons des métriques;
- nous réparons automatiquement les pannes, si nous le pouvons;
- si nous ne le pouvons pas — nous notifions;
- Nous travaillons sur des tableaux de bord et un ensemble d'outils de triage pour une réaction rapide.
Leçons tirées
Il ne faut pas beaucoup de temps pour écrire un prototype. Dans notre cas, il était prêt en seulement 4 mois. Avec celui-ci, nous avons obtenu de nouvelles métriques, et 10 mois après le début du développement, nous avons reçu notre premier trafic de production. Ensuite, un travail pénible et très complexe a commencé : il a fallu progressivement industrialiser et mettre à l'échelle le système, migrer le trafic principal et apprendre de nos erreurs. Ce processus efficace ne sera pas linéaire — malgré tous les efforts, tout ne peut pas être prévu. Une itération rapide et une réaction aux nouvelles données sont beaucoup plus efficaces.
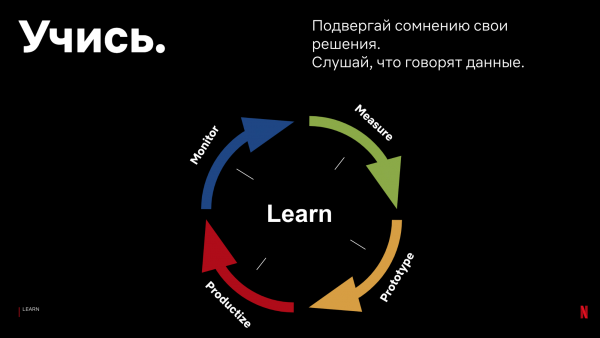
D'après notre expérience, nous pouvons conseiller ce qui suit :
- Ne faites pas confiance à votre intuition.
Notre intuition nous a souvent induits en erreur, malgré l'immense expérience des membres de l'équipe. Par exemple, nous avons mal prédit l'accélération attendue avec l'utilisation de proxys CDN, ou le comportement de TCP Anycast.
- Obtenez des données de production.
Il est important d'accéder le plus rapidement possible à au moins une petite quantité de données de production. Il est pratiquement impossible d'obtenir le nombre de cas uniques, de configurations et de réglages dans des conditions de laboratoire. Un accès rapide aux résultats permettra d'être informé plus rapidement des problèmes potentiels, pour les prendre en compte dans l'architecture du système.
- Ne suivez pas les conseils et les résultats des autres — collectez vos propres données.
Suivez les principes de collecte et d'analyse des données, mais ne prenez pas aveuglément les résultats et les affirmations des autres. Vous seul pouvez savoir ce qui fonctionne pour vos utilisateurs. Vos systèmes et vos clients peuvent être très différents de ceux d'autres entreprises. Heureusement, les outils d'analyse sont maintenant facilement accessibles et faciles à utiliser. Les résultats que vous obtenez peuvent ne pas correspondre à ce que des entreprises comme Netflix, Facebook, Akamai et d'autres affirment. Dans notre cas, les performances TLS, HTTP2 ou les statistiques sur les requêtes DNS diffèrent des résultats de Facebook, Uber, Akamai — car nous avons d'autres appareils, clients et flux de données.
- Ne courez pas après des tendances à la mode sans nécessité et évaluation de l'efficacité.
Commencez par le simple. Il est préférable de créer un système de travail simple dans un court laps de temps que de passer énormément de temps à développer des composants inutiles. Résolvez des tâches et des problèmes qui sont importants sur la base de vos mesures et résultats.
- Préparez-vous aux nouvelles applications.
Tout comme il est difficile de prévoir tous les problèmes, il est tout aussi difficile d'anticiper les avantages et les applications. Prenez exemple sur les startups : leur capacité à s'adapter aux besoins des clients. Dans votre cas, vous pouvez découvrir de nouveaux problèmes et leurs solutions. Dans notre projet, nous avons visé à réduire la latence des requêtes. Cependant, au cours de notre analyse et de nos discussions, nous avons compris que nous pouvions également utiliser des serveurs proxy :
- pour équilibrer le trafic à travers les régions AWS et réduire les coûts ;
- pour modéliser la stabilité du CDN ;
- pour configurer le DNS ;
- pour configurer le TLS/TCP.
Conclusion
Dans ma présentation, j'ai décrit comment Netflix aborde le problème d'accélération des requêtes Internet entre les clients et le cloud. Comment nous collectons des données à l'aide d'un système de sondes sur les clients, et utilisons les données historiques recueillies pour diriger les requêtes de production des clients par le chemin le plus rapide sur Internet. Comment nous utilisons les principes de fonctionnement des protocoles réseau, notre infrastructure CDN, notre réseau backbone, et nos serveurs DNS pour atteindre cet objectif.
Cependant, notre solution n'est qu'un exemple de la façon dont nous avons mis en œuvre un tel système chez Netflix. Ce qui a fonctionné pour nous. La partie pratique de mon exposé pour vous concerne les principes de développement et de support que nous suivons et qui nous permettent d'obtenir de bons résultats.
Notre solution à ce problème peut ne pas convenir à votre cas. Cependant, les théories et les principes de développement restent valables, même si vous n'avez pas votre propre infrastructure CDN, ou si elle diffère considérablement de la nôtre.
L'importance de la vitesse des requêtes pour l'entreprise demeure. Même pour un service simple, il faut faire des choix : entre les fournisseurs « cloud », l'emplacement des serveurs, les fournisseurs de CDN et de DNS. Votre choix influencera l'efficacité des requêtes Internet pour vos clients. Il est important que vous mesuriez et compreniez cette influence.
Commencez par des solutions simples, prenez soin de manière dont vous modifiez le produit. Apprenez en cours de route et améliorez le système sur la base des données de vos clients, de votre infrastructure et de votre entreprise. Pensez à la possibilité de pannes inattendues lors de la conception. Ainsi, vous pourrez accélérer votre processus de développement, améliorer l'efficacité de la solution, éviter une surcharge de support et dormir sur vos deux oreilles.
Cette année en format en ligne. Vous pourrez poser des questions à l'un des pères de DevOps, le même John Willis !
Source : habr.com
