

Bonjour à tous, je m'appelle Sergey Emelyanchik. Je suis le directeur de la société Audit-Telecom, le principal développeur et l'auteur du système Veliam. J'ai décidé d'écrire un article sur la façon dont mon ami et moi avons créé une entreprise d'externalisation, avons développé un logiciel pour nous-mêmes et avons ensuite commencé à le distribuer à tous ceux qui le souhaitaient sous un modèle SaaS. Je parlerai de mon scepticisme initial à croire que c'était possible. L'article contiendra non seulement un récit, mais aussi des détails techniques sur la création du produit Veliam, y compris des extraits de code source. Je raconterai les erreurs que nous avons commises et comment nous les avons corrigées par la suite. J'ai eu des doutes sur la publication de cet article. Mais je me suis dit qu'il valait mieux le faire, obtenir des retours et m'améliorer, plutôt que de ne pas publier et de me demander ce qui aurait pu se passer…
Contexte
J'ai travaillé dans une entreprise en tant qu'employé informatique. C'était une société assez grande avec une structure réseau complexe. Je ne vais pas m'attarder sur mes responsabilités, je dirai juste que le développement de quoi que ce soit n'en faisait certainement pas partie.
Nous avions une solution de surveillance, mais par pure curiosité académique, je voulais essayer d'écrire la mienne. L'idée était la suivante : je voulais que ce soit accessible sur le web, afin que l'on puisse facilement s'y connecter sans installer de clients, et voir ce qui se passait avec le réseau depuis n'importe quel appareil, y compris un mobile via Wi-Fi. Je voulais également comprendre rapidement dans quelle pièce se trouvait l'équipement qui avait 'mal', car nous avions des exigences très strictes en matière de temps de réponse face à de tels problèmes. Au final, j'ai imaginé un plan pour écrire une simple page web, avec en fond un jpeg représentant le schéma du réseau, en découpant sur cette image les appareils avec leurs adresses IP, et en affichant, sur l'image aux coordonnées appropriées, un contenu dynamique sous forme d'adresses IP vertes ou rouge clignotant. La tâche est posée, à l'œuvre.
Auparavant, je faisais de la programmation en Delphi, PHP, JS et, très brièvement, en C++. Je connais assez bien le fonctionnement des réseaux : VLAN, Routage (OSPF, EIGRP, BGP), NAT. Cela suffisait pour créer un prototype de surveillance primitive tout seul.
J'ai écrit ce que j'avais en tête en PHP. Le serveur Apache et PHP fonctionnaient sur Windows car Linux me semblait, à l'époque, quelque chose de compliqué et très difficile. Comme je l'ai compris plus tard, je me trompais largement, car dans de nombreux cas, Linux est bien plus simple que Windows. Mais c'est un sujet à part et nous savons tous combien de controverses existent à ce sujet. Le planificateur de tâches de Windows exécutait un script PHP à intervalles réguliers (je ne me souviens plus exactement, mais c'était quelque chose comme une fois toutes les trois secondes), qui interrogeait tous les objets par un simple ping et enregistrait l'état dans un fichier.
system(“ping -n 3 -w 100 {$ip_address}“);
Oui, à l'époque, je n'avais pas non plus maîtrisé le travail avec les bases de données. Je ne savais pas qu'il était possible de paraller des processus, et le passage à travers tous les nœuds du réseau prenait beaucoup de temps, car tout se faisait en un seul fil d'exécution. Des problèmes survenaient particulièrement lorsque plusieurs nœuds étaient inaccessibles, car chacun retardait le script de 300 ms. Du côté client, il y avait une simple fonction en boucle qui, toutes les quelques secondes, récupérait les informations mises à jour du serveur par une requête Ajax et mettait à jour l'interface. Et ensuite, après trois pings infructueux consécutifs, si la page web de surveillance était ouverte sur l'ordinateur, une mélodie joyeuse se jouait.
Quand tout a fonctionné, j'ai été très inspiré par le résultat et j'ai pensé qu'on pouvait ajouter d'autres fonctionnalités (en fonction de mes connaissances et capacités). Cependant, j'ai toujours eu un aversion pour les systèmes avec des millions de graphiques, que je considérais alors, et considère encore aujourd'hui, pour être souvent inutiles. Je voulais intégrer uniquement ce qui m'aiderait réellement dans mon travail. Ce principe reste aujourd'hui fondamental dans le développement de Veliam. Ensuite, j'ai réalisé qu'il serait très pratique de ne pas avoir à garder la surveillance ouverte et de ne savoir qu'il y a un problème que lorsque cela se produit, pour ensuite ouvrir la page et voir où se trouve le nœud problématique du réseau et ce qu'il faut en faire. À l'époque, je ne lisais pas les e-mails, je ne les utilisais tout simplement pas. J'ai découvert sur Internet qu'il existe des passerelles SMS auxquelles on peut envoyer des requêtes GET ou POST, et elles m'enverraient un SMS sur mon téléphone portable avec le texte que j'écrirais. J'ai immédiatement réalisé que je voulais vraiment cela. J'ai donc commencé à étudier la documentation. Après un certain temps, j'ai réussi, et maintenant je recevais des SMS concernant des problèmes sur le réseau sur mon portable avec le nom de l'objet « tombé ». Même si le système était primitif, il avait été écrit par moi-même, et surtout, ce qui me motivait à le développer à l'époque, c'était qu'il s'agissait d'un programme appliqué qui m'aidait réellement dans mon travail.
Et le jour est enfin arrivé où l'un des canaux Internet a échoué au travail, mais ma surveillance ne m'a donné aucun signe. Les DNS de Google étaient toujours bien pingés. Il était temps de réfléchir à la manière de surveiller si le canal de communication était actif. J'avais différentes idées sur comment le faire. Je n'avais pas accès à tout l'équipement. Il fallait donc trouver un moyen de déterminer quel canal était opérationnel sans avoir la possibilité de le vérifier directement sur le matériel réseau. C'est alors qu'un collègue a suggéré que la traceroute vers des serveurs publics pourrait varier en fonction du canal de communication utilisé pour accéder à Internet. J'ai vérifié, et c'était effectivement le cas. Différents itinéraires apparaissaient lors de la traceroute.
system(“tracert -d -w 500 8.8.8.8”);
C'est ainsi qu'un autre script est apparu, ou plutôt qu'une traçabilité a été ajoutée à la fin du même script, qui pingait tous les appareils du réseau. En effet, c'était un autre processus long, qui s'exécutait dans le même fil et ralenti le fonctionnement de l'ensemble du script. Mais à l'époque, cela ne semblait pas aussi évident. Quoi qu'il en soit, il accomplissait sa tâche, le code était rigoureusement écrit pour spécifier quelle traçabilité chaque canal devait avoir. Ainsi, un système a commencé à fonctionner, qui surveillait (un terme un peu fort, car aucune métrique n'était collectée, juste des pings) les appareils réseau (routeurs, commutateurs, Wi-Fi, etc.) et les canaux de communication avec le monde extérieur. Les SMS arrivaient sans faille, et sur le schéma, il était toujours facile de voir où se trouvait le problème.
Ensuite, dans mon travail quotidien, j'ai dû m'occuper de la traversée des réseaux. Et il est devenu fastidieux de devoir me connecter aux commutateurs Cisco pour voir quel interface utiliser. Quelle aurait été la commodité de cliquer sur l'objet dans le monitoring et de voir la liste de ses interfaces avec des descriptions. Cela m'aurait fait gagner du temps. De plus, dans ce schéma, il n'était pas nécessaire de lancer Putty ou SecureCRT, d'entrer des identifiants et des commandes. Il suffisait de cliquer dans le monitoring, de voir ce qu'il fallait faire et d'aller effectuer mon travail. J'ai commencé à chercher comment interagir avec les commutateurs. À première vue, j'ai trouvé deux options : SNMP ou se connecter au commutateur via SSH, entrer les commandes nécessaires et parser le résultat. J'ai écarté SNMP en raison de la complexité de sa mise en œuvre, je voulais obtenir un résultat rapidement. Avec SNMP, j'aurais dû passer beaucoup de temps à examiner le MIB, à partir de ces données pour former des informations sur les interfaces. Il existe une commande remarquable dans CISCO
show interface statusElle montre exactement ce dont j'ai besoin pour les croisements. Pourquoi se fatiguer avec SNMP, quand je veux juste voir le résultat de cette commande, ai-je pensé. Après un certain temps, j'ai mis en œuvre cette possibilité. Je cliquais sur l'objet sur la page web. Un événement se produisait, par lequel le client sollicitait le serveur via AJAX, et ce dernier se connectait par SSH au commutateur dont j'avais besoin (les identifiants étaient intégrés dans le code, je n'avais pas envie de rendre cela plus beau, de créer des menus séparés où l'on pourrait changer les identifiants depuis l'interface, j'avais besoin d'un résultat et rapidement) j'entrais la commande susmentionnée et la renvoyais au navigateur. Ainsi, j'ai commencé à voir les informations sur les interfaces d'un simple clic de souris. C'était extrêmement pratique, surtout lorsque je devais consulter ces informations sur plusieurs commutateurs en même temps.
La surveillance des canaux basée sur le tracé s'est finalement révélée ne pas être la meilleure idée, car des travaux étaient parfois effectués sur le réseau, et le tracé pouvait changer, ce qui amenait la surveillance à me crier qu'il y avait des problèmes avec le canal. Mais après avoir passé beaucoup de temps à analyser, je réalisais que tous les canaux fonctionnaient, alors que ma surveillance me trompait. Finalement, j'ai demandé à des collègues qui géraient les commutateurs de formation de canaux de m'envoyer simplement des syslogs lorsque l'état de visibilité des voisins changeait. Évidemment, cela était beaucoup plus simple, plus rapide et plus fiable que le tracé. Un événement du type voisin perdu arrivait, et je créais immédiatement une alerte sur la chute du canal.
Ensuite, des sorties sur clic sur l'objet avec encore quelques commandes sont apparues, et SNMP a été ajouté pour collecter certaines métriques, et c'est à peu près tout. Le système ne s'est pas développé davantage. Il faisait tout ce dont j'avais besoin, c'était un bon outil. Beaucoup de lecteurs, probablement, me diront qu'il existe déjà une quantité de logiciels en ligne pour résoudre ces problèmes. Mais en réalité, je n'avais pas trouvé de produits gratuits à l'époque et je tenais vraiment à développer mes compétences en programmation, et quoi de mieux pour pousser cela qu'un problème pratique réel. Ainsi, la première version de la surveillance était terminée et n'a plus été modifiée.
Création de la société Audit-Telecom
Avec le temps, j'ai commencé à travailler en parallèle dans d'autres entreprises, ce qui était possible grâce à mon emploi du temps. Lorsque l'on travaille dans plusieurs entreprises, les compétences se développent rapidement dans divers domaines, ce qui élargit les horizons. Il y a des entreprises où, comme on dit, tu es à la fois tailleur, moissonneur et joueur de flûte. D'un côté, c'est difficile, mais de l'autre, si l'on ne se laisse pas abattre, on devient un spécialiste polyvalent, ce qui permet de résoudre les problèmes plus rapidement et efficacement parce que l'on sait comment fonctionne un domaine connexe.
Mon ami Pavel (qui est également dans le secteur IT) m'a constamment encouragé à me lancer dans les affaires. Il y avait d'innombrables idées avec différentes options pour créer notre propre activité. Cela a été discuté pendant plusieurs années. Au final, cela n'a abouti à rien car je suis sceptique et Pavel est un rêveur. Chaque fois qu'il proposait une idée, je n'y croyais jamais et refusais d'y participer. Mais nous avions très envie d'ouvrir notre propre entreprise.
Enfin, nous avons réussi à trouver une option qui nous convenait à tous les deux et à nous lancer dans ce que nous savions faire. En 2016, nous avons décidé de créer une entreprise IT qui aiderait les entreprises à résoudre leurs problèmes informatiques. Cela inclut le déploiement de systèmes IT (1C, serveur de terminaux, serveur de messagerie, etc.), leur maintenance, un classique HelpDesk pour les utilisateurs et l'administration du réseau.
Honnêtement, au moment de la création de l'entreprise, je n'y croyais pas à environ 99,9 %. Mais d'une manière ou d'une autre, Pavel a réussi à me convaincre d'essayer, et pour faire court, il avait raison. Pavel et moi avons chacun investi 300 000 roubles, enregistré une nouvelle LLC "Audit-Telecom", loué un petit bureau, créé de superbes cartes de visite, et en somme, comme la plupart des entrepreneurs novices, nous avons commencé à chercher des clients. La recherche de clients est une histoire à part. Peut-être que nous écrirons un article distinct sur le blog d'entreprise si cela intéresse quelqu'un. Appels à froid, prospectus, et autres. Cela n'a donné aucun résultat. Comme je le lis maintenant dans de nombreuses histoires d'affaires, beaucoup de choses dépendent finalement de la chance. Nous avons eu de la chance. Et littéralement quelques semaines après la création de la société, mon frère Vladimir est venu vers nous et a amené notre premier client. Je ne vais pas vous fatiguer avec les détails du travail avec les clients, ce n'est pas le sujet de l'article, je dirai juste que nous sommes allés à un audit, identifié des points critiques et ces points ont échoué pendant que nous prenions la décision de collaborer avec nous sur une base régulière en tant que sous-traitants. Après cela, une décision positive a été prise immédiatement.
Ensuite, principalement par le bouche-à-oreille via nos connaissances, d'autres entreprises ont commencé à faire appel à nos services. Le support était dans un système. Les connexions aux équipements réseau et aux serveurs dans un autre, selon les cas. Certaines personnes gardaient des raccourcis, d'autres utilisaient des carnets d'adresses RDP. La surveillance était encore un autre système. Travailler en équipe dans des systèmes disparates est très inconfortable. Des informations importantes peuvent passer inaperçues. Par exemple, si le serveur terminal d'un client devient inaccessible. Des demandes arrivent immédiatement de la part des utilisateurs de ce client. Un spécialiste du support crée une demande (qui a été faite par téléphone). Si les incidents et les demandes étaient enregistrés dans un seul système, le spécialiste du support verrait tout de suite quel est le problème de l'utilisateur et pourrait lui en parler, tout en se connectant déjà à l'objet concerné pour gérer la situation. Tout le monde est au courant de la situation tactique et travaille de manière coordonnée. Nous n'avons pas trouvé de système où tout cela serait combiné. Il est devenu évident qu'il était temps de créer notre propre produit.
Poursuite du travail sur notre propre système de surveillance
Il était clair que le système écrit précédemment ne correspondait absolument pas aux tâches actuelles, ni en termes de fonctionnalité ni de qualité. Il a donc été décidé de développer un système à partir de zéro. Graphiquement, cela devait déjà avoir une apparence complètement différente. Cela devait être un système hiérarchique, permettant d'ouvrir rapidement et facilement l'objet nécessaire pour le client adéquat. Le schéma de la première version était totalement inapproprié dans ce cas, car les clients sont différents et il n'avait pas d'importance de savoir dans quelles pièces se trouvaient les équipements. Cela avait déjà été pris en compte dans la documentation.
Ainsi, les tâches :
- Structure hiérarchique ;
- Une sorte de partie serveur, que nous pourrions placer chez le client sous forme de machine virtuelle pour collecter les métriques nécessaires et les envoyer au serveur central, qui va tout synthétiser et nous montrer ;
- Alertes. Celles que l'on ne peut pas manquer, car à ce moment-là, il n'était pas possible de faire en sorte que quelqu'un regarde seulement l'écran ;
- Système de tickets. Des clients ont commencé à apparaître, dont nous gérions non seulement l'équipement serveur et réseau, mais aussi les stations de travail ;
- Possibilité de se connecter rapidement aux serveurs et équipements depuis le système ;
Les tâches sont définies, nous commençons à coder. En parallèle, nous traitons les demandes des clients. À ce moment-là, nous étions déjà 4 personnes. Nous avons commencé à développer simultanément les deux parties : le serveur central et le serveur à installer chez les clients. À ce moment-là, Linux n'était plus étranger pour nous et il a été décidé que les machines virtuelles chez les clients seraient sur Debian. Il n'y aura pas d'installateurs, nous allons simplement créer le projet de la partie serveur sur une machine virtuelle spécifique, et ensuite simplement la cloner pour le client nécessaire. C'était une autre erreur. Plus tard, il est devenu évident qu'un mécanisme de mise à jour n'avait absolument pas été étudié dans ce schéma. Autrement dit, nous ajoutions une nouvelle fonctionnalité, mais ensuite, il y avait tout un problème pour la déployer sur tous les serveurs des clients, mais nous y reviendrons plus tard, tout en temps voulu.
Nous avons créé le premier prototype. Il pouvait pinger les périphériques réseau et serveurs nécessaires de nos clients et envoyer ces données à notre serveur central. Ce dernier, à son tour, mettait à jour ces données dans la base commune sur le serveur central. Je vais écrire ici non seulement l'histoire de ce que nous avons réussi, mais aussi les erreurs de débutants que nous avons commises et comment cela a impacté notre temps. Ainsi, tout l'arbre d'objets était stocké dans un seul fichier sous forme d'objet sérialisé. Tant que nous avons connecté quelques clients au système, tout allait plus ou moins bien, bien qu'il y ait eu parfois des artefacts complètement incompréhensibles. Mais lorsque nous avons connecté une dizaine de serveurs au système, des merveilles ont commencé à se produire. Parfois, sans raison apparente, tous les objets du système disparaissaient simplement. Il est important de noter que les serveurs des clients envoyaient des données au serveur central toutes les quelques secondes par le biais d'une requête POST. Le lecteur attentif et le programmeur expérimenté auront déjà compris qu'il y avait un problème d'accès concurrent à ce même fichier dans lequel était stocké l'objet sérialisé, provenant de différents threads en même temps. Et c'est précisément lorsque cela se produisait que des merveilles de disparition des objets se manifestaient. Le fichier devenait tout simplement vide. Mais cela n'a été découvert qu'après coup, au cours de l'exploitation avec plusieurs serveurs. Pendant ce temps, une fonctionnalité de scan des ports a été ajoutée (les serveurs envoyaient au central non seulement des informations sur la disponibilité des périphériques, mais aussi sur les ports ouverts). Cela a été réalisé en appelant la commande :
$connection = @fsockopen($ip, $port, $errno, $errstr, 0.5);
les résultats étaient souvent incorrects et le scan prenait beaucoup de temps. J'ai complètement oublié le ping, qui était exécuté via fping :
system("fping -r 3 -t 100 {$this->ip}");
Tout cela n'était pas non plus parallélisé et donc le processus était très long. Plus tard, dans fping, la liste entière des adresses IP à vérifier était transmise en une seule fois et nous recevions en retour la liste de ceux qui avaient répondu. Contrairement à nous, fping savait paralléliser les processus.
Une autre tâche routinière fréquente était la configuration de certains services via le WEB. Par exemple, l'ECP de MS Exchange. En fin de compte, ce n'est qu'un lien. Nous avons donc décidé de permettre d'ajouter ces liens directement dans le système, afin de ne pas avoir à chercher dans la documentation ou ailleurs pour accéder à l'ECP d'un client spécifique. C'est ainsi qu'est apparue la notion de liens de ressources pour le système, dont la fonctionnalité est disponible encore aujourd'hui et n'a pas subi de changements, presque.
Fonctionnement des liens de ressources dans Veliam
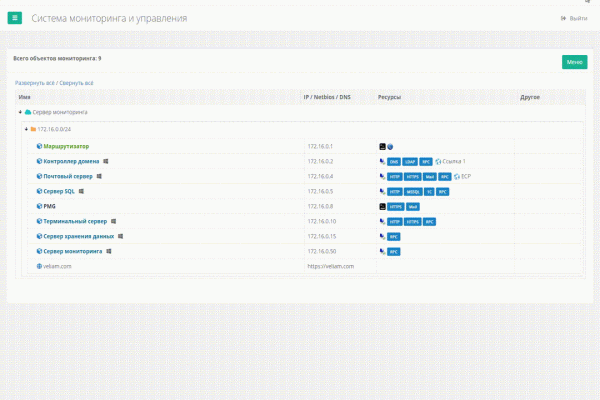
Connexions distantes
Voici à quoi cela ressemble en pratique dans la version actuelle de Veliam
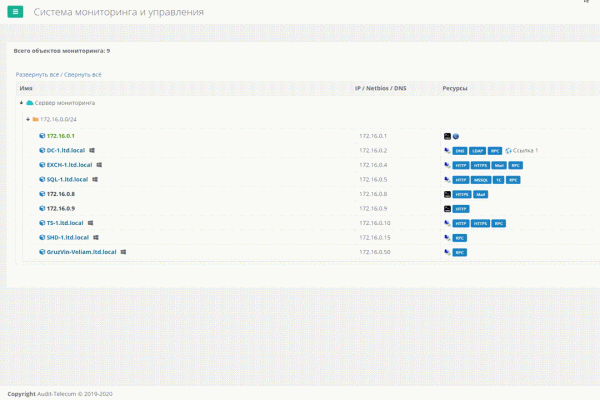
L'une des tâches était de se connecter rapidement et facilement aux serveurs, dont le nombre est maintenant élevé (plus d'une centaine), et parcourir des millions de raccourcis RDP sauvegardés était extrêmement inconfortable. Un outil était nécessaire. Il existe des logiciels sur Internet qui ressemblent à un carnet d'adresses pour ces connexions RDP, mais ils ne sont pas intégrés au système de surveillance, et les identifiants ne peuvent pas être sauvegardés. Saisir les identifiants pour différents clients est un véritable cauchemar lorsque vous vous connectez plusieurs fois par jour à différents serveurs. Les choses sont un peu mieux avec SSH, il existe plusieurs bons logiciels qui permettent d'organiser ces connexions par dossiers et de mémoriser les identifiants. Mais il y a deux problèmes. Premier problème : nous n'avons pas trouvé un programme unique pour les connexions RDP et SSH. Deuxième problème : si à un moment donné je ne suis pas devant mon ordinateur et que je dois me connecter rapidement, ou si je réinstalle simplement le système, je devrai réviser la documentation pour consulter l'identifiant de ce client. Ceci est peu pratique et constitue une perte de temps.
Nous avions déjà la structure hiérarchique nécessaire pour les serveurs des clients dans notre produit interne. Il ne restait plus qu'à envisager comment y intégrer des connexions rapides au matériel nécessaire. Pour commencer, au moins à l'intérieur de notre réseau.
Étant donné que le client dans notre système était un navigateur n'ayant pas accès aux ressources locales de l'ordinateur, afin de simplement lancer une application via une commande, nous avons décidé de tout faire à travers un "schéma d'URL personnalisé Windows". Ainsi est né un certain "plugin" à notre système, qui incluait simplement Putty et Remote Desktop Plus et, lors de l'installation, enregistrait juste le schéma URI dans Windows. Maintenant, lorsque nous voulions nous connecter à un objet via RDP ou SSH, nous cliquions sur cette action dans notre système et le Custom URI s'activait. L'application du standard mstsc.exe intégré dans Windows ou de putty, inclus dans le "plugin", se lançait. J'utilise les guillemets autour du mot plugin, car cela ne constitue pas un plugin de navigateur au sens classique.
C'était au moins quelque chose. Un annuaire pratique. Dans le cas de Putty, tout était plutôt bon, car on pouvait lui fournir comme paramètres d'entrée à la fois l'IP de connexion et le nom d'utilisateur ainsi que le mot de passe. C'est-à-dire que pour les serveurs Linux dans notre réseau, nous nous connections déjà d'un simple clic sans saisir de mots de passe. Mais avec RDP, ce n'était pas aussi simple. Avec le mstsc standard, il n'était pas possible de fournir les informations d'identification comme paramètres. Remote Desktop Plus est venu à notre secours. Il permettait de le faire. Maintenant, nous nous passons de lui, mais il a longtemps été un fidèle assistant dans notre système. Avec les sites HTTP(S), tout était simple, ces objets s'ouvraient tout simplement dans le navigateur. Pratique et fonctionnel. Mais cela n'était un bonheur que dans le réseau interne.
Comme nous résolvions la plupart des problèmes à distance depuis le bureau, la solution la plus simple était de créer des VPN pour les clients. Ainsi, notre système pouvait se connecter à eux. Mais cela restait peu pratique. Pour chaque client, il fallait avoir une multitude de connexions mémorisées sur chaque ordinateur. VPN Avant de se connecter à l'une d'elles, il fallait activer le VPN correspondant. Nous avons utilisé cette solution pendant un certain temps. Mais le nombre de clients augmentait, tout comme celui des VPN, et tout cela devenait pesant et il fallait faire quelque chose. En particulier, cela devenait frustrant après une réinstallation du système, quand il fallait ressaisir des dizaines de connexions VPN dans un nouveau profil Windows. Assez, ai-je dit, et j'ai commencé à réfléchir à ce que l'on pouvait faire.
Il est devenu habituel que tous les clients possèdent des routeurs de la célèbre marque Mikrotik. Ils sont très fonctionnels et adaptés à pratiquement toutes les tâches. Parmi leurs inconvénients, on note qu'ils sont souvent 'détournés'. Nous avons résolu ce problème simplement en fermant tous les accès externes. Cependant, il fallait de toute manière pouvoir y accéder sans se rendre physiquement chez le client, car cela prenait beaucoup de temps. Nous avons simplement créé des tunnels pour chaque Mikrotik et les avons regroupés dans un pool séparé, sans aucune routage, afin d'éviter la fusion de notre réseau avec ceux de nos clients et entre les réseaux des clients eux-mêmes.
L'idée est née de faire en sorte que, lorsque je clique sur l'objet désiré dans le système, le serveur central de surveillance, connaissant les identifiants SSH de tous les Mikrotik clients, se connecte au bon appareil et crée une règle de redirection vers l'hôte approprié avec le port requis. Ici, il y a plusieurs points à prendre en compte. La solution n'est pas universelle - elle ne fonctionnera que pour les Mikrotik, car la syntaxe des commandes varie d'un routeur à un autre. De plus, ces redirections devraient également être supprimées, mais la partie serveur de notre système n'était en réalité pas capable de suivre si j'avais fini ma session de travail par RDP. Et une telle redirection représente une vulnérabilité pour le client. Nous ne recherches même pas l'universalité, car le produit était utilisé uniquement au sein de notre entreprise et sortir dans le public n'était même pas envisagé.
Chacune des problématiques a été résolue à sa manière. Lorsque la règle était créée, la redirection n'était accessible que depuis une adresse IP externe spécifique (celle à partir de laquelle la connexion avait été initiée). Ainsi, il a été possible de diminuer les failles de sécurité. Cependant, à chaque connexion, une règle était ajoutée sur le Mikrotik dans la page NAT et n'était pas supprimée. Il est bien connu que plus il y a de règles, plus le processeur du routeur est sollicité. De manière générale, je ne pouvais pas accepter le fait que je me connecte une fois à un Mikrotik et que là se trouvent des centaines de règles inutiles et mortes.
Puisque notre serveur ne peut pas suivre l'état de la connexion, laissons MikroTik s’en occuper lui-même. J'ai écrit un script qui surveille en permanence toutes les règles de redirection avec une description spécifique (description) et vérifie s'il existe une connexion TCP avec la règle appropriée. Si cela n'a pas été le cas pendant un certain temps, il est probable que la connexion soit déjà terminée et que cette redirection puisse être supprimée. Tout a fonctionné, le script marchait bien.
Voici d'ailleurs le script :
global atmonrulecounter {"dontDelete"="dontDelete"}
:foreach i in=[/ip firewall nat find comment~"atmon_script_main"] do={
	local dstport [/ip firewall nat get value-name="dst-port" $i]
	local dstaddress [/ip firewall nat get value-name="dst-address" $i]
	local dstaddrport "$dstaddress:$dstport"
	#log warning message=$dstaddrport
	local thereIsCon [/ip firewall connection find dst-address~"$dstaddrport"]
	if ($thereIsCon = "") do={
		set ($atmonrulecounter->dstport) ($atmonrulecounter->dstport + 1)
		#:log warning message=($atmonrulecounter->dstport)
		if (($atmonrulecounter->dstport) > 5) do={
			#log warning message="Removing nat rules added automatically by atmon_script"
			/ip firewall nat remove [/ip firewall nat find comment~"atmon_script_main_$dstport"]
			/ip firewall nat remove [/ip firewall nat find comment~"atmon_script_sub_$dstport"]
			set ($atmonrulecounter->dstport) 0
		}
	} else {
		set ($atmonrulecounter->dstport) 0
	}
}
Il est sûr qu'on aurait pu le rendre plus joli, plus rapide, etc., mais il fonctionnait, ne surchargeait pas les MikroTik et faisait le job. Nous avons enfin pu nous connecter aux serveurs et équipements réseau des clients simplement d'un clic de souris, sans devoir activer le VPN et sans entrer de mots de passe. Le système est devenu vraiment très facile à utiliser. Le temps d'entretien a diminué, et nous passons tous notre temps à travailler, plutôt qu'à nous connecter aux objets nécessaires.
Sauvegarde MikroTik
Nous avions configuré la sauvegarde de tous les MikroTik sur FTP. En gros, tout allait bien. Mais quand il fallait récupérer une sauvegarde, il fallait ouvrir ce FTP et la chercher là-bas. Nous avons un système où tous les routeurs sont enregistrés, nous savons communiquer avec les appareils par SSH. Pourquoi ne pas mettre en place un système qui va chaque jour récupérer les sauvegardes de tous les MikroTik, me suis-je dit. J'ai donc commencé à le mettre en œuvre. On s'est connectés, avons fait une sauvegarde et l'avons transférée dans le stockage.
Code du script en PHP pour récupérer la sauvegarde d'un MikroTik :
<?php

	$IP = '0.0.0.0';
	$LOGIN = 'admin';
	$PASSWORD = '';
	$BACKUP_NAME = 'test';

    $connection = ssh2_connect($IP, 22);

    if (!ssh2_auth_password($connection, $LOGIN, $PASSWORD)) exit;

    ssh2_exec($connection, '\/system backup save name="atmon" password="atmon"');
    stream_get_contents($connection);
    ssh2_exec($connection, '\/export file="atmon.rsc"');
    stream_get_contents($connection);
    sleep(40); \/\/ Waiting bakup makes

    $sftp = ssh2_sftp($connection);

    \/\/ Download backup file
    $size = filesize("ssh2.sftp:\/\/{$sftp}\/atmon.backup");
    $stream = fopen("ssh2.sftp:\/\/{$sftp}\/atmon.backup", 'r');
    $contents = '';
    $read = 0;
    $len = $size;
    while ($read < $len && ($buf = fread($stream, $len - $read))) {
        $read += strlen($buf);
        $contents .= $buf;
    }
    file_put_contents ($BACKUP_NAME . ‘.backup’, $contents);
    @fclose($stream);

    sleep(3);
    \/\/ Download RSC file
    $size = filesize("ssh2.sftp:\/\/{$sftp}\/atmon.rsc");
    $stream = fopen("ssh2.sftp:\/\/{$sftp}\/atmon.rsc", 'r');
    $contents = '';
    $read = 0;
    $len = $size;
    while ($read
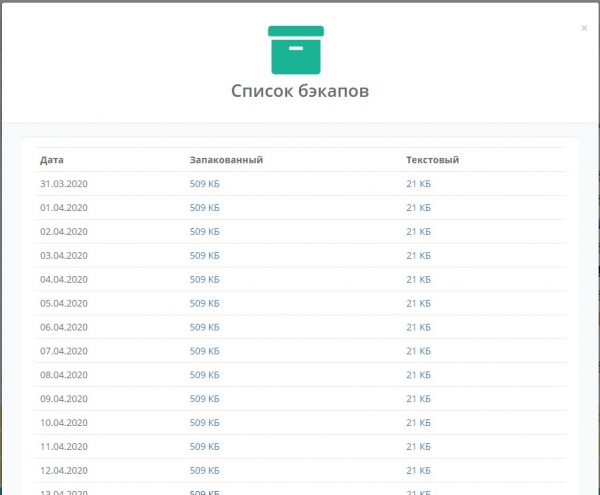
La sauvegarde est réalisée sous deux formats : binaire et configuration texte. Le binaire permet une restauration rapide de la configuration nécessaire, tandis que le format texte aide à comprendre les démarches à suivre en cas de remplacement involontaire du matériel, quand il n'est pas possible de restaurer avec le binaire. En fin de compte, cela a ajouté une fonctionnalité supplémentaire pratique dans le système. De plus, lors de l'ajout de nouveaux Mikrotiks, aucune configuration n'était nécessaire, il suffisait d'ajouter l'objet dans le système et de lui attribuer un compte SSH. Ensuite, le système prenait en charge la sauvegarde automatiquement. Dans la version actuelle de SaaS Veliam, cette fonctionnalité n'est pas encore disponible, mais nous allons bientôt la porter.
Captures d'écran de l'apparence dans le système interne
Passage à un stockage normal dans la base de données
J'ai déjà mentionné ci-dessus qu'il y avait des artefacts. Parfois, toute la liste des objets dans le système disparaissait, et parfois, lors de l'édition d'un objet, les informations n'étaient pas sauvegardées, ce qui me contraignait à renommer l'objet trois fois. C'était extrêmement frustrant pour tout le monde. La disparition des objets se produisait rarement et était facilement récupérable en restaurant le fichier en question, mais l'échec lors de l'édition des objets était fréquent. Il est probable que je n'ai pas initialement fait cela via une base de données parce que je ne comprenais pas comment garder un arbre avec toutes ses relations dans une table plate. C'est une table plate, tandis qu'un arbre est hiérarchique. Mais une bonne solution pour l'accès multiple, et par la suite (avec la complexité croissante du système) pour les transactions, est une base de données. Je ne suis sûrement pas le premier à être confronté à ce problème. J'ai commencé à chercher sur Google. Il s'est avéré que tout avait déjà été inventé avant moi, et il existe plusieurs algorithmes qui construisent un arbre à partir d'une table plate. En examinant chacun d'eux, j'ai réalisé l'un d'eux. Cependant, c'était déjà une nouvelle version du système, car il a en fait fallu réécrire beaucoup de choses à cause de cela. Le résultat était naturel, les problèmes de comportement aléatoire du système ont disparu. Certains peuvent dire que les erreurs sont très amateur (scripts unithread, stockage d'informations accessibles simultanément par plusieurs threads dans un fichier, etc.) dans le domaine du développement de logiciels. Peut-être que c'est vrai, mais mon travail principal était l'administration, et la programmation était en quelque sorte une occupation secondaire pour le plaisir, et je n'avais tout simplement pas d'expérience de travail dans une équipe de programmeurs, là où des choses aussi élémentaires m'auraient été indiquées immédiatement par des collègues plus âgés. Ainsi, j'ai appris toutes ces leçons moi-même, mais j'ai très bien assimilé le matériel. De plus, mon travail comprend également des rencontres avec des clients, des actions visant à essayer de promouvoir l'entreprise, et une multitude de questions administratives internes à l'entreprise, et bien d'autres choses encore. Quoi qu'il en soit, ce qui existait déjà était en demande. Les gars et moi-même utilisions le produit dans notre travail quotidien. Il y avait aussi des idées franchement ratées, et des solutions sur lesquelles du temps a été perdu, pour finalement réaliser que c'était un outil inutilisable que personne n'utilisait, et cela n'est pas entré dans Veliam.
Service d'assistance — HelpDesk
Il n'est pas superflu de mentionner comment a été formé le HelpDesk. C'est en effet une histoire à part, car chez Veliam, c'est déjà la 3ème version complètement nouvelle, qui se distingue de toutes les précédentes. Actuellement, il s'agit d'un système simple, intuitif, sans fioritures, avec la possibilité de s'intégrer à un domaine, ainsi que la possibilité d'accéder au même profil utilisateur depuis n'importe où via un lien dans un e-mail. Et ce qui est le plus important, c'est la possibilité de se connecter à un demandeur par VNC directement depuis la demande, sans VPN ni redirections de ports. Je vais vous raconter comment nous en sommes arrivés là, ce qu'il y avait avant et quelles solutions horrible étaient proposées.
Nous étions connectés aux utilisateurs via le célèbre TeamViewer. Sur tous les ordinateurs des utilisateurs que nous assistons, TV était installé. La première chose que nous avons faite de travers, et que nous avons ensuite supprimée, était l'association de chaque client HWID au matériel. Comment un utilisateur pouvait-il se connecter au système HWID pour soumettre une demande ? Sur tous les ordinateurs, en plus de TV, une utilitaire spéciale écrite en Lazarus était installée (beaucoup vont sûrement écarquiller les yeux ici et peut-être même chercher ce que c'est, mais le meilleur des langages compilables que je connaissais était Delphi, et Lazarus, c'est presque la même chose, juste gratuit). En gros, l'utilisateur lançait chez lui un script spécial, qui exécutait cette utilitaire, celle-ci lisait le HWID du système et ensuite un navigateur se lançait et l'authentification se réalisait. Pourquoi cela a-t-il été fait ? Dans certaines entreprises, le comptage des utilisateurs servis se fait à l'unité, et le tarif de service pour chaque mois est établi en fonction du nombre de personnes. Cela est compréhensible, direz-vous, mais pourquoi l'association au matériel ? Très simplement, certaines personnes rentraient chez elles et soumettaient une demande depuis leur ordinateur portable personnel dans le style "faites-moi tout joli ici". En plus de lire le HWID du système, l'utilitaire extrayait l'ID actuel de TeamViewer du registre et le transmettait également à nous. TeamViewer a une API pour l'intégration. Et nous avons réalisé cette intégration. Mais il y avait un problème. À travers cette API, il n'est pas possible de se connecter à l'ordinateur de l'utilisateur, sauf s'il initie explicitement cette session et après une tentative de connexion, il doit encore cliquer sur "confirmer". À ce moment-là, il nous semblait logique que sans l'accord de l'utilisateur, personne ne devrait se connecter, et comme la personne est devant l'ordinateur, elle initierait la session et répondrait positivement à la demande de connexion à distance. Tout ne s'est pas passé comme prévu. Les demandeurs oubliaient d'initier la session, et il fallait leur dire cela au téléphone. Cela prenait du temps et agaçait les deux parties du processus. De plus, il n'est pas rare que des moments comme celui-ci se présentent, où une personne laisse une demande, mais n'autorise la connexion que lorsqu'elle part en pause déjeuner. Car le problème n'est pas critique et ne souhaite pas interrompre son processus de travail. Par conséquent, elle ne cliquera sur aucun bouton pour permettre la connexion. C'est ainsi qu'une fonctionnalité supplémentaire a été ajoutée lors de l'authentification dans HelpDesk - la lecture de l'ID TeamViewer. Nous connaissions le mot de passe constant, qui était utilisé lors de l'installation de TeamViewer. En fait, seule la systeme le savait, car il était intégré dans l'installateur et dans notre système. Par conséquent, il y avait un bouton de connexion dans la demande, en cliquant sur lequel il n'était pas nécessaire d'attendre quoi que ce soit, TeamViewer s'ouvrait immédiatement et la connexion se faisait. Au final, il y avait deux types de connexions possibles. Via l'API officielle de TeamViewer et notre propre. À ma grande surprise, la première a presque immédiatement cessé d'être utilisée, bien qu'il ait été précisé de l'utiliser uniquement dans des cas particuliers et lorsque l'utilisateur donne lui-même son accord. La sécurité est devenue primordiale. Mais il s'est avéré que les demandeurs ne souhaitent pas cela. Ils n'ont absolument rien contre que l'on se connecte à eux sans bouton de confirmation. Et donc, par la suite, la fonctionnalité de connexion via l'API a été abandonnée par manque de besoin.
Passage à la multithreading sous Linux
La question de l'accélération du passage du scanner réseau pour vérifier l'ouverture d'une liste prédéfinie de ports et la simple vérification de l'accessibilité des objets du réseau se posait déjà depuis longtemps. La première solution qui vient à l'esprit est donc le multithreading. En effet, le temps passé à pinger dépend principalement de l'attente de la réponse des paquets, et le ping suivant ne peut pas commencer tant que le paquet précédent n'est pas revenu. Dans les entreprises ayant même plus de 20 serveurs et d'équipements réseau, ce processus devenait déjà assez lent. L'essentiel est qu'un paquet peut disparaître, et il n'est pas possible d'informer immédiatement l'administrateur système à ce sujet. Il finira par ne plus prêter attention à un tel spam. Il est donc nécessaire de pinguer chaque objet plusieurs fois avant de conclure à son indisponibilité. Pour ne pas entrer dans trop de détails, il faut paralléliser, car sinon, l'administrateur système risque d'apprendre le problème par le client, et non par le système de surveillance.
PHP, par défaut, ne supporte pas le multithreading. Il prend en charge la multiprocessabilité et permet de fork. Cependant, j'avais déjà écrit un mécanisme d'interrogation et je voulais le concevoir de telle sorte qu'une seule fois, je puisse récupérer tous les nœuds nécessaires depuis la base de données, les pinguer tous en même temps, attendre la réponse de chacun d'eux et ensuite écrire les données immédiatement. Cela économise le nombre de requêtes de lecture. Cette idée s'intégrait parfaitement à la multithreading. Il existe un module PThreads pour PHP, qui permet une véritable multithreading ; j'ai dû travailler dur pour le configurer sur PHP 7.2, mais cela a été fait. Le scan des ports et le ping sont devenus rapides. Par exemple, au lieu de 15 secondes par cycle auparavant, ce processus ne prenait désormais plus que 2 secondes. C'était un bon résultat.
Audit rapide des nouvelles entreprises
Comment est apparue la fonctionnalité de collecte de diverses métriques et caractéristiques du matériel ? C'est simple. Parfois, on nous demande simplement d'auditer l'infrastructure informatique existante. Et il en est de même pour accélérer l'audit d'un nouveau client. Il fallait quelque chose qui nous permette d'entrer dans une entreprise de taille moyenne ou grande et de rapidement s'orienter sur ce qu'ils ont. À mon avis, seuls ceux qui souhaitent compliquer leur vie bloquent le ping dans leur réseau interne, et d'après notre expérience, ils ne sont pas très nombreux. Mais ils existent. Par conséquent, il est possible de scanner rapidement les réseaux à la recherche de dispositifs avec un simple ping. Ensuite, il est possible de les ajouter et de les scanner pour détecter les ports ouverts qui nous intéressent. En substance, cette fonctionnalité était déjà présente, il fallait juste ajouter une commande depuis le serveur central vers le serveur subordonné, afin que celui-ci scanne les réseaux définis et ajoute à la liste tout ce qu'il trouve. J'ai oublié de mentionner qu'il était supposé que nous disposions déjà d'une image prête avec un système configuré (serveur de monitoring subordonné) que nous pouvions simplement déployer chez le client lors de l'audit et le connecter à notre cloud.
Mais le résultat d'un audit comprend généralement une multitude d'informations, dont l'une est — quels appareils se trouvent sur le réseau. En premier lieu, nous étions intéressés par les serveurs Windows et les stations de travail Windows au sein du domaine. En effet, dans les moyennes et grandes entreprises, l'absence de domaine est probablement une exception à la règle. Pour parler d’une même voix, je considère qu'une entreprise moyenne compte 100 personnes ou plus. Il fallait trouver un moyen de rassembler les données de toutes les machines et serveurs Windows, en connaissant leur adresse IP et le compte de l'administrateur de domaine, mais sans installer de logiciel sur chacun d'eux. C'est là qu'intervient l'interface WMI. Windows Management Instrumentation (WMI) se traduit littéralement par l'instrumentation de gestion de Windows. WMI est l'une des technologies de base pour la gestion centralisée et le suivi des différentes parties de l'infrastructure informatique sous la plateforme Windows. Cela a été extrait de la wiki. Ensuite, j'ai dû à nouveau m'atteler à la tâche de rassembler wmic (c'est le client WMI) pour Debian. Une fois tout cela prêt, il suffisait de questionner les nœuds nécessaires via wmic pour obtenir les informations recherchées. Grâce à WMI, il est possible d'extraire presque n'importe quelle information d'un ordinateur Windows, et de plus, il est également possible de gérer l'ordinateur, par exemple, en l'ordonnant à redémarrer. C'est ainsi qu'est née la collecte d'informations sur les stations et serveurs Windows dans notre système. En plus de cela, nous avions également des informations mises à jour sur les indicateurs de charge du système. Nous les interrogeons plus fréquemment, tandis que les informations matérielles le sont moins souvent. Après cela, il est devenu un peu plus agréable de mener l’audit.
Décision de diffusion de logiciels
Nous utilisons nous-mêmes ce système tous les jours, et il est toujours ouvert à chaque membre du personnel technique. Nous avons pensé qu’il serait possible de partager ce que nous avons déjà avec d'autres. Le système n'était pas encore du tout prêt à être diffusé. Il était nécessaire de retravailler beaucoup de choses pour transformer la version locale en SaaS. Cela inclut des modifications de divers aspects techniques du système (connexions distantes, service d'assistance), l'analyse des modules en ce qui concerne la licence, le sharding des bases de données clients, la mise à l'échelle de chacun des services, et le développement de systèmes de mises à jour automatiques pour toutes les parties. Mais cela fera l'objet de la deuxième partie de l'article.
Mise à jour
Source : habr.com
