

Chez Badoo, nous surveillons constamment les nouvelles technologies et évaluons si elles valent la peine d'être utilisées dans notre système. Nous souhaitons partager avec la communauté l'une de nos recherches. Elle est dédiée à Loki — un système d'agrégation de logs.
Loki est une solution pour le stockage et la visualisation des logs, ce stack offre également un système flexible pour leur analyse et l'envoi de données à Prometheus. En mai, une nouvelle mise à jour est sortie, qui est activement promue par les créateurs. Nous sommes intéressés par ce que Loki peut faire, quelles sont ses fonctionnalités et dans quelle mesure il peut servir d'alternative à l'ELK — le stack que nous utilisons actuellement.
Qu'est-ce que Loki
Grafana Loki est un ensemble de composants pour un système complet de gestion des logs. Contrairement à d'autres systèmes similaires, Loki repose sur l'idée d'indexer uniquement les métadonnées des logs — labels (comme dans Prometheus), tandis que les logs eux-mêmes sont compressés à proximité dans des chunks séparés.
,
Avant de passer à la description de ce que l'on peut faire avec Loki, je veux expliquer ce que signifie « l'idée d'indexer uniquement les métadonnées ». Comparons l'approche de Loki à celle de l'indexation dans des solutions traditionnelles, comme Elasticsearch, en prenant en exemple une ligne de log nginx :
172.19.0.4 - - [01/Juin/2020:12:05:03 +0000] "GET /purchase?user_id=75146478&item_id=34234 HTTP/1.1" 500 8102 "-" "Stub_Bot/3.0" "0.001"Les systèmes traditionnels analysent la ligne dans son intégralité, y compris les champs avec un grand nombre de valeurs uniques pour user_id et item_id, et conservent tout dans de grands index. L'avantage de cette approche est que l'on peut effectuer des requêtes complexes rapidement, car presque toutes les données sont dans l'index. Mais cela vient au prix de l'augmentation de la taille de l'index, ce qui implique des exigences en mémoire. Au final, l'index plein texte des logs est comparable en taille aux logs eux-mêmes. Pour rechercher rapidement, l'index doit être chargé en mémoire. Plus il y a de logs, plus l'index augmente rapidement et consomme de la mémoire.
L'approche de Loki nécessite d'extraire uniquement les données nécessaires de la chaîne, dont le nombre de valeurs est limité. Ainsi, nous obtenons un petit index et pouvons rechercher des données en les filtrant par temps et par champs indexés, puis en les scannant avec des expressions régulières ou une recherche de sous-chaîne. Le processus ne semble pas très rapide, mais Loki divise la requête en plusieurs parties et les exécute en parallèle, traitant une grande quantité de données en peu de temps. Le nombre de shards et de requêtes parallèles est configurable ; ainsi, la quantité de données pouvant être traitée par unité de temps dépend linéairement des ressources fournies.
Ce compromis entre un grand index rapide et un petit index avec un balayage complet parallèle permet à Loki de contrôler le coût du système. Il peut être configuré et étendu de manière flexible en fonction des besoins.
La pile Loki se compose de trois composants : Promtail, Loki, Grafana. Promtail collecte les logs, les traite et les envoie à Loki. Loki les stocke. Et Grafana sait interroger les données de Loki et les afficher. En fait, Loki peut être utilisé non seulement pour le stockage de logs et leur recherche. L'ensemble de la pile offre de grandes possibilités de traitement et d'analyse des données entrantes, en utilisant la méthode Prometheus.
Une description du processus d'installation peut être trouvée .
Recherche dans les logs
La recherche dans les logs peut se faire via l'interface spéciale de Grafana — Explorer. Pour les requêtes, le langage LogQL est utilisé, très similaire à PromQL, utilisé dans Prometheus. En principe, il peut être considéré comme un grep distribué.
L'interface de recherche ressemble à ceci :
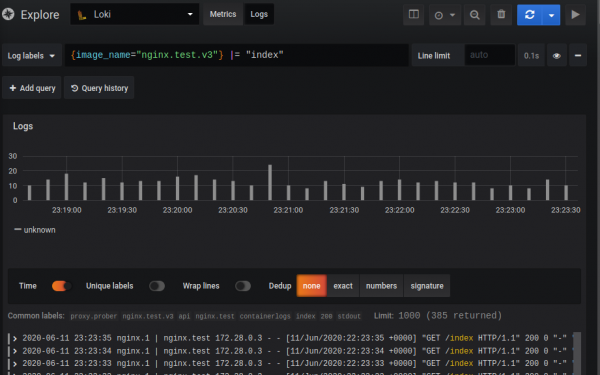
La requête elle-même se compose de deux parties : le sélecteur et le filtre. Le sélecteur est la recherche dans les métadonnées indexées (étiquettes), qui sont attribuées aux logs, tandis que le filtre est la chaîne de recherche ou l'expression régulière utilisée pour filtrer les entrées définies par le sélecteur. Dans l'exemple donné : Dans les accolades, se trouve le sélecteur, tout ce qui suit est le filtre.
{image_name="nginx.promtail.test"} |= "index"En raison du fonctionnement de Loki, il n'est pas possible de faire des requêtes sans sélecteur, mais les étiquettes peuvent être rendues aussi générales que souhaité.
Le sélecteur est une valeur clé-valeur entre accolades. Il est possible de combiner des sélecteurs et de définir différentes conditions de recherche en utilisant les opérateurs =, != ou les expressions régulières :
{instance=~"kafka-[23]",name!="kafka-dev"}
// Trouvera les logs avec le label instance, ayant pour valeur kafka-2, kafka-3, et exclura dev
Un filtre est un texte ou une expression régulière qui filtrera toutes les données obtenues par le sélecteur.
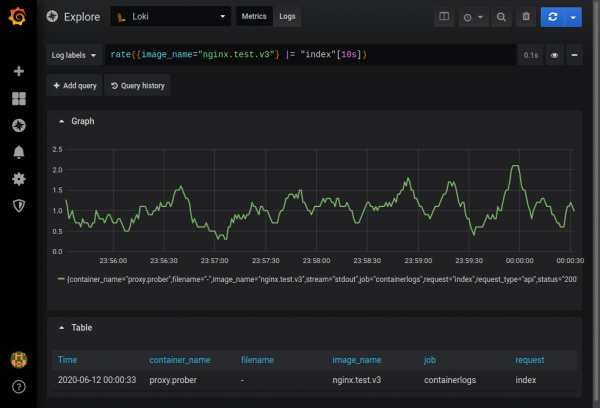
Il est possible d'obtenir des graphiques ad-hoc à partir des données obtenues en mode metrics. Par exemple, vous pouvez connaître la fréquence d'apparition dans les logs nginx d'une entrée contenant la chaîne index:
Une description complète des fonctionnalités est disponible dans la documentation .
Analyse des logs
Il existe plusieurs façons de collecter les logs :
- À l'aide de Promtail, le composant standard de la pile pour la collecte de logs.
- Directement depuis le conteneur Docker à l'aide du
- Utiliser Fluentd ou Fluent Bit, qui peuvent envoyer des données à Loki. Contrairement à Promtail, ils disposent de parseurs prêts à l'emploi pour presque tous les types de logs et gèrent également les logs multilignes.
En général, pour l'analyse, on utilise Promtail. Il effectue trois actions :
- Trouve des sources de données.
- Attache des labels à celles-ci.
- Envoie les données à Loki.
Actuellement, Promtail peut lire les logs à partir de fichiers locaux et du journal systemd. Il doit être installé sur chaque machine à partir de laquelle les logs sont collectés.
Il existe une intégration avec Kubernetes : Promtail apprend automatiquement l'état du cluster via l'API REST Kubernetes et collecte les logs d'un nœud, d'un service ou d'un pod, en étoffant immédiatement les labels à partir des métadonnées provenant de Kubernetes (nom du pod, nom du fichier, etc.).
Des labels peuvent également être ajoutés à partir des données du log à l'aide de Pipeline. Le pipeline de Promtail peut se composer de quatre types d'étapes. Plus de détails dans , je noterai ici certains points particuliers.
- Étapes de transformation. C'est l'étape RegEx et JSON. À ce stade, nous extrayons des données des logs dans ce qu'on appelle une extracted map. On peut extraire à partir de JSON simplement en copiant les champs souhaités dans l'extracted map, ou via des expressions régulières (RegEx), où dans extracted map les groupes nommés sont « mappés ». L'extracted map représente un stockage key-value, où la clé est le nom du champ et la valeur est sa valeur dans les logs.
- Étapes de transformation. Cette étape a deux options : transform, où nous définissons les règles de transformation, et source, qui est la source de données pour la transformation à partir de l'extracted map. Si ce champ n'existe pas dans l'extracted map, il sera créé. Ainsi, il est possible de créer des labels qui ne sont pas basés sur l'extracted map. À ce stade, nous pouvons manipuler les données dans l'extracted map en utilisant un . De plus, il est important de se rappeler que la carte extraite est entièrement chargée lors du parsing, ce qui permet, par exemple, de vérifier la valeur : « {{if .tag}la valeur du tag existe{end}} ». Le modèle supporte les conditions, les boucles et certaines fonctions de chaîne, telles que Replace et Trim.
- Étapes d'action. À ce stade, vous pouvez faire quelque chose avec ce qui a été extrait :
- Créer une étiquette à partir des données extraites, qui sera indexée par Loki.
- Modifier ou définir le temps de l'événement à partir du journal.
- Modifier les données (texte du journal) qui seront envoyées à Loki.
- Créer des métriques.
- Étapes de filtrage. Étape de correspondance, où vous pouvez soit envoyer dans /dev/null les enregistrements dont nous n'avons pas besoin, soit les diriger vers un traitement ultérieur.
Je vais montrer, à l'aide d'un exemple de traitement de journaux nginx ordinaires, comment il est possible de parser des journaux avec Promtail.
Pour le test, prenons comme proxy nginx une image modifiée nginx jwilder/nginx-proxy:alpine et un petit démon capable de se questionner lui-même par HTTP. Le démon a plusieurs points de terminaison, auxquels il peut répondre de tailles différentes, avec différents statuts HTTP et différents délais.
Nous allons collecter les journaux à partir des conteneurs Docker, que l'on peut trouver au chemin /var/lib/docker/containers//-json.log
Dans le fichier docker-compose.yml, nous configurons Promtail et indiquons le chemin vers le fichier de configuration :
promtail:
  image: grafana/promtail:1.4.1
 // ...
 volumes:
   - /var/lib/docker/containers:/var/lib/docker/containers:ro
   - promtail-data:/var/lib/promtail/positions
   - ${PWD}/promtail/docker.yml:/etc/promtail/promtail.yml
 command:
   - '-config.file=/etc/promtail/promtail.yml'
 // ...
Ajoutons dans promtail.yml le chemin vers les journaux (dans la config, il y a une option "docker", qui fait la même chose en une ligne, mais cela ne serait pas aussi clair) :
scrape_configs:
 - job_name: containers

   static_configs:
       labels:
         job: containerlogs
         __path__: /var/lib/docker/containers/*/*log  # pour linux uniquement
En activant cette configuration, les journaux de tous les conteneurs seront envoyés à Loki. Pour éviter cela, nous modifions les paramètres du nginx de test dans docker-compose.yml — ajoutons le champ d'enregistrement tag :
proxy:
 image: nginx.test.v3
//…
 logging:
   driver: "json-file"
   options:
     tag: "{{.ImageName}}|{{.Name}}"
Modifions promtail.yml et configurons le Pipeline. En entrée, les journaux sont de la forme suivante :
{"log":"u001b[0;33;1mnginx.1    | u001b[0mnginx.test 172.28.0.3 - - [13/Juin/2020:23:25:50 +0000] \"GET /api/index HTTP/1.1\" 200 0 \"-\" \"Stub_Bot/0.1\" \"0.096\"n","stream":"stdout","attrs":{"tag":"nginx.promtail.test|proxy.prober"},"time":"2020-06-13T23:25:50.66740443Z"}
{"log":"u001b[0;33;1mnginx.1    | u001b[0mnginx.test 172.28.0.3 - - [13/Juin/2020:23:25:50 +0000] \"GET /200 HTTP/1.1\" 200 0 \"-\" \"Stub_Bot/0.1\" \"0.000\"n","stream":"stdout","attrs":{"tag":"nginx.promtail.test|proxy.prober"},"time":"2020-06-13T23:25:50.702925272Z"}
Étape du pipeline :
 - json:
     expressions:
       stream: stream
       attrs: attrs
       tag: attrs.tag
Nous extrayons les champs stream, attrs, attrs.tag (s'ils existent) du JSON d'entrée et les plaçons dans la carte extraite.
 - regex:
     expression: ^(?P([^|]+))|(?P([^|]+))$
     source: "tag"
Si le champ tag a pu être placé dans la carte extraite, nous extrayons les noms de l'image et du conteneur à l'aide d'une expression régulière.
 - labels:
     image_name:
     container_name:
Nous attribuons des étiquettes. Si les clés image_name et container_name sont trouvées dans les données extraites, leurs valeurs seront assignées aux étiquettes correspondantes.
 - match:
     selector: '{job="docker",container_name="",image_name=""}'
     action: drop
Nous ignorons tous les journaux pour lesquels les étiquettes image_name et container_name ne sont pas détectées.
  - match:
     selector: '{image_name="nginx.promtail.test"}'
     stages:
       - json:
           expressions:
             row: log
Pour tous les journaux où image_name est égal à nginx.promtail.test, nous extrayons le champ log de l'enregistrement source et le plaçons dans la carte extraite avec la clé row.
  - regex:
         # supprimer les couleurs forego
         expression: .+nginx.+|.+[0m(?P[a-z_.-]+) +(?P.+)
         source: logrow
Nous nettoyons la chaîne d'entrée à l'aide d'expressions régulières et extrayons l'hôte virtuel nginx et la ligne de journal nginx.
     - regex:
         source: nginxlog
         expression: ^(?P[w.]+) - (?P[^ ]*) [(?P[^ ]+).*] "(?P[^ ]*) (?P[^ ]*) (?P[^ ]*)" (?P[d]+) (?P[d]+) "(?P[^"]*)" "(?P[^"]*)"( "(?P[d.]+)")?
Nous analysons le journal nginx à l'aide d'expressions régulières.
    - regex:
           source: request_url
           expression: ^.+.(?Pjpg|jpeg|gif|png|ico|css|zip|tgz|gz|rar|bz2|pdf|txt|tar|wav|bmp|rtf|js|flv|swf|html|htm)$
     - regex:
           source: request_url
           expression: ^/photo/(?P[^/?.]+).*$
       - regex:
           source: request_url
           expression: ^/api/(?P[^/?.]+).*$
Nous analysons request_url. À l'aide d'expressions régulières, nous déterminons la destination de la demande : statique, photos, API et plaçons la clé correspondante dans la carte extraite.
       - template:
           source: request_type
           template: "{{if .photo}}photo{{else if .static_type}}static{{else if .api_request}}api{{else}}other{{end}}"
À l'aide d'opérateurs conditionnels dans le modèle, nous vérifions les champs définis dans la carte extraite et attribuons aux champs request_type les valeurs nécessaires : photo, static, API. Nous attribuons other si cela échoue. Désormais, request_type contient le type de demande.
       - labels:
           api_request:
           virtual_host:
           request_type:
           status:
Nous définissons les étiquettes api_request, virtual_host, request_type et le statut (statut HTTP) en fonction de ce qui a été placé dans la carte extraite.
       - output:
           source: nginx_log_row
Nous changeons la sortie. Maintenant, le journal nginx nettoyé provenant de la carte extraite va à Loki.
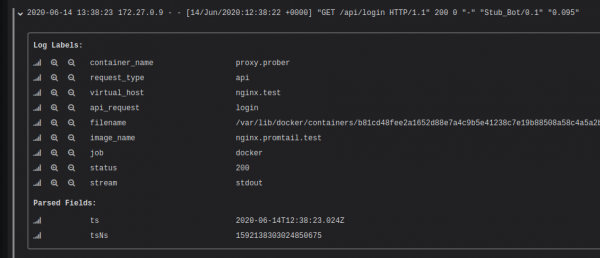
Après le lancement de la configuration fournie, il est possible de voir que chaque entrée a reçu des étiquettes basées sur les données du journal.
Il faut garder à l'esprit que l'extraction d'étiquettes avec un grand nombre de valeurs (cardinalité) peut considérablement ralentir le fonctionnement de Loki. Il n'est donc pas conseillé de mettre, par exemple, user_id dans l'index. Pour plus de détails, consultez l'article “”. Cependant, cela ne signifie pas qu'il est impossible de rechercher par user_id sans index. Il faut utiliser des filtres lors de la recherche (pour « greper » les données), et l'index sert ici d'identifiant de flux.
Visualisation des logs
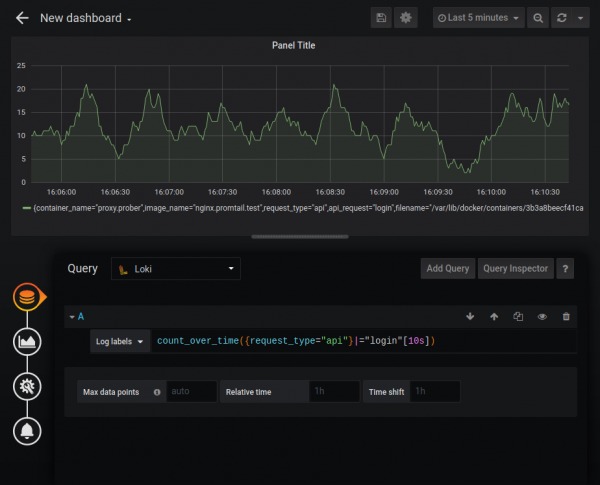
Loki peut servir de source de données pour les graphiques Grafana, en utilisant LogQL. Les fonctions suivantes sont supportées :
- rate — nombre d'enregistrements par seconde ;
- count over time — nombre d'enregistrements dans une plage donnée.
On trouve également des fonctions d'agrégation comme Sum, Avg et d'autres. Il est possible de construire des graphiques assez complexes, par exemple un graphique du nombre d'erreurs HTTP :
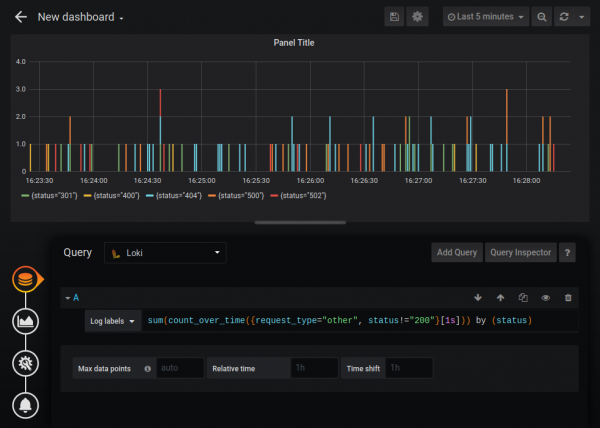
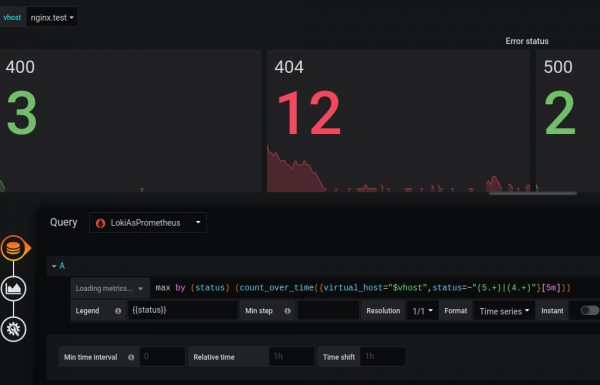
La source de données standard Loki est quelque peu limitée en termes de fonctionnalités par rapport à la source de données Prometheus (par exemple, on ne peut pas changer la légende), mais Loki peut être connecté comme source de type Prometheus. Je ne suis pas sûr que ce soit un comportement documenté, mais selon la réponse des développeurs “”, par exemple, c'est tout à fait légal, et Loki est entièrement compatible avec PromQL.
Ajoutons Loki comme source de données de type Prometheus et ajoutons l'URL /loki :

Et on peut réaliser des graphiques comme si nous travaillions avec des métriques de Prometheus :
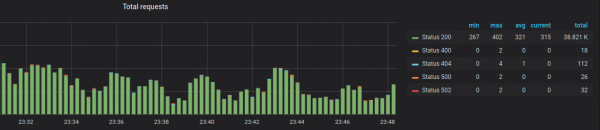
Je pense que l'écart de fonctionnalité est temporaire et que les développeurs le corrigeront dans le futur.
Métriques
Dans Loki, il est possible d'extraire des métriques numériques des logs et de les envoyer à Prometheus. Par exemple, dans le log nginx, il y a le nombre de bytes pour la réponse, ainsi que, avec une certaine modification du format de log standard, le temps en secondes qu'il a fallu pour répondre. Ces données peuvent être extraites et envoyées à Prometheus.
Ajoutons une autre section dans promtail.yml :
- match:
   selector: '{request_type="api"}'
   stages:
     - metrics:
         http_nginx_response_time:
           type: Histogram
           description: "temps de réponse ms"
           source: response_time
           config:
             buckets: [0.010,0.050,0.100,0.200,0.500,1.0]
- match:
   selector: '{request_type=~"static|photo"}'
   stages:
     - metrics:
         http_nginx_response_bytes_sum:
           type: Counter
           description: "somme des bytes de réponse"
           source: bytes_out
           config:
             action: add
         http_nginx_response_bytes_count:
           type: Counter
           description: "nombre de bytes de réponse"
           source: bytes_out
           config:
             action: inc
Cette option permet de définir et de mettre à jour des métriques sur la base des données extraites de la carte. Ces métriques ne sont pas envoyées à Loki — elles apparaissent à l'endpoint Promtail /metrics. Prometheus doit être configuré pour recevoir les données générées à ce stade. Dans l'exemple donné pour request_type=“api”, nous collectons une métrique histogramme. Avec ce type de métriques, il est facile d'obtenir des percentiles. Pour les statistiques et les photos, nous rassemblons le total des octets et le nombre de lignes où nous avons reçu des octets, afin de calculer la valeur moyenne.
Pour en savoir plus sur les métriques, lisez .
Ouvrons le port sur Promtail :
promtail:
     image: grafana/promtail:1.4.1
     container_name: monitoring.promtail
     expose:
       - 9080
     ports:
       - "9080:9080"
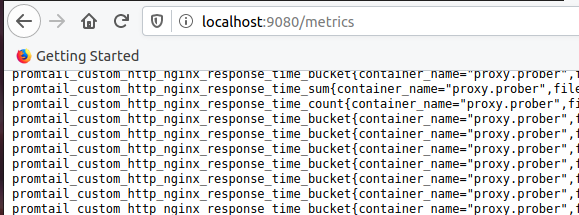
Nous nous assurons que les métriques avec le préfixe promtail_custom sont apparues :
Configurons Prometheus. Ajoutons le job promtail :
- job_name: 'promtail'
 scrape_interval: 10s
 static_configs:
   - targets: ['promtail:9080']
Et nous traçons le graphique :
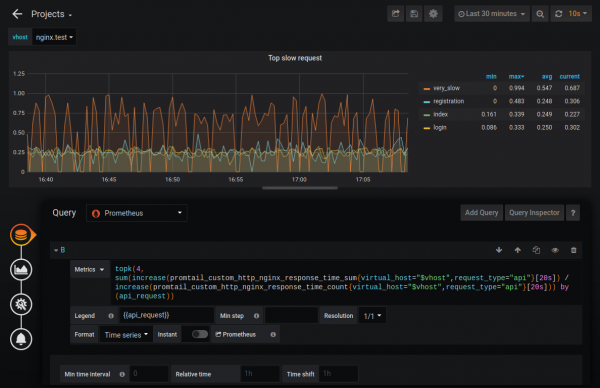
De cette manière, nous pouvons par exemple identifier les quatre requêtes les plus lentes. De plus, nous pouvons configurer la surveillance sur ces données métriques.
Mise à l’échelle
Loki peut fonctionner en mode autonome (single binary mode) ou en mode shardé (horizontally-scalable mode). Dans le deuxième cas, il peut stocker des données dans le cloud, avec les chunks et l'index stockés séparément. Dans la version 1.5, une possibilité de stockage en un seul endroit a été réalisée, mais il n'est pas recommandé de l'utiliser en production pour le moment.
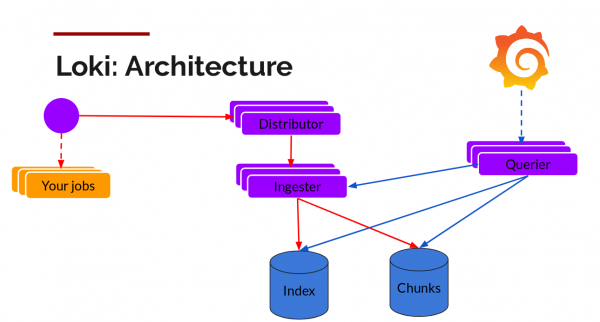
Les chunks peuvent être stockés dans un stockage compatible S3, tandis que les index doivent utiliser des bases de données horizontalement évolutives : Cassandra, BigTable ou DynamoDB. Les autres parties de Loki — Distributors (pour l'écriture) et Querier (pour les requêtes) — sont sans état et peuvent également être mises à l'échelle horizontalement.
Lors de la conférence DevOpsDays Vancouver 2019, un des participants, Callum Styan, a déclaré qu'avec Loki, son projet dispose de pétabytes de logs avec un index de moins de 1 % de la taille totale : “”.
Comparaison entre Loki et ELK
Taille de l'index
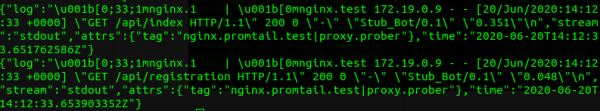
Pour tester la taille de l'index obtenue, j'ai pris les logs d'un conteneur nginx, pour lequel le Pipeline ci-dessus a été configuré. Le fichier de logs contenait 406 624 lignes pour un volume total de 109 Mo. Les logs ont été générés pendant une heure, à environ 100 enregistrements par seconde.
Exemple de deux lignes dans le log :
Lors de l'indexation ELK, cela a donné une taille d'index de 30,3 Mo :
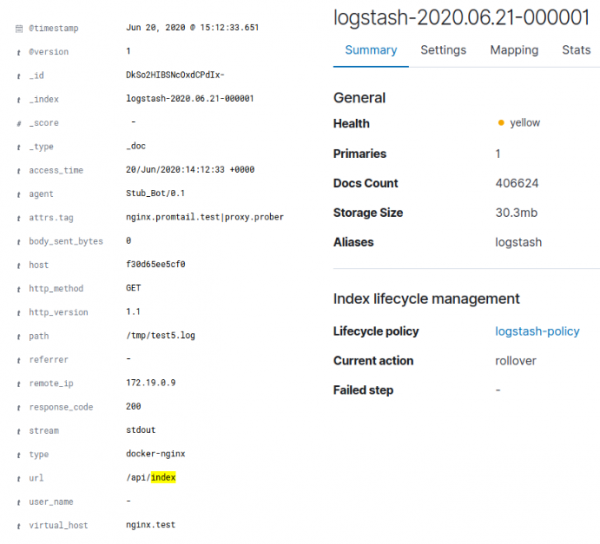
Dans le cas de Loki, cela a donné environ 128 Ko d'index et environ 3,8 Mo de données dans les chunks. Il convient de noter que le journal a été généré artificiellement et ne présentait pas une grande diversité de données. Une simple compression gzip du journal JSON d'origine de Docker donnait un taux de compression de 95,4 %, et étant donné que seul le journal nginx nettoyé était envoyé à Loki, une compression à 4 Mo est compréhensible. Le nombre total de valeurs uniques pour les labels de Loki était de 35, ce qui explique la petite taille de l'index. Pour ELK, le journal était également nettoyé. Ainsi, Loki a compressé les données d'origine de 96 %, tandis qu'ELK l'a fait de 70 %.
Consommation de mémoire
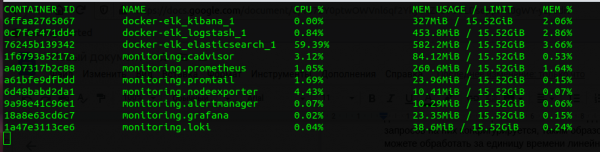
Si l'on compare l'ensemble de la pile Prometheus et ELK, Loki consomme plusieurs fois moins. Il est évident qu'un service en Go consomme moins qu'un service en Java, et la comparaison de la taille du tas JVM d'Elasticsearch et de la mémoire dédiée à Loki n'est pas tout à fait correcte, mais il convient de noter que Loki utilise beaucoup moins de mémoire. Son avantage au niveau CPU n'est pas aussi évident, mais il est également présent.
Vitesse
Loki « engloutit » les journaux plus rapidement. La vitesse dépend de nombreux facteurs : le type de journaux, la manière dont nous les analysons, le réseau, le disque, etc. — mais elle est sans conteste supérieure à celle d'ELK (dans mon test, environ deux fois plus rapide). Cela s'explique par le fait que Loki enregistre beaucoup moins de données dans l'index et, par conséquent, passe moins de temps à indexer. En revanche, la situation est inverse pour la vitesse de recherche : Loki ralentit sensiblement avec des données de plus de quelques gigaoctets, tandis qu'ELK ne voit pas sa vitesse de recherche affectée par la taille des données.
Recherche dans les logs
Loki est nettement inférieur à ELK en termes de capacités de recherche dans les journaux. Grep avec des expressions régulières est puissant, mais il ne rivalise pas avec une base de données mature. L'absence de requêtes de plage, l'agrégation uniquement par labels, l'impossibilité de rechercher sans labels — tout cela nous limite dans la recherche d'informations d'intérêt dans Loki. Cela ne veut pas dire qu'il est impossible de trouver quoi que ce soit avec Loki, mais cela détermine le flux de travail avec les journaux, où vous identifiez d'abord un problème sur les graphiques de Prometheus, puis vous recherchez ce qui s'est passé dans les journaux à l'aide de ces labels.
Interface
Tout d'abord, c'est joli (désolé, je n'ai pas pu m'en empêcher). Grafana a une interface agréable à regarder, mais Kibana est beaucoup plus fonctionnelle.
Avantages et inconvénients de Loki
Parmi les avantages, on peut noter que Loki s'intègre avec Prometheus, ce qui signifie que les métriques et les alertes sont disponibles immédiatement. Il est pratique pour collecter et stocker des journaux avec des pods Kubernetes, car il hérite de la découverte de services de Prometheus et ajoute automatiquement des labels.
Parmi les inconvénients, il y a la documentation peu fournie. Certaines informations, comme les caractéristiques et les fonctionnalités de Promtail, je les ai découvertes seulement en étudiant le code, heureusement disponible en open-source. Un autre inconvénient est la faible capacité de parsing. Par exemple, Loki ne peut pas parser les journaux multilignes. On peut également considérer comme un défaut que Loki est une technologie relativement jeune (la version 1.0 est sortie en novembre 2019).
Conclusion
Loki est une technologie 100 % intéressante, adaptée aux petits et moyens projets, permettant de résoudre de nombreuses tâches d'agrégation de journaux, de recherche dans les journaux, de surveillance et d'analyse des journaux.
Nous n'utilisons pas Loki chez Badoo, car nous avons un stack ELK qui nous satisfait et qui, au fil des années, a accumulé diverses solutions personnalisées. Pour nous, le principal obstacle est la recherche dans les journaux. Avec presque 100 Go de journaux par jour, il est essentiel pour nous de pouvoir tout trouver, et un peu plus, rapidement. Pour la création de graphiques et la surveillance, nous utilisons d'autres solutions adaptées à nos besoins et intégrées entre elles. Le stack Loki a des avantages notables, mais il ne nous apportera pas plus que ce que nous avons, et ses avantages ne compenseront pas le coût de la migration.
Et bien qu'après étude il soit clair que nous ne pouvons pas utiliser Loki, nous espérons que cet article vous aidera dans votre choix.
Le dépôt avec le code utilisé dans l'article se trouve .
Source : habr.com
