

VictoriaMetrics, TimescaleDB et InfluxDB ont été comparés dans sur un ensemble de données contenant un milliard de points de données, appartenant à 40K séries temporelles uniques.
Il y a quelques années, l'ère de Zabbix a commencé. Chaque serveur bare metal avait au maximum quelques indicateurs - utilisation du processeur, utilisation de la mémoire, utilisation du disque et utilisation du réseau. Ainsi, les métriques de milliers de serveurs pouvaient tenir dans 40 000 séries temporelles uniques, et Zabbix pouvait utiliser MySQL comme backend pour les données de séries temporelles 🙂
Aujourd'hui, un avec des configurations par défaut fournit plus de 500 métriques sur un hôte moyen. Il existe de nombreux pour différentes bases de données, serveurs web, systèmes matériels, etc. Tous fournissent de nombreux indicateurs utiles. De plus en plus d'applications Quelle est la grande quantité de séries temporelles uniques actuellement ? Peut-être 400K ou 4M ? Ou 40M ? Comparons les TSDB modernes avec ces chiffres.
Installer le benchmark
TSBS
-scale -scale-var ). 10 est le nombre de dimensions (métriques) générées sur chaque hôte, serveur. Les ensembles de données suivants ont été créés avec TSBS pour le benchmark :400K série temporelle unique, 60 secondes d'intervalle entre les points de données, les données couvrent 3 jours complets, ~1.7B au total de points de données.
- 4M série temporelle unique, intervalle de 600 secondes, les données couvrent 3 jours complets, ~1.7B au total de points de données.
- 40M série temporelle unique, intervalle de 1 heure, les données couvrent 3 jours complets, ~2.8B au total de points de données.
- 40M série temporelle unique, intervalle de 1 heure, les données couvrent 3 jours complets, ~2,8 B points de données au total.
Le client et le serveur ont été lancés sur des instances dédiées dans le cloud Google. Ces instances avaient les configurations suivantes :
- vCPUs : 16
- RAM : 60 Go
- Stockage : disque dur standard de 1 To. Il fournit une bande passante de lecture/écriture de 120 Mbps, 750 opérations de lecture par seconde et 1,5K opérations d'écriture par seconde.
Les TSDBs ont été extraits d'images docker officielles et lancés dans docker avec les configurations suivantes :
VictoriaMetrics :
docker run -it --rm -v /mnt/disks/storage/vmetrics-data:/victoria-metrics-data -p 8080:8080 valyala/victoria-metricsLes valeurs InfluxDB (-e sont nécessaires pour supporter une haute capacité. Pour plus de détails, voir la ):
docker run -it --rm -p 8086:8086
-e INFLUXDB_DATA_MAX_VALUES_PER_TAG=4000000
-e INFLUXDB_DATA_CACHE_MAX_MEMORY_SIZE=100g
-e INFLUXDB_DATA_MAX_SERIES_PER_DATABASE=0
-v /mnt/disks/storage/influx-data:/var/lib/influxdb influxdb
TimescaleDB (la configuration a été prise de MEM=`free -m | grep "Mem" | awk ‘{print $7}’` let "SHARED=$MEM/4" let "CACHE=2*$MEM/3" let "WORK=($MEM-$SHARED)/30" let "MAINT=$MEM/16" let "WAL=$MEM/16" docker run -it — rm -p 5432:5432 --shm-size=${SHARED}MB -v /mnt/disks/storage/timescaledb-data:/var/lib/postgresql/data timescale/timescaledb:latest-pg10 postgres -cmax_wal_size=${WAL}MB -clog_line_prefix="%m [%p]: [%x] %u@%d" -clogging_collector=off -csynchronous_commit=off -cshared_buffers=${SHARED}MB -ceffective_cache_size=${CACHE}MB -cwork_mem=${WORK}MB -cmaintenance_work_mem=${MAINT}MB -cmax_files_per_process=100
Le chargeur de données a été lancé avec 16 threads en parallèle.Cet article contient uniquement les résultats pour les indicateurs de performance d'insertion. Les résultats du benchmark d'échantillonnage seront publiés dans un article séparé.
400K séries temporelles uniques
Commençons par des éléments simples — 400K. Résultats du benchmark :
VictoriaMetrics : 2,6M points de données par seconde ; utilisation de la mémoire : 3 Go ; taille finale des données sur disque : 965 Mo
- InfluxDB : 1.2M points de données par seconde ; utilisation de la mémoire : 8.5 Go ; taille finale des données sur disque : 1.6 Go
- Timescale : 849K points de données par seconde ; utilisation de la mémoire : 2,5 Go ; taille finale des données sur disque : 50 Go
- Comme vous pouvez le constater dans les résultats ci-dessus, VictoriaMetrics est en tête en termes de performance d'insertion et de taux de compression. Timescale est meilleur en utilisation de la mémoire, mais elle utilise beaucoup d'espace disque — 29 octets par point de données.
Ci-dessous se trouvent des graphiques d'utilisation du processeur (CPU) pour chacun des TSDBs pendant le benchmark :
En haut, capture d'écran : VictoriaMetrics — Charge CPU lors du test d'insertion pour la métrique unique 400K.
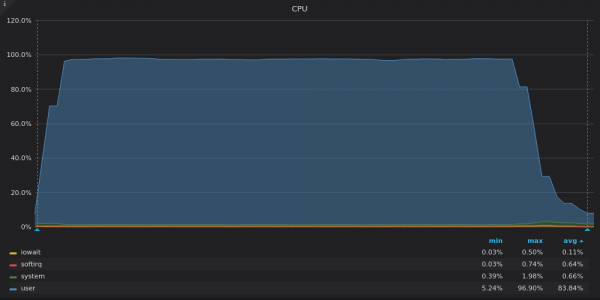
Vous trouverez ci-dessus une capture d'écran : VictoriaMetrics — Utilisation CPU lors du test d'insertion pour une métrique unique de 400K.
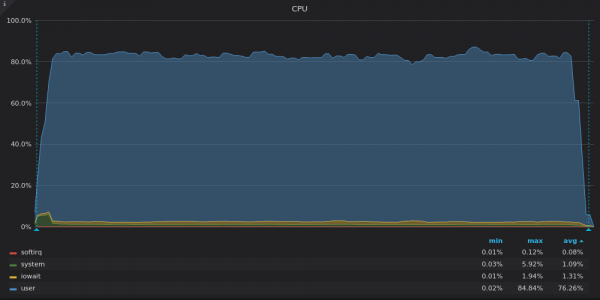
Capture d'écran ci-dessus : InfluxDB — Charge CPU lors du test d'insertion pour une métrique unique de 400K.
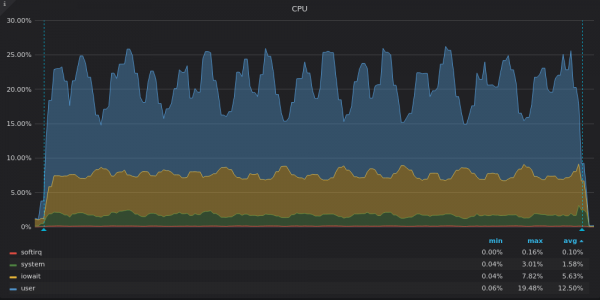
Capture d'écran ci-dessus : TimescaleDB — Charge CPU lors du test d'insertion pour une métrique unique de 400K.
VictoriaMetrics utilise tous les vCPUs disponibles, tandis qu'InfluxDB n'exploite pas suffisamment ~2 sur 16 vCPUs.
Timescale n'utilise que 3 à 4 sur 16 vCPUs. De fortes parts de iowait et system sur le graphique TimescaleDB indiquent un goulet d'étranglement dans la sous-système d'entrée-sortie (I/O). Regardons les graphiques d'utilisation de la bande passante du disque :
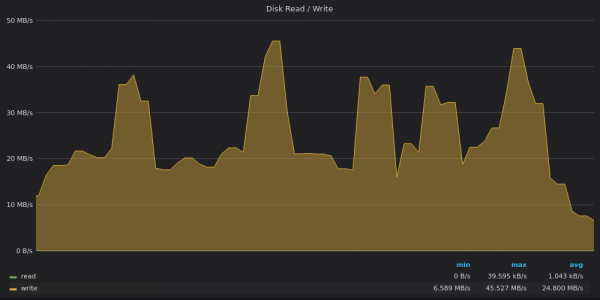
Capture d'écran ci-dessus : VictoriaMetrics — Utilisation de la bande passante du disque lors du test d'insertion pour des indicateurs uniques de 400K.
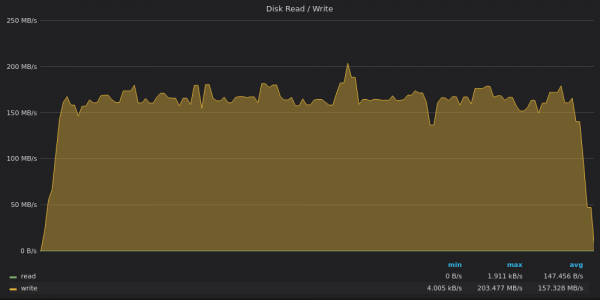
Capture d'écran ci-dessus : InfluxDB — Utilisation de la bande passante du disque lors du test d'insertion pour des indicateurs uniques de 400K.
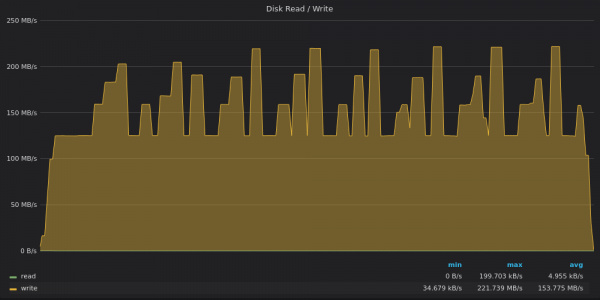
Capture d'écran ci-dessus : TimescaleDB — Utilisation de la bande passante du disque lors du test d'insertion pour des indicateurs uniques de 400K.
VictoriaMetrics écrit des données à une vitesse de 20 Mbit/s avec des pics allant jusqu'à 45 Mbit/s. Les pics correspondent à de grandes fusions partielles dans l'arbre .
InfluxDB écrit des données à une vitesse de 160 Mo/s, alors qu'un disque de 1 To à une bande passante d'écriture de 120 Mo/s.
TimescaleDB est limitée à une bande passante d'écriture de 120 Mbit/s, mais parfois elle dépasse cette limite et atteint 220 Mbit/s lors de pics. Ces pics correspondent à des baisses d'utilisation du processeur sur le graphique précédent.
Regardons les graphiques d'utilisation de l'entrée-sortie (I/O) :
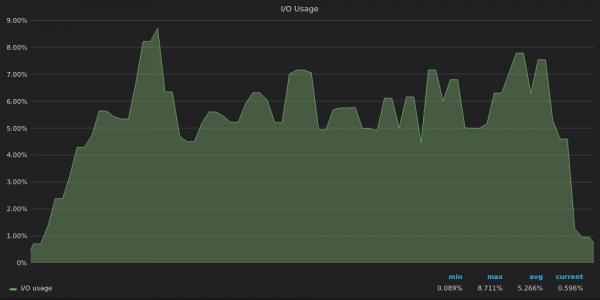
Capture d'écran ci-dessus : VictoriaMetrics — Utilisation de l'entrée-sortie lors du test d'insertion pour 400K métriques uniques.
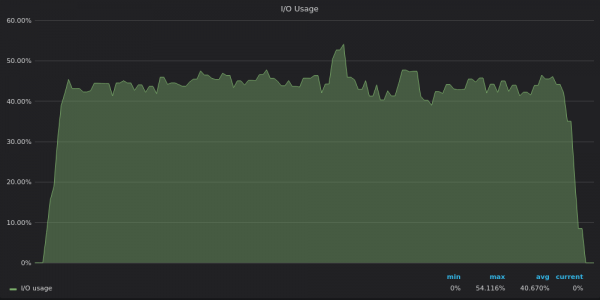
Capture d'écran ci-dessus : InfluxDB — Utilisation de l'entrée-sortie lors du test d'insertion pour 400K métriques uniques.
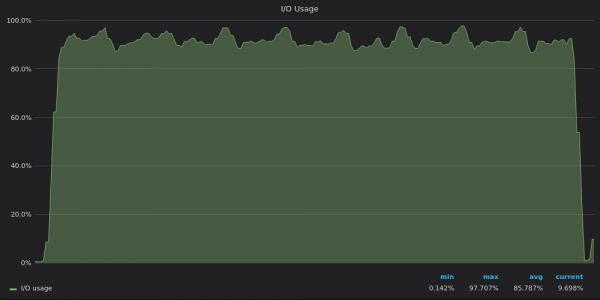
Capture d'écran ci-dessus : TimescaleDB — Utilisation de l'entrée-sortie lors du test d'insertion pour 400K métriques uniques.
Il est maintenant clair que TimescaleDB atteint la limite d'entrée-sortie, donc elle ne peut pas utiliser les 12 vCPUs restants.
4M séries temporelles uniques
4M séries temporelles peuvent sembler un peu provocantes. Mais nos concurrents réussissent cet examen. Résultats du benchmark :
- VictoriaMetrics : 2,2M points de données par seconde ; utilisation de la mémoire vive : 6 Go ; taille finale des données sur disque : 3 Go.
- InfluxDB : 330K points de données par seconde ; utilisation de la mémoire vive : 20,5 Go ; taille finale des données sur disque : 18,4 Go.
- TimescaleDB : 480K points de données par seconde ; utilisation de la mémoire vive : 2,5 Go ; taille finale des données sur le disque : 52 Go.
Les performances d'InfluxDB ont chuté de 1,2 million de points de données par seconde pour 400K séries temporelles à 330 000 points de données par seconde pour 4M séries temporelles. C'est une perte de performance significative par rapport à d'autres concurrents. Examinons les graphiques d'utilisation du processeur pour comprendre la cause de cette perte :
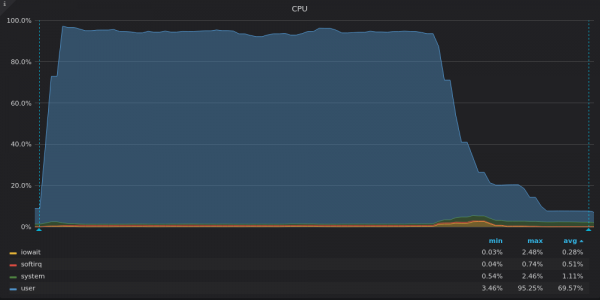
Capture d'écran ci-dessus : VictoriaMetrics - Utilisation du CPU lors du test d'insertion pour une série temporelle unique de 4M.
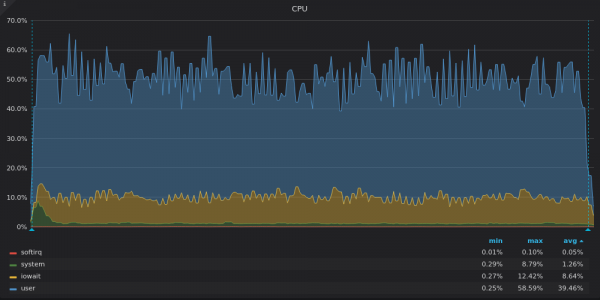
Capture d'écran ci-dessus : InfluxDB - Utilisation du CPU lors du test d'insertion pour une série temporelle unique de 4M.
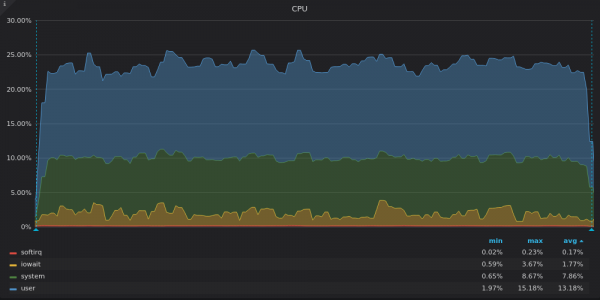
Capture d'écran ci-dessus : TimescaleDB - Utilisation du CPU lors du test d'insertion pour une série temporelle unique de 4M.
VictoriaMetrics utilise presque toute la puissance du processeur (CPU). La baisse à la fin correspond aux fusions LSM restantes après l'insertion de toutes les données.
InfluxDB utilise seulement 8 des 16 vCPUs, tandis que TimescaleDB utilise 4 des 16 vCPUs. Quel est le point commun de leurs graphiques ? Une forte part de iowait, ce qui, encore une fois, indique un goulot d'étranglement en entrée/sortie.
TimescaleDB a une part élevée de system. Nous supposons que cette haute capacité a entraîné de nombreux appels système ou de nombreux .
Jetons un œil aux graphiques de bande passante disque :
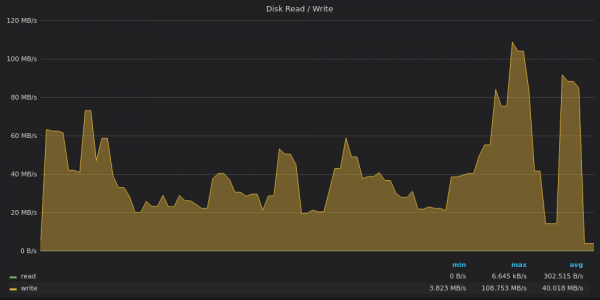
Capture d'écran ci-dessus : VictoriaMetrics - Utilisation de la bande passante disque pour l'insertion de 4M métriques uniques.
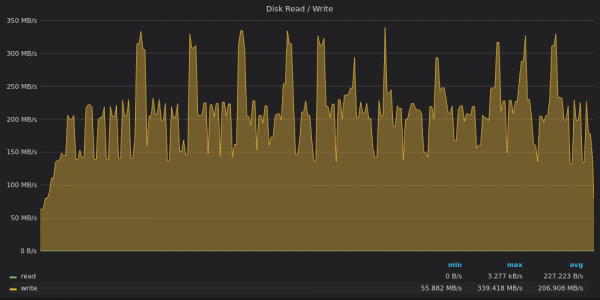
Capture d'écran ci-dessus : InfluxDB - Utilisation de la bande passante disque pour l'insertion de 4M métriques uniques.
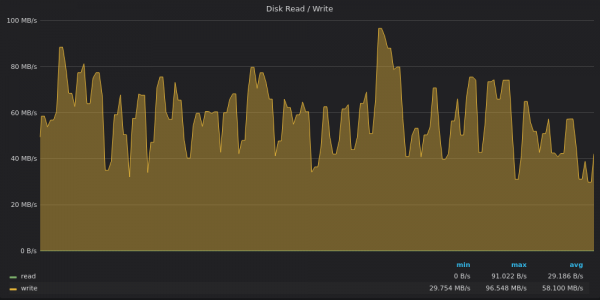
Capture d'écran ci-dessus : TimescaleDB - Utilisation de la bande passante disque pour l'insertion de 4M métriques uniques.
VictoriaMetrics a atteint une limite de 120 Mo/s lors des pics, tandis que la vitesse d'écriture moyenne était de 40 Mo/s. Pendant le pic, plusieurs lourdes fusions LSM ont probablement été effectuées.
InfluxDB atteint de nouveau un débit d'écriture moyen de 200 Mo/s avec des pics allant jusqu'à 340 Mo/s sur un disque limité à 120 Mo/s 🙂
TimescaleDB n'est plus limité par le disque. Il semble qu'il soit limité par autre chose en rapport avec une forte part de system la charge CPU.
Jetons un œil aux graphiques d'utilisation IO :
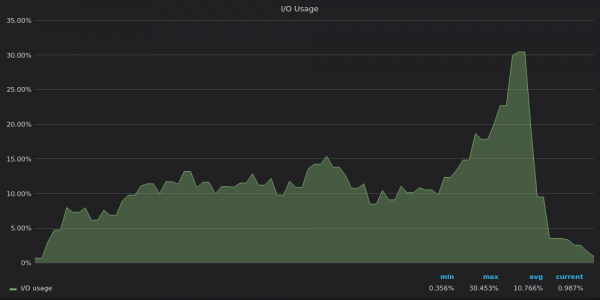
Capture d'écran ci-dessus : VictoriaMetrics - Utilisation d'entrée/sortie lors du test d'insertion pour une série temporelle unique de 4M.
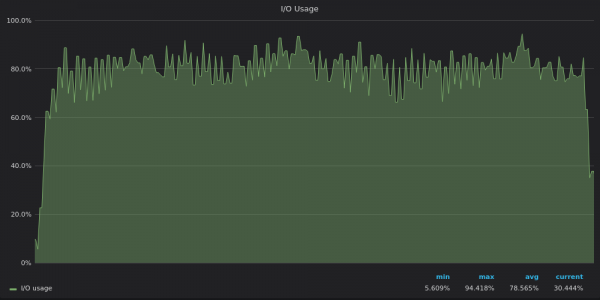
Capture d'écran ci-dessus : InfluxDB - Utilisation d'entrée/sortie lors du test d'insertion pour une série temporelle unique de 4M.
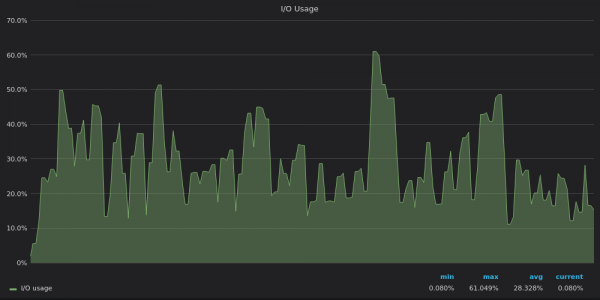
Capture d'écran ci-dessus : TimescaleDB — Utilisation des entrées-sorties pendant le test d'insertion pour une série temporelle unique de 4M.
Les graphiques d'utilisation des E/S reproduisent les graphiques d'utilisation de la bande passante du disque — InfluxDB est limité en E/S, tandis que VictoriaMetrics et TimescaleDB disposent de ressources d'E/S supplémentaires.
40M séries temporelles uniques
40M séries temporelles uniques étaient trop grandes pour InfluxDB 🙁
Résultats du benchmark :
- VictoriaMetrics : 1,7M points de données par seconde ; utilisation de la mémoire vive : 29 Go ; utilisation de l'espace disque : 17 Go.
- InfluxDB : non terminé car cela nécessitait plus de 60 Go de mémoire vive.
- TimescaleDB : 330K points de données par seconde, utilisation de la mémoire vive : 2,5 Go ; utilisation de l'espace disque : 84 Go.
TimescaleDB montre une utilisation de la mémoire vive exceptionnellement basse et stable – 2,5 Go — autant que pour 4M de métriques uniques et 400K.
VictoriaMetrics a lentement augmenté à 100 000 points de données par seconde, jusqu'à ce que tous les 40M de noms de métriques avec labels soient traités. Il a ensuite atteint une vitesse d'insertion stable de 1,5 à 2,0M points de données par seconde, donc le résultat final était de 1,7M points de données par seconde.
Les graphiques pour 40M séries temporelles uniques sont similaires aux graphiques pour 4M séries temporelles uniques, donc nous allons les ignorer.
Conclusions
- Les TSDB modernes sont capables de traiter des insertions pour des millions de séries temporelles uniques sur un seul serveur. Dans le prochain article, nous examinerons à quel point les TSDBs exécutent des requêtes sur des millions de séries temporelles uniques.
- Une utilisation insuffisante du processeur indique généralement un goulot d'étranglement des E/S. De plus, cela peut indiquer un verrouillage trop grossier, où seulement quelques threads peuvent fonctionner simultanément.
- Un goulot d'étranglement des E/S existe réellement, surtout dans les stockages sans SSD, tels que les dispositifs de bloc virtualisés des fournisseurs de cloud.
- VictoriaMetrics fournit la meilleure optimisation pour les stockages lents avec un faible niveau d'E/S. Il offre la meilleure vitesse et le meilleur taux de compression.
Téléchargez et testez-la avec vos données. Le fichier binaire statique correspondant est disponible sur .
Pour en savoir plus sur VictoriaMetrics, consultez cet .
Mise à jour : publiée avec des résultats reproductibles.
Mise à jour #2 : Lisez aussi .
Mise à jour #3 : !
Chat Telegram :
Source : habr.com
