

La traduction de l'article a été préparée en prévision du lancement du cours .
Comment économiser sur les coûts cloud lors de l'utilisation de Kubernetes ? Il n'existe pas de solution unique, mais cet article décrit plusieurs outils qui vous aideront à gérer vos ressources plus efficacement et à réduire vos dépenses en informatique cloud.
J'ai rédigé cet article en me basant sur Kubernetes pour AWS, mais il sera applicable (presque) de la même manière pour d'autres fournisseurs de cloud. Je suppose que votre(s) cluster(s) a déjà un auto-scaling configuré (). La suppression de ressources et la réduction de l'échelle du déploiement ne permettront d'économiser que si cela réduit également votre parc de nœuds de travail (instances EC2).
Cet article abordera :
- nettoyage des ressources inutilisées ()
- réduction de l'échelle en dehors des heures de travail ()
- utilisation de l'auto-scaling horizontal (HPA),
- réduction de la surallocation des ressources (, VPA)
- utilisation des instances Spot
Nettoyage des ressources inutilisées
Travailler dans un environnement en constante évolution est formidable. Nous souhaitons que les organisations techniques . Une livraison de logiciels plus rapide signifie également un plus grand nombre de déploiements de PR, d'environnements de prévisualisation, de prototypes et de solutions analytiques. Tout est déployé sur Kubernetes. Qui a le temps de nettoyer les déploiements de test manuellement ? Il est facile d'oublier de supprimer une expérience vieille d'une semaine. La facture cloud finira par augmenter à cause de ce que nous avons oublié de fermer :
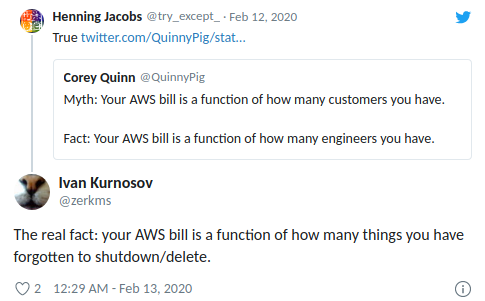
(Henning Jacobs :
Vérité :
(citant) Corey Quinn :
Mythe : Votre facture AWS dépend du nombre de vos utilisateurs.
Fait : Votre facture AWS dépend du nombre de vos ingénieurs.
Ivan Kournosov (en réponse) :
Véritable fait : Votre facture AWS dépend du nombre de choses que vous avez oublié d'éteindre/supprimer.)
(kube-janitor) aide à nettoyer votre cluster. La configuration du janitor est flexible à la fois pour une utilisation globale et locale :
- Des règles générales pour l'ensemble du cluster peuvent définir la durée de vie maximale (TTL - time-to-live) pour les déploiements de PR/test.
- Des ressources individuelles peuvent être annotées à l'aide de janitor/ttl, par exemple pour supprimer automatiquement le spike/prototype après 7 jours.
Les règles générales sont définies dans un fichier YAML. Son chemin est passé via le paramètre --rules-file dans kube-janitor. Voici un exemple de règle pour supprimer tous les espaces de noms contenant -pr- dans le nom après deux jours :
- id: cleanup-resources-from-pull-requests
  resources:
    - namespaces
  jmespath: "contains(metadata.name, '-pr-')"
  ttl: 2d
L'exemple suivant réglemente l'utilisation de l'étiquette application sur les pods Deployment et StatefulSet pour tous les nouveaux Deployments/StatefulSet en 2020, mais en même temps permet des tests sans cette étiquette pendant une semaine :
- id: require-application-label
  # supprimer les deployments et statefulsets sans l'étiquette "application"
  resources:
    - deployments
    - statefulsets
  # voir http://jmespath.org/specification.html
  jmespath: "!(spec.template.metadata.labels.application) && metadata.creationTimestamp > '2020-01-01'"
  ttl: 7d
Exécution d'une démo limitée dans le temps pendant 30 minutes dans un cluster où kube-janitor est en cours d'exécution :
kubectl run nginx-demo --image=nginx
kubectl annotate deploy nginx-demo janitor/ttl=30m
Une autre source de coûts croissants est les volumes permanents (AWS EBS). Lorsque StatefulSet de Kubernetes est supprimé, ses volumes permanents (PVC — PersistentVolumeClaim) ne sont pas supprimés. Les volumes EBS non utilisés peuvent facilement entraîner des coûts allant jusqu'à des centaines de dollars par mois. Kubernetes Janitor a une fonction pour nettoyer les PVC non utilisés. Par exemple, cette règle supprimera tous les PVC qui ne sont pas montés par un module et qui ne sont pas référencés par StatefulSet ou CronJob :
# удалить все PVC, которые не смонтированы и на которые не ссылаются StatefulSets
- id: remove-unused-pvcs
  resources:
  - persistentvolumeclaims
  jmespath: "_context.pvc_is_not_mounted && _context.pvc_is_not_referenced"
  ttl: 24h
Kubernetes Janitor peut vous aider à garder votre cluster « propre » et à éviter l'accumulation lente de coûts en cloud. Pour des instructions sur le déploiement et la configuration, suivez dans .
Réduction de la taille pendant les périodes non travaillées
Les systèmes de test et intermédiaires sont généralement nécessaires uniquement pendant les heures de travail. Certaines applications en production, telles que les outils de back-office / d'administration, nécessitent également une disponibilité limitée et peuvent être arrêtées la nuit.
(kube-downscaler) permet aux utilisateurs et aux opérateurs de réduire l'échelle du système en dehors des heures de travail. Les Deployments et StatefulSets peuvent être réduits à zéro répliques. Les CronJobs peuvent être suspendus. Kubernetes Downscaler est configuré pour l'ensemble du cluster, un ou plusieurs espaces de noms ou des ressources individuelles. On peut définir soit un « temps d'inactivité », soit un « temps de fonctionnement ». Par exemple, pour minimiser au maximum le scaling pendant la nuit et les week-ends :
image: hjacobs/kube-downscaler:20.4.3
args:
  - --interval=30
  # ne pas désactiver les composants d'infrastructure
  - --exclude-namespaces=kube-system,infra
  # ne pas désactiver kube-downscaler, et garder le Postgres Operator afin que les bases de données exclues puissent être gérées
  - --exclude-deployments=kube-downscaler,postgres-operator
  - --default-uptime=Mon-Fri 08:00-20:00 Europe/Berlin
  - --include-resources=deployments,statefulsets,stacks,cronjobs
  - --deployment-time-annotation=deployment-time
Voici le graphique de mise à l'échelle des nœuds de travail du cluster pendant le week-end :
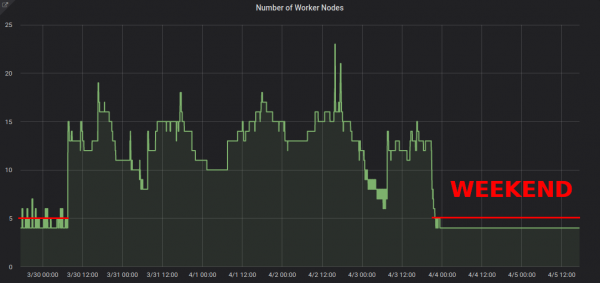
La réduction de l'échelle de ~13 à 4 nœuds de travail fait certainement une différence notable dans la facture AWS.
Mais que faire si je dois travailler pendant le « temps d'inactivité » du cluster ? Certains déploiements peuvent être définitivement exclus du scaling en ajoutant l'annotation downscaler/exclude: true. Les déploiements peuvent être temporairement exclus à l'aide de l'annotation downscaler/exclude-until avec un timestamp absolu au format AAAA-MM-JJ HH:MM (UTC). Si nécessaire, l'ensemble du cluster peut être redimensionné à nouveau en déployant un pod avec l'annotation downscaler/force-uptime, par exemple, en lançant une image nginx :
kubectl run scale-up --image=nginx
kubectl annotate deploy scale-up janitor/ttl=1h # supprimer le déploiement après une heure
kubectl annotate pod $(kubectl get pod -l run=scale-up -o jsonpath="{.items[0].metadata.name}") downscaler/force-uptime=true
Voir , si vous êtes intéressé par les instructions de déploiement et les options supplémentaires.
Utilisez le scaling automatique horizontal
De nombreuses applications/services font face à un schéma de charge dynamique : parfois leurs modules sont inactifs, et parfois ils fonctionnent à pleine capacité. Travailler avec un parc constant de pods pour gérer la charge de pointe maximale n'est pas économique. Kubernetes prend en charge le scaling automatique horizontal via la ressource (HPA). L'utilisation du CPU est souvent un bon indicateur pour le scaling :
apiVersion: autoscaling/v2beta2
kind: HorizontalPodAutoscaler
metadata:
  name: my-app
spec:
  scaleTargetRef:
    apiVersion: apps/v1
    kind: Deployment
    name: my-app
  minReplicas: 3
  maxReplicas: 10
  metrics:
  - type: Resource
    resource:
      name: cpu
      target:
        averageUtilization: 100
        type: Utilization
Zalando a créé un composant pour intégrer facilement des métriques personnalisées pour le scaling : (kube-metrics-adapter) est un adaptateur de métriques universel pour Kubernetes, capable de collecter et de servir des métriques personnalisées et externes pour le scaling horizontal des pods. Il prend en charge le scaling basé sur des métriques Prometheus, des files d'attente SQS et d'autres configurations. Par exemple, pour mettre à l'échelle un déploiement à l'aide d'une métrique personnalisée fournie par l'application sous forme de JSON dans /metrics, utilisez :
apiVersion: autoscaling/v2beta2
kind: HorizontalPodAutoscaler
metadata:
  name: myapp-hpa
  annotations:
    # metric-config.<metricType>.<metricName>.<collectorName>/<configKey>
    metric-config.pods.requests-per-second.json-path/json-key: "$.http_server.rps"
    metric-config.pods.requests-per-second.json-path/path: /metrics
    metric-config.pods.requests-per-second.json-path/port: "9090"
spec:
  scaleTargetRef:
    apiVersion: apps/v1
    kind: Deployment
    name: myapp
  minReplicas: 1
  maxReplicas: 10
  metrics:
  - type: Pods
    pods:
      metric:
        name: requests-per-second
      target:
        averageValue: 1k
        type: AverageValue
La configuration du scaling horizontal avec HPA devrait être l'une des actions par défaut pour améliorer l'efficacité pour les services sans état. Spotify a une présentation avec ses expériences et recommandations concernant le HPA : .
Réduction de la réserve de ressources excessive
Les charges de travail Kubernetes définissent leurs besoins en CPU/mémoire via des « demandes de ressources » (resource requests). Les ressources CPU sont mesurées en cœurs virtuels ou plus souvent en « milli-coeurs » (millicores), par exemple, 500m représente 50 % de vCPU. Les ressources mémoire sont mesurées en octets, et vous pouvez utiliser des suffixes courants comme 500Mi, ce qui signifie 500 mégaoctets. Les demandes de ressources « bloquent » la quantité sur les nœuds de travail, c'est-à-dire qu'un module avec une demande de CPU de 1000m sur un nœud avec 4 vCPUs laissera seulement 3 vCPUs disponibles pour d'autres modules.
Slack (excès de réserve) — c'est la différence entre les ressources demandées et l'utilisation réelle. Par exemple, un pod qui demande 2 GiB de mémoire mais n'en utilise que 200 MiB a environ 1,8 GiB de mémoire “excédentaire”. L'excédent coûte de l'argent. On peut estimer grossièrement qu'1 GiB de mémoire excédentaire coûte environ 10 dollars par mois.
(kube-resource-report) affiche les réserves excédentaires et peut vous aider à identifier le potentiel d'économies :
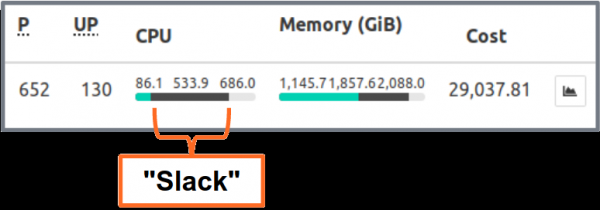
montre l'excédent agrégé par application et par équipe. Cela permet de trouver des endroits où les demandes de ressources peuvent être réduites. Le rapport HTML généré ne fournit qu'un instantané de l'utilisation des ressources. Vous devez examiner l'utilisation du processeur / de la mémoire dans le temps pour déterminer des demandes de ressources adéquates. Voici un graphique Grafana pour un service « typique » avec une forte charge CPU : tous les pods utilisent sensiblement moins de 3 cœurs CPU demandés :
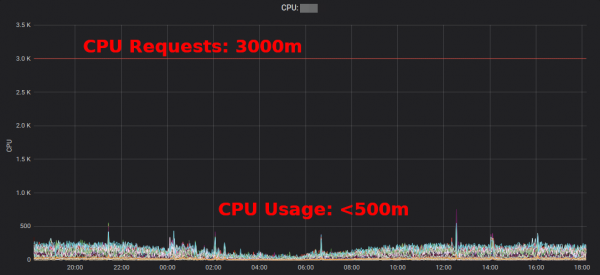
Réduire la demande de CPU de 3000m à environ 400m libère des ressources pour d'autres charges de travail et permet de diminuer le cluster.
« L'utilisation moyenne des instances EC2 varie souvent dans la plage des pourcentages à un chiffre », . Alors que pour EC2 , modifier certaines demandes de ressources Kubernetes dans le fichier YAML est facile et peut entraîner d'énormes économies.
Mais voulons-nous vraiment que les gens modifient des valeurs dans des fichiers YAML ? Non, les machines peuvent le faire beaucoup mieux ! Kubernetes (VPA) s'occupe exactement de cela : il adapte les demandes de ressources et les limites en fonction de la charge de travail. Voici un exemple de graphique des demandes de CPU Prometheus (ligne bleue fine), adaptées par le VPA au fil du temps :
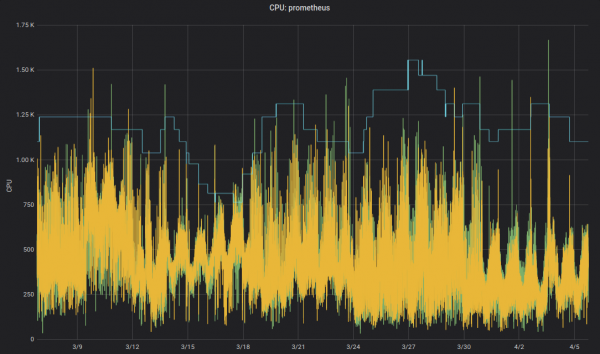
pour les composants d'infrastructure. Les applications non critiques peuvent également utiliser le VPA.
de Fairwind est un outil qui crée un VPA pour chaque déploiement dans l'espace de noms, puis affiche la recommandation VPA sur son tableau de bord. Il peut aider les développeurs à définir les bonnes demandes de CPU / mémoire pour leurs applications :
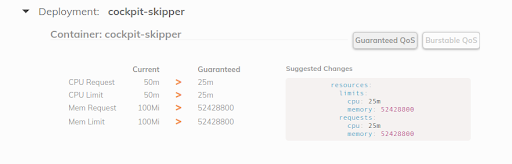
J'ai écrit un petit en 2019, et récemment dans .
Utilisation des instances EC2 Spot
Enfin, et ce n'est pas moins important, les coûts d'AWS EC2 peuvent être réduits en utilisant des instances Spot comme nœuds de travail Kubernetes. Les instances Spot sont disponibles avec des réductions allant jusqu'à 90 % par rapport aux prix à la demande. Exécuter Kubernetes sur EC2 Spot est une bonne combinaison : vous devez spécifier plusieurs types d'instances pour une plus grande disponibilité, c'est-à-dire que vous pouvez obtenir un nœud plus grand pour le même prix ou un prix inférieur, et la capacité accrue peut être utilisée par les charges de travail conteneurisées Kubernetes.
Comment exécuter Kubernetes sur EC2 Spot ? Il existe plusieurs options : utiliser un service tiers tel que SpotInst (qui s'appelle maintenant « Spot », ne me demandez pas pourquoi), ou simplement ajouter un AutoScalingGroup (ASG) Spot à votre cluster. Par exemple, voici un extrait CloudFormation pour un ASG Spot « optimisé par capacité » avec plusieurs types d'instances :
MySpotAutoScalingGroup:
 Properties:
   HealthCheckGracePeriod: 300
   HealthCheckType: EC2
   MixedInstancesPolicy:
     InstancesDistribution:
       OnDemandPercentageAboveBaseCapacity: 0
       SpotAllocationStrategy: capacity-optimized
     LaunchTemplate:
       LaunchTemplateSpecification:
         LaunchTemplateId: !Ref LaunchTemplate
         Version: !GetAtt LaunchTemplate.LatestVersionNumber
       Overrides:
         - InstanceType: "m4.2xlarge"
         - InstanceType: "m4.4xlarge"
         - InstanceType: "m5.2xlarge"
         - InstanceType: "m5.4xlarge"
         - InstanceType: "r4.2xlarge"
         - InstanceType: "r4.4xlarge"
   LaunchTemplate:
     LaunchTemplateId: !Ref LaunchTemplate
     Version: !GetAtt LaunchTemplate.LatestVersionNumber
   MinSize: 0
   MaxSize: 100
   Tags:
   - Key: k8s.io/cluster-autoscaler/node-template/label/aws.amazon.com/spot
     PropagateAtLaunch: true
     Value: "true"
Quelques remarques sur l'utilisation des Spot avec Kubernetes :
- Vous devez gérer les terminaisons de Spot, par exemple en drainant le nœud lors de l'arrêt de l'instance.
- Zalando utilise le scaling automatique officiel du cluster avec des priorités de pool de nœuds.
- Les nœuds Spot à accepter les « inscriptions » des charges de travail pour s'exécuter en Spot.
Résumé
J'espère que vous trouverez certains des outils présentés utiles pour réduire votre facture de cloud computing. Vous pouvez également trouver la majorité du contenu de l'article dans .
Quelles sont vos meilleures pratiques pour réduire les coûts cloud sur Kubernetes ? Faites-le moi savoir sur .
En réalité, moins de 3 vCPUs virtuels seront utilisables, car la capacité du nœud diminue en raison des ressources système réservées. Kubernetes fait la distinction entre la capacité physique du nœud et les ressources "allouées" ().
Exemple de calcul : une instance m5.large avec 8 GiB de mémoire coûte environ 84 USD par mois (eu-central-1, à la demande), donc le blocage de 1/8 du nœud représente environ 10 USD par mois.
Il existe de nombreuses façons de réduire votre facture EC2, notamment les instances réservées, le plan d'économies, etc. — je ne vais pas aborder ces sujets ici, mais vous devriez absolument vous renseigner à leur sujet !
Source : habr.com
