

Structuration de données non structurées avec GROK
Si vous utilisez la stack Elastic (ELK) et souhaitez faire correspondre les journaux personnalisés Logstash avec Elasticsearch, ce post est fait pour vous.
La stack ELK est l'acronyme de trois projets open source : Elasticsearch, Logstash et Kibana. Ensemble, ils forment une plateforme de gestion des journaux.
- Elasticsearch – est un système de recherche et d'analyse.
- Logstash – est un pipeline de traitement des données côté serveur qui reçoit des données provenant de plusieurs sources simultanément, les transforme puis les envoie dans un 'stash', comme Elasticsearch.
- Kibana permet aux utilisateurs de visualiser les données via des graphiques et des diagrammes dans Elasticsearch.
Beats a été introduit plus tard et est un expéditeur de données léger. L'introduction des Beats a transformé la stack ELK en Elastic Stack, mais ce n'est pas l'essentiel.
Cet article est consacré à Grok, qui est une fonction dans Logstash capable de transformer vos journaux avant qu'ils ne soient envoyés dans le 'stash'. Pour nos besoins, je vais parler uniquement du traitement des données de Logstash vers Elasticsearch.
Grok est un filtre au sein de Logstash qui est utilisé pour analyser des données non structurées en quelque chose de structuré et interrogeable. Il repose sur des expressions régulières (regex) et utilise des modèles de texte pour faire correspondre des chaînes dans les fichiers journaux.
Comme nous le verrons dans les sections suivantes, l'utilisation de Grok est cruciale pour une gestion efficace des journaux.
Sans Grok, vos données de journal sont non structurées.
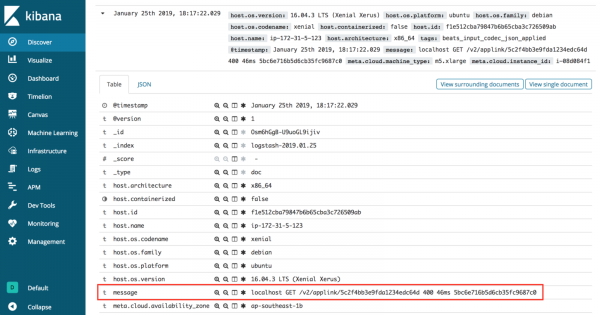
Sans Grok, lorsque les journaux sont envoyés de Logstash à Elasticsearch et visualisés dans Kibana, ils n'apparaissent qu'en tant que valeur de message.
La requête d'informations significatives dans cette situation est difficile, car toutes les données de journal sont stockées sous une seule clé. Ce serait mieux si les messages de journal étaient mieux organisés.
Données non structurées provenant des journaux
localhost GET /v2/applink/5c2f4bb3e9fda1234edc64d 400 46ms 5bc6e716b5d6cb35fc9687c0Si vous regardez attentivement les données brutes, vous verrez qu'elles se composent en réalité de différentes parties, chacune étant séparée par un espace.
Pour les développeurs plus expérimentés, vous pouvez probablement deviner ce que signifie chaque partie et que ceci est un message de journal d'un appel API. La représentation de chaque élément est présentée ci-dessous.
Vue structurée de nos données
- localhost == environnement
- GET == méthode
- /v2/applink/5c2f4bb3e9fda1234edc64d == url
- 400 == statut_de_réponse
- 46ms == temps_de_réponse
- 5bc6e716b5d6cb35fc9687c0 == id_utilisateur
Comme nous pouvons le voir dans les données structurées, il existe un ordre pour les journaux non structurés. La prochaine étape est le traitement programmatique des données brutes. C'est là que Grok brille.
Modèles Grok
Les modèles Grok intégrés
Logstash est livré avec plus de 100 modèles intégrés pour structurer les données non structurées. Vous devriez certainement en tirer parti lorsque cela est possible pour les journaux systèmes courants, tels que apache, linux, haproxy, aws, etc.
Cependant, que se passe-t-il lorsque vous avez des journaux personnalisés, comme dans l'exemple ci-dessus ? Vous devez créer votre propre modèle Grok.
Modèles Grok personnalisés
Il faut essayer pour construire son propre modèle Grok. J'ai utilisé et .
Notez que la syntaxe des modèles Grok est la suivante : %{SYNTAXE:SÉMANTIQUE}
La première chose que j'ai essayé de faire, c'est d'aller sur l'onglet Découvrir dans le débogueur Grok. J'ai pensé qu'il serait génial si cet outil pouvait générer automatiquement un modèle Grok, mais ce n'était pas très utile, car il n'a trouvé que deux correspondances.
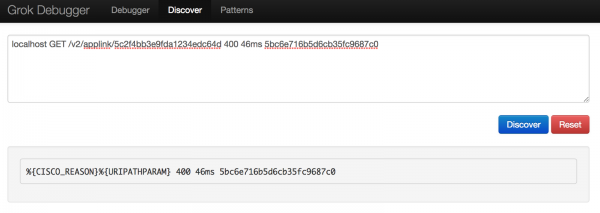
En utilisant cette découverte, j'ai commencé à créer mon propre modèle dans le débogueur Grok, en utilisant la syntaxe trouvée sur la page Github Elastic.
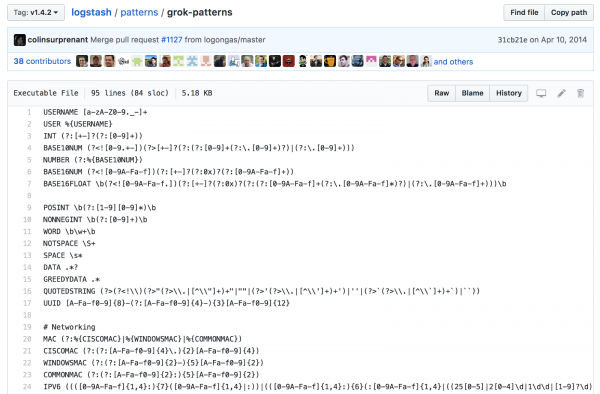
En jouant avec différentes syntaxes, j'ai finalement pu structurer les données de journal comme je le souhaitais.
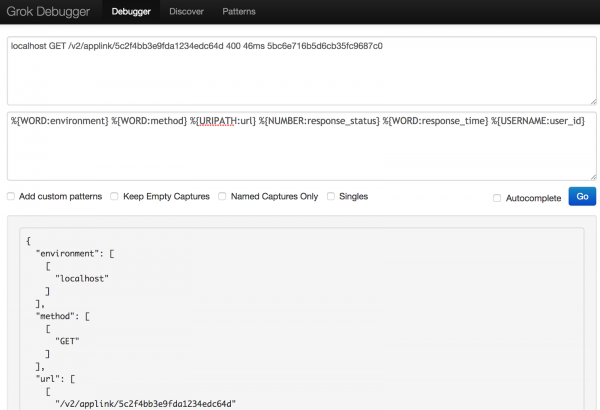
Lien vers le débogueur Grok
Texte source :
localhost GET /v2/applink/5c2f4bb3e9fda1234edc64d 400 46ms 5bc6e716b5d6cb35fc9687c0Modèle :
%{WORD:environnement} %{WORD:méthode} %{URIPATH:url} %{NUMBER:statut_de_réponse} %{WORD:temps_de_réponse} %{USERNAME:id_utilisateur}Ce que j'ai obtenu au final
{
  "environnement": [
    [
      "localhost"
    ]
  ],
  "méthode": [
    [
      "GET"
    ]
  ],
  "url": [
    [
      "/v2/applink/5c2f4bb3e9fda1234edc64d"
    ]
  ],
  "statut_de_réponse": [
    [
      "400"
    ]
  ],
  "BASE10NUM": [
    [
      "400"
    ]
  ],
  "temps_de_réponse": [
    [
      "46ms"
    ]
  ],
  "id_utilisateur": [
    [
      "5bc6e716b5d6cb35fc9687c0"
    ]
  ]
}
Avec le modèle Grok en main et les données correspondantes, la dernière étape consiste à l'ajouter à Logstash.
Mise à jour du fichier de configuration Logstash.conf
Sur le serveur où vous avez installé la pile ELK, accédez à la configuration de Logstash :
sudo vi /etc/logstash/conf.d/logstash.confCollez les modifications.
input {
  file {
    path => "/your_logs/*.log"
  }
}
filter{
  grok {
    match => { "message" => "%{WORD:environnement} %{WORD:méthode} %{URIPATH:url} %{NUMBER:statut_de_réponse} %{WORD:temps_de_réponse} %{USERNAME:id_utilisateur}"}
  }
}
output {
  elasticsearch {
    hosts => [ "localhost:9200" ]
  }
}
Après avoir enregistré les modifications, redémarrez Logstash et vérifiez son état pour vous assurer qu'il fonctionne toujours.
sudo service logstash restart
sudo service logstash status
Enfin, pour vous assurer que les modifications ont pris effet, veillez à mettre à jour l'index Elasticsearch pour Logstash dans Kibana !
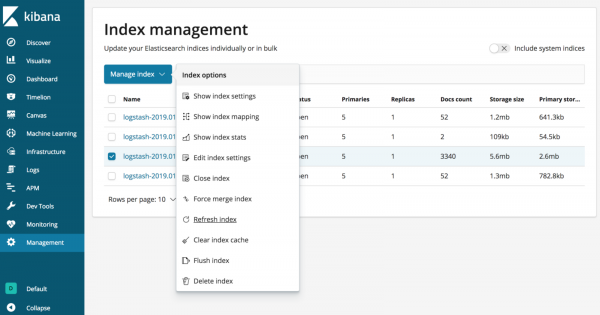
Avec Grok, vos données de logs sont structurées !
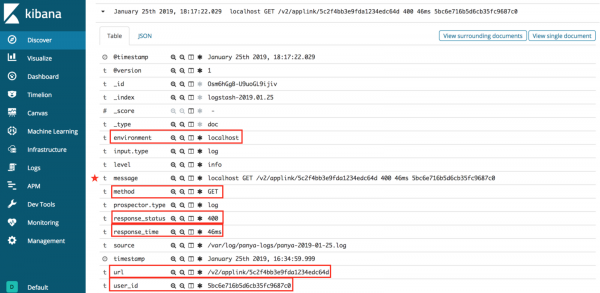
Comme nous le voyons sur l'image ci-dessus, Grok est capable de faire correspondre automatiquement les données de journal avec Elasticsearch. Cela facilite la gestion des journaux et l'extraction rapide d'informations. Au lieu de fouiller dans les fichiers journaux pour le débogage, vous pouvez simplement filtrer ce que vous recherchez, comme l'environnement ou l'URL.
Essayez de donner une chance aux expressions Grok ! Si vous avez une autre méthode pour le faire ou si vous avez des problèmes avec les exemples ci-dessus, laissez simplement un commentaire ci-dessous pour me le faire savoir.
Merci de votre lecture — et n'hésitez pas à me suivre ici, sur Medium, pour d'autres articles intéressants sur l'ingénierie logicielle !
Ressources
P.S
Canal Telegram sur
Source : habr.com
