

Il y a quelque temps, nous avons dû choisir un outil ETL pour travailler avec Big Data. La solution précédemment utilisée, Informatica BDM, ne nous satisfaisait pas en raison de ses fonctionnalités limitées. Son utilisation se limitait à un cadre pour exécuter des commandes spark-submit. Il n'y avait pas beaucoup d'alternatives sur le marché capables de gérer le volume de données que nous traitons chaque jour. En fin de compte, nous avons choisi Ab Initio. Lors des démonstrations pilotes, le produit a montré une vitesse de traitement des données très élevée. Il y a peu d'informations sur Ab Initio en russe, c'est pourquoi nous avons décidé de partager notre expérience sur Habr.
Ab Initio offre de nombreuses transformations classiques et inhabituelles, dont le code peut être étendu à l'aide de son propre langage PDL. Pour les petites entreprises, un outil aussi puissant pourrait être excessif, et la plupart de ses capacités pourraient s'avérer coûteuses et inutilisées. Mais si vos échelles se rapprochent de celles de Sberbank, Ab Initio pourrait vous intéresser.
Il aide les entreprises à acquérir des connaissances globales et à développer un écosystème, tout en permettant aux développeurs d'améliorer leurs compétences en ETL, d'approfondir leurs connaissances en shell, de maîtriser le langage PDL, et de fournir une vue visuelle des processus de chargement, simplifiant ainsi le développement grâce à une abondance de composants fonctionnels.
Dans ce post, je parlerai des fonctionnalités d'Ab Initio et fournirai des caractéristiques comparatives de son fonctionnement avec Hive et GreenPlum.
- Description du cadre MDW et des travaux pour son ajustement à GreenPlum
- Caractéristiques comparatives de la performance d'Ab Initio avec Hive et GreenPlum
- Fonctionnement d'Ab Initio avec GreenPlum en mode Near Real Time
La fonctionnalité de ce produit est très vaste et nécessite un certain temps pour être maîtrisée. Cependant, avec les compétences adéquates et les réglages de performance appropriés, les résultats du traitement des données s'avèrent impressionnants. L'utilisation d'Ab Initio peut offrir un intérêt aux développeurs. C'est un nouveau regard sur le développement ETL, un hybride entre un environnement visuel et le développement de chargements dans un langage de type script.
Les entreprises développent leurs écosystèmes et cet outil leur est plus utile que jamais. Avec Ab Initio, il est possible de capitaliser sur les connaissances acquises sur l'entreprise actuelle et d'utiliser ces connaissances pour étendre les anciennes et en créer de nouvelles. Parmi les alternatives à Ab Initio, on peut citer les environnements de développement visuels comme Informatica BDM et les environnements non visuels tels qu'Apache Spark.
Description d'Ab Initio
Ab Initio, comme d'autres outils ETL, est un ensemble de produits.
Ab Initio GDE (Graphical Development Environment) est un environnement pour développeurs où ils configurent les transformations de données et les connectent par des flux de données sous forme de flèches. Cet ensemble de transformations est appelé un graphe :
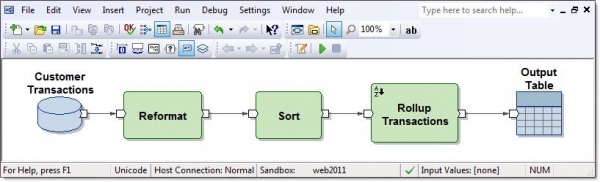
Les connexions d'entrée et de sortie des composants fonctionnels sont des ports et contiennent des champs calculés à l'intérieur des transformations. Plusieurs graphes, connectés par des flux sous forme de flèches dans l'ordre de leur exécution, sont appelés un plan.
Il existe plusieurs centaines de composants fonctionnels, ce qui est beaucoup. Beaucoup d'entre eux sont spécialisés. Les capacités des transformations classiques dans Ab Initio sont plus larges que dans d'autres outils ETL. Par exemple, la jointure a plusieurs sorties. En plus du résultat de la jointure des ensembles de données, il est possible de ramener les enregistrements des ensembles de données d'entrée pour lesquels une jointure n'a pas pu être effectuée. Il est également possible d'obtenir des rejets, des erreurs et un journal des opérations de transformation, qui peut être lu dans ce même graphe comme un fichier texte et traité par d'autres transformations :
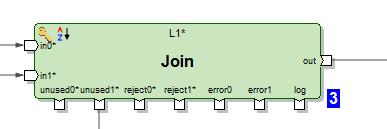
Ou, par exemple, on peut matérialiser le récepteur de données sous forme de table et lire les données de celle-ci dans le même graphe.
Il existe des transformations originales. Par exemple, la transformation Scan a une fonctionnalité similaire à celle des fonctions analytiques. Certaines transformations portent des noms évocateurs : Create Data, Read Excel, Normalize, Sort within Groups, Run Program, Run SQL, Join with DB, etc. Les graphes peuvent utiliser des paramètres d'exécution, y compris la possibilité de passer des paramètres depuis le système d'exploitation ou vers le système d'exploitation. Les fichiers contenant un ensemble prédéfini de paramètres à transmettre au graphe sont appelés ensemble de paramètres (psets).
Comme il se doit, Ab Initio GDE dispose de son propre référentiel, appelé EME (Enterprise Meta Environment). Les développeurs ont la possibilité de travailler avec des versions locales de code et d'effectuer un check-in de leurs développements dans le référentiel central.
Il est possible, pendant ou après l'exécution du graphique, de cliquer sur n'importe quelle liaison des transformations de flux et de voir les données passées entre ces transformations :
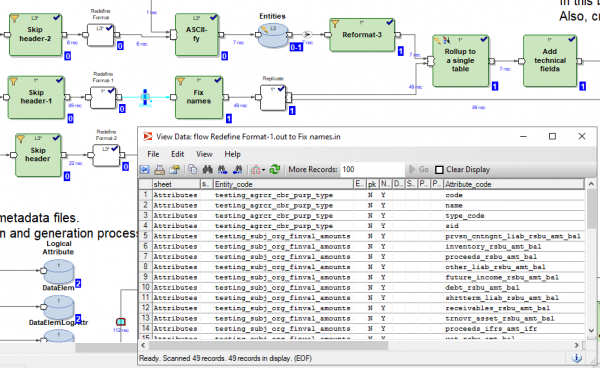
Il est également possible de cliquer sur n'importe quel flux et de consulter les détails de suivi – combien de parallèles ont fonctionné, combien de lignes et d'octets ont été chargés dans lequel des parallèles :
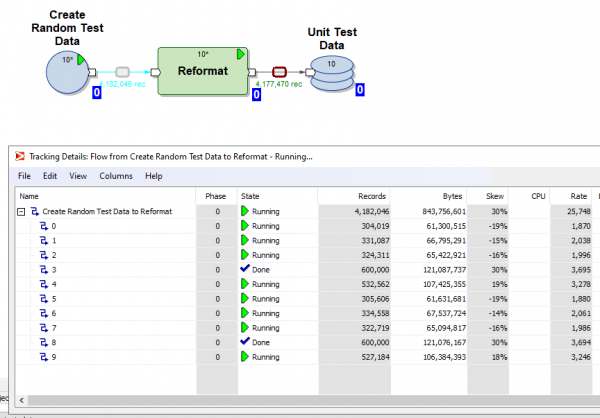
Il est possible de diviser l'exécution du graphique en phases et de marquer certaines transformations comme devant être exécutées en premier (dans la phase zéro), les suivantes dans la première phase, les suivantes dans la deuxième phase, etc.
Pour chaque transformation, il est possible de choisir un layout (où elle sera exécutée) : sans parallèles ou dans des flux parallèles, dont le nombre peut être spécifié. Les fichiers temporaires créés par Ab Initio lors de l'exécution des transformations peuvent être placés à la fois dans le système de fichiers de serveurs, ainsi que dans HDFS.
Dans chaque transformation basée sur le modèle par défaut, il est possible de créer son propre script en langage PDL, qui ressemble un peu à un shell.
À l'aide du langage PDL, vous pouvez étendre la fonctionnalité des transformations et, en particulier, générer dynamiquement (pendant l'exécution) des fragments de code arbitraires en fonction des paramètres d'exécution.
De plus, Ab Initio a une bonne intégration avec l'OS via le shell. En particulier, dans Sberbank, il utilise linux ksh. Il est possible d'échanger des variables avec le shell et de les utiliser comme paramètres de graphiques. Il est possible d'appeler l'exécution des graphiques Ab Initio depuis le shell et de gérer Ab Initio.
En plus d'Ab Initio GDE, plusieurs autres produits sont inclus dans la livraison. Il existe son propre système Co>Operation avec la prétention d'être un système d'exploitation. Il existe Control>Center, où l'on peut programmer et surveiller les flux de chargement. Il existe des produits pour le développement à un niveau plus élémentaire que celui permis par Ab Initio GDE.
Description du cadre MDW et des travaux pour son ajustement à GreenPlum
Avec ses produits, le fournisseur livre le produit MDW (Metadata Driven Warehouse), qui est un configurateur de graphiques destiné à aider dans des tâches typiques de remplissage des entrepôts de données ou des data vaults.
Il contient des parseurs de métadonnées spécifiques au projet et des générateurs de code prêts à l'emploi.
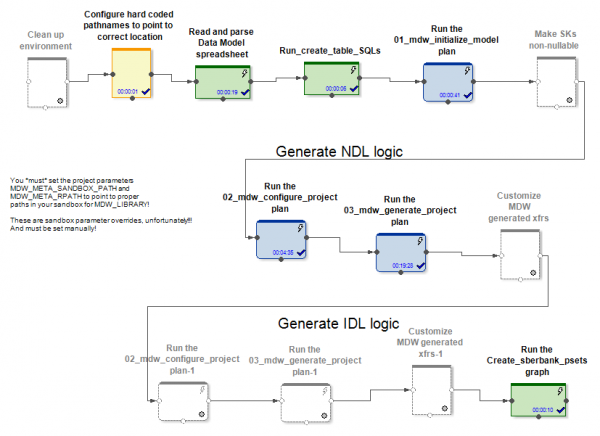
À l'entrée, MDW reçoit un modèle de données, un fichier de configuration pour le paramétrage de la connexion à la base de données (Oracle, Teradata ou Hive) et d'autres paramètres. La partie spécifique au projet déploie par exemple le modèle dans la base de données. La partie standard du produit génère des graphes et des fichiers de configuration associés lors du chargement des données dans les tables du modèle. Cela crée des graphes (et des psets) pour plusieurs modes de travail d'initialisation et d'incrémentation pour la mise à jour des entités.
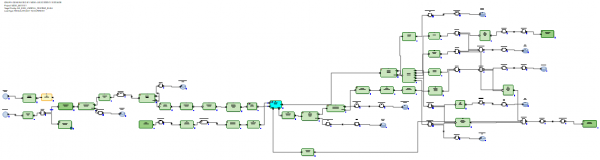
Dans les cas de Hive et de RDBMS, des graphes différents sont générés pour la mise à jour initiale et incrémentale des données.
Dans le cas de Hive, les données reçues de la delta sont combinées par un Ab Initio Join avec les données qui étaient dans la table avant la mise à jour. Les chargeurs de données dans MDW (tant dans Hive que dans RDBMS) insèrent non seulement de nouvelles données de la delta, mais également ferment les périodes de validité des données, selon les clés primaires par lesquelles la delta a été reçue. De plus, il faut réécrire la partie des données qui n'a pas changé. Mais cela est nécessaire, car il n'y a pas d'opérations de suppression ou de mise à jour dans Hive.
Dans le cas des RDBMS, les graphes pour la mise à jour incrémentale des données semblent plus optimaux, car les RDBMS disposent de réelles capacités de mise à jour.
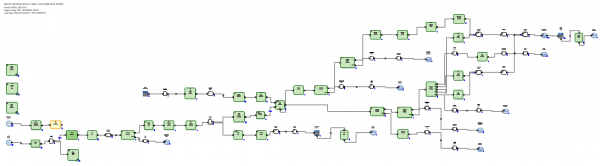
La delta reçue est chargée dans une table intermédiaire de la base de données. Après cela, la delta est jointe avec les données qui étaient dans la table avant la mise à jour, à l'aide d'une requête SQL générée. Ensuite, grâce à des commandes SQL delete+insert, de nouvelles données de la delta sont insérées dans la table cible et les périodes de validité des données sont fermées selon les clés primaires par lesquelles la delta a été reçue.
Il n'est pas nécessaire de réécrire les données inchangées.
Ainsi, nous sommes arrivés à la conclusion que dans le cas de Hive, MDW doit opter pour la réécriture de toute la table, car Hive ne dispose pas de fonction de mise à jour. Rien de mieux que la réécriture complète des données lors de la mise à jour n'a été imaginé. En revanche, dans le cas des RDBMS, les créateurs du produit ont jugé nécessaire de confier la connexion et la mise à jour des tables à l'utilisation de SQL.
Pour le projet chez Sberbank, nous avons créé une nouvelle implémentation réutilisable du chargeur de base de données pour GreenPlum. Cela a été fait sur la base de la version générée par MDW pour Teradata. C'est Teradata, et non Oracle, qui convenait le mieux, car elle est également un système MPP. Les méthodes de fonctionnement ainsi que la syntaxe de Teradata et GreenPlum se sont avérées proches.
Les exemples critiques de différences entre différents SGBD pour MDW sont les suivants. Dans GreenPlum, contrairement à Teradata, lors de la création de tables, il faut écrire la clause
distributed byDans Teradata, on écrit
supprimer <table> tout, et dans GreenPlum, on écrit
supprimer de <table>Dans Oracle, à des fins d'optimisation, on écrit
delete from t where rowid in (), alors que dans Teradata et GreenPlum, on écrit
delete from t where exists (select * from delta where delta.pk=t.pk)Nous notons également que pour le fonctionnement d'Ab Initio avec GreenPlum, il a fallu installer le client GreenPlum sur tous les nœuds du cluster Ab Initio. Cela est dû au fait que nous nous sommes connectés à GreenPlum simultanément depuis tous les nœuds de notre cluster. Pour que la lecture de GreenPlum soit parallèle et que chaque flux parallèle d'Ab Initio lise sa portion de données de GreenPlum, il a fallu inclure dans la section « where » des requêtes SQL une construction comprise par Ab Initio
where ABLOCAL()et définir la valeur de cette construction en précisant un paramètre de la transformation lisant depuis la base de données
ablocal_expr="string_concat("mod(t.", string_filter_out("{$TABLE_KEY}","{}"), ",", (decimal(3))(number_of_partitions()),")=", (decimal(3))(this_partition()))", qui se compile en quelque chose comme
mod(sk,10)=3, c'est-à-dire qu'il faut indiquer à GreenPlum un filtre explicite pour chaque partition. Pour d'autres bases de données (Teradata, Oracle), Ab Initio peut effectuer ce parallélisme automatiquement.
Caractéristiques comparatives de la performance d'Ab Initio avec Hive et GreenPlum
À Sberbank, une expérience a été réalisée pour comparer les performances des graphes générés par MDW appliqués à Hive et à GreenPlum. Dans le cadre de l'expérience, dans le cas de Hive, il y avait 5 nœuds sur le même cluster que celui d'Ab Initio, tandis que pour GreenPlum, il y avait 4 nœuds sur un cluster séparé. Cela signifie que Hive avait un certain avantage sur GreenPlum en termes de matériel.
Deux paires de graphes exécutant la même tâche de mise à jour des données dans Hive et dans GreenPlum ont été examinées. Les graphes générés par le configurateur MDW ont été lancés :
- chargement initial + chargement incrémentiel de données générées aléatoirement dans la table Hive
- chargement initial + chargement incrémentiel de données générées aléatoirement dans une table équivalente de GreenPlum
Dans les deux cas (Hive et GreenPlum), nous avons lancé des chargements à 10 flux parallèles sur le même cluster Ab Initio. Les données intermédiaires pour les calculs Ab Initio ont été enregistrées dans HDFS (en termes d'Ab Initio, un MFS layout utilisant HDFS a été utilisé). Une ligne de données générées aléatoirement occupait dans les deux cas 200 octets.
Le résultat est le suivant :
Hive :
Chargement initial dans Hive
Lignes insérées
6 000 000
60 000 000
600 000 000
Durée du chargement initial
en secondes
41
203
1 601
Chargement incrémental dans Hive
Nombre de lignes présentes dans
la table cible au début de l'expérience
6 000 000
60 000 000
600 000 000
Nombre de lignes delta appliquées à
la table cible au cours de l'expérience
6 000 000
6 000 000
6 000 000
Durée du chargement incrémental
en secondes
88
299
2 541
GreenPlum :
Chargement initial dans GreenPlum
Lignes insérées
6 000 000
60 000 000
600 000 000
Durée du chargement initial
en secondes
72
360
3 631
Chargement incrémental dans GreenPlum
Nombre de lignes présentes dans
la table cible au début de l'expérience
6 000 000
60 000 000
600 000 000
Nombre de lignes delta appliquées à
la table cible au cours de l'expérience
6 000 000
6 000 000
6 000 000
Durée du chargement incrémental
en secondes
159
199
321
Nous constatons que la vitesse du chargement initial tant dans Hive que dans GreenPlum dépend linéairement du volume de données et en raison de matériaux informatiques supérieurs, elle est un peu plus rapide pour Hive que pour GreenPlum.
Le chargement incrémental dans Hive dépend également linéairement du volume des données déjà chargées dans la table cible et se fait assez lentement à mesure que le volume augmente. Cela est dû à la nécessité de réécrire entièrement la table cible. Cela signifie qu'appliquer de petites modifications à de grandes tables n'est pas une très bonne option d'utilisation pour Hive.
En revanche, le chargement incrémental dans GreenPlum dépend peu du volume des données déjà présentes dans la table cible et se fait assez rapidement. Cela a été rendu possible grâce aux jointures SQL et à l'architecture de GreenPlum, qui permet l'opération de suppression.
Ainsi, GreenPlum intègre le delta via la méthode delete+insert, tandis qu'il n'y a pas d'opérations de suppression ou de mise à jour dans Hive, donc tout l'ensemble de données devait être réécrit entièrement lors de la mise à jour incrémentale. La comparaison des cellules en gras est particulièrement révélatrice, car elle correspond aux cas d'utilisation les plus courants pour des chargements gourmands en ressources. Nous voyons que GreenPlum a remporté ce test face à Hive par un facteur de 8.
Fonctionnement d'Ab Initio avec GreenPlum en mode Near Real Time
Dans cette expérience, nous allons tester la capacité d'Ab Initio à mettre à jour la table GreenPlum avec des lots de données générés aléatoirement dans un mode proche du temps réel. Nous considérerons la table GreenPlum dev42_1_db_usl.TESTING_SUBJ_org_finval, sur laquelle nous allons travailler.
Nous utiliserons trois graphes Ab Initio pour travailler avec elle :
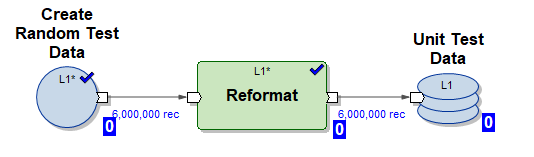
1) Graph Create_test_data.mp – crée 10 flux parallèles de fichiers de données dans HDFS contenant 6 000 000 de lignes. Les données sont aléatoires, leur structure est organisée pour l'insertion dans notre table.
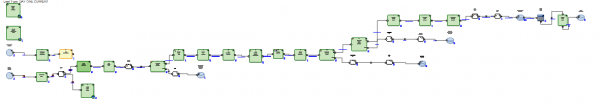
2) Graph mdw_load.day_one.current.dev42_1_db_usl_testing_subj_org_finval.pset – graphique MDW généré pour l'insertion initiale de données dans notre table en 10 flux parallèles (des données de test générées par le graphique (1) sont utilisées).
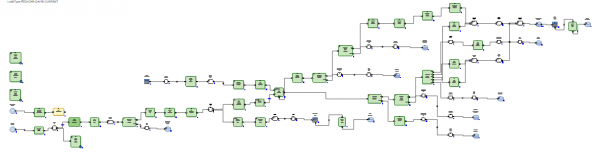
3) Graph mdw_load.regular.current.dev42_1_db_usl_testing_subj_org_finval.pset – graphique MDW généré pour la mise à jour incrémentale de notre table en 10 flux parallèles utilisant un lot de données fraîches récemment arrivées (delta) générées par le graphique (1).
Exécutons le scénario ci-dessous en mode NRT :
- générer 6 000 000 de lignes de test
- effectuer un chargement initial en insérant 6 000 000 de lignes de test dans une table vide
- répéter 5 fois le chargement incrémental
- générer 6 000 000 de lignes de test
- effectuer une insertion incrémentale de 6 000 000 de lignes de test dans la table (les anciennes données se voient attribuer un temps d'expiration valid_to_ts et des données plus récentes avec la même clé primaire sont insérées).
Ce scénario émule le mode de fonctionnement réel d'un système commercial – un volume suffisant de nouvelles données apparaît en temps réel et est immédiatement intégré dans GreenPlum.
Voyons maintenant le journal de l'exécution du scénario :
Démarrer Create_test_data.input.pset à 2020-06-04 11:49:11
Terminer Create_test_data.input.pset à 2020-06-04 11:49:37
Démarrer mdw_load.day_one.current.dev42_1_db_usl_testing_subj_org_finval.pset à 2020-06-04 11:49:37
Terminer mdw_load.day_one.current.dev42_1_db_usl_testing_subj_org_finval.pset à 2020-06-04 11:50:42
Démarrer Create_test_data.input.pset à 2020-06-04 11:50:42
Terminer Create_test_data.input.pset à 2020-06-04 11:51:06
Démarrer mdw_load.regular.current.dev42_1_db_usl_testing_subj_org_finval.pset à 2020-06-04 11:51:06
Terminer mdw_load.regular.current.dev42_1_db_usl_testing_subj_org_finval.pset à 2020-06-04 11:53:41
Démarrer Create_test_data.input.pset à 2020-06-04 11:53:41
Terminer Create_test_data.input.pset à 2020-06-04 11:54:04
Démarrer mdw_load.regular.current.dev42_1_db_usl_testing_subj_org_finval.pset à 2020-06-04 11:54:04
Terminer mdw_load.regular.current.dev42_1_db_usl_testing_subj_org_finval.pset à 2020-06-04 11:56:51
Démarrer Create_test_data.input.pset à 2020-06-04 11:56:51
Terminer Create_test_data.input.pset à 2020-06-04 11:57:14
Démarrer mdw_load.regular.current.dev42_1_db_usl_testing_subj_org_finval.pset à 2020-06-04 11:57:14
Terminer mdw_load.regular.current.dev42_1_db_usl_testing_subj_org_finval.pset à 2020-06-04 11:59:55
Démarrer Create_test_data.input.pset à 2020-06-04 11:59:55
Terminer Create_test_data.input.pset à 2020-06-04 12:00:23
Démarrer mdw_load.regular.current.dev42_1_db_usl_testing_subj_org_finval.pset à 2020-06-04 12:00:23
Terminer mdw_load.regular.current.dev42_1_db_usl_testing_subj_org_finval.pset à 2020-06-04 12:03:23
Démarrer Create_test_data.input.pset à 2020-06-04 12:03:23
Terminer Create_test_data.input.pset à 2020-06-04 12:03:49
Démarrer mdw_load.regular.current.dev42_1_db_usl_testing_subj_org_finval.pset à 2020-06-04 12:03:49
Terminer mdw_load.regular.current.dev42_1_db_usl_testing_subj_org_finval.pset à 2020-06-04 12:06:46
Voici le tableau obtenu :
Graphique
Heure de démarrage
Temps de fin
Longueur
Create_test_data.input.pset
04.06.2020 11:49:11
04.06.2020 11:49:37
00:00:26
mdw_load.day_one.current.
dev42_1_db_usl_testing_subj_org_finval.pset
04.06.2020 11:49:37
04.06.2020 11:50:42
00:01:05
Create_test_data.input.pset
04.06.2020 11:50:42
04.06.2020 11:51:06
00:00:24
mdw_load.regular.current.
dev42_1_db_usl_testing_subj_org_finval.pset
04.06.2020 11:51:06
04.06.2020 11:53:41
00:02:35
Create_test_data.input.pset
04.06.2020 11:53:41
04.06.2020 11:54:04
00:00:23
mdw_load.regular.current.
dev42_1_db_usl_testing_subj_org_finval.pset
04.06.2020 11:54:04
04.06.2020 11:56:51
00:02:47
Create_test_data.input.pset
04.06.2020 11:56:51
04.06.2020 11:57:14
00:00:23
mdw_load.regular.current.
dev42_1_db_usl_testing_subj_org_finval.pset
04.06.2020 11:57:14
04.06.2020 11:59:55
00:02:41
Create_test_data.input.pset
04.06.2020 11:59:55
04.06.2020 12:00:23
00:00:28
mdw_load.regular.current.
dev42_1_db_usl_testing_subj_org_finval.pset
04.06.2020 12:00:23
04.06.2020 12:03:23
00:03:00
Create_test_data.input.pset
04.06.2020 12:03:23
04.06.2020 12:03:49
00:00:26
mdw_load.regular.current.
dev42_1_db_usl_testing_subj_org_finval.pset
04.06.2020 12:03:49
04.06.2020 12:06:46
00:02:57
Nous voyons que 6 000 000 lignes d'incrément sont traitées en 3 minutes, ce qui est assez rapide.
Les données dans la table cible sont réparties comme suit :
select valid_from_ts, valid_to_ts, count(1), min(sk), max(sk) from dev42_1_db_usl.TESTING_SUBJ_org_finval group by valid_from_ts, valid_to_ts order by 1,2; 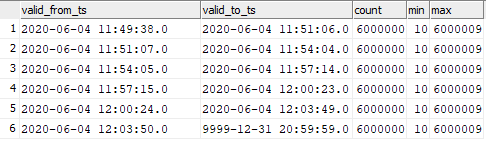
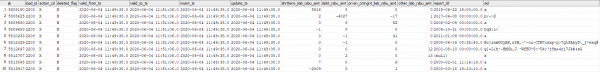
On peut voir la correspondance entre les données insérées et les moments de lancement des graphiques.
Cela signifie qu'il est possible de lancer dans Ab Initio le chargement incrémentiel des données dans GreenPlum avec une très haute fréquence et d'observer une grande vitesse d'insertion de ces données dans GreenPlum. Bien sûr, il ne sera pas possible de lancer toutes les secondes, car Ab Initio, comme tout outil ETL, nécessite un certain temps 'd'échauffement' au démarrage.
Conclusion
Actuellement, Ab Initio est utilisé à Sberbank pour construire une couche sémantique unique de données (ESS). Ce projet implique la création d'une version unique de l'état de diverses entités métier bancaires. Les informations proviennent de diverses sources, dont les répliques sont préparées sur Hadoop. En fonction des besoins de l'entreprise, un modèle de données est préparé et les transformations de données sont décrites. Ab Initio charge les informations dans l'ESS, et les données chargées non seulement représentent un intérêt pour les affaires elles-mêmes, mais servent aussi de source pour la construction de vitrines de données. La fonctionnalité du produit permet d'utiliser divers systèmes comme récepteurs (Hive, Greenplum, Teradata, Oracle), ce qui donne la possibilité de préparer les données pour l'entreprise dans les différents formats requis sans trop d'efforts.
Les capacités d'Ab Initio sont vastes, par exemple, le cadre MDW inclus permet de construire l'historique technique et commercial des données 'prêts à l'emploi'. Pour les développeurs, Ab Initio offre la possibilité de 'ne pas réinventer la roue', mais d'utiliser de nombreux composants fonctionnels existants, qui sont en fait des bibliothèques nécessaires lors du travail avec les données.
L'auteur est un expert de la communauté professionnelle de Sberbank SberProfi DWH/BigData. La communauté professionnelle SberProfi DWH/BigData est responsable du développement des compétences dans des domaines tels que l'écosystème Hadoop, Teradata, Oracle DB, GreenPlum, ainsi que dans les outils BI tels que Qlik, SAP BO, Tableau, etc.
Source : habr.com
