

Voici à quoi ressemble la redondance
Les codes de redondance* sont largement utilisés dans les systèmes informatiques pour améliorer la fiabilité du stockage des données. Chez Yandex, ils sont utilisés dans de nombreux projets. Par exemple, l'utilisation de codes de redondance à la place de la réplication dans notre système de stockage d'objets interne permet d'économiser des millions sans diminuer la fiabilité. Mais malgré leur large utilisation, une description claire de leur fonctionnement est rare. Ceux qui souhaitent comprendre se heurtent généralement à ce qui suit (voir ):
Je m'appelle Vadim, et chez Yandex, je travaille sur le développement du système de stockage d'objets interne MDS. Dans cet article, je vais expliquer les principes théoriques des codes de redondance (codes de Reed-Solomon et LRC) en des termes simples. Je vais décrire leur fonctionnement sans mathématiques complexes ni termes rares. À la fin, je donnerai des exemples d'utilisation des codes de redondance chez Yandex.
Je ne vais pas aborder en détail certains aspects mathématiques, mais je fournirai des liens pour ceux qui souhaitent approfondir. Je souligne également que certaines définitions mathématiques peuvent ne pas être strictes, car l'article s'adresse non pas à des mathématiciens mais à des ingénieurs désireux de comprendre le cœur du sujet.
* Dans la littérature anglophone, les codes de redondance sont souvent appelés erasure codes.
1. La nature des codes de redondance
La nature de tous les codes de redondance est extrêmement simple : stocker (ou transmettre) des données de manière à ce qu'elles ne soient pas perdues en cas d'erreurs (pannes de disque, erreurs de transmission des données, etc.).
Dans la plupart des* codes de redondance, les données sont divisées en n blocs de données, et m blocs de codes de redondance sont générés, ce qui donne un total de n + m blocs. Les codes de redondance sont construits de manière à ce que l'on puisse récupérer n blocs de données en n'utilisant qu'une partie des n + m blocs. Nous allons ici examiner uniquement les codes de redondance bloqués, c'est-à-dire ceux dans lesquels les données sont divisées en blocs.
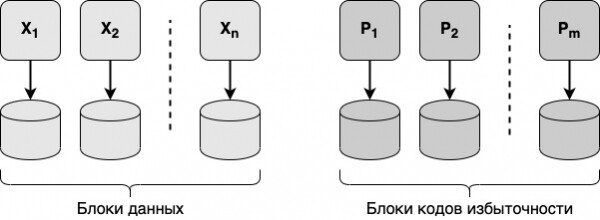
Pour récupérer tous les n blocs de données, il faut au minimum n des n + m blocs, car il est impossible d'obtenir n blocs avec seulement n-1 bloc (dans ce cas, il faudrait prendre 1 bloc « dans l'air »). Suffit-il d'avoir n blocs aléatoires parmi n + m blocs pour restaurer toutes les données ? Cela dépend du type de codes dRedondance, par exemple les codes de Reed-Solomon permettent de récupérer toutes les données avec des blocs aléatoires n, tandis que les codes de redondance LRC ne le permettent pas toujours.
Stockage des données
Dans les systèmes de stockage de données, en règle générale, chacun des blocs de données et des blocs de codes de redondance est enregistré sur un disque distinct. Ainsi, en cas de panne d'un disque aléatoire, les données d'origine pourront toujours être restaurées et lues. Les données pourront être restaurées même en cas de panne simultanée de plusieurs disques.
Transmission de données
Les codes de redondance peuvent être utilisés pour une transmission fiable des données sur un réseau peu fiable. Les données transmises sont divisées en blocs, pour lesquels des codes de redondance sont calculés. Tant les blocs de données que les blocs de codes de redondance sont transmis sur le réseau. En cas d'erreurs dans des blocs aléatoires (jusqu'à un certain nombre de blocs), les données peuvent tout de même être transmises sans erreur sur le réseau. Les codes de Reed-Solomon, par exemple, sont utilisés pour la transmission de données sur des lignes de communication optique et dans les communications par satellite.
* Il existe également des codes de redondance dans lesquels les données ne sont pas divisées en blocs, comme les codes de Hamming et les codes CRC, largement utilisés pour la transmission de données dans les réseaux Ethernet. Ce sont des codes de codage à épreuve d'erreurs, destinés à la détection des erreurs plutôt qu'à leur correction (le code de Hamming permet également de corriger partiellement les erreurs).
2. Codes de Reed-Solomon
Les codes de Reed-Solomon sont parmi les codes de redondance les plus largement utilisés, inventés dans les années 1960 et qui ont d'abord été largement appliqués dans les années 1980 pour la production en série de disques compacts.
Deux questions clés pour comprendre les codes de Reed-Solomon sont : 1) comment créer des blocs de codes de redondance ; 2) comment restaurer les données à l'aide de blocs de codes de redondance. Trouvons les réponses à ces questions.
Pour simplifier, nous allons considérer que n=6 et m=4. D'autres schémas peuvent être examinés par analogie.
Comment créer des blocs de codes de redondance
Chaque bloc de codes d'erreur est compté indépendamment des autres. Pour le calcul de chaque bloc, tous les n blocs de données sont utilisés. Dans le schéma ci-dessous, X1-X6 représentent les blocs de données, P1–P4 les blocs de codes d'erreur.
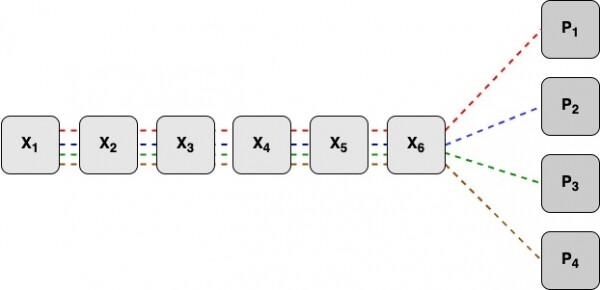
Tous les blocs de données doivent être de la même taille. Des bits nuls peuvent être utilisés pour l'alignement. Les blocs de codes d'erreur obtenus auront la même taille que les blocs de données. Tous les blocs de données sont divisés en mots (par exemple, de 16 bits). Supposons que nous avons divisé les blocs de données en k mots. Alors, tous les blocs de codes d'erreur seront également divisés en k mots.
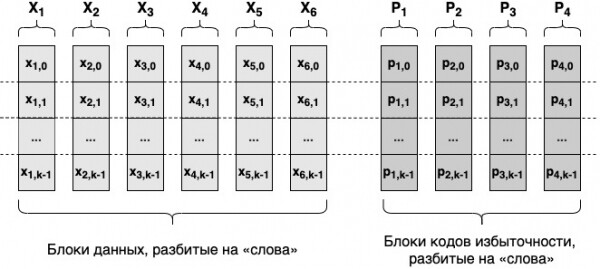
Pour le calcul du ième mot de chaque bloc de codes d'erreur, les ièmes mots de tous les blocs de données seront utilisés. Ils seront calculés selon la formule suivante :
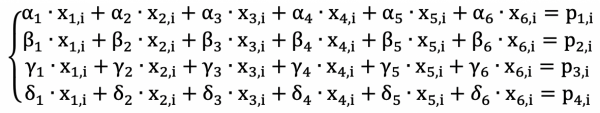
Ici, les valeurs x représentent les mots des blocs de données, p les mots des blocs de codes d'erreur, et tous les alpha, beta, gamma et delta sont des nombres spécifiquement choisis, identiques pour tous les i. Il faut préciser que toutes ces valeurs ne sont pas des nombres ordinaires, mais des éléments du corps de Galois, avec des opérations +, -, *, / qui ne sont pas les opérations habituelles, mais des opérations spéciales définies sur les éléments du corps de Galois.
Pourquoi les corps de Galois sont-ils nécessaires ?
À première vue, cela semble simple : nous divisons les données en blocs, les blocs en mots, et avec les mots des blocs de données, nous calculons les mots des blocs de codes d'erreur, et nous obtenons les blocs de codes d'erreur. En général, c'est ainsi que cela fonctionne, mais le diable est dans les détails :
- Comme mentionné ci-dessus, la taille du mot est fixe, dans notre exemple 16 bits. Les formules ci-dessus pour les codes de Reed-Solomon sont telles que, lorsque des entiers ordinaires sont utilisés, le résultat du calcul de p peut ne pas être représentable par un mot de taille admissible.
- Lors de la récupération des données, les formules ci-dessus seront considérées comme un système d'équations à résoudre pour récupérer les données. Dans le processus de résolution, il peut être nécessaire de diviser des entiers les uns par les autres, ce qui aboutira à un nombre réel qui ne peut pas être représenté avec précision en mémoire informatique.
Ces problèmes empêchent d'utiliser des entiers pour les codes de Reed-Solomon. La solution est originale et peut être décrite comme suit : inventons des nombres spéciaux qui peuvent être représentés par des mots de longueur appropriée (par exemple, 16 bits), et le résultat de toutes les opérations sur eux (addition, soustraction, multiplication, division) sera également représenté en mémoire de l'ordinateur par des mots de la même longueur.
Ces « nombres spéciaux » sont étudiés depuis longtemps par les mathématiciens, et on les appelle des corps. Un corps est un ensemble d'éléments avec des opérations de addition, soustraction, multiplication et division définies.
Les corps de Galois* sont des corps pour lesquels il existe un et un seul résultat pour chaque opération (+, -, *, /) pour n'importe quelle paire d'éléments du corps. Des corps de Galois peuvent être construits pour des nombres qui sont des puissances de 2 : 2, 4, 8, 16, etc. (en réalité, toute puissance d'un nombre premier p, mais en pratique, nous nous intéressons uniquement aux puissances de 2). Par exemple, pour des mots de taille 16 bits, ce corps contient 65 536 éléments, pour chaque paire desquels il est possible de trouver le résultat de toute opération (+, -, *, /). Les valeurs x, p, alpha, beta, gamma, delta des équations ci-dessus seront considérées comme des éléments du corps de Galois lors des calculs.
Ainsi, nous avons un système d'équations qui permet de construire des blocs de codes de redondance en écrivant un programme informatique adéquat. Ce même système d'équations peut être utilisé pour récupérer des données.
* Ce n'est pas une définition stricte, plutôt une description.
Comment récupérer des données
La récupération est nécessaire lorsque, dans n + m blocs, une partie des blocs est manquante. Cela peut concerner à la fois des blocs de données et des blocs de codes de redondance. L'absence de blocs de données et/ou de blocs de codes de redondance signifie que dans les équations ci-dessus, les variables correspondantes x et/ou p sont inconnues.
Les équations pour les codes de Reed-Solomon peuvent être considérées comme un système d'équations dans lequel toutes les valeurs alpha, beta, gamma, delta sont des constantes, tous les x et p correspondant aux blocs disponibles sont des variables connues, tandis que les autres x et p sont inconnus.
Par exemple, supposons que les blocs de données 1, 2, 3 et le bloc de codes de redondance 2 soient indisponibles, alors pour le ième groupe de mots, le système d'équations suivant sera le suivant (les inconnues sont marquées en rouge) :
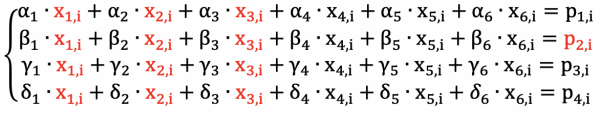
Nous avons un système de 4 équations avec 4 inconnues, ce qui signifie que nous pouvons le résoudre et récupérer les données !
De ce système d'équations découlent plusieurs conclusions sur la restauration des données pour les codes de Reed-Solomon (n blocs de données, m blocs de codes de redondance) :
- Les données peuvent être récupérées en cas de perte de n'importe quels m blocs ou moins. En cas de perte de m+1 blocs ou plus, les données ne peuvent pas être récupérées : il est impossible de résoudre un système de m équations avec m + 1 inconnues.
- Pour restaurer même un seul bloc de données, il faut utiliser n'importe quels n des blocs restants, tout en pouvant utiliser n'importe quel code de redondance.
Que faut-il savoir d'autre
Dans la description ci-dessus, j'ignore un certain nombre de questions importantes, dont l'examen nécessite une plongée plus approfondie dans les mathématiques. En particulier, je ne dis rien sur ce qui suit :
- Le système d'équations pour les codes de Reed-Solomon doit avoir une (unique) solution quelle que soit la combinaison des inconnues (pas plus de m inconnues). À partir de cette exigence, les valeurs d'alpha, bêta, gamma, et delta sont choisies.
- Le système d'équations doit être capable d'être construit automatiquement (selon les blocs qui sont inaccessibles) et résolu.
- Il faut construire un corps de Galois : pour une taille de mot donnée, savoir trouver le résultat de n'importe quelle opération (+, -, *, /) pour deux éléments quelconques.
À la fin de l'article, il y a des liens vers la littérature sur ces questions importantes.
Choix de n et m
Comment choisir pratiquement n et m ? Dans la pratique, dans les systèmes de stockage de données, les codes de redondance sont utilisés pour économiser de l'espace, donc m est toujours choisi inférieur à n. Leurs valeurs spécifiques dépendent de plusieurs facteurs, y compris :
- Fiabilité du stockage des données. Plus m est grand, plus le nombre de pannes de disque pouvant être toléré est élevé, donc plus la fiabilité est accrue.
- Redondance du stockage. Plus le ratio m/n est élevé, plus la redondance du stockage sera importante, et plus le coût du système sera élevé.
- Temps de traitement des requêtes. Plus la somme n + m est grande, plus le temps de réponse aux requêtes sera long. En effet, pour lire les données (en cas de restauration), il faut lire n blocs, stockés sur n disques différents, donc le temps de lecture sera déterminé par le disque le plus lent.
De plus, le stockage des données dans plusieurs centres de données impose des restrictions supplémentaires sur le choix de n et m : lors de la défaillance d'un centre de données, les données doivent toujours être accessibles en lecture. Par exemple, lorsque des données sont stockées dans 3 centres de données, la condition suivante doit être remplie : m >= n/2, sinon il se peut que les données ne soient pas accessibles en lecture lors de la déconnexion d'un centre de données.
3. LRC — Codes de Reconstruction Locaux
Pour récupérer les données à l'aide des codes de Reed-Solomon, il est nécessaire d'utiliser n blocs de données arbitraires. C'est un inconvénient majeur pour les systèmes de stockage de données répartis, car pour récupérer les données d'un disque défectueux, il faudra lire les données de la plupart des autres disques, créant ainsi une charge supplémentaire importante sur les disques et le réseau.
Les erreurs les plus courantes sont l'indisponibilité d'un bloc de données en raison de la panne ou de la surcharge d'un disque. Peut-on réduire la charge excessive lors de la récupération des données dans un tel cas (le plus fréquent) ? Il s'avère que oui : des codes de redondance LRC existent spécifiquement à cet effet.
LRC (Local Reconstruction Codes) — codes de redondance conçus par Microsoft pour une utilisation dans Windows Azure Storage. L'idée des LRC est très simple : diviser tous les blocs de données en deux (ou plusieurs) groupes et calculer une partie des blocs de codes de redondance pour chaque groupe séparément. Ainsi, une partie des blocs de codes de redondance sera calculée à l'aide de tous les blocs de données (dans les LRC, ils sont appelés codes de redondance globaux), et une autre partie — à l'aide de l'un des deux groupes de blocs de données (appelés codes de redondance locaux).
Les LRC sont notés par trois nombres : n-r-l, où n est le nombre de blocs de données, r est le nombre de blocs de codes de redondance globaux, et l est le nombre de blocs de codes de redondance locaux. Pour lire les données lors de l'indisponibilité d'un bloc de données, il suffit de lire seulement n/l blocs — c'est l fois moins que dans les codes de Reed-Solomon.
Prenons par exemple le schéma LRC 6-2-2. X1–X6 — 6 blocs de données, P1, P2 — 2 blocs de redondance globaux, P3, P4 — 2 blocs de redondance locaux.
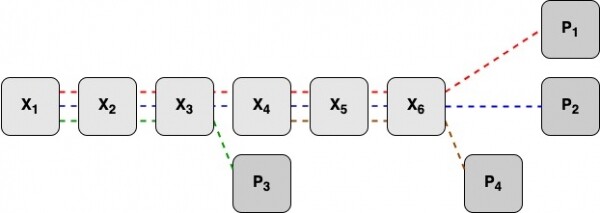
Les blocs de codes de redondance P1, P2 sont calculés à l'aide de tous les blocs de données. Le bloc de codes de redondance P3 — à l'aide des blocs de données X1–X3, le bloc de codes de redondance P4 — à l'aide des blocs de données X4–X6.
Le reste se fait dans LRC de la même manière que pour les codes de Reed-Solomon. Les équations pour le calcul des mots des blocs de codes d'excédent seront les suivantes :
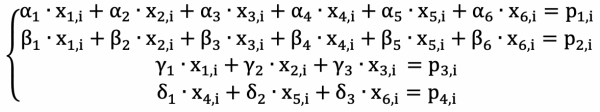
Pour sélectionner les nombres alpha, beta, gamma, delta, il est nécessaire de respecter une série de conditions garantissant la possibilité de récupérer les données (c'est-à-dire de résoudre le système d'équations). Vous pouvez en savoir plus à ce sujet dans .
En pratique, l'opération XOR est également utilisée pour le calcul des codes d'excédent locaux P3, P4.
Du système d'équations pour LRC, on peut tirer plusieurs conclusions :
- Pour récupérer n'importe quel bloc de données, il suffit de lire n/l blocs (n/2 dans notre exemple).
- Si r + l blocs ne sont pas accessibles et que tous les blocs appartiennent à un même groupe, alors les données ne peuvent pas être récupérées. Cela peut être illustré par un exemple. Supposons que les blocs X1–X3 et P3 ne soient pas accessibles : ce sont r + l blocs d'un même groupe, soit 4 dans notre cas. Nous avons alors un système de 3 équations avec 4 inconnues, qui ne peut pas être résolu.
- Dans tous les autres cas d'indisponibilité de r + l blocs (lorsqu'au moins un bloc de chaque groupe est accessible), les données dans LRC peuvent être récupérées.
Ainsi, LRC a un avantage sur les codes de Reed-Solomon en matière de récupération de données après des erreurs simples. Dans les codes de Reed-Solomon, pour récupérer même un seul bloc de données, n blocs doivent être utilisés, tandis que dans LRC, il suffit d'utiliser n/l blocs (n/2 dans notre exemple) pour récupérer un bloc de données. D'un autre côté, LRC est désavantagé par rapport aux codes de Reed-Solomon en ce qui concerne le nombre maximum d'erreurs tolérées. Dans les exemples ci-dessus, les codes de Reed-Solomon peuvent récupérer des données même avec 4 erreurs, alors que pour LRC, il existe 2 combinaisons de 4 erreurs où les données ne peuvent pas être récupérées.
Ce qui est plus important dépend de la situation concrète, mais souvent, l'économie de surcharge d'excédent que LRC offre l'emporte sur une fiabilité de stockage légèrement inférieure.
4. Autres codes d'excédent
Outre les codes de Reed-Solomon et LRC, il existe de nombreux autres codes d'excédent. Différents codes d'excédent utilisent des mathématiques différentes. Voici quelques autres codes d'excédent :
- Code d'excédent utilisant un opérateur XOR. L'opération XOR est effectuée sur n blocs de données, et un bloc de codes d'excédent en résulte, soit le schéma n+1 (n blocs de données, 1 code d'excédent). Utilisé dans , où les blocs de données et de codes d'excédent sont écrits de manière cyclique sur tous les disques du tableau.
- L'algorithme even-odd, basé sur l'opération XOR. Permet de construire 2 blocs de codes de redondance, soit le schéma n+2.
- L'algorithme STAR, basé sur l'opération XOR. Permet de construire 3 blocs de codes de redondance, soit le schéma n+3.
- Les codes pyramides — encore des codes de redondance de Microsoft.
5. Utilisation dans Yandex
Plusieurs projets d'infrastructure de Yandex utilisent des codes de redondance pour un stockage fiable des données. Voici quelques exemples :
- Le stockage d'objets interne MDS, dont j'ai parlé au début de l'article.
- — Système MapReduce de Yandex.
- (Yandex DataBase) — base de données distribuée newSQL.
Dans MDS, des codes de redondance LRC sont utilisés, le schéma 8-2-2. Les données avec des codes de redondance sont écrites sur 12 disques différents dans différents serveurs dans 3 centres de données : 4 serveurs dans chaque centre de données. Pour plus de détails, lisez .
Dans YT, sont utilisés à la fois des codes de Reed-Solomon (schéma 6-3), qui ont été réalisés en premier, et des codes de redondance LRC (schéma 12-2-2), le LRC étant le moyen de stockage préféré.
Dans YDB, des codes de redondance basés sur even-odd (schéma 4-2) sont utilisés. Des informations sur les codes de redondance dans YDB ont déjà été .
L'utilisation de différents schémas de codes de redondance est déterminée par les exigences diverses qui sont posées aux systèmes. Par exemple, dans MDS, les données stockées par LRC sont réparties sur 3 centres de données. Il est important pour nous que les données restent accessibles en lecture lors d'une panne de n'importe quel centre de données, donc les blocs doivent être distribués entre les centres de données de manière à ce qu'en cas d'inaccessibilité de l'un d'eux, le nombre de blocs inaccessibles ne dépasse pas le seuil acceptable. Dans le schéma 8-2-2, il est possible de placer 4 blocs dans chaque centre de données, de sorte qu'en cas de désactivation de n'importe quel centre de données, 4 blocs seront inaccessibles, mais les données pourront être lues. Quel que soit le schéma que nous choisissons pour le placement dans 3 centres de données, il doit en tout cas y avoir (r + l) / n >= 0,5, c'est-à-dire que la redondance de stockage sera d'au moins 50%.
Dans YT, la situation est différente : chaque cluster YT se trouve entièrement dans 1 centre de données (divers clusters dans différents centres de données), donc il n'y a pas de telle restriction. Le schéma 12-2-2 donne une redondance de 33%, donc le stockage des données devient moins cher, tout en permettant également de survivre à 4 pannes simultanées de disques, tout comme dans le schéma MDS.
Il existe encore de nombreuses particularités concernant l'application des codes de redondance dans les systèmes de stockage et de traitement des données : nuances de la récupération des données, impact de la récupération sur le temps de réponse, particularités de l'écriture des données, etc. Je prévois d'aborder séparément ces aspects et d'autres concernant l'application des codes de redondance dans la pratique, si le sujet suscite de l'intérêt.
6. Liens
- Série d'articles sur les codes de Reed-Solomon et les champs de Galois :
Ils abordent la mathématique de manière accessible. - Article de Microsoft sur LRC :
Dans la section 2, la théorie est brièvement expliquée, suivie d'une discussion sur l'expérience de l'application de LRC dans la pratique. - Schéma even-odd :
- Schéma STAR :
- Codes pyramidaux :
- Codes de redondance dans MDS :
- Codes de redondance dans YT :
- Codes de redondance dans YDB :
Source : habr.com
