

Je travaille actuellement pour une entreprise de logiciels, notamment dans le domaine des solutions de gestion des accès. Mon expérience « d'une vie antérieure » est liée à la partie commanditaire – une grande organisation financière. À l'époque, notre équipe de contrôle d'accès au sein du département de cybersécurité n'avait pas de grandes compétences en IdM. Nous avons beaucoup appris sur le tas, et nous avons dû surmonter de nombreuses difficultés pour établir un mécanisme de gestion des droits des utilisateurs au sein des systèmes d'information de l'entreprise.
En combinant mon expérience éprouvée chez le client avec des connaissances et compétences du fournisseur, je souhaite partager avec vous en quelque sorte un guide étape par étape : comment créer un modèle de gestion des accès basé sur les rôles dans une grande entreprise, et ce que cela va apporter à l'issue. Mon guide se compose de deux parties : la première – nous nous préparons à construire le modèle, la seconde – nous le construisons effectivement. Vous avez devant vous la première partie, celle de la préparation.
N.B. La construction d'un modèle de rôle n'est malheureusement pas un résultat, mais un processus. Plus précisément, c'est même une partie du processus de création dans l'entreprise d'un écosystème de gestion des accès. Préparez-vous donc à un effort à long terme.
Commençons par définir ce qu'est la gestion des accès basée sur les rôles. Supposons que vous ayez une grande banque avec des dizaines, voire des centaines de milliers d'employés (sujets), chacun ayant des dizaines de droits d'accès dans des centaines de systèmes d'information internes (objets). Multipliez alors le nombre d'objets par le nombre de sujets – c'est le nombre minimum de relations que vous devez d'abord établir, puis contrôler. Est-il vraiment possible de le faire manuellement ? Certainement pas – c'est pour résoudre ce problème qu'ont été créées les rôles.
Un rôle est un ensemble de prérogatives nécessaires à un utilisateur ou à un groupe d'utilisateurs pour accomplir des tâches professionnelles spécifiques. Chaque employé peut avoir un ou plusieurs rôles, et chaque rôle peut contenir une ou plusieurs prérogatives qui sont autorisées à l'utilisateur dans le cadre de ce rôle. Les rôles peuvent être liés à des postes spécifiques, des départements ou des tâches fonctionnelles des employés.
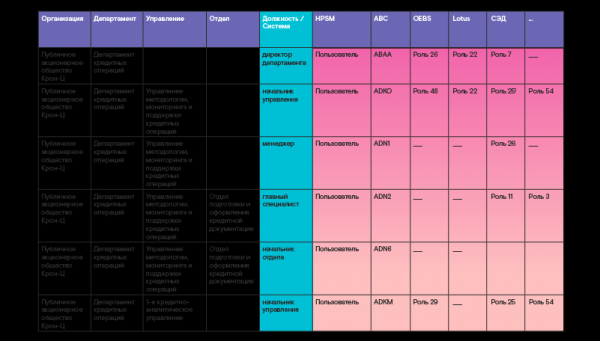
Les rôles sont généralement créés à partir des droits individuels des employés dans chaque système d'information. Ensuite, les rôles de chaque système forment des rôles métiers globaux. Par exemple, le rôle métier de « gestionnaire de crédit » comprendra plusieurs rôles distincts dans les systèmes d'information utilisés dans le bureau des clients de la banque. Prenons ceux tels que le système bancaire automatisé principal, le module de caisse, le système de gestion documentaire électronique, le gestionnaire de services, et d'autres. Les rôles métiers sont généralement liés à la structure organisationnelle - en d'autres termes, à l'ensemble des divisions de l'entreprise et des postes qu'elles contiennent. Cela forme une matrice de rôles globale (un exemple est donné dans le tableau ci-dessous).
Il convient de noter qu'il est impossible de construire un modèle de rôle à 100 %, en fournissant tous les droits nécessaires aux employés de chaque poste dans une structure commerciale. Et ce n'est même pas nécessaire. En effet, un modèle de rôle ne peut pas être statique, car il dépend d'environnements en constante évolution. Cela est dû aux changements dans les activités commerciales de l'entreprise, qui influencent à leur tour la structure organisationnelle et les fonctions. À l'absence de ressources complètes, au non-respect des instructions de travail, à la recherche de profit au détriment de la sécurité, et à de nombreux autres facteurs. Par conséquent, il faut construire un modèle de rôle capable de couvrir jusqu'à 80 % des besoins des utilisateurs en droits de base nécessaires lors de leur nomination à un poste. Les 20 % restants pourront être demandés ultérieurement par des demandes spécifiques si nécessaire.
Bien sûr, vous pouvez demander : « Existe-t-il des modèles de rôle à 100 % ? » Eh bien, cela se produit, par exemple, dans des structures non commerciales qui ne sont pas sujettes à des changements fréquents, comme dans un institut de recherche. Ou dans des organisations de l'industrie de la défense avec un niveau de sécurité élevé, où la sécurité est primordiale. Cela peut également se voir dans une structure commerciale, mais dans le cadre d'une division spécifique dont le fonctionnement est un processus assez statique et prévisible.
Le principal avantage de la gestion des rôles est la simplification de l'octroi des droits, car le nombre de rôles est bien inférieur à celui des utilisateurs du système d'information. Et cela s'applique à tous les secteurs.
Prenons une entreprise de détail : elle emploie des milliers de vendeurs, mais l'ensemble des droits dans le système N est identique, et pour eux, un seul rôle sera créé. Un nouveau vendeur arrive dans l'entreprise – il se voit automatiquement attribuer le rôle nécessaire dans le système, qui contient déjà tous les pouvoirs requis. Il est également possible de modifier en un clin d'œil les droits pour des milliers de vendeurs à la fois, par exemple, en ajoutant une nouvelle option pour générer un rapport. Il n'est pas nécessaire d'effectuer mille opérations en associant le nouveau droit à chaque compte – il suffit d'ajouter cette option au rôle, et elle sera disponible pour tous les vendeurs simultanément.
Un autre avantage de la gestion par rôle est l'évitement de l'attribution de pouvoirs incompatibles. Cela signifie qu'un employé ayant un certain rôle dans le système ne peut pas simultanément posséder un autre rôle dont les droits ne doivent pas s'associer avec ceux du premier. Un exemple frappant est l'interdiction de la combinaison des fonctions d'entrée et de contrôle d'une opération financière.
Tous ceux qui s'intéressent à l'apparition de la gestion des accès par rôle peuvent
plonger dans un aperçu historique
Si l'on se tourne vers l'histoire, on constate que pour la première fois, la communauté informatique s'est interrogée sur les méthodes de gestion des accès dès les années 70 du XXe siècle. Bien que les applications fussent alors assez simples, tout le monde souhaitait, comme aujourd'hui, gérer commodément l'accès à celles-ci. Accorder, modifier et contrôler les droits des utilisateurs – juste pour mieux comprendre quel accès chacun d'eux avait. Mais à l'époque, il n'existait aucun standard commun, les premiers systèmes de gestion des accès étaient en cours de développement, et chaque entreprise se basait sur ses propres conceptions et règles.
À l'heure actuelle, de nombreux modèles de gestion des accès sont connus, mais ils n'ont pas émergé immédiatement. Concentrons-nous sur ceux qui ont apporté une contribution significative à ce domaine.
Le premier et probablement le plus simple modèle est le Contrôle d'accès discrétionnaire (DAC) (DAC – Contrôle d'accès discrétionnaire). Ce modèle implique le partage des droits par tous les participants au processus d'accès. Chaque utilisateur a accès à des objets ou opérations spécifiques. En essence, ici, le nombre de sujets de droit correspond à un nombre multiple d'objets. Ce modèle a été jugé trop flexible et trop complexe à gérer : les listes d'accès deviennent au fil du temps énormes et difficiles à contrôler.
Le deuxième modèle est le Contrôle d'accès obligatoire (MAC — Mandatory access control). Dans ce modèle, chaque utilisateur a accès à un objet en fonction de l'autorisation formelle accordée pour un certain niveau de confidentialité des données. Par conséquent, les objets doivent être catégorisés par niveau de confidentialité. Contrairement au premier modèle flexible, celui-ci s'est révélé trop strict et restrictif. Son application n'est pas justifiée lorsque l'entreprise dispose de nombreuses ressources d'information variées : pour restreindre l'accès à différentes ressources, il faut introduire de nombreuses catégories qui ne se croiseront pas.
En raison des évidentes imperfections de ces deux méthodes, la communauté informatique a poursuivi le développement de modèles plus flexibles et plus ou moins universels pour soutenir différents types de politiques organisationnelles de contrôle d'accès. C'est alors qu'est apparu le troisième modèle de gestion des accès basé sur les rôles ! Cette approche s'est révélée la plus prometteuse, car elle nécessite non seulement l'autorisation de l'identité de l'utilisateur, mais aussi de ses fonctions professionnelles dans les systèmes.
La première structure de modèle de rôle clairement décrite a été proposée par des chercheurs américains, David Ferraiolo et Richard Kuhn, du National Institute of Standards and Technology des États-Unis, en 1992. C'est alors que le terme RBAC (contrôle d'accès basé sur les rôles). Ces recherches et descriptions des composants principaux, ainsi que leurs interactions, ont servi de base à la norme actuelle INCITS 359-2012, adoptée par le comité international des normes en technologies de l'information (INCITS).
La norme définit le rôle comme « une fonction dans le contexte d'une organisation avec une certaine sémantique associée aux pouvoirs et aux responsabilités qui incombent à l'utilisateur désigné pour ce rôle ». Le document établit les éléments de base de RBAC - utilisateurs, sessions, rôles, autorisations, opérations et objets, ainsi que les relations et interrelations entre eux.
La norme fournit la structure minimale nécessaire pour construire un modèle de rôle - réunir des droits dans des rôles, puis accorder l'accès aux utilisateurs via ces rôles. Elle désigne les mécanismes de composition des rôles à partir d'objets et d'opérations, décrit la hiérarchie des rôles et l'héritage des pouvoirs. En effet, dans toute entreprise, il existe des rôles rassemblant des pouvoirs élémentaires nécessaires à tous les employés. Cela peut inclure l'accès à la messagerie électronique, à la GED, au portail d'entreprise, etc. Ces pouvoirs peuvent être regroupés dans un rôle général appelé « employé », ce qui évite d'avoir à lister à chaque fois tous les droits élémentaires dans les rôles de niveau supérieur. Il suffit de spécifier l'attribut d'héritage du rôle « employé ».
Plus tard, la norme a été enrichie de nouveaux attributs d'accès liés à un environnement en constante évolution. La possibilité d'introduire des restrictions statiques et dynamiques a été ajoutée. Les restrictions statiques impliquent l'impossibilité de combiner des rôles (le fameux contrôle des opérations mentionné plus haut). Les restrictions dynamiques peuvent être définies par des paramètres changeants, tels que le temps (heures ou jours ouvrables/non ouvrables), la localisation (bureau/maison), etc.
Il convient de mentionner séparément la gestion des accès basée sur les attributs (ABAC — Attribute-based access control). Cette approche repose sur l'octroi d'accès via des règles de partage d'attributs. Ce modèle peut être utilisé seul, mais il complète souvent le modèle de rôle classique : il est possible d'ajouter des attributs d'utilisateurs, de ressources et de dispositifs à un rôle déterminé, ainsi que des paramètres de temps ou de localisation. Cela permet d'utiliser moins de rôles, d'introduire des restrictions supplémentaires et de rendre l'accès minimalement suffisant, ce qui améliore par conséquent la sécurité.
Par exemple, on peut autoriser un comptable à accéder aux comptes s'il travaille dans une région spécifique. Dans ce cas, la localisation du spécialiste sera comparée à une valeur référentielle définie. On peut également accorder l'accès aux comptes uniquement si l'utilisateur s'authentifie à partir d'un appareil enregistré dans la liste des autorisations. C'est un bon complément au modèle de rôle, mais il n'est pas souvent utilisé seul en raison de la nécessité de créer de nombreuses règles et tableaux d'autorisations ou de restrictions.
Voici un exemple d'application de l'ABAC de ma « vie précédente ». Dans notre banque, il y avait plusieurs agences. Les employés des bureaux clients de ces agences effectuaient des opérations tout à fait identiques, mais devaient travailler dans le système principal uniquement avec les comptes de leur région. Au début, nous avons commencé à créer des rôles distincts pour chaque région – et il y avait énormément de ces rôles avec une fonctionnalité répétitive, mais avec un accès à différents comptes ! Ensuite, en utilisant l'attribut de localisation pour l'utilisateur et en le liant à une plage de comptes spécifique pour vérification, nous avons considérablement réduit le nombre de rôles dans le système. En conséquence, il ne restait que des rôles pour une seule agence, qui étaient dupliqués pour les postes correspondants dans toutes les autres subdivisions territoriales de la banque.
Et maintenant, parlons des étapes préparatoires nécessaires, sans lesquelles il est tout simplement impossible de construire un modèle de rôle fonctionnel.
Étape 1. Créons un modèle fonctionnel
Il est important de commencer par créer un modèle fonctionnel, un document de haut niveau dans lequel la fonctionnalité de chaque département et de chaque poste est décrite en détail. En général, les informations proviennent de divers documents tels que les descriptions de poste et les règlements relatifs aux départements, divisions et services. Le modèle fonctionnel doit être validé par tous les départements concernés (gestion, contrôle interne, sécurité) et approuvé par la direction de l'entreprise. À quoi sert ce document ? Pour que le modèle de rôle puisse s'y référer. Par exemple, si vous prévoyez de construire un modèle de rôle basé sur les droits des employés existants, extraits du système et « harmonisés ». Ensuite, lors de la validation des rôles obtenus avec le propriétaire commercial du système, il est possible de se référer à un point particulier du modèle fonctionnel, sur la base duquel un droit spécifique est inclus dans le rôle.
Étape 2. Audit des systèmes informatiques et établissement d'un plan de priorisation
À ce stade, il est nécessaire de réaliser un audit des systèmes informatiques pour comprendre comment l'accès à ces derniers est organisé. Par exemple, dans ma société financière, plusieurs centaines de systèmes d'information étaient en service. Tous ces systèmes possédaient des éléments d’une gestion des rôles, la plupart du temps sous forme de rôles, mais souvent sur papier ou dans le registre du système – ils étaient devenus obsolètes, et l'accès y était accordé sur la base des demandes des utilisateurs. Naturellement, il est impossible de construire un modèle de rôle instantanément pour plusieurs centaines de systèmes, il faut par où commencer. Nous avons réalisé une analyse approfondie du processus de gestion des accès pour déterminer son niveau de maturité. Au cours de cette analyse, nous avons établi des critères de priorisation des systèmes d'information : criticité, préparation, plans de désaffectation, etc. Grâce à ceux-ci, nous avons construit une séquence pour le développement/la mise à jour des modèles de rôles pour ces systèmes. Puis nous avons intégré les modèles de rôles dans le plan d'intégration avec la solution de gestion des identités, afin d'automatiser la gestion des accès.
Alors, comment déterminer la criticité d'un système ? Répondez aux questions suivantes :
- Le système est-il lié aux processus opérationnels dont dépend l'activité essentielle de l'entreprise ?
- Un dysfonctionnement du système affectera-t-il l'intégrité des actifs de l'entreprise ?
- Quel est le temps d'arrêt maximal acceptable pour le système, au-delà duquel il est impossible de rétablir l'activité après une interruption ?
- Une atteinte à l'intégrité des informations dans le système peut-elle entraîner des conséquences irréversibles, tant financières que réputationnelles ?
- Criticité face à la fraude. La présence d'une fonctionnalité, dont le contrôle insuffisant pourrait permettre des actions frauduleuses internes / externes ;
- Quelles sont les exigences législatives ainsi que les règles et procédures internes relatives à ces systèmes ? Y aura-t-il des amendes de la part des régulateurs en cas de non-respect ?
Dans notre entreprise financière, nous avons effectué l'audit de cette manière. La direction a développé une procédure d'audit Access Right Review pour examiner les utilisateurs existants et leurs droits, en commençant par les systèmes d'information figurant sur la liste des plus prioritaires. La sécurité a été désignée comme responsable de ce processus. Mais pour obtenir une vue d'ensemble des droits d'accès au sein de l'entreprise, il était nécessaire d'impliquer les départements IT et métier dans le processus. Et c'est là que les différends, les malentendus et parfois même le sabotage ont commencé : personne ne veut interrompre ses tâches actuelles pour participer à des activités qui, à première vue, semblent incompréhensibles.
N.B. Les grandes entreprises avec des processus IT développés connaissent sûrement la procédure d'audit IT – les contrôles généraux IT (ITGC), qui permettent d'identifier les défauts dans les processus IT et de mettre en place un contrôle pour améliorer les processus conformément aux meilleures pratiques (ITIL, COBIT, IT Governance, etc.) Cet audit permet à l'IT et au business de mieux se comprendre et de développer une stratégie de développement commune, d'analyser les risques, d'optimiser les coûts et de développer des approches de travail plus efficaces.
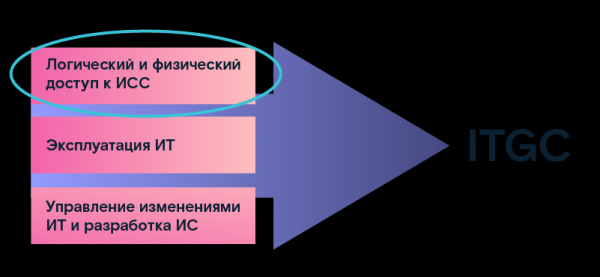
L'un des axes de l'audit est de déterminer les paramètres d'accès logique et physique aux systèmes d'information. Les données obtenues ont servi de base pour une utilisation ultérieure dans la construction du modèle de rôle. À la suite de cet audit, nous avons établi un registre des systèmes informatiques, dans lequel leurs paramètres techniques ont été définis et des descriptions fournies. De plus, pour chaque système, un propriétaire a été désigné au sein de la direction commerciale, dans l'intérêt de laquelle il était exploité : c'est lui qui était responsable des processus commerciaux que ce système servait. Un responsable des services informatiques a également été nommé, chargé de la mise en œuvre technique des besoins de l'entreprise dans le système d'information spécifique. Les systèmes les plus critiques pour l'entreprise ont été identifiés, ainsi que leurs paramètres techniques, les délais de mise en service et de retrait, etc. Ces paramètres ont été très utiles dans le processus de préparation à la construction du modèle de rôle.
Étape 3 Créer la méthodologie
La clé du succès de toute entreprise est une méthode choisie correctement. C'est pourquoi, tant pour la construction du modèle de rôle que pour la réalisation de l'audit, nous devons créer une méthodologie dans laquelle nous décrirons l'interaction entre les départements, établirons des responsabilités dans les règlements de l'entreprise, etc.
Pour commencer, il est nécessaire d'examiner tous les documents disponibles qui établissent l'ordre d'octroi d'accès et de droits. Idéalement, les processus doivent être documentés à plusieurs niveaux :
- exigences générales de l'entreprise ;
- exigences pour les domaines de la sécurité de l'information (en fonction des domaines d'activité de l'organisation) ;
- exigences pour les processus technologiques (instructions, matrices d'accès, directives méthodologiques, exigences de configuration).
Dans notre entreprise financière, nous avons découvert de nombreux documents obsolètes - il a fallu les mettre en conformité avec les nouveaux processus mis en œuvre.
Sur ordre de la direction, un groupe de travail a été formé, composé de représentants des départements de sécurité, des TI, des affaires et du contrôle interne. Les objectifs de création du groupe, ses domaines d'activité, sa durée d'existence et les responsables de chaque côté ont été définis dans l'ordre. De plus, nous avons élaboré une méthodologie pour mener des audits et établir un modèle de rôle : ceux-ci ont été approuvés par tous les représentants responsables des départements et validés par la direction de l'entreprise.
Les documents décrivant la procédure de travail, les délais, les responsabilités, etc. sont la clé pour s'assurer qu'aucune question ne surgisse sur « pourquoi faisons-nous cela, pourquoi en avons-nous besoin, etc. » sur le chemin de l'objectif souhaité, qui au départ n'est pas évident pour tous, et qu'il n'y aura pas d'opportunité de « dévier » ou de ralentir le processus.
Étape 4. Nous fixons les paramètres du modèle de gestion des accès existant
Nous établissons ce que l'on appelle le « passeport du système » en ce qui concerne la gestion des accès. En substance, il s'agit d'un questionnaire relatif à un système d'information spécifique, dans lequel tous les algorithmes de gestion des accès y sont consigné. Les entreprises ayant déjà mis en œuvre des solutions de type IdM sont sans doute familières avec ce genre de questionnaire, car c'est par là que commence l'étude des systèmes.
Une partie des paramètres sur le système et les propriétaires a été intégrée au questionnaire à partir du registre des TI (voir étape 2, audit), mais de nouveaux éléments ont été ajoutés :
- comment la gestion des comptes utilisateur est effectuée (directement dans la base de données ou via des interfaces de programmation) ;
- comment les utilisateurs se connectent au système (avec un compte séparé ou en utilisant un compte AD, LDAP ou autre) ;
- quels niveaux d'accès au système sont utilisés (niveau application, niveau système, utilisation des ressources de fichiers de réseau par le système) ;
- description et paramètres serveurs, sur lesquels le système fonctionne ;
- quelles opérations de gestion des comptes utilisateur sont prises en charge (blocage, renommage, etc.) ;
- selon quels algorithmes ou règles l'identifiant de l'utilisateur du système est-il généré ;
- selon quel attribut peut-on établir un lien avec l'enregistrement d'un employé dans le système de paie (nom complet, numéro de badge ou autre) ;
- tous les attributs possibles de l'enregistrement et les règles de leur remplissage ;
- quels droits d'accès existent dans le système (rôles, groupes, droits atomiques, etc., y a-t-il des droits imbriqués ou hiérarchiques) ;
- mécanismes de séparation des droits d'accès (par poste, département, fonction, etc.);
- y a-t-il des règles de séparation des droits (SOD - Segregation of Duties) dans le système et comment fonctionnent-elles;
- comment le système traite-t-il les événements d'absence, de transfert, de départ, de mise à jour des données sur les employés, etc.
Nous pouvons continuer cette liste en détaillant divers paramètres et autres objets impliqués dans le processus de gestion des accès.
Étape 5. Création d'une description orientée métier des pouvoirs
Un autre document dont nous aurons besoin pour construire le modèle de rôle est un répertoire de tous les pouvoirs (droits) possibles à accorder aux utilisateurs dans le système d'information, avec une description détaillée de la fonction métier qui sous-tend chacun. Souvent, les pouvoirs dans le système sont codés par des noms spécifiques composés de lettres et de chiffres, ce qui rend leur compréhension difficile pour les employés de l'entreprise. Ils se tournent alors vers le service informatique, mais là… il est également difficile de répondre à des questions concernant, par exemple, des droits peu utilisés. Il est alors nécessaire de procéder à des tests supplémentaires.
Il est préférable que la description métier existe déjà ou qu'il y ait au moins une consolidation de ces droits en groupes et rôles. Pour certaines applications, il est recommandé de créer un tel répertoire dès la phase de développement. Cependant, cela est rare, donc nous retournons au service informatique pour rassembler des informations sur tous les droits possibles et les décrire. Notre répertoire contiendra au final ce qui suit:
- nom du pouvoir, y compris l'objet auquel le droit d'accès s'applique;
- action autorisée avec l'objet ( consultation, modification, etc., possibilité de restriction, par exemple, selon le critère territorial ou le groupe de clients);
- code du pouvoir (code et nom de la fonction / demande système pouvant être exécutée avec ce pouvoir);
- description du pouvoir (description détaillée des actions dans le SI lors de l'application du pouvoir et de leurs conséquences pour le processus;
- statut du pouvoir : "Actif" (si le pouvoir est attribué à au moins un utilisateur) ou "Inactif" (si le pouvoir n'est pas utilisé).
Étape 6 Exporter les données des utilisateurs et des droits des systèmes et les comparer à la source des ressources humaines
À l'étape finale de la préparation, il est nécessaire d'extraire les données des systèmes d'information concernant tous les utilisateurs et les droits qu'ils possèdent actuellement. Deux scénarios sont possibles. Premier : le département de la sécurité a un accès direct au système et dispose des moyens pour extraire les rapports correspondants, ce qui est rare, mais très pratique. Deuxième : nous envoyons une demande au service informatique pour obtenir les rapports au format requis. La pratique montre qu'il est souvent difficile de s'arranger avec le service informatique et d'obtenir les données nécessaires dès le premier coup. Il faut plusieurs tentatives avant que l'information soit obtenue dans le format souhaité.
Quelles données doivent être extraites :
- Nom du compte
- Nom et prénom de l'employé auquel il est associé
- Statut (actif ou bloqué)
- Date de création du compte
- Date de la dernière utilisation
- Liste des droits/groupes/rôles disponibles
Ainsi, nous avons obtenu des extractions du système avec tous les utilisateurs et tous les droits qui leur sont accordés. Nous avons immédiatement mis de côté tous les comptes bloqués, car le travail de construction du modèle de rôle ne sera effectué que pour les utilisateurs actifs.
Ensuite, si votre entreprise ne dispose pas de moyens automatisés pour fermer l'accès aux employés licenciés (ce qui est assez fréquent) ou que vous avez une automatisation éparse qui ne fonctionne pas toujours correctement, il est nécessaire d'identifier toutes les « âmes mortes ». Cela concerne les comptes des employés déjà licenciés dont les droits ne sont, pour une raison quelconque, pas bloqués – il faut les bloquer. Pour cela, nous comparons les données extraites avec la source des ressources humaines. L'extraction des données RH doit également être obtenue au préalable auprès de l'entité qui gère la base de données des employés.
Il est nécessaire de mettre de côté les comptes dont les propriétaires ne figurent pas dans la base de données du personnel, c'est-à-dire ceux qui ne sont attribués à personne, donc sans propriétaire. Pour cette liste, nous aurons besoin de la date de la dernière utilisation : si elle est relativement récente, il faudra tout de même chercher les propriétaires. Cela peut inclure des comptes de sous-traitants externes ou des comptes de service, non attribués à quiconque, mais associés à certains processus. Pour déterminer la propriété des comptes, nous pouvons envoyer des courriels à tous les départements en leur demandant de se manifester. Lorsque les propriétaires sont identifiés, nous enregistrons leurs informations dans le système : ainsi, tous les comptes actifs sont identifiés, et nous bloquons les autres.
Une fois que nos exports sont dépouillés des enregistrements superflus et qu'il ne reste que des comptes actifs, nous pouvons commencer à établir le modèle de rôle pour un système d'information spécifique. Mais je vous en parlerai dans le prochain article.
Auteur : Lioudmila Sévastyanova, responsable marketing Solar inRights
Source : habr.com
