

Déchiffrement de la présentation de Bruce Momjian en 2020 "Déverrouiller le gestionnaire de verrouillage Postgres".
(Remarque : Toutes les requêtes SQL des diapositives peuvent être obtenues à ce lien : )
Bonjour ! C'est formidable d'être à nouveau ici en Russie. Je m'excuse de ne pas avoir pu venir l'année dernière, mais cette année, Ivan et moi avons de grands projets. J'espère être ici beaucoup plus souvent. J'adore venir en Russie. Je vais visiter Tyumen et Tver. Je suis très heureux d'avoir la chance de visiter ces villes.
Je m'appelle Bruce Momjian. Je travaille chez EnterpriseDB et j'utilise Postgres depuis plus de 23 ans. Je vis à Philadelphie, aux États-Unis. Je voyage environ 90 jours par an et assiste à environ 40 conférences. Mon , qui contient les diapositives que je vais vous montrer maintenant. Donc, après la conférence, vous pourrez les télécharger depuis mon site personnel. Il contient également environ 30 présentations. Il y a aussi des vidéos et un grand nombre d'articles de blog, plus de 500. C'est une ressource assez riche. Et si ce matériel vous intéresse, je vous invite à en profiter.
J'ai été enseignant, professeur avant de commencer à travailler avec Postgres. Et je suis très heureux de pouvoir vous parler de ce que je m'apprête à vous expliquer. C'est une de mes présentations les plus intéressantes. Cette présentation contient 110 diapositives. Nous commencerons par des choses simples, et à la fin, la présentation deviendra de plus en plus complexe et assez difficile.
C'est une conversation plutôt désagréable. La gestion des verrouillages n'est pas un sujet populaire. Nous voulons que cela disparaisse. C'est comme aller chez le dentiste.
- Le verrouillage est un problème pour beaucoup de personnes qui travaillent avec des bases de données où plusieurs processus fonctionnent en même temps. Ils ont besoin de verrouillage. Donc, aujourd'hui je vais vous donner les connaissances de base sur le verrouillage.
- Identifiants de transactions. C'est une partie assez ennuyeuse de la présentation, mais il est nécessaire de les comprendre.
- Ensuite, nous parlerons des types de verrouillage. C'est une partie assez mécanique.
- Et après cela, nous fournirons quelques exemples de verrouillage. Et cela sera assez difficile à comprendre.
Parlons des verrouillages.
La terminologie est assez complexe chez nous. Combien d'entre vous savent d'où provient cet extrait ? Deux personnes. C'est tiré d'un jeu qui s'appelle « L'énorme aventure dans la grotte ». C'était un jeu vidéo textuel dans les années 80, je crois. Il fallait entrer dans une grotte, dans un labyrinthe, et le texte changeait, mais le contenu restait à peu près le même à chaque fois. C'est ainsi que je me souviens de ce jeu.
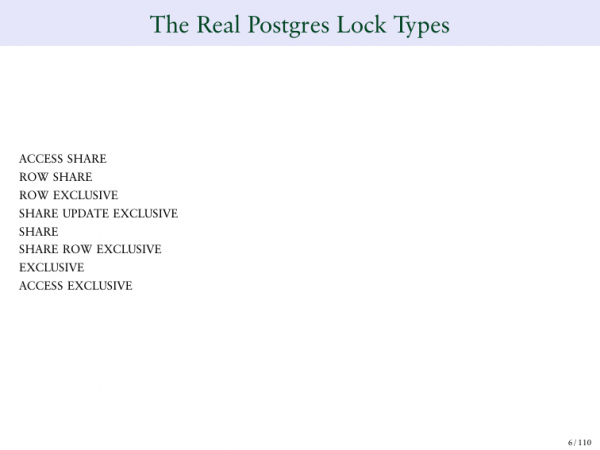
Et ici, nous voyons les noms des verrouillages qui nous viennent d'Oracle. Nous les utilisons.
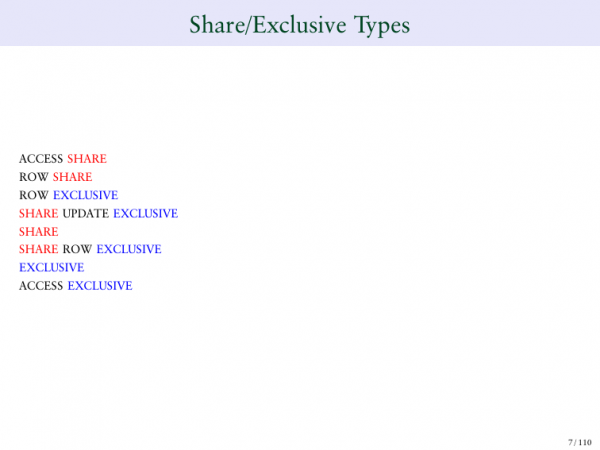
Ici, nous voyons des termes qui me déroutent. Par exemple, SHARE UPDATE EXCLUSIVE. Ensuite, SHARE RAW EXCLUSIVE. Honnêtement, ces noms ne sont pas très clairs. Nous allons essayer de les examiner plus en détail. Certains contiennent le mot « share », qui signifie — se séparer. Certains contiennent le mot « exclusive » — exclusif. Certains contiennent ces deux mots. Je voudrais commencer par expliquer comment fonctionnent ces verrouillages.
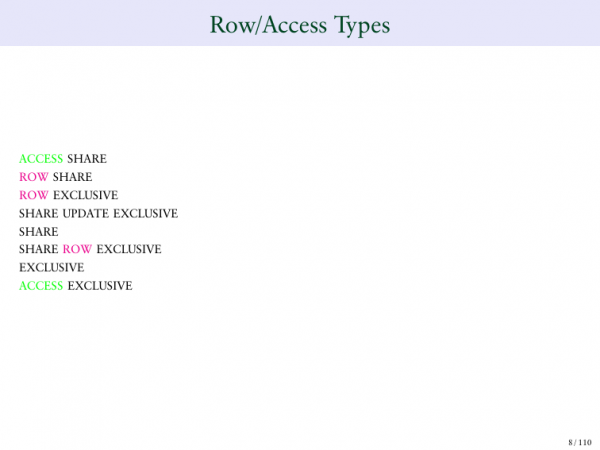
Il est également très important de comprendre le mot « accès » — access. Et le mot « row » — ligne. C'est-à-dire la répartition des accès, la répartition des lignes.
Un autre problème à comprendre dans Postgres, je ne pourrai malheureusement pas en parler lors de ma présentation, c'est le MVCC. J'ai une présentation distincte sur ce sujet sur mon site web. Et si vous pensez que cette présentation est complexe, le MVCC est probablement ma plus compliquée. Et si ça vous intéresse, vous pouvez la voir sur le site. Vous pouvez regarder la vidéo.
Un autre point à comprendre, ce sont les identifiants de transaction. De nombreuses transactions ne peuvent pas fonctionner sans identifiants uniques. Et ici, nous avons une explication de ce qu'est une transaction. Dans Postgres, il y a deux systèmes de numérotation des transactions. Je sais que ce n'est pas une solution très élégante.
Gardez également à l'esprit que les diapositives seront assez complexes à comprendre, donc il faut prêter attention à ce qui est marqué en rouge, c'est justement sur cela qu'il faut se concentrer.
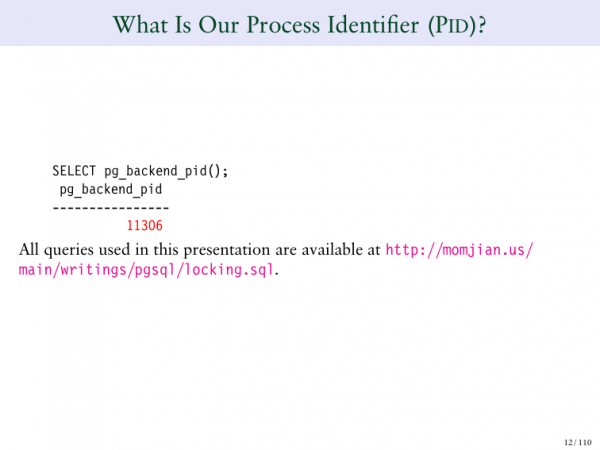
Regardons. Le numéro de la transaction est en rouge. Ici, la fonction SELECT pg_back est montrée. Elle renvoie ma transaction et l'ID de cette transaction.
Une autre chose, si vous aimez cette présentation et souhaitez l'exécuter dans votre base de données, vous pouvez suivre ce lien en rose et télécharger le SQL pour cette présentation. Et vous pouvez simplement l’exécuter dans votre PSQL, et toute la présentation apparaîtra sur votre écran immédiatement. Elle ne contiendra pas de couleurs, mais au moins nous pourrons la voir.
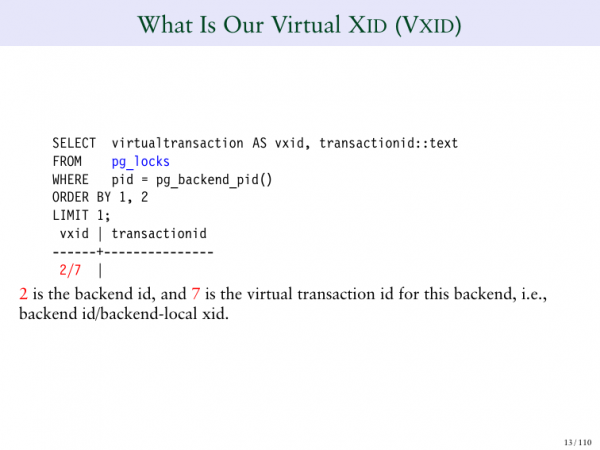
Dans ce cas, nous voyons l'ID de la transaction. C'est le numéro que nous lui avons attribué. Il existe également un autre type d'ID de transaction dans Postgres, appelé ID de transaction virtuel.
Et nous devons comprendre cela. C'est très important, sinon nous ne pourrons pas comprendre le blocage dans Postgres.
L'ID de transaction virtuel est celui d'une transaction qui ne contient pas de valeurs permanentes. Par exemple, si j'exécute une commande SELECT, je ne vais probablement pas changer la base de données, je ne vais rien bloquer. Ainsi, lorsque nous exécutons un simple SELECT, nous ne donnons pas à cette transaction un ID permanent. Nous lui attribuons seulement un ID virtuel.
Et cela améliore les performances de Postgres, améliore les capacités de nettoyage, donc l'ID de transaction virtuel est composé de deux nombres. Le premier nombre avant la barre oblique est l'ID du backend. À droite, nous voyons simplement un compteur.
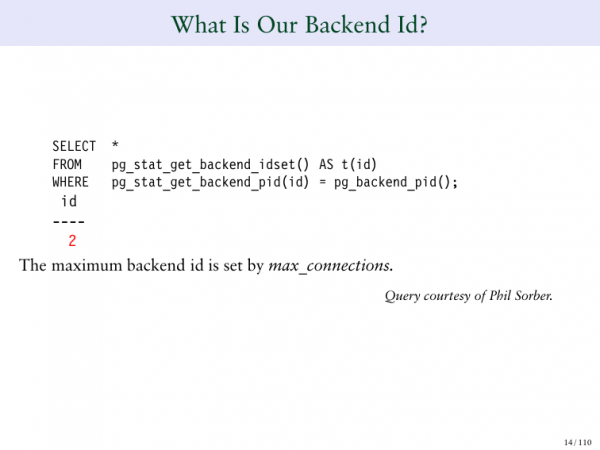
Donc, si j'exécute une requête, il indique que l'ID du backend est 2.
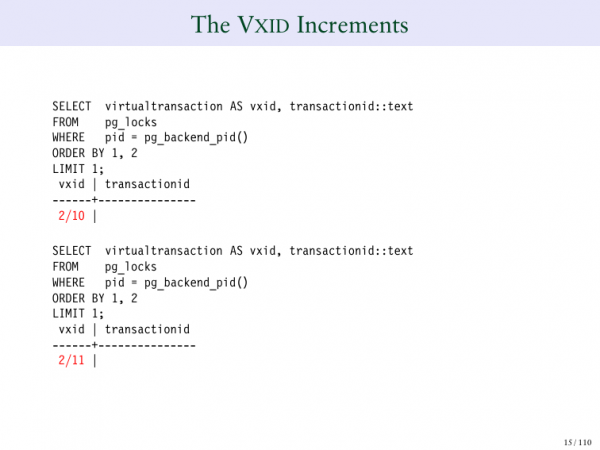
Et si j'exécute une série de telles transactions, nous voyons que le compteur augmente chaque fois que j'exécute une requête. Par exemple, lorsque j'exécute les requêtes 2/10, 2/11, 2/12, etc.
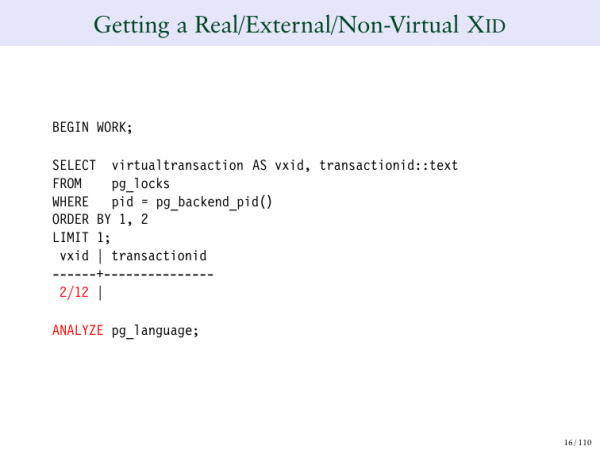
Notez qu'il y a deux colonnes ici. À gauche, nous avons l'ID de transaction virtuel – 2/12. Et à droite, nous avons l'ID de transaction permanent. Et ce champ est vide. Cette transaction ne modifie pas la base de données. Donc, je ne lui attribue pas d'ID de transaction permanent.
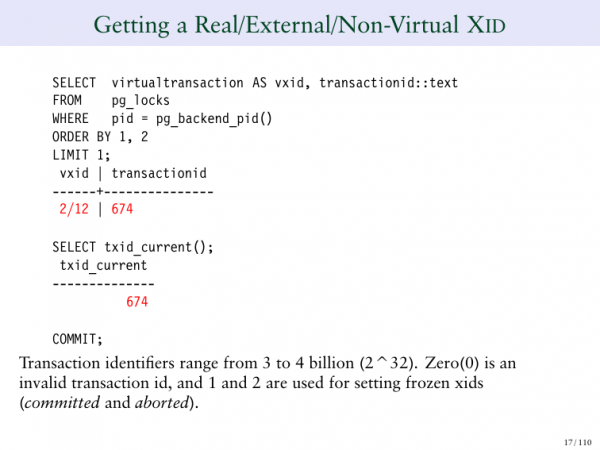
Dès que j'exécute la commande d'analyse (ANALYZE), la même requête me donne un ID de transaction permanent. Regardez comment cela a changé. Auparavant, je n'avais pas cet ID, maintenant il est apparu.
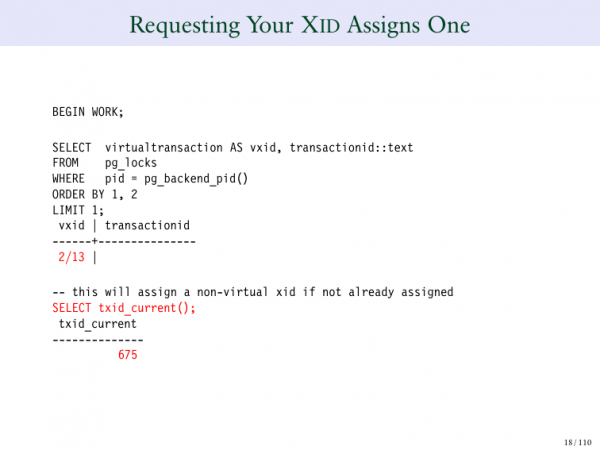
Donc, ici encore une fois une requête, une autre transaction. Le numéro de transaction virtuel est 2/13. Et si je demande l'ID de transaction permanent, lorsque j'exécute la requête, je l’obtiendrai.
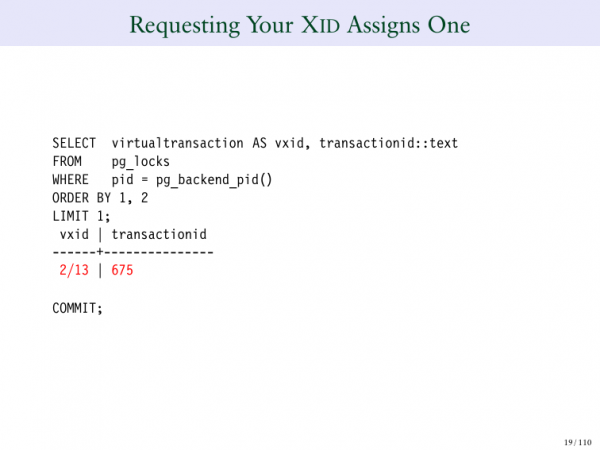
Donc, encore une fois. Nous avons l'ID de transaction virtuel et l'ID de transaction permanent. Comprenez simplement ce point pour comprendre le comportement de Postgres.
Nous passons à la troisième section. Ici, nous allons simplement passer en revue les différents types de verrouillages dans Postgres. Ce n'est pas très intéressant. La dernière section sera beaucoup plus captivante. Mais nous devons aborder les bases, sinon nous ne comprendrons pas ce qui suit.
Nous allons parcourir cette section, en observant chaque type de verrouillage. Je vais vous montrer des exemples de la façon dont ils sont définis, comment ils fonctionnent, et vous montrer quelques requêtes que vous pouvez utiliser pour voir comment fonctionne le verrouillage dans Postgres.
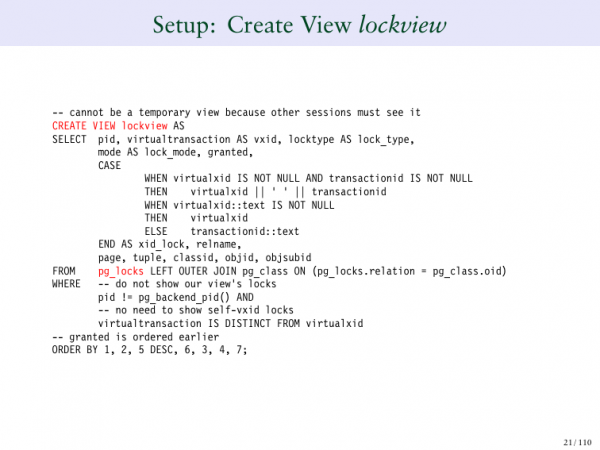
Pour créer une requête et voir ce qui se passe dans Postgres, nous devons exécuter une requête dans la vue système. Dans ce cas, pg_lock est mis en évidence en rouge. Pg_lock est une table système qui nous indique quels verrouillages sont actuellement utilisés dans Postgres.
Cependant, il m'est très difficile de vous montrer pg_lock en soi, car c'est assez complexe. C'est pourquoi j'ai créé une vue qui montre pg_locks. Elle effectue également un certain travail pour moi, ce qui me permet de mieux comprendre. C'est-à-dire qu'elle exclut mes verrouillages, ma propre session, etc. C'est juste du SQL standard et cela me permet de mieux vous montrer ce qui se passe.
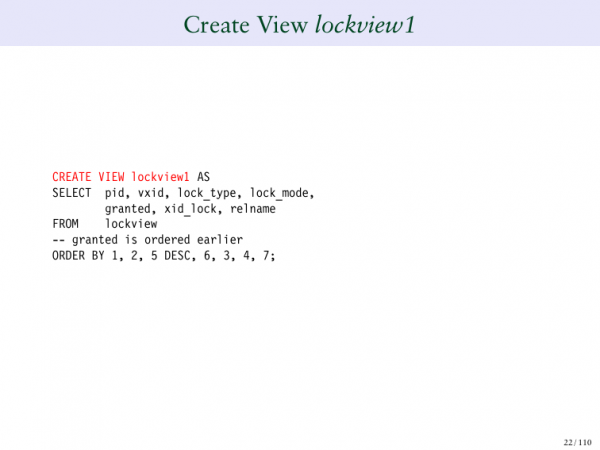
Un autre problème est que cette vue est très large, donc je dois créer une seconde – lockview2.
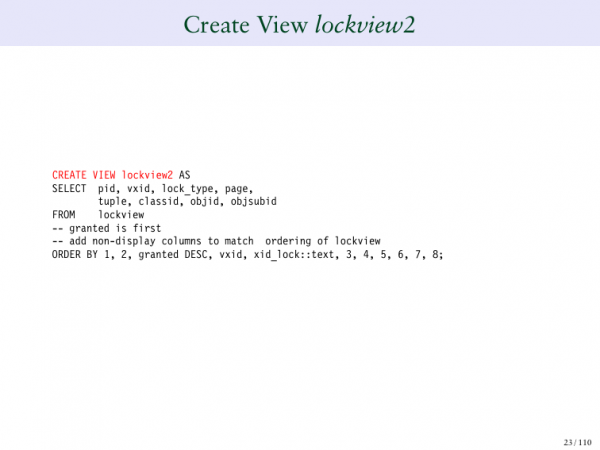 Et cela me montre encore d'autres colonnes de la table. Et une autre, qui me montre les colonnes restantes. C'est assez complexe, donc j'ai essayé de le rendre le plus simple possible.
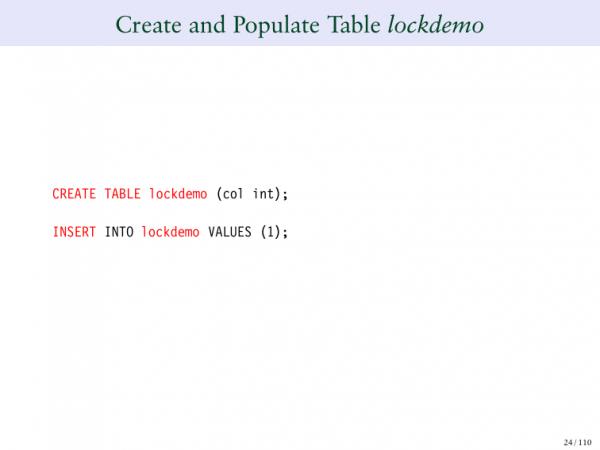
Ainsi, nous avons créé une table appelée Lockdemo. Et nous y avons créé une ligne. C'est notre table d'exemple. Et nous allons créer des sections simplement pour vous montrer des exemples de verrouillages.
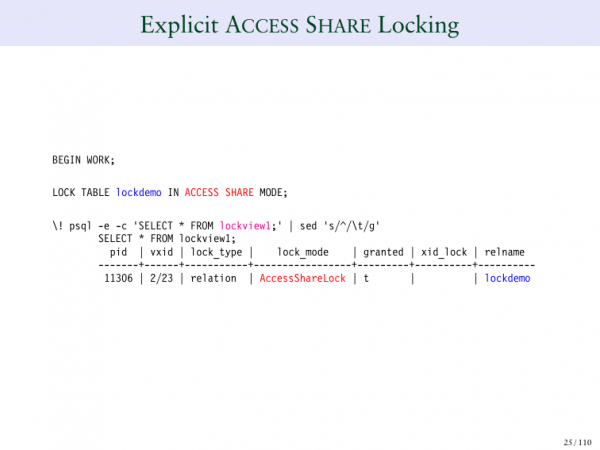
Donc, une ligne, une colonne. Le premier type de verrouillage s'appelle ACCESS SHARE. C'est le verrouillage le moins restrictif. Cela signifie qu'il ne conflit pratiquement pas avec les autres verrouillages.
Et si nous voulons explicitement définir le verrouillage, nous lançons la commande « lock table ». Cela bloquera explicitement, c'est-à-dire que nous exécutons lock table en mode ACCESS SHARE. Et si je lance PSQL en arrière-plan, cela signifie que j'ouvre ainsi une deuxième session à partir de ma première session. Que vais-je faire ici ? Je passe à l'autre session et je lui demande « montre-moi le lockview pour cette requête ». Ici, j'ai AccessShareLock dans cette table. C'est exactement ce que j'ai demandé. Et il indique que le verrou a été attribué. C'est très simple.
Ensuite, si nous regardons la deuxième colonne, il n'y a rien. Elles sont vides.
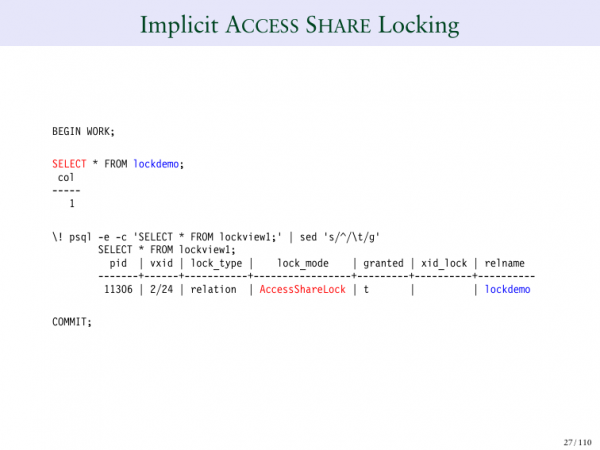
Et si j'exécute la commande « SELECT », c'est une manière implicite (explicite) de demander AccessShareLock. Alors je libère ma table et j'exécute la requête, et celle-ci retourne plusieurs lignes. Dans l'une des lignes, nous voyons AccessShareLock. Ainsi, SELECT appelle AccessShareLock dans la table. Et cela ne crée pratiquement aucun conflit, car il s'agit d'un verrouillage de bas niveau.
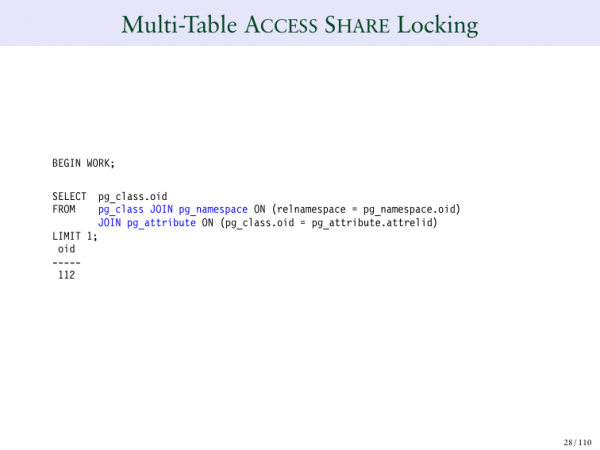
Que se passe-t-il si je lance SELECT et que j'ai trois tables différentes ? Auparavant, je n'exécutais qu'une seule table, maintenant j'en exécute trois : pg_class, pg_namespace et pg_attribute.
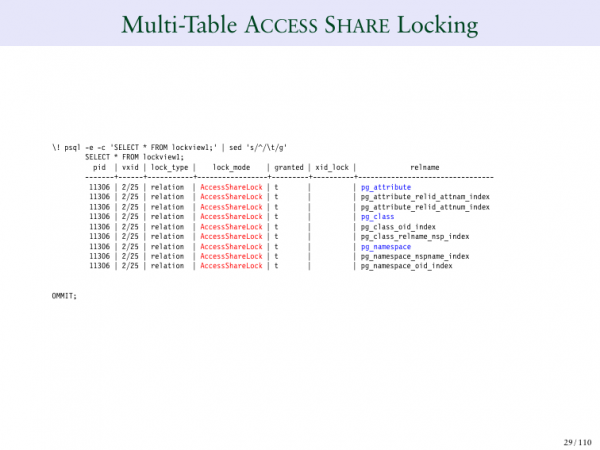
Et maintenant, lorsque je regarde la requête, je vois 9 AccessShareLocks dans les trois tables. Pourquoi ? En bleu, trois tables sont mises en évidence : pg_attribute, pg_class, pg_namespace. Mais vous pouvez également voir que tous les index définis à travers ces tables ont également AccessShareLock.
Et c'est un verrou qui ne crée pratiquement pas de conflit avec d'autres. Tout ce qu'il fait, c'est de nous empêcher de réinitialiser la table pendant que nous la sélectionnons. Cela a du sens. C'est-à-dire que si nous choisissons une table et qu'elle disparaît à ce moment-là, ce serait incorrect, donc AccessShare est un verrou faible qui nous dit "ne supprimez pas cette table tant que je travaille dessus".. En essence, c'est tout ce qu'il fait.
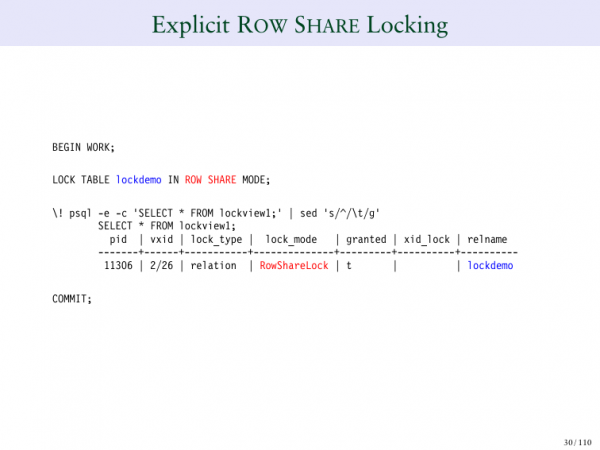
ROW SHARE est un verrou légèrement différent.
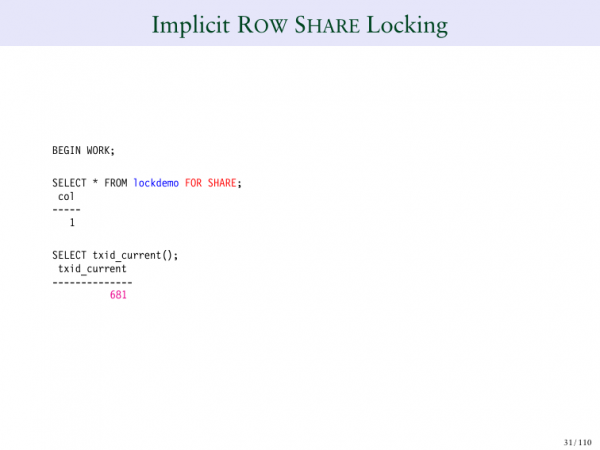
Prenons un exemple. SELECT ROW SHARE bloque chaque ligne individuellement.. Ainsi, personne ne peut les supprimer ou les modifier tant que nous les regardons.
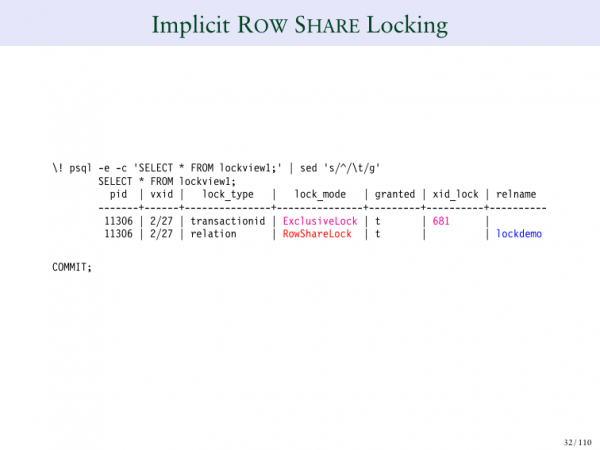 Alors, que fait le SHARE LOCK ? Nous voyons que l'ID de la transaction 681 pour le SELECT. Et c'est intéressant. Que s'est-il passé ici ? Pour la première fois, nous voyons un numéro dans le champ « Lock ». Nous prenons l'ID de la transaction, et il indique qu'il la bloque en mode exclusif. Tout ce qu'il dit, c'est que j'ai une ligne qui est techniquement bloquée quelque part dans la table. Mais il ne dit pas où exactement. Un peu plus tard, nous examinerons cela plus en détail.
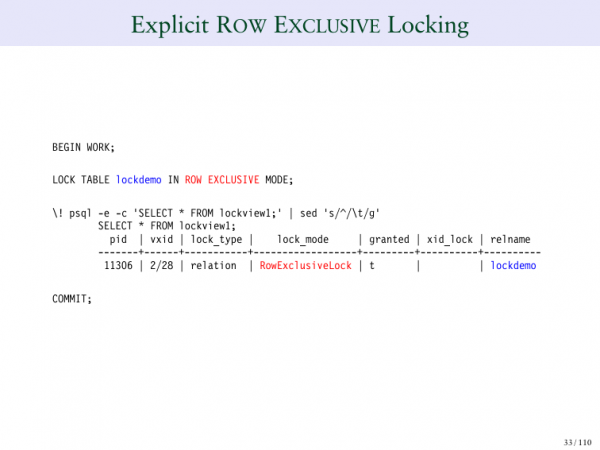
Ici, nous disons que le verrou est utilisé par nous.
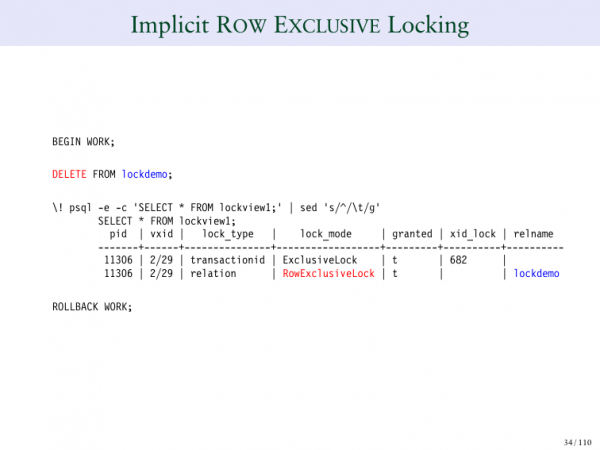
Donc, le verrou exclusif indique explicitement qu'il est exclusif. Et aussi, si vous supprimez une ligne dans cette table, c'est ce qui se passera, comme vous pouvez le voir.
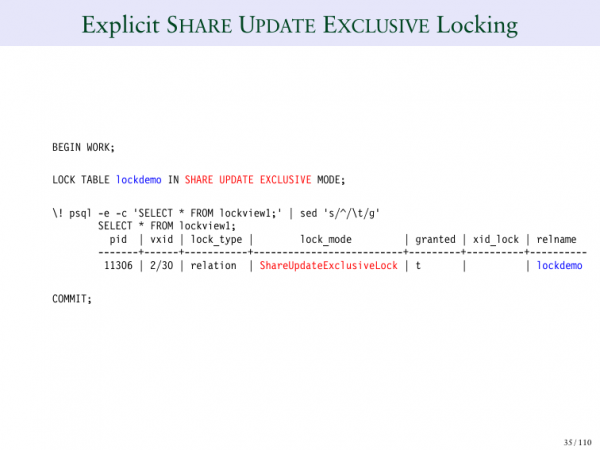
SHARE EXCLUSIVE – c'est un verrouillage plus long.
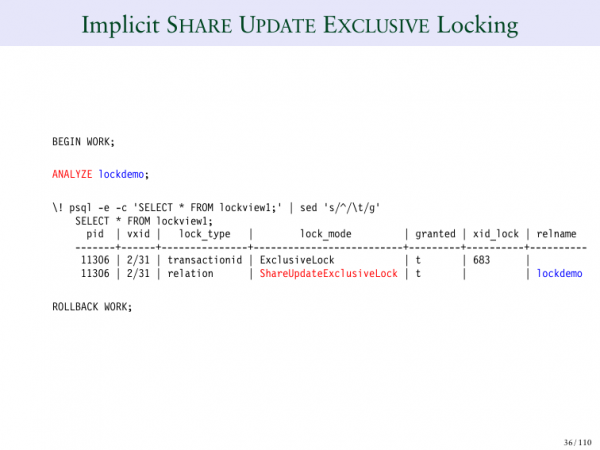
C'est la commande (ANALYZE) de l'analyseur qui sera utilisée.
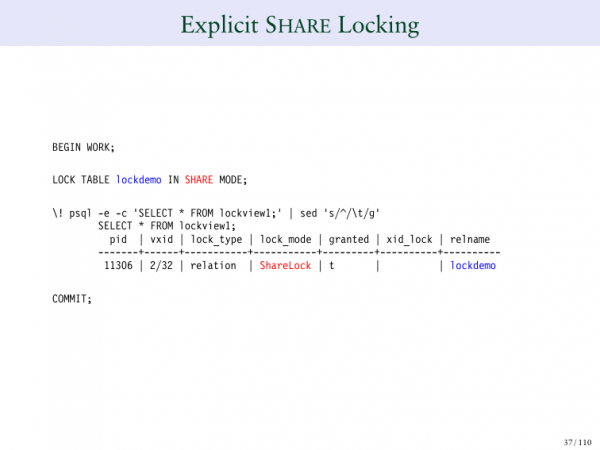
SHARE LOCK – vous pouvez explicitement verrouiller en mode share.
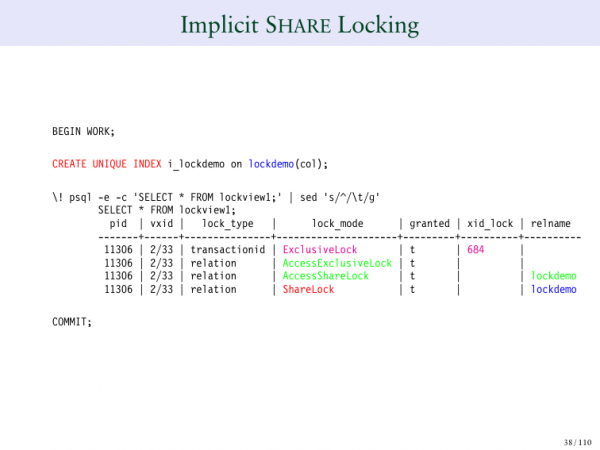
Vous pouvez également créer un index unique. Et là, vous pouvez voir le SHARE LOCK, qui en fait partie. Et il bloque la table et lui impose un verrou SHARE LOCK.
Par défaut, le SHARE LOCK sur la table signifie que d'autres personnes peuvent lire la table, mais personne ne peut la modifier. Et c'est ce qui se passe lorsque vous créez un index unique.
Si je crée un index unique en mode concurrently, j'aurai un autre type de verrouillage, car, comme vous le savez, l'utilisation des index en mode concurrently réduit l'exigence de verrouillage. Et si j'utilise un verrou normal, un index normal, je préviendrai ainsi l'écriture dans l'index de la table pendant sa création. Si j'utilise un index en mode concurrently, je dois utiliser un autre type de verrou.
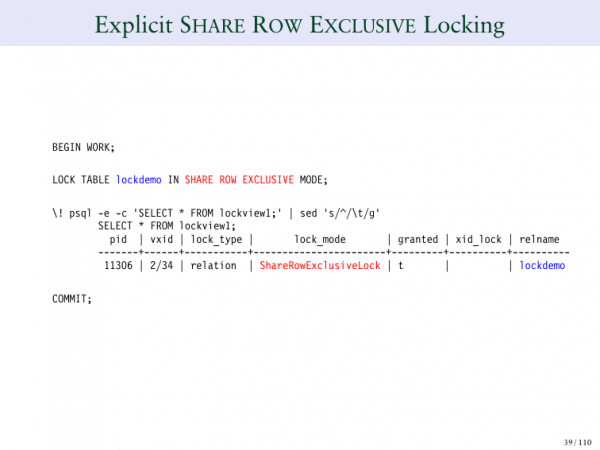
SHARE ROW EXCLUSIVE – encore une fois, cela peut être déclaré explicitement.
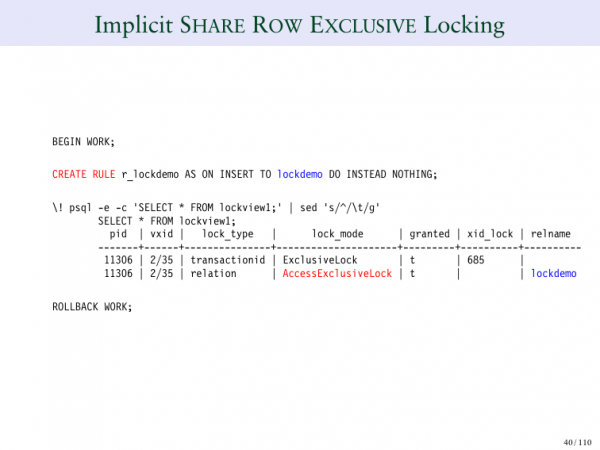
Ou nous pouvons créer une règle, c'est-à-dire prendre un cas particulier dans lequel elle sera utilisée.
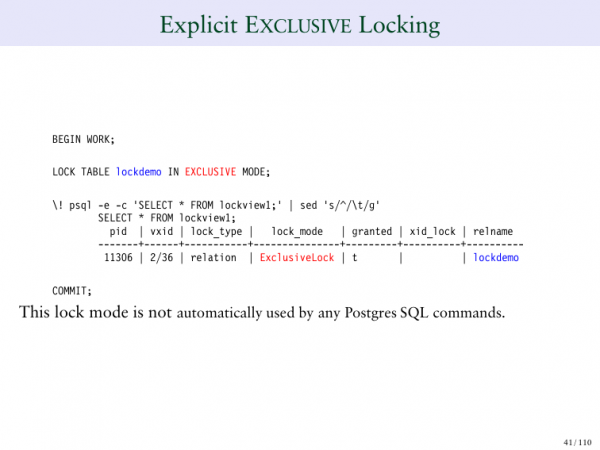
Le verrou EXCLUSIVE signifie que personne d'autre ne pourra modifier la table.
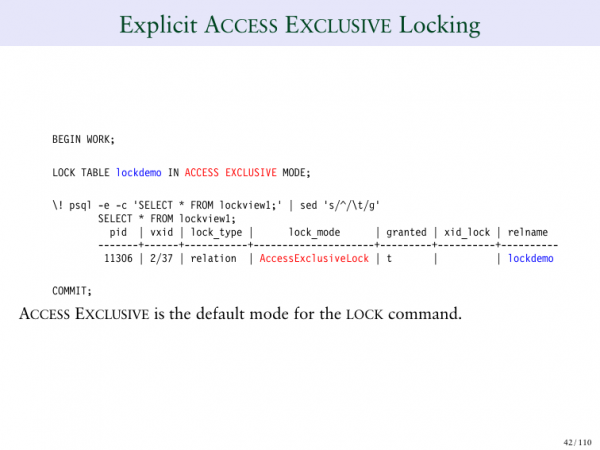
Ici, nous voyons différents types de verrouillages.
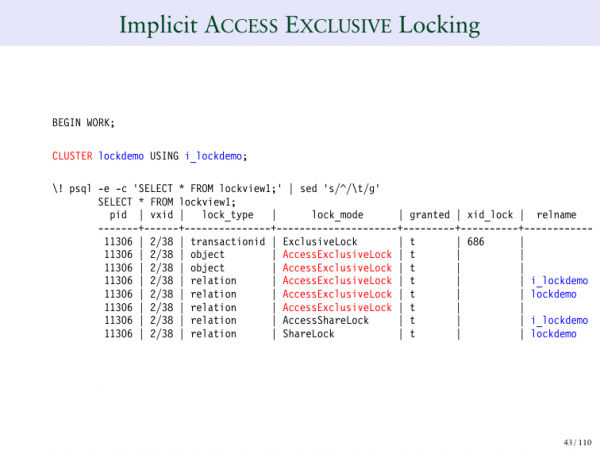
ACCESS EXCLUSIVE, par exemple, est une commande de verrouillage. Par exemple, si vous faites CLUSTER table, cela signifie que personne ne pourra y écrire. Et cela bloque non seulement la table elle-même, mais aussi les index.
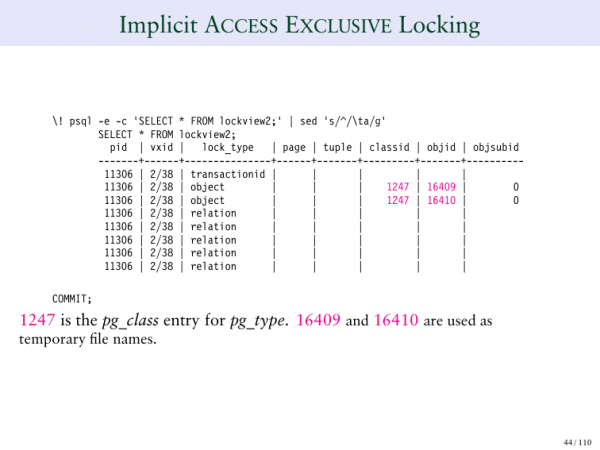
C'est la deuxième page du verrou ACCESS EXCLUSIVE, où nous voyons précisément ce qu'il bloque dans la table. Il bloque des lignes individuelles de la table, ce qui est assez intéressant.
Voici toutes les informations de base que je voulais fournir. Nous avons parlé des verrous, des ID de transactions, des ID de transactions virtuelles, et des ID de transactions permanents.
Nous allons maintenant passer aux exemples de verrous. C'est la partie la plus intéressante. Nous allons examiner des cas très captivants. Mon objectif dans cette présentation est de vous donner une meilleure compréhension de ce que Postgres fait réellement lorsqu'il tente de verrouiller certaines choses. Je pense qu'il est très efficace pour verrouiller des parties spécifiques.
Examinons certains exemples.
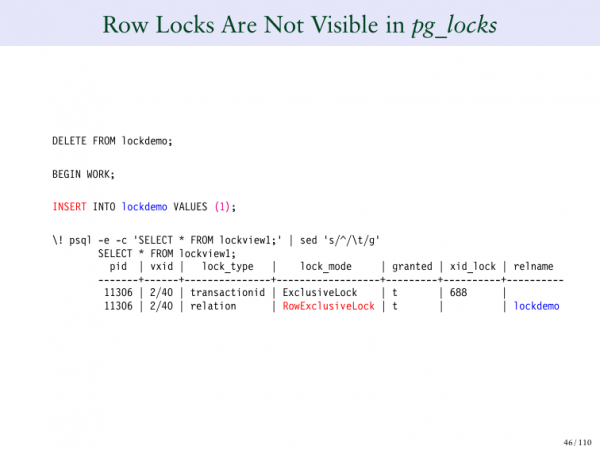
Commençons par les tables et une ligne dans la table. Lorsque j'insère quelque chose, j'obtiens un ExclusiveLock, l'ID de la transaction et un ExclusiveLock sur la table.
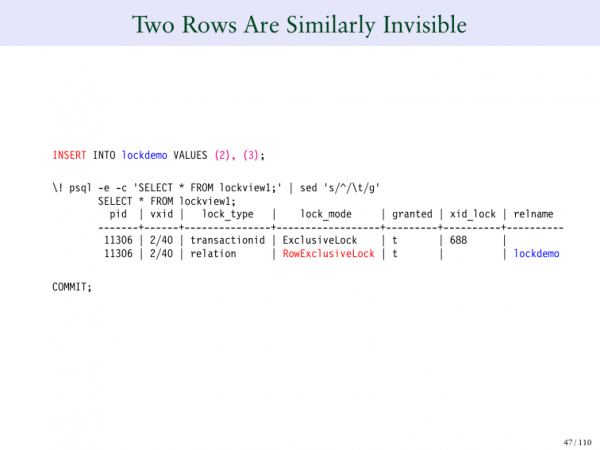
Que se passe-t-il si j'insère encore deux lignes ? Nous avons maintenant trois lignes dans notre table. J'ai inséré une ligne et obtenu ceci en sortie. Et si j'insère encore deux lignes, quelle est l'anomalie ici ? Il y a une étrangeté, car j'ai ajouté trois lignes à cette table, mais j'ai toujours deux lignes dans la table de verrouillage. Et c'est, en substance, le comportement fondamental de Postgres.
Beaucoup pensent que si dans une base de données, vous verrouillez 100 lignes, il vous faudra créer 100 entrées de verrouillage. Si je verrouille immédiatement 1 000 lignes, alors il me faudra 1 000 telles requêtes. Et si je dois en verrouiller un million ou un milliard. Mais si nous agissons ainsi, cela ne fonctionnera pas très bien. Si vous avez utilisé un système qui crée des entrées de verrouillage pour chaque ligne individuelle, vous voyez que c'est compliqué. Car il vous faut déterminer immédiatement la table de verrouillage, qui peut être saturée, mais Postgres ne fait pas cela.
Et sur cette diapositive, il est très important de noter qu'il est clairement démontré qu'il existe un autre système qui fonctionne à l'intérieur du MVCC, qui verrouille des lignes individuelles. Ainsi, lorsque vous verrouillez des milliards de lignes, Postgres ne crée pas un milliard de commandes distinctes de verrouillage. Et cela améliore considérablement les performances.
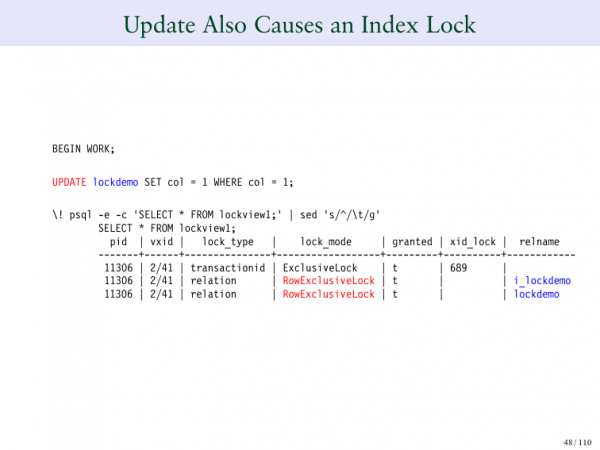
Qu'en est-il de la mise à jour ? Je mets actuellement à jour une ligne, et vous pouvez constater qu'elle exécute immédiatement deux opérations différentes. Elle a bloqué la table tout en bloquant également l'index. Elle devait bloquer l'index en raison des contraintes uniques sur cette table. Nous voulons nous assurer que personne ne le modifie, donc nous le bloquons.
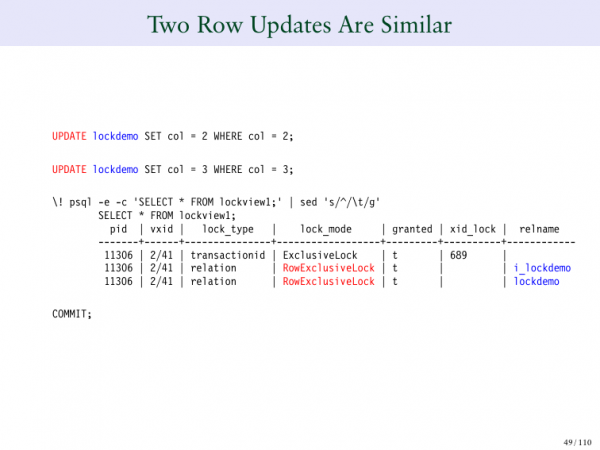
Que se passe-t-il si je veux mettre à jour deux lignes ? Nous voyons qu'elle se comporte de la même manière. Nous effectuons deux fois plus de mises à jour, mais le même nombre de verrous de lignes.
Si vous êtes curieux de savoir comment Postgres s'y prend, vous devez écouter mes présentations sur le MVCC pour comprendre comment Postgres marque en interne les lignes qu'il modifie. Et Postgres a un moyen de le faire, mais il ne le fait pas au niveau de verrouillage des tables, il le fait à un niveau plus bas et plus efficace.
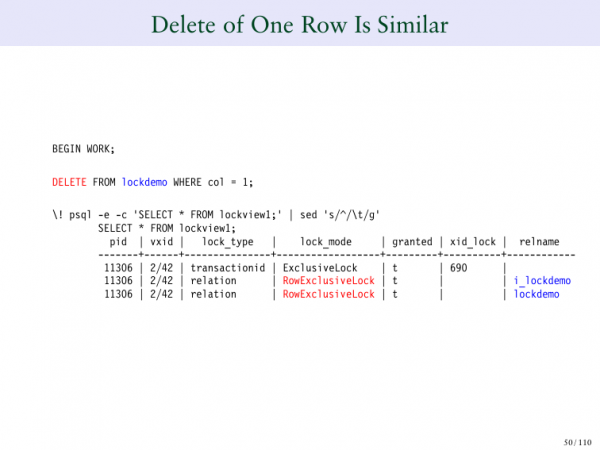
Et si je veux supprimer quelque chose ? Si je supprime par exemple une ligne et que j'ai toujours mes deux entrées de verrou, même si je voulais les supprimer toutes, elles seraient toujours présentes.
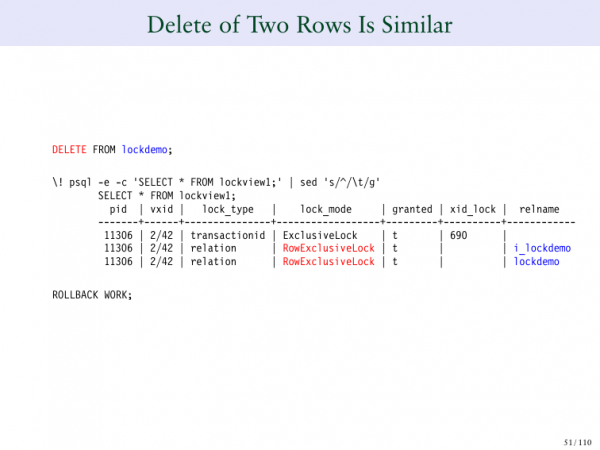
Et par exemple, si je veux insérer 1 000 lignes, puis soit supprimer, soit ajouter 1 000 lignes, alors les lignes individuelles que j'ajoute ou modifie ne sont pas enregistrées ici. Elles sont enregistrées à un niveau plus bas à l'intérieur de la ligne elle-même. Et lors de ma présentation sur le MVCC, j'en ai parlé en détail. Mais il est très important, lorsque vous analysez les verrouillages, de vous assurer que vous avez un verrou au niveau de la table et que vous ne voyez pas ici comment se passent les écritures des lignes individuelles.
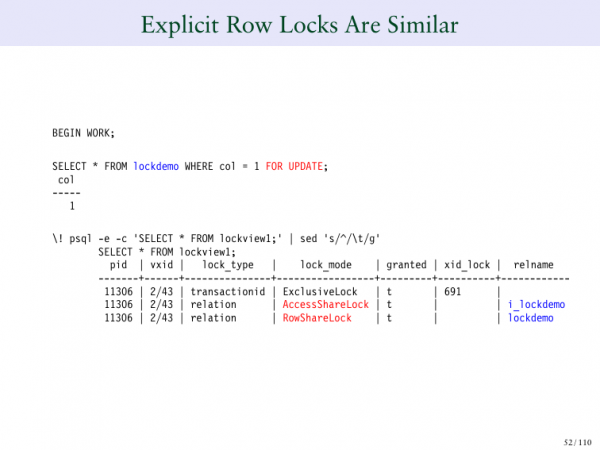
Qu'en est-il du verrouillage explicite ?
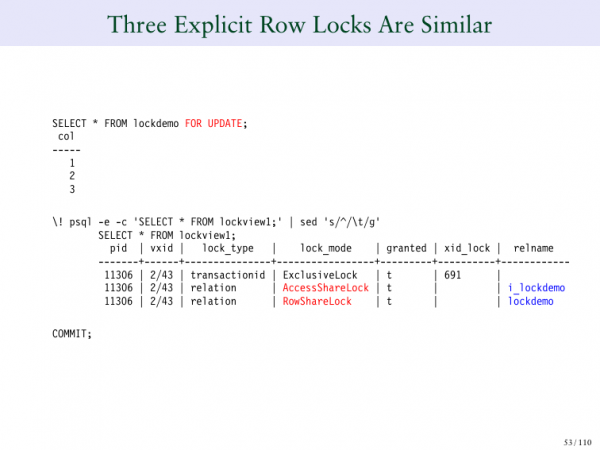
Si je clique sur « mettre à jour », j'ai deux lignes verrouillées. Et si je les sélectionne toutes et clique sur « mettre à jour partout », j'ai toujours deux enregistrements de verrou.
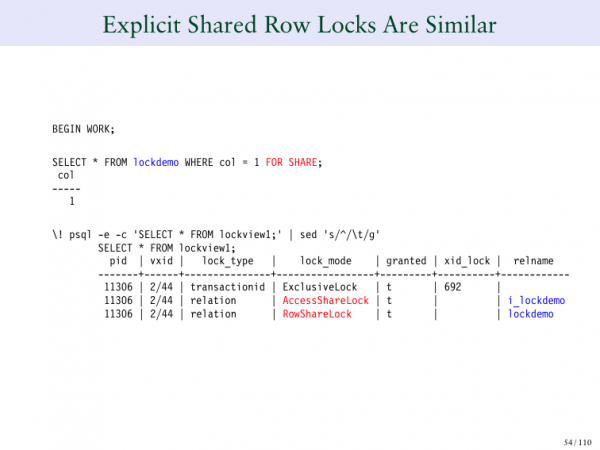
Nous ne créons pas d'enregistrements séparés pour chaque ligne individuelle. Parce que cela nuirait aux performances, cela pourrait en avoir trop. Et nous pourrions nous retrouver dans une situation difficile.
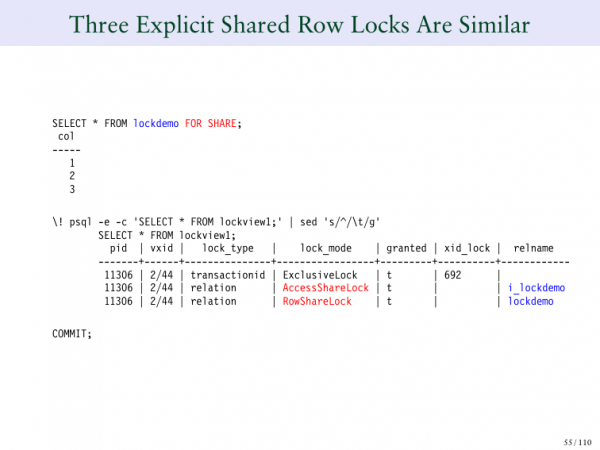
Et il en va de même si nous faisons un partage, nous pouvons le faire 30 fois.
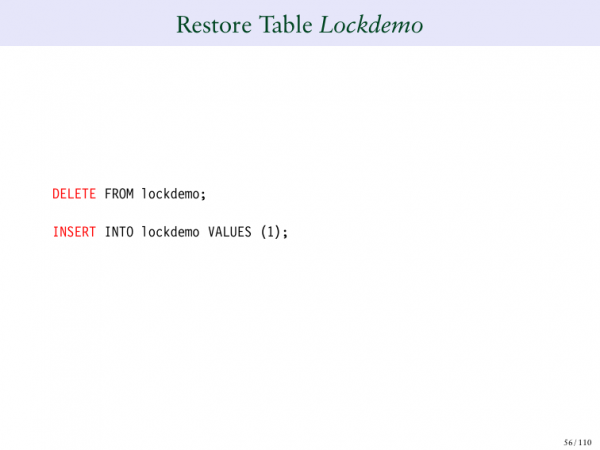
Nous rétablissons notre table, nous supprimons tout, puis nous insérons à nouveau une ligne.
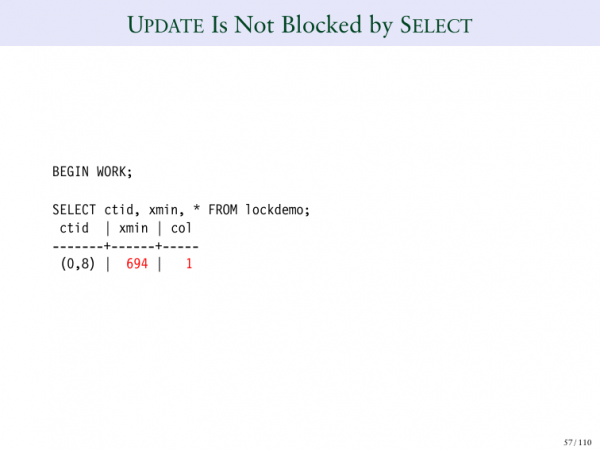
Un autre comportement que vous pouvez observer dans Postgres est ce comportement bien connu et souhaitable : vous pouvez effectuer un update ou un select. Et vous pouvez le faire simultanément. Le select ne bloque pas l'update et inversement. Nous disons que le lecteur ne bloque pas l'écrivain, et l'écrivain ne bloque pas le lecteur.
Je vais vous montrer un exemple. Je vais faire un select maintenant. Ensuite, nous ferons un INSERT. Et vous pourrez voir – 694. Vous pourrez voir l'ID de la transaction qui a effectué cette insertion. Et c'est ainsi que cela fonctionne.
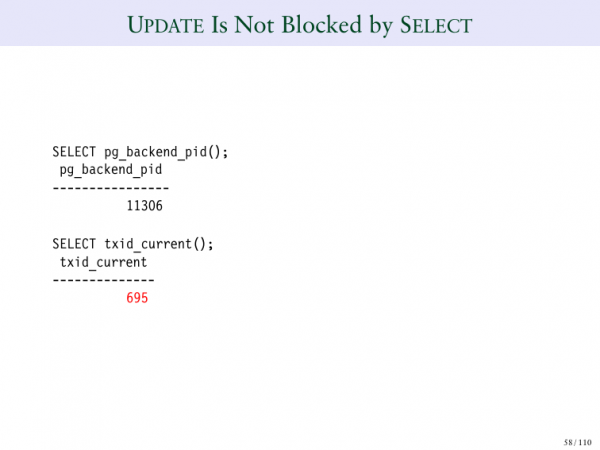
Et si je regarde maintenant l'ID de mon backend, il est devenu – 695.
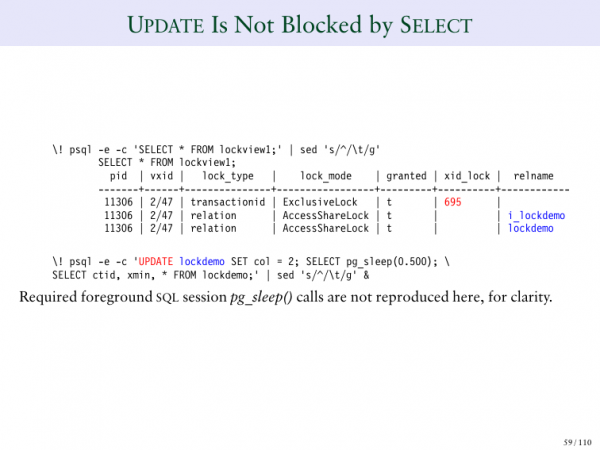
Et je peux voir que 695 apparaît dans ma table.
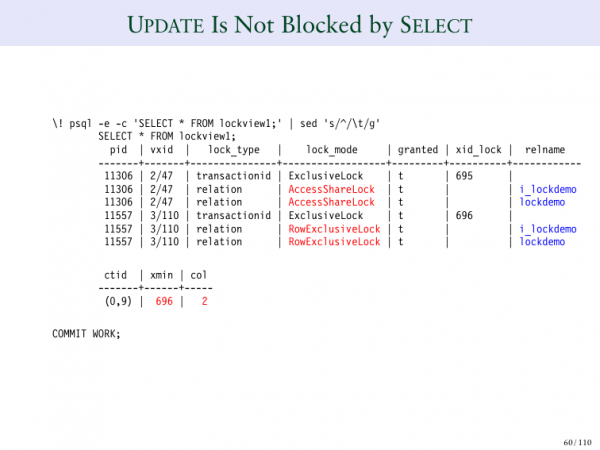
Et si je fais une mise à jour ici comme ça, j'obtiens un autre cas. Dans ce cas, 695 – c'est un verrou exclusif, et l'update a un comportement similaire, mais il n'y a pas de conflit entre eux, ce qui est assez inhabituel.
Et vous pouvez remarquer qu'en haut – c'est un ShareLock, et en bas – c'est un ExclusiveLock. Et les deux transactions ont été faites.
Et il faut écouter ma présentation sur MVCC pour comprendre comment cela se passe. Mais c'est une illustration de ce que vous pouvez faire simultanément, c'est-à-dire faire SELECT et UPDATE en même temps.
Réinitialisons et faisons à nouveau une opération.
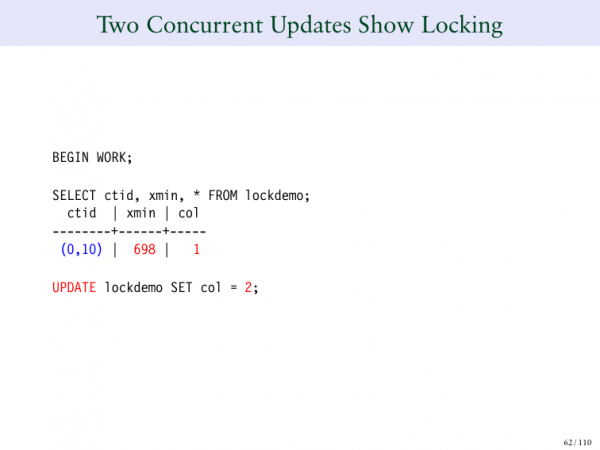
Si vous essayez d'exécuter deux updates simultanément sur la même ligne, cela sera bloqué. Et rappelez-vous, je vous ai dit que le lecteur ne bloque pas l'écrivain, et l'écrivain bloque le lecteur, mais un écrivain bloque un autre écrivain. C'est-à-dire que nous ne pouvons pas faire en sorte que deux personnes mettent à jour la même ligne en même temps. Il faut attendre qu'un d'eux termine.
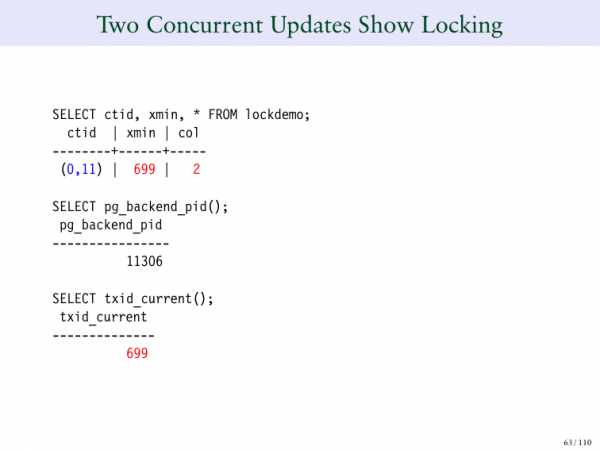
Et pour illustrer cela, je vais regarder la table Lockdemo. Et nous allons examiner une ligne. Pour la transaction 698.
Nous l'avons mise à jour à 2. 699 – c'est la première mise à jour. Et elle a réussi ou elle est en attente dans la transaction et attend que nous confirmions ou annulions.
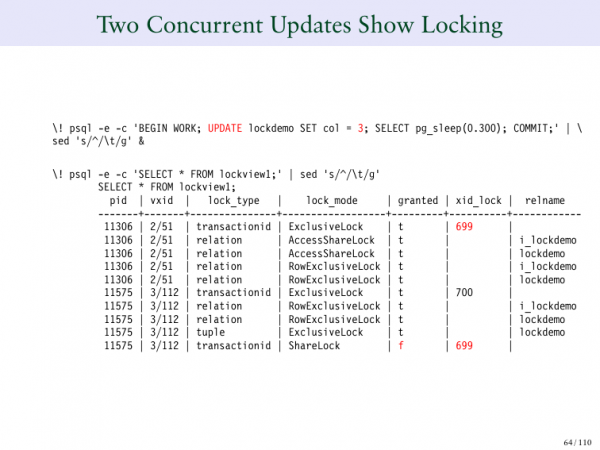
Mais regardez autre chose – 2/51 – c'est notre première transaction, notre première session. 3/112 – c'est la deuxième requête qui est apparue en haut et qui a remplacé cette valeur par 3. Et si vous remarquez, le supérieur s'est bloqué lui-même, qui est 699. Mais 3/112 n'a pas fourni de blocage. Dans la colonne Lock_mode, il est écrit qu'il attend. Il attend 699. Et si vous regardez où est 699, il est au-dessus. Et qu'est-ce que la première session a fait ? Elle a créé un verrou exclusif sur son propre ID de transaction. C'est comme ça que Postgres fonctionne. Il bloque son propre ID de transaction. Et si vous voulez attendre que quelqu'un confirme ou annule, vous devez attendre qu'il y ait une transaction en attente. C'est pourquoi nous pouvons voir cette ligne étrange.
Regardons encore une fois. À gauche, nous voyons notre ID de traitement. Dans la deuxième colonne, nous voyons notre ID virtuel de transaction, et dans la troisième, nous voyons lock_type. Que signifie cela ? En gros, cela dit qu'il bloque l'ID de transaction. Mais remarquez que dans toutes les lignes en bas, il est écrit relation. Et donc, vous avez deux types de verrouillage dans la table. Il y a le verrouillage de relation. Et il y a aussi le verrouillage transactionid, où vous vous bloquez vous-même, c'est exactement ce qui se passe dans la première ligne ou en bas, où transactionid, où nous attendons que 699 termine son opération.
Je regarde ce qu'il se passe ici. Et deux choses se produisent simultanément. Vous regardez le verrouillage par ID de transaction dans la première ligne, qui se bloque elle-même. Et elle se bloque elle-même pour forcer les gens à attendre.
Si vous regardez la 6e ligne, c'est le même enregistrement que le premier. Et donc la transaction 699 est bloquée. 700 se bloque aussi lui-même. Et ensuite, dans la ligne inférieure, vous verrez que nous attendons que 699 termine son opération.
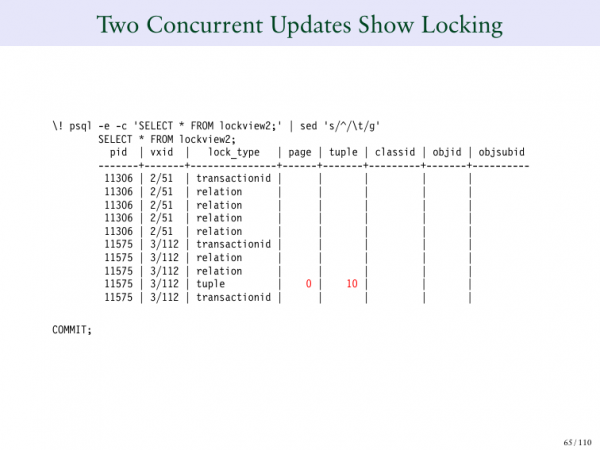
Et dans lock_type, tuple vous voyez des numéros.
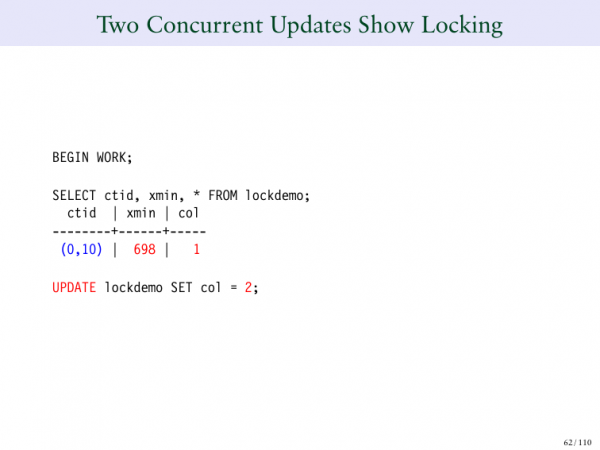
Vous pouvez voir que c'est 0/10. Et c'est le numéro de page, et aussi l'offset de cette ligne spécifique.
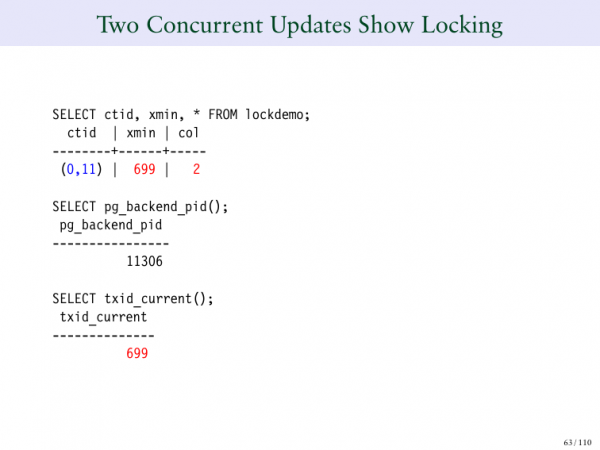
Et vous voyez que cela devient 0/11 lorsque nous mettons à jour.
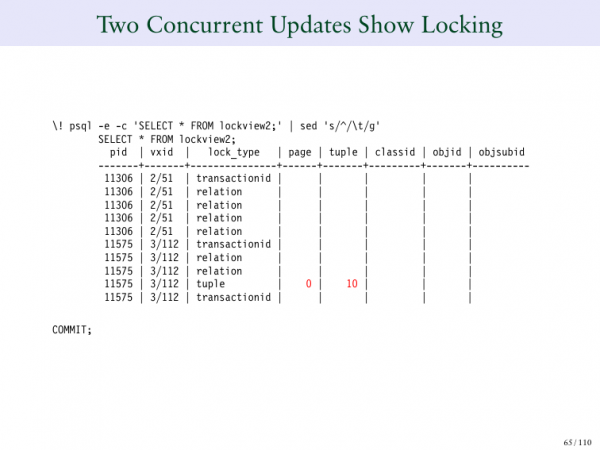
Mais en réalité – c'est 0/10, car cette opération est en attente. Nous avons la possibilité de voir que c'est cette ligne que j'attends pour confirmer.
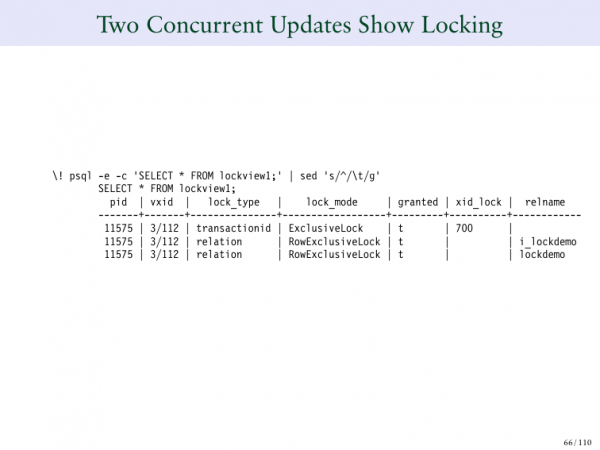
Une fois que nous l'avons validé et cliqué sur commit, et lorsque la mise à jour est terminée, voici ce que nous obtenons à nouveau. La transaction 700 est le seul verrouillage, elle n'attend plus personne, car elle a été validée. Elle attend simplement que la transaction se termine. Dès que 699 se termine, nous n'attendons plus rien. Et maintenant, la transaction 700 indique que tout va bien, que tous les verrous nécessaires sont présents dans toutes les tables autorisées.
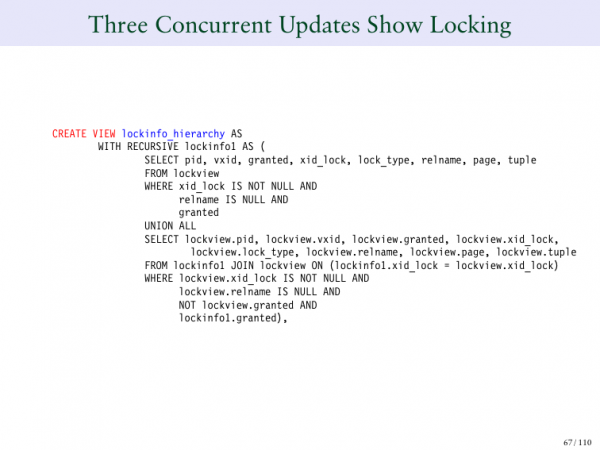
Et pour compliquer encore les choses, nous créons une autre vue, qui cette fois nous fournira une hiérarchie. Je ne m'attends pas à ce que vous compreniez cette requête. Mais cela nous donnera une vision plus claire de ce qui se passe.
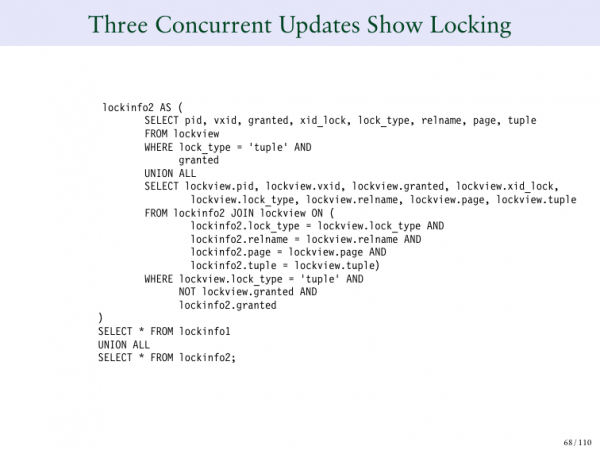
C'est une vue récursive, qui a également une autre section. Et elle renvoie ensuite tout ensemble. Utilisons cela.
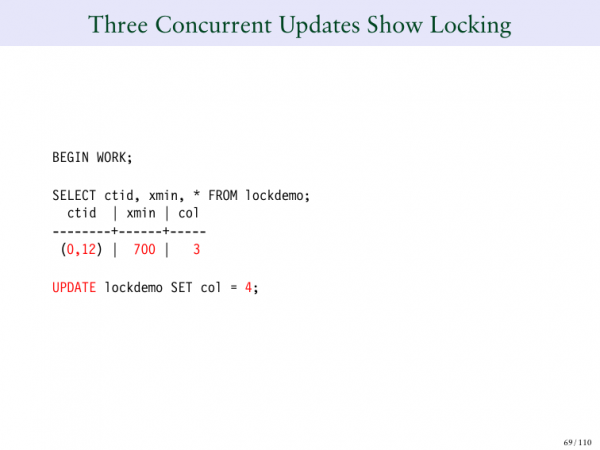
Que se passerait-il si nous faisions trois mises à jour simultanées et disions que la rangée est maintenant égale à trois. Et nous changeons 3 en 4.
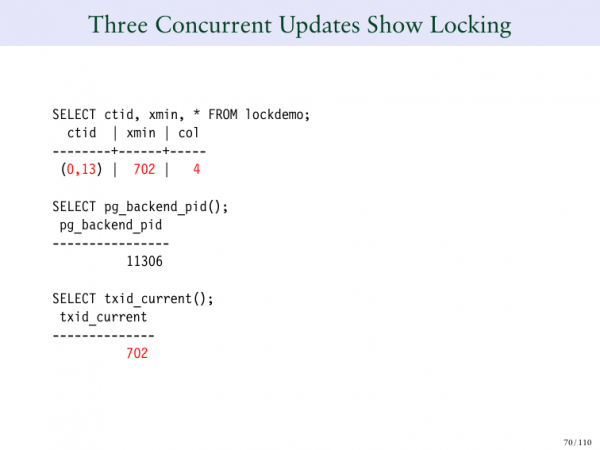
Et voici nous voyons 4. Et l'ID de transaction 702.
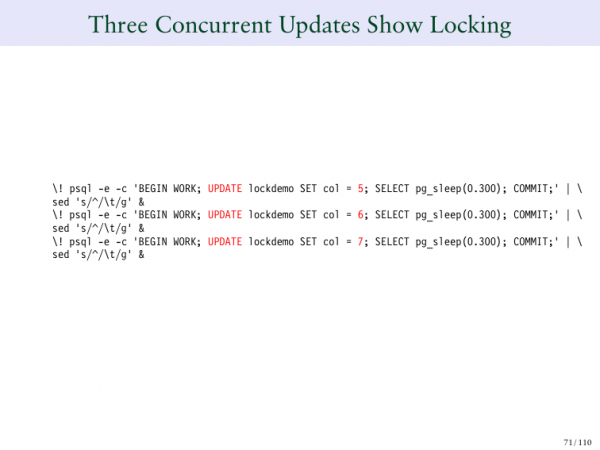
Et ensuite je change 4 en 5. Et 5 en 6, et 6 en 7. Et je fais la file de personnes qui attendent que cette seule transaction se termine.
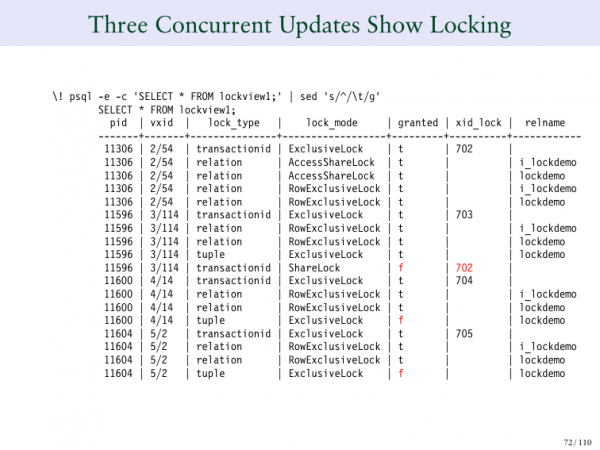
Et tout devient clair. Quelle est la première rangée ? C'est 702. C'est l'ID de transaction qui a initialement défini cette valeur. Et qu'est-ce que j'ai dans la colonne Accordé ? J'ai des marques f. Ce sont mes mises à jour, qui (5, 6, 7) ne peuvent pas être validées, car nous attendons que l'ID de transaction 702 se termine. Nous avons un verrou sur l'ID de transaction. Ce sont donc 5 verrous d'ID transactionnels.
Et si vous regardez 704, 705, il n'y a rien noté là-bas, car ils ne savent pas encore ce qui se passe. Ils écrivent simplement qu'ils n'ont aucune idée de ce qui se passe. Et ils vont simplement s'endormir, car ils attendent que quelqu'un termine et les réveille quand il y a une opportunité de changer la rangée.
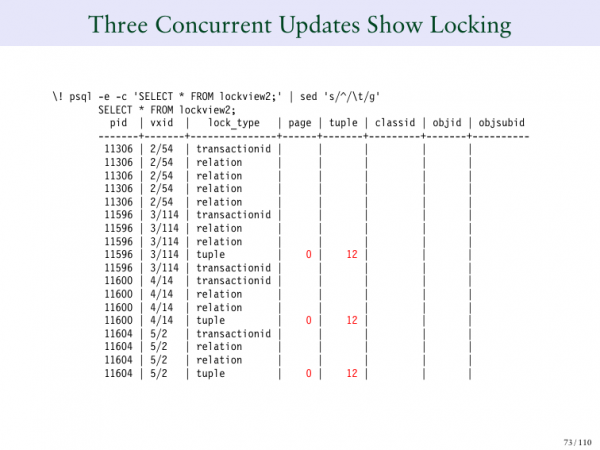
Voici à quoi cela ressemble. Il est clair qu'ils attendent tous la ligne 12.
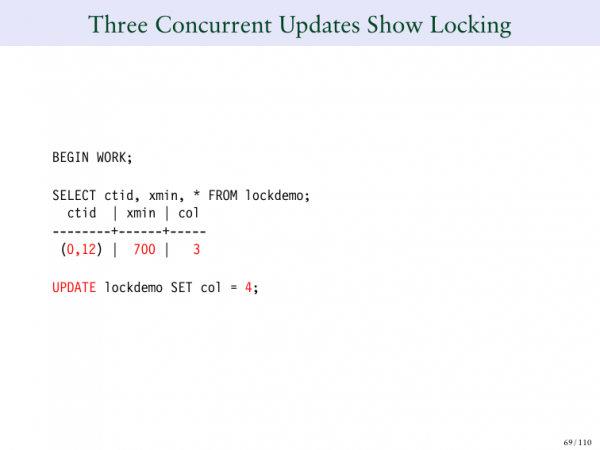
C'est ce que nous avons vu ici. Voici 0/12.
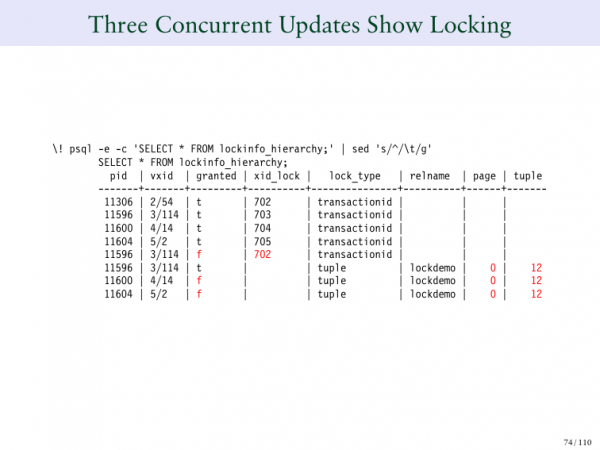
Donc, une fois que la première transaction est approuvée, vous pouvez voir ici comment la hiérarchie fonctionne. Et maintenant, tout devient clair. Ils sont tous libérés. Et ils sont en fait toujours en attente.
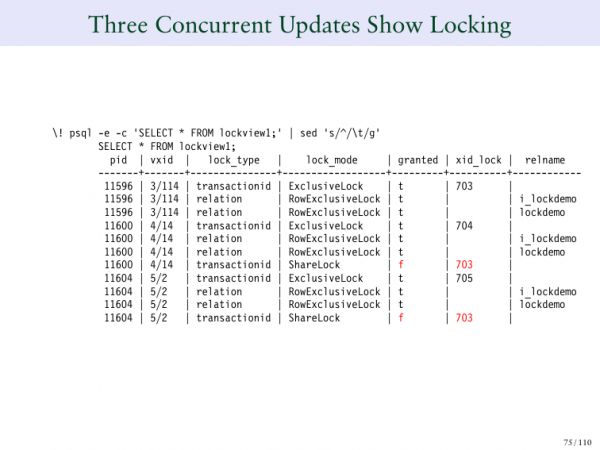
Voici ce qui se passe. 702 s'engage. Et maintenant 703 reçoit ce verrou de ligne, puis 704 commence à attendre que 703 s'engage. Et 705 attend également cela. Et quand tout cela est terminé, ils se nettoient eux-mêmes. Je voudrais souligner que tout le monde fait la queue. Cela ressemble beaucoup à une situation de bouchon, où tout le monde attend la première voiture. La première voiture s'arrête et tout le monde fait une longue file. Ensuite, elle avance, puis la voiture suivante peut passer devant et obtenir son verrou, etc.
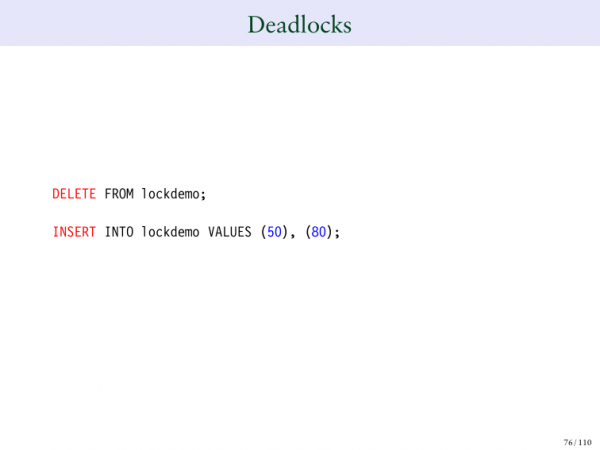
Et si cela ne vous semble pas assez compliqué, parlons maintenant des deadlocks. Je ne sais pas qui parmi vous en a déjà rencontré. C'est un problème assez courant dans les systèmes de bases de données. Mais les deadlocks sont le cas où une session attend qu'une autre session exécute quelque chose. Pendant ce temps, l'autre session attend que la première session exécute quelque chose.
Et, par exemple, si Ivan dit : « Donne-moi quelque chose », et que je dis : « Non, je te le donnerai seulement si tu me donnes autre chose ». Et il dit : « Non, je ne te donnerai pas cela si tu ne me donnes pas ». Et nous nous retrouvons dans une situation de deadlock. Je suis sûr qu'Ivan ne ferait pas cela, mais vous comprenez le sens : deux personnes veulent obtenir quelque chose et elles ne sont pas prêtes à le donner tant que l'autre personne ne leur a pas donné ce qu'elles veulent. Et il n'y a pas de solution.
Et en gros, votre base de données doit le détecter. Et ensuite, il est nécessaire de terminer ou de fermer l'une des sessions, sinon elles resteront là pour toujours. Et nous le voyons dans les bases de données, nous le voyons dans les systèmes d'exploitation. Et dans tous les endroits où nous avons des processus parallèles, cela peut se produire.
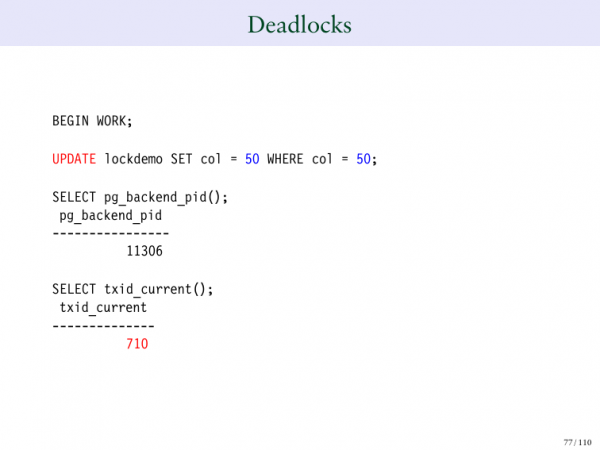
Et nous allons maintenant établir deux deadlocks. Nous allons établir 50 et 80. Dans la première rangée, je vais effectuer une mise à jour de 50 à 50. J'obtenirai le numéro de transaction 710.
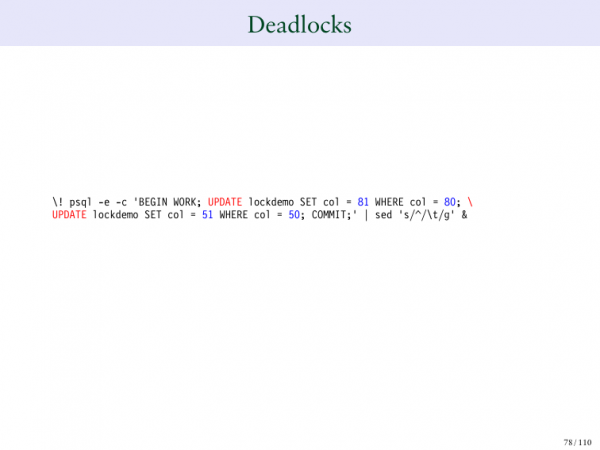
Et ensuite je vais changer 80 à 81, et 50 à 51.
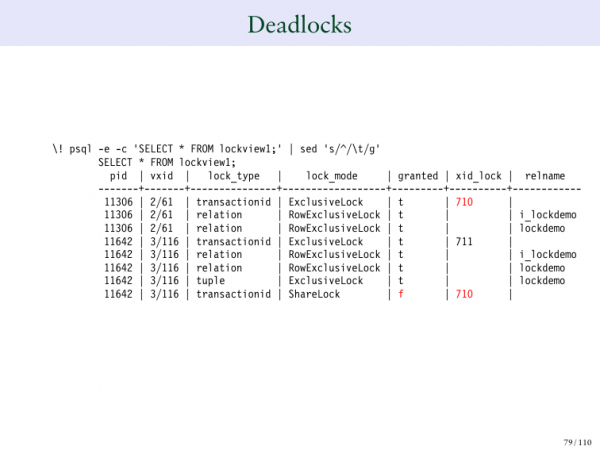
Et voici à quoi cela va ressembler. Et donc 710 a un verrou de ligne, tandis que 711 attend une confirmation. Nous avons vu cela lors de la mise à jour. 710 est le propriétaire de notre ligne. Et 711 attend que 710 termine la transaction.
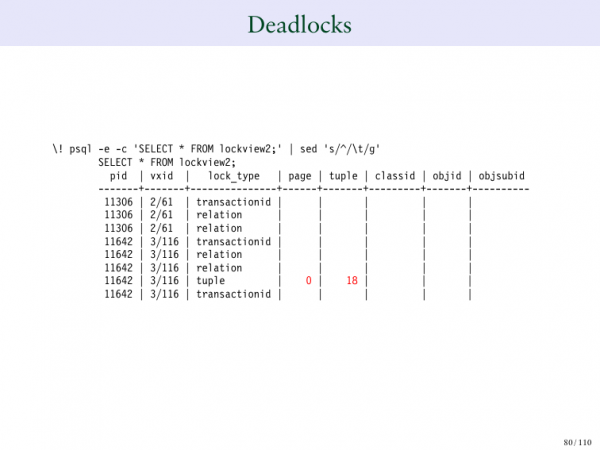
Et il y a même une indication sur la ligne exacte où nous avons des deadlocks. Et c'est là que cela commence à devenir étrange.
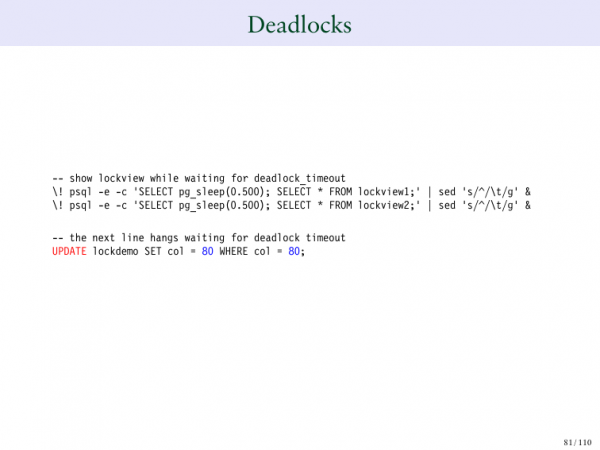
Maintenant, nous mettons à jour 80 à 80.
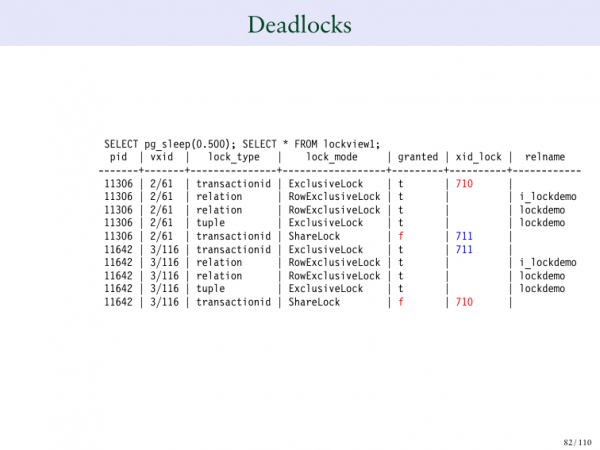
Et voilà, c'est là que commencent les deadlocks. 710 attend une réponse de 711, tandis que 711 attend 710. Et cela ne va pas bien se terminer. Il n'y a pas d'issue. Ils vont attendre une réponse l'un de l'autre.
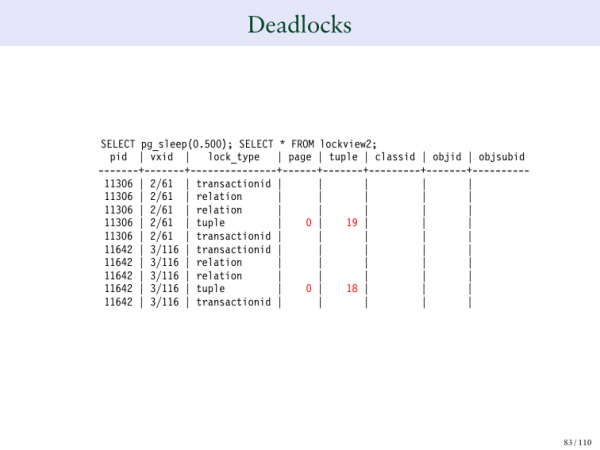
Et cela va simplement commencer à tout retarder. Et nous ne voulons pas ça.
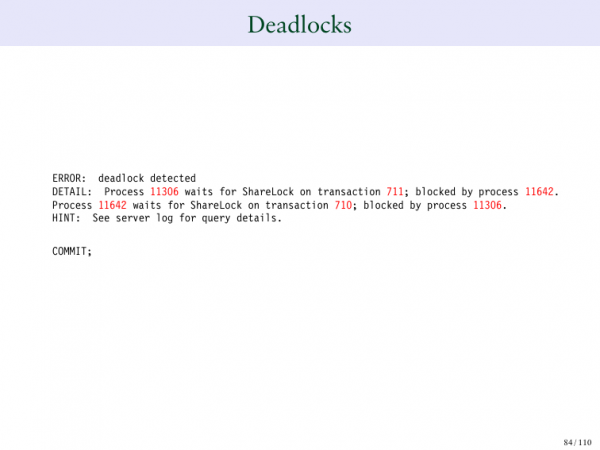
Et dans Postgres, il existe des moyens de détecter quand cela se produit. Et quand cela se produit, vous obtenez l'erreur suivante. Cela montre clairement qu'un certain processus attend un SHARE LOCK d'un autre processus, c'est-à-dire qui est bloqué par le processus 711. Et ce processus attendait qu'un SHARE LOCK soit accordé pour un certain ID de transaction et a été bloqué par un certain processus. Donc ici, nous avons une situation de deadlock.
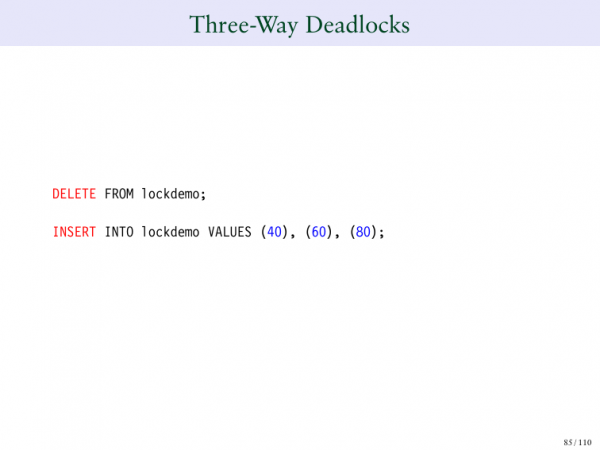
Y a-t-il des deadlocks à trois voies ? Est-ce possible ? Oui.
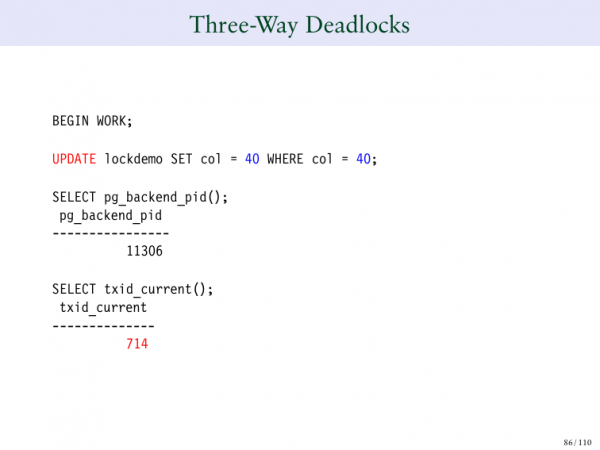
Nous saisissons ces nombres dans le tableau. Nous changeons 40 en 40, nous faisons une verrouillage.
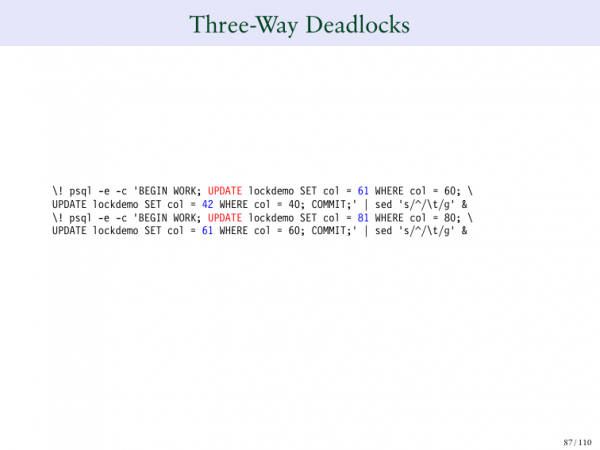
Nous changeons 60 en 61, 80 en 81.
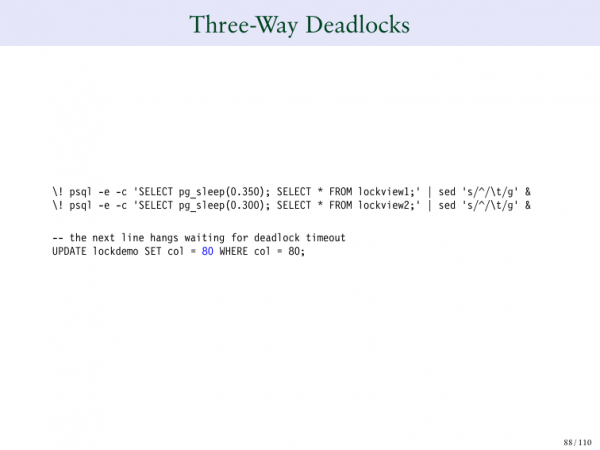
Et ensuite nous changeons 80, et ensuite – boum !
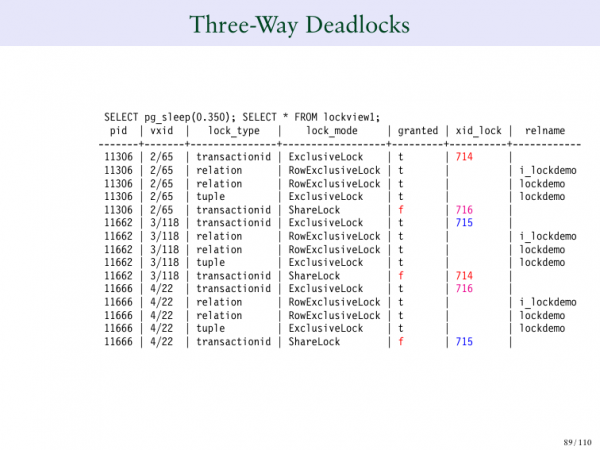
Et 714 attend maintenant 715. 716 attend 715. Et il n'y a plus rien à faire avec ça.
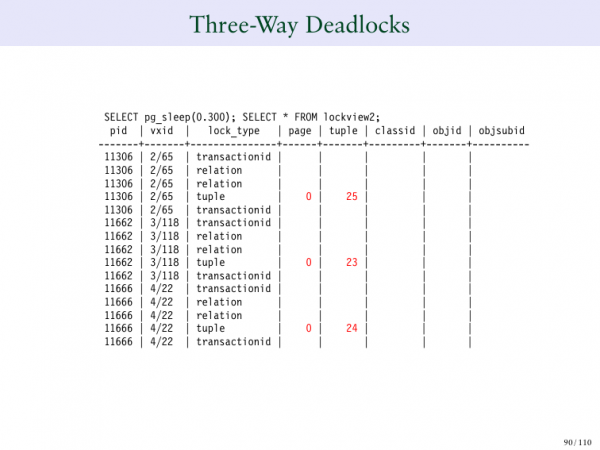
Il n'y a pas deux personnes ici, mais trois. Je veux quelque chose de toi, celui-ci veut quelque chose de la troisième personne, et la troisième personne veut quelque chose de moi. Et nous nous retrouvons dans une attente à trois, car nous attendons tous que l'autre personne termine ce qu'elle doit faire.
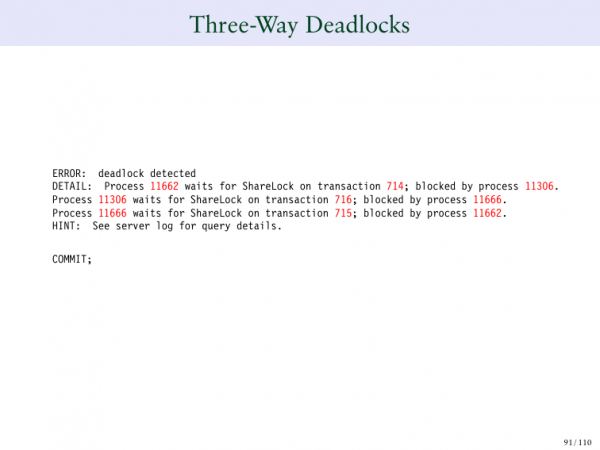
Et Postgres sait sur quelle ligne cela se produit. C'est pourquoi il vous donnera le message suivant, qui montre que vous avez un problème où trois entrées se bloquent mutuellement. Et ici, il n'y a pas de limites. Cela peut se produire si 20 enregistrements se bloquent mutuellement.
Le problème suivant est le serializable.
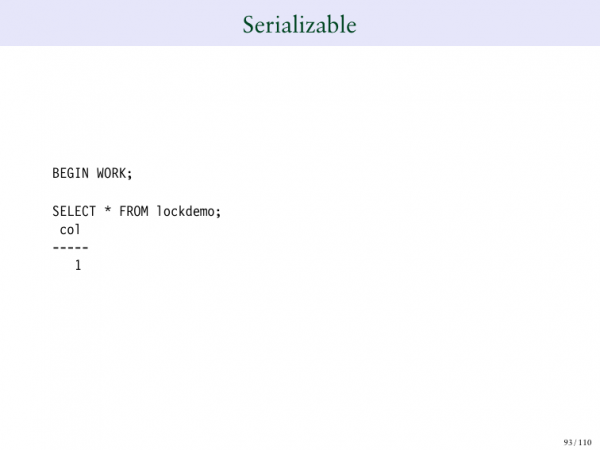
S'il s'agit d'un verrou spécial de type serializable.
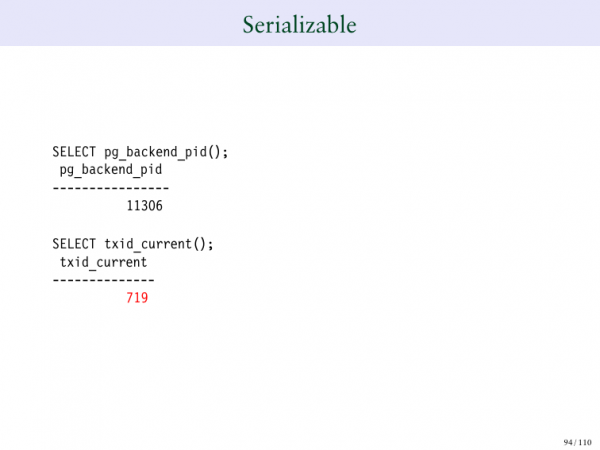
Nous revenons à 719. Sa sortie est tout à fait normale.
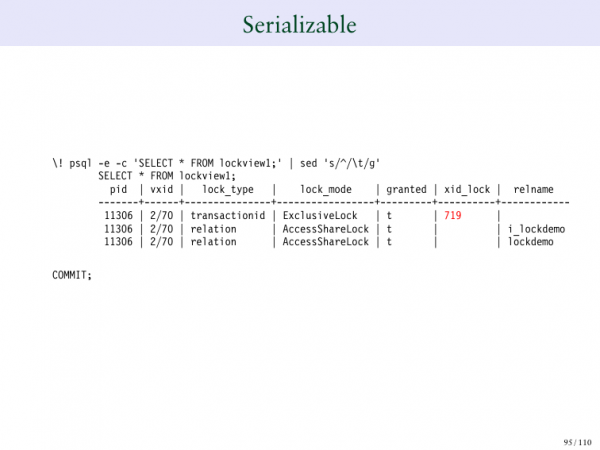
Et vous pouvez appuyer pour effectuer une transaction de type serializable.
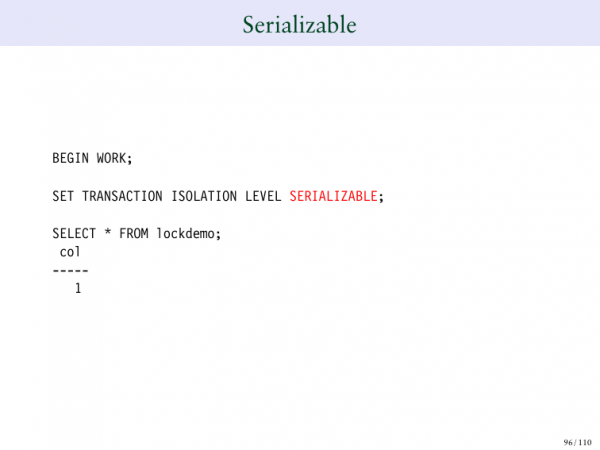
Et vous comprenez que vous avez maintenant un autre type de verrou SA – cela signifie serializable.
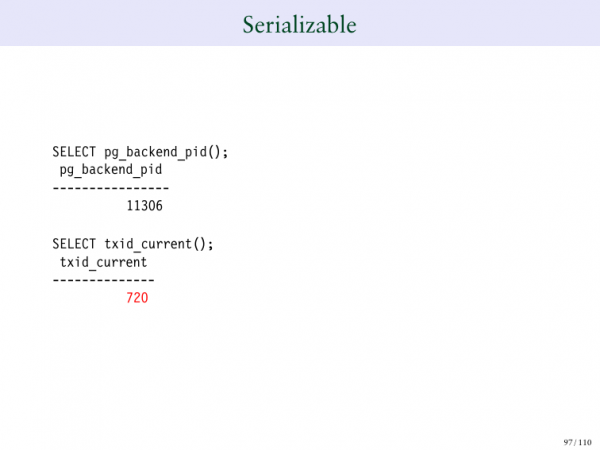
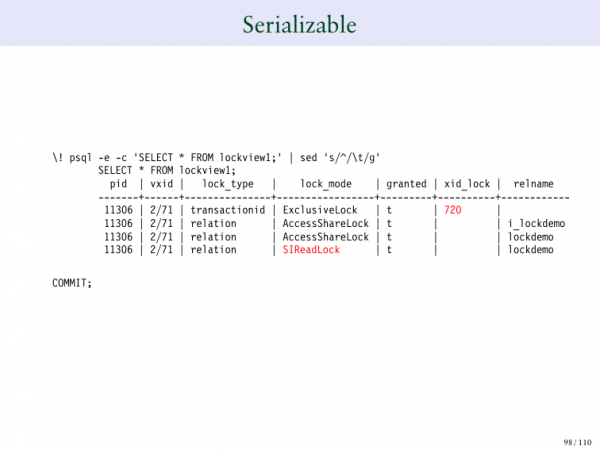
Et donc nous avons un nouveau type de verrou appelé SARieadLock, qui est un verrou série et permet d'introduire des séries.
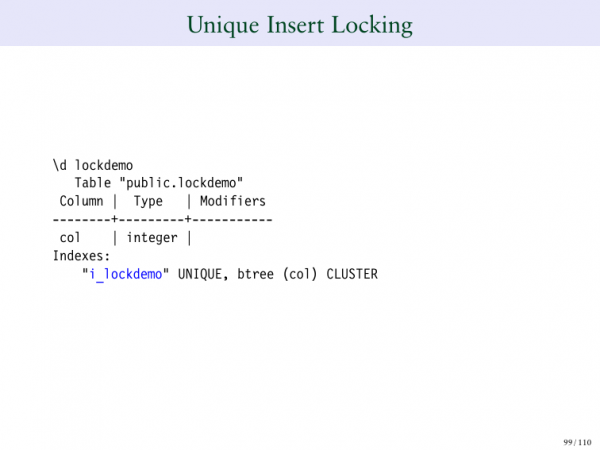
Et vous pouvez également insérer des index uniques.
Dans ce tableau, nous avons des index uniques.
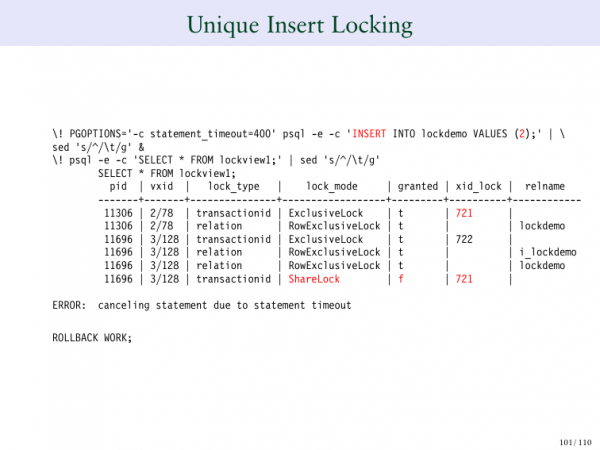
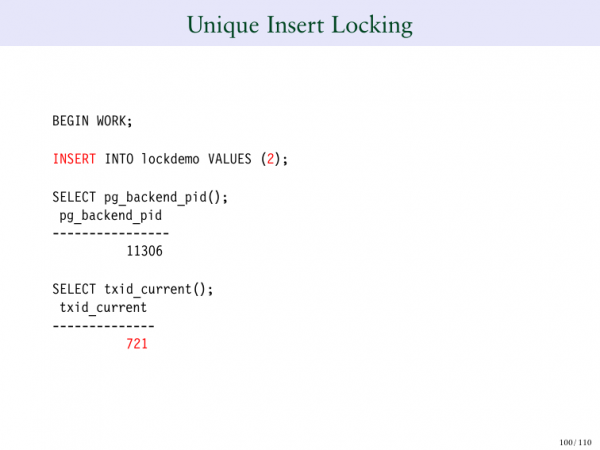
Donc, si je saisis le numéro 2 ici, j'ai donc 2. Mais tout en haut, j'insère un autre 2. Et vous pouvez voir que le 721 a un verrou exclusif. Mais maintenant, 722 attend que 721 termine son opération, car il ne peut pas insérer 2 tant qu'il ne sait pas ce qui va se passer avec 721.
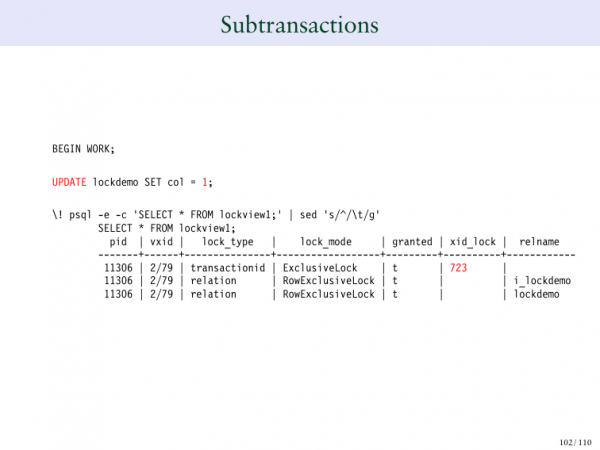
Et si nous faisons une subtransaction.
Voici notre 723.
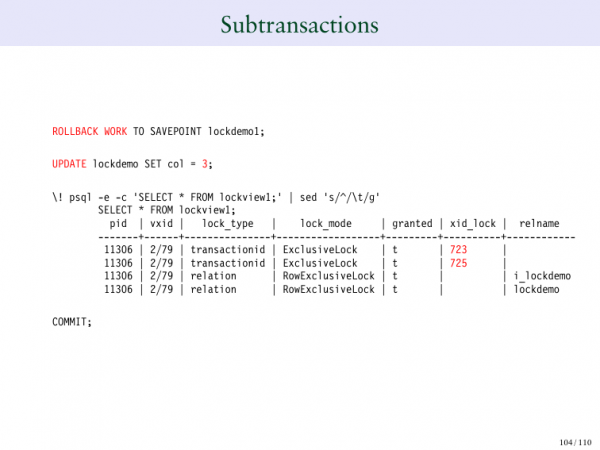
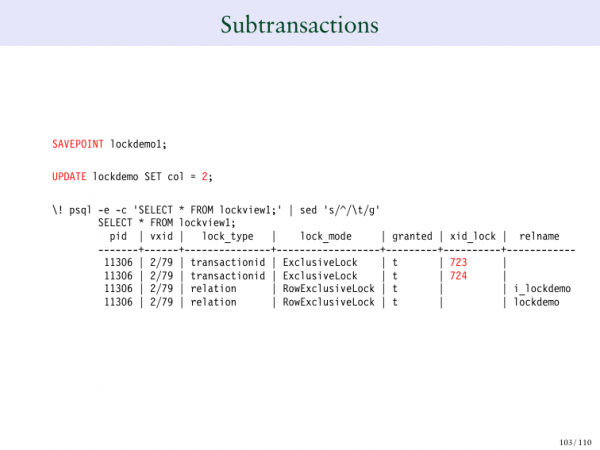
Et si nous conservons un point et que nous le mettons à jour, nous obtenons un nouvel ID de transaction. C'est un autre comportement que vous devez connaître. Si nous le retournons, l'ID de transaction disparaît. 724 disparaît. Mais maintenant, nous avons 725.
Et que suis-je en train d'essayer de faire ici ? J'essaie de vous montrer des exemples de verrouillages inhabituels que vous pourriez rencontrer : que ce soit des verrouillages sérialisables ou des SAVEPOINTS – ce sont différents types de verrouillages qui apparaîtront dans la table des verrouillages.
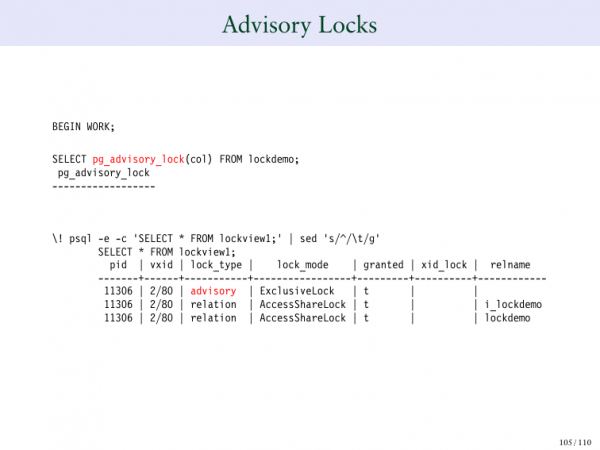
C'est la création de verrouillages explicites qui comportent pg_advisory_lock.
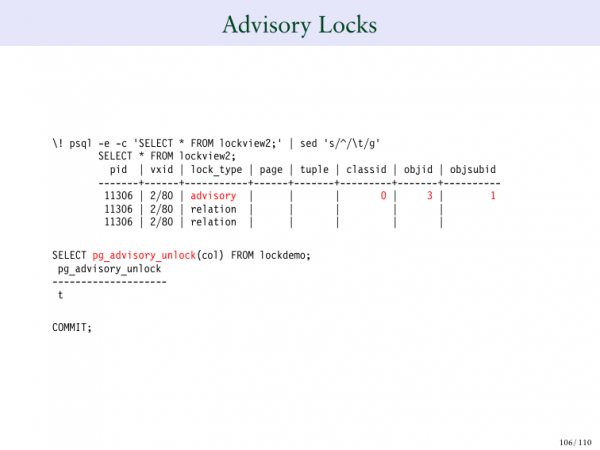
Et vous voyez que le type de verrouillage est listé ici comme étant advisory. Et ici, il est écrit en rouge « advisory ». Et vous pouvez simultanément le bloquer avec pg_advisory_unlock.
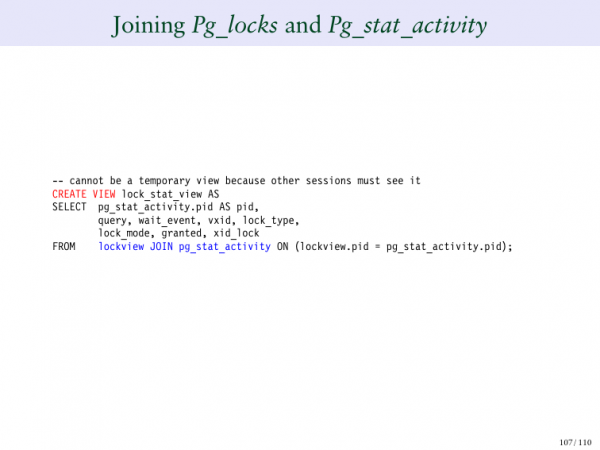
Pour conclure, je voudrais vous montrer une autre chose incroyable. Je vais créer un autre type. Mais je vais lier la table pg_locks à la table pg_stat_activity. Et pourquoi veux-je faire cela ? Parce que cela me permettra de voir toutes les sessions en cours et d'observer quels types de verrouillages elles attendent. C'est assez intéressant de rassembler la table des verrouillages et la table des requêtes.
Et ici, nous créons pg_stat_view.
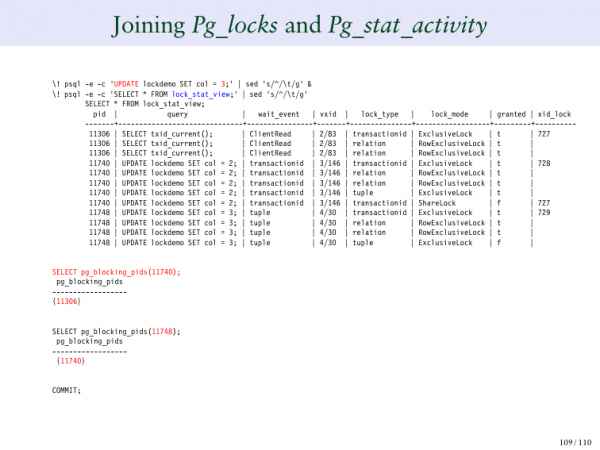
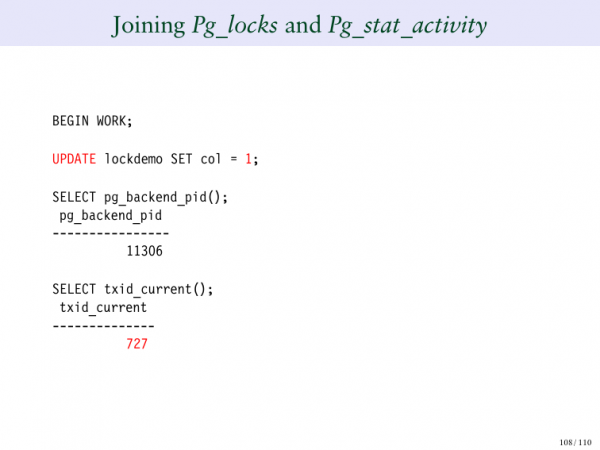
Et nous mettons à jour la ligne à un. Et ici, nous voyons 724. Puis nous mettons notre ligne à trois. Et que voyez-vous ici maintenant ? Ce sont des requêtes, c'est-à-dire que vous voyez toute la liste des requêtes énumérées dans la colonne de gauche. Ensuite, à droite, vous pouvez voir les verrouillages et ce qu'ils créent. C'est peut-être plus clair pour vous afin que vous n'ayez pas à revenir à chaque session pour voir s'il faut y participer ou non. Cela se fait pour nous.
Une autre fonctionnalité qui est très utile est pg_blocking_pidsVous n'en avez probablement jamais entendu parler. Que fait-elle ? Elle nous permet de dire que pour cette session 11740, quels ID de processus elle attend précisément. Et vous pouvez voir que 11740 attend 724. Et 724 est en haut de la liste. Quant à 11306, c'est votre ID de processus. En gros, cette fonction parcourt votre tableau de verrouillage. Je sais que c'est un peu complexe, mais vous parvenez à le comprendre. En substance, cette fonction parcourt ce tableau de verrouillage et essaie de trouver où se trouve cet ID de processus, en tenant compte des verrouillages qu'il attend. Elle essaie également de calculer quel ID de processus est associé à celui qui attend les verrouillages. Vous pouvez donc exécuter cette fonction. pg_blocking_pids.
Et c'est très utile. Nous l'avons ajoutée seulement depuis la version 9.6, donc cette fonction n'a que 5 ans, mais elle est extrêmement utile. Il en va de même pour la deuxième requête. Elle montre exactement ce que nous devons voir.
C'est le sujet dont je voulais discuter avec vous. Comme je m'y attendais, nous avons utilisé tout notre temps, car il y avait une si grande quantité de diapositives. Les diapositives sont disponibles en téléchargement. Je voudrais vous remercier d'être ici. Je suis sûr que vous apprécierez le reste de la conférence, merci beaucoup !
Questions :
Par exemple, si j'essaie de mettre à jour des lignes alors qu'une autre session tente de supprimer toute la table. D'après ce que je comprends, il devrait y avoir quelque chose comme un 'intent lock'. Existe-t-il cela dans Postgres ?
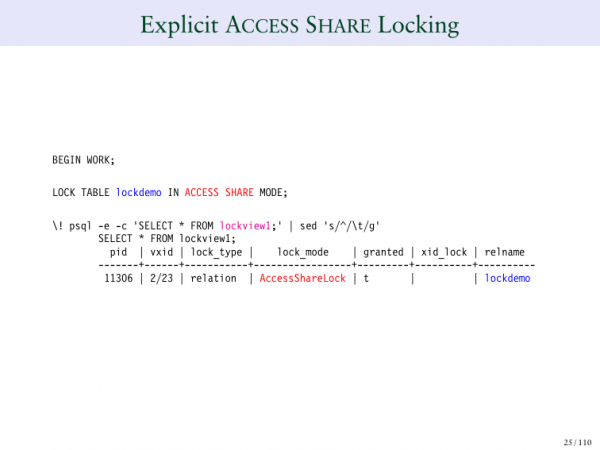
Revenons au tout début. Peut-être vous rappelez-vous que quand vous faites quoi que ce soit, par exemple, un SELECT, nous émettons un AccessShareLock. Et cela empêche la suppression de la table. Donc, si vous souhaitez mettre à jour une ligne dans la table ou en supprimer une, quelqu'un ne peut pas supprimer toute la table en même temps, car vous maintenez cet AccessShareLock sur toute la table et sur la ligne. Une fois que vous avez terminé, ils peuvent la supprimer. Mais tant que vous modifiez quelque chose, ils ne le peuvent pas.
Faisons-le encore une fois. Passons à un exemple de suppression. Et vous voyez qu'il y a un verrou exclusif sur toute la table sur cette ligne.
Cela ressemblera à un verrou exclusif, n'est-ce pas ?
Oui, cela ressemble à cela. Je comprends de quoi vous parlez. Vous dites que si j'exécute un SELECT, je vais avoir un ShareExclusive, et ensuite je le transforme en état Row Exclusive, est-ce que cela pose problème ? Mais étrangement, cela ne crée pas de problème. Cela ressemble à une élévation du niveau de verrouillage, mais en substance, j'ai un verrou qui empêche la suppression. Et maintenant, quand je rends ce verrou plus puissant, il empêche toujours la suppression. Donc, ce n'est pas comme si je montais en niveau. C'est-à-dire qu'il l'empêchait même quand il était à un niveau inférieur, donc lorsque j'élève son niveau, il empêche toujours la suppression de la table.
Je comprends de quoi vous parlez. Il n'y a pas de cas d'augmentation du niveau de verrouillage où vous essayez de renoncer à un verrou pour en introduire un plus puissant. Ici, cela augmente simplement globalement cette prévention, donc cela ne provoque aucun conflit. Mais c'est une bonne question. Merci beaucoup de l'avoir posée !
Que devons-nous faire pour éviter une situation de deadlock lorsque nous avons de nombreuses sessions et un grand nombre d'utilisateurs ?
Postgres détecte automatiquement les situations de deadlock. Et il supprimera automatiquement l'une des sessions. Le seul moyen d'éviter la situation de deadlocks est de verrouiller les gens dans le même ordre. Donc, lorsque vous regardez votre application, la plupart du temps, la cause des deadlocks... Imaginons que je veuille verrouiller deux choses différentes. Une application verrouille la table 1, et une autre application verrouille la 2, puis la table 1. Et la façon la plus simple d'éviter les deadlocks est de voir votre application et d'essayer de vous assurer que le verrouillage se fait dans le même ordre dans toutes les applications. Et cela élimine généralement 80 % des problèmes, car diverses personnes écrivent ces applications. Et si vous les verrouillez dans le même ordre, vous ne rencontrerez pas de situation de deadlock.
Merci beaucoup pour votre présentation ! Vous parliez de vacuum full, et si je comprends bien, vacuum full déforme l'ordre des enregistrements dans le stockage séparé, donc il maintient les enregistrements actuels inchangés. Et pourquoi vacuum full nécessite-t-il un accès exclusif au verrou et pourquoi cela entre-t-il en conflit avec les opérations d'écriture ?
C'est une bonne question. La raison en est que le vacuum full prend la table. Nous créons essentiellement une nouvelle version de la table. Ce sera donc une toute nouvelle version de la table. Et le problème est que, lorsque nous faisons cela, nous ne voulons pas que les gens lisent l'ancienne version, car nous avons besoin qu'ils voient la nouvelle table. C'est donc lié à votre question précédente. Si nous pouvions lire simultanément, nous ne pourrions pas déplacer et diriger les gens vers la nouvelle table. Nous devrions attendre que chacun ait fini de lire cette table, ce qui en gros crée une situation de verrouillage exclusif.
Nous disons simplement que nous bloquons dès le départ, car nous savons qu'à la fin, nous aurons besoin d'un verrouillage exclusif pour déplacer tout le monde vers la nouvelle copie. Donc potentiellement, nous pouvons permettre cela. Et nous faisons cela avec un indexage simultané. Mais c'est beaucoup plus compliqué à réaliser. Et cela se rapporte fortement à votre question précédente sur le verrouillage exclusif.
Est-il possible d'ajouter un délai d'attente de verrouillage dans Postgres ? Dans Oracle, je peux par exemple écrire « sélectionner pour mise à jour » et attendre 50 secondes avant la mise à jour. Cela était bon pour l'application. Mais dans Postgres, je dois soit le faire immédiatement et ne pas attendre du tout, soit attendre jusqu'à un certain moment.
Oui, vous pouvez choisir un délai d'attente pour vos verrouillages. Vous pouvez également émettre la commande no way, qui sera …, si vous ne pouvez pas obtenir le verrou immédiatement. Donc soit un délai d'attente de verrouillage, soit autre chose qui permettra cela. Cela ne se fait pas au niveau syntaxique. Cela se fait comme une variable sur le serveur. Parfois, cela ne peut pas être utilisé.
Pouvez-vous ouvrir le diapositive 75 ?
Oui.
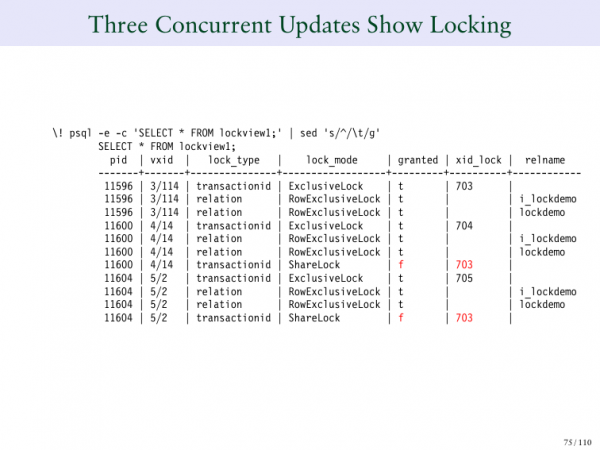
Et ma question est la suivante. Pourquoi les deux processus de mise à jour attendent-ils 703 ?
C'est une question très pertinente. Je ne comprends d'ailleurs pas pourquoi Postgres fait cela. Mais lorsque 703 a été créé, il s'attendait à 702. Et quand 704 et 705 apparaissent, il semble qu'ils ne sachent pas ce qu'ils attendent, parce qu'il n'y a rien pour l'instant. Et Postgres agit ainsi : quand vous ne pouvez pas obtenir un verrou, il se dit « Pourquoi vous traiter ? », car vous attendez déjà quelqu'un. Donc, laissons-le en suspens, il ne met à jour rien du tout. Mais que se passe-t-il ici ? Une fois que 702 a terminé le processus et que 703 a obtenu son verrou, le système revient en arrière. Et il dit que maintenant nous avons deux personnes en attente. Et ensuite, mettons-les à jour ensemble. Et indiquons que les deux attendent.
Je ne sais pas pourquoi Postgres fait cela. Mais il y a un problème appelé f…. Il me semble que ce n'est pas un terme en français. C'est quand tout le monde attend un verrou, même si 20 instances attendent le même verrou. Et tout à coup, ils se réveillent tous en même temps. Tous commencent à essayer de réagir. Mais le système fait que tout le monde attend 703. Parce qu'ils attendent tous, et nous les mettons immédiatement en file. Et si une nouvelle demande apparaît, par exemple, 707, il y aura à nouveau un vide.
Et je pense que c'est fait pour pouvoir dire qu'à ce stade 702 attend 703, alors que tous ceux qui viennent après n'ont aucune note dans ce champ. Mais dès que le premier en attente part, tous ceux qui attendaient à ce moment-là avant la mise à jour reçoivent le même marqueur. Et donc, il me semble que c'est fait pour que nous puissions traiter dans l'ordre, afin qu'ils soient correctement classés.
Je l'ai toujours vu comme un phénomène assez étrange. Parce qu'ici, par exemple, nous ne les énumérons pas du tout. Mais il me semble que chaque fois que nous donnons un nouveau verrou, nous regardons toutes les personnes en attente. Ensuite, nous les mettons tous en file. Et ensuite, toute nouvelle arrivée ne sera mise en file que lorsque la personne suivante aura terminé le traitement. Très bonne question. Merci beaucoup pour votre question !
Il me semble beaucoup plus logique que 705 attende 704.
Mais le problème est le suivant.Techniquement, vous pouvez réveiller l'un ou l'autre. Et donc nous allons réveiller l'un ou l'autre. Mais que se passe-t-il dans le fonctionnement du système ? Vous voyez que 703, tout en haut, a verrouillé son propre ID de transaction. C'est comme ça que Postgres fonctionne. Et 703 est bloqué par son propre ID de transaction, donc, si quelqu'un veut attendre, il attendra 703. Et en gros, 703 se termine. Et ce n'est qu'après son achèvement qu'un des processus se réveille. Et nous ne savons pas quel processus se réveillera. Ensuite, nous traitons progressivement tout. Mais il n'est pas clair quel processus se réveille en premier, car cela peut être n'importe lequel de ces processus. En gros, nous avions un planificateur qui disait que nous pouvions maintenant réveiller n'importe lequel de ces processus. Nous choisissons simplement l'un d'eux au hasard. C'est pourquoi les deux doivent être marqués, car nous pouvons réveiller l'un ou l'autre.
Et le problème est que nous avons CP-infini. Et donc, il est tout à fait probable que nous puissions réveiller le plus tardif. Et si, par exemple, nous réveilleons le plus tardif, nous attendrons celui qui vient juste de recevoir le verrou, donc nous ne savons pas qui sera réveillé en premier. Nous créons simplement une telle situation, et le système les réveillera dans un ordre aléatoire.
Oui . Regardez, ils sont aussi intéressants et utiles. Le sujet est, bien sûr, extrêmement complexe. Merci beaucoup, Bruce !
Source : habr.com
