

Contexte
En tant qu'amateur de matériel rétro, j'ai un jour acquis auprès d'un vendeur britannique un ZX Spectrum+. Avec l'ordinateur lui-même, j'ai reçu plusieurs cassettes audio contenant des jeux (dans leur emballage d'origine avec des instructions), ainsi que des programmes enregistrés sur des cassettes sans aucune indication. À ma grande surprise, les données des cassettes âgées de 40 ans se lisaient bien et j'ai réussi à charger presque tous les jeux et programmes à partir de celles-ci.
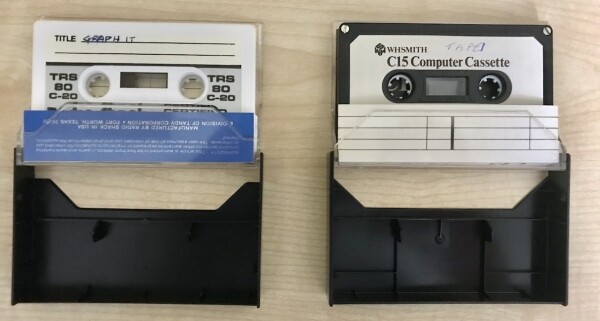
Cependant, sur certaines cassettes, j'ai trouvé des enregistrements qui n'avaient manifestement pas été réalisés par un ZX Spectrum. Ils sonnaient complètement différemment et, contrairement aux enregistrements de l'ordinateur mentionné, ne commençaient pas par le court chargeur BASIC qui est généralement présent dans les enregistrements de tous les programmes et jeux.
Pendant un certain temps, cela m'a travaillé — j'avais vraiment envie de découvrir ce qui était caché à l'intérieur. Si j'arrivais à lire le signal audio comme une séquence de bytes, je pourrais chercher des symboles ou quelque chose qui indique l'origine du signal. Une sorte d'archéologie rétro.
Maintenant, quand je regarde tout le chemin parcouru et que je regarde les étiquettes des cassettes elles-mêmes, je souris, car
la réponse était juste devant mes yeux tout ce temps
Sur l'étiquette de la cassette de gauche se trouve le nom de l'ordinateur TRS-80, et juste en dessous le nom du fabricant : «Manufactured by Radio Shack in USA»
(Si vous voulez garder le suspense jusqu'à la fin, ne lisez pas le spoiler)
Comparaison des signaux audio
Tout d'abord, numérisons les enregistrements audio. Vous pouvez écouter comment cela sonne :
Et voici comment un enregistrement du ZX Spectrum sonne habituellement :
Dans les deux cas, au début de l'enregistrement, se trouve ce qu'on appelle un ton pilote — un son d'une seule fréquence (dans le premier enregistrement, il est très court <1 sec, mais il est discernable). Le ton pilote sert de signal à l'ordinateur pour se préparer à recevoir des données. En général, chaque ordinateur ne reconnaît que son propre ton pilote par la forme du signal et sa fréquence.
Il faut parler de la forme même du signal. Par exemple, sur le ZX Spectrum, sa forme est rectangulaire :
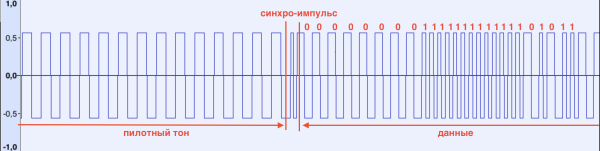
Lorsqu'il détecte le ton pilote, le ZX Spectrum affiche des bandes rouges et bleues alternées sur la partie bord de l'écran, indiquant que le signal a été reconnu. Le ton pilote se termine par une impulsion de synchronisation, qui signale à l'ordinateur de commencer à recevoir des données. Il se caractérise par une durée plus courte (comparée au ton de pilotage et aux données suivantes) (voir illustration)
Une fois le signal de synchronisation reçu, l'ordinateur enregistre chaque montée/descente du signal, mesurant sa durée. Si la durée est inférieure à un seuil défini, un bit 1 est enregistré en mémoire, sinon un bit 0. Les bits sont regroupés en octets et le processus se répète jusqu'à ce que N octets soient obtenus. Le nombre N est généralement tiré de l'en-tête du fichier à charger. La séquence de chargement est la suivante :
- ton pilote
- en-tête (de longueur fixe), contenant la taille des données à charger (N), le nom et le type de fichier
- ton pilote
- les données elles-mêmes
Pour s'assurer que les données sont correctement chargées, le ZX Spectrum lit le dernier octet, appelé octet de parité qui est calculé lors de la sauvegarde du fichier par opération XOR sur tous les octets de données enregistrées. Lors de la lecture du fichier, l'ordinateur calcule l'octet de parité à partir des données reçues et, si le résultat diffère de celui enregistré, il affiche le message d'erreur « R Tape loading error ». Strictement parlant, l'ordinateur peut afficher ce message plus tôt si, lors de la lecture, il ne peut pas reconnaître l'impulsion (si elle est manquée ou si sa durée ne correspond pas à certaines limites)
Jetons maintenant un œil à à quoi ressemble un signal inconnu :
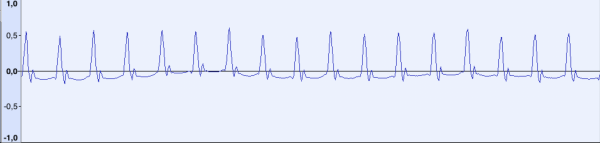
Ceci est le ton de pilotage. La forme du signal diffère considérablement, mais il est clair que le signal est composé d'impulsions courtes répétées à une fréquence déterminée. À une fréquence d'échantillonnage de 44100 Hz, la distance entre les « pics » est d'environ 48 échantillons (ce qui correspond à une fréquence d'environ 918 Hz) Retenons ce chiffre.
Voyons maintenant un fragment avec des données :
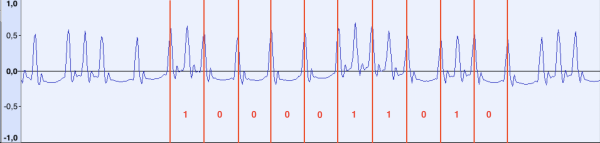
Si l'on mesure la distance entre les différentes impulsions, on constate qu'entre les « longues » impulsions, la distance est encore de ~48 échantillons, tandis qu'entre les courtes, elle est de ~24. En avançant un peu, je dirai qu'il s'est avéré que les impulsions « de référence » à une fréquence de 918 Hz suivent de manière continue, du début à la fin du fichier. On peut supposer que lors de la transmission de données, si une impulsion supplémentaire apparaît entre les impulsions de référence, nous la considérons comme un bit 1, sinon un bit 0.
Qu'en est-il du signal de synchronisation ? Jetons un œil au début des données :
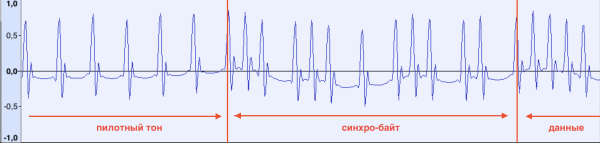
Le ton pilote se termine et les données commencent immédiatement. Un peu plus tard, en analysant plusieurs enregistrements audio différents, nous avons pu découvrir que le premier octet de données est toujours le même (10100101b, A5h). Il est possible que l'ordinateur commence à lire les données après les avoir reçues.
Nous pouvons également faire attention au décalage du premier impulsion de référence juste après le dernier 1 dans le synchroniseur de bits. Nous avons réussi à le détecter beaucoup plus tard dans le processus de développement du programme de reconnaissance des données, lorsque les données en début de fichier ne pouvaient pas être lues de manière stable.
Nous allons maintenant essayer de décrire l'algorithme qui traitera le fichier audio et chargera les données.
Chargement des données
Tout d'abord, considérons quelques hypothèses pour ne pas compliquer l'algorithme :
- Nous allons considérer uniquement les fichiers au format WAV ;
- Le fichier audio doit commencer par un ton pilote et ne doit pas contenir de silence au début.
- Le fichier d'origine doit avoir une fréquence d'échantillonnage de 44100 Hz. Dans ce cas, la distance entre les impulsions de référence dans 48 échantillons est déjà définie et nous n'avons pas besoin de la calculer programmatiquement ;
- Le format des échantillons peut être n'importe quel (8/16 bits/flottant) — car lors de la lecture, nous pouvons le convertir au format nécessaire ;
- Nous supposons que le fichier d'origine est normalisé en amplitude, ce qui devrait stabiliser le résultat ;
L'algorithme de lecture sera le suivant :
- Nous lisons le fichier en mémoire, tout en convertissant simultanément le format des échantillons en 8 bits ;
- Nous déterminons la position de la première impulsion dans les données audio. Pour ce faire, nous devons calculer le numéro de l'échantillon avec l'amplitude maximale. Pour simplifier, nous le calculons une fois manuellement. Nous le stockons dans la variable prev_pos ;
- Nous ajoutons 48 à la position de la dernière impulsion (pos := prev_pos + 48)
- Comme l'augmentation de la position à 48 ne garantit pas que nous atteindrons la position de l'impulsion de référence suivante (défauts de bande, fonctionnement instable du mécanisme de transport de bande, etc.), il est nécessaire d'ajuster la position de l'impulsion pos. Pour cela, prenons un petit échantillon de données (pos-8;pos+8) et trouvons le maximum de la valeur d'amplitude. La position correspondant au maximum sera conservée dans pos. Ici, 8 = 48/6 — une constante obtenue expérimentalement, qui garantit que nous déterminerons le bon maximum sans toucher à d'autres impulsions qui pourraient être à proximité. Dans de très mauvais cas, lorsque la distance entre les impulsions est beaucoup plus petite ou plus grande que 48, une recherche forcée de l'impulsion peut être mise en œuvre, mais je ne décrirai pas cela dans l'algorithme dans le cadre de cet article.
- Lors de l'étape précédente, il est également nécessaire de vérifier que l'impulsion de référence a bien été trouvée. En d'autres termes, simplement chercher le maximum ne garantit pas que l'impulsion soit présente dans cet intervalle. Dans sa dernière version du programme de lecture, je vérifie la différence entre la valeur maximale et minimale de l'amplitude sur l'intervalle, et si elle dépasse une certaine limite, je considère la présence de l'impulsion. La question est également de savoir que faire si l'impulsion de référence n'est pas trouvée. Il y a deux options : soit les données sont épuisées et ensuite il y a un silence, soit cela doit être considéré comme une erreur de lecture. Cependant, omettons cela pour simplifier l'algorithme.
- À l'étape suivante, il faut déterminer la présence d'une impulsion de données (bit 0 ou 1), pour cela, prenons le milieu de l'intervalle (prev_pos;pos) middle_pos égal à middle_pos := (prev_pos+pos)/2 et dans une certaine proximité de middle_pos sur l'intervalle (middle_pos-8;middle_pos+8) nous compterons le maximum et le minimum de l'amplitude. Si la différence entre eux est supérieure à 10, nous enregistrons dans le résultat le bit 1 sinon 0. 10 — une constante obtenue par expérimentation.
- Nous conservons la position actuelle dans prev_pos (prev_pos := pos)
- Nous répétons à partir de l'étape 3, jusqu'à ce que le fichier soit entièrement lu.
- Le tableau de bits obtenu doit être enregistré sous forme d'un ensemble d'octets. Comme nous n'avons pas pris en compte le byte de synchronisation lors de la lecture, le nombre de bits peut ne pas être un multiple de 8, et l'offset en bits nécessaire est également inconnu. Dans ma première implémentation de l'algorithme, je ne savais pas qu'un byte de synchronisation existait et je sauvegardais simplement 8 fichiers avec un décalage de bits différent. L'un d'eux contenait des données correctes. Dans l'algorithme final, je supprime simplement tous les bits jusqu'à A5h, ce qui permet d'obtenir immédiatement un fichier correct en sortie.
L'algorithme en Ruby, pour ceux que ça intéresse.
Comme langage pour écrire le programme, j'ai choisi Ruby, car je programme principalement dans ce langage. Ce n'est pas une solution hautement performante, mais l'objectif d'avoir une vitesse de lecture maximale n'est pas une priorité.
# Используем gem 'wavefile'
require 'wavefile'

reader = WaveFile::Reader.new('input.wav')
samples = []
format = WaveFile::Format.new(:mono, :pcm_8, 44100)

# Читаем WAV файл, конвертируем в формат Mono, 8 bit
# Массив samples будет состоять из байт со значениями 0-255
reader.each_buffer(10000) do |buffer|
  samples += buffer.convert(format).samples
end

# Позиция первого импульса (вместо 0)
prev_pos = 0
# Расстояние между импульсами
distance = 48
# Значение расстояния для окрестности поиска локального максимума
delta = (distance / 6).floor
# Биты будем сохранять в виде строки из "0" и "1"
bits = ""

loop do
  # Рассчитываем позицию следующего импульса
  pos = prev_pos + distance

  # Выходим из цикла если данные закончились
  break if pos + delta >= samples.size

  # Корректируем позицию pos обнаружением максимума на отрезке [pos - delta;pos + delta]
  (pos - delta..pos + delta).each { |p| pos = p if samples[p] > samples[pos] }

  # Находим середину отрезка [prev_pos;pos]
  middle_pos = ((prev_pos + pos) / 2).floor

  # Берем окрестность в середине
  sample = samples[middle_pos - delta..middle_pos + delta]

  # Определяем бит как "1" если разница между максимальным и минимальным значением на отрезке превышает 10
  bit = sample.max - sample.min > 10
  bits += bit ? "1" : "0"
end

# Определяем синхро-байт и заменяем все предшествующие биты на 256 бит нулей (согласно спецификации формата)
bits.gsub! /^[01]*?10100101/, ("0" * 256) + "10100101"

# Сохраняем выходной файл, упаковывая биты в байты
File.write "output.cas", [bits].pack("B*")
Résultat
Après avoir essayé plusieurs variantes de l'algorithme et des constantes, j'ai eu la chance d'obtenir quelque chose d'extrêmement intéressant :
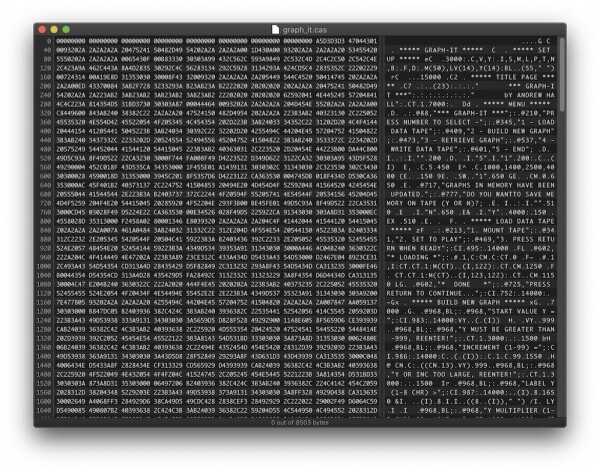
Ainsi, d'après les chaînes de caractères, nous avons un programme pour créer des graphiques. Cependant, le texte du programme ne contient pas de mots-clés. Tous les mots-clés sont codés sous forme d'octets (valeur supérieure à 80h). Maintenant, il faut déterminer quel ordinateur des années 80 pouvait sauvegarder des programmes dans ce format.
En réalité, cela ressemble beaucoup à un programme en langage BASIC. C'est à peu près le même format que celui dans lequel l'ordinateur ZX Spectrum stocke et enregistre des programmes sur cassette. Au cas où, j'ai vérifié les mots-clés pour correspondre avec Cependant, le résultat s'est évidemment révélé négatif.
J'ai également vérifié les mots-clés BASIC des ordinateurs populaires de l'époque comme Atari, Commodore 64 et quelques autres pour lesquels j'ai pu trouver de la documentation, mais en vain — mes connaissances sur les différentes sortes d'ordinateurs rétro n'étaient pas si larges.
J'ai alors décidé de suivre la et c'est alors que mon regard s'est posé sur le nom du fabricant Radio Shack et de l'ordinateur TRS-80. Ces noms étaient justement inscrits sur les étiquettes des cassettes qui étaient sur mon bureau ! Je ne connaissais pas ces noms auparavant et je n'étais pas familier avec l'ordinateur TRS-80, donc il me semblait que Radio Shack était un fabricant de cassettes audio, comme BASF, Sony ou TDK, et que TRS-80 était la durée de reproduction. Pourquoi pas ?
Ordinateur Tandy/Radio Shack TRS-80
Il est très probable que l'enregistrement audio en question, que j'ai utilisé comme exemple au début de l'article, ait été fait sur un tel ordinateur :
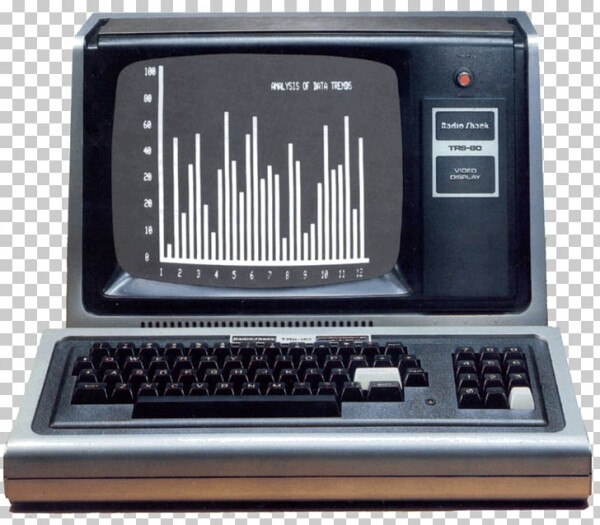
Il s'avère que cet ordinateur et ses variantes (Modèle I/Modèle III/Modèle IV, etc.) étaient très populaires à leur époque (bien sûr, pas en Russie). Il est intéressant de noter que le processeur utilisé dans ces machines était également un Z80. On peut trouver beaucoup d'informations sur cet ordinateur sur Internet . Dans les années 80, les informations sur l'ordinateur étaient diffusées dans des . Actuellement, il existe plusieurs de cet ordinateur pour différentes plateformes.
J'ai téléchargé l'émulateur et j'ai pu voir pour la première fois comment cet ordinateur fonctionnait. Bien sûr, l'ordinateur ne supportait pas la sortie couleur, la résolution de l'écran était de seulement 128x48 pixels, mais il existait de nombreuses extensions et modifications qui pouvaient augmenter la résolution de l'écran. Il y avait également de nombreuses variantes de systèmes d'exploitation pour cet ordinateur et de mises en œuvre du langage BASIC (qui, contrairement au ZX Spectrum, n'était dans certains modèles même pas « gravé » dans la ROM et n'importe quelle version pouvait être chargée depuis une disquette, tout comme le système d'exploitation lui-même)
J'ai également trouvé pour convertir des enregistrements audio en format CAS, qui est pris en charge par les émulateurs, cependant, il a été impossible de lire les enregistrements de mes cassettes pour une raison quelconque.
Après avoir compris le format de fichier CAS (qui s'est révélé simplement être une copie bit à bit des données de la bande que j'avais déjà entre les mains, à l'exception de l'en-tête avec la présence d'un byte de synchronisation), j'ai apporté plusieurs modifications à mon programme et j'ai pu obtenir en sortie un fichier CAS fonctionnel, qui a fonctionné dans l'émulateur (TRS-80 Modèle III):
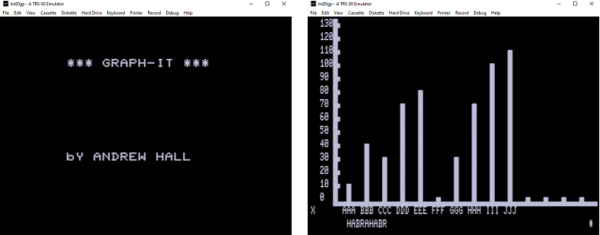
La dernière version de l'outil de conversion avec détection automatique du premier impulsion et de l'espacement entre les impulsions de référence a été conçue sous forme de paquet GEM, le code source est disponible sur .
Conclusion
Le chemin parcouru s'est avéré être un voyage fascinant dans le passé, et je suis heureux d'avoir finalement trouvé la solution. En plus de cela, j'ai:
- Compris le format de sauvegarde des données dans le ZX Spectrum et étudié les sous-programmes intégrés dans la ROM pour sauvegarder/lire des données à partir de cassettes audio
- Familiarisé avec l'ordinateur TRS-80 et ses variantes, étudié le système d'exploitation, examiné des exemples de programmes et même eu l'opportunité de faire du débogage en codes machine (tous les mnémotechniques Z80 me sont bien connus)
- J'ai développé un utilitaire complet pour convertir des enregistrements audio au format CAS, capable de lire des données non reconnues par l'utilitaire « officiel »
Source : habr.com
