

De nos jours, il est impossible d'imaginer un projet basé sur Kubernetes sans la pile ELK, qui permet de conserver les journaux tant des applications que des composants système du cluster. Dans notre pratique, nous utilisons la pile EFK avec Fluentd à la place de Logstash.
Fluentd est un collecteur de journaux moderne et polyvalent, gagnant en popularité et ayant rejoint la Cloud Native Computing Foundation, ce qui oriente les axes de son développement vers une utilisation conjointe avec Kubernetes.
Le choix d'utiliser Fluentd au lieu de Logstash ne change pas l'essence globale du système, cependant, Fluentd présente des spécificités propres, découlant de sa multifonctionnalité.
Par exemple, en commençant à utiliser EFK dans un projet très chargé avec une forte intensité d'écriture de journaux, nous avons constaté qu'à Kibana, certains messages s'affichent plusieurs fois. Dans cet article, nous expliquerons pourquoi ce phénomène se produit et comment résoudre le problème.
Le problème de duplication des documents
Dans nos projets, Fluentd est déployé en tant que DaemonSet (il se lance automatiquement en une seule instance sur chaque nœud du cluster Kubernetes) et surveille les journaux stdout des conteneurs dans /var/log/containers. Après collecte et traitement, les journaux sous forme de documents JSON sont envoyés à ElasticSearch, déployé en mode cluster ou autonome, selon l'ampleur du projet et les exigences de performance et de tolérance aux pannes. Kibana est utilisé comme interface graphique.
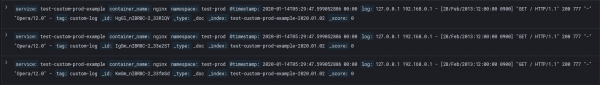
Lors de l'utilisation de Fluentd avec un plugin de mise en mémoire tampon en sortie, nous avons rencontré une situation où certains documents dans ElasticSearch avaient un contenu identique, seulement leur identifiant différait. Pour vérifier qu'il s'agit bien de messages répétés, on peut se référer à un exemple de log Nginx. Dans le fichier de log, ce message n'existe qu'une seule fois :
127.0.0.1 192.168.0.1 - [28/Fév/2013:12:00:00 +0900] "GET / HTTP/1.1" 200 777 "-" "Opera/12.0" -Cependant, dans ElasticSearch, plusieurs documents contiennent ce message :
{
  "_index": "test-custom-prod-example-2020.01.02",
  "_type": "_doc",
  "_id": "HgGl_nIBR8C-2_33RlQV",
  "_version": 1,
  "_score": 0,
  "_source": {
    "service": "test-custom-prod-example",
    "container_name": "nginx",
    "namespace": "test-prod",
    "@timestamp": "2020-01-14T05:29:47.599052886 00:00",
    "log": "127.0.0.1 192.168.0.1 - [28/Fév/2013:12:00:00  0900] "GET / HTTP/1.1" 200 777 "-" "Opera/12.0" -",
    "tag": "custom-log"
  }
}

{
  "_index": "test-custom-prod-example-2020.01.02",
  "_type": "_doc",
  "_id": "IgGm_nIBR8C-2_33e2ST",
  "_version": 1,
  "_score": 0,
  "_source": {
    "service": "test-custom-prod-example",
    "container_name": "nginx",
    "namespace": "test-prod",
    "@timestamp": "2020-01-14T05:29:47.599052886 00:00",
    "log": "127.0.0.1 192.168.0.1 - [28/Fév/2013:12:00:00  0900] "GET / HTTP/1.1" 200 777 "-" "Opera/12.0" -",
    "tag": "custom-log"
  }
}
Cependant, il peut y avoir plus de deux répétitions.
Lors de l'analyse de ce problème dans les journaux de Fluentd, on peut observer un grand nombre d'avertissements du type suivant :
2020-01-16 01:46:46 +0000 [warn]: [test-prod] échec de l'envoi du tampon. retry_time=4 next_retry_seconds=2020-01-16 01:46:53 +0000 chunk="59c37fc3fb320608692c352802b973ce" error_class=Fluent::Plugin::ElasticsearchOutput::RecoverableRequestFailure error="impossible d'envoyer les journaux au cluster Elasticsearch ({:host=>"elasticsearch", :port=>9200, :scheme=>"http", :user=>"elastic", :password=>"obfuscated"}): délai d'attente de lecture atteint"Ces avertissements surviennent lorsque ElasticSearch ne peut pas renvoyer de réponse à la demande dans le temps imparti par le paramètre request_timeout, ce qui empêche le segment de tampon transmis d'être nettoyé. Par la suite, Fluentd essaie d'envoyer le segment de tampon à ElasticSearch à nouveau et après un certain nombre d'essais, l'opération réussit :
2020-01-16 01:47:05 +0000 [warn]: [test-prod] tentative réussie. chunk_id="59c37fc3fb320608692c352802b973ce"
2020-01-16 01:47:05 +0000 [warn]: [test-prod] tentative réussie. chunk_id="59c37fad241ab300518b936e27200747"
2020-01-16 01:47:05 +0000 [warn]: [test-dev] tentative réussie. chunk_id="59c37fc11f7ab707ca5de72a88321cc2"
2020-01-16 01:47:05 +0000 [warn]: [test-dev] tentative réussie. chunk_id="59c37fb5adb70c06e649d8c108318c9b"
2020-01-16 01:47:15 +0000 [warn]: [kube-system] tentative réussie. chunk_id="59c37f63a9046e6dff7e9987729be66f"
Cependant, ElasticSearch considère chacun des segments de tampon retransmis comme unique et leur attribue des valeurs de champ _id uniques lors de l'indexation. C'est ainsi que les copies de messages apparaissent.
Dans Kibana, cela se présente comme suit :
Résoudre le problème
Il existe plusieurs solutions à ce problème. L'une d'elles est le mécanisme de génération de hachage unique pour chaque document intégré dans le plugin fluent-plugin-elasticsearch. En utilisant ce mécanisme, ElasticSearch reconnaîtra les doublons lors de l'envoi et évitera la duplication des documents. Cependant, il ne faut pas négliger que cette méthode lutte contre les conséquences sans résoudre l'erreur de manque de délai d'attente, c'est pourquoi nous avons décidé de ne pas l'utiliser.
Nous utilisons un plugin de mise en tampon en sortie de Fluentd pour éviter la perte de logs en cas de brèves défaillances réseau ou d'une intensité accrue des écritures de logs. Si, pour une quelconque raison, ElasticSearch ne peut pas immédiatement enregistrer un document dans l'indice, le document est mis dans une file d'attente stockée sur disque. Ainsi, dans notre cas, pour éliminer la source du problème qui entraîne l'erreur décrite ci-dessus, il est nécessaire de définir des valeurs correctes pour les paramètres de mise en tampon, de sorte que le tampon de sortie de Fluentd ait un volume suffisant et s'écoule dans le temps imparti.
Il est à noter que les valeurs des paramètres, dont nous parlerons ci-dessous, sont individuelles pour chaque cas d'utilisation de la mise en tampon dans les plugins de sortie, car elles dépendent de nombreux facteurs : l'intensité des écritures de messages dans les logs par les services, la performance du système de disque, la charge du réseau et sa bande passante. Par conséquent, pour obtenir des réglages appropriés pour chaque cas particulier, sans trop d'excès, il est possible de se servir des informations de débogage que Fluentd écrit dans son log pendant son fonctionnement et d'obtenir relativement rapidement des valeurs correctes.
Au moment de la constatation du problème, la configuration était la suivante :
 @type file
        path /var/log/fluentd-buffers/kubernetes.test.buffer
        flush_mode interval
        retry_type exponential_backoff
        flush_thread_count 2
        flush_interval 5s
        retry_forever
        retry_max_interval 30
        chunk_limit_size 8M
        queue_limit_length 8
        overflow_action block
Dans le cadre de la résolution du problème, les valeurs des paramètres suivants ont été ajustées manuellement :
chunk_limit_size — la taille des chunks dans lesquels les messages sont divisés dans le tampon.
- flush_interval — l'intervalle de temps après lequel le tampon est vidé.
- queue_limit_length — le nombre maximum de chunks dans la file d'attente.
- request_timeout — le temps pendant lequel la connexion entre Fluentd et ElasticSearch est établie.
La taille totale du tampon peut être calculée en multipliant les paramètres queue_limit_length et chunk_limit_size, ce qui peut être interprété comme «le nombre maximum de chunks dans la file d'attente, chacun ayant un volume donné». En cas de taille de tampon insuffisante, l'avertissement suivant apparaîtra dans les logs :
2020-01-21 10:22:57 +0000 [warn]: [test-prod] échec de l'écriture des données dans le tampon en raison de l'action de débordement du tampon : action=:blockCela signifie que le tampon ne se vide pas dans le temps imparti et que les données arrivant dans un tampon plein sont bloquées, ce qui entraînera la perte d'une partie des logs.
Le tampon peut être augmenté de deux manières : en augmentant soit la taille de chaque chunk dans la file d'attente, soit le nombre de chunks pouvant être présents dans la file d'attente.
Si la taille du chunk chunk_limit_size est définie à plus de 32 mégaoctets, ElasticSearch ne l'acceptera pas car le paquet entrant sera trop volumineux. Par conséquent, si une augmentation supplémentaire du tampon est nécessaire, il est préférable d'augmenter la longueur maximale de la file d'attente queue_limit_length.
Lorsque le tampon cesse de déborder et qu'il ne reste qu'un message concernant un manque de timeout, vous pouvez commencer à augmenter le paramètre request_timeout. Cependant, si vous définissez une valeur supérieure à 20 secondes, des avertissements suivants commenceront à apparaître dans les logs de Fluentd :
2020-01-21 09:55:33 +0000 [warn]: [test-dev] le vidage du tampon a pris plus de temps que le slow_flush_log_threshold : elapsed_time=20.85753920301795 slow_flush_log_threshold=20.0 plugin_id="postgresql-dev" Ce message n'a aucune incidence sur le fonctionnement du système et signifie que le temps de vidage du tampon a été supérieur à ce que définit le slow_flush_log_threshold. Il s'agit d'une information de débogage que nous utilisons lors de l'ajustement de la valeur du paramètre request_timeout.
L'algorithme de réglage général est le suivant :
- Définir la valeur de request_timeout bien supérieure à ce qui est nécessaire (centaines de secondes). Pendant le réglage, le critère principal pour la bonne définition de ce paramètre sera la disparition des avertissements concernant le manque de timeout.
- Attendre l'apparition des messages indiquant que le seuil slow_flush_log_threshold a été dépassé. Dans le texte de l'avertissement, le champ elapsed_time indiquera le temps réel du vidage du tampon.
- Configure the request_timeout value to be greater than the maximum elapsed_time recorded during the monitoring period. We calculate the request_timeout value as elapsed_time + 50%.
- To remove warnings about slow buffer flushing from the logs, you can increase the slow_flush_log_threshold value. We calculate this value as elapsed_time + 25%.
The final values of these parameters, as noted earlier, are unique to each case. Following the above algorithm, we can reliably eliminate the error that leads to repeated messages.
The table below shows how the number of daily errors that result in message duplication changes as we adjust the values of the parameters described above:
node-1
node-2
node-3
node-4
Before/After
Before/After
Before/After
Before/After
failed to flush the buffer
1749/2
694/2
47/0
1121/2
retry succeeded
410/2
205/1
24/0
241/2
It is also worth noting that the configured settings may become outdated as the project grows and the volume of logs increases. A primary indication of an insufficiently set timeout is the return of Fluentd log messages about slow buffer flushing, meaning the slow_flush_log_threshold has been exceeded. From this point, there is still a slight buffer before surpassing the request_timeout parameter, so it is essential to react timely to these messages and repeat the process of adjusting the optimal settings described above.
Conclusion
Fine-tuning the output buffer of Fluentd is one of the key stages in configuring the EFK stack, determining its operational stability and the correct placement of documents in indexes. By following the described tuning algorithm, one can be sure that all logs will be recorded in the ElasticSearch index in the correct order, without repetitions and losses.
Lisez aussi d'autres articles sur notre blog :
Source : habr.com
