

Souvent, les personnes qui s'aventurent dans le domaine de la Data Science ont des attentes peu réalistes sur ce qui les attend. Beaucoup pensent qu'ils vont commencer à écrire des réseaux de neurones impressionnants, créer un assistant vocal comme Iron Man, ou battre tous les autres sur les marchés financiers.
Mais le travail Données de Data Scientist est centré sur les données, et l'un des moments les plus cruciaux et chronophages est le traitement des données avant de les soumettre à un réseau de neurones ou de les analyser d'une certaine manière.
Dans cet article, notre équipe décrira comment il est possible de traiter facilement et rapidement les données avec un guide étape par étape et du code. Nous avons essayé de rendre le code suffisamment flexible pour qu'il puisse être appliqué à différents ensembles de données.
Beaucoup de professionnels ne trouveront peut-être rien d'extraordinaire dans cet article, mais les débutants pourront y découvrir quelque chose de nouveau, et tous ceux qui ont longtemps rêvé de créer un notebook dédié au traitement rapide et structuré des données pourront copier le code et l'adapter à leurs besoins, ou
Nous avons obtenu le dataset. Que faire ensuite ?
Ainsi, la norme : il faut comprendre de quoi nous avons affaire, avoir une vue d'ensemble. Pour cela, nous utiliserons pandas afin de définir simplement les différents types de données.
import pandas as pd #importons pandas
import numpy as np  #importons numpy
df = pd.read_csv("AB_NYC_2019.csv") #lisons le dataset et le stockons dans la variable df
df.head(3) #regardons les 3 premières lignes pour comprendre à quoi ressemblent les valeurs 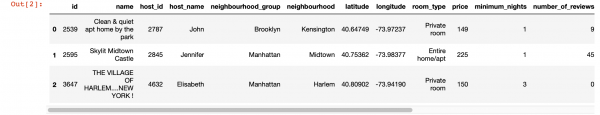
df.info() #Affichons les informations sur les colonnes 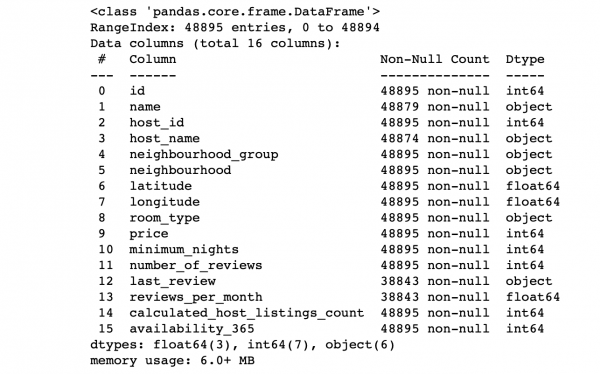
Regardons les valeurs des colonnes :
- Le nombre de lignes de chaque colonne correspond-il au nombre total de lignes ?
- Quelle est la nature des données dans chaque colonne ?
- Quelle colonne souhaitons-nous définir comme cible pour effectuer des prédictions ?
Les réponses à ces questions permettront d'analyser le dataset et d'esquisser un plan pour les actions à venir.
De plus, pour un aperçu plus approfondi des valeurs de chaque colonne, nous pouvons utiliser la fonction pandas describe(). Cependant, le inconvénient de cette fonction est qu'elle ne fournit pas d'informations sur les colonnes contenant des valeurs de type chaîne. Nous nous en occuperons plus tard.
df.describe() 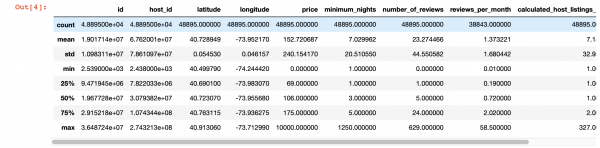
Visualisation magique
Jetons un œil à l'endroit où nous manquons complètement de valeurs :
import seaborn as sns
sns.heatmap(df.isnull(),yticklabels=False,cbar=False,cmap='viridis') 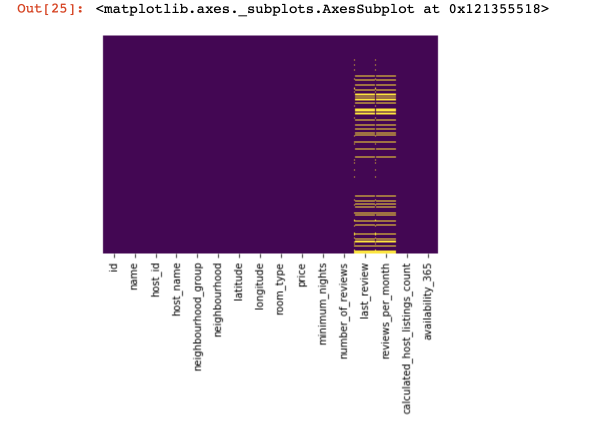
C'était un petit aperçu, maintenant nous allons aborder des choses plus intéressantes.
Essayons de trouver et, si possible, de supprimer les colonnes qui contiennent une seule valeur dans toutes les lignes (elles n'auront aucun impact sur le résultat) :
df = df[[c for c
        in list(df)
        if len(df[c].unique()) > 1]] #Nous réécrivons le dataset, en gardant uniquement les colonnes avec plus d'une valeur unique.
Maintenant, protégeons-nous et assurons le succès de notre projet contre les lignes dupliquées (lignes contenant les mêmes informations dans le même ordre que l'une des lignes existantes) :
df.drop_duplicates(inplace=True) #Nous faisons cela si nous le jugeons nécessaire.
                                 #Dans certains projets, il n'est pas judicieux de supprimer ces données dès le départ.
Nous séparons le dataset en deux : un avec des valeurs qualitatives et un autre avec des valeurs quantitatives.
Il convient de préciser que si les lignes avec des données manquantes pour les données qualitatives et quantitatives ne sont pas fortement corrélées, il faudra prendre une décision sur ce que nous sacrifions : toutes les lignes avec des données manquantes, seulement une partie d'entre elles ou certaines colonnes. En revanche, si les lignes sont corrélées, nous avons le droit de diviser le dataset en deux. Sinon, il faudra d'abord s'occuper des lignes où les données manquantes ne correspondent pas entre les qualitatives et les quantitatives, et seulement ensuite diviser le dataset en deux.
df_numerical = df.select_dtypes(include=[np.number])
df_categorical = df.select_dtypes(exclude=[np.number])
Nous faisons cela pour faciliter le traitement de ces deux types de données différents — nous comprendrons ensuite à quel point cela simplifie notre vie.
Travaillons avec les données quantitatives.
La première chose à faire est de déterminer s'il n'y a pas de « colonnes-espions » dans les données quantitatives. Nous les appelons ainsi car elles se présentent comme des données quantitatives, mais fonctionnent comme des qualitatives.
Comment les identifier ? Bien sûr, tout dépend de la nature des données que vous analysez, mais en général, ces colonnes peuvent avoir peu de données uniques (environ 3-10 valeurs uniques).
print(df_numerical.nunique())Après avoir déterminé les colonnes-espions, nous les déplacerons des données quantitatives vers les qualitatives :
spy_columns = df_numerical[['colonne1', 'colonne2', 'colonne3']]#Nous extrayons les colonnes espion et les enregistrons dans un dataframe séparé
df_numerical.drop(labels=['colonne1', 'colonne2', 'colonne3'], axis=1, inplace = True)#Nous coupons ces colonnes des données numériques
df_categorical.insert(1, 'colonne1', spy_columns['colonne1']) #Nous ajoutons la première colonne espion aux données qualitatives
df_categorical.insert(1, 'colonne2', spy_columns['colonne2']) #Nous ajoutons la deuxième colonne espion aux données qualitatives
df_categorical.insert(1, 'colonne3', spy_columns['colonne3']) #Nous ajoutons la troisième colonne espion aux données qualitatives
Enfin, nous avons complètement séparé les données numériques des données qualitatives et nous pouvons désormais travailler correctement avec elles. Pour commencer, nous devons comprendre où nous avons des valeurs manquantes (NaN, et dans certains cas 0 seront considérés comme des valeurs manquantes).
for i in df_numerical.columns:
    print(i, df[i][df[i]==0].count())
À ce stade, il est important de comprendre dans quelles colonnes des zéros peuvent représenter des valeurs manquantes : cela est-il lié à la manière dont les données ont été collectées ? Ou cela peut-il être lié aux valeurs des données ? Ces questions doivent être abordées au cas par cas.
Donc, si nous avons décidé que les données peuvent être manquantes là où il y a des zéros, nous devrions remplacer les zéros par NaN pour faciliter le traitement de ces données perdues :
df_numerical[["colonne 1", "colonne 2"]] = df_numerical[["colonne 1", "colonne 2"]].replace(0, nan)Maintenant, regardons où nous avons des données manquantes :
sns.heatmap(df_numerical.isnull(),yticklabels=False,cbar=False,cmap='viridis') # Vous pouvez également utiliser df_numerical.info() 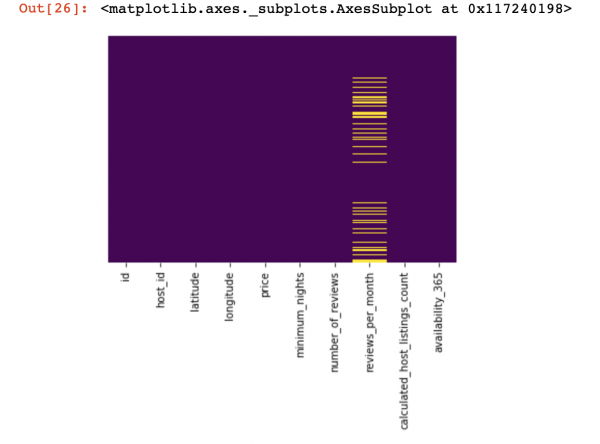
Les valeurs dans les colonnes qui sont absentes doivent être marquées en jaune ici. Et la question la plus intéressante commence maintenant : comment traiter ces valeurs ? Supprimer les lignes avec ces valeurs ou les colonnes ? Ou remplir ces valeurs manquantes avec d'autres ?
Voici un schéma approximatif qui peut vous aider à décider de ce que vous pouvez faire avec les valeurs manquantes :
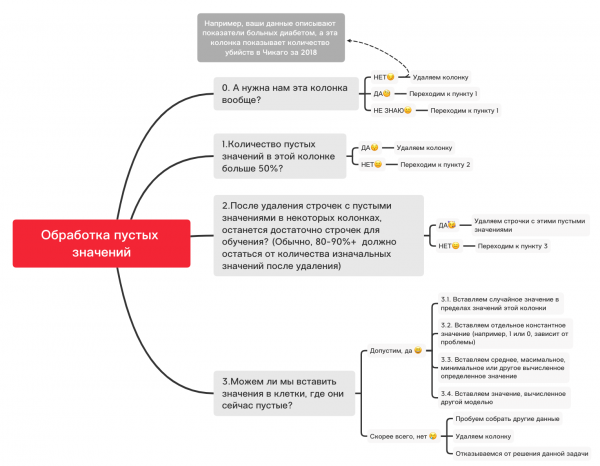
0. Supprimer les colonnes inutiles
df_numerical.drop(labels=["colonne1","colonne2"], axis=1, inplace=True)1. Le nombre de valeurs manquantes dans cette colonne est-il supérieur à 50 % ?
print(df_numerical.isnull().sum() / df_numerical.shape[0] * 100)df_numerical.drop(labels=["colonne1","colonne2"], axis=1, inplace=True)#Supprimer si une colonne a plus de 50 valeurs manquantes2. Supprimer les lignes avec des valeurs manquantes
df_numerical.dropna(inplace=True)#Supprimer les lignes avec des valeurs vides, si suffisamment de données restent pour l'apprentissage3.1. Insérer une valeur aléatoire
import random #importer random
df_numerical["colonne"].fillna(lambda x: random.choice(df[df[column] != np.nan]["colonne"]), inplace=True) #insérer des valeurs aléatoires dans les cellules vides du tableau
3.2. Insérer une valeur constante
from sklearn.impute import SimpleImputer #importer SimpleImputer, qui aidera à insérer des valeurs
imputer = SimpleImputer(strategy='constant', fill_value="") #insérer une valeur spécifique avec SimpleImputer
df_numerical[["nouvelle_colonne1",'nouvelle_colonne2','nouvelle_colonne3']] = imputer.fit_transform(df_numerical[['colonne1', 'colonne2', 'colonne3']]) #Appliquer cela à notre tableau
df_numerical.drop(labels = ["colonne1","colonne2","colonne3"], axis = 1, inplace = True) #Supprimer les colonnes avec d'anciennes valeurs
3.3. Insérer la moyenne ou la valeur la plus fréquente
from sklearn.impute import SimpleImputer #importer SimpleImputer, qui aidera à insérer des valeurs
imputer = SimpleImputer(strategy='mean', missing_values = np.nan) #au lieu de mean, on peut également utiliser most_frequent
df_numerical[["nouvelle_colonne1",'nouvelle_colonne2','nouvelle_colonne3']] = imputer.fit_transform(df_numerical[['colonne1', 'colonne2', 'colonne3']]) #Appliquer cela à notre tableau
df_numerical.drop(labels = ["colonne1","colonne2","colonne3"], axis = 1, inplace = True) #Supprimer les colonnes avec d'anciennes valeurs
3.4. Insérer une valeur calculée par un autre modèle
Parfois, les valeurs peuvent être calculées à l'aide de modèles de régression, en utilisant des modèles de la bibliothèque sklearn ou d'autres bibliothèques similaires. Notre équipe consacrera un article séparé sur la manière de procéder dans un avenir proche.
Ainsi, le récit sur les données quantitatives s'interrompt pour l'instant, car il existe de nombreux autres aspects sur la meilleure façon de réaliser la préparation et le prétraitement des données pour différentes tâches, et les concepts de base pour les données quantitatives ont été abordés dans cet article. Il est maintenant temps de revenir aux données qualitatives, que nous avons séparées quelques étapes en arrière des quantitatives. Vous pouvez modifier ce notebook comme bon vous semble, l'adaptant à différentes tâches, afin que le prétraitement des données se déroule très rapidement !
Données qualitatives
Principalement, la méthode de One-hot-encoding est utilisée pour formater les données qualitatives de string (ou objet) en numérique. Avant d'aborder ce point, utilisons le schéma et le code ci-dessus pour examiner les valeurs manquantes.
df_categorical.nunique()sns.heatmap(df_categorical.isnull(), yticklabels=False, cbar=False, cmap='viridis') 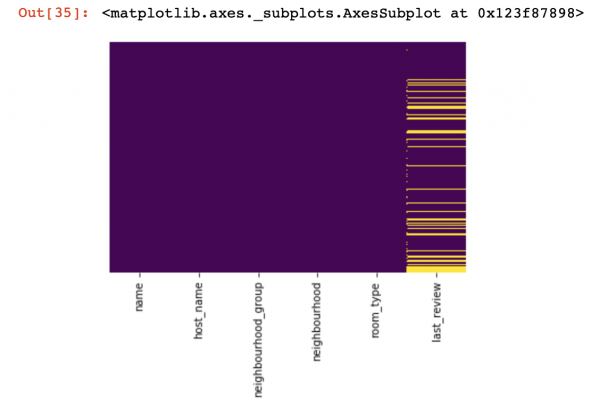
0. Supprimer les colonnes inutiles
df_categorical.drop(labels=["colonne1", "colonne2"], axis=1, inplace=True)1. Le nombre de valeurs manquantes dans cette colonne est-il supérieur à 50 % ?
print(df_categorical.isnull().sum() / df_numerical.shape[0] * 100)df_categorical.drop(labels=["colonne1", "colonne2"], axis=1, inplace=True) # Supprimez si une colonne a plus de 50 % de valeurs manquantes2. Supprimer les lignes avec des valeurs manquantes
df_categorical.dropna(inplace=True) # Supprimez les lignes avec des valeurs manquantes, si suffisamment de données restent pour l'apprentissage3.1. Insérer une valeur aléatoire
import random
df_categorical["colonne"].fillna(lambda x: random.choice(df[df[column] != np.nan]["colonne"]), inplace=True)
3.2. Insérer une valeur constante
from sklearn.impute import SimpleImputer
imputer = SimpleImputer(strategy='constant', fill_value="")
df_categorical[["nouvelle_colonne1", 'nouvelle_colonne2', 'nouvelle_colonne3']] = imputer.fit_transform(df_categorical[['colonne1', 'colonne2', 'colonne3']])
df_categorical.drop(labels=["colonne1", "colonne2", "colonne3"], axis=1, inplace=True)
Nous avons donc enfin résolu le problème des valeurs manquantes dans les données qualitatives. Il est maintenant temps de procéder à l'encodage one-hot pour les valeurs dans votre base de données. Cette méthode est extrêmement courante afin que votre algorithme puisse être formé en tenant compte des données qualitatives.
def encode_and_bind(original_dataframe, feature_to_encode):
    dummies = pd.get_dummies(original_dataframe[[feature_to_encode]])
    res = pd.concat([original_dataframe, dummies], axis=1)
    res = res.drop([feature_to_encode], axis=1)
    return(res)
features_to_encode = ["colonne1", "colonne2", "colonne3"]
for feature in features_to_encode:
df_categorical = encode_and_bind(df_categorical, feature)Nous avons donc enfin terminé de traiter séparément les données qualitatives et quantitatives — il est temps de les regrouper.
new_df = pd.concat([df_numerical, df_categorical], axis=1)Après avoir fusionné les datasets en un seul, nous pouvons utiliser la transformation des données avec MinMaxScaler de la bibliothèque sklearn. Cela fera en sorte que nos valeurs soient comprises entre 0 et 1, ce qui aidera lors de la formation du modèle à l'avenir.
from sklearn.preprocessing import MinMaxScaler
min_max_scaler = MinMaxScaler()
new_df = min_max_scaler.fit_transform(new_df)
Ces données sont maintenant prêtes pour tout — pour les réseaux neuronaux, les algorithmes d'apprentissage automatique standard, etc. !
Dans cet article, nous n'avons pas pris en compte le traitement des données concernant les séries chronologiques, car pour ces données, il convient d'utiliser des techniques légèrement différentes en fonction de votre tâche. À l'avenir, notre équipe consacrera un article séparé à ce sujet, et nous espérons qu'il pourra apporter quelque chose d'intéressant, de nouveau et d'utile dans votre vie, tout comme celui-ci.
Source : habr.com
