

La surveillance est devenue un élément crucial des solutions cloud en pleine croissance, en raison de la complexité croissante des systèmes distribués. Elle est nécessaire pour comprendre leur comportement. Des outils évolutifs sont nécessaires pour collecter des données depuis tous les services - et fournir aux spécialistes une interface unique avec une analyse des performances, une démonstration des erreurs, la disponibilité et les journaux.
Ces outils doivent également être efficaces et performants. Dans cet article, nous examinerons deux piles technologiques populaires : EFK (Elasticsearch) et PLG (Loki), et nous analyserons leurs architectures et différences.
La pile EFK
Vous avez peut-être déjà entendu parler du très populaire ELK ou EFK. La pile se compose de plusieurs parties distinctes : Elasticsearch (stockage d'objets), Logstash ou FluentD (collecte et agrégation des journaux) et Kibana pour la visualisation.
Un schéma de fonctionnement typique ressemble à ceci :
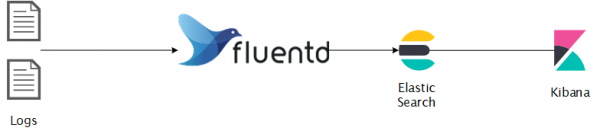
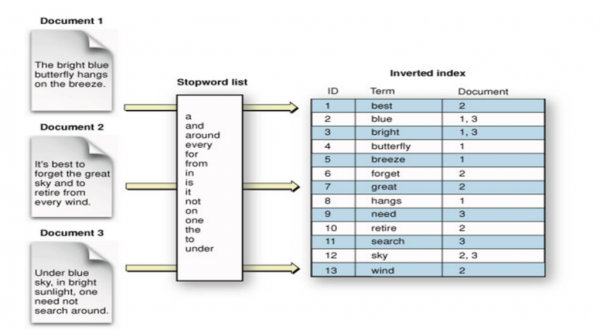
Elasticsearch — un stockage d'objets distribué avec recherche et analyse en temps réel. Excellente solution pour les données partiellement structurées, comme les journaux. Les informations sont conservées sous forme de documents JSON, indexées en temps réel et réparties sur les nœuds du cluster. Un index inversé est utilisé, contenant tous les mots uniques et les documents associés pour la recherche plein texte, qui est elle-même basée sur le moteur de recherche Apache Lucene.
FluentD — est un agrégateur de données qui uniformise les données lors de leur collecte et consumption. Il s’efforce de structurer les données en JSON autant que possible. Son architecture est extensible, avec plus de , soutenues par la communauté, pour tous les cas de figure.
Kibana — est un outil de visualisation de données pour Elasticsearch, avec diverses fonctionnalités supplémentaires, telles que l'analyse des séries temporelles, des graphes, l'apprentissage automatique et plus encore.
Architecture d'Elasticsearch
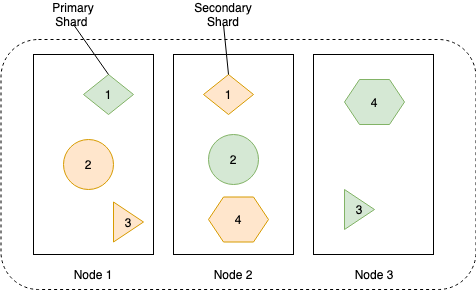
Les données du cluster Elasticsearch sont dispersées sur tous les nœuds. Le cluster se compose de plusieurs nœuds pour améliorer la disponibilité et la résilience. Chaque nœud peut remplir tous les rôles du cluster, mais dans les déploiements évolutifs à grande échelle, des tâches distinctes sont généralement assignées aux nœuds.
Types de nœuds de cluster :
- nœud maître — gère le cluster, minimum de trois nécessaires, un toujours actif;
- nœud de données — stocke les données indexées et effectue diverses tâches avec celles-ci;
- ingest node — organise des pipelines pour la transformation des données avant l'indexation ;
- coordinating node — routage des requêtes, réduction de la phase de traitement de recherche, coordination de l'indexation en masse ;
- alerting node — déclenchement de tâches d'alerte ;
- machine learning node — traitement des tâches d'apprentissage automatique.
Le diagramme ci-dessous montre comment les données sont sauvegardées et répliquées entre les nœuds pour atteindre une plus haute disponibilité des données.
Les données de chaque réplique sont stockées dans un index inversé, le schéma ci-dessous montre comment cela se produit :
Installation
Vous pouvez consulter les détails , je vais utiliser le helm chart :
$ helm install efk-stack stable/elastic-stack --set logstash.enabled=false --set fluentd.enabled=true --set fluentd-elasticsStack PLG
Ne soyez pas surpris si vous ne trouvez pas cet acronyme, car on le connaît mieux sous le nom de Grafana Loki. Quoi qu'il en soit, cette pile gagne en popularité car elle applique des solutions techniques éprouvées. Vous avez peut-être déjà entendu parler de Grafana, un outil de visualisation populaire. Ses créateurs, s'inspirant de Prometheus, ont développé Loki, un système d'agrégation de journaux hautement performant et scalable horizontalement. Loki n'indexe que les métadonnées, pas les journaux eux-mêmes, cette solution technique lui a permis d'être simple à utiliser et économiquement viable.
Promtail — agent pour envoyer des journaux du système d'exploitation au cluster Loki. Grafana — un outil de visualisation basé sur des données provenant de Loki.
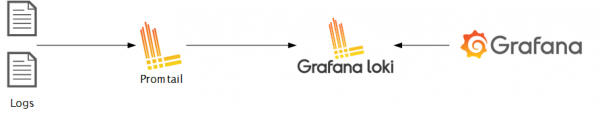
Loki est construit sur les mêmes principes que Prometheus, donc il est bien adapté pour le stockage et l'analyse des journaux Kubernetes.
Architecture de Loki
Loki peut être exécuté soit en mode processus unique, soit en plusieurs processus, ce qui permet un étagement horizontal.
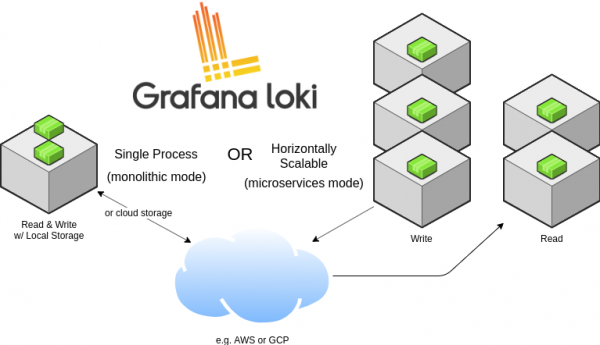
Il peut également fonctionner à la fois comme une application monolithique et comme un microservice. L'exécution en tant que processus unique peut être utile pour le développement local ou pour un petit monitoring. Pour une mise en production industrielle et une charge scalable, il est recommandé d'utiliser l'option microservice. Les chemins d'écriture et de lecture des données sont séparés, ce qui permet une configuration et une échelle suffisantes selon les besoins.
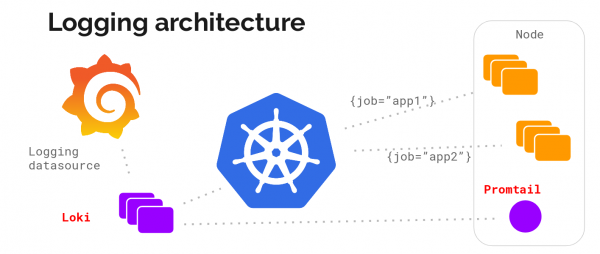
Jetons un œil à l'architecture du système de collecte des journaux sans entrer dans les détails :
Et voici — une description (architecture microservices) :
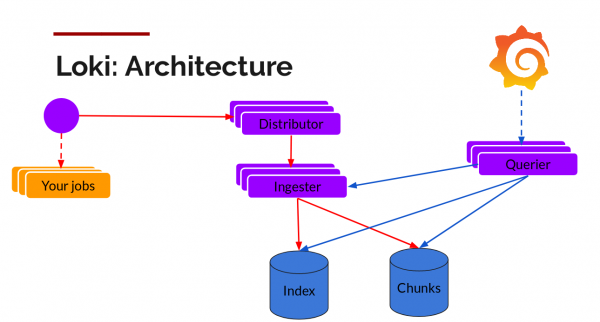
Composants :
Promtail — un agent installé sur des nœuds (sous forme d'un ensemble de services), il extrait les journaux des tâches et interroge l'API Kubernetes pour obtenir des métadonnées que les journaux seront étiquetés. Ensuite, il envoie le journal au service principal Loki. Pour le mappage des métadonnées, les mêmes règles de marquage que dans Prometheus sont prises en charge.
Distributeur — un service de distribution qui fonctionne comme un tampon. Pour traiter des millions d'enregistrements, il emballe les données entrantes en les compressant par blocs au fur et à mesure de leur arrivée. Plusieurs récepteurs de données fonctionnent simultanément, mais les journaux appartenant à un flux de données entrant doivent se trouver uniquement dans l'un d'eux pour tous ses blocs. Cela est organisé sous la forme d'un anneau de récepteurs et de hachage séquentiel. Pour assurer la tolérance aux pannes et la redondance, cela se fait n fois (3, si non configuré).
Ingester — un service récepteur. Les blocs de données arrivent compressés avec des journaux ajoutés. Une fois qu'un bloc est de taille suffisante, il est vidé dans la base de données. Les métadonnées vont dans l'index, et les données du bloc avec le journal vont dans les Chunks (c'est généralement un stockage d'objets). Après la vidange, le récepteur crée un nouveau bloc dans lequel de nouveaux enregistrements seront ajoutés.
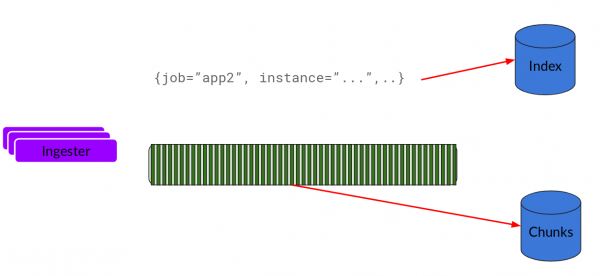
Index — base de données, DynamoDB, Cassandra, Google BigTable, etc.
Chunks — blocs de journaux sous forme compressée, généralement stockés dans un stockage d'objets, comme S3.
Querier — le chemin de lecture qui fait tout le travail noir. Il examine la plage de temps et les étiquettes, puis consulte l'index pour rechercher des correspondances. Ensuite, il lit les blocs de données et les filtre pour obtenir le résultat.
Et maintenant, voyons tout en action.
Installation
Pour l'installation dans Kubernetes, il est plus facile d'utiliser helm. Nous supposons que vous l'avez déjà installé et configuré ( note du traducteur)
Ajoutez le référentiel et installez la pile.
$ helm repo add loki https://grafana.github.io/loki/charts
$ helm repo update
$ helm upgrade --install loki loki/loki-stack --set grafana.enabled=true,prometheus.enabled=true,prometheus.alertmanager.persistentVolume.enabled=false,prometheus.server.persistentVolume.enabled=false
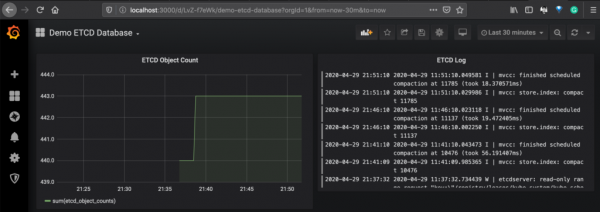
Voici un exemple de tableau de bord montrant des données de Prometheus pour les métriques Etcd et Loki pour les journaux des pods Etcd.
Et maintenant, discutons de l'architecture des deux systèmes et comparons leurs capacités.
Comparaison
Langage de requêtes
Elasticsearch utilise Query DSL et le langage de requête Lucene, qui offrent des capacités de recherche en texte intégral. C'est un moteur de recherche robuste et établi, avec un large soutien pour les opérateurs. Avec lui, vous pouvez rechercher par contexte et trier par pertinence.
De l'autre côté du ring se trouve LogQL, utilisé dans Loki, l'héritier de PromQL (le langage de requête de Prometheus). Il utilise des étiquettes de journaux pour filtrer et extraire les données des journaux. Il est possible d'utiliser certains opérateurs et de l'arithmétique, comme décrit , mais en termes de capacités, il est en retard par rapport au langage Elastic.
Étant donné que les requêtes dans Loki sont liées aux étiquettes, elles peuvent facilement être mises en corrélation avec des métriques, ce qui facilite l'organisation de la surveillance opérationnelle.
Scalabilité
Les deux piles sont évolutives horizontalement, mais avec Loki, cela est plus simple, car il a des chemins de lecture et d'écriture de données séparés, ainsi qu'une architecture microservices. Loki peut être configuré en fonction de vos besoins et peut être utilisé pour des volumes très importants de données de journaux.
Multi-location
La multi-location du cluster est un thème commun pour réduire l'OPEX, les deux piles assurent la multi-location. Pour Elasticsearch, il existe plusieurs de séparation des clients : un index séparé pour chaque client, routage basé sur le client, champs uniques pour chaque client, filtres de recherche. Dans Loki, cela se fait sous la forme de l'en-tête HTTP X-Scope-OrgID.
Coût
Loki est très économiquement efficace car il n'indexe pas les données, seulement les métadonnées. Cela permet d'atteindre et de mémoire (cache), puisque le stockage d'objets est moins cher que le stockage par blocs utilisé dans les clusters Elasticsearch.
Conclusion
La pile EFK peut être utilisée à diverses fins, offrant une flexibilité maximale et une interface multifonctionnelle Kibana pour l'analytique, la visualisation et les requêtes. Elle peut également être améliorée par des capacités d'apprentissage automatique.
La pile Loki est utile dans l'écosystème Kubernetes grâce à son mécanisme de découverte des métadonnées. Il est facile de faire correspondre les données pour la surveillance basées sur des séries temporelles dans Grafana et les journaux.
En ce qui concerne le coût et la conservation à long terme des journaux, Loki est un excellent choix pour entrer dans des solutions cloud.
Il existe de nombreuses alternatives sur le marché — certaines peuvent mieux vous convenir. Par exemple, GKE dispose d'une intégration Stackdriver qui offre une excellente solution de surveillance. Nous ne les avons pas incluses dans notre analyse dans cet article.
Liens :
L'article a été traduit et préparé pour Habr par ses employés — des intensifs, des formations vidéo et de l'apprentissage en entreprise dispensés par des professionnels en exercice (Kubernetes, DevOps, Docker, Ansible, Ceph, SRE, Agile)
Source : habr.com
