

Chers lecteurs, bonjour. Aujourd'hui, nous allons parler un peu d'Apache Spark et de ses perspectives de développement.
Dans le monde moderne du Big Data, Apache Spark est de facto le standard pour le développement de tâches de traitement par lot. De plus, il est également utilisé pour créer des applications de streaming fonctionnant selon le concept de micro-batch, traitant et livrant des données par petites portions (Spark Structured Streaming). Traditionnellement, il faisait partie de la pile Hadoop générale, utilisant comme gestionnaire de ressources YARN (ou, dans certains cas, Apache Mesos). D'ici 2020, son utilisation en tant que telle pour la plupart des entreprises est en grand question en raison du manque de distributions Hadoop viables — le développement de HDP et CDH est arrêté, CDH est insuffisamment développé et coûteux, et d'autres fournisseurs Hadoop ont soit cessé d'exister, soit ont un avenir incertain. Par conséquent, un intérêt croissant de la part de la communauté et des grandes entreprises se concentre sur le lancement d'Apache Spark via Kubernetes — devenu le standard pour l'orchestration de conteneurs et la gestion des ressources dans des environnements cloud privés et publics, il résout le problème de la planification difficile des ressources des tâches Spark sur YARN et offre une plateforme en développement stable avec de nombreuses distributions commerciales et open source pour des entreprises de toutes tailles. De plus, sur la vague de sa popularité, la plupart des acteurs ont déjà acquis quelques installations et développé de l'expertise dans son utilisation, ce qui facilite la migration.
Depuis la version 2.3.0, Apache Spark dispose d'un support officiel pour l'exécution des tâches dans un cluster Kubernetes. Aujourd'hui, nous allons parler de la maturité actuelle de cette approche, des différentes options d'utilisation et des écueils à éviter lors de son implémentation.
Tout d'abord, examinons le processus de développement des tâches et des applications basées sur Apache Spark et identifions les cas types dans lesquels il est nécessaire de lancer une tâche sur un cluster Kubernetes. Pour la préparation de ce post, la distribution utilisée est OpenShift et les commandes fournies seront pertinentes pour son outil en ligne de commande (oc). Pour d'autres distributions Kubernetes, les commandes correspondantes de l'outil en ligne de commande standard Kubernetes (kubectl) ou leurs équivalents (par exemple, pour oc adm policy) peuvent être utilisées.
La première option d'utilisation est spark-submit
Dans le processus de développement de tâches et d'applications, le développeur doit exécuter des tâches pour déboguer la transformation des données. Théoriquement, des simulations peuvent être utilisées à cette fin, mais le développement impliquant des instances réelles (même si elles sont de test) des systèmes finaux s'est révélé plus rapide et de meilleure qualité dans ce type de tâches. Dans le cas où nous procédons au débogage sur des instances réelles des systèmes finaux, deux scénarios de fonctionnement sont possibles :
- le développeur exécute la tâche Spark localement en mode standalone ;

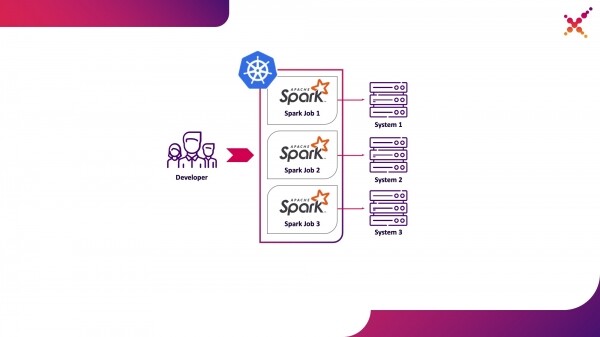
- le développeur exécute la tâche Spark sur un cluster Kubernetes dans un environnement de test.
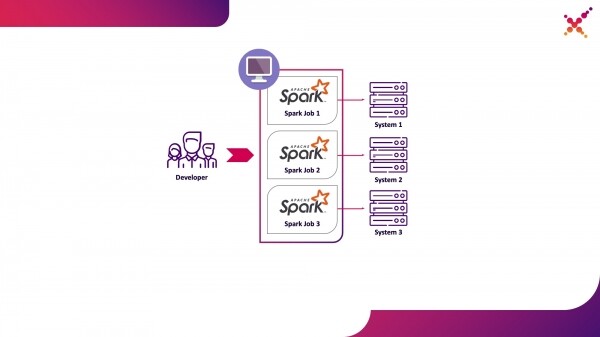
La première option a le droit d'exister, mais entraîne une série d'inconvénients :
- chaque développeur doit garantir l'accès depuis son poste de travail à toutes les instances nécessaires des systèmes finaux ;
- la machine de travail doit disposer d'un nombre suffisant de ressources pour exécuter la tâche en développement.
La deuxième option est dépourvue de ces inconvénients, car l'utilisation du cluster Kubernetes permet de réserver le pool de ressources nécessaire pour exécuter les tâches et d'assurer les accès nécessaires aux instances des systèmes finaux, en fournissant un accès flexible via le modèle de rôle Kubernetes pour tous les membres de l'équipe de développement. Nous la mettons en avant en tant que première option d'utilisation : exécution des tâches Spark depuis la machine locale du développeur sur un cluster Kubernetes dans un environnement de test.
Nous parlerons en détail du processus de configuration de Spark pour une exécution locale. Pour commencer à utiliser Spark, il doit être installé :
mkdir /opt/spark
cd /opt/spark
wget http://mirror.linux-ia64.org/apache/spark/spark-2.4.5/spark-2.4.5.tgz
tar zxvf spark-2.4.5.tgz
rm -f spark-2.4.5.tgz
Nous rassemblons les packages nécessaires pour travailler avec Kubernetes :
cd spark-2.4.5/
./build/mvn -Pkubernetes -DskipTests clean package
La construction complète prend beaucoup de temps, et pour créer des images Docker et les exécuter sur un cluster Kubernetes, seuls les fichiers jar du répertoire « assembly/ » sont réellement nécessaires, nous pouvons donc construire uniquement ce sous-projet :
./build/mvn -f ./assembly/pom.xml -Pkubernetes -DskipTests clean package
Pour exécuter des tâches Spark dans Kubernetes, il est nécessaire de créer une image Docker qui sera utilisée comme base. Deux approches sont possibles ici :
- L'image Docker créée contient le code exécutable de la tâche Spark ;
- L'image créée ne contient que Spark et ses dépendances nécessaires, le code exécutable étant stocké à distance (par exemple, dans HDFS).
Pour commencer, construisons une image Docker contenant un exemple de tâche Spark. Pour créer des images Docker, Spark dispose d'un outil correspondant appelé « docker-image-tool ». Examinons son aide :
./bin/docker-image-tool.sh --help
Avec cet outil, il est possible de créer des images Docker et de les charger dans des registres distants, mais par défaut, il présente certains inconvénients :
- il crée systématiquement 3 images Docker — pour Spark, PySpark et R ;
- il ne permet pas de spécifier le nom de l'image.
Nous allons donc utiliser une version modifiée de cet outil, présentée ci-dessous :
vi bin/docker-image-tool-upd.sh
#!/usr/bin/env bash

function error {
  echo "$@" 1>&2
  exit 1
}

if [ -z "${SPARK_HOME}" ]; then
  SPARK_HOME="$(cd "`dirname "$0"`"/..; pwd)"
fi
. "${SPARK_HOME}/bin/load-spark-env.sh"

function image_ref {
  local image="$1"
  local add_repo="${2:-1}"
  if [ $add_repo = 1 ] && [ -n "$REPO" ]; then
    image="$REPO/$image"
  fi
  if [ -n "$TAG" ]; then
    image="$image:$TAG"
  fi
  echo "$image"
}

function build {
  local BUILD_ARGS
  local IMG_PATH

  if [ ! -f "$SPARK_HOME/RELEASE" ]; then
    IMG_PATH=$BASEDOCKERFILE
    BUILD_ARGS=(
      ${BUILD_PARAMS}
      --build-arg
      img_path=$IMG_PATH
      --build-arg
      datagram_jars=datagram/runtimelibs
      --build-arg
      spark_jars=assembly/target/scala-$SPARK_SCALA_VERSION/jars
    )
  else
    IMG_PATH="kubernetes/dockerfiles"
    BUILD_ARGS=(${BUILD_PARAMS})
  fi

  if [ -z "$IMG_PATH" ]; then
    error "Cannot find docker image. This script must be run from a runnable distribution of Apache Spark."
  fi

  if [ -z "$IMAGE_REF" ]; then
    error "Cannot find docker image reference. Please add -i arg."
  fi

  local BINDING_BUILD_ARGS=(
    ${BUILD_PARAMS}
    --build-arg
    base_img=$(image_ref $IMAGE_REF)
  )
  local BASEDOCKERFILE=${BASEDOCKERFILE:-"$IMG_PATH/spark/docker/Dockerfile"}

  docker build $NOCACHEARG "${BUILD_ARGS[@]}"
    -t $(image_ref $IMAGE_REF)
    -f "$BASEDOCKERFILE" .
}

function push {
  docker push "$(image_ref $IMAGE_REF)"
}

function usage {
  cat <<EOF
Usage: $0 [options] [command]
Builds or pushes the built-in Spark Docker image.

Commands:
  build       Build image. Requires a repository address to be provided if the image will be
              pushed to a different registry.
  push        Push a pre-built image to a registry. Requires a repository address to be provided.

Options:
  -f file               Dockerfile to build for JVM based Jobs. By default builds the Dockerfile shipped with Spark.
  -p file               Dockerfile to build for PySpark Jobs. Builds Python dependencies and ships with Spark.
  -R file               Dockerfile to build for SparkR Jobs. Builds R dependencies and ships with Spark.
  -r repo               Repository address.
  -i name               Image name to apply to the built image, or to identify the image to be pushed.
  -t tag                Tag to apply to the built image, or to identify the image to be pushed.
  -m                    Use minikube's Docker daemon.
  -n                    Build docker image with --no-cache
  -b arg      Build arg to build or push the image. For multiple build args, this option needs to
              be used separately for each build arg.

Using minikube when building images will do so directly into minikube's Docker daemon.
There is no need to push the images into minikube in that case, they'll be automatically
available when running applications inside the minikube cluster.

Check the following documentation for more information on using the minikube Docker daemon:

  https://kubernetes.io/docs/getting-started-guides/minikube/#reusing-the-docker-daemon

Examples:
  - Build image in minikube with tag "testing"
    $0 -m -t testing build

  - Build and push image with tag "v2.3.0" to docker.io/myrepo
    $0 -r docker.io/myrepo -t v2.3.0 build
    $0 -r docker.io/myrepo -t v2.3.0 push
EOF
}

if [[ "$@" = *--help ]] || [[ "$@" = *-h ]]; then
  usage
  exit 0
fi

REPO=
TAG=
BASEDOCKERFILE=
NOCACHEARG=
BUILD_PARAMS=
IMAGE_REF=
while getopts f:mr:t:nb:i: option
do
 case "${option}"
 in
 f) BASEDOCKERFILE=${OPTARG};;
 r) REPO=${OPTARG};;
 t) TAG=${OPTARG};;
 n) NOCACHEARG="--no-cache";;
 i) IMAGE_REF=${OPTARG};;
 b) BUILD_PARAMS=${BUILD_PARAMS}" --build-arg "${OPTARG};;
 esac
done

case "${@: -1}" in
  build)
    build
    ;;
  push)
    if [ -z "$REPO" ]; then
      usage
      exit 1
    fi
    push
    ;;
  *)
    usage
    exit 1
    ;;
esac
Avec cela, nous allons assembler l'image de base de Spark, contenant une tâche de test pour calculer le nombre Pi à l'aide de Spark (ici {docker-registry-url} — l'URL de votre registre d'images Docker, {repo} — le nom du dépôt au sein du registre, correspondant au projet dans OpenShift, {image-name} — le nom de l'image (si une séparation en trois niveaux est utilisée, par exemple, comme dans le registre d'images intégré de Red Hat OpenShift), {tag} — le tag de cette version de l'image) :
./bin/docker-image-tool-upd.sh -f resource-managers/kubernetes/docker/src/main/dockerfiles/spark/Dockerfile -r {docker-registry-url}/{repo} -i {image-name} -t {tag} build
Nous nous authentifions dans le cluster OKD à l'aide de l'outil en ligne de commande (ici {OKD-API-URL} — l'URL de l'API du cluster OKD) :
oc login {OKD-API-URL}
Obtenons le jeton de l'utilisateur courant pour l'authentification dans Docker Registry :
oc whoami -t
Nous nous authentifions dans le Docker Registry interne du cluster OKD (en utilisant le mot de passe généré par la commande précédente) :
docker login {docker-registry-url}
Téléchargons l'image Docker assemblée dans le Docker Registry OKD :
./bin/docker-image-tool-upd.sh -r {docker-registry-url}/{repo} -i {image-name} -t {tag} push
Vérifions que l'image assemblée est disponible dans OKD. Pour cela, ouvrons dans le navigateur l'URL contenant la liste des images du projet correspondant (ici {project} — le nom du projet dans le cluster OpenShift, {OKD-WEBUI-URL} — l'URL de la console Web OpenShift) — https://{OKD-WEBUI-URL}/console/project/{project}/browse/images/{image-name}.
Pour exécuter des tâches, un compte de service avec des privilèges de lancement de pods sous root doit être créé (nous discuterons de ce point ultérieurement) :
oc create sa spark -n {project}
oc adm policy add-scc-to-user anyuid -z spark -n {project}
Exécutons la commande spark-submit pour soumettre la tâche Spark dans le cluster OKD, en spécifiant le compte de service créé et l'image Docker :
/opt/spark/bin/spark-submit --name spark-test --class org.apache.spark.examples.SparkPi --conf spark.executor.instances=3 --conf spark.kubernetes.authenticate.driver.serviceAccountName=spark --conf spark.kubernetes.namespace={project} --conf spark.submit.deployMode=cluster --conf spark.kubernetes.container.image={docker-registry-url}/{repo}/{image-name}:{tag} --conf spark.master=k8s://https://{OKD-API-URL} local:///opt/spark/examples/target/scala-2.11/jars/spark-examples_2.11-2.4.5.jar
Ici :
--name — le nom de la tâche, qui participera à la formation des noms des pods Kubernetes ;
—class — classe du fichier exécutable appelé lors du lancement de la tâche ;
—conf — paramètres de configuration de Spark ;
spark.executor.instances — nombre d'instances de Spark à exécuter ;
spark.kubernetes.authenticate.driver.serviceAccountName — nom du compte de service Kubernetes utilisé lors du lancement des pods (pour définir le contexte de sécurité et les autorisations lors de l'interaction avec l'API Kubernetes) ;
spark.kubernetes.namespace — espace de noms Kubernetes dans lequel les pods du driver et des exécutants seront lancés ;
spark.submit.deployMode — mode de déploiement de Spark (pour le spark-submit standard, 'cluster' est utilisé, pour Spark Operator et les versions plus récentes de Spark, c'est 'client') ;
spark.kubernetes.container.image — image Docker utilisée pour le lancement des pods ;
spark.master — URL de l'API Kubernetes (indiquée pour que l'accès se fasse depuis la machine locale) ;
local:// — chemin vers le fichier exécutable Spark à l'intérieur de l'image Docker.
Accédez au projet OKD correspondant et examinez les pods créés — https://{OKD-WEBUI-URL}/console/project/{project}/browse/pods.
Pour simplifier le processus de développement, une autre option peut être utilisée, où une image de base commune de Spark est créée, utilisée par toutes les tâches pour l'exécution, et les instantanés des fichiers exécutables sont publiés dans un stockage externe (comme Hadoop) et spécifiés lors de l'appel de spark-submit sous forme de lien. Dans ce cas, différentes versions des tâches Spark peuvent être exécutées sans reconstruction d'images Docker, en utilisant par exemple WebHDFS pour la publication des images. Envoyez une demande de création de fichier (ici {host} — hôte du service WebHDFS, {port} — port du service WebHDFS, {path-to-file-on-hdfs} — chemin souhaité vers le fichier sur HDFS) :
curl -i -X PUT "http://{host}:{port}/webhdfs/v1/{path-to-file-on-hdfs}?op=CREATE
Vous recevrez alors une réponse de ce type (ici {location} — l'URL à utiliser pour télécharger le fichier) :
HTTP/1.1 307 TEMPORARY_REDIRECT
Location: {location}
Content-Length: 0
Téléchargez le fichier exécutable Spark sur HDFS (ici {path-to-local-file} — chemin vers le fichier exécutable Spark sur l'hôte actuel) :
curl -i -X PUT -T {path-to-local-file} "{location}"
Après cela, nous pouvons faire un spark-submit en utilisant le fichier Spark téléchargé sur HDFS (ici {class-name} — nom de la classe à exécuter pour la tâche) :
/opt/spark/bin/spark-submit --name spark-test --class {class-name} --conf spark.executor.instances=3 --conf spark.kubernetes.authenticate.driver.serviceAccountName=spark --conf spark.kubernetes.namespace={project} --conf spark.submit.deployMode=cluster --conf spark.kubernetes.container.image={docker-registry-url}/{repo}/{image-name}:{tag} --conf spark.master=k8s://https://{OKD-API-URL} hdfs://{host}:{port}/{path-to-file-on-hdfs}
À noter qu'un accès à HDFS et un fonctionnement de la tâche peuvent nécessiter des modifications du Dockerfile et du script entrypoint.sh — ajout d'une directive dans le Dockerfile pour copier les bibliothèques dépendantes dans le répertoire /opt/spark/jars et inclure le fichier de configuration HDFS dans SPARK_CLASSPATH dans entrypoint.sh.
Deuxième cas d'utilisation — Apache Livy
Ensuite, lorsque la tâche est développée et qu'il est nécessaire de tester le résultat, la question de son exécution dans le cadre du processus CI/CD et du suivi de son statut se pose. Bien sûr, il est possible de l’exécuter en utilisant un appel local spark-submit, mais cela complique l'infrastructure CI/CD car cela nécessite l'installation et la configuration de Spark sur les agents/exécuteurs du serveur CI et la configuration d'accès à l'API Kubernetes. Pour ce cas, la réalisation ciblée choisie est l'utilisation d'Apache Livy comme API REST pour lancer des tâches Spark, hébergées à l'intérieur du cluster Kubernetes. Avec lui, il est possible de lancer des tâches Spark sur le cluster Kubernetes en utilisant des requêtes cURL classiques, ce qui est facilement réalisable avec n'importe quelle solution CI, et son hébergement à l'intérieur du cluster Kubernetes résout le problème d'authentification lors de l'interaction avec l'API Kubernetes.
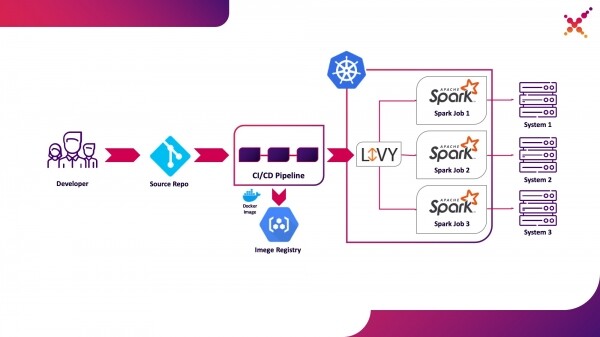
Soulignons-le comme un deuxième cas d'utilisation — exécution de tâches Spark dans le cadre du processus CI/CD sur le cluster Kubernetes dans un environnement de test.
Un peu sur Apache Livy — il fonctionne comme un serveur HTTP, fournissant une interface Web et une API RESTful, permettant de lancer spark-submit à distance en passant les paramètres nécessaires. Traditionnellement, il était inclus dans la distribution HDP, mais peut également être déployé sur OKD ou toute autre installation Kubernetes à l'aide de son manifeste et d'un ensemble d'images Docker appropriées, par exemple — . Pour notre cas, une image Docker similaire a été construite, incluant Spark version 2.4.5 à partir du Dockerfile suivant :
FROM java:8-alpine

ENV SPARK_HOME=/opt/spark
ENV LIVY_HOME=/opt/livy
ENV HADOOP_CONF_DIR=/etc/hadoop/conf
ENV SPARK_USER=spark

WORKDIR /opt

RUN apk add --update openssl wget bash &&
    wget -P /opt https://downloads.apache.org/spark/spark-2.4.5/spark-2.4.5-bin-hadoop2.7.tgz &&
    tar xvzf spark-2.4.5-bin-hadoop2.7.tgz &&
    rm spark-2.4.5-bin-hadoop2.7.tgz &&
    ln -s /opt/spark-2.4.5-bin-hadoop2.7 /opt/spark

RUN wget http://mirror.its.dal.ca/apache/incubator/livy/0.7.0-incubating/apache-livy-0.7.0-incubating-bin.zip &&
    unzip apache-livy-0.7.0-incubating-bin.zip &&
    rm apache-livy-0.7.0-incubating-bin.zip &&
    ln -s /opt/apache-livy-0.7.0-incubating-bin /opt/livy &&
    mkdir /var/log/livy &&
    ln -s /var/log/livy /opt/livy/logs &&
    cp /opt/livy/conf/log4j.properties.template /opt/livy/conf/log4j.properties

ADD livy.conf /opt/livy/conf
ADD spark-defaults.conf /opt/spark/conf/spark-defaults.conf
ADD entrypoint.sh /entrypoint.sh

ENV PATH="/opt/livy/bin:${PATH}"

EXPOSE 8998

ENTRYPOINT ["/entrypoint.sh"]
CMD ["livy-server"]
L'image créée peut être construite et téléchargée dans votre dépôt Docker existant, par exemple, le dépôt interne OKD. Le déploiement se fait à l'aide du manifeste suivant ({registry-url} — URL du registre d'images Docker, {image-name} — nom de l'image Docker, {tag} — tag de l'image Docker, {livy-url} — URL souhaitée à laquelle le serveur Livy sera accessible ; le manifeste "Route" est appliqué si Red Hat OpenShift est utilisé comme distribution Kubernetes, sinon un manifeste Ingress ou un Service de type NodePort correspondant est utilisé :
---
apiVersion: apps/v1
kind: Deployment
metadata:
  labels:
    component: livy
  name: livy
spec:
  progressDeadlineSeconds: 600
  replicas: 1
  revisionHistoryLimit: 10
  selector:
    matchLabels:
      component: livy
  strategy:
    rollingUpdate:
      maxSurge: 25%
      maxUnavailable: 25%
    type: RollingUpdate
  template:
    metadata:
      creationTimestamp: null
      labels:
        component: livy
    spec:
      containers:
        - command:
            - livy-server
          env:
            - name: K8S_API_HOST
              value: localhost
            - name: SPARK_KUBERNETES_IMAGE
              value: 'gnut3ll4/spark:v1.0.14'
          image: '{registry-url}/{image-name}:{tag}'
          imagePullPolicy: Always
          name: livy
          ports:
            - containerPort: 8998
              name: livy-rest
              protocol: TCP
          resources: {}
          terminationMessagePath: /dev/termination-log
          terminationMessagePolicy: File
          volumeMounts:
            - mountPath: /var/log/livy
              name: livy-log
            - mountPath: /opt/.livy-sessions/
              name: livy-sessions
            - mountPath: /opt/livy/conf/livy.conf
              name: livy-config
              subPath: livy.conf
            - mountPath: /opt/spark/conf/spark-defaults.conf
              name: spark-config
              subPath: spark-defaults.conf
        - command:
            - /usr/local/bin/kubectl
            - proxy
            - '--port'
            - '8443'
          image: 'gnut3ll4/kubectl-sidecar:latest'
          imagePullPolicy: Always
          name: kubectl
          ports:
            - containerPort: 8443
              name: k8s-api
              protocol: TCP
          resources: {}
          terminationMessagePath: /dev/termination-log
          terminationMessagePolicy: File
      dnsPolicy: ClusterFirst
      restartPolicy: Always
      schedulerName: default-scheduler
      securityContext: {}
      serviceAccount: spark
      serviceAccountName: spark
      terminationGracePeriodSeconds: 30
      volumes:
        - emptyDir: {}
          name: livy-log
        - emptyDir: {}
          name: livy-sessions
        - configMap:
            defaultMode: 420
            items:
              - key: livy.conf
                path: livy.conf
            name: livy-config
          name: livy-config
        - configMap:
            defaultMode: 420
            items:
              - key: spark-defaults.conf
                path: spark-defaults.conf
            name: livy-config
          name: spark-config
---
apiVersion: v1
kind: ConfigMap
metadata:
  name: livy-config
data:
  livy.conf: |-
    livy.spark.deploy-mode=cluster
    livy.file.local-dir-whitelist=/opt/.livy-sessions/
    livy.spark.master=k8s://http://localhost:8443
    livy.server.session.state-retain.sec = 8h
  spark-defaults.conf: 'spark.kubernetes.container.image        "gnut3ll4/spark:v1.0.14"'
---
apiVersion: v1
kind: Service
metadata:
  labels:
    app: livy
  name: livy
spec:
  ports:
    - name: livy-rest
      port: 8998
      protocol: TCP
      targetPort: 8998
  selector:
    component: livy
  sessionAffinity: None
  type: ClusterIP
---
apiVersion: route.openshift.io/v1
kind: Route
metadata:
  labels:
    app: livy
  name: livy
spec:
  host: {livy-url}
  port:
    targetPort: livy-rest
  to:
    kind: Service
    name: livy
    weight: 100
  wildcardPolicy: None
Après son utilisation et le lancement réussi du pod, l'interface graphique de Livy est accessible via le lien : http://{livy-url}/ui. Avec Livy, nous pouvons publier notre tâche Spark en utilisant une requête REST, par exemple depuis Postman. Un exemple de collection avec des requêtes est présenté ci-dessous (dans le tableau « args », des arguments de configuration avec des variables nécessaires à l'exécution de la tâche peuvent être transmis) :
{
    "info": {
        "_postman_id": "be135198-d2ff-47b6-a33e-0d27b9dba4c8",
        "name": "Spark Livy",
        "schema": "https://schema.getpostman.com/json/collection/v2.1.0/collection.json"
    },
    "item": [
        {
            "name": "1 Soumettre un travail avec jar",
            "request": {
                "method": "POST",
                "header": [
                    {
                        "key": "Content-Type",
                        "value": "application/json"
                    }
                ],
                "body": {
                    "mode": "raw",
                    "raw": "{nt\"file\": \"local://opt/spark/examples/target/scala-2.11/jars/spark-examples_2.11-2.4.5.jar\", nt\"className\": \"org.apache.spark.examples.SparkPi\",nt\"numExecutors\":1,nt\"name\": \"spark-test-1\",nt\"conf\": {ntt\"spark.jars.ivy\": \"/tmp/.ivy\",ntt\"spark.kubernetes.authenticate.driver.serviceAccountName\": \"spark\",ntt\"spark.kubernetes.namespace\": \"{project}\",ntt\"spark.kubernetes.container.image\": \"{docker-registry-url}/{repo}/{image-name}:{tag}\"nt}n}"
                },
                "url": {
                    "raw": "http://{livy-url}/batches",
                    "protocol": "http",
                    "host": [
                        "{livy-url}"
                    ],
                    "path": [
                        "batches"
                    ]
                }
            },
            "response": []
        },
        {
            "name": "2 Soumettre un travail sans jar",
            "request": {
                "method": "POST",
                "header": [
                    {
                        "key": "Content-Type",
                        "value": "application/json"
                    }
                ],
                "body": {
                    "mode": "raw",
                    "raw": "{nt\"file\": \"hdfs://{host}:{port}/{path-to-file-on-hdfs}\", nt\"className\": \"{class-name}\",nt\"numExecutors\":1,nt\"name\": \"spark-test-2\",nt\"proxyUser\": \"0\",nt\"conf\": {ntt\"spark.jars.ivy\": \"/tmp/.ivy\",ntt\"spark.kubernetes.authenticate.driver.serviceAccountName\": \"spark\",ntt\"spark.kubernetes.namespace\": \"{project}\",ntt\"spark.kubernetes.container.image\": \"{docker-registry-url}/{repo}/{image-name}:{tag}\"nt},nt\"args\": [ntt\"HADOOP_CONF_DIR=/opt/spark/hadoop-conf\",ntt\"MASTER=k8s://https://kubernetes.default.svc:8443"nt]n}"
                },
                "url": {
                    "raw": "http://{livy-url}/batches",
                    "protocol": "http",
                    "host": [
                        "{livy-url}"
                    ],
                    "path": [
                        "batches"
                    ]
                }
            },
            "response": []
        }
    ],
    "event": [
        {
            "listen": "prerequest",
            "script": {
                "id": "41bea1d0-278c-40c9-ad42-bf2e6268897d",
                "type": "text/javascript",
                "exec": [
                    ""
                ]
            }
        },
        {
            "listen": "test",
            "script": {
                "id": "3cdd7736-a885-4a2d-9668-bd75798f4560",
                "type": "text/javascript",
                "exec": [
                    ""
                ]
            }
        }
    ],
    "protocolProfileBehavior": {}
}
Exécutons la première requête de la collection, allons dans l'interface OKD et vérifions que la tâche a été lancée avec succès — https://{OKD-WEBUI-URL}/console/project/{project}/browse/pods. Pendant ce temps, une session apparaîtra dans l'interface Livy (http://{livy-url}/ui), où il est possible de suivre l'avancement de la tâche et d'examiner les journaux de session à l'aide de l'API Livy ou de l'interface graphique.
Nous allons maintenant examiner le fonctionnement de Livy. Pour cela, nous étudierons les journaux du conteneur Livy à l'intérieur du pod avec le serveur Livy — https://{OKD-WEBUI-URL}/console/project/{project}/browse/pods/{livy-pod-name}?tab=logs. Il en ressort que lors de l'appel de l'API REST Livy, le conteneur nommé « livy » exécute un spark-submit, similaire à celui que nous avons utilisé précédemment (ici, {livy-pod-name} est le nom du pod créé avec le serveur Livy). La collection présente également une deuxième requête, permettant de lancer des tâches avec un fichier exécutable Spark hébergé à distance à l'aide du serveur Livy.
La troisième option d'utilisation — Spark Operator
Maintenant que la tâche a été testée, la question se pose de son lancement régulier. La méthode native pour le lancement régulier de tâches dans un cluster Kubernetes est l'entité CronJob, et il est possible de l'utiliser, mais actuellement, l'utilisation d'opérateurs pour gérer les applications dans Kubernetes est beaucoup plus populaire, et pour Spark, il existe un opérateur suffisamment mature, qui, entre autres, est utilisé dans des solutions de niveau Entreprise (par exemple, Lightbend FastData Platform). Nous vous recommandons de l'utiliser — la version stable actuelle de Spark (2.4.5) a des capacités de configuration assez limitées pour le lancement de tâches Spark dans Kubernetes, alors que dans la prochaine version majeure (3.0.0), un support complet de Kubernetes est annoncé, mais la date de sortie reste inconnue. Spark Operator compense ce manque en ajoutant d'importants paramètres de configuration (par exemple, le montage de ConfigMap avec la configuration d'accès à Hadoop dans les pods Spark) et la possibilité de lancer des tâches de façon régulière selon un emploi du temps.
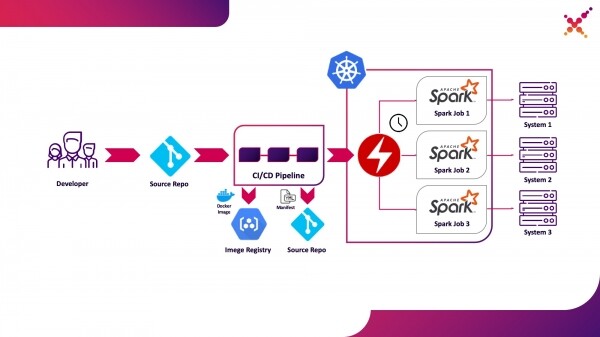
Nous le mettons en avant en tant que troisième option d'utilisation — le lancement régulier de tâches Spark sur un cluster Kubernetes dans un environnement de production.
Spark Operator est open-source et développé dans le cadre de Google Cloud Platform — . Son installation peut être réalisée de 3 manières :
- Dans le cadre de l'installation de Lightbend FastData Platform/Cloudflow ;
- À l'aide de Helm :
helm repo add incubator http://storage.googleapis.com/kubernetes-charts-incubator helm install incubator/sparkoperator --namespace spark-operator - L'utilisation des manifestes depuis le dépôt officiel (https://github.com/GoogleCloudPlatform/spark-on-k8s-operator/tree/master/manifest). À noter que Cloudflow inclut un opérateur avec la version API v1beta1. Si ce type d'installation est utilisé, la description des manifestes des applications Spark doit être basée sur des exemples provenant des balises dans Git avec la version API correspondante, par exemple, « v1beta1-0.9.0-2.4.0 ». La version de l'opérateur peut être consultée dans la description CRD qui fait partie de l'opérateur dans le dictionnaire « versions » :
oc get crd sparkapplications.sparkoperator.k8s.io -o yaml
Si l'opérateur est installé correctement, un pod actif avec l'opérateur Spark apparaîtra dans le projet correspondant (par exemple, cloudflow-fdp-sparkoperator dans l'espace Cloudflow pour l'installation de Cloudflow), ainsi qu'un type de ressource Kubernetes nommé « sparkapplications ». Pour examiner les applications Spark existantes, vous pouvez utiliser la commande suivante :
oc get sparkapplications -n {project}
Pour exécuter des tâches à l'aide de Spark Operator, trois choses sont nécessaires :
- créer une image Docker incluant toutes les bibliothèques nécessaires ainsi que les fichiers de configuration et exécutables. Dans l'image cible, il s'agit d'une image créée lors de l'étape CI/CD et testée sur un cluster de test ;
- publier l'image Docker dans un registre accessible depuis le cluster Kubernetes ;
- émettre un manifeste de type « SparkApplication » décrivant la tâche à exécuter. Des exemples de manifestes sont disponibles dans le dépôt officiel (par exemple, ). Il est important de noter quelques points concernant le manifeste :
- dans le dictionnaire « apiVersion », la version API correspondant à la version de l'opérateur doit être spécifiée ;
- dans le dictionnaire « metadata.namespace », l'espace de noms dans lequel l'application sera exécutée doit être spécifié ;
- dans le dictionnaire « spec.image », l'adresse de l'image Docker créée dans le registre accessible doit être spécifiée ;
- dans le dictionnaire « spec.mainClass », la classe de la tâche Spark qui doit être exécutée lors du lancement du processus doit être indiquée ;
- dans le dictionnaire « spec.mainApplicationFile », le chemin vers le fichier jar exécutable doit être indiqué ;
- dans le dictionnaire « spec.sparkVersion », la version de Spark utilisée doit être spécifiée ;
- dans le dictionnaire « spec.driver.serviceAccount », le compte de service dans l'espace de noms Kubernetes correspondant à utiliser pour exécuter l'application doit être spécifié ;
- dans le dictionnaire « spec.executor », le nombre de ressources allouées à l'application doit être précisé.
- Dans le dictionnaire «spec.volumeMounts», un répertoire local doit être spécifié, dans lequel les fichiers locaux de la tâche Spark seront créés.
Exemple de création d'un manifeste (ici {spark-service-account} est le compte de service au sein du cluster Kubernetes pour l'exécution des tâches Spark) :
apiVersion: "sparkoperator.k8s.io/v1beta1"
kind: SparkApplication
metadata:
  name: spark-pi
  namespace: {project}
spec:
  type: Scala
  mode: cluster
  image: "gcr.io/spark-operator/spark:v2.4.0"
  imagePullPolicy: Always
  mainClass: org.apache.spark.examples.SparkPi
  mainApplicationFile: "local:///opt/spark/examples/jars/spark-examples_2.11-2.4.0.jar"
  sparkVersion: "2.4.0"
  restartPolicy:
    type: Never
  volumes:
    - name: "test-volume"
      hostPath:
        path: "/tmp"
        type: Directory
  driver:
    cores: 0.1
    coreLimit: "200m"
    memory: "512m"
    labels:
      version: 2.4.0
    serviceAccount: {spark-service-account}
    volumeMounts:
      - name: "test-volume"
        mountPath: "/tmp"
  executor:
    cores: 1
    instances: 1
    memory: "512m"
    labels:
      version: 2.4.0
    volumeMounts:
      - name: "test-volume"
        mountPath: "/tmp"
Ce manifeste indique un compte de service pour lequel il est nécessaire de créer les liaisons de rôles requises avant de publier le manifeste, afin de fournir les droits d'accès nécessaires pour permettre à l'application Spark d'interagir avec l'API Kubernetes (si nécessaire). Dans notre cas, l'application a besoin des droits pour créer des pods. Créons la liaison de rôle requise :
oc adm policy add-role-to-user edit system:serviceaccount:{project}:{spark-service-account} -n {project}
Il convient également de noter que dans la spécification de ce manifeste, le paramètre «hadoopConfigMap» peut être spécifié, permettant de désigner un ConfigMap avec la configuration Hadoop sans avoir à préalablement insérer le fichier correspondant dans l'image Docker. Cela convient également pour le lancement régulier des tâches — le paramètre «schedule» peut être utilisé pour définir un calendrier de lancement de cette tâche.
Après cela, nous sauvegardons notre manifeste dans le fichier spark-pi.yaml et l'appliquons à notre cluster Kubernetes :
oc apply -f spark-pi.yaml
Un objet de type «sparkapplications» sera créé :
oc get sparkapplications -n {project}
> NAME       AGE
> spark-pi   22h
Un pod avec l'application sera créé, dont le statut sera affiché dans le «sparkapplications» créé. On peut le consulter avec la commande suivante :
oc get sparkapplications spark-pi -o yaml -n {project}
À la fin de la tâche, le POD passera au statut «Completed», qui sera également mis à jour dans le «sparkapplications». Les journaux de l'application peuvent être consultés dans le navigateur ou avec la commande suivante (ici {sparkapplications-pod-name} est le nom du pod de la tâche exécutée) :
oc logs {sparkapplications-pod-name} -n {project}
La gestion des tâches Spark peut également être réalisée à l'aide de l'outil spécialisé sparkctl. Pour l'installer, nous clonons le dépôt contenant son code source, installons Go et compilons cet utilitaire :
git clone https://github.com/GoogleCloudPlatform/spark-on-k8s-operator.git
cd spark-on-k8s-operator/
wget https://dl.google.com/go/go1.13.3.linux-amd64.tar.gz
tar -xzf go1.13.3.linux-amd64.tar.gz
sudo mv go /usr/local
mkdir $HOME/Projects
export GOROOT=/usr/local/go
export GOPATH=$HOME/Projects
export PATH=$GOPATH/bin:$GOROOT/bin:$PATH
go -version
cd sparkctl
go build -o sparkctl
sudo mv sparkctl /usr/local/bin
Examinons la liste des tâches Spark en cours :
sparkctl list -n {project}
Créons une description pour une tâche Spark :
vi spark-app.yaml
apiVersion: "sparkoperator.k8s.io/v1beta1"
kind: SparkApplication
metadata:
  name: spark-pi
  namespace: {project}
spec:
  type: Scala
  mode: cluster
  image: "gcr.io/spark-operator/spark:v2.4.0"
  imagePullPolicy: Always
  mainClass: org.apache.spark.examples.SparkPi
  mainApplicationFile: "local:///opt/spark/examples/jars/spark-examples_2.11-2.4.0.jar"
  sparkVersion: "2.4.0"
  restartPolicy:
    type: Never
  volumes:
    - name: "test-volume"
      hostPath:
        path: "/tmp"
        type: Directory
  driver:
    cores: 1
    coreLimit: "1000m"
    memory: "512m"
    labels:
      version: 2.4.0
    serviceAccount: spark
    volumeMounts:
      - name: "test-volume"
        mountPath: "/tmp"
  executor:
    cores: 1
    instances: 1
    memory: "512m"
    labels:
      version: 2.4.0
    volumeMounts:
      - name: "test-volume"
        mountPath: "/tmp"
Lançons la tâche décrite à l'aide de sparkctl :
sparkctl create spark-app.yaml -n {project}
Examinons la liste des tâches Spark en cours :
sparkctl list -n {project}
Examinons la liste des événements de la tâche Spark en cours :
sparkctl event spark-pi -n {project} -f
Examinons le statut de la tâche Spark en cours :
sparkctl status spark-pi -n {project}
En conclusion, examinons les inconvénients découverts lors de l'exploitation de la version stable actuelle de Spark (2.4.5) dans Kubernetes :
- Le premier et probablement le principal inconvénient est l'absence de localité des données. Malgré toutes les faiblesses de YARN, il y avait aussi des avantages à son utilisation, comme le principe de livraison de code aux données (et non l'inverse). Grâce à cela, les tâches Spark étaient exécutées sur les nœuds où se trouvaient les données impliquées dans les calculs, ce qui réduisait considérablement le temps de transfert des données sur le réseau. Avec Kubernetes, nous sommes confrontés à la nécessité de déplacer des données requises pour le traitement des tâches à travers le réseau. Si elles sont suffisamment volumineuses, le temps d'exécution peut augmenter considérablement et il peut également être nécessaire de disposer d'une quantité importante d'espace disque alloué aux instances de tâches Spark pour un stockage temporaire. Cet inconvénient peut être atténué grâce à l'utilisation d'outils logiciels spécialisés qui assurent la localité des données dans Kubernetes (comme Alluxio), mais cela implique en fait la nécessité de conserver une copie complète des données sur les nœuds du cluster Kubernetes.
- Le deuxième inconvénient important est la sécurité. Par défaut, les fonctionnalités liées à la sécurité lors de l'exécution des tâches Spark sont désactivées, l'utilisation de Kerberos dans la documentation officielle n'est pas abordée (bien que des paramètres pertinents soient apparus dans la version 3.0.0, ce qui nécessitera un travail supplémentaire), et dans la documentation sur la sécurité lors de l'utilisation de Spark (https://spark.apache.org/docs/2.4.5/security.html), seuls YARN, Mesos et le cluster autonome figurent parmi les magasins de clés. De plus, l'utilisateur sous lequel les tâches Spark sont exécutées ne peut pas être spécifié directement — nous ne définissons qu'un compte de service sous lequel le pod fonctionnera, et l'utilisateur est sélectionné en fonction des politiques de sécurité configurées. Par conséquent, soit nous utilisons l'utilisateur root, ce qui n'est pas sûr dans un environnement de production, soit un utilisateur avec un UID aléatoire, ce qui complique la répartition des droits d'accès aux données (résoluble en créant des PodSecurityPolicies et en les liant aux comptes de service appropriés). Actuellement, la solution passe soit par la mise en place de tous les fichiers nécessaires directement dans l'image Docker, soit par la modification du script de lancement de Spark pour utiliser le mécanisme de stockage et d'accès aux secrets adopté dans votre organisation.
- Le lancement des tâches Spark via Kubernetes est toujours en mode expérimental et des changements significatifs concernant les artefacts utilisés (fichiers de configuration, images de base Docker et scripts de lancement) sont possibles à l'avenir. En effet, lors de la préparation du matériel, les versions 2.3.0 et 2.4.5 ont été testées et leur comportement était sensiblement différent.
Nous attendons des mises à jour — une nouvelle version de Spark (3.0.0) a récemment été publiée, apportant des changements notables au fonctionnement de Spark sur Kubernetes, tout en conservant le statut expérimental du support de ce gestionnaire de ressources. Il est possible que les prochaines mises à jour permettent effectivement de recommander pleinement d'abandonner YARN et de lancer des tâches Spark sur Kubernetes, sans craindre pour la sécurité de votre système et sans nécessiter d'ajouts fonctionnels manuels.
Fin.
Source : habr.com
