

par St-Pete
Bonjour à tous ! Je suis Mons Anderson, architecte de la plateforme , je vais vous expliquer comment nous avons construit notre stockage S3, comment cela fonctionne, quelles solutions ont été réussies et lesquelles nous aurions dû changer si nous devions recommencer un projet similaire aujourd'hui.
Cet article est basé sur une présentation lors de par Mail.ru Cloud Solutions & Tarantool. Dans cet article, nous aborderons :
- comment était organisé le stockage de Mail.ru, sur lequel nous avons construit le stockage S3 ;
- ce que nous avons ajouté pour créer Mail.ru Cloud Storage ;
- comment fonctionne le modèle de stockage d'objets et quelles étapes ont été mises en place pour la mise en production ;
- les améliorations du système en production : basculement et mise à l'échelle ;
- comment nous avons mis en œuvre le sharding et le resharding ;
- ainsi que le travail avec les certificats SSL.
Si vous ne souhaitez pas lire, vous pouvez .
Comment était organisé le stockage de Mail.ru, sur lequel nous avons construit le stockage S3
Le développement de notre S3 a commencé sur la base du stockage Cloud de Mail.ru, donc il est d'abord important d'expliquer comment cela fonctionne et ce qu'il peut faire.
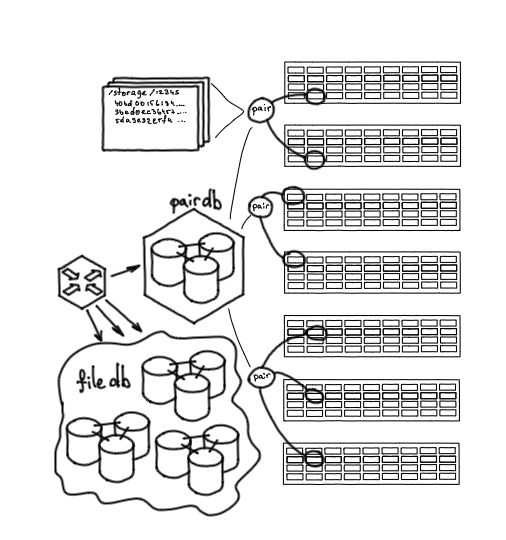
Le stockage Cloud de Mail.ru se compose de serveurs avec des disques. En moyenne, un serveur de stockage moderne compte 36 disques de 12 à 14 téraoctets. Autrefois, les disques étaient plus petits, mais au cours des trois dernières années, la capacité des disques a augmenté et aujourd'hui, il s'agit de près de 0,5 pétaoctet de données brutes.
Les disques de différents serveurs de stockage sont regroupés en ce que l'on appelle des « paires » (pair). Une paire est une unité de stockage de fichiers. En essence, c'est un disque monté dans une partition donnée à un chemin spécifique, où des fichiers identifiés par des hachages peuvent être placés.
Le terme paire est un nom historique, il est resté jusqu'à aujourd'hui, même si actuellement, une paire ne compte pas nécessairement seulement deux disques. Il peut y en avoir trois, et il peut également y avoir différents types de stockage hybride, par exemple 3/2.
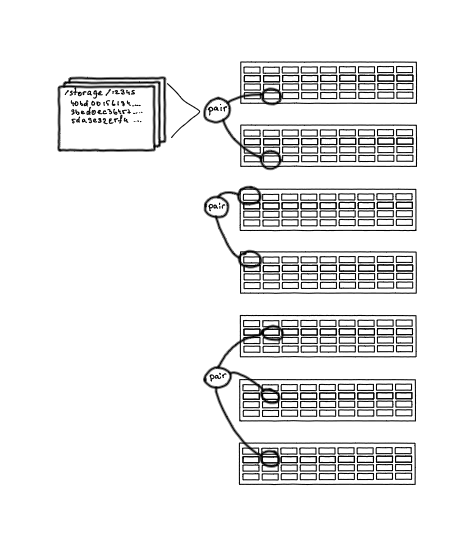
Paires (pair) — unités de stockage d'objets
Toutes les paires sont stockées dans PairDB — une application basée sur Tarantool. Toutes les bases dans notre stockage, dès les premières, sont sur Tarantool, nous n'utilisons pas d'autres bases.
PairDB stocke toutes les paires, leurs états, l'espace libre, les capacités de défaillance, les dernières erreurs. Elle peut également vérifier les paires, actualiser leur état, vérifier si elles fonctionnent ou non. Autrement dit, PairDB donne une vue d'ensemble de l'état de tous les disques de notre système.
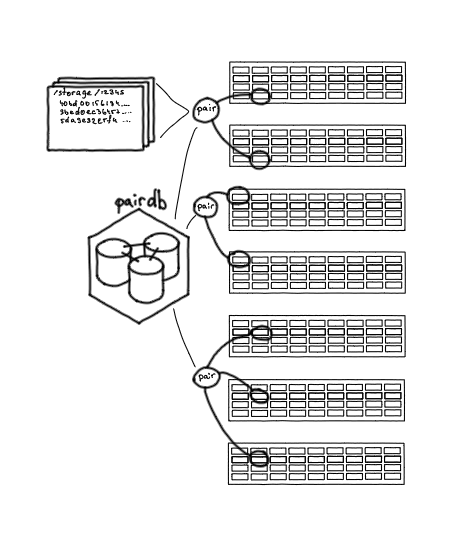
Pair DB : base de données contenant l'état des paires
Les fichiers sont stockés sur des paires, et pour savoir quel fichier se trouve sur quelle paire, une autre base est nécessaire : FileDB. Elle conserve le mappage, la définition de la correspondance : tel fichier est stocké sur telle paire, ainsi qu'un petit nombre d'attributs nécessaires.
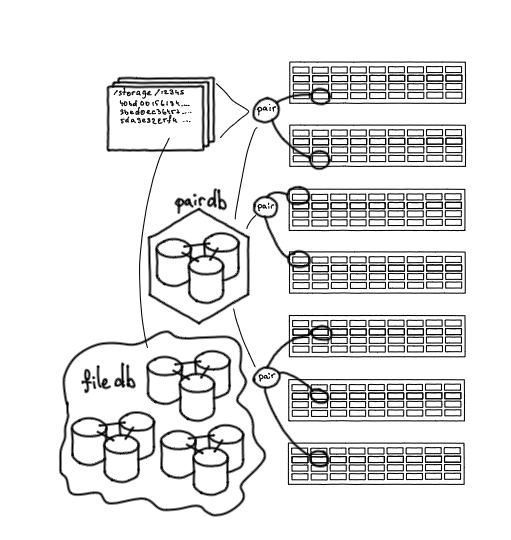 File DB : emplacement où le fichier est stocké
Un autre maillon important est le service Nylon, un routeur pour travailler avec des bases de données. Il constitue un point d'entrée unique, permettant de travailler à travers une interface unique à la fois avec PairDB et FileDB. C'est un service sans état, il effectue l'équilibrage des demandes, comprend sur quelle shard de FileDB se diriger, sait quelles paires sont actives et lesquelles ne le sont pas.
Nylon : routeur pour travailler avec des bases de données
Il est également nécessaire de faire entrer du contenu dans le stockage. Pour cela, il y a un service — Streamer. Il fournit deux méthodes HTTP : la méthode PUT pour charger du contenu dans le stockage et la méthode GET pour le récupérer. HTTP est un protocole assez populaire et pratique pour le transfert de données.
Lorsque nous interrogeons Streamer, il passe par Nylon pour interroger PairDB, détermine sur quelle paire il est possible de charger le fichier, puis transmet les données via WebDAV à cette paire.
Essentiellement, tout serveur de stockage est constitué de nginx plus des disques montés sur des chemins donnés. Nous pouvons depuis Streamer charger un fichier dans le stockage, le supprimer, le renommer ou vérifier son intégrité. C'est-à-dire que c'est une interface pratique pour une interaction de bas niveau avec le stockage.
Streamer : point d'entrée dans le stockage
Ce que nous avons ajouté pour créer un stockage S3
Ainsi, nous avons examiné l'architecture de base du stockage au moment de lancer le stockage S3. Grâce à la méthode PUT, nous pouvions y placer n'importe quel contenu et obtenir comme identifiant de ces données un hachage. Avec cet identifiant, il était ensuite possible de revenir chercher le fichier d'origine. Mais cela n'est pas suffisant pour mettre en œuvre S3. Dans le protocole S3, en plus du simple stockage d'objets, il y a :
- le stockage de métadonnées — propriétés supplémentaires des objets ;
- l'organisation de l'accès aux objets via HTTP ;
- le regroupement d'objets dans des collections — des buckets ;
- HTTP-S3 Endpoint. S3 organise les données dans des structures définies — des buckets, chacun fournissant un point d'entrée pour le stockage de fichiers.
Pour mettre en œuvre cette logique, un service distinct était nécessaire. Nous voulions également anticiper l'architecture pour une croissance future du service avec une évolutivité linéaire.
Les premiers composants
Démon qui implémente l'API S3. Il s'agit de l'API S3 standard d'Amazon, qui prend en charge le travail avec XML pour les métadonnées et permet de transférer directement du contenu. Nous n'avons pas eu besoin d'inventer quoi que ce soit, tout est décrit et documenté.
Nous avons également placé Nginx devant le service. Nous l'avons utilisé pour la terminaison SSL, l'équilibrage de charge, ainsi que pour une certaine logique en Lua (métriques, journalisation et traçage).
Pour le stockage des métadonnées S3, nous avons également choisi Tarantool. Dans la première version, le démon S3 accédait à cette base pour les métadonnées, tandis que le contenu lui-même était stocké dans un grand stockage via Streamer.
Nginx + API S3 + métadonnées
Modèle de stockage objet
Voyons comment S3 fonctionne. L'utilisateur peut créer un bucket - une collection d'objets. Le bucket est adressé par le nom d'hôte et est un sous-domaine du service. Au sein du bucket, l'utilisateur peut créer des objets. L'identifiant d'un objet sera l'URL. Le contenu de l'objet est un blob, un tableau de données binaires que nous allons stocker dans le stockage. L'objet a également des attributs : un nom - l'URL elle-même, un ACL (liste de contrôle d'accès), d'autres attributs supplémentaires ou arbitraires - tout cela est enregistré dans les métadonnées.
Un schéma normalisé de ces données pourrait ressembler à ceci : il y a des projets qui possèdent des buckets, qui possèdent des objets, et les objets peuvent être composites. Puisque l'un des moyens de télécharger un objet est par morceaux, il existe deux tables auxiliaires pour le téléchargement : uploads et chunks. Les projets ont également des identifiants pour l'accès et la facturation.
Schéma de données
Étant donné que nous avons créé un service B2B avec accès payant, une facturation était nécessaire dans ce schéma.
Le service de facturation a également été mis en œuvre sur Tarantool.
Améliorations du stockage S3 : étapes vers la production
Nous avons déjà créé un modèle fonctionnel qui peut être utilisé : les objets et les métadonnées étaient stockés, mais il manquait quelques éléments pour passer en production.
Tout d'abord, il y a le système de limitation de taux. Si nous lançons le service sans cela, lors d'une charge de pointe, nous pourrions surcharger de manière imprévisible certaines parties du système. La limitation de taux doit fonctionner de la manière suivante : toute requête S3 arrive sur un hôte spécifique, cet hôte est l'identifiant du bucket, et le bucket appartient à un client. Nous devons définir une certaine fonction à partir du bucket qui permettrait de calculer la limitation de taux.
De plus, le système de limitation de taux doit être suffisamment performant pour supporter la charge qui arrive sur S3.
Ici, nous avons de nouveau utilisé Tarantool. Les limitations de taux consistent en un cluster de 21 instances, les instances sont divisées en groupes, réparties sur trois nœuds physiques et regroupées en un grand cluster topologique. Les modifications de configuration y sont automatiquement propagées : les limitations de taux, les valeurs par défaut et la configuration sont définies. Chaque bucket est servi par exactement une instance. Lorsque une requête arrive pour un bucket spécifique, une instance responsable de ce bucket est déterminée. Au sein de ce nœud, le taux actuel des requêtes est calculé selon un algorithme similaire à Token Bucket. Ensuite, le système de limitations de taux, basé sur les indicateurs de charge actuels et les propriétés définies pour le bucket spécifique, décide si la requête peut être exécutée ou non. La vérification des limites s'effectue à la première étape de l'exécution de la requête S3, protégeant tous les autres éléments du système contre une surcharge excessive.
Il est également assez difficile de fonctionner sans cache sous une charge. S3 implique des accès répétés aux mêmes objets, c'est-à-dire qu'il s'agit d'un stockage chaud. Dans des conditions normales, l'accès à un seul fichier est géré par toute la chaîne : Streamer, FileDB, PairDB, Storage. Mais lors d'un accès répété au fichier, nous optimisons l'accès à ce contenu à l'aide d'un cache local.
Le cache est hiérarchique et est réalisé à l'aide de nginx, de disques SSD locaux et de RAM. Ici, nous n'avons pas utilisé Tarantool, car il est plus pratique de servir des objets à partir du système de fichiers, ce qui nous permet de mettre en œuvre un tiering de cache. De plus, nous avons de gros objets avec une taille maximale de 32 Go, et dans Tarantool, il n'est possible de mettre en cache que de petits objets.
Ce premier système que nous avons lancé avait une capacité calculée, suffisante pour explorer et comprendre le produit, et pour s'assurer qu'il fonctionnerait.
Améliorations du système opérationnel : basculement et mise à l'échelle
Le système était déjà opérationnel, mais nous avions omis certaines choses au départ ; il fallait ajouter le basculement et la mise à l'échelle.
Notre démon S3 récupérait des métadonnées via le protocole Tarantool. À la place de la base de données originale, nous avons installé Tarantool, qui agissait comme un routeur proxy pour les requêtes de métadonnées. Du point de vue de l'application implémentant l'API, rien n'a changé — elle continuait à interroger la base via le protocole Tarantool, mais le routeur a pu assurer un basculement actif. Cela signifie que nous pouvions vérifier la disponibilité des nœuds, gérer les pauses lors des commutations et des pannes, etc. De plus, nous n'avons pas modifié l'application elle-même.
En savoir plus sur notre mise en œuvre du sharding
La question suivante à laquelle nous avons dû faire face était le sharding. Le système grandissait, le nombre d'objets augmentait et il fallait assurer des possibilités de croissance future.
Revenons au schéma de données : il y a des projets, des compartiments, des crédos et de la facturation. Ce sont des objets qui, très probablement, ne dépasseront pas les limites d'une instance en termes de volume ou de requêtes dans un avenir proche. Donc, il n'y a pas de sens à les sharder, et nous les avons extraits dans une instance séparée, qui restera non shardée. Cela permet de gérer les projets et les compartiments de manière plus cohérente, puisqu'il y a un point non shardé unique.
Il y a aussi dans le schéma des objets qui croissent linéairement — au départ, il y en avait des centaines de milliers, maintenant leur nombre se compte par milliards. De tels objets, ainsi que leurs parties, devaient être déplacés vers un cluster shardé.
Nous avons divisé le schéma, mais les objets doivent interagir avec les compartiments : chaque objet appartient toujours à un compartiment spécifique, plus l'ACL fonctionne sur le compartiment. Ainsi, pour chaque shard contenant des objets, nous conservons une copie fantôme de chaque compartiment. De plus, lors de la modification des objets et de l'exécution des requêtes, il est nécessaire de calculer le volume pour la facturation, c'est pourquoi chaque shard a des compteurs de facturation.
Nous avons également ajouté plusieurs tables et composants :
- une corbeille, pour la suppression de projets anciens qui sont supprimés ou gelés ;
- une file d'attente pour les tâches en arrière-plan, c'est-à-dire que le stockage principal peut exécuter des tâches en arrière-plan qui doivent être effectuées sur le cluster;
- le support du cycle de vie — un mécanisme qui permet de travailler avec des objets et de gérer leur cycle de vie.
Étant donné qu'une partie des données a été répartie sur des shards, il a été nécessaire d'utiliser un proxy de shard. On aurait pu réutiliser le routeur pour ce rôle, mais un proxy de shard distinct, dédié uniquement à la shardisation des données, permet de récupérer les données en entier depuis le routeur, sans penser à la shardisation.
Je vais expliquer séparément pourquoi nous n'avons pas choisi une solution existante, mais voulions créer une fonction de shardisation personnalisée.
Voyons comment cela fonctionne. Nous avons 256 shards disponibles. Pour chaque bucket, nous définissons une plage à l'aide d'une fonction de cohérence. C'est simple : tout comme vous utilisez une fonction de cohérence pour déterminer l'appartenance à un shard, vous déterminez le shard de départ et attribuez une plage :
f(bucket, shards) = sous-ensemble
Donc, si l'on prend un bucket, on peut dire que lui et ses données seront toujours dans un sous-ensemble spécifique de tous les shards. Cela permet de réduire l'influence de certains buckets sur d'autres et de simplifier le traitement des requêtes map-reduce, lorsque nous devons, par exemple, effectuer une liste des objets d'un bucket. Pour cela, il faut interroger tous les shards où ces objets sont stockés. Si les objets étaient répartis sur tous les shards, toute liste impacterait l'ensemble du système, ici cela n'impacte qu'un sous-ensemble spécifique.
Ensuite, chaque objet appartient à un bucket spécifique, donc lorsque nous sollicitons un objet, nous le faisons par son nom dans un bucket spécifique. Cela signifie que nous pouvons définir une fonction pour un objet, non pas sur l'ensemble du domaine disponible des shards, mais seulement sur son sous-ensemble de bucket :
f(object, subset) = shard
Nous prenons un objet spécifique, et comme arguments de la fonction, nous passons non pas tous les shards, mais le sous-ensemble de son bucket — et nous obtenons le shard spécifique.
Ainsi, la shardisation est réalisée, il existe un proxy de shard. Ensuite, il reste à accéder au proxy de shard depuis le routeur et la base de données des métadonnées. Par exemple, pour créer des objets de copies de sauvegarde — lorsque nous créons un bucket, le stockage principal doit créer un représentant de ce bucket sur tous les shards où il doit être présent.
Comment nous avons mis en œuvre le resharding
Le plus grand défi du sharding est le resharing. Il était crucial pour nous de le réaliser sans downtime, car le système était déjà en production. Je vais montrer comment nous avons résolu le problème à l'aide d'une tâche similaire de migration de données en direct d'un projet à un autre.
Voici le schéma de notre cluster, obtenu après l'implémentation du sharding. Nous avons nginx, l'API S3, un routeur, une base primaire avec des projets, un proxy sharding et directement des shards.
Au-dessus, j'ai omis de mentionner qu'à un certain stade du projet, il y avait une tâche produit : « Lancer un autre stockage, Icebox, comme Hotbox, mais pour les données froides ». En fait, c'est le même type de stockage, mais avec des URL différentes et sans caches.
Icebox était moins utilisé que Hotbox, donc il a mis un certain temps à bénéficier d'un sharding. Finalement, nous avons décidé de l'abandonner et de fusionner Hotbox et Icebox en un seul service, en séparant simplement les classes de stockage.
Les buckets dans les stockages ne se chevauchent pas, il était donc facile de les fusionner et de les déplacer, mais les clients utilisaient à la fois l'un et l'autre stockage, il fallait donc résoudre le problème du downtime. Nous ne pouvions pas simplement éteindre et copier. Nous avons migré en plusieurs étapes.
Tout d'abord, nous avons synchronisé les stockages primaires. Nous avions Tarantool et nous pouvions lors de la création d'un objet faire ce qui suit :
- une demande de création de bucket arrive à la base, par exemple dans Hotbox ;
- Tarantool vérifie dans une autre base (dans ce cas, dans Icebox) qu'il n'existe pas de tel bucket ;
- si le bucket existe, la base indique qu'il ne peut pas être créé, et il est synchronisé comme existant.

Synchronisation des buckets
Dans le stockage qui devait recevoir toutes les données, nous avons introduit pour les projets et les buckets un indicateur indiquant où l'objet est stocké. Il pouvait être stocké localement, c'est-à-dire dans Hotbox, dans Icebox — alors il n'y avait aucune donnée dans le nouveau stockage, ou il pouvait être en état de migration.
Si un projet ou un bucket avait l'indicateur Migrating, alors pendant la migration, la demande était d'abord exécutée dans le nouveau stockage, celui où les données devaient se trouver, et si elles n'y étaient pas, les demandes étaient redirigées vers le stockage alternatif.
Ensuite, nous avons basculé le trafic. Étant donné que l'API pouvait gérer les demandes d'Icebox ainsi que celles de Hotbox, nous avons pu changer le trafic sans downtime, simplement en déplaçant les hôtes et en ajoutant les enregistrements correspondants dans Nginx.
Après le redirection du trafic, Nginx et l'API d'Icebox pouvaient être retirés.
Nous avons ensuite supprimé Icebox nginx et l'API S3 — et tout a fonctionné :
Nous avons ensuite lancé un processus de migration en arrière-plan qui fonctionne dans la base de données — elle passe en revue tous les projets et leurs buckets un par un, attribue le statut Migrating, transfère les données et, à la fin du transfert, change le statut en Local.
Après le transfert des données, nous n'avons plus besoin de l'ancien stockage, et nous supprimons les dernières parties de l'ancien système, ainsi que le support du statut de migration dans le code.
Le resharding de l'ancien stockage vers un stockage shardé a été réalisé selon les mêmes principes :
- Tous les buckets ont été marqués comme
Non-sharded. Toutes les requêtes à eux allaient vers le stockage original, non shardé. - De nouveaux buckets étaient immédiatement créés avec le statut
Sharded. - Nous avons pris les buckets un par un, avons défini le statut
Migratinget avons transféré les données.
Les requêtes étaient traitées selon le principe suivant :
- Nous lisons dans le nouveau, puis dans l'ancien.
- Nous créons uniquement dans le nouveau.
- Nous mettons à jour en deux phases : si le nouveau n’existe pas, nous transférons de l’ancien au nouveau, puis nous mettons à jour.
Gestion des certificats SSL
Sur le frontend, nous utilisons Nginx. Dans notre cas, ce n'est pas un Nginx ordinaire, mais un OpenResty, Nginx avec le support de LuaJIT.
Une autre partie du système — gestion des certificats SSL. Dans le stockage S3, vous pouvez définir votre propre domaine pour accéder à un bucket spécifique, simplement grâce à CNAME. Mais sans HTTPS aujourd'hui, cela n'est pas possible : un domaine personnalisé implique un certificat SSL personnalisé.
Comme je l'ai déjà mentionné, Nginx est responsable de l'équilibrage et de la terminaison SSL. Dans notre cas, ce n'est pas un Nginx ordinaire, mais un OpenResty, Nginx avec le support de LuaJIT.
Cela nous a permis d'apprendre très facilement à notre Nginx à délivrer des certificats arbitraires. De plus, il était nécessaire de délivrer des certificats de manière dynamique (sans avoir besoin de les écrire dans le fichier de configuration). Nous avons utilisé l'extension ssl_certificate_by_lua, qui permet de lire le certificat à partir d'une source arbitraire directement pendant le handshake TLS. Comme stockage de certificats, nous avons également utilisé Tarantool : cela permet de gérer les certificats de l'extérieur et assure une délivrance extrêmement rapide.
Un démon séparé a également été mis en place, chargé de mettre à jour régulièrement les certificats délivrés par Let’s Encrypt.
Ce que j'aurais conservé et ce que j'aurais fait différemment en redéveloppant un stockage.
Ce qui aurait dû être utilisé dès le départ.
Sharding dès le départ.. La re-sharding a causé pas mal de problèmes. C'est facile à faire, mais néanmoins, si l'on commence des projets qui doivent être évolutifs, il vaut mieux directement opter pour un cluster shardé, même avec un minimum de nœuds. La mise en œuvre du sharding dès le départ est presque gratuite par rapport à l'intégration du sharding dans un système en production.
Travailler avec Tarantool via les load balancers.. Maintenant, nous intégrons toutes les nouvelles bases au travail via des load balancers. Cela permet d'élargir les fonctionnalités et d'atteindre une plus grande résilience.
Auto-failover.. J'aurais installé tous les outils nécessaires pour l'auto-failover, car les premiers échecs après le lancement étaient liés à son absence. Après l'expérience avec S3, tous les produits suivants ont été lancés en tenant compte de cela.
La fonctionnalité S3 « Versioning ».. Au départ, cela semblait être une fonctionnalité peu recherchée. Intégrer cette possibilité dans l'architecture d'un système opérationnel est extrêmement difficile.
Facturation séparée.. La façon dont nous avons intégré la facturation dans notre système a bien fonctionné au début, mais par la suite, cela est devenu un frein. Il aurait mieux valu l'implémenter comme un service complètement indépendant.
Ce qui était une décision judicieuse.
Modèle de données.. L'histoire a montré qu'au fur et à mesure du développement du service, nous correspondons assez précisément au modèle de données d'Amazon, ce qui nous permet de réaliser les fonctionnalités disponibles là-bas.
Schéma de sharding.. Je soutiendrais des sharding de plage similaires par compartiments, car cela permet de bien répartir les demandes de différents compartiments à travers un grand cluster.
Utilisation de Tarantool.. Tarantool a beaucoup aidé au développement et à la modification du service. Nous avons facilement travaillé avec les données, transformé et shardé le stockage sans avoir besoin de monter au niveau de l'application.
Cette présentation a été prononcée pour la première fois à par Mail.ru Cloud Solutions & Tarantool. Voir d'autres présentations et abonnez-vous aux annonces des événements sur Telegram. .
Vous pouvez également consulter mon ancienne présentation sur S3 ou lire l'article de mon collègue sur le stockage en bloc.
- .
- .
Source : habr.com
