

Je m'appelle Viktor Yagofarov et je développe une plateforme Kubernetes chez DomKlik en tant que responsable technique de développement dans l'équipe Ops (exploitation). Je voudrais vous parler de l'organisation de nos processus Dev Ops, des particularités de l'exploitation de l'un des plus grands clusters k8s en Russie, ainsi que des pratiques DevOps/SRE que notre équipe applique.
Équipe Ops
L'équipe Ops compte actuellement 15 personnes. Trois d'entre elles s'occupent du bureau, deux travaillent dans un autre fuseau horaire et sont disponibles, y compris la nuit. Ainsi, il y a toujours quelqu'un de l'équipe Ops derrière un écran, prêt à réagir à tout incident, quelle que soit sa complexité. Nous n'avons pas de nuits de garde, ce qui préserve notre santé mentale et permet à chacun de bien dormir et de passer du temps libre en dehors des ordinateurs.
Les compétences varient d'une personne à l'autre : administrateurs réseau, DBA, spécialistes de la pile ELK, administrateurs/développeurs Kubernetes, experts en surveillance, virtualisation, matériel, etc. Ce qui nous unit, c'est que chacun peut remplacer, dans une certaine mesure, n'importe lequel d'entre nous : par exemple, ajouter de nouveaux nœuds au cluster k8s, mettre à jour PostgreSQL, écrire un pipeline CI/CD + Ansible, automatiser des tâches en Python/Bash/Go, connecter du matériel dans un datacenter. Avoir de solides compétences dans un domaine n'empêche pas de changer de direction et de se perfectionner dans un autre domaine. Par exemple, j'ai rejoint l'entreprise en tant que spécialiste de PostgreSQL, et maintenant ma principale zone de responsabilité est les clusters Kubernetes. Au sein de l'équipe, toute progression est encouragée et il existe un fort sentiment de camaraderie.
En fait, nous sommes en train de recruter. Les exigences pour les candidats sont assez standard. Pour moi personnellement, il est important que la personne s'intègre dans l'équipe, qu'elle soit non conflictuelle, mais qu'elle puisse aussi défendre son point de vue, qu'elle ait l'envie de se développer et qu'elle n'ait pas peur de faire quelque chose de nouveau, en proposant ses idées. De plus, des compétences en programmation sur des langages de script, une connaissance des bases de Linux et de l'anglais sont indispensables. L'anglais est nécessaire simplement pour que la personne puisse rapidement rechercher une solution à un problème en cas de pépin, en 10 secondes plutôt qu'en 10 minutes. Il est actuellement très difficile de trouver des spécialistes ayant une connaissance approfondie de Linux : c'est drôle, mais deux candidats sur trois ne peuvent pas répondre à la question « Qu'est-ce que la charge moyenne ? De quoi est-elle composée ? », et ils considèrent la question « Comment collecter un core dump d'un programme en C » comme quelque chose qui appartient à un autre monde… ou à celui des dinosaures. Nous devons composer avec cela, car généralement, les gens ont des compétences très développées dans d'autres domaines, et nous allons former sur Linux. La réponse à la question « Pourquoi est-il nécessaire de tout savoir pour un ingénieur DevOps dans le monde moderne du cloud » devra être laissée en dehors de cet article, mais en trois mots : tout cela est nécessaire.
Équipe Outils
L'équipe Outils joue un rôle non négligeable dans l'automatisation. Leur principal objectif est de créer des outils graphiques et CLI pratiques pour les développeurs. Par exemple, notre développement interne Confer permet de déployer une application dans Kubernetes en seulement quelques clics, de configurer ses ressources, clés de vault, etc. Auparavant, nous utilisions Jenkins + Helm 2, mais nous avons dû développer notre propre outil pour éliminer le copier-coller et introduire l'uniformité dans le cycle de vie des logiciels.
L'équipe Ops n'écrit pas de pipelines pour les développeurs, mais peut les conseiller sur toutes les questions concernant leur rédaction (certaines personnes utilisent encore Helm 3).
DevOps
En ce qui concerne DevOps, nous le voyons comme suit :
Les équipes Dev écrivent du code, le déploient via Confer dans dev -> qa/stage -> prod. La responsabilité de s'assurer que le code ne ralentit pas et ne génère pas d'erreurs repose sur les équipes Dev et Ops. Pendant la journée, la réaction à un incident avec son application doit être assurée en première instance par le référent de l'équipe Ops, tandis que le soir et la nuit, l'admin de garde (Ops) doit réveiller le développeur de garde s'il est certain que le problème n'est pas dans l'infrastructure. Toutes les métriques et alertes dans la surveillance apparaissent automatiquement ou semi-automatiquement.
La zone de responsabilité des Ops commence au moment du déploiement de l'application en production, mais la responsabilité des Devs ne s'arrête pas là - nous faisons un travail commun et sommes dans le même bateau.
Les développeurs conseillent les administrateurs si de l'aide est nécessaire pour écrire un microservice admin (par exemple, backend Go + HTML5), et les administrateurs conseillent les développeurs sur toute question d'infrastructure ou liée à k8s.
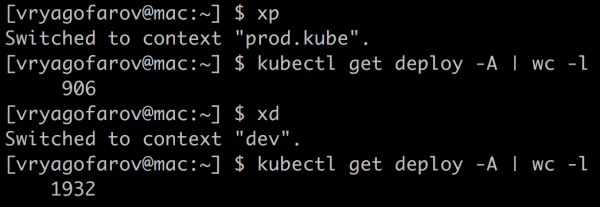
Au fait, nous n'avons pas de monolithe, seulement des microservices. Leur nombre oscille actuellement entre 900 et 1000 dans notre cluster k8s en production, si l'on mesure par le volume. déploiementsLe nombre de pods varie entre 1700 et 2000. Il y a actuellement environ 2000 pods dans le cluster de production.
Je ne peux pas donner de chiffres précis, car nous surveillons les microservices inutiles et les supprimons de manière semi-automatique. La surveillance des entités inutiles dans k8s est facilitée par , ce qui permet d'économiser des ressources et de l'argent.
Gestion des ressources
Surveillance
La pierre angulaire de l'exploitation d'un grand cluster est un monitoring bien structuré et informatif. Nous n'avons pas encore trouvé de solution universelle qui couvre 100 % de tous les besoins en matière de monitoring, c'est pourquoi nous développons périodiquement différentes solutions personnalisées dans ce domaine.
- Zabbix. Un monitoring classique, qui est principalement destiné à suivre l'état général de l'infrastructure. Il nous indique quand un nœud échoue en raison d'un pourcentage de CPU, de mémoire, de disque, de réseau, etc. Rien de surhumain, mais nous avons également un DaemonSet d'agents, grâce auxquels, par exemple, nous surveillons l'état du DNS dans le cluster : nous recherchons les pods coredns qui ralentissent, vérifions l'accessibilité des hôtes externes. On pourrait se demander pourquoi gérer cela, mais avec de gros volumes de trafic, ce composant représente un point de défaillance sérieux. Précédemment, j'avais déjà , comment j'avais lutté contre les performances du DNS dans le cluster.
- Prometheus Operator. Un ensemble de différents exporters offre une grande vue d'ensemble de tous les composants du cluster. Ensuite, nous visualisons tout cela sur de grands tableaux de bord dans Grafana, et pour les alertes, nous utilisons alertmanager.
Un autre outil utile pour nous est devenu . Nous l'avons écrit après avoir rencontré plusieurs fois la situation où une équipe écrase l'Ingress d'une autre équipe, ce qui entraîne des erreurs 50x. Maintenant, avant de déployer en production, les développeurs vérifient qu'ils ne vont déranger personne, et pour mon équipe, c'est un bon outil pour un diagnostic initial des problèmes d'Ingress. C'est drôle qu'il ait d'abord été écrit pour les admins et qu'il avait un aspect assez « rustique », mais après que l'outil ait plu aux équipes de développement, il a beaucoup évolué et n'a plus l'allure d'un « admin faisant une interface pour les admins ». Bientôt, nous nous passerons de cet outil et de telles situations seront validées avant même le déploiement du pipeline.
Ressources des équipes dans « Kube »
Avant de commencer avec les exemples, il est important d'expliquer comment nous allouons les ressources pour microservices.
Pour comprendre quelles équipes et en quelles quantités utilisent leurs ressources (processeur, mémoire, SSD local), nous attribuons à chaque équipe sa propre namespace dans « Kube » et limitons ses capacités maximales en termes de processeur, de mémoire et de disque, après avoir discuté des besoins des équipes. Par conséquent, une équipe ne bloquera généralement pas tout le cluster pour le déploiement en s'appropriant des milliers de cœurs et des téraoctets de mémoire. Les accès dans l'espace de noms sont accordés via AD (nous utilisons RBAC). Les espaces de noms et leurs limites sont ajoutés via une pull request dans le dépôt GIT, et ensuite, tout est automatiquement déployé via un pipeline Ansible.
Exemple d'allocation de ressources pour une équipe :
namespaces:

  chat-team:
    pods: 23
    limits:
      cpu: 11
      memory: 20Gi
    requests:
      cpu: 11
      memory: 20Gi
Demandes et limites
Dans « Kube » Request — c'est le nombre de ressources réservées garantis pour pod (un ou plusieurs conteneurs Docker) dans le cluster. Limit — c'est le maximum non garanti. On peut souvent voir sur les graphiques qu'une certaine équipe a attribué trop de demandes pour toutes ses applications et ne peut pas déployer l'application dans « Kube », car tous les requêtes dans leur espace de noms ont déjà été « épuisées ».
La bonne façon de sortir de cette situation : observer la consommation réelle des ressources et la comparer à la quantité demandée (Request).
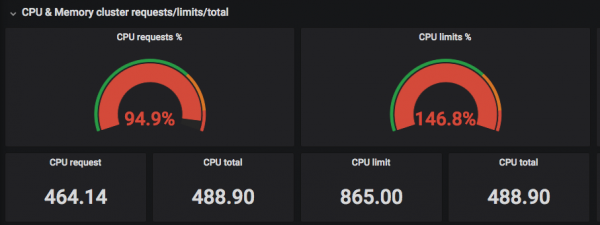
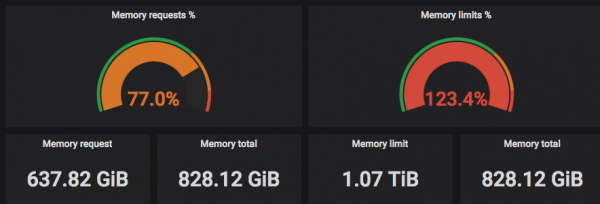
Sur les captures d'écran ci-dessus, on peut voir que les « demandés » (Requested) en CPU se rapprochent du nombre réel de threads, tandis que les Limites peuvent dépasser le nombre réel de threads de processeurs centraux =)
Passons maintenant en revue un namespace spécifique (j'ai choisi le namespace kube-system — le namespace système pour les composants de « Kube ») et examinons la relation entre le temps processeur réellement utilisé et la mémoire demandée :
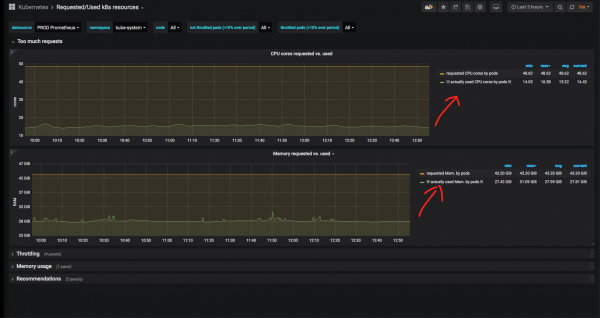
Il est évident que la mémoire et le CPU réservés pour les services système sont bien supérieurs à leur utilisation réelle. Dans le cas de kube-system, cela est justifié : il est arrivé que le contrôleur d'entrée nginx ou nodelocaldns atteignent leur maximum de CPU et consomment beaucoup de RAM, donc cette réserve est justifiée. De plus, nous ne pouvons pas nous fier aux graphiques des dernières 3 heures : il est préférable de voir des métriques historiques sur une période plus longue.
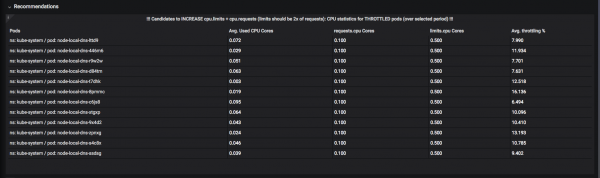
Un système de « recommandations » a été développé. Par exemple, ici, on peut voir quels ressources il serait bénéfique d'augmenter les « limites » (plafond autorisé), afin d'éviter le « throttling » : le moment où le CPU ou la mémoire déjà utilisé atteint le temps imparti et attend d'être « débloqué » :
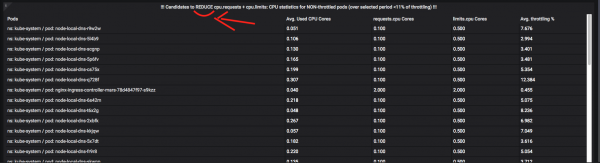
Et voici les pods qui devraient réduire leur consommation :
À propos de throttling + la surveillance des ressources est un sujet qui pourrait faire l'objet de plusieurs articles, donc n'hésitez pas à poser vos questions dans les commentaires. En quelques mots, je peux dire que l'automatisation de telles métriques est une tâche complexe et nécessite beaucoup de temps et une certaine dextérité avec les fonctions « window » et « CTE » Prometheus / VictoriaMetrics (ces termes sont entre guillemets, car dans PromQL, il n'y a presque rien de semblable, et il faut créer des requêtes complexes de plusieurs écrans de texte et s'occuper de leur optimisation).
En fin de compte, les développeurs disposent d'outils pour surveiller leurs namespaces dans « Kube », et ils peuvent choisir où et à quel moment des ressources peuvent être « réduites », et quels pods peuvent se voir allouer tout le CPU pour toute la nuit.
Méthodologies
Dans notre entreprise, comme c'est à la mode maintenant, nous adhérons aux pratiques DevOps et-pratiques. Lorsqu'une entreprise compte 1000 microservices, environ 350 développeurs et 15 administrateurs pour toute l'infrastructure, il faut « être à la mode » : derrière tous ces « mots à la mode » se cache un besoin urgent d'automatisation de tout, et les administrateurs ne doivent pas constituer un goulot d'étranglement dans les processus. SREEn tant qu'Ops, nous fournissons diverses métriques et tableaux de bord pour les développeurs, liés à la rapidité de réponse des services et leurs erreurs.
Nous utilisons des méthodologies telles que :
RED , et , en les combinant. Nous essayons de minimiser le nombre de tableaux de bord afin qu'il soit clair en un coup d'œil quel service est actuellement en dégradation (par exemple, les codes de réponse par seconde, le temps de réponse au 99ème percentile), etc. Dès que de nouvelles métriques sont nécessaires pour les tableaux de bord généraux, nous les traçons et les ajoutons immédiatement.
Je n'ai pas dessiné de graphiques depuis un mois. C'est probablement un bon signe : cela signifie que la plupart des « désirs » ont déjà été réalisés. Il y a eu des semaines où je dessinais au moins un nouveau graphique par jour.
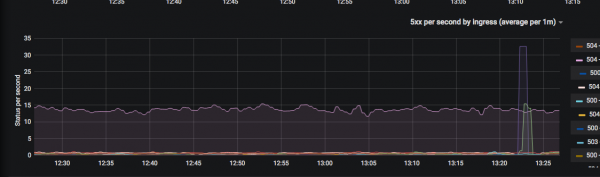
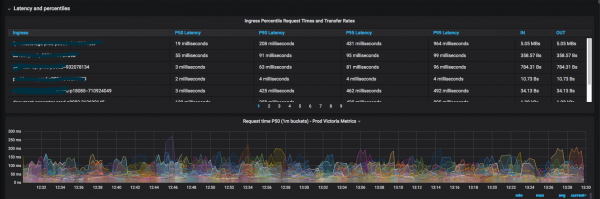
Le résultat obtenu est précieux car maintenant les développeurs viennent assez rarement voir les administrateurs avec des questions comme « où puis-je trouver une certaine métrique ? »
Déploiement Service Mesh n’est pas loin et devrait grandement faciliter la vie de tous, mes collègues des Outils sont déjà proches de la mise en œuvre de l’abstrait « Istio de la personne saine » : le cycle de vie de chaque requête HTTP(s) sera visible dans la surveillance, et il sera toujours possible de comprendre « à quel moment cela a cassé » lors des interactions entre services (et pas seulement). Abonnez-vous aux nouvelles du hub de l'entreprise DomClick. =)
Support de l'infrastructure Kubernetes
Historiquement, nous utilisons une version patchée Kubespray — rôle Ansible pour déployer, étendre et mettre à jour Kubernetes. À un moment donné, la prise en charge des installations non kubeadm a été supprimée de la branche principale, et le processus de transition vers kubeadm n'a pas été proposé. En conséquence, la société Southbridge a fait son fork (avec prise en charge de kubeadm et correction rapide des problèmes critiques).
Le processus de mise à jour de tous les clusters k8s se déroule comme suit :
- Nous prenons Kubespray de Southbridge, vérifions avec notre branche, fusionnons.
- Nous déployons la mise à jour dans Stress-« Cube ».
- Nous déployons la mise à jour un nœud à la fois (dans Ansible, c'est « serial: 1 ») dans Dev-« Cube ».
- Nous mettons à jour Prod le samedi soir un nœud à la fois.
À l'avenir, il est prévu de remplacer Kubespray par quelque chose de plus rapide et de passer à kubeadm.
Nous avons au total trois « Cubes » : Stress, Dev et Prod. Nous prévoyons de lancer un autre (hot standby) Prod-« Cube » dans le second datacenter. Stress et Dev vivent dans des « virtual machines » (oVirt pour Stress et VMWare cloud pour Dev). Prod-« Cube » vit sur du « matériel nu » (bare metal) : ce sont des nœuds identiques avec 32 threads CPU, 64-128 Go de RAM et 300 Go de SSD RAID 10 — un total de 50 pièces. Trois nœuds « fins » sont réservés pour le « maître » Prod-« Cube » : 16 Go de RAM, 12 threads CPU.
Pour la production, nous préférons utiliser du « matériel nu » et évitons les niveaux intermédiaires inutiles comme OpenStack: nous n'avons pas besoin de « voisins bruyants » et de temps de vol CPU steal time. De plus, la complexité de l'administration augmente presque de moitié dans le cas d'OpenStack en interne.
Pour les composants d'infrastructure CI/CD « Cubiques » et autres, nous utilisons un serveur GIT distinct, Helm 3 (nous avons migré assez douloureusement depuis Helm 2, mais nous sommes très contents de l'option atomic), Jenkins, Ansible et Docker. Nous aimons les branches de fonctionnalités et le déploiement dans différents environnements à partir d'un seul référentiel.
Conclusion
Voilà, en gros, à quoi ressemble le processus DevOps chez DomClick du point de vue de l'ingénieur d'exploitation. L'article s'est avéré moins technique que je ne l'avais prévu, donc, restez à l'écoute des nouvelles de DomClick sur Habr : il y aura des articles plus « hardcore » sur Kubernetes et plus encore.
Source : habr.com
