

Au début, il y avait une technologie appelée BPF. Nous l'avons examinée dans , l'article de style ancien de ce cycle. En 2013, grâce aux efforts d'Alexei Starovoitov et de Daniel Borkman, une version améliorée a été développée et intégrée dans le noyau Linux, optimisée pour les machines modernes 64 bits. Cette nouvelle technologie a brièvement porté le nom de Internal BPF, puis a été renommée en Extended BPF, et maintenant, après plusieurs années, tout le monde l'appelle simplement BPF.
En gros, BPF permet d'exécuter du code arbitraire fourni par l'utilisateur dans l'espace noyau de Linux et la nouvelle architecture s'est révélée si réussie qu'il nous faudra encore une dizaine d'articles pour décrire toutes ses applications. (La seule chose que les développeurs n'ont pas réussi à faire, comme vous pouvez le voir sur la capture d'écran ci-dessous, c'est de créer un logo convenable.)
Cet article décrit la structure de la machine virtuelle BPF, les interfaces du noyau pour travailler avec BPF, les outils de développement, ainsi qu'un aperçu très bref, mais très concis, des capacités existantes, c'est-à-dire tout ce dont nous aurons besoin par la suite pour approfondir notre étude des applications pratiques de BPF.
Résumé de l'article
Tout d'abord, nous examinerons l'architecture BPF d'un point de vue aérien et identifierons les principaux composants.
Déjà en ayant une compréhension générale de l'architecture, nous décrirons la structure de la machine virtuelle BPF.
Dans cette section, nous examinerons plus attentivement le cycle de vie des objets BPF - programmes et maps.
Ayant déjà une certaine compréhension du système, nous examinerons enfin comment créer et gérer des objets depuis l'espace utilisateur à l'aide d'un appel système spécial - bpf(2).
Il est certainement possible d'écrire des programmes à l'aide d'un appel système. Mais c'est compliqué. Pour un scénario plus réaliste, les programmeurs du noyau ont développé une bibliothèque libbpf. Nous créerons le squelette d'application BPF le plus simple que nous utiliserons dans les exemples suivants.
Ici, nous allons découvrir comment les programmes BPF peuvent accéder aux fonctions auxiliaires du noyau — un outil qui, avec les maps, élargit considérablement les capacités du nouveau BPF par rapport au BPF classique.
À ce stade, nous saurons suffisamment pour comprendre comment créer des programmes utilisant des maps. Nous jeterons même un œil au grand et puissant vérificateur.
Section de référence sur la façon de compiler les utilitaires et le noyau nécessaires pour les expériences.
À la fin de l'article, ceux qui auront lu jusqu'ici trouveront des mots motivants et un bref aperçu de ce qui sera abordé dans les articles suivants. Nous énumérerons également quelques liens pour auto-apprentissage pour ceux qui ne souhaitent pas ou ne peuvent pas attendre la suite.
Introduction à l'architecture BPF
Avant de commencer à examiner l'architecture BPF, nous ferons une dernière référence (vraiment ?) au , qui a été développé en réponse à l'émergence des machines RISC et a résolu le problème du filtrage efficace des paquets. L'architecture s'est avérée si réussie qu'elle, née dans les durs années quatre-vingt-dix à Berkeley UNIX, a été portée sur la plupart des systèmes d'exploitation existants, a survécu aux années folles et continue de trouver de nouvelles applications.
Le nouveau BPF a été conçu en réponse à la généralisation des machines 64 bits, des services cloud et des besoins accrus en outils pour créer des SDN (Sréseau-ddéfini npar logiciel). Développé par des ingénieurs réseau du noyau comme une alternative améliorée au BPF classique, le nouveau BPF a rapidement trouvé des applications dans la tâche ardue de traçage des systèmes Linux, et maintenant, six ans après son apparition, nous aurons besoin d'un article entier juste pour énumérer les différents types de programmes.
DeS cHaOs
Au fond, BPF est une machine virtuelle sandbox permettant d'exécuter du code « arbitraire » dans l'espace noyau sans compromettre la sécurité. Les programmes BPF sont créés dans l'espace utilisateur, chargés dans le noyau et attachés à une source d'événements. Un événement peut être, par exemple, la livraison d'un paquet sur une interface réseau, l'activation d'une fonction du noyau, etc. En cas de paquet, les données et les métadonnées du paquet seront accessibles au programme BPF (en lecture et, peut-être, en écriture, selon le type de programme), et en cas d'activation d'une fonction du noyau — les arguments de la fonction, y compris les pointeurs vers la mémoire noyau, etc.
Examinons ce processus plus en détail. Pour commencer, parlons de la première différence avec le BPF classique, dont les programmes étaient écrits en assembleur. Dans la nouvelle version, l'architecture a été améliorée pour permettre l'écriture de programmes dans des langages de haut niveau, principalement en C. Pour cela, un backend pour llvm a été développé, permettant de générer du bytecode pour l'architecture BPF.
L'architecture BPF a été conçue, entre autres, pour être exécutée efficacement sur les machines modernes. Pour que cela fonctionne dans la pratique, le bytecode BPF, après son chargement dans le noyau, est traduit en code natif à l'aide d'un composant appelé JIT compiler (Just In desime). Ensuite, si vous vous en souvenez, dans le BPF classique, le programme était chargé dans le noyau et attaché à la source d'événements de manière atomique — dans le contexte d'un seul appel système. Dans la nouvelle architecture, cela se produit en deux étapes — d'abord le code est chargé dans le noyau à l'aide d'un appel système bpf(2), puis, plus tard, à l'aide d'autres mécanismes, différents selon le type de programme, le programme est attaché à la source d'événements.
Ici, le lecteur pourrait se poser la question : est-ce que c'était vraiment possible ? Comment la sécurité de l'exécution de ce code est-elle garantie ? La sécurité d'exécution est garantie par l'étape de chargement des programmes BPF appelée vérificateur (en anglais, cette étape s'appelle verifier et je continuerai à utiliser le terme anglais) :
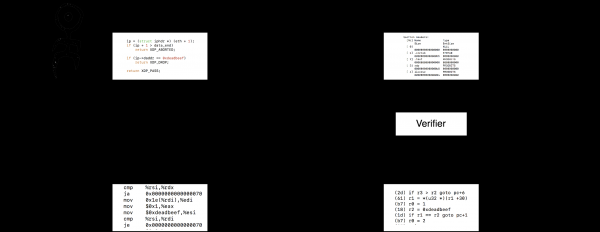
Le Verifier est un analyseur statique qui garantit qu'un programme ne perturbera pas le bon fonctionnement du noyau. Cela ne signifie pas pour autant qu'un programme ne peut pas interférer avec le fonctionnement du système : les programmes BPF, en fonction de leur type, peuvent lire et réécrire des zones de mémoire du noyau, modifier les valeurs de retour des fonctions, tronquer, compléter, réécrire et même transférer des paquets réseau. Verifier garantit qu'il n'y aura pas de crash du noyau lors de l'exécution d'un programme BPF et que le programme, qui a normalement accès en écriture, par exemple, aux données d'un paquet sortant, ne pourra pas écraser la mémoire du noyau en dehors du paquet. Nous examinerons plus en détail le verifier dans la section correspondante, après avoir fait connaissance avec tous les autres composants de BPF.
Alors, que savons-nous jusqu'à présent ? L'utilisateur écrit un programme en langage C, le charge dans le noyau via un appel système bpf(2), où il passe à travers le verificateur et est traduit en bytecode natif. Ensuite, le même utilisateur ou un autre connecte le programme à une source d'événements et il commence à s'exécuter. La séparation du chargement et de la connexion est nécessaire pour plusieurs raisons. Tout d'abord, l'exécution du verificateur est relativement coûteuse et charger le même programme plusieurs fois consomme du temps processeur inutilement. Deuxièmement, la façon dont le programme est connecté dépend de son type, et une interface "universelle" créée il y a un an peut ne pas convenir aux nouveaux types de programmes. (Bien qu'aujourd'hui, alors que l'architecture devient plus mature, il y ait une idée de normaliser cette interface au niveau libbpf.)
Un lecteur attentif pourra remarquer que nous n'avons pas encore terminé avec les images. En effet, tout ce qui a été dit précédemment n'explique pas en quoi le BPF modifie fondamentalement la situation par rapport au BPF classique. Deux innovations, qui élargissent considérablement les frontières d'applicabilité, sont la possibilité d'utiliser de la mémoire partagée et les fonctions d'assistance du noyau (kernel helpers). Dans le BPF, la mémoire partagée est réalisée grâce à ce que l'on appelle des maps — des structures de données partagées avec une API définie. Ce nom a probablement été choisi car le premier type de map à apparaître était une table de hachage. Ensuite, il y a eu des tableaux, des tables de hachage locales (par CPU) et des tableaux locaux, des arbres de recherche, des maps contenant des pointeurs vers des programmes BPF et bien d'autres encore. Ce qui nous intéresse ici, c'est que les programmes BPF ont désormais la possibilité de conserver un état entre les appels et de le partager avec d'autres programmes ainsi qu'avec l'espace utilisateur.
L'accès aux maps s'effectue depuis les processus utilisateur par le biais d'un appel système bpf(2), et depuis les programmes BPF fonctionnant dans le noyau — par l'intermédiaire de fonctions d'assistance. De plus, ces helpers ne servent pas seulement à travailler avec les maps, mais permettent également d'accéder à d'autres fonctionnalités du noyau. Par exemple, les programmes BPF peuvent utiliser des fonctions d'assistance pour rediriger des paquets vers d'autres interfaces, générer des événements du sous-système perf, accéder à des structures du noyau, etc.
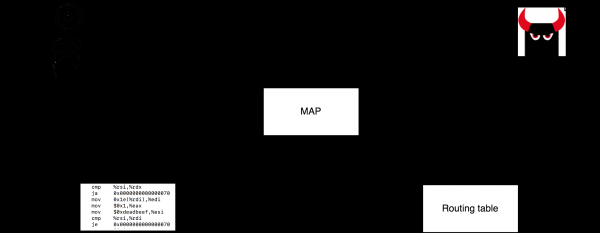
En bref, le BPF permet de charger du code utilisateur arbitraire, c'est-à-dire ayant passé le vérificateur (verifier), dans l'espace du noyau. Ce code peut conserver son état entre les appels et échanger des données avec l'espace utilisateur, tout en ayant accès aux sous-systèmes du noyau qui sont autorisés pour ce type de programmes.
Cela ressemble déjà aux fonctionnalités offertes par les modules du noyau, par rapport auxquelles BPF présente certains avantages (bien sûr, on ne peut comparer que des applications similaires, par exemple, le traçage système — on ne peut pas écrire un driver arbitraire avec BPF). On peut noter un seuil d'entrée plus bas (certaines utilitaires utilisant BPF ne supposent pas que l'utilisateur ait des compétences en programmation de noyau, ni même des compétences en programmation en général), la sécurité à l'exécution (levez la main dans les commentaires si vous n'avez jamais cassé un système lors de l'écriture ou du test de modules), l'atomicité — lors du rechargement de modules, il y a un temps d'arrêt, et le sous-système BPF garantit qu'aucun événement ne sera manqué (pour être juste, cela n'est pas vrai pour tous les types de programmes BPF).
La présence de telles fonctionnalités rend BPF un outil polyvalent pour l'extension du noyau, ce qui est confirmé par la pratique : de nouveaux types de programmes sont constamment ajoutés à BPF, de plus en plus de grandes entreprises utilisent BPF sur des serveurs de production 24/7, et de plus en plus de startups construisent leur activité sur des solutions reposant sur BPF. BPF est utilisé partout : dans la protection contre les attaques DDoS, dans la création de SDN (par exemple, la mise en œuvre de réseaux pour Kubernetes), comme principal outil de traçage des systèmes et de collecte de statistiques, dans les systèmes de détection d'intrusion et dans les environnements de sandbox, etc.
Terminons ici la partie d'introduction de l'article et examinons la machine virtuelle et l'écosystème BPF plus en détail.
Remarque : utilitaires
Pour pouvoir exécuter les exemples des sections suivantes, vous pourriez avoir besoin d'un certain nombre d'utilitaires, au minimum llvm/clang avec le support de bpf et bpftool. Dans la section vous pouvez lire les instructions sur la compilation des utilitaires, ainsi que de votre noyau. Cette section est placée ci-dessous pour ne pas perturber la fluidité de notre exposé.
Registres et système de commandes de la machine virtuelle BPF
L'architecture et le système de commandes BPF ont été développés en tenant compte du fait que les programmes seraient écrits en langage C et, après avoir été chargés dans le noyau, seraient traduits en code natif. Ainsi, le nombre de registres et le type de commandes ont été choisis en fonction de l'intersection, au sens mathématique, des capacités des machines modernes. De plus, des restrictions diverses sont imposées aux programmes, par exemple, jusqu'à récemment, il n'était pas possible d'écrire des boucles et des sous-programmes, et le nombre d'instructions était limité à 4096 (actuellement, les programmes privilégiés peuvent charger jusqu'à un million d'instructions).
Il y a onze registres 64 bits à la disposition de l'utilisateur dans BPF. r0—r10 et le compteur d'instructions (program counter). Le registre r10 contient un pointeur vers la pile (frame pointer) et n'est accessible qu'en lecture. Les programmes ont accès à une pile de 512 octets et à un nombre illimité de mémoire partagée sous forme de maps.
Les programmes BPF sont autorisés à exécuter un ensemble de fonctions auxiliaires (kernel helpers) qui dépendent du type de programme et, depuis peu, des fonctions ordinaires. Chaque fonction appelée peut accepter jusqu'à cinq arguments, transmis dans les registres r1—r5, et la valeur de retour est transmise à r0. Il est garanti qu'après le retour de la fonction, le contenu des registres r6—r9 ne changera pas.
Pour une translation efficace des programmes, les registres r0—r11 pour toutes les architectures supportées sont clairement mappés sur de véritables registres, en tenant compte des particularités de l'ABI de l'architecture actuelle. Par exemple, pour x86_64 les registres r1—r5, utilisés pour passer des paramètres à des fonctions, sont mappés sur rdi, rsi, rdx, rcx, r8, qui sont utilisés pour passer des paramètres dans les fonctions sur x86_64. Par exemple, le code de gauche est traduit en code de droite de la manière suivante :
1:  (b7) r1 = 1                    mov    $0x1,%rdi
2:  (b7) r2 = 2                    mov    $0x2,%rsi
3:  (b7) r3 = 3                    mov    $0x3,%rdx
4:  (b7) r4 = 4                    mov    $0x4,%rcx
5:  (b7) r5 = 5                    mov    $0x5,%r8
6:  (85) call pc+1                 callq  0x0000000000001ee8
Le registre r0 est également utilisé pour retourner le résultat de l'exécution du programme, tandis que dans le registre r1 le programme reçoit un pointeur vers le contexte — en fonction du type de programme, cela peut être par exemple la structure (pour XDP) ou la structure (pour différents programmes réseau) ou la structure (pour différents types de programmes de tracing), etc.
Ainsi, nous avions un ensemble de registres, des helpers du noyau, une pile, un pointeur de contexte et de la mémoire partagée sous forme de maps. Ce n'est pas que tout cela soit absolument nécessaire en déplacement, mais...
Continuons la description et parlons du jeu d'instructions pour travailler avec ces objets. Tous () les instructions BPF ont une taille fixe de 64 bits. Si vous regardez une instruction sur une machine 64 bits Big Endian, vous verrez

Ici Code — c'est le codage de l'instruction, Dst/Src — ce sont les codages du récepteur et de la source, respectivement, Moyen (3 Go de VRAM) — un décalage signé de 16 bits, et Imm — c'est un entier signé de 32 bits utilisé dans certaines instructions (analogue à la constante K de cBPF). Le codage Code a l'une des deux formes :
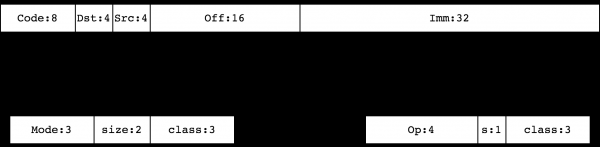
Les classes d'instructions 0, 1, 2, 3 définissent les commandes pour travailler avec la mémoire. Elles , BPF_LD, BPF_LDX, BPF_ST, BPF_STX, respectivement. Les classes 4, 7 (BPF_ALU, BPF_ALU64) constituent un ensemble d'instructions ALU. Les classes 5, 6 (BPF_JMP, BPF_JMP32) regroupent les instructions de saut.
Le plan d'étude du système d'instructions BPF est le suivant : au lieu d'énumérer minutieusement toutes les instructions et leurs paramètres, nous allons examiner quelques exemples dans cette section et il deviendra clair comment les instructions sont réellement structurées et comment désassembler manuellement n'importe quel fichier binaire pour BPF. Pour renforcer les connaissances, nous allons rencontrer encore des instructions individuelles dans les sections sur le Vérificateur, le compilateur JIT, la traduction du BPF classique, ainsi que lors de l'étude des maps, de l'appel de fonctions, etc.
Lorsque nous parlerons d'instructions individuelles, nous nous référerons aux fichiers du noyau et , dans lesquels les codes numériques des instructions BPF sont définis. En étudiant par vous-même l'architecture et/ou l'analyse des binaires, vous pouvez trouver la sémantique dans les sources suivantes, triées par ordre de difficulté : , , et, bien sûr, dans les codes sources de Linux — vérificateur, JIT, interpréteur BPF.
Exemple : désassemblons BPF dans notre esprit
Examinons un exemple où nous compilerons le programme readelf-example.c et regarderons le binaire résultant. Nous allons déduire le contenu original readelf-example.c ci-dessous, une fois que nous aurons restauré sa logique à partir des codes binaires :
$ clang -target bpf -c readelf-example.c -o readelf-example.o -O2
$ llvm-readelf -x .text readelf-example.o
Hex dump of section '.text':
0x00000000 b7000000 01000000 15010100 00000000 ................
0x00000010 b7000000 02000000 95000000 00000000 ................
Première colonne dans la sortie readelf — c'est un retrait et notre programme se compose donc de quatre commandes :
Code Dst Src Off  Imm
b7   0   0   0000 01000000
15   0   1   0100 00000000
b7   0   0   0000 02000000
95   0   0   0000 00000000
Les codes des instructions sont égaux b7, 15, b7 et 95. Rappelons que les trois bits les moins significatifs représentent la classe d'instruction. Dans notre cas, le quatrième bit est vide pour toutes les instructions, donc les classes d'instructions sont égales, respectivement, 7, 5, 7, 5. La classe 7 est BPF_ALU64, et 5 est BPF_JMP. Pour les deux classes, le format de l'instruction est identique (voir ci-dessus) et nous pouvons réécrire notre programme ainsi (en réécrivant les autres colonnes de manière compréhensible) :
Op S  Class   Dst Src Off  Imm
b  0  ALU64   0   0   0    1
1  0  JMP     0   1   1    0
b  0  ALU64   0   0   0    2
9  0  JMP     0   0   0    0
Opération b classe ALU64 — ce sont des . Elle assigne une valeur au registre de destination. Si le bit s (source) est défini, alors la valeur vient du registre source, et si, comme dans notre cas, il n'est pas défini, la valeur provient du champ Imm. Ainsi, dans les premières et troisièmes instructions, nous effectuons l'opération r0 = Imm. Ensuite, l'opération 1 de la classe JMP est (sauter si égal). Dans notre cas, comme le bit S est égal à zéro, elle compare la valeur du registre source au champ Imm. Si les valeurs coïncident, le saut se produit vers PC + Off, où PC, qui contient l'adresse de la prochaine instruction. Enfin, l'opération 9 de la classe JMP est . Cette instruction termine l'exécution du programme, retournant au noyau r0. Ajoutons une nouvelle colonne à notre tableau :
Op    S  Class   Dst Src Off  Imm    Disassm
MOV   0  ALU64   0   0   0    1      r0 = 1
JEQ   0  JMP     0   1   1    0      if (r1 == 0) goto pc+1
MOV   0  ALU64   0   0   0    2      r0 = 2
EXIT  0  JMP     0   0   0    0      exit
Nous pouvons réécrire cela d'une manière plus pratique :
     r0 = 1
     if (r1 == 0) goto END
     r0 = 2
END:
     exit
Si nous nous rappelons que dans le registre r1 un pointeur vers le contexte est passé par le noyau, et dans le registre r0 la valeur est retournée au noyau, nous pouvons voir que si le pointeur vers le contexte est nul, nous retournons 1, sinon 2. Vérifions que nous avons raison en regardant le code source :
$ cat readelf-example.c
int foo(void *ctx)
{
        return ctx ? 2 : 1;
}
Oui, c'est un programme absurde, mais il se compile en seulement quatre instructions simples.
Exemple-exclusion : instruction de 16 octets
Nous avons déjà mentionné que certaines instructions prennent plus de 64 bits. Cela s'applique, par exemple, à l'instruction lddw (Code = 0x18 = | | ) — charger un double mot dans le registre à partir des champs Imm. Le fait est que Imm a une taille de 32 bits, et un mot double représente 64 bits, il n'est donc pas possible de charger une valeur immédiate de 64 bits dans un registre avec une seule instruction de 64 bits. Pour cela, deux instructions consécutives sont utilisées pour stocker la seconde partie de la valeur de 64 bits dans le champ Imm. Exemple :
$ cat x64.c
long foo(void *ctx)
{
        return 0x11223344aabbccdd;
}
$ clang -target bpf -c x64.c -o x64.o -O2
$ llvm-readelf -x .text x64.o
Heure hexadécimale de la section '.text':
0x00000000 18000000 ddccbbaa 00000000 44332211 ............D3".
0x00000010 95000000 00000000                   ........
Dans le programme binaire, il n'y a que deux instructions :
Binaire                                 Désassemblage
18000000 ddccbbaa 00000000 44332211    r0 = Imm[0]|Imm[1]
95000000 00000000                      exit
Nous rencontrerons encore l'instruction lddw, lorsque nous parlerons des relocalisations et de la gestion des maps.
Exemple : désassemblons le BPF avec des outils standards
Ainsi, nous avons appris à lire les codes binaires BPF et sommes prêts à analyser n'importe quelle instruction si nécessaire. Cependant, il convient de noter qu'en pratique, il est plus pratique et rapide de désassembler des programmes à l'aide d'outils standards, par exemple :
$ llvm-objdump -d x64.o

Désassemblage de la section .text :

0000000000000000 <foo>:
 0: 18 00 00 00 dd cc bb aa 00 00 00 00 44 33 22 11 r0 = 1234605617868164317 ll
 2: 95 00 00 00 00 00 00 00 exit
Cycle de vie des objets BPF, système de fichiers bpffs
(Certains détails décrits dans cette sous-section, je les ai appris pour la première fois de Alexei Starovoitov dans .)
Les objets BPF — programmes et maps — sont créés à partir de l'espace utilisateur à l'aide des commandes BPF_PROG_LOAD et BPF_MAP_CREATE de l'appel système bpf(2), nous parlerons de la manière dont cela se produit dans la prochaine section. À ce stade, les structures de données du noyau sont créées et pour chacune d'elles refcount compteur de références) est initialisé à un et un descripteur de fichier est renvoyé à l'utilisateur, pointant vers l'objet. Après la fermeture du descripteur refcount de l'objet est réduit d'un et lorsqu'il atteint zéro, l'objet est détruit.
Si le programme utilise des maps, alors refcount le nombre de ces maps est augmenté d'un après le chargement du programme, c'est-à-dire que leurs descripteurs de fichiers peuvent être fermés à partir du processus utilisateur sans que refcount n'atteigne zéro :
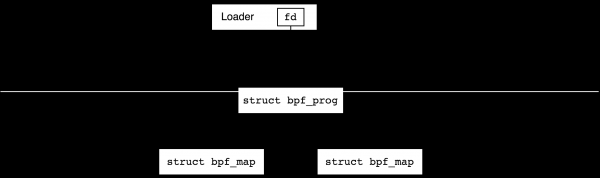
Après un chargement réussi du programme, nous l'attachons généralement à un générateur d'événements. Par exemple, nous pouvons le connecter à une interface réseau pour traiter les paquets entrants ou le relier à un tracepoint dans le noyau. À ce moment-là, le compteur de références augmentera également d'un et nous pourrons fermer le descripteur de fichier dans le programme de chargement.
Que se passera-t-il si nous terminons maintenant le travail du chargeur ? Cela dépend du type de générateur d'événements (hook). Tous les hooks réseau existeront après la fin du chargeur, ce sont ce que l'on appelle des hooks globaux. Par exemple, les programmes de traçage seront libérés après la fin du processus qui les a créés (et c'est pourquoi on les appelle locaux, de « local to the process »). Techniquement, les hooks locaux ont toujours un descripteur de fichier correspondant dans l'espace utilisateur et sont donc fermés avec la fermeture du processus, alors que les globaux ne le sont pas. Dans l'illustration suivante, j'essaie de montrer avec des croix rouges comment la fin du programme du chargeur influence la durée de vie des objets en cas de hooks locaux et globaux.
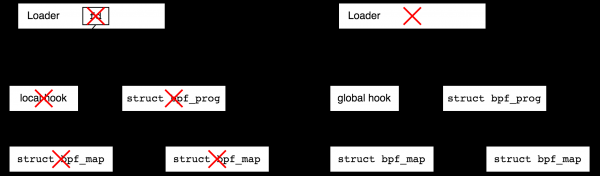
Pourquoi existe-t-il une distinction entre hooks locaux et globaux ? Le lancement de certains types de programmes réseau a du sens même sans userspace. Par exemple, imaginez une protection contre le DDoS : le chargeur définit des règles et connecte un programme BPF à l'interface réseau, après quoi le chargeur peut se terminer. D'autre part, imaginez un programme de traçage de débogage que vous avez écrit à la va-vite en dix minutes : après sa fin, vous voudriez que le système ne conserve pas de déchets, et les hooks locaux garantissent cela.
D'un autre côté, imaginez que vous souhaitiez vous connecter à un point de trace (tracepoint) dans le noyau et collecter des statistiques pendant de nombreuses années. Dans ce cas, vous souhaiteriez terminer la partie utilisateur et revenir aux statistiques de temps à autre. Cette possibilité est offerte par le système de fichiers bpf. C'est un système de fichiers pseudo qui n'existe qu'en mémoire, permettant de créer des fichiers faisant référence à des objets BPF et, ce faisant, augmentant refcount le nombre d'objets. Après cela, le chargeur peut se terminer, tandis que les objets qu'il a créés resteront actifs.
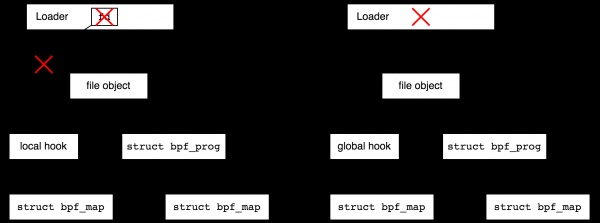
La création de fichiers dans bpffs, qui font référence à des objets BPF est appelée « ancrage » (« pin », comme dans la phrase suivante : « le processus peut ancrer un programme ou une carte BPF »). Créer des objets de fichiers pour des objets BPF a du sens non seulement pour prolonger la vie des objets locaux, mais aussi pour la commodité d'utilisation des objets globaux — revenant à l'exemple d'un programme global de protection contre le DDoS, nous voulons avoir la possibilité de revenir de temps en temps et de consulter les statistiques.
Le système de fichiers BPF est généralement monté dans /sys/fs/bpf, mais il peut aussi être monté localement, par exemple comme suit :
$ mkdir bpf-mountpoint
$ sudo mount -t bpf none bpf-mountpoint
Les noms dans le système de fichiers sont créés à l'aide de la commande BPF_OBJ_PIN d'appel du système BPF. À titre d'illustration, prenons un programme, compilons-le, chargeons-le et fixons-le dans bpffs. Notre programme ne fait rien d'utile, nous n'incluons son code que pour vous permettre de reproduire l'exemple :
$ cat test.c
__attribute__((section("xdp"), used))
int test(void *ctx)
{
        return 0;
}

char _license[] __attribute__((section("license"), used)) = "GPL";
Compilons ce programme et créons une copie locale du système de fichiers bpffs:
$ clang -target bpf -c test.c -o test.o
$ mkdir bpf-mountpoint
$ sudo mount -t bpf none bpf-mountpoint
Maintenant, chargeons notre programme à l'aide de l'utilitaire bpftool et observons les appels système associés bpf(2) (certaines lignes non pertinentes ont été supprimées de la sortie de strace) :
$ sudo strace -e bpf bpftool prog load .\/test.o bpf-mountpoint\/test
bpf(BPF_PROG_LOAD, {prog_type=BPF_PROG_TYPE_XDP, prog_name="test", ...}, 120) = 3
bpf(BPF_OBJ_PIN, {pathname="bpf-mountpoint\/test", bpf_fd=3}, 120) = 0
Ici, nous avons chargé le programme à l'aide de BPF_PROG_LOAD, avons reçu un descripteur de fichier du noyau 3 et à l'aide de la commande BPF_OBJ_PIN nous avons fixé ce descripteur de fichier sous la forme d'un fichier "bpf-mountpoint\/test". Après cela, le programme chargeur bpftool a terminé son travail, mais notre programme est resté dans le noyau, même si nous ne l'avons pas attaché à une interface réseau :
$ sudo bpftool prog | tail -3
783: xdp  name test  tag 5c8ba0cf164cb46c  gpl
        loaded_at 2020-05-05T13:27:08+0000  uid 0
        xlated 24B  jited 41B  memlock 4096B
Nous pouvons supprimer l'objet de fichier avec une simple unlink(2) et après cela, le programme correspondant sera supprimé :
$ sudo rm .\/bpf-mountpoint\/test
$ sudo bpftool prog show id 783
Error: get by id (783): No such file or directory
Suppression des objets
En parlant de la suppression des objets, il convient de préciser qu'après avoir détaché le programme du hook (générateur d'événements), aucun nouvel événement ne déclenchera son exécution, cependant, toutes les instances en cours du programme seront terminées correctement.
Certaines types de programmes BPF permettent de remplacer le programme à la volée, c'est-à-dire qu'ils fournissent l'atomicité de la séquence replace = détacher l'ancien programme, attacher le nouveau programme. Dans ce cas, toutes les instances actives de l'ancienne version du programme termineront leur exécution, et de nouveaux gestionnaires d'événements seront créés à partir du nouveau programme, l'« atomicité » signifie ici qu'aucun événement ne sera omis.
Connexion des programmes aux sources d'événements
Dans cet article, nous ne décrirons pas séparément la connexion des programmes aux sources d'événements, car cela a du sens d'étudier dans le contexte d'un type de programme spécifique. Voir ci-dessous, où nous montrons comment les programmes de type XDP sont connectés.
Gestion des objets par l'appel système bpf
Programmes BPF
Tous les objets BPF sont créés et gérés depuis l'espace utilisateur par l'appel système bpf, qui a le prototype suivant :
#include <linux/bpf.h>

int bpf(int cmd, union bpf_attr *attr, unsigned int size);
Ici, la commande cmd est l'une des valeurs de type , attr — un pointeur vers les paramètres pour un programme spécifique et taille — la taille de l'objet pointé, c'est-à-dire généralement sizeof(*attr). Dans le noyau 5.8, l'appel système bpf supporte 34 commandes différentes, et union bpf_attr occupera 200 lignes. Mais cela ne doit pas nous effrayer, car nous allons nous familiariser avec les commandes et les paramètres au cours de plusieurs articles.
Nous commencerons par la commande BPF_PROG_LOAD, qui crée des programmes BPF — prend un ensemble d'instructions BPF et le charge dans le noyau. Au moment du chargement, le vérificateur est lancé, puis le compilateur JIT et, après une exécution réussie, un descripteur de fichier du programme est retourné à l'utilisateur. Nous avons vu ce qui se passe ensuite dans la section précédente .
Maintenant, nous allons écrire un programme utilisateur qui chargera un programme BPF simple, mais d'abord, nous devons décider quel type de programme nous voulons charger — nous devrons choisir et dans le cadre de ce type, écrire un programme qui réussira la vérification par le vérificateur. Cependant, pour ne pas compliquer le processus, voici une solution prête à l'emploi : nous allons prendre un programme de type BPF_PROG_TYPE_XDP, qui retournera la valeur XDP_PASS (passer tous les paquets). En assembleur BPF, cela semble très simple :
r0 = 2
exit
Après avoir déterminé ce que ce que nous allons charger, nous pouvons expliquer comment nous allons le faire :
#define _GNU_SOURCE
#include <string.h>
#include <unistd.h>
#include <sys/syscall.h>
#include <linux/bpf.h>

static inline __u64 ptr_to_u64(const void *ptr)
{
        return (__u64) (unsigned long) ptr;
}

int main(void)
{
    struct bpf_insn insns[] = {
        {
            .code = BPF_ALU64 | BPF_MOV | BPF_K,
            .dst_reg = BPF_REG_0,
            .imm = XDP_PASS
        },
        {
            .code = BPF_JMP | BPF_EXIT
        },
    };

    union bpf_attr attr = {
        .prog_type = BPF_PROG_TYPE_XDP,
        .insns     = ptr_to_u64(insns),
        .insn_cnt  = sizeof(insns)/sizeof(insns[0]),
        .license   = ptr_to_u64("GPL"),
    };

    strncpy(attr.prog_name, "woo", sizeof(attr.prog_name));
    syscall(__NR_bpf, BPF_PROG_LOAD, &attr, sizeof(attr));

    for ( ;; )
        pause();
}
Les événements intéressants dans le programme commencent par la définition du tableau insns — notre programme BPF en code machine. Chaque instruction du programme BPF est encapsulée dans une structure . Le premier élément insns correspond à l'instruction r0 = 2, l'autre — exit.
En bref. Dans le noyau, des macros plus pratiques sont définies pour écrire du code machine, et en utilisant le fichier d'en-tête du noyau tools/include/linux/filter.h nous pourrions écrire
struct bpf_insn insns[] = {
    BPF_MOV64_IMM(BPF_REG_0, XDP_PASS),
    BPF_EXIT_INSN()
};
Cependant, comme l'écriture de programmes BPF en codes machine est nécessaire uniquement pour les tests dans le noyau et les articles sur BPF, l'absence de ces macros ne complique en réalité pas la vie des développeurs.
Après avoir défini le programme BPF, nous passons à son chargement dans le noyau. Notre ensemble minimaliste de paramètres attr comprend le type de programme, le nombre et l'ensemble d'instructions, la licence obligatoire, ainsi que le nom "woo", que nous utilisons pour retrouver notre programme dans le système après son chargement. Le programme, comme promis, est chargé dans le système via un appel système bpf.
À la fin du programme, nous entrons dans une boucle infinie qui simule la charge utile. Sans cela, le programme serait détruit par le noyau lors de la fermeture du descripteur de fichier retourné par l'appel système bpf, et nous ne le verrions pas dans le système.
Eh bien, nous sommes prêts pour les tests. Construisons et exécutons le programme sous strace, pour vérifier que tout fonctionne comme prévu :
$ clang -g -O2 simple-prog.c -o simple-prog

$ sudo strace .\/simple-prog
execve(".\/simple-prog", [".\/simple-prog"], 0x7ffc7b553480 /* 13 vars */) = 0
...
bpf(BPF_PROG_LOAD, {prog_type=BPF_PROG_TYPE_XDP, insn_cnt=2, insns=0x7ffe03c4ed50, license="GPL", log_level=0, log_size=0, log_buf=NULL, kern_version=KERNEL_VERSION(0, 0, 0), prog_flags=0, prog_name="woo", prog_ifindex=0, expected_attach_type=BPF_CGROUP_INET_INGRESS}, 72) = 3
pause(
Tout va bien, bpf(2) nous a retourné le descripteur 3 et nous sommes entrés dans une boucle infinie avec pause(). Essayons de retrouver notre programme dans le système. Pour cela, nous allons dans un autre terminal et utilisons l'outil bpftool:
# bpftool prog | grep -A3 woo
390: xdp  name woo  tag 3b185187f1855c4c  gpl
        loaded_at 2020-08-31T24:66:44+0000  uid 0
        xlated 16B  jited 40B  memlock 4096B
        pids simple-prog(10381)
Nous voyons qu'il y a un programme chargé dans le système woo dont l'ID global est 390, et qu'il y a actuellement un descripteur de fichier ouvert dans le processus simple-prog pointant vers le programme (et si simple-prog il se termine, alors woo il disparaîtra). Comme prévu, le programme woo occupe 16 octets — deux instructions — de codes binaires en architecture BPF, mais sous forme native (x86_64), cela représente déjà 40 octets. Regardons notre programme dans sa forme originale :
# bpftool prog dump xlated id 390
   0: (b7) r0 = 2
   1: (95) exit
sans surprises. Maintenant, regardons le code généré par le compilateur JIT :
# bpftool prog dump jited id 390
bpf_prog_3b185187f1855c4c_woo:
   0:   nopl   0x0(%rax,%rax,1)
   5:   push   %rbp
   6:   mov    %rsp,%rbp
   9:   sub    $0x0,%rsp
  10:   push   %rbx
  11:   push   %r13
  13:   push   %r14
  15:   push   %r15
  17:   pushq  $0x0
  19:   mov    $0x2,%eax
  1e:   pop    %rbx
  1f:   pop    %r15
  21:   pop    %r14
  23:   pop    %r13
  25:   pop    %rbx
  26:   leaveq
  27:   retq
pas très efficace pour exit(2), mais pour être juste, notre programme est trop simple, et pour des programmes non triviales, le prologue et l'épilogue ajoutés par le compilateur JIT sont bien sûr nécessaires.
Maps
Les programmes BPF peuvent utiliser des zones de mémoire structurées, accessibles à d'autres programmes BPF ainsi qu'aux programmes de l'espace utilisateur. Ces objets sont appelés maps et dans cette section, nous montrerons comment les gérer à l'aide d'appels système. bpf.
Il convient de dire dès le départ que les capacités des maps ne se limitent pas seulement à l'accès à la mémoire partagée. Il existe des maps spécialisées, contenant par exemple des pointeurs vers des programmes BPF ou des pointeurs vers des interfaces réseau, des maps pour travailler avec des événements de performance, etc. Nous ne parlerons pas de cela ici pour ne pas embrouiller le lecteur. De plus, nous ignorons les problèmes de synchronisation, car cela n'est pas pertinent pour nos exemples. Une liste complète des types de maps disponibles peut être trouvée dans , et dans cette section, nous prendrons comme exemple le tout premier type, une table de hachage. BPF_MAP_TYPE_HASH.
Si vous créez une table de hachage, disons en C++, vous direz unordered_map woo, ce qui signifie en français « j'ai besoin d'une table woo de taille illimitée, dont les clés ont le type int, et les valeurs le type long». Pour créer une table de hachage BPF, nous devons faire à peu près la même chose, en précisant que nous devons indiquer la taille maximale de la table, et à la place des types de clés et de valeurs, nous devons spécifier leurs tailles en octets. La commande utilisée pour créer des maps est BPF_MAP_CREATE de l'appel système bpf. Jetons un œil à un programme plus ou moins minimal qui crée une map. Après le programme précédent qui charge des programmes BPF, celui-ci devrait vous sembler simple :
$ cat simple-map.c
#define _GNU_SOURCE
#include
#include
#include
#include

int main(void)
{
    union bpf_attr attr = {
        .map_type = BPF_MAP_TYPE_HASH,
        .key_size = sizeof(int),
        .value_size = sizeof(int),
        .max_entries = 4,
    };
    strncpy(attr.map_name, "woo", sizeof(attr.map_name));
    syscall(__NR_bpf, BPF_MAP_CREATE, &attr, sizeof(attr));

    for (;;)
        pause();
}
Ici, nous définissons un ensemble de paramètres attr, dans lequel nous disons « j'ai besoin d'une table de hachage avec des clés et des valeurs de taille sizeof(int), dans laquelle je peux mettre un maximum de quatre éléments ». Lors de la création de maps BPF, d'autres paramètres peuvent également être spécifiés, par exemple, tout comme dans l'exemple avec le programme, nous avons spécifié le nom de l'objet comme "woo".
Nous allons compiler et exécuter le programme :
$ clang -g -O2 simple-map.c -o simple-map
$ sudo strace ./simple-map
execve("./simple-map", ["./simple-map"], 0x7ffd40a27070 /* 14 vars */) = 0
...
bpf(BPF_MAP_CREATE, {map_type=BPF_MAP_TYPE_HASH, key_size=4, value_size=4, max_entries=4, map_name="woo", ...}, 72) = 3
pause(
Ici, l'appel système bpf(2) nous a renvoyé le descripteur de la carte numéro 3 et ensuite, le programme, comme prévu, attend d'autres instructions dans l'appel système pause(2).
Nous allons maintenant envoyer notre programme en arrière-plan ou ouvrir un autre terminal et examiner notre objet à l'aide de l'utilitaire bpftool (nous pouvons distinguer notre carte des autres par son nom) :
$ sudo bpftool map
...
114: hash  nom woo  flags 0x0
        clé 4B  valeur 4B  max_entries 4  memlock 4096B
...
Le nombre 114 est l'ID global de notre objet. Tout programme dans le système peut utiliser cet ID pour ouvrir une carte existante en utilisant la commande BPF_MAP_GET_FD_BY_ID de l'appel système bpf.
Nous pouvons maintenant jouer avec notre table de hachage. Regardons son contenu :
$ sudo bpftool map dump id 114
Aucun élément trouvé
Vide. Mettons-y une valeur hash[1] = 1:
$ sudo bpftool map update id 114 key 1 0 0 0 value 1 0 0 0Regardons la table encore une fois :
$ sudo bpftool map dump id 114
clé : 01 00 00 00  valeur : 01 00 00 00
Élément trouvé : 1
Hourra ! Nous avons réussi à ajouter un élément. Notez que pour cela, nous devons travailler au niveau des octets, car bptftool ne sait pas quel type ont les valeurs dans la table de hachage. (On peut lui transmettre cette connaissance en utilisant BTF, mais ce n'est pas le sujet ici.)
Comment exactement bpftool lit et ajoute des éléments ? Jetons un œil sous le capot :
$ sudo strace -e bpf bpftool map dump id 114
bpf(BPF_MAP_GET_FD_BY_ID, {map_id=114, next_id=0, open_flags=0}, 120) = 3
bpf(BPF_MAP_GET_NEXT_KEY, {map_fd=3, key=NULL, next_key=0x55856ab65280}, 120) = 0
bpf(BPF_MAP_LOOKUP_ELEM, {map_fd=3, key=0x55856ab65280, value=0x55856ab652a0}, 120) = 0
clé : 01 00 00 00  valeur : 01 00 00 00
bpf(BPF_MAP_GET_NEXT_KEY, {map_fd=3, key=0x55856ab65280, next_key=0x55856ab65280}, 120) = -1 ENOENT
D'abord, nous avons ouvert la carte par son ID global à l'aide de la commande BPF_MAP_GET_FD_BY_ID et bpf(2) nous a renvoyé le descripteur 3. Ensuite, avec la commande BPF_MAP_GET_NEXT_KEY nous avons trouvé la première clé de la table, en passant NULL comme pointeur vers la « clé précédente ». En présence d'une clé, nous pouvons faire BPF_MAP_LOOKUP_ELEM, qui renvoie la valeur dans le pointeur value. L'étape suivante consiste à essayer de trouver l'élément suivant, en passant le pointeur à la clé actuelle, mais notre table ne contient qu'un seul élément et la commande BPF_MAP_GET_NEXT_KEY retourne ENOENT.
Bien, changeons la valeur pour la clé 1, disons que notre logique métier nécessite d'écrire hash[1] = 2:
$ sudo strace -e bpf bpftool map update id 114 key 1 0 0 0 value 2 0 0 0
bpf(BPF_MAP_GET_FD_BY_ID, {map_id=114, next_id=0, open_flags=0}, 120) = 3
bpf(BPF_MAP_UPDATE_ELEM, {map_fd=3, key=0x55dcd72be260, value=0x55dcd72be280, flags=BPF_ANY}, 120) = 0
Comme prévu, c'est très simple : la commande BPF_MAP_GET_FD_BY_ID ouvre notre carte par ID, et la commande BPF_MAP_UPDATE_ELEM écrase l'élément.
En résumé, après avoir créé une table de hachage à partir d'un programme, nous pouvons lire et écrire son contenu depuis un autre. Notez que si nous avons pu le faire depuis la ligne de commande, alors n'importe quel autre programme dans le système peut également le faire. En plus des commandes décrites ci-dessus, pour travailler avec des mappages depuis l'espace utilisateur, il existe :
BPF_MAP_LOOKUP_ELEM: trouver une valeur par cléBPF_MAP_UPDATE_ELEM: mettre à jour/créer une valeurBPF_MAP_DELETE_ELEM: supprimer une cléBPF_MAP_GET_NEXT_KEY: trouver la clé suivante (ou la première)BPF_MAP_GET_NEXT_ID: permet de parcourir tous les mappages existants, c'est ainsi que fonctionnebpftool mapBPF_MAP_GET_FD_BY_ID: ouvrir un mappage existant par son ID globalBPF_MAP_LOOKUP_AND_DELETE_ELEM: mettre à jour atomiquement la valeur d'un objet et renvoyer l'ancienneBPF_MAP_FREEZE: rendre le mappage immuable depuis l'espace utilisateur (cette opération ne peut pas être annulée)BPF_MAP_LOOKUP_BATCH,BPF_MAP_LOOKUP_AND_DELETE_BATCH,BPF_MAP_UPDATE_BATCH,BPF_MAP_DELETE_BATCH: opérations en masse. Par exemple,BPF_MAP_LOOKUP_AND_DELETE_BATCH— c'est le seul moyen fiable de lire et de réinitialiser toutes les valeurs d'un mappage
Toutes ces commandes ne fonctionnent pas pour tous les types de mappages, mais en général, travailler avec d'autres types de mappages depuis l'espace utilisateur ressemble exactement à travailler avec des tables de hachage.
Pour terminer, complétons nos expériences avec la table de hachage. Rappelez-vous que nous avons créé une table pouvant contenir jusqu'à quatre clés ? Ajoutons quelques éléments supplémentaires :
$ sudo bpftool map update id 114 key 2 0 0 0 value 1 0 0 0
$ sudo bpftool map update id 114 key 3 0 0 0 value 1 0 0 0
$ sudo bpftool map update id 114 key 4 0 0 0 value 1 0 0 0
Tout va bien jusqu'à présent :
$ sudo bpftool map dump id 114
key: 01 00 00 00  value: 01 00 00 00
key: 02 00 00 00  value: 01 00 00 00
key: 04 00 00 00  value: 01 00 00 00
key: 03 00 00 00  value: 01 00 00 00
Trouvé 4 éléments
Essayons d'en ajouter un autre :
$ sudo bpftool map update id 114 key 5 0 0 0 value 1 0 0 0
Erreur : mise à jour échouée : liste des arguments trop longue
Comme prévu, cela n'a pas fonctionné. Examinons l'erreur de plus près :
$ sudo strace -e bpf bpftool map update id 114 key 5 0 0 0 value 1 0 0 0
bpf(BPF_MAP_GET_FD_BY_ID, {map_id=114, next_id=0, open_flags=0}, 120) = 3
bpf(BPF_OBJ_GET_INFO_BY_FD, {info={bpf_fd=3, info_len=80, info=0x7ffe6c626da0}}, 120) = 0
bpf(BPF_MAP_UPDATE_ELEM, {map_fd=3, key=0x56049ded5260, value=0x56049ded5280, flags=BPF_ANY}, 120) = -1 E2BIG (liste des arguments trop longue)
Erreur : mise à jour échouée : liste des arguments trop longue
+++ quitté avec 255 +++
Tout va bien : comme prévu, la commande BPF_MAP_UPDATE_ELEM essaie de créer une nouvelle clé, la cinquième, mais échoue avec E2BIG.
Ainsi, nous savons créer et charger des programmes BPF, ainsi que créer et gérer des maps depuis l'espace utilisateur. Il est maintenant logique de voir comment nous pouvons utiliser les maps depuis les programmes BPF eux-mêmes. Nous pourrions en parler dans un langage difficile à lire de programmes en codes machines-macro, mais il est vraiment temps de montrer comment les programmes BPF sont réellement écrits et entretenus — par l'intermédiaire de libbpf.
(Pour les lecteurs mécontents du manque d'un exemple bas niveau : nous allons détailler des programmes utilisant des maps et des fonctions auxiliaires, créées à l'aide de libbpf et expliquer ce qui se passe au niveau des instructions. Pour les lecteurs qui se disent très insatisfaits, nous avons ajouté à l'endroit approprié dans l'article.)
Écriture de programmes BPF avec libbpf
Écrire des programmes BPF en utilisant des codes machines peut être intéressant seulement un temps, après quoi vient la saturation. À ce moment-là, il faut porter son regard sur llvm, qui a un backend pour générer du code pour l'architecture BPF, ainsi que sur la bibliothèque libbpf, qui permet d'écrire la partie utilisateur des applications BPF et de charger le code des programmes BPF générés à l'aide de llvm/clang.
En réalité, comme nous le verrons dans cet article et les suivants, libbpf fait beaucoup de travail et sans elle (ou des outils similaires — iproute2, libbcc, libbpf-go, etc.) il est impossible de vivre. L'une des fonctionnalités killer du projet libbpf est BPF CO-RE (Compile Once, Run Everywhere) — un projet qui permet d'écrire des programmes BPF, portables d'un noyau à l'autre, avec la capacité de fonctionner sur différentes API (par exemple, lorsque la structure du noyau change d'une version à l'autre). Pour pouvoir travailler avec CO-RE, votre noyau doit être compilé avec le support BTF (comment le faire est expliqué dans la section . Vérifier si votre noyau est compilé avec BTF ou non est très simple — par la présence du fichier suivant :
$ ls -lh /sys/kernel/btf/vmlinux
-r--r--r-- 1 root root 2.6M Jul 29 15:30 /sys/kernel/btf/vmlinux
Ce fichier contient des informations sur tous les types de données utilisés dans le noyau et est utilisé dans tous nos exemples utilisant libbpf. Nous allons parler en détail de CO-RE dans le prochain article, et dans celui-ci — construisez simplement votre noyau avec CONFIG_DEBUG_INFO_BTF.
Bibliothèque libbpf qui se trouve directement dans le répertoire tools/lib/bpf du noyau et son développement se fait via la liste de diffusion bpf@vger.kernel.org. Cependant, pour les applications fonctionnant en dehors du noyau, un dépôt séparé est pris en charge. dans lequel la bibliothèque du noyau est réfléchie pour un accès en lecture plus ou moins tel quel.
Dans cette section, nous allons examiner comment créer un projet utilisant libbpf, écrire quelques programmes tests (plus ou moins sans signification) et analyser en détail comment tout cela fonctionne. Cela nous permettra d'expliquer plus facilement dans les sections suivantes comment les programmes BPF interagissent avec les maps, les helpers du noyau, BTF, etc.
Habituellement, les projets utilisant libbpf ajoutent un dépôt GitHub comme sous-module Git, faisons-le également :
$ mkdir /tmp/libbpf-example
$ cd /tmp/libbpf-example/
$ git init-db
Dépôt Git vide initialisé dans /tmp/libbpf-example/.git/
$ git submodule add https://github.com/libbpf/libbpf.git
Clonage dans '/tmp/libbpf-example/libbpf'...
remote: Énumération des objets : 200, fait.
remote: Comptage des objets : 100 % (200/200), fait.
remote: Compression des objets : 100 % (103/103), fait.
remote: Total 3354 (delta 101), réutilisé 118 (delta 79), pack-réutilisé 3154
Réception des objets : 100 % (3354/3354), 2.05 MiB | 10.22 MiB/s, fait.
Résolution des deltas : 100 % (2176/2176), fait.
La compilation libbpf est très simple :
$ cd libbpf/src
$ mkdir build
$ OBJDIR=build DESTDIR=root make -s install
$ find root
root
root/usr
root/usr/include
root/usr/include/bpf
root/usr/include/bpf/bpf_tracing.h
root/usr/include/bpf/xsk.h
root/usr/include/bpf/libbpf_common.h
root/usr/include/bpf/bpf_endian.h
root/usr/include/bpf/bpf_helpers.h
root/usr/include/bpf/btf.h
root/usr/include/bpf/bpf_helper_defs.h
root/usr/include/bpf/bpf.h
root/usr/include/bpf/libbpf_util.h
root/usr/include/bpf/libbpf.h
root/usr/include/bpf/bpf_core_read.h
root/usr/lib64
root/usr/lib64/libbpf.so.0.1.0
root/usr/lib64/libbpf.so.0
root/usr/lib64/libbpf.a
root/usr/lib64/libbpf.so
root/usr/lib64/pkgconfig
root/usr/lib64/pkgconfig/libbpf.pc
Notre plan pour cette section est le suivant : nous allons écrire un programme BPF de type BPF_PROG_TYPE_XDP, le même que dans l'exemple précédent, mais en C, le compiler à l'aide de clang, et écrire un programme d'assistance qui le chargera dans le noyau. Dans les sections suivantes, nous allons étendre les fonctionnalités du programme BPF ainsi que celles du programme d'assistance.
Exemple : créons une application complète à l'aide de libbpf
Pour commencer, nous allons utiliser le fichier /sys/kernel/btf/vmlinux, mentionné ci-dessus, et créer son équivalent sous forme de fichier d'en-tête :
$ bpftool btf dump file /sys/kernel/btf/vmlinux format c > vmlinux.hCe fichier contiendra toutes les structures de données présentes dans notre noyau, par exemple, c'est ainsi que l'en-tête IPv4 est défini dans le noyau :
$ grep -A 12 'struct iphdr {' vmlinux.h
struct iphdr {
    __u8 ihl: 4;
    __u8 version: 4;
    __u8 tos;
    __be16 tot_len;
    __be16 id;
    __be16 frag_off;
    __u8 ttl;
    __u8 protocol;
    __sum16 check;
    __be32 saddr;
    __be32 daddr;
};
Nous allons maintenant écrire notre programme BPF en langage C :
$ cat xdp-simple.bpf.c
#include "vmlinux.h"
#include

SEC("xdp/simple")
int simple(void *ctx)
{
        return XDP_PASS;
}

char LICENSE[] SEC("license") = "GPL";
Bien que notre programme soit très simple, nous devons néanmoins prêter attention à de nombreux détails. Tout d'abord, le premier fichier d'en-tête que nous incluons est vmlinux.h, que nous venons de générer à l'aide de bpftool btf dump — maintenant, nous n'avons plus besoin d'installer le paquet kernel-headers pour connaître la structure du noyau. Le prochain fichier d'en-tête provient de la bibliothèque libbpf. Actuellement, il est nécessaire uniquement pour définir la macro SEC, qui envoie le symbole dans la section appropriée du fichier objet ELF. Notre programme se trouve dans la section xdp/simple, où avant le slash, nous définissons le type de programme BPF — il s'agit d'une convention utilisée dans libbpf, sur la base du nom de la section, elle insérera le bon type lors de l'exécution bpf(2). Le programme BPF lui-même est C — très simple et consiste en une seule ligne return XDP_PASS. Enfin, une section distincte "license" contient le nom de la licence.
Nous pouvons compiler notre programme à l'aide de llvm/clang, version >= 10.0.0, de préférence supérieure (voir la section ):
$ clang --version
clang version 11.0.0 (https://github.com/llvm/llvm-project.git afc287e0abec710398465ee1f86237513f2b5091)
...

$ clang -O2 -g -c -target bpf -I libbpf/src/root/usr/include xdp-simple.bpf.c -o xdp-simple.bpf.o
Parmi les fonctionnalités intéressantes : nous spécifions l'architecture cible -target bpf et le chemin vers les en-têtes libbpf, que nous avons récemment installés. N'oubliez pas de prendre en compte -O2, sans cette option, des surprises peuvent vous attendre par la suite. Voyons notre code, avons-nous réussi à écrire le programme que nous voulions ?
$ llvm-objdump --section=xdp/simple --no-show-raw-insn -D xdp-simple.bpf.o

xdp-simple.bpf.o:       file format elf64-bpf

Désassemblage de la section xdp/simple :

0000000000000000  :
       0:       r0 = 2
       1:       exit
Oui, c'est fait ! Maintenant, nous avons un fichier binaire avec le programme, et nous voulons créer une application qui le chargera dans le noyau. Pour cela, la bibliothèque libbpf nous propose deux options — utiliser une API de bas niveau ou une API de haut niveau. Nous allons choisir la deuxième option, car nous souhaitons apprendre à écrire, charger et connecter des programmes BPF avec un minimum d'efforts pour les étudier par la suite.
Pour commencer, nous devons générer le « squelette » de notre programme à partir de son binaire à l'aide de l'outil susmentionné bpftool — du couteau suisse du monde BPF (ce qui peut être compris littéralement, car Daniel Borkman — l'un des créateurs et mainteneurs de BPF — est suisse) :
$ bpftool gen skeleton xdp-simple.bpf.o > xdp-simple.skel.hDans le fichier xdp-simple.skel.h contient le code binaire de notre programme et des fonctions pour le gérer — charger, joindre, supprimer notre objet. Dans notre cas simple, cela peut sembler excessif, mais cela fonctionne même lorsque le fichier objet contient de nombreux programmes BPF et maps, et pour charger ce gigantesque ELF, il nous suffit de générer un squelette et d'appeler une ou deux fonctions depuis l'application utilisateur, à l'écriture de laquelle nous allons maintenant passer.
En fait, notre programme de chargement est trivial :
#include <err.h>
#include <unistd.h>
#include "xdp-simple.skel.h"

int main(int argc, char **argv)
{
    struct xdp_simple_bpf *obj;

    obj = xdp_simple_bpf__open_and_load();
    if (!obj)
        err(1, "failed to open and/or load BPF objectn");

    pause();

    xdp_simple_bpf__destroy(obj);
}
Ici struct xdp_simple_bpf est défini dans le fichier xdp-simple.skel.h et décrit notre fichier objet :
struct xdp_simple_bpf {
    struct bpf_object_skeleton *skeleton;
    struct bpf_object *obj;
    struct {
        struct bpf_program *simple;
    } progs;
    struct {
        struct bpf_link *simple;
    } links;
};
Nous pouvons y apercevoir des traces de l'API bas niveau : la structure struct bpf_program *simple et struct bpf_link *simple. La première structure décrit spécifiquement notre programme, inscrit dans la section xdp/simple, tandis que la seconde décrit comment le programme se connecte à la source d'événements.
Fonction xdp_simple_bpf__open_and_load, ouvre un objet ELF, l'analyse, crée toutes les structures et sous-structures (en dehors du programme, l'ELF contient aussi d'autres sections — data, readonly data, informations de débogage, licence, etc.), puis le charge dans le noyau via un appel système bpf, ce que nous pouvons vérifier en compilant et en exécutant le programme :
$ clang -O2 -I ./libbpf/src/root/usr/include/ xdp-simple.c -o xdp-simple ./libbpf/src/root/usr/lib64/libbpf.a -lelf -lz

$ sudo strace -e bpf ./xdp-simple
...
bpf(BPF_BTF_LOAD, 0x7ffdb8fd9670, 120)  = 3
bpf(BPF_PROG_LOAD, {prog_type=BPF_PROG_TYPE_XDP, insn_cnt=2, insns=0xdfd580, license="GPL", log_level=0, log_size=0, log_buf=NULL, kern_version=KERNEL_VERSION(5, 8, 0), prog_flags=0, prog_name="simple", prog_ifindex=0, expected_attach_type=0x25 /* BPF_??? */, ...}, 120) = 4
Voyons maintenant notre programme à l'aide de bpftool. Trouvons son ID :
# bpftool p | grep -A4 simple
463: xdp  name simple  tag 3b185187f1855c4c  gpl
        loaded_at 2020-08-01T01:59:49+0000  uid 0
        xlated 16B  jited 40B  memlock 4096B
        btf_id 185
        pids xdp-simple(16498)
et affichons-le (nous utilisons la forme abrégée de la commande bpftool prog dump xlated):
# bpftool p d x id 463
int simple(void *ctx):
; return XDP_PASS;
   0: (b7) r0 = 2
   1: (95) exit
Quelque chose de nouveau ! Le programme a imprimé des morceaux de notre fichier source en C. Cela a été fait par la bibliothèque libbpf, qui a trouvé la section de débogage dans le binaire, l'a compilée en objet BTF, l'a chargée dans le noyau via BPF_BTF_LOAD, puis a passé le descripteur de fichier obtenu lors du chargement du programme avec la commande BPG_PROG_LOAD.
Fonctions du noyau
Les programmes BPF peuvent exécuter des fonctions « externes » — des helpers du noyau. Ces fonctions d'assistance permettent aux programmes BPF d'accéder aux structures du noyau, de gérer des maps et de communiquer avec le « monde réel » — de créer des événements perf, de gérer le matériel (par exemple, rediriger des paquets), etc.
Exemple : bpf_get_smp_processor_id
Dans le cadre de la paradigm « apprentissage par l'exemple », considérons l'une des fonctions d'assistance, bpf_get_smp_processor_id(), dans le fichier kernel/bpf/helpers.c. Elle retourne le numéro du processeur sur lequel le programme BPF qui l'appelle s'exécute. Mais ce qui nous intéresse moins, c'est sa sémantique, que le fait que son implémentation tient en une ligne :
BPF_CALL_0(bpf_get_smp_processor_id)
{
    return smp_processor_id();
}
Les définitions des fonctions d'assistance BPF ressemblent à celles des appels système Linux. Ici, par exemple, on définit une fonction sans arguments. (Une fonction acceptant, disons, trois arguments, est définie à l'aide du macro BPF_CALL_3. Le nombre maximal d'arguments est de cinq.) Cependant, voici seulement la première partie de la définition. La deuxième partie concerne la définition de la structure de type struct bpf_func_proto, qui contient une description de la fonction d'assistance, compréhensible par le vérificateur :
const struct bpf_func_proto bpf_get_smp_processor_id_proto = {
    .func     = bpf_get_smp_processor_id,
    .gpl_only = false,
    .ret_type = RET_INTEGER,
};
Enregistrement des fonctions d'assistance
Pour que les programmes BPF d'un certain type puissent utiliser cette fonction, ils doivent l'enregistrer, par exemple, pour le type BPF_PROG_TYPE_XDP dans le noyau, on définit la fonction xdp_func_proto, qui, selon l'ID de la fonction d'assistance, détermine si XDP prend en charge cette fonction ou non. Notre fonction, elle :
static const struct bpf_func_proto *
xdp_func_proto(enum bpf_func_id func_id, const struct bpf_prog *prog)
{
    switch (func_id) {
    ...
    case BPF_FUNC_get_smp_processor_id:
        return &bpf_get_smp_processor_id_proto;
    ...
    }
}
Les nouveaux types de programmes BPF sont « définis » dans le fichier à l'aide du macro BPF_PROG_TYPE. Défini est mis entre guillemets, car c'est une définition logique, et en termes de langage C, la définition d'un ensemble entier de structures concrètes se fait ailleurs. En particulier, dans le fichier kernel/bpf/verifier.c toutes les définitions du fichier bpf_types.h sont utilisées pour créer un tableau de structures bpf_verifier_ops[]:
static const struct bpf_verifier_ops *const bpf_verifier_ops[] = {
#define BPF_PROG_TYPE(_id, _name, prog_ctx_type, kern_ctx_type)
    [_id] = & _name ## _verifier_ops,
#include <linux/bpf_types.h>
#undef BPF_PROG_TYPE
};
C'est-à-dire que pour chaque type de programme BPF, un pointeur vers une structure de données de type struct bpf_verifier_ops, qui est initialisé avec la valeur _name ## _verifier_ops, c'est-à-dire, xdp_verifier_ops pour xdp. La structure xdp_verifier_ops dans le fichier net/core/filter.c comme suit :
const struct bpf_verifier_ops xdp_verifier_ops = {
    .get_func_proto     = xdp_func_proto,
    .is_valid_access    = xdp_is_valid_access,
    .convert_ctx_access = xdp_convert_ctx_access,
    .gen_prologue       = bpf_noop_prologue,
};
Ici, nous voyons notre fonction familière xdp_func_proto, qui sera exécutée par le vérificateur chaque fois qu'il rencontrera un appel de quelque fonction à l'intérieur du programme BPF, cf. .
Voyons comment un programme BPF hypothétique utilise la fonction bpf_get_smp_processor_id. Pour cela, nous allons réécrire le programme de notre section précédente comme suit :
#include "vmlinux.h"
#include <bpf/bpf_helpers.h>

SEC("xdp/simple")
int simple(void *ctx)
{
    if (bpf_get_smp_processor_id() != 0)
        return XDP_DROP;
    return XDP_PASS;
}

char LICENSE[] SEC("license") = "GPL";
Le symbole bpf_get_smp_processor_id dans <bpf/bpf_helper_defs.h> bibliothèques libbpf comment
static u32 (*bpf_get_smp_processor_id)(void) = (void *) 8;c'est-à-dire, bpf_get_smp_processor_id — c'est un pointeur vers une fonction, dont la valeur est égale à 8, où 8 est la valeur BPF_FUNC_get_smp_processor_id de type enum bpf_fun_id, qui est définie pour nous dans le fichier vmlinux.h (le fichier bpf_helper_defs.h dans le noyau est généré par un script, donc les « nombres magiques » sont ok). Cette fonction ne prend pas d'arguments et retourne une valeur de type __u32. Lorsque nous l'exécutons dans notre programme, clang elle génère une instruction BPF_CALL « d'un type correct ». Compilez le programme et examinons la section xdp/simple:
$ clang -O2 -g -c -target bpf -I libbpf/src/root/usr/include xdp-simple.bpf.c -o xdp-simple.bpf.o
$ llvm-objdump -D --section=xdp/simple xdp-simple.bpf.o

xdp-simple.bpf.o:       format de fichier elf64-bpf

Désassemblage de la section xdp/simple:

0000000000000000 <simple>:
       0:       85 00 00 00 08 00 00 00 call 8
       1:       bf 01 00 00 00 00 00 00 r1 = r0
       2:       67 01 00 00 20 00 00 00 r1 <<= 32
       3:       77 01 00 00 20 00 00 00 r1 >>= 32
       4:       b7 00 00 00 02 00 00 00 r0 = 2
       5:       15 01 01 00 00 00 00 00 if r1 == 0 goto +1 <LBB0_2>
       6:       b7 00 00 00 01 00 00 00 r0 = 1

0000000000000038 <LBB0_2>:
       7:       95 00 00 00 00 00 00 00 exit
Dès la première ligne, nous voyons l'instruction call, paramètre IMM valant 8 et SRC_REG égale à zéro. Selon la convention ABI utilisée par le vérificateur, cela constitue un appel à la fonction d'assistance numéro huit. Après son exécution, la logique est simple. La valeur retournée par le registre r0 est copiée dans r1 et aux lignes 2,3, elle est convertie en type u32 — les 32 bits supérieurs sont remis à zéro. Aux lignes 4,5,6,7, nous retournons 2 (XDP_PASS) ou 1 (XDP_DROP) selon que la fonction d'assistance de la ligne 0 a retourné une valeur nulle ou non nulle.
Vérifions nous-mêmes : chargeons le programme et examinons la sortie. bpftool prog dump xlated:
$ bpftool gen skeleton xdp-simple.bpf.o > xdp-simple.skel.h
$ clang -O2 -g -I ./libbpf/src/root/usr/include/ -o xdp-simple xdp-simple.c ./libbpf/src/root/usr/lib64/libbpf.a -lelf -lz
$ sudo ./xdp-simple &
[2] 10914

$ sudo bpftool p | grep simple
523: xdp name simple tag 44c38a10c657e1b0 gpl
        pids xdp-simple(10915)

$ sudo bpftool p d x id 523
int simple(void *ctx):
; if (bpf_get_smp_processor_id() != 0)
   0: (85) call bpf_get_smp_processor_id#114128
   1: (bf) r1 = r0
   2: (67) r1 <>= 32
   4: (b7) r0 = 2
; }
   5: (15) if r1 == 0x0 goto pc+1
   6: (b7) r0 = 1
   7: (95) exit
Bien, le vérificateur a trouvé le bon kernel-helper.
Exemple : nous passons les arguments et finalement nous lançons le programme !
Toutes les fonctions d'assistance au niveau d'exécution ont un prototype
u64 fn(u64 r1, u64 r2, u64 r3, u64 r4, u64 r5)Les paramètres sont passés aux fonctions d'assistance dans les registres r1—r5, et la valeur est renvoyée dans un registre r0. Il n'y a pas de fonctions prenant plus de cinq arguments et l'ajout de leur support à l'avenir n'est pas prévu.
Voyons comment le nouveau kernel helper fonctionne et comment BPF passe les paramètres. Réécrivons xdp-simple.bpf.c comme suit (les autres lignes n'ont pas été modifiées) :
SEC("xdp/simple")
int simple(void *ctx)
{
    bpf_printk("running on CPU%un", bpf_get_smp_processor_id());
    return XDP_PASS;
}
Notre programme imprime le numéro du CPU sur lequel il est exécuté. Nous allons le compiler et examiner le code :
$ llvm-objdump -D --section=xdp/simple --no-show-raw-insn xdp-simple.bpf.o

0000000000000000 :
       0:       r1 = 10
       1:       *(u16 *)(r10 - 8) = r1
       2:       r1 = 8441246879787806319 ll
       4:       *(u64 *)(r10 - 16) = r1
       5:       r1 = 2334956330918245746 ll
       7:       *(u64 *)(r10 - 24) = r1
       8:       call 8
       9:       r1 = r10
      10:       r1 += -24
      11:       r2 = 18
      12:       r3 = r0
      13:       call 6
      14:       r0 = 2
      15:       exit
Dans les lignes 0-7, nous écrivons sur la pile la chaîne running on CPU%un, puis à la ligne 8, nous lançons le mème connu bpf_get_smp_processor_id. Dans les lignes 9-12, nous préparons les arguments du helper bpf_printk — registres r1, r2, r3. Pourquoi y en a-t-il trois et non deux ? Parce que bpf_printk — autour du véritable helper bpf_trace_printk, qui nécessite de passer la taille de la chaîne formatée.
Ajoutons maintenant quelques lignes à xdp-simple.c, pour que notre programme se connecte à l'interface lo et s'exécute réellement !
$ cat xdp-simple.c
#include
#include
#include
#include "xdp-simple.skel.h"

int main(int argc, char **argv)
{
    __u32 flags = XDP_FLAGS_SKB_MODE;
    struct xdp_simple_bpf *obj;

    obj = xdp_simple_bpf__open_and_load();
    if (!obj)
        err(1, "failed to open and/or load BPF objectn");

    bpf_set_link_xdp_fd(1, -1, flags);
    bpf_set_link_xdp_fd(1, bpf_program__fd(obj->progs.simple), flags);

cleanup:
    xdp_simple_bpf__destroy(obj);
}
Ici, nous utilisons la fonction bpf_set_link_xdp_fd, qui relie les programmes BPF de type XDP aux interfaces réseau. Nous avons codé en dur le numéro de l'interface lo, qui est toujours égal à 1. Nous exécutons la fonction deux fois pour d'abord dissocier l'ancienne application, si elle était connectée. Notez que maintenant nous n'avons pas besoin d'un appel. pause ou une boucle infinie : notre programme de chargement se terminera, mais le programme BPF ne sera pas détruit, car il est connecté à la source d'événements. Après avoir chargé avec succès et connecté, le programme sera exécuté pour chaque paquet réseau entrant sur lo.
Chargeons le programme et observons l'interface. lo:
$ sudo ./xdp-simple
$ sudo bpftool p | grep simple
669: xdp  nom simple  tag 4fca62e77ccb43d6  gpl
$ ip l show dev lo
1: lo:  mtu 65536 xdpgeneric qdisc noqueue état UNKNOWN mode DEFAULT groupe default qlen 1000
    link/loopback 00:00:00:00:00:00 brd 00:00:00:00:00:00
    prog/xdp id 669
Le programme que nous avons chargé a l'ID 669 et nous voyons ce même ID sur l'interface. lo. Envoyons quelques paquets à 127.0.0.1 (demande + réponse) :
$ ping -c1 localhostet maintenant regardons le contenu du fichier virtuel de débogage /sys/kernel/debug/tracing/trace_pipe, dans lequel bpf_printk écrit ses messages :
# cat /sys/kernel/debug/tracing/trace_pipe
ping-13937 [000] d.s1 442015.377014: bpf_trace_printk: running on CPU0
ping-13937 [000] d.s1 442015.377027: bpf_trace_printk: running on CPU0
Deux paquets ont été détectés sur lo et traités sur CPU0 - notre premier vrai programme BPF insignifiant a fonctionné !
Il convient de noter que bpf_printk n'écrit pas en vain dans le fichier de débogage : ce n'est pas le meilleur assistant à utiliser en production, mais notre objectif était de montrer quelque chose de simple.
Accès aux maps depuis des programmes BPF
Exemple : utilisons une map depuis un programme BPF
Dans les sections précédentes, nous avons appris à créer et à utiliser des maps depuis l'espace utilisateur, et maintenant regardons la partie noyau. Commençons, comme d'habitude, par un exemple. Réécrivons notre programme. xdp-simple.bpf.c comme suit :
#include "vmlinux.h"
#include <bpf/bpf_helpers.h>

struct {
    __uint(type, BPF_MAP_TYPE_ARRAY);
    __uint(max_entries, 8);
    __type(key, u32);
    __type(value, u64);
} woo SEC(".maps");

SEC("xdp/simple")
int simple(void *ctx)
{
    u32 key = bpf_get_smp_processor_id();
    u32 *val;

    val = bpf_map_lookup_elem(&woo, &key);
    if (!val)
        return XDP_ABORTED;

    *val += 1;

    return XDP_PASS;
}

char LICENSE[] SEC("license") = "GPL";
Au début du programme, nous avons ajouté la définition d'une map woo: c'est un tableau de 8 éléments qui stocke des valeurs de type u64 (en C, nous définirions un tel tableau comme u64 woo[8]). Dans le programme "xdp/simple" nous obtenons le numéro du processeur actuel dans la variable key et ensuite, à l'aide de la fonction d'assistance bpf_map_lookup_element nous obtenons un pointeur sur l'enregistrement correspondant dans le tableau, que nous augmentons de un. En d'autres termes : nous comptons les statistiques sur quel CPU les paquets entrants ont été traités. Essayons d'exécuter le programme :
$ clang -O2 -g -c -target bpf -I libbpf/src/root/usr/include xdp-simple.bpf.c -o xdp-simple.bpf.o
$ bpftool gen skeleton xdp-simple.bpf.o > xdp-simple.skel.h
$ clang -O2 -g -I ./libbpf/src/root/usr/include/ -o xdp-simple xdp-simple.c ./libbpf/src/root/usr/lib64/libbpf.a -lelf -lz
$ sudo ./xdp-simple
Vérifions qu'il s'est connecté à lo et envoyons quelques paquets :
$ ip l show dev lo
1: lo:  mtu 65536 xdpgeneric qdisc noqueue state UNKNOWN mode DEFAULT group default qlen 1000
    link/loopback 00:00:00:00:00:00 brd 00:00:00:00:00:00
    prog/xdp id 108

$ for s in `seq 234`; do sudo ping -f -c 100 127.0.0.1 >/dev/null 2>&1; done
Voyons maintenant le contenu du tableau :
$ sudo bpftool map dump name woo
[
    { "key": 0, "value": 0 },
    { "key": 1, "value": 400 },
    { "key": 2, "value": 0 },
    { "key": 3, "value": 0 },
    { "key": 4, "value": 0 },
    { "key": 5, "value": 0 },
    { "key": 6, "value": 0 },
    { "key": 7, "value": 46400 }
]
Presque tous les processus ont été traités sur le CPU7. Peu importe pour nous, l'essentiel est que le programme fonctionne et que nous avons compris comment accéder aux maps depuis les programmes BPF — grâce à .
Pointeur mystique
Ainsi, nous pouvons accéder à la map dans un programme BPF en utilisant des appels de type
val = bpf_map_lookup_elem(&woo, &key);où la fonction helper ressemble à ceci
void *bpf_map_lookup_elem(struct bpf_map *map, const void *key)mais nous passons un pointeur &woo vers une structure anonyme struct { ... }…
Si nous examinons l'assembleur du programme, nous verrons que la valeur &woo n'est en réalité pas définie (ligne 4) :
llvm-objdump -D --section xdp/simple xdp-simple.bpf.o

xdp-simple.bpf.o : format de fichier elf64-bpf

Désassemblage de la section xdp/simple :

0000000000000000  :
       0 : 85 00 00 00 08 00 00 00 call 8
       1 : 63 0a fc ff 00 00 00 00 *(u32 *)(r10 - 4) = r0
       2 : bf a2 00 00 00 00 00 00 r2 = r10
       3 : 07 02 00 00 fc ff ff ff r2 += -4
       4 : 18 01 00 00 00 00 00 00 00 00 00 00 00 00 00 00 r1 = 0 ll
       6 : 85 00 00 00 01 00 00 00 call 1
...
et est contenue dans les relocations :
$ llvm-readelf -r xdp-simple.bpf.o | head -4

La section de relocation '.relxdp/simple' à l'offset 0xe18 contient 1 entrée :
    Offset             Info             Type               Valeur du symbole  Nom du symbole
0000000000000020  0000002700000001 R_BPF_64_64            0000000000000000 woo
Mais si nous regardons le programme déjà chargé, nous verrons le pointeur vers la bonne map (ligne 4) :
$ sudo bpftool prog dump x name simple
int simple(void *ctx) :
   0 : (85) call bpf_get_smp_processor_id#114128
   1 : (63) *(u32 *)(r10 -4) = r0
   2 : (bf) r2 = r10
   3 : (07) r2 += -4
   4 : (18) r1 = map[id:64]
...
Ainsi, nous pouvons conclure qu'au moment de l'exécution de notre programme de chargement, la référence à &woo a été remplacée par quelque chose par la bibliothèque libbpf. Pour commencer, examinons le résultat strace:
$ sudo strace -e bpf ./xdp-simple
...
bpf(BPF_MAP_CREATE, {map_type=BPF_MAP_TYPE_ARRAY, key_size=4, value_size=8, max_entries=8, map_name="woo", ...}, 120) = 4
bpf(BPF_PROG_LOAD, {prog_type=BPF_PROG_TYPE_XDP, prog_name="simple", ...}, 120) = 5
Nous voyons que libbpf a créé la map woo et ensuite a chargé notre programme simple. Examinons de plus près comment nous chargeons le programme :
- appelons
xdp_simple_bpf__open_and_loaddepuis un fichierxdp-simple.skel.h - qui appelle
xdp_simple_bpf__loaddepuis un fichierxdp-simple.skel.h - qui appelle
bpf_object__load_skeletondepuis un fichierlibbpf/src/libbpf.c - qui appelle
bpf_object__load_xattrdelibbpf/src/libbpf.c
La dernière fonction, entre autres, appellera bpf_object__create_maps, qui crée ou ouvre des maps existantes, les transformant en descripteurs de fichiers. (C'est ici que nous voyons BPF_MAP_CREATE dans la sortie strace.) Ensuite, la fonction est appelée bpf_object__relocate et c'est précisément elle qui nous intéresse, puisqu'on se rappelle que nous avons vu woo dans le tableau des relocations. En l'explorant, nous finissons par atteindre la fonction bpf_program__relocate, qui :
case RELO_LD64:
    insn[0].src_reg = BPF_PSEUDO_MAP_FD;
    insn[0].imm = obj->maps[relo->map_idx].fd;
    break;
Ainsi, nous prenons notre instruction
18 01 00 00 00 00 00 00 00 00 00 00 00 00 00 00 r1 = 0 llet remplaçons le registre source par BPF_PSEUDO_MAP_FD, et le premier IMM par le descripteur de fichier de notre map, et si, par exemple, il est égal à 0xdeadbeef, alors nous obtiendrons comme résultat l'instruction
18 11 00 00 ef eb ad de 00 00 00 00 00 00 00 00 r1 = 0 llC'est ainsi que les informations sur les maps sont transmises à un programme BPF chargé spécifique. Le map peut être créé à l'aide de BPF_MAP_CREATE, ou ouvert par ID à l'aide de BPF_MAP_GET_FD_BY_ID.
En résumé, l'algorithme est le suivant : libbpf au moment de la compilation, des enregistrements pour les références aux maps sont créés dans le tableau de relocation
- ouvre l'objet ELF, trouve tous les maps utilisés et crée des descripteurs de fichiers pour eux
libbpfles descripteurs de fichiers sont chargés dans le noyau comme partie de l'instruction- LD64
Comme vous pouvez le comprendre, ce n'est pas tout, et nous devrons plonger dans le noyau. Heureusement, nous avons une piste — nous avons inscrit la valeur
dans le registre source et pouvons le scruter, ce qui nous mènera dans le saint des saints — BPF_PSEUDO_MAP_FD , où une fonction au nom caractéristique remplace le descripteur de fichier par l'adresse d'une structure de type kernel/bpf/verifier.cstruct bpf_map static int replace_map_fd_with_map_ptr(struct bpf_verifier_env *env) { ...f = fdget(insn[0].imm); map = __bpf_map_get(f); if (insn->src_reg == BPF_PSEUDO_MAP_FD) { addr = (unsigned long)map; } insn[0].imm = (u32)addr; insn[1].imm = addr >> 32;:
(le code complet peut être trouvé). Donc, nous pouvons compléter notre algorithme : lors du chargement du programme, le vérificateur vérifie la validité de l'utilisation du map et inscrit l'adresse de la structure correspondante
- Lors du chargement d'un binaire ELF à l'aide de
static int replace_map_fd_with_map_ptr(struct bpf_verifier_env *env) { ...f = fdget(insn[0].imm); map = __bpf_map_get(f); if (insn->src_reg == BPF_PSEUDO_MAP_FD) { addr = (unsigned long)map; } insn[0].imm = (u32)addr; insn[1].imm = addr >> 32;
beaucoup d'autres événements se produisent, mais nous discuterons de cela dans d'autres articles. libbpf Chargement de programmes et de maps sans libbpf
Comme promis, voici un exemple pour les lecteurs qui souhaitent savoir comment créer et charger un programme utilisant des maps, sans aide
Comme promis, voici un exemple pour les lecteurs qui souhaitent savoir comment créer et charger un programme utilisant des maps, sans aide. libbpf. Cela peut être utile lorsque vous travaillez dans un environnement pour lequel vous ne pouvez pas rassembler les dépendances, ou si vous économisez chaque octet, ou si vous écrivez un programme de type , qui génère du code binaire BPF à la volée.
Pour faciliter le suivi de la logique, nous allons réécrire notre exemple xdp-simple. Le code complet et légèrement étendu du programme examiné dans cet exemple peut être trouvé dans ce .
La logique de notre application est la suivante :
- créer une carte de type
BPF_MAP_TYPE_ARRAYen utilisant la commandeBPF_MAP_CREATE, - créer un programme utilisant cette carte,
- connecter le programme à l'interface
lo,
ce qui se traduit par
int main(void)
{
    int map_fd, prog_fd;

    map_fd = map_create();
    if (map_fd < 0)
        err(1, "bpf: BPF_MAP_CREATE");

    prog_fd = prog_load(map_fd);
    if (prog_fd < 0)
        err(1, "bpf: BPF_PROG_LOAD");

    xdp_attach(1, prog_fd);
}
Ici map_create crée une carte exactement de la même manière que nous l'avons fait dans le premier exemple sur les appels système bpf — « noyau, s'il te plaît, crée-moi une nouvelle carte sous la forme d'un tableau de 8 éléments de type __u64 et renvoie-moi un descripteur de fichier :
static int map_create()
{
    union bpf_attr attr;

    memset(&attr, 0, sizeof(attr));
    attr.map_type = BPF_MAP_TYPE_ARRAY,
    attr.key_size = sizeof(__u32),
    attr.value_size = sizeof(__u64),
    attr.max_entries = 8,
    strncpy(attr.map_name, "woo", sizeof(attr.map_name));
    return syscall(__NR_bpf, BPF_MAP_CREATE, &attr, sizeof(attr));
}
Le programme est également chargé simplement :
static int prog_load(int map_fd)
{
    union bpf_attr attr;
    struct bpf_insn insns[] = {
        ...
    };

    memset(&attr, 0, sizeof(attr));
    attr.prog_type = BPF_PROG_TYPE_XDP;
    attr.insns     = ptr_to_u64(insns);
    attr.insn_cnt  = sizeof(insns)/sizeof(insns[0]);
    attr.license   = ptr_to_u64("GPL");
    strncpy(attr.prog_name, "woo", sizeof(attr.prog_name));
    return syscall(__NR_bpf, BPF_PROG_LOAD, &attr, sizeof(attr));
}
La partie complexe prog_load — c'est la définition de notre programme BPF sous la forme d'un tableau de structures struct bpf_insn insns[]. Mais comme nous utilisons un programme que nous avons en C, nous pouvons nous arranger un peu :
$ llvm-objdump -D --section xdp/simple xdp-simple.bpf.o

0000000000000000 :
       0:       85 00 00 00 08 00 00 00 call 8
       1:       63 0a fc ff 00 00 00 00 *(u32 *)(r10 - 4) = r0
       2:       bf a2 00 00 00 00 00 00 r2 = r10
       3:       07 02 00 00 fc ff ff ff r2 += -4
       4:       18 01 00 00 00 00 00 00 00 00 00 00 00 00 00 00 r1 = 0 ll
       6:       85 00 00 00 01 00 00 00 call 1
       7:       b7 01 00 00 00 00 00 00 r1 = 0
       8:       15 00 04 00 00 00 00 00 if r0 == 0 goto +4
       9:       61 01 00 00 00 00 00 00 r1 = *(u32 *)(r0 + 0)
      10:       07 01 00 00 01 00 00 00 r1 += 1
      11:       63 10 00 00 00 00 00 00 *(u32 *)(r0 + 0) = r1
      12:       b7 01 00 00 02 00 00 00 r1 = 2

0000000000000068 :
      13:       bf 10 00 00 00 00 00 00 r0 = r1
      14:       95 00 00 00 00 00 00 00 exit
En conclusion, nous devons écrire 14 instructions sous la forme de structures de type struct bpf_insn (conseil : Prenez le dump ci-dessus, relisez la section sur les instructions, ouvrez et et essayez de déterminer struct bpf_insn insns[] vous-même):
struct bpf_insn insns[] = {
    /* 85 00 00 00 08 00 00 00 call 8 */
    {
        .code = BPF_JMP | BPF_CALL,
        .imm = 8,
    },

    /* 63 0a fc ff 00 00 00 00 *(u32 *)(r10 - 4) = r0 */
    {
        .code = BPF_MEM | BPF_STX,
        .off = -4,
        .src_reg = BPF_REG_0,
        .dst_reg = BPF_REG_10,
    },

    /* bf a2 00 00 00 00 00 00 r2 = r10 */
    {
        .code = BPF_ALU64 | BPF_MOV | BPF_X,
        .src_reg = BPF_REG_10,
        .dst_reg = BPF_REG_2,
    },

    /* 07 02 00 00 fc ff ff ff r2 += -4 */
    {
        .code = BPF_ALU64 | BPF_ADD | BPF_K,
        .dst_reg = BPF_REG_2,
        .imm = -4,
    },

    /* 18 01 00 00 00 00 00 00 00 00 00 00 00 00 00 00 r1 = 0 ll */
    {
        .code = BPF_LD | BPF_DW | BPF_IMM,
        .src_reg = BPF_PSEUDO_MAP_FD,
        .dst_reg = BPF_REG_1,
        .imm = map_fd,
    },
    { }, /* placeholder */

    /* 85 00 00 00 01 00 00 00 call 1 */
    {
        .code = BPF_JMP | BPF_CALL,
        .imm = 1,
    },

    /* b7 01 00 00 00 00 00 00 r1 = 0 */
    {
        .code = BPF_ALU64 | BPF_MOV | BPF_K,
        .dst_reg = BPF_REG_1,
        .imm = 0,
    },

    /* 15 00 04 00 00 00 00 00 if r0 == 0 goto +4  */
    {
        .code = BPF_JMP | BPF_JEQ | BPF_K,
        .off = 4,
        .src_reg = BPF_REG_0,
        .imm = 0,
    },

    /* 61 01 00 00 00 00 00 00 r1 = *(u32 *)(r0 + 0) */
    {
        .code = BPF_MEM | BPF_LDX,
        .off = 0,
        .src_reg = BPF_REG_0,
        .dst_reg = BPF_REG_1,
    },

    /* 07 01 00 00 01 00 00 00 r1 += 1 */
    {
        .code = BPF_ALU64 | BPF_ADD | BPF_K,
        .dst_reg = BPF_REG_1,
        .imm = 1,
    },

    /* 63 10 00 00 00 00 00 00 *(u32 *)(r0 + 0) = r1 */
    {
        .code = BPF_MEM | BPF_STX,
        .src_reg = BPF_REG_1,
        .dst_reg = BPF_REG_0,
    },

    /* b7 01 00 00 02 00 00 00 r1 = 2 */
    {
        .code = BPF_ALU64 | BPF_MOV | BPF_K,
        .dst_reg = BPF_REG_1,
        .imm = 2,
    },

    /* : bf 10 00 00 00 00 00 00 r0 = r1 */
    {
        .code = BPF_ALU64 | BPF_MOV | BPF_X,
        .src_reg = BPF_REG_1,
        .dst_reg = BPF_REG_0,
    },

    /* 95 00 00 00 00 00 00 00 exit */
    {
        .code = BPF_JMP | BPF_EXIT
    },
};
Un exercice pour ceux qui n'ont pas écrit cela eux-mêmes — trouvez map_fd.
Il reste une partie non révélée dans notre programme — xdp_attach. Malheureusement, les programmes de type XDP ne peuvent pas être attachés via un appel système bpf. Les personnes qui ont créé BPF et XDP venaient de la communauté réseau Linux, ce qui signifie qu'ils utilisaient l'interface qu'ils connaissaient le mieux (mais pas pour les gens) pour interagir avec le noyau : , voir aussi . La façon la plus simple de le mettre en œuvre xdp_attach — est de copier le code de libbpf, en particulier, du fichier , ce que nous avons fait en le raccourcissant un peu :
Bienvenue dans le monde des sockets netlink
Ouvrons un socket netlink de type NETLINK_ROUTE:
int netlink_open(__u32 *nl_pid)
{
    struct sockaddr_nl sa;
    socklen_t addrlen;
    int one = 1, ret;
    int sock;

    memset(&sa, 0, sizeof(sa));
    sa.nl_family = AF_NETLINK;

    sock = socket(AF_NETLINK, SOCK_RAW, NETLINK_ROUTE);
    if (sock < 0)
        err(1, "socket");

    if (setsockopt(sock, SOL_NETLINK, NETLINK_EXT_ACK, &one, sizeof(one)) < 0)
        warnx("rapport d'erreur netlink non supporté");

    if (bind(sock, (struct sockaddr *)&sa, sizeof(sa)) < 0)
        err(1, "bind");

    addrlen = sizeof(sa);
    if (getsockname(sock, (struct sockaddr *)&sa, &addrlen) < 0)
        err(1, "getsockname");

    *nl_pid = sa.nl_pid;
    return sock;
}
Lecture à partir d'une telle socket :
static int bpf_netlink_recv(int sock, __u32 nl_pid, int seq)
{
    bool multipart = true;
    struct nlmsgerr *errm;
    struct nlmsghdr *nh;
    char buf[4096];
    int len, ret;

    while (multipart) {
        multipart = false;
        len = recv(sock, buf, sizeof(buf), 0);
        if (len nlmsg_pid != nl_pid)
                errx(1, "pid incorrect");
            if (nh->nlmsg_seq != seq)
                errx(1, "INVSEQ");
            if (nh->nlmsg_flags & NLM_F_MULTI)
                multipart = true;
            switch (nh->nlmsg_type) {
                case NLMSG_ERROR:
                    errm = (struct nlmsgerr *)NLMSG_DATA(nh);
                    if (!errm->error)
                        continue;
                    ret = errm->error;
                    // libbpf_nla_dump_errormsg(nh); trop de code à copier...
                    goto done;
                case NLMSG_DONE:
                    return 0;
                default:
                    break;
            }
        }
    }
    ret = 0;
done:
    return ret;
}
Enfin, voici notre fonction qui ouvre une socket et envoie un message spécial contenant un descripteur de fichier :
static int xdp_attach(int ifindex, int prog_fd)
{
    int sock, seq = 0, ret;
    struct nlattr *nla, *nla_xdp;
    struct {
        struct nlmsghdr  nh;
        struct ifinfomsg ifinfo;
        char             attrbuf[64];
    } req;
    __u32 nl_pid = 0;

    sock = netlink_open(&nl_pid);
    if (sock nla_type = NLA_F_NESTED | IFLA_XDP;
    nla->nla_len = NLA_HDRLEN;

    /* ajout du XDP fd */
    nla_xdp = (struct nlattr *)((char *)nla + nla->nla_len);
    nla_xdp->nla_type = IFLA_XDP_FD;
    nla_xdp->nla_len = NLA_HDRLEN + sizeof(int);
    memcpy((char *)nla_xdp + NLA_HDRLEN, &prog_fd, sizeof(prog_fd));
    nla->nla_len += nla_xdp->nla_len;

    /* si l'utilisateur a passé des drapeaux, les ajouter aussi */
    __u32 flags = XDP_FLAGS_SKB_MODE;
    nla_xdp = (struct nlattr *)((char *)nla + nla->nla_len);
    nla_xdp->nla_type = IFLA_XDP_FLAGS;
    nla_xdp->nla_len = NLA_HDRLEN + sizeof(flags);
    memcpy((char *)nla_xdp + NLA_HDRLEN, &flags, sizeof(flags));
    nla->nla_len += nla_xdp->nla_len;

    req.nh.nlmsg_len += NLA_ALIGN(nla->nla_len);

    if (send(sock, &req, req.nh.nlmsg_len, 0) < 0)
        err(1, "send");
    ret = bpf_netlink_recv(sock, nl_pid, seq);

cleanup:
    close(sock);
    return ret;
}
Tout est prêt pour le test :
$ cc nolibbpf.c -o nolibbpf
$ sudo strace -e bpf ./nolibbpf
bpf(BPF_MAP_CREATE, {map_type=BPF_MAP_TYPE_ARRAY, map_name="woo", ...}, 72) = 3
bpf(BPF_PROG_LOAD, {prog_type=BPF_PROG_TYPE_XDP, insn_cnt=15, prog_name="woo", ...}, 72) = 4
+++ sorti avec 0 +++
Voyons si notre programme est connecté à lo:
$ ip l show dev lo
1: lo:  mtu 65536 xdpgeneric qdisc noqueue state UNKNOWN mode DEFAULT group default qlen 1000
    link/loopback 00:00:00:00:00:00 brd 00:00:00:00:00:00
    prog/xdp id 160
Envoyons des pings et regardons la carte :
$ for s in `seq 234`; do sudo ping -f -c 100 127.0.0.1 >/dev/null 2>&1; done
$ sudo bpftool m dump name woo
key: 00 00 00 00  value: 90 01 00 00 00 00 00 00
key: 01 00 00 00  value: 00 00 00 00 00 00 00 00
key: 02 00 00 00  value: 00 00 00 00 00 00 00 00
key: 03 00 00 00  value: 00 00 00 00 00 00 00 00
key: 04 00 00 00  value: 00 00 00 00 00 00 00 00
key: 05 00 00 00  value: 00 00 00 00 00 00 00 00
key: 06 00 00 00  value: 40 b5 00 00 00 00 00 00
key: 07 00 00 00  value: 00 00 00 00 00 00 00 00
Trouvé 8 éléments
C'est génial, tout fonctionne. Notez d'ailleurs que notre carte est à nouveau affichée sous forme d'octets. Cela se produit parce que, contrairement à libbpf nous n'avons pas chargé les informations sur les types (BTF). Mais nous en parlerons plus en détail la prochaine fois.
Outils de développement
Dans cette section, nous allons examiner l'ensemble minimal d'outils pour les développeurs BPF.
En général, il n'est pas nécessaire d'avoir quoi que ce soit de spécial pour développer des programmes BPF — BPF fonctionne sur n'importe quel noyau de distribution décent, et les programmes sont compilés à l'aide de clang, qui peut être installé à partir du paquet. Cependant, étant donné que BPF est en cours de développement, le noyau et les outils changent constamment. Si vous ne souhaitez pas écrire des programmes BPF avec les méthodes anciennes de 2019, vous devrez les compiler
llvm/clangpahole- votre noyau
bpftool
(Pour référence : cette section et tous les exemples de l'article ont été exécutés sur Debian 10.)
llvm/clang
BPF fonctionne bien avec LLVM et, bien que récemment, les programmes BPF puissent également être compilés à l'aide de gcc, tout le développement actuel se fait pour LLVM. Par conséquent, nous allons d'abord compiler la version actuelle clang à partir de git :
$ sudo apt install ninja-build
$ git clone --depth 1 https://github.com/llvm/llvm-project.git
$ mkdir -p llvm-project/llvm/build/install
$ cd llvm-project/llvm/build
$ cmake .. -G "Ninja" -DLLVM_TARGETS_TO_BUILD="BPF;X86"
                      -DLLVM_ENABLE_PROJECTS="clang"
                      -DBUILD_SHARED_LIBS=OFF
                      -DCMAKE_BUILD_TYPE=Release
                      -DLLVM_BUILD_RUNTIME=OFF
$ time ninja
... beaucoup de temps plus tard
$
Maintenant, nous pouvons vérifier si tout s'est bien compilé :
$ ./bin/llc --version
LLVM (http://llvm.org/) :
  Version LLVM 11.0.0git
  Compilation optimisée.
  Cible par défaut : x86_64-unknown-linux-gnu
  CPU hôte : znver1

  Cibles enregistrées :
    bpf    - BPF (endian hôte)
    bpfeb  - BPF (big endian)
    bpfel  - BPF (little endian)
    x86    - X86 32 bits : Pentium-Pro et supérieur
    x86-64 - X86 64 bits : EM64T et AMD64
(Les instructions de compilation clang ont été prises par moi dans .)
Nous ne allons pas installer les programmes récemment compilés, mais plutôt les ajouter à PATH, par exemple :
export PATH="`pwd`/bin:$PATH"(Cela peut être ajouté dans .bashrc ou dans un fichier séparé. Personnellement, j'ajoute ces éléments dans ~/bin/activate-llvm.sh et quand cela est nécessaire, je fais . activate-llvm.sh.)
Pahole et BTF
Utilitaire pahole sont utilisés lors de la compilation du noyau pour générer des informations de débogage au format BTF. Nous ne allons pas détailler cette technologie BTF dans cet article, si ce n'est qu'elle est pratique et que nous souhaitons l'utiliser. Par conséquent, si vous prévoyez de compiler votre noyau, compilez d'abord pahole (sans pahole vous ne pourrez pas compiler le noyau avec l'option CONFIG_DEBUG_INFO_BTF:
$ git clone https://git.kernel.org/pub/scm/devel/pahole/pahole.git
$ cd pahole/
$ sudo apt install cmake
$ mkdir build
$ cd build/
$ cmake -D__LIB=lib ..
$ make
$ sudo make install
$ which pahole
/usr/local/bin/pahole
Noyaux pour expérimenter avec BPF
Lors de l'exploration des possibilités de BPF, il est souhaitable de compiler son propre noyau. Cela n'est pas strictement nécessaire, car vous pouvez compiler et charger des programmes BPF sur un noyau distribué, mais avoir son propre noyau permet d'utiliser les toutes dernières fonctionnalités de BPF, qui ne seront disponibles dans votre distribution qu'après plusieurs mois ou, dans le cas de certains outils de débogage, ne seront pas emballées dans un avenir prévisible. Un noyau personnalisé permet également d'expérimenter librement avec le code.
Pour construire un noyau, vous avez besoin, d'une part, du noyau lui-même et, d'autre part, d'un fichier de configuration du noyau. Pour les expériences avec BPF, nous pouvons utiliser un noyau ordinaire ou l'un des noyaux de développement. Historiquement, le développement de BPF se fait au sein de la communauté réseau Linux et tous les changements passent tôt ou tard par David Miller, le mainteneur de la partie réseau de Linux. Selon leur nature, qu'il s'agisse de corrections ou de nouvelles fonctionnalités, les changements réseau sont intégrés dans l'un des deux noyaux : ou . Les changements pour BPF sont répartis de la même manière entre et , qui sont ensuite intégrés dans net et net-next, respectivement. Pour plus de détails, voir et . Donc, choisissez un noyau en fonction de vos préférences et de vos besoins en matière de stabilité du système sur lequel vous testez (*-next sont les noyaux les plus instables de la liste).
Cette article ne couvre pas comment gérer les fichiers de configuration du noyau — il est supposé que vous savez déjà le faire ou que vous par vous-même. Cependant, les instructions suivantes devraient être, grosso modo, suffisantes pour vous permettre d'avoir un système fonctionnel avec le support de BPF.
Téléchargez l'un des noyaux mentionnés ci-dessus :
$ git clone git://git.kernel.org/pub/scm/linux/kernel/git/bpf/bpf-next.git
$ cd bpf-next
Compilez une configuration de noyau minimale fonctionnelle :
$ cp /boot/config-`uname -r` .config
$ make localmodconfig
Activez les options BPF dans le fichier .config de votre choix (très probablement, la configuration CONFIG_BPF sera déjà activée, car elle est utilisée par systemd). Voici la liste des options du noyau qui ont été utilisées pour cet article :
CONFIG_CGROUP_BPF=y
CONFIG_BPF=y
CONFIG_BPF_LSM=y
CONFIG_BPF_SYSCALL=y
CONFIG_ARCH_WANT_DEFAULT_BPF_JIT=y
CONFIG_BPF_JIT_ALWAYS_ON=y
CONFIG_BPF_JIT_DEFAULT_ON=y
CONFIG_IPV6_SEG6_BPF=y
# CONFIG_NETFILTER_XT_MATCH_BPF is not set
# CONFIG_BPFILTER is not set
CONFIG_NET_CLS_BPF=y
CONFIG_NET_ACT_BPF=y
CONFIG_BPF_JIT=y
CONFIG_BPF_STREAM_PARSER=y
CONFIG_LWTUNNEL_BPF=y
CONFIG_HAVE_EBPF_JIT=y
CONFIG_BPF_EVENTS=y
CONFIG_BPF_KPROBE_OVERRIDE=y
CONFIG_DEBUG_INFO_BTF=y
Ensuite, nous pouvons facilement compiler et installer les modules et le noyau (d'ailleurs, vous pouvez compiler le noyau avec celui que vous venez de compiler clang, en ajoutant CC=clang):
$ make -s -j $(getconf _NPROCESSORS_ONLN)
$ sudo make modules_install
$ sudo make install
et redémarrer avec le nouveau noyau (j'utilise pour cela kexec du paquet kexec-tools):
v=5.8.0-rc6+ # si vous recompiliez le noyau actuel, vous pouvez faire v=`uname -r`
sudo kexec -l -t bzImage /boot/vmlinuz-$v --initrd=/boot/initrd.img-$v --reuse-cmdline &&
sudo kexec -e
bpftool
L'utilitaire le plus couramment utilisé dans cet article sera l'outil bpftool, fourni avec le noyau Linux. Il est écrit et maintenu par les développeurs de BPF pour les développeurs de BPF et permet de gérer tous les types d'objets BPF - charger des programmes, créer et modifier des maps, explorer la dynamique de l'écosystème BPF, etc. La documentation sous forme de sources pour les pages man peut être trouvée ou, déjà compilée, .
Au moment de la rédaction de cet article bpftool n'est fourni en version prête à l'emploi que pour RHEL, Fedora et Ubuntu (voir, par exemple, , qui raconte l'histoire inachevée de l'emballage bpftool dans Debian). Mais si vous avez déjà compilé votre noyau, il est très facile de compiler bpftool :
$ cd ${linux}/tools/bpf/bpftool
# ... indiquez les chemins vers le dernier clang, comme expliqué ci-dessus
$ make -s

Détection automatique des fonctionnalités du système :
...                        libbfd : [ activé ]
...        désassembleur-quatre-args : [ activé ]
...                          zlib : [ activé ]
...                        libcap : [ activé ]
...               clang-bpf-co-re : [ activé ]

Détection automatique des fonctionnalités du système :
...                        libelf : [ activé ]
...                          zlib : [ activé ]
...                           bpf : [ activé ]

$
(ici ${linux} est votre répertoire avec le noyau.) Après avoir exécuté ces commandes, bpftool il sera compilé dans le répertoire ${linux}/tools/bpf/bpftool et vous pourrez l'ajouter au chemin (principalement pour l'utilisateur root) ou simplement le copier dans /usr/local/sbin.
Il vaut mieux compiler bpftool avec le dernier clang, comme décrit ci-dessus, et vérifier si elle a été correctement compilée - avec, par exemple, la commande
$ sudo bpftool feature probe kernel
Analyse de la configuration système...
bpf() syscall pour les utilisateurs non privilégiés est activé
Le compilateur JIT est activé
Le durcissement du compilateur JIT est désactivé
Les exports de kallsyms du compilateur JIT sont activés pour root
...
qui montrera quelles fonctionnalités BPF sont activées dans votre noyau.
Au fait, la commande précédente peut être exécutée comme
# bpftool f p kC'est fait par analogie avec les outils du paquet iproute2, où nous pouvons, par exemple, dire ip a s eth0 au lieu de ip addr show dev eth0.
Conclusion
BPF permet de façon efficace de mesurer et de modifier à la volée la fonctionnalité du noyau. Le système s'est avéré très réussi, dans la meilleure tradition UNIX : un mécanisme simple permettant de (re)programmer le noyau a permis à un grand nombre de personnes et d'organisations d'expérimenter. Et, bien que les expériences, tout comme le développement de l'infrastructure BPF elle-même, ne soient pas encore terminées, le système a déjà un ABI stable, permettant de construire une logique métier fiable et surtout efficace.
Il convient de noter, à mon avis, que cette technologie est devenue si populaire parce que, d'une part, on peut jouer (l'architecture de la machine peut être comprise plus ou moins en une soirée), et d'autre part — résoudre des problèmes qui étaient impossibles (de manière élégante) avant son apparition. Ces deux composantes ensemble incitent les gens à expérimenter et à rêver, ce qui entraîne l'émergence de nouvelles solutions innovantes.
Cet article, bien qu'il ne soit pas particulièrement court, constitue simplement une introduction au monde de BPF et ne décrit pas les possibilités "avancées" et les parties importantes de l'architecture. Le plan ultérieur est à peu près le suivant : le prochain article sera une revue des types de programmes BPF (la version 5.8 du noyau supporte 30 types de programmes), ensuite nous nous pencherons enfin sur la façon de rédiger de vraies applications BPF à travers des programmes de traçage du noyau, puis viendra le temps pour un cours plus approfondi sur l'architecture BPF, et enfin — des exemples d'applications BPF pour le réseau et la sécurité.
Les articles précédents de cette série
Liens
— documentation sur BPF de cilium, plus précisément de Daniel Borkman, l'un des créateurs et mainteneurs de BPF. C'est l'une des premières descriptions sérieuses qui se distingue des autres par le fait que Daniel sait exactement de quoi il parle, sans erreurs. En particulier, ce document explique comment travailler avec des programmes BPF des types XDP et TC à l'aide de l'outil bien connu
ipdu paquetiproute2.— le document original sur la documentation de BPF classique et ensuite sur le BPF étendu. Utile à lire si vous souhaitez plonger dans l'assembleur et les détails techniques de l'architecture.
. Mis à jour rarement, mais avec précision, car y contribuent Alexei Starovoitov (auteur de eBPF) et Andrii Nakryiko — (mainteneur
libbpf).. Un fil Twitter intéressant de Quentin Monnet avec des exemples et des secrets d'utilisation de bpftool.
. Une liste gigantesque (et toujours maintenue) de liens vers la documentation BPF par Quentin Monnet.
Source : habr.com
