

Le 10 août, un , dans lequel nous l'explorons en profondeur — des abstractions de base aux paramètres réseau.
Dans cet article, nous discuterons de l'histoire de Docker et de ses principales abstractions : Image, Cli, Dockerfile. La leçon est destinée aux débutants, elle ne sera donc probablement pas intéressante pour les utilisateurs expérimentés. Il n'y aura pas de détails techniques complexes, juste les fondamentaux.
Qu'est-ce que Docker
Voyons la définition de Docker sur Wikipédia.
Docker est un logiciel permettant d'automatiser le déploiement et la gestion des applications dans des environnements prenant en charge la containerisation.
Cette définition peut sembler floue. En particulier, il n'est pas clair ce que signifie « dans des environnements prenant en charge la containerisation ». Pour mieux comprendre, revenons en arrière. Commençons par une époque que j'appelle 'l'ère monolithique'.
L'ère monolithique
L'ère monolithique correspond au début des années 2000, lorsque toutes les applications étaient monolithiques et comportaient de nombreuses dépendances. Le développement était long. Par ailleurs, nous avions peu de serveurs, et nous les connaissions tous par leur nom et les surveillons. Il existe une comparaison amusante :
Les animaux de compagnie — c'est comment nous décrivons nos serveurs. À l'ère monolithique, nous les traitions comme des animaux de compagnie, en prenant soin d'eux et en les chouchoutant. Pour mieux gérer les ressources, nous utilisions la virtualisation : nous prenions un serveur et le portions en plusieurs machines virtuelles, assurant ainsi l'isolation de l'environnement.
Systèmes de virtualisation basés sur un hyperviseur
Tout le monde a probablement entendu parler des systèmes de virtualisation : VMware, VirtualBox, Hyper-V, Qemu KVM, etc. Ils assurent l'isolation des applications et la gestion des ressources, mais présentent également des inconvénients. Pour mettre en place la virtualisation, un hyperviseur est nécessaire. Et l'hyperviseur entraîne une surcharge de ressources. De plus, la machine virtuelle est souvent très lourde : elle comprend un système d'exploitation, Nginx, Apache, et peut-être MySQL. L'image est volumineuse, et il est compliqué de travailler avec une machine virtuelle. Par conséquent, le travail avec des machines virtuelles peut être lent. Pour résoudre ce problème, des systèmes de virtualisation au niveau du noyau ont été créés.
Systèmes de virtualisation au niveau du noyau
La virtualisation au niveau du noyau est prise en charge par des systèmes comme OpenVZ, Systemd-nspawn, LXC. Un exemple frappant de ce type de virtualisation est LXC (Linux Containers).
LXC — un système de virtualisation au niveau du système d'exploitation permettant de lancer plusieurs instances isolées du système d'exploitation Linux sur un même nœud. LXC ne utilise pas de machines virtuelles, mais crée un environnement virtuel avec son propre espace de processus et sa pile réseau.
En essence, LXC crée des conteneurs. Quelle est la différence entre les machines virtuelles et les conteneurs ?
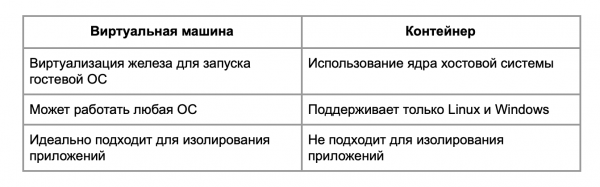
Le conteneur n'est pas adapté à l'isolation des processus : dans les systèmes de virtualisation au niveau du noyau, on trouve des vulnérabilités qui permettent de sortir du conteneur vers l'hôte. Donc, si vous devez isoler quelque chose, il est préférable d'utiliser une machine virtuelle.
Les différences entre la virtualisation et la conteneurisation peuvent être visualisées sur un schéma.
Il existe des hyperviseurs matériels, des hyperviseurs basés sur l'OS et des conteneurs.
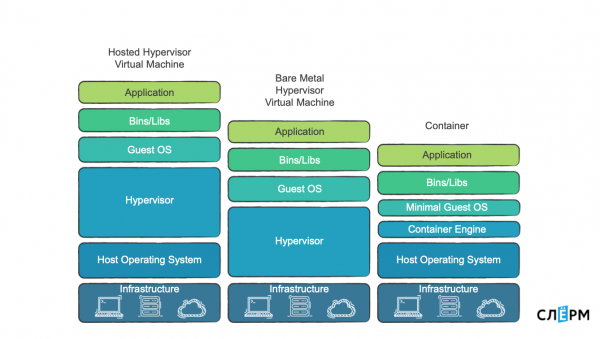
Les hyperviseurs « matériels » sont une chose formidable si vous souhaitez réellement isoler quelque chose. Parce qu'ils permettent l'isolation au niveau des pages mémoire et des processeurs.
Il existe des hyperviseurs sous forme de programmes et des conteneurs, c'est de ces derniers que nous parlerons ensuite. Dans les systèmes de conteneurisation, il n'y a pas d'hyperviseur, mais il y a un moteur de conteneur qui crée et gère les conteneurs. C'est une solution plus légère, donc, grâce à son interaction avec le noyau, la surcharge est moindre, voire inexistante.
Ce qui est utilisé pour la conteneurisation au niveau du noyau
Les principales technologies permettant de créer un conteneur isolé des autres processus sont les Namespaces et les Control Groups.
Namespaces : PID, Réseau, Montage et Utilisateur. Il y en a d'autres, mais pour simplifier la compréhension, nous allons nous concentrer sur ceux-ci.
Le Namespace PID limite les processus. Lorsque nous créons par exemple un Namespace PID, y plaçons un processus, il devient avec PID 1. En général, dans les systèmes, le PID 1 est systemd ou init. Ainsi, lorsque nous plaçons un processus dans un nouveau namespace, il reçoit également PID 1.
Le Namespace Réseau permet de limiter/isolier le réseau et d'y placer ses propres interfaces. Le Montage est une restriction au niveau du système de fichiers. Utilisateur — restriction au niveau des utilisateurs.
Control Groups : Mémoire, CPU, IOPS, Réseau — environ 12 paramètres au total. On les appelle aussi Cgroups (« groupes C »).
Les Control Groups gèrent les ressources pour le conteneur. Grâce aux Control Groups, nous pouvons spécifier qu'un conteneur ne doit pas consommer plus d'une certaine quantité de ressources.
Pour que la conteneurisation fonctionne pleinement, des technologies supplémentaires sont utilisées : Capabilities, Copy-on-write et d'autres.
Les Capabilities désignent ce que nous disons à un processus qu'il peut ou ne peut pas faire. Au niveau du noyau, ce ne sont que des cartes de bits avec de nombreux paramètres. Par exemple, l'utilisateur root a tous les privilèges et peut tout faire. Un serveur de temps peut modifier le temps système : il possède des capacités sur Time Capsule, c'est tout. Grâce aux privilèges, il est possible de configurer de manière flexible les restrictions pour les processus, assurant ainsi notre sécurité.
Le système Copy-on-write nous permet de travailler avec des images Docker, les utilisant de manière plus efficace.
À ce jour, Docker a des problèmes de compatibilité avec Cgroups v2, c'est pourquoi cet article aborde spécifiquement Cgroups v1.
Mais revenons à l'histoire.
Lorsque les systèmes de virtualisation au niveau du noyau sont apparus, ils ont été rapidement adoptés. La surcharge du hyperviseur a disparu, mais certains problèmes persistent :
- de grandes images : dans OpenVZ, on pousse le système d'exploitation, des bibliothèques, plein de logiciels, et au final, l'image reste conséquente ;
- il n'existe pas de véritable standard pour l'emballage et la livraison, d'où la problématique des dépendances. Il arrive que deux morceaux de code utilisent une même bibliothèque, mais avec des versions différentes. Cela peut entraîner des conflits.
Pour résoudre tous ces problèmes, la prochaine ère est arrivée.
L'ère des conteneurs
Lorsque l'ère des conteneurs est arrivée, la philosophie de travail avec eux a changé :
- Un processus — un conteneur.
- Toutes les dépendances nécessaires pour le processus sont livrées dans son conteneur. Cela nécessite de découper les monolithes en microservices.
- Plus l'image est petite, mieux c'est — moins de vulnérabilités potentielles, un déploiement plus rapide, etc.
- Les instances deviennent éphémères.
Rappelez-vous, je parlais des animaux de compagnie contre le bétail ? Autrefois, les instances étaient comparables à des animaux de compagnie, maintenant elles ressemblent à du bétail. Auparavant, il y avait un monolithe — une application. Maintenant, il y a 100 microservices, 100 conteneurs. Certains conteneurs peuvent avoir 2 à 3 répliques. Nous ne tenons plus à contrôler chaque conteneur. Ce qui est essentiel pour nous, c'est la disponibilité du service lui-même : ce que fait cet ensemble de conteneurs. Cela modifie les approches en matière de surveillance.
Entre 2014 et 2015, Docker a connu un essor — cette technologie dont nous allons maintenant parler.
Docker a transformé la philosophie et standardisé l’emballage des applications. Avec Docker, nous pouvons emballer une application, l’envoyer dans un dépôt, puis la télécharger et la déployer.
Dans un conteneur Docker, nous intégrons tout ce qui est nécessaire, ce qui résout le problème des dépendances. Docker garantit la reproductibilité. Je pense que beaucoup ont rencontré des problèmes de reproductibilité : tout fonctionne pour vous, puis vous le poussez en production et cela cesse de fonctionner. Avec Docker, ce problème disparaît. Si votre conteneur Docker se lance et effectue les tâches requises, il y a de fortes chances qu'il fonctionne en production et y fasse la même chose.
Une digression sur l’overhead
Concernant l’overhead, il y a des débats constants. Certains estiment que Docker ne génère pas de charge supplémentaire, car il utilise le noyau Linux et tous ses processus nécessaires à la containerisation. En d’autres termes, « si vous dites que Docker est un overhead, alors le noyau Linux en est un aussi ».
D'autre part, si l'on approfondit, il y a effectivement quelques aspects dans Docker qui peuvent être qualifiés d’overhead avec un peu de rigueur.
Le premier est l’espace de noms PID. Lorsque nous plaçons un processus dans un espace de noms, il reçoit le PID 1. En même temps, ce processus a un autre PID, qui se trouve dans l’espace de noms de l’hôte, en dehors du conteneur. Par exemple, nous avons lancé Nginx dans un conteneur, il est devenu le PID 1 (processus maître). Et sur l’hôte, il a le PID 12623. Il est donc difficile de déterminer dans quelle mesure cela constitue un overhead.
Le second aspect concerne les Cgroups. Prenons les Cgroups pour la mémoire, c'est-à-dire la possibilité de limiter la mémoire d’un conteneur. Lorsque cette option est activée, des compteurs se mettent en route, la comptabilité mémoire : le noyau doit comprendre combien de pages sont allouées et combien sont encore libres pour ce conteneur. Cela peut être un overhead, mais je n'ai pas trouvé d'études précises sur son impact sur les performances, et je n'ai pas remarqué que l'application exécutée dans Docker perdait soudainement des performances.
Et encore une remarque sur les performances. Certains paramètres du noyau sont transférés de l’hôte au conteneur. En particulier, certains paramètres réseau. Donc, si vous souhaitez exécuter quelque chose de haute performance dans Docker, par exemple quelque chose qui va utiliser activement le réseau, vous devez au minimum ajuster ces paramètres. Par exemple, un paramètre comme nf_conntrack.
Sur le concept de Docker
Docker se compose de plusieurs composants :
- Docker Daemon — c'est le moteur de conteneurs qui exécute les conteneurs.
- Docker CII — outil de gestion de Docker.
- Dockerfile — instruction sur la manière de construire une image.
- Image — image à partir de laquelle le conteneur est déployé.
- Conteneur.
- Docker registry — dépôt d'images.
Schématiquement, cela ressemble à peu près à ceci :
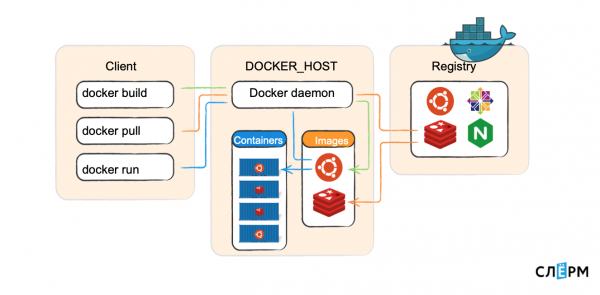
Sur Docker_host fonctionne le démon Docker, qui lance les conteneurs. Il y a un client qui envoie des commandes : construire une image, télécharger une image, exécuter un conteneur. Le démon Docker interroge le registre et exécute les commandes. Le client Docker peut communiquer également localement (avec un socket Unix) ou via TCP à partir d'un hôte distant.
Passons en revue chaque composant.
Docker daemon (démon) — c'est la partie serveur, elle fonctionne sur la machine hôte : elle télécharge des images et lance des conteneurs à partir de celles-ci, crée un réseau entre les conteneurs, collecte les journaux. Lorsque nous disons « crée une image », c'est également le travail du démon.
Docker CLI — la partie client de Docker, un utilitaire en console pour interagir avec le démon. Je le répète, il peut fonctionner non seulement localement, mais aussi sur le réseau.
Commandes de base :
docker ps — afficher les conteneurs actuellement en cours d'exécution sur le Docker-hôte.
docker images — afficher les images téléchargées localement.
docker search — rechercher une image dans le registre.
docker pull — télécharger une image depuis le registre sur la machine.
docker build <> — construire une image.
docker run — lancer un conteneur.
docker rm — supprimer un conteneur.
docker logs — journaux du conteneur.
docker start/stop/restart — gestion du conteneur.
Si vous maîtrisez ces commandes et que vous les utilisez avec assurance, considérez que vous avez maîtrisé Docker à 70 % au niveau utilisateur.
Dockerfile — instruction pour créer une image. Presque chaque commande dans l'instruction crée une nouvelle couche. Regardons avec un exemple.
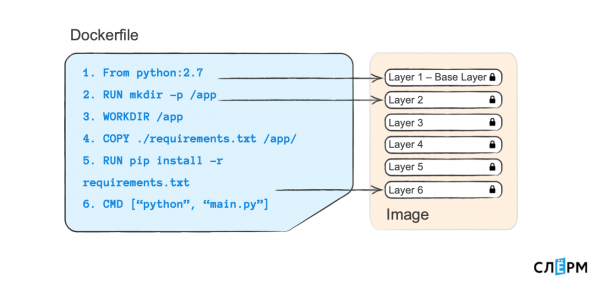
Un Dockerfile ressemble à cela : à gauche les commandes, à droite — les arguments. Chaque commande présente ici (et généralement celle écrite dans le Dockerfile) crée une nouvelle couche dans l'image.
Rien qu'en regardant le côté gauche, on peut à peu près comprendre ce qui se passe. Nous disons : « crée un dossier pour nous » — c'est une couche. « Définit ce dossier comme dossier de travail » — c'est une autre couche, et ainsi de suite. Le gâteau à plusieurs couches simplifie la vie. Si je crée un autre Dockerfile et change quelque chose sur la dernière ligne — exécuter non pas "python" "main.py", mais autre chose, ou installer des dépendances depuis un autre fichier — les couches précédentes seront réutilisées comme cache.
Image — c'est un conteneur d'image à partir duquel des conteneurs sont lancés. Si l'on considère Docker comme un gestionnaire de paquets (comme si nous travaillions avec des paquets deb ou rpm), alors l'image est essentiellement un paquet rpm. Avec yum install, nous pouvons installer une application, la supprimer, la rechercher dans le dépôt, la télécharger. Ici, c'est à peu près la même chose : des conteneurs sont lancés à partir de l'image, ils sont stockés dans le Docker registry (par analogie avec yum, dans le dépôt), et chaque image a un hachage SHA-256, un nom et une balise.
L'image est construite selon les instructions du Dockerfile. Chaque instruction du Dockerfile crée une nouvelle couche. Les couches peuvent être réutilisées.
Docker registry — c'est un dépôt d'images Docker. À l'instar des systèmes d'exploitation, Docker a un registre standard public — dockerhub. Mais il est possible de créer son propre dépôt, son propre Docker registry.
Conteneur — c'est ce qui est lancé à partir de l'image. Nous avons construit l'image selon les instructions du Dockerfile, puis nous la lançons à partir de cette image. Ce conteneur est isolé des autres conteneurs, il doit contenir tout ce qui est nécessaire au fonctionnement de l'application. De plus, un conteneur correspond à un processus. Il arrive qu'il faille créer deux processus, mais cela va à l'encontre de l'idéologie de Docker.
L'exigence « un conteneur — un processus » est liée au PID Namespace. Lorsqu'un processus avec PID 1 est lancé dans le Namespace, s'il meurt, tout le conteneur meurt aussi. Si deux processus sont lancés : l'un vit, l'autre meurt, le conteneur survivra quand même. Mais cela concerne les meilleures pratiques, dont nous parlerons dans d'autres documents.
Pour explorer plus en détail les caractéristiques et le programme complet du cours, vous pouvez suivre ce lien : «».
Auteur : Marsel Ibraev, administrateur Kubernetes certifié, ingénieur praticien chez Southbridge, conférencier et développeur de cours chez Slurm.
Source : habr.com
