

Cet article regroupe quelques modèles généraux qui aident les ingénieurs à travailler avec des services à grande échelle, qui reçoivent des requêtes de millions d'utilisateurs.
D'après l'expérience de l'auteur, ce n'est pas une liste exhaustive, mais elle contient vraiment des conseils efficaces. Alors, commençons.
Traduit avec le soutien de .
Niveau de base
Les mesures énumérées ci-dessous sont relativement simples à mettre en œuvre, mais offrent un excellent retour sur investissement. Si vous ne les avez pas encore mises en œuvre, vous serez surpris des améliorations significatives.
Infrastructure en tant que code
La première partie des conseils consiste à mettre en œuvre l'infrastructure en tant que code. Cela signifie que vous devez avoir un moyen programmatique de déployer l'ensemble de l'infrastructure. Cela peut sembler compliqué, mais en réalité, nous parlons du code suivant :
Déploiement de 100 machines virtuelles
- sous Ubuntu
- 2 Go de RAM chacune
- elles disposeront du code suivant
- avec les paramètres suivants
Vous pouvez suivre les modifications de l'infrastructure et y revenir rapidement grâce à un système de gestion de versions.
Le moderniste en moi dit qu'il est possible d'utiliser Kubernetes/Docker pour réaliser tout ce qui a été mentionné ci-dessus, et il a raison.
De plus, l'automatisation peut être réalisée grâce à Chef, Puppet ou Terraform.
Intégration et livraison continues
Pour créer un service évolutif, il est important d'avoir un pipeline de compilation et de test pour chaque demande de tirage. Même si le test est le plus simple, il garantit au moins que le code que vous déployez se compile.
À chaque étape, vous vous posez la question suivante : ma compilation se compilera-t-elle et passera-t-elle des tests, est-elle valide ? Cela peut sembler une barre basse, mais cela résout de nombreux problèmes.
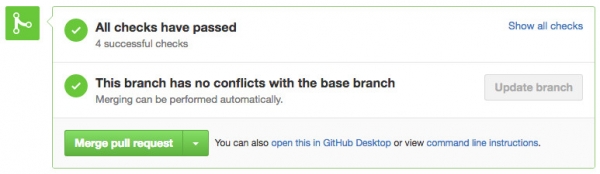
Il n'y a rien de mieux que de voir ces cases cochées
Pour cette technologie, vous pouvez envisager Github, CircleCI ou Jenkins.
Équilibreurs de charge
Nous souhaitons donc mettre en place un répartiteur de charge pour rediriger le trafic et assurer une charge égale sur tous les nœuds ou le bon fonctionnement du service en cas de défaillance :
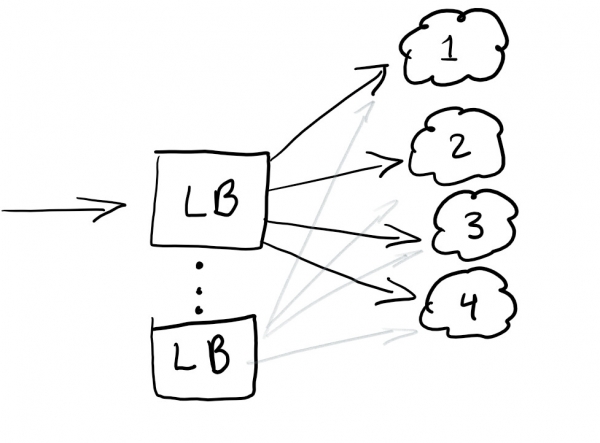
Un répartiteur de charge aide généralement à répartir le trafic. La meilleure pratique est la redondance des équilibrages afin d'éviter un point de défaillance unique.
Les équilibreurs de charge sont généralement configurés dans le cloud que vous utilisez.
RayID, ID de corrélation ou UUID pour les requêtes
Avez-vous déjà rencontré une erreur dans une application avec un message comme celui-ci : « Quelque chose s'est mal passé. Veuillez conserver cet ID et l'envoyer à notre support »?
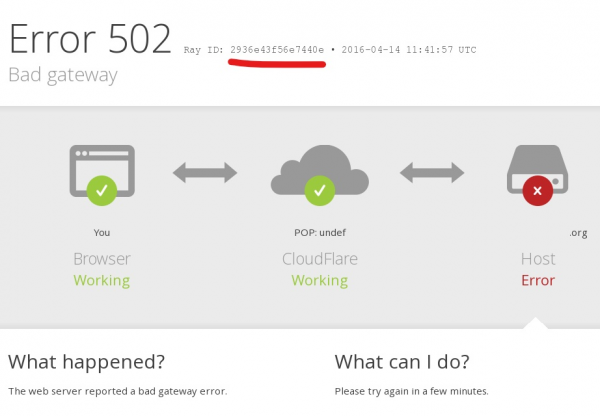
Un identifiant unique, l'ID de corrélation, le RayID ou l'un de ses variantes, est un identifiant unique qui permet de suivre une requête tout au long de son cycle de vie. Cela permet de suivre tout le chemin de la requête dans les journaux.
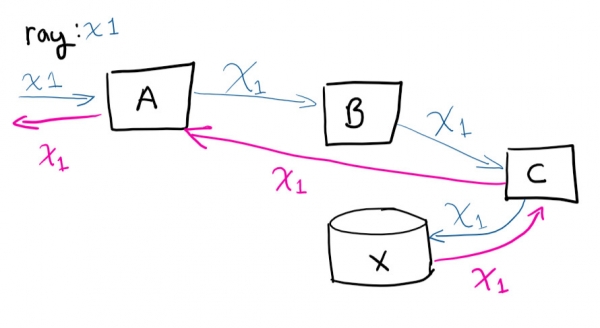
L'utilisateur effectue une requête vers le système A, puis A se connecte à B, qui se connecte à C, enregistre dans X et la requête revient à A.
Si vous vous connectiez à distance aux machines virtuelles et essayiez de retracer le chemin de la requête (et de faire correspondre manuellement quels appels se déroulent), vous deviendriez fou. Avoir un identifiant unique facilite considérablement la vie. C'est l'une des choses les plus simples à faire pour gagner du temps à mesure que le service se développe.
Niveau intermédiaire
Ici, les conseils sont plus complexes que précédemment, mais les bons outils facilitent la tâche, assurant un retour sur investissement même pour les petites et moyennes entreprises.
Journalisation centralisée
Félicitations ! Vous avez déployé 100 machines virtuelles. Le lendemain, le directeur général vient et se plaint d'une erreur qu'il a rencontrée lors des tests du service. Il indique l'identifiant correspondant dont nous avons parlé précédemment, mais vous devrez passer en revue les journaux de 100 machines pour trouver celle qui a échoué. Et il faut la trouver avant la présentation de demain.
Bien que cela ressemble à une aventure amusante, il est préférable de s'assurer que vous avez la possibilité de rechercher dans tous les journaux depuis un seul endroit. J'ai résolu le problème de la centralisation des journaux avec la fonctionnalité intégrée de la pile ELK : ici, la collecte des journaux avec possibilité de recherche est prise en charge. Cela aidera vraiment à résoudre le problème de recherche d'un journal spécifique. En prime, vous pouvez créer des graphiques et d'autres choses amusantes.
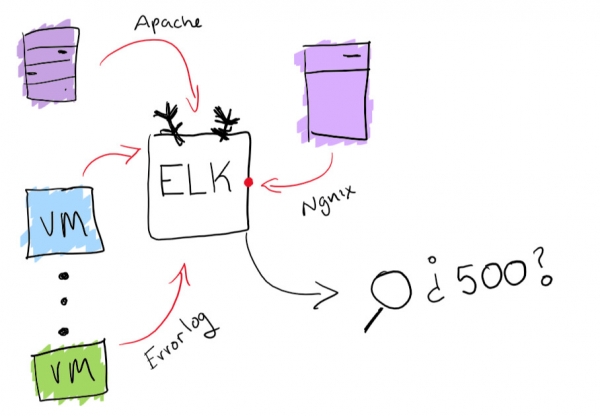
Fonctionnalité de la pile ELK
Agents de surveillance
Maintenant que votre service est opérationnel, il est nécessaire de s'assurer qu'il fonctionne sans interruption. La meilleure façon de le faire est de lancer plusieurs agents, qui fonctionnent en parallèle et vérifient qu'il fonctionne et que les opérations de base sont exécutées.
À ce stade, vous vérifiez que Le build lancé fonctionne bien et fonctionne normalement..
Pour les petits et moyens projets, je recommande Postman pour surveiller et documenter les API. Mais en général, il suffit de s'assurer que vous avez un moyen de savoir quand une panne se produit et de recevoir des alertes en temps utile.
Mise à l'échelle automatique en fonction de la charge.
C'est très simple. Si vous avez une machine virtuelle servant des requêtes et qu'elle approche de 80 % de mémoire utilisée, vous pouvez soit augmenter ses ressources, soit ajouter davantage de machines virtuelles dans le cluster. L'exécution automatique de ces opérations convient parfaitement pour ajuster de manière élastique la puissance en fonction de la charge. Mais vous devez toujours faire attention à combien d'argent vous dépensez et établir des limites raisonnables.
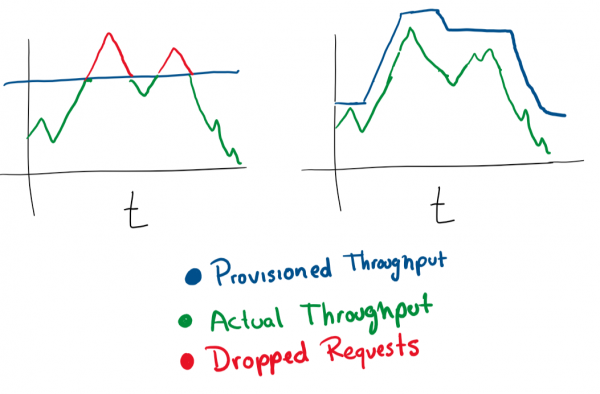
Dans la plupart des services cloud, vous pouvez configurer la mise à l'échelle automatique en utilisant un plus grand nombre de serveurs ou des serveurs plus puissants.
Système d'expérimentations.
Un bon moyen de déployer des mises à jour en toute sécurité serait de tester quelque chose pour 1 % des utilisateurs pendant une heure. Vous avez certainement vu ces mécanismes en action. Par exemple, Facebook montre à une partie de son audience une autre couleur ou modifie la taille de la police pour voir comment les utilisateurs perçoivent les changements. Cela s'appelle un test A/B.
Même le lancement d'une nouvelle fonctionnalité peut être réalisé comme une expérience, puis déterminer comment la déployer. Vous avez également la possibilité de « rappeler » ou de modifier la configuration à la volée en tenant compte d'une fonctionnalité qui cause une dégradation de votre service.
Niveau avancé.
Voici des conseils qui sont assez difficiles à mettre en œuvre. Vous aurez probablement besoin de ressources supplémentaires, donc il sera difficile pour une petite ou moyenne entreprise de gérer cela.
Déploiements bleu-vert.
C'est ce que j'appelle une méthode de déploiement « erlangienne ». Erlang a été largement utilisé lorsque les compagnies téléphoniques sont apparues. Des commutateurs logiciels ont été appliqués pour le routage des appels téléphoniques. La tâche principale du logiciel de ces commutateurs était de ne pas couper les appels pendant la mise à jour du système. Erlang a un excellent moyen de charger un nouveau module sans faire tomber l'ancien.
Cette étape dépend de la disponibilité d'un répartiteur de charge. Supposons que vous ayez la version N de votre logiciel, puis que vous souhaitiez déployer la version N+1.
Vous pourriez simplement arrêter le service et déployer la version suivante à un moment que vous jugez approprié pour vos utilisateurs, ce qui entraînerait un certain temps d'arrêt. Mais supposons que vous ayez vraiment des conditions SLA strictes. Un SLA de 99,99 % signifie que vous pouvez être hors ligne uniquement pendant 52 minutes par an.
Si vous souhaitez vraiment atteindre de tels niveaux, il vous faut deux déploiements simultanés :
- celui qui est en cours (N) ;
- la version suivante (N+1).
Vous indiquez au répartiteur de charge de rediriger un pourcentage du trafic vers la nouvelle version (N+1), tandis que vous suivez activement les régressions.
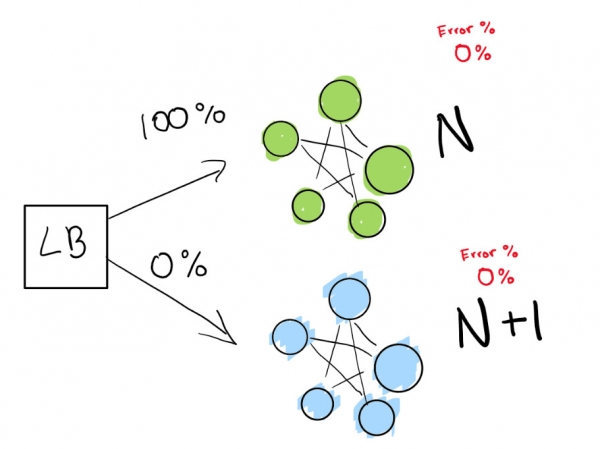
Ici, nous avons le déploiement vert N, qui fonctionne normalement. Nous essayons de passer à la nouvelle version de ce déploiement.
D'abord, nous envoyons un très petit test pour voir si notre déploiement N+1 fonctionne avec un faible volume de trafic :
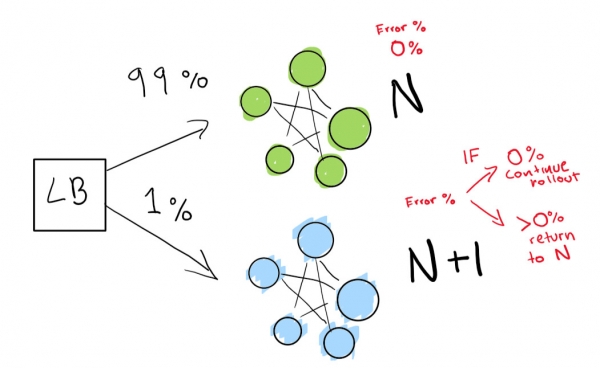
Enfin, nous avons un ensemble de vérifications automatiques que nous exécutons jusqu'à ce que notre déploiement soit terminé. Si vous êtes très, très prudent, vous pouvez également conserver votre déploiement N indéfiniment pour un retour rapide en arrière en cas de mauvaise régression :
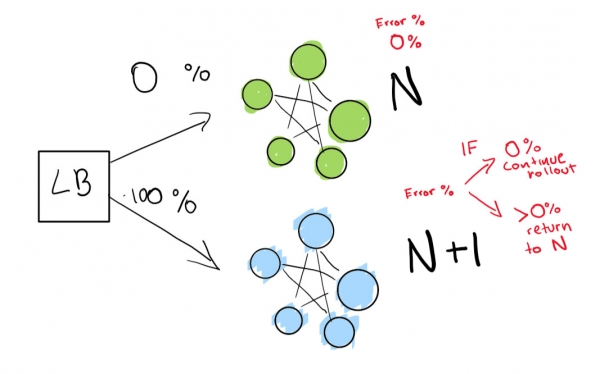
Si vous voulez aller encore plus loin, laissez tout dans le déploiement bleu-vert se faire automatiquement.
Détection des anomalies et atténuation automatique des conséquences
Étant donné que vous avez une journalisation centralisée et une bonne collecte de logs, vous pouvez déjà vous fixer des objectifs plus élevés. Par exemple, prévoir proactivement des pannes. Les moniteurs et les journaux suivent les fonctions et construisent divers graphiques — et il est possible de prédire à l'avance ce qui pourrait mal tourner :
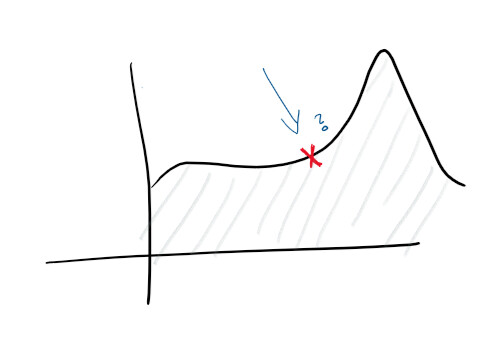
Avec la détection des anomalies, vous commencez à examiner certains indices que le service indique. Par exemple, une augmentation de la charge CPU peut indiquer qu'un disque dur est en train de tomber en panne, et une augmentation du nombre de requêtes signifie qu'il faut mettre à l'échelle. Ce type de données statistiques permet de rendre le service proactif.
En recevant de telles données analytiques, vous pouvez évoluer dans n'importe quelle dimension, modifier proactivement et réactivement les caractéristiques des machines, des bases de données, des connexions et d'autres ressources.
C'est tout !
Cette liste de priorités vous débarrassera de nombreux problèmes si vous développez un service cloud.
L'auteur de l'article original invite les lecteurs à laisser leurs commentaires et à apporter des modifications. L'article est distribué en tant que source ouverte, les demandes de tirage sont acceptées par l'auteur .
Que lire d'autre sur le sujet :
Source : habr.com
