

Le développement d'un entrepôt est une tâche longue et sérieuse.
Beaucoup de choses dans la vie d'un projet dépendent de la qualité de la conception du modèle d'objet et de la structure de la base de données dès le départ.
L'approche courante consiste à utiliser diverses combinaisons du schéma en étoile avec la troisième forme normale. En règle générale, selon le principe : données sources — 3NF, vitrines — étoile. Cette approche, validée par le temps et soutenue par de nombreuses recherches, est la première (et parfois la seule) idée qui vient à l'esprit d'un expert DWH lorsqu'il pense à l'apparence d'un entrepôt analytique.
D'autre part, le monde des affaires dans son ensemble et les exigences des clients en particulier ont tendance à changer rapidement, tandis que les données continuent de croître à la fois en profondeur et en largeur. C'est ici que se révèle le principal inconvénient du modèle en étoile : sa flexibilité limitée. flexibilité.
Et si, dans votre vie tranquille et confortable de développeur DWH, soudainement :
- une tâche est apparue pour « faire rapidement quelque chose, et nous verrons plus tard » ;
- un projet en plein essor est arrivé, avec l'intégration de nouvelles sources et le remodelage du modèle d'affaires au moins une fois par semaine ;
- un client, qui n’a aucune idée de l’apparence et des fonctions finales du système, mais est prêt à expérimenter et à affiner progressivement le résultat souhaité tout en s’approchant de celui-ci ;
- un chef de projet s'est présenté avec la bonne nouvelle : « Eh bien, maintenant nous avons l'agile ! »
Ou si vous souhaitez simplement savoir comment d'autres modèles d'entrepôts peuvent être construits - bienvenue sous le capot !
Que signifie « flexibilité »
D'abord, définissons les propriétés qu'un système doit posséder pour être qualifié de « flexible ».
Il convient de préciser que les propriétés décrites doivent se rapporter strictement au système, et non au processus de son développement. Par conséquent, si vous vouliez lire sur Agile en tant que méthodologie de développement, il vaut mieux consulter d'autres articles. Par exemple, ici même sur Habr, il existe de nombreux matériaux intéressants (comme et , et via ).
Cela ne signifie pas que le processus de développement et la structure du DWH ne sont pas liés. En général, développer un entrepôt avec une architecture flexible en suivant le principe Agile devrait être nettement plus facile. Cependant, dans la pratique, on rencontre plus souvent des cas de développement d'un DWH classique selon Kimball et DataVault en waterfall que de coïncidences heureuses de flexibilité entre les deux approches dans un même projet.
Alors, quelles capacités un entrepôt flexible doit-il posséder ? On peut souligner trois points :
- Livraison anticipée et modifications rapides — cela signifie qu'idéalement, le premier résultat commercial (par exemple, les premiers rapports fonctionnels) doit être obtenu le plus tôt possible, c'est-à-dire avant même que le système soit entièrement conçu et mis en œuvre. Chaque amélioration suivante doit également prendre le moins de temps possible.
- Amélioration itérative — cela signifie que chaque amélioration suivante ne doit idéalement pas affecter les fonctionnalités déjà en place. Ce point devient souvent le plus grand cauchemar sur de grands projets : tôt ou tard, certains objets commencent à accumuler tant de connexions qu'il devient plus simple de reproduire complètement la logique à côté plutôt que d'ajouter un champ dans une table existante. Et si vous êtes étonné que l'analyse de l'impact d'une amélioration sur les objets existants puisse prendre plus de temps que l'amélioration elle-même, vous n'avez probablement pas encore travaillé avec de grands DWH dans le secteur bancaire ou des télécommunications.
- Adaptation continue aux exigences changeantes des entreprises — la structure d'objets générale doit être conçue non seulement en tenant compte des extensions possibles, mais en prévoyant que l'orientation de cette extension ne pourrait même pas vous venir à l'esprit au stade de la conception.
Et oui, répondre à toutes ces exigences dans un seul système est possible (évidemment, dans certains cas et avec certaines réserves).
Ci-dessous, je vais examiner deux des méthodologies de conception flexible les plus populaires pour les DWH — Modèle d'ancrage et Data Vault. Rester en dehors de telles merveilleuses techniques, comme l'EAV, la 6NF (dans sa forme pure) et tout ce qui concerne les solutions NoSQL — non pas parce qu'elles sont en quelque sorte inférieures, et même pas parce que cet article risquerait d'avoir le volume d'une thèse moyenne. Simplement, tout cela concerne des solutions de classe différente — soit des techniques que vous pouvez appliquer dans des cas spécifiques, indépendamment de l'architecture générale de votre projet (comme l'EAV), soit des paradigmes globaux différents de stockage de l'information (comme les bases de données graphiques et autres options NoSQL).
Les problèmes de l'approche « classique » et leurs solutions dans les méthodologies flexibles
Par « approche classique », j'entends la bonne vieille étoile (quelle que soit la mise en œuvre spécifique des couches sous-jacentes, que les adeptes de Kimball, Inmon et CDM me pardonnent).
1. La cardinalité stricte des relations
À la base de ce modèle se trouve une séparation claire des données en dimensions (Dimension) et faits (Fact). Et c'est, bon sang, logique — car l'analyse des données, dans la grande majorité des cas, se résume précisément à l'analyse de certains indicateurs numériques (faits) sous certains angles (dimensions).
Les relations entre les objets sont établies sous forme de liens entre les tables par une clé étrangère. Cela semble tout à fait naturel, mais entraîne immédiatement la première limitation de la flexibilité — la définition stricte de la cardinalité des relations.
. Cela signifie qu'à l'étape de conception des tables, vous devez définir avec précision pour chaque paire d'objets liés s'ils peuvent être de type plusieurs-à-plusieurs, ou uniquement un-à-plusieurs, et dans quel sens. Cela dépend directement de laquelle des tables aura la clé primaire et laquelle aura la clé étrangère. Le changement de cette relation lors de l'obtention de nouvelles exigences entraînera très probablement une refonte de la base.
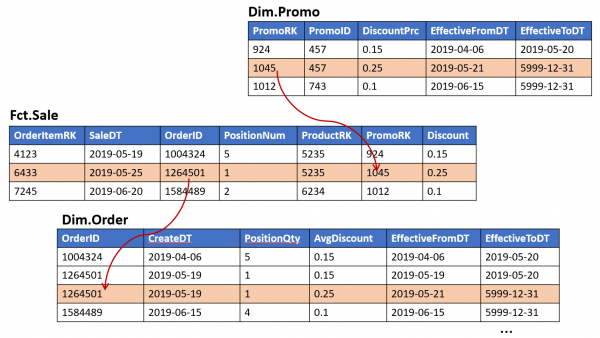
Par exemple, en concevant l'objet « reçu de caisse », vous vous êtes appuyé sur les promesses solennelles du département des ventes pour prévoir la possibilité d'une action d'une promotion sur plusieurs positions de reçus mais pas l'inverse :
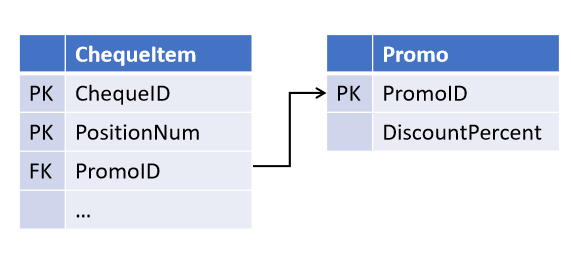
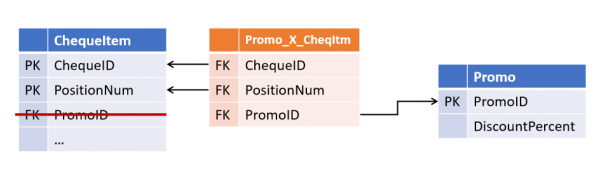
Et après un certain temps, les collègues ont introduit une nouvelle stratégie marketing, dans laquelle plusieurs promotions peuvent s'appliquer simultanément à une même position. Et maintenant, vous devez modifier les tables, en isolant la relation dans un objet séparé..
(Tous les objets dérivés où la vérification des promotions se produit doivent également être retravaillés maintenant).
Relations dans Data Vault et Modèle Ancre
Éviter une telle situation s'est avéré assez simple : il ne faut pas faire confiance au service des ventes pour cela. Conserver toutes les relations dans des tables séparées dès le départ. Et les traiter comme des plusieurs-à-plusieurs.
Cette approche a été proposée par Dan Linstedt comme partie de la paradigme Data Vault et entièrement soutenue par Lars Rönnbäck dans Modèle Ancre.
Au final, nous obtenons la première caractéristique distinctive des méthodologies flexibles :
Les relations entre objets ne sont pas stockées dans les attributs des entités parent, mais représentent un type d'objet distinct.
Dans Data Vault Ces tables de liaison sont appelées Link, et dans Modèle Ancre — Tie. À première vue, elles se ressemblent beaucoup, bien que leurs différences ne se limitent pas simplement à leur nom (nous en discuterons plus bas). Dans les deux architectures, les tables de liaison peuvent relier un nombre quelconque d'entités (pas nécessairement 2).
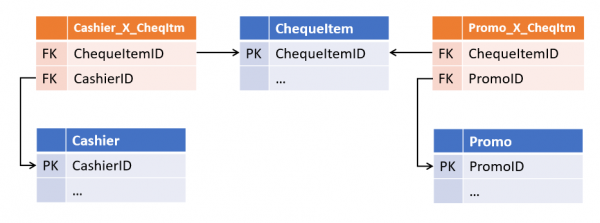
Cette redondance apparente offre une flexibilité significative lors des modifications. Cette structure devient tolérante non seulement aux changements de cardinalité des relations existantes, mais aussi à l'ajout de nouvelles — si maintenant la position de caisse a aussi un lien avec le caissier qui l'a enregistrée, l'apparition de ce lien devient simplement un surcroît par rapport aux tables existantes sans affecter les objets et processus actuels.
2. Duplication des données
Le deuxième problème que les architectures flexibles résolvent est moins évident et est principalement caractéristique des mesures de type SCD2 (mesures lentement changeantes de deuxième type), bien que pas seulement pour elles.
Dans un entrepôt classique, une mesure est généralement une table contenant une clé de substitution (en tant que PK) ainsi qu'un ensemble de clés et d'attributs commerciaux dans des colonnes séparées.
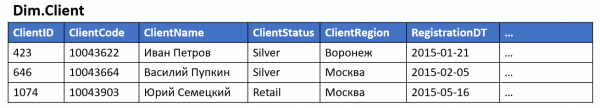
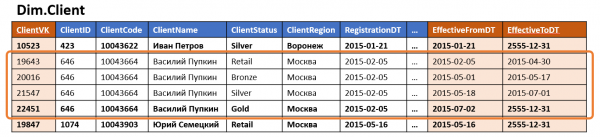
Si la mesure prend en charge la versioning, un ensemble standard de champs est complété par des bornes temporelles de validité de la version, et une ligne dans la source apparaît avec plusieurs versions dans l'entrepôt (une pour chaque changement des attributs versionnels).
Si une dimension contient au moins un attribut versionné souvent modifié, le nombre de versions de cette dimension sera considérable (même si les autres attributs ne sont pas versionnés ou ne changent jamais), et si plusieurs de ces attributs existent, le nombre de versions peut croître de manière exponentielle en fonction de leur quantité. Une telle dimension peut occuper une quantité substantielle d'espace disque, bien que la majorité des données stockées soient simplement des duplications des valeurs d'attributs inaltérables provenant d'autres lignes.
À cela s'ajoute très souvent la dénormalisation — une partie des attributs est intentionnellement stockée sous forme de valeur, et non comme référence à un répertoire ou une autre dimension. Cette approche accélère l'accès aux données, réduisant le nombre de jointures lors de l'interrogation de la dimension.
En général, cela conduit à ce que la même information soit stockée simultanément à plusieurs endroits. Par exemple, les informations concernant la région de résidence et l'appartenance à une catégorie de client peuvent être simultanément stockées dans les dimensions « Client », ainsi que dans les faits « Achat », « Livraison » et « Appels au centre d'appel », en plus de la table de correspondance « Client — Responsable Client ».
Dans l'ensemble, ce qui a été décrit ci-dessus s'applique également aux dimensions ordinaires (non versionnées), mais dans le cas des dimensions versionnées, cela peut avoir une autre ampleur : l'apparition d'une nouvelle version d'un objet (surtout rétroactivement) ne se limite pas simplement à la mise à jour de toutes les tables associées, mais entraîne une apparition en cascade de nouvelles versions des objets concernés — lorsque la Table 1 est utilisée pour construire la Table 2, et la Table 2 — pour construire la Table 3, etc. Même si aucun attribut de la Table 1 n'est impliqué dans la construction de la Table 3 (d'autres attributs de la Table 2, obtenus d'autres sources, le sont), la mise à jour versionnée de cette construction entraînera au minimum des frais supplémentaires, et au maximum des versions superflues dans la Table 3, qui n'est ici
3. Complexité non linéaire des modifications
À cela s'ajoute que chaque nouvelle vitrine construite sur la base d'une autre augmente le nombre d'endroits où les données peuvent « diverger » lors de modifications dans l'ETL. Cela, à son tour, entraîne une augmentation de la complexité (et de la durée) de chaque modification suivante.
Si ce qui précède concerne des systèmes avec des processus ETL rarement développés, il est possible de vivre dans cette paradigme — il suffit de veiller à ce que les nouvelles modifications soient correctement intégrées dans tous les objets associés. Toutefois, si les modifications se produisent fréquemment, la probabilité d'“oublier” accidentellement plusieurs relations augmente considérablement.
De plus, si l'on considère que l'ETL "versionné" est nettement plus complexe que l'ETL "non versionné", éviter les erreurs lors de la modification fréquente de l'ensemble de ce système devient suffisamment difficile.
Stockage des objets et des attributs dans le Data Vault et le modèle Anchor
L'approche proposée par les auteurs des architectures flexibles peut se formuler ainsi :
Il est nécessaire de séparer ce qui change de ce qui reste constant. Autrement dit, stocker les clés séparément des attributs.
Il convient néanmoins de ne pas confondre non versionné attribut avec constant: le premier ne conserve pas l'historique de ses changements, mais peut changer (par exemple, lors de la correction d'une erreur de saisie ou de l'obtention de nouvelles données), le second — ne change jamais.
Les opinions sur ce qui peut effectivement être considéré comme constant dans le Data Vault et le modèle Anchor varient.
D'un point de vue architectural, Data Vaultce qui est constant peut être considéré comme l'ensemble des clés — clés naturelles (comme le numéro d'identification de l'organisation, le code produit dans le système source, etc.) et clés de substitution. Dans ce cas, les autres attributs peuvent être classés par groupes selon leur source et/ou leur fréquence de modification et pour chaque groupe, maintenir une table distincte avec un ensemble de versions indépendantes.
Dans la paradigme Anchor Model ce qui est constant est considéré comme seulement la clé de substitution de l'entité. Tout le reste (y compris les clés naturelles) n'est qu'un cas particulier de ses attributs. Dans ce cadre, tous les attributs sont par défaut indépendants les uns des autres, c'est pourquoi pour chaque attribut, une table distincte doit être créée..
Dans Data Vault Les tables contenant les clés des entités sont appelées Hubs.Les Hubs contiennent toujours un ensemble fixe de champs :
- Clés naturelles de l'entité
- Clé de substitution
- Lien vers la source
- Date d'ajout de l'enregistrement.
Les enregistrements dans les Hubs ne changent jamais et n'ont pas de versions.. Les hubs ressemblent beaucoup aux tables de type ID-map, utilisées dans certains systèmes pour générer des surrogats, cependant, il est recommandé d'utiliser un hachage de l'ensemble des clés métiers comme surrogat dans le Data Vault plutôt qu'une séquence entière. Cette approche simplifie le chargement des relations et des attributs des sources (il n'est pas nécessaire de se joindre au hub pour obtenir le surrogat, il suffit de calculer le hachage de la clé naturelle), mais peut provoquer d'autres problèmes (par exemple, liés aux collisions, à la casse et aux caractères non imprimables dans les clés de chaîne, etc.), ce qui fait qu'elle n'est pas universellement adoptée.
Tous les autres attributs des entités sont stockés dans des tables spéciales, appelées Satellites (Satellit). Un hub peut avoir plusieurs satellites, stockant différents ensembles d'attributs.
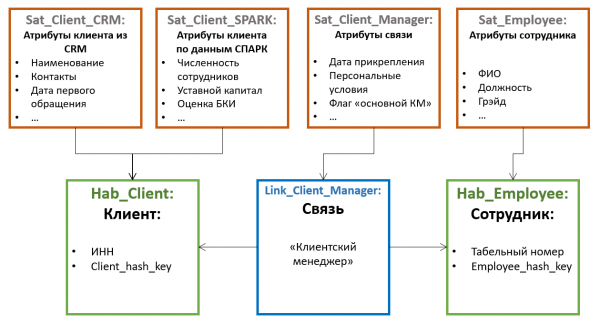
La distribution des attributs entre les satellites se fait selon le principe de changement conjoint — un satellite peut contenir des attributs non versionnés (par exemple, la date de naissance et le SNILS pour les personnes physiques), un autre — des attributs versionnés rarement modifiés (par exemple, le nom de famille et le numéro de passeport), un troisième — des attributs souvent modifiés (par exemple, l'adresse de livraison, catégorie, date de dernière commande, etc.). La version est gérée au niveau de chaque satellite, et non de l'entité dans son ensemble, c'est pourquoi il est judicieux de répartir les attributs de manière à réduire au minimum l'intersection des versions au sein d'un même satellite (ce qui réduit le nombre total de versions stockées).
De plus, pour optimiser le processus de chargement des données, des attributs provenant de différentes sources sont souvent extraits dans des satellites distincts.
Les satellites sont liés au hub par une clé étrangère (ce qui correspond à une cardinalité de 1 à plusieurs). Cela signifie que des valeurs multiples d'attributs (par exemple, plusieurs numéros de téléphone pour un client) sont prises en charge par cette architecture “par défaut”.
Dans Le modèle d'ancrage (Anchor Model) les tables stockant les clés sont appelées Ancres (Anchor). Elles stockent :
- Uniquement des clés surrogates
- Lien vers la source
- Date d'ajout de l'enregistrement.
Les clés naturelles, du point de vue du modèle d'ancrage, sont considérées comme des attributs ordinaires. Cette option peut sembler plus complexe à comprendre, mais elle offre beaucoup plus de liberté pour identifier un objet.
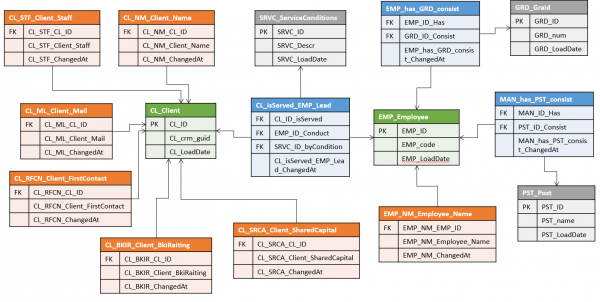
Par exemple, si les données concernant une même entité peuvent provenir de différents systèmes, chacun utilisant sa propre clé naturelle. Dans le Data Vault, cela peut conduire à des constructions assez encombrantes avec plusieurs hubs (un par source + une version master unificatrice), tandis que dans le modèle Ancre, la clé naturelle de chaque source est placée dans son propre attribut et peut être utilisée lors du chargement indépendamment des autres.
Mais il y a un détail sournois : si des attributs d'une même entité sont regroupés à partir de différents systèmes, il y a de fortes chances qu'il existe certaines règles de "fusion", selon lesquelles le système doit comprendre que les enregistrements provenant de différentes sources correspondent à une même instance de l'entité.
Dans Data Vault Ces règles détermineront probablement la formation d'un "hub de substitution" de l'entité master et n'influenceront pas les hubs qui stockent les clés naturelles des sources et leurs attributs d'origine. Si à un moment donné les règles de fusion changent (ou si une mise à jour des attributs selon lesquels elle est réalisée arrive), il suffira de reformer les hubs de substitution.
Dans Dans le modèle Ancre , une telle entité sera probablement stockée dans une seule ancre. Cela signifie que tous les attributs, peu importe leur source, seront liés à un même substitut. Séparer des enregistrements fusionnés par erreur et suivre la pertinence de la fusion dans un tel système pourrait s'avérer beaucoup plus difficile, surtout si les règles sont assez complexes et changent fréquemment, et qu'un même attribut peut provenir de différentes sources (bien que cela soit précisément possible, car chaque version de l'attribut conserve un lien avec sa source).
Quoi qu'il en soit, si votre système envisage la mise en œuvre de la fonctionnalité de dé-duplication, de fusion d'enregistrements et d'autres éléments MDM, il convient de prêter une attention particulière aux aspects de stockage des clés naturelles dans des méthodologies flexibles. Il est probable qu'une construction plus encombrante de Data Vault s'avère soudainement plus sûre en ce qui concerne les erreurs de fusion.
Le modèle Ancre prévoit également un type d'objet supplémentaire appelé Nœud (Knot) qui est en fait un type spécial réduit d'ancre., qui peut contenir un seul attribut. Les nœuds sont supposés être utilisés pour stocker des annuaires plats (par exemple, le sexe, l'état civil, la catégorie de service à la clientèle, etc.). Contrairement à l'Ancre, le Nœud n'a pas de tables d'attributs liées, et son unique attribut (le nom) est toujours stocké dans une seule table avec la clé. Les nœuds sont liés aux Ancres par des tables de liaison (Tie) de la même manière que les ancres entre elles.
Il n'y a pas d'avis unanime sur l'utilisation des Nœuds. Par exemple, , qui promeut activement l'application du modèle d'Ancre en Russie, estime (non sans raison) qu'il est difficile d'affirmer avec certitude qu'un annuaire ont toujours sera statique et unidimensionnel, il est donc préférable d'utiliser directement une vraie Ancre pour tous les objets.
Une autre différence importante entre Data Vault et le modèle d'Ancre réside dans la présence d'attributs pour les relations.:
Dans Data Vault Les relations sont des objets à part entière, tout comme les Hubs, et peuvent avoir leurs propres attributs.. Il y a Dans le modèle Ancre Les relations ne sont utilisées que pour relier des Ancres et ne peuvent pas avoir leurs propres attributs.. Cette distinction donne lieu à des approches de modélisation très différentes des faits,ce dont nous parlerons ensuite.
Le stockage des faits
Jusqu'à présent, nous avons principalement parlé de la modélisation des dimensions. Les faits sont un peu moins clairs.
Dans Data Vault un objet typique pour le stockage des faits est la Relation (Link), dans les Satellites desquels sont accumulés des indicateurs tangibles.
Cette approche semble intuitivement compréhensible. Elle donne un accès facile aux indicateurs analysés et ressemble dans l'ensemble à une table de faits traditionnelle (seulement les indicateurs ne sont pas stockés dans la table elle-même, mais dans la 'voisine'). Mais il y a des inconvénients : l'une des modifications typiques du modèle — l'extension de la clé du fait — nécessite l'ajout d'une nouvelle clé étrangère dans le Link.Cela, à son tour, casse la modularité et pourrait nécessiter des modifications d'autres objets.
Dans Dans le modèle Ancre La Relation ne peut pas avoir ses propres attributs, donc cette approche ne fonctionnera pas — absolument tous les attributs et indicateurs doivent être liés à une Ancre spécifique. La conclusion est simple — chaque fait a également besoin de sa propre ancre.. Pour certaines choses que nous avons appris à considérer comme des faits, cela peut sembler naturel — par exemple, le fait d'acheter se résume bien à un objet “commande” ou “reçu”, la visite d'un site web — à une session, etc. Mais il existe aussi des faits pour lesquels il n'est pas si simple de trouver un “objet-support” naturel — par exemple, les stocks de produits en entrepôt au début de chaque jour.
En conséquence, il n’y a pas de problèmes de modularité lors de l’élargissement de la clé de fait dans le modèle d’ancrage (il suffit d’ajouter une nouvelle relation à l’ancre correspondante), mais la conception du modèle pour afficher les faits est moins évidente, des ancres “artificielles” peuvent apparaître, représentant le modèle objet de l’entreprise de manière moins évidente.
Comment atteint-on la flexibilité
La structure obtenue dans les deux cas contient considérablement plus de tables, que la mesure traditionnelle. Mais elle peut occuper considérablement moins d'espace disque avec le même ensemble d'attributs versionnels que la mesure traditionnelle. Pas de magie ici, bien sûr — il s'agit simplement de normalisation. En répartissant les attributs sur des satellites (dans le Data Vault) ou sur des tables distinctes (modèle d'ancrage), nous réduisons (ou éliminons complètement) la duplication des valeurs de certains attributs lors du changement d'autres.
Pour Data Vault le gain dépendra de la répartition des attributs sur les satellites, et pour Dans le modèle Ancre — sera pratiquement directement proportionnel au nombre moyen de versions de l’objet de mesure.
Cependant, le gain en espace occupé est un avantage important, mais ce n'est pas le principal avantage d'un stockage distinct des attributs. Avec le stockage distinct des relations, cette approche rend le entrepôt une construction modulaire. Cela signifie que l'ajout d'attributs individuels, ainsi que de nouvelles domaines thématiques dans un tel modèle, se présente comme un surajout au jeu d'objets existants sans les modifier. Et c'est précisément ce qui rend les méthodologies décrites flexibles.
Cela rappelle également le passage de la production à l'unité à la production de masse — si, dans l'approche traditionnelle, chaque table du modèle est unique et nécessite une attention particulière, dans les méthodologies flexibles — il s'agit déjà d'un ensemble de “détails” standard. D'un côté, il y a plus de tables, les processus de chargement et de récupération des données doivent sembler plus complexes. D'un autre côté — ils deviennent standardisés. Ce qui signifie qu'ils peuvent être automatisés et gérés par des métadonnées. La question « comment allons-nous nous organiser ? », dont la réponse pouvait représenter une part importante des travaux de conception des modifications, ne se pose plus (tout comme la question de l'impact d'un changement de modèle sur les processus en cours).
Cela ne signifie pas que les analystes ne sont pas du tout nécessaires dans un tel système : quelqu'un doit encore travailler sur un ensemble d'objets avec des attributs et comprendre d'où et comment tout cela doit être chargé. Mais le volume de travail, ainsi que la probabilité et le coût d'erreur, diminuent considérablement. À la fois lors de l'analyse et lors du développement de l'ETL, qui peut dans une large mesure se résumer à l'édition de métadonnées.
Le côté obscur
Tout ce qui précède rend les deux approches réellement flexibles, technologiques et adaptées à des modifications itératives. Bien sûr, il y a aussi un « pot de miel » dont vous, je pense, vous doutez déjà.
La décomposition des données, qui sous-tend la modularité des architectures flexibles, entraîne une augmentation du nombre de tables et, par conséquent, de frais généraux pour les jointures lors des sélections. Pour obtenir simplement tous les attributs d'une dimension, un seul select suffit dans un entrepôt classique, tandis qu'une architecture flexible nécessitera une série de jointures. En effet, si pour les rapports toutes ces jointures peuvent être écrites à l'avance, les analystes habitués à écrire du SQL à la main souffriront deux fois plus.
Il existe plusieurs faits qui facilitent cette situation :
Lors du traitement de grandes dimensions, presque tous ses attributs ne sont jamais utilisés simultanément. Cela signifie que le nombre de jointures peut être inférieur à ce qu'il semble au premier coup d'œil sur le modèle. Dans le Data Vault, on peut également prendre en compte la fréquence estimée de l'utilisation conjointe lors de la répartition des attributs dans les satellites. Les Hubs ou Ancrages eux-mêmes sont principalement nécessaires pour la génération et le mappage des substituts lors de la charge, et sont rarement utilisés dans les requêtes (surtout en ce qui concerne les Ancrages).
Toutes les jointures sont basées sur des clés. De plus, un moyen de stockage des données plus « compressé » réduit les frais généraux liés à l'analyse des tables lorsqu'elle est nécessaire (par exemple lors du filtrage par valeur d'attribut). Cela peut amener à ce qu'une extraction d'une base normalisée avec plusieurs jointures soit même plus rapide que le scan d'une seule dimension lourde avec de nombreuses versions par ligne.
Par exemple, dans cet article, il y a un test comparatif détaillé des performances du modèle d'ancrage avec extraction d'une seule table.
Beaucoup dépend du moteur. De nombreuses plateformes modernes disposent de mécanismes d'optimisation internes pour les jointures. Par exemple, MS SQL et Oracle sont capables de « sauter » les jointures sur des tables si leurs données ne sont utilisées nulle part ailleurs, sauf dans d'autres jointures, et n'affectent pas l'extraction finale (élimination des tables/jointures), tandis que MPP Vertica, d'après , s'est avéré être un excellent moteur pour le modèle d'ancrage, en tenant compte de certaines optimisations manuelles du plan de requête. D'un autre côté, stocker le modèle d'ancrage, par exemple, sur Click House, qui a un support limité des jointures, ne semble pas être une très bonne idée.
De plus, pour les deux architectures, il existe des techniques spéciales, facilitant l'accès aux données (tant du point de vue des performances des requêtes que pour les utilisateurs finaux). Par exemple, les tables Point-In-Time dans Data Vault ou des fonctions de table spéciales dans le modèle d'ancrage.
Au total
L'essence des architectures flexibles examinées réside dans la modularité de leur "construction".
C'est précisément cette propriété qui permet :
- Après une préparation initiale liée au déploiement des métadonnées et à l'écriture des algorithmes ETL de base, de fournir rapidement au client le premier résultat sous la forme de quelques rapports contenant des données de quelques objets sources. Il n'est pas nécessaire de penser complètement (même à un niveau supérieur) à tout le modèle objet pour cela.
- Le modèle de données peut commencer à fonctionner (et à apporter des bénéfices) avec seulement 2 à 3 objets, puis se développer progressivement (par rapport au modèle d'ancrage, Nikolai une belle comparaison avec le mycélium).
- La plupart des améliorations, y compris l'expansion du domaine thématique et l'ajout de nouvelles sources n'affectent pas la fonctionnalité existante et ne risquent pas de casser quelque chose qui fonctionne déjà..
- Grâce à la décomposition en éléments standards, les processus ETL dans de tels systèmes ont une apparence uniforme, leur rédaction peut être automatisée et, en fin de compte, automatisée.
Le prix de cette flexibilité est la performance. Cela ne signifie pas qu'il est impossible d'atteindre une performance acceptable avec de tels modèles. La plupart du temps, il peut simplement vous falloir plus d'efforts et d'attention aux détails pour atteindre les métriques souhaitées.
Applications
Types d'entités Data Vault
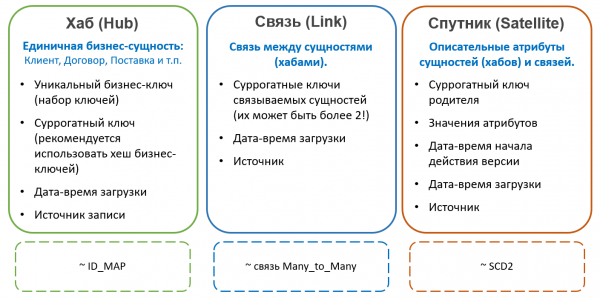
En savoir plus sur le Data Vault :
Types d'entités Anchor Model
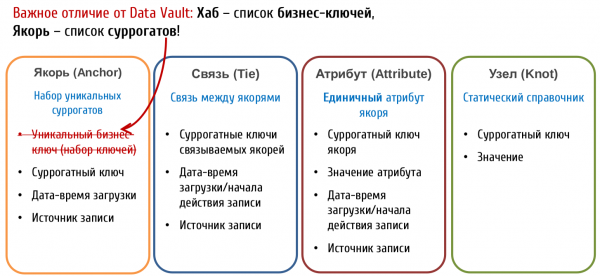
En savoir plus sur le modèle d'ancrage :
Tableau récapitulatif des caractéristiques communes et des différences des approches examinées :
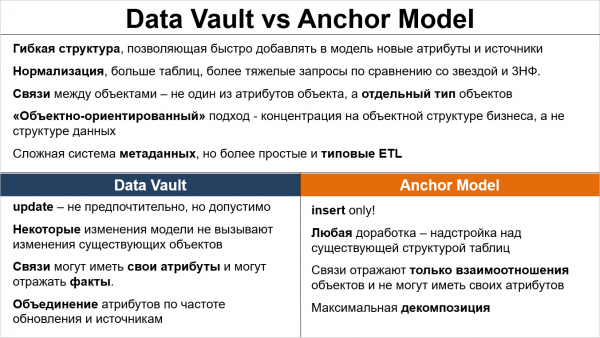
Source : habr.com
