

Les services de cloud computing pénètrent de plus en plus dans notre vie, et il est probablement rare de trouver une personne qui n'a jamais utilisé un service cloud au moins une fois. Cependant, qu'est-ce que c'est que le cloud et comment cela fonctionne ? Peu de gens connaissent même le concept au niveau des idées. La 5G devient déjà une réalité, et l'infrastructure télécom commence à passer de solutions traditionnelles à des solutions basées sur le cloud, tout comme cela s'est produit lors de la transition des solutions 100% matérielles vers des « colonnes » virtualisées.
Aujourd'hui, nous allons parler de l'univers interne de l'infrastructure cloud, en particulier des bases de la partie réseau.
Qu'est-ce que le cloud ? Est-ce que la virtualisation en est une vue d'ensemble ?
C'est une question tout à fait logique. Non, ce n'est pas de la virtualisation, bien que cela y soit lié. Considérons deux définitions :
Le cloud computing (ci-après le Cloud) est un modèle fournissant un accès convivial à des ressources de calcul distribuées, qui doivent être déployées et lancées à la demande avec un minimum de latence et de coûts pour le fournisseur de services.
Virtualisation c'est la capacité de diviser une entité physique (par exemple, un serveur) en plusieurs entités virtuelles, augmentant ainsi l'utilisation des ressources (par exemple, si vous aviez 3 serveurs chargés à 25-30 %, après virtualisation, vous obtiendrez 1 serveur chargé à 80-90 %). Évidemment, la virtualisation consomme une partie des ressources — il faut alimenter l'hyperviseur, mais comme l'a montré la pratique, cela en vaut la peine. Un exemple idéal de virtualisation est VMWare, qui prépare très bien les machines virtuelles, ou par exemple KVM, qui est celui que je préfère, mais c'est là une question de goût.
Nous utilisons la virtualisation sans même nous en rendre compte, même les routeurs matériels utilisent déjà la virtualisation — par exemple, dans les dernières versions de JunOS, le système d'exploitation est installé comme une machine virtuelle au-dessus d'une distribution linux en temps réel (Wind River 9). Mais la virtualisation n'est pas un cloud, cependant, un cloud ne peut exister sans virtualisation.
La virtualisation est un des blocs de construction sur lequel repose le cloud.
Créer un cloud en rassemblant simplement plusieurs hyperviseurs dans un seul domaine L2, en ajoutant quelques playbooks yaml pour l'automatisation de la configuration des VLAN via un outil comme Ansible, et en superposant un système d'orchestration pour la création automatique de machines virtuelles — cela ne fonctionnera pas. En fait, cela fonctionnera, mais le Frankenstein obtenu n'est pas le cloud dont nous avons besoin, bien que pour certains cela puisse représenter un rêve. De plus, si l'on prend OpenStack — c'est en grande partie un autre Frankenstein, mais bref, ne parlons pas de cela pour le moment.
Mais je comprends que la définition ci-dessus n'explique pas vraiment ce que l'on peut considérer comme un cloud.
C'est pourquoi le document du NIST (National Institute of Standards and Technology) présente 5 caractéristiques fondamentales que doit avoir une infrastructure cloud :
Fourniture de services à la demande. L'utilisateur doit avoir un accès libre aux ressources informatiques qui lui sont attribuées (telles que les réseaux, les disques virtuels, la mémoire, les cœurs de processeurs, etc.), et ces ressources doivent être fournies automatiquement — c'est-à-dire sans intervention de la part du fournisseur de services.
Accessibilité étendue des services. L'accès aux ressources doit être assuré par des mécanismes standard pour permettre l'utilisation tant sur des PC standards que sur des clients légers et des appareils mobiles.
Consolidation des ressources en pools. Les pools de ressources doivent permettre la fourniture simultanée de ressources à plusieurs clients, garantissant l'isolement des clients et l'absence d'interférences ou de concurrence pour les ressources. Les réseaux sont également inclus dans les pools, ce qui permet l'utilisation d'adressage croisé. Les pools doivent supporter l'évolutivité à la demande. L'utilisation de pools permet d'assurer le niveau nécessaire de résilience des ressources et l'abstraction des ressources physiques et virtuelles — le bénéficiaire du service reçoit simplement l'ensemble de ressources qu'il a demandé (peu importe où ces ressources sont physiquement situées, sur combien de serveurs et de commutateurs — cela n'intéresse pas le client). Cependant, il est important que le fournisseur assure une transparence dans la réserve de ces ressources.
Adaptation rapide à diverses conditions. Les services doivent être flexibles : provisionnement rapide des ressources, redistribution, ajout ou réduction des ressources sur demande du client. Le client doit avoir l'impression que les ressources du cloud sont infinies. Pour faciliter la compréhension, par exemple, vous ne recevez pas d'avertissement lorsque vous perdez une partie de l'espace disque dans Apple iCloud en raison d'un disque dur défaillant sur le serveur, car les disques tombent en panne. De plus, de votre côté, les possibilités de ce service sont pratiquement illimitées : si vous avez besoin de 2 To, pas de problème, vous payez et vous les obtenez. Un exemple similaire peut être donné avec Google Drive ou Yandex Disk.
La possibilité de mesurer le service fourni. Les systèmes cloud doivent contrôler automatiquement et optimiser les ressources consommées, et ces mécanismes doivent être transparents tant pour l'utilisateur que pour le fournisseur de services. Cela signifie que vous pouvez toujours vérifier combien de ressources vous et vos clients consommez.
Il convient de prendre en compte le fait que ces exigences sont principalement des exigences pour le cloud public, donc pour un cloud privé (c'est-à-dire un cloud lancé pour les besoins internes de l'entreprise), ces exigences peuvent être légèrement ajustées. Cependant, elles doivent toujours être respectées, sinon nous ne tirerons pas tous les avantages du cloud computing.
Pourquoi avons-nous besoin d'un cloud ?
Cependant, toute nouvelle technologie ou tout protocole existant est créé pour quelque chose (à l'exception de RIP-ng, bien sûr). Un protocole pour le protocole ne sert à rien (à l'exception de RIP-ng, bien sûr). Il est logique que le Cloud soit créé pour fournir un service à l'utilisateur/client. Nous connaissons tous au moins quelques services cloud, comme Dropbox ou Google Docs, et je suppose que la plupart d'entre nous les utilisent avec succès — par exemple, cet article a été écrit en utilisant le service cloud Google Docs. Mais les services cloud que nous connaissons ne représentent qu'une partie des possibilités du cloud — plus précisément, ce n'est qu'un service de type SaaS. Nous pouvons fournir un service cloud de trois manières : sous forme de SaaS, PaaS ou IaaS. Le service dont vous avez besoin dépend de vos souhaits et possibilités.
Examinons chaque cas dans l'ordre :
Software as a Service (SaaS) — c'est un modèle de fourniture d'un service complet au client, par exemple un service de messagerie comme Yandex.Mail ou Gmail. Dans ce modèle de fourniture de service, vous, en tant que client, ne faites en fait rien d'autre que d'utiliser le service — c'est-à-dire que vous n'avez pas à penser à la configuration du service, à sa résilience ou à la sauvegarde. L'essentiel est de ne pas compromettre votre mot de passe, tout le reste sera géré par le fournisseur de ce service. Du point de vue du fournisseur de service, il est entièrement responsable de l'ensemble du service — depuis le matériel serveur et les systèmes d'exploitation hôtes jusqu'aux configurations des bases de données et des logiciels.
Platform as a Service (PaaS) — en utilisant ce modèle, le fournisseur de services fournit au client un cadre pour le service, prenons par exemple un serveur Web. Le fournisseur de services a fourni au client un serveur virtuel (en fait un ensemble de ressources telles que RAM/CPU/Stockage/Réseaux, etc.), et a même installé le système d'exploitation et les logiciels nécessaires sur ce serveur, cependant, la configuration de tout cela est effectuée par le client et c'est le client qui est responsable du fonctionnement du service. Le fournisseur de services, comme dans le cas précédent, est responsable du fonctionnement du matériel physique, des hyperviseurs, de la machine virtuelle elle-même, de sa disponibilité réseau, etc., mais le service lui-même est déjà hors de sa zone de responsabilité.
Infrastructure as a Service (IaaS) — cette approche est déjà plus intéressante, en fait le fournisseur de services fournit au client une infrastructure virtualisée complète — c'est-à-dire un certain ensemble (pool) de ressources telles que Cœurs CPU, RAM, Réseaux, etc. Tout le reste est l'affaire du client — ce que le client veut faire avec ces ressources dans le cadre du pool (quota) qui lui est attribué — au fournisseur, cela n'intéresse pas vraiment. Si le client souhaite créer son propre vEPC ou même devenir un petit opérateur et fournir des services de communication — pas de problème — faites-le. Dans ce scénario, le fournisseur de services est responsable de la fourniture des ressources, de leur résilience et de leur disponibilité, ainsi que du système d'exploitation permettant de regrouper ces ressources en pools et de les fournir au client avec la possibilité d'augmenter ou de réduire les ressources à tout moment à la demande du client. Toutes les machines virtuelles et autres détails sont configurés par le client lui-même via le portail d'auto-service et la console, y compris la configuration des réseaux (à l'exception des réseaux externes).
Qu'est-ce qu'OpenStack ?
Dans les trois options, le fournisseur de services nécessite un système d'exploitation qui permet de créer une infrastructure cloud. En réalité, dans le cas du SaaS, un seul département ne gère pas l'ensemble de cette pile technologique — il existe un département qui gère l'infrastructure, c'est-à-dire qui fournit l'IaaS à un autre département, et ce dernier offre le SaaS au client. OpenStack est l'un des systèmes d'exploitation cloud qui permet de rassembler de nombreux commutateurs, serveurs et systèmes de stockage en un pool de ressources unique, de diviser ce pool général en sous-pools (tenants) et de fournir ces ressources aux clients via le réseau.
OpenStack — est un système d'exploitation cloud qui permet de contrôler de grands pools de ressources informatiques, de stockage de données et de ressources réseau, dont le provisionnement et la gestion se font via une API en utilisant des mécanismes d'authentification standard.
En d'autres termes, il s'agit d'un ensemble de projets de logiciels libres destinés à créer des services cloud (publics et privés) — c'est-à-dire un ensemble d'outils permettant de consolider le matériel serveur et de commutation en un pool unique de ressources, de gérer ces ressources tout en assurant le niveau de tolérance aux pannes requis.
Au moment de la rédaction de ce document, la structure d'OpenStack est la suivante :
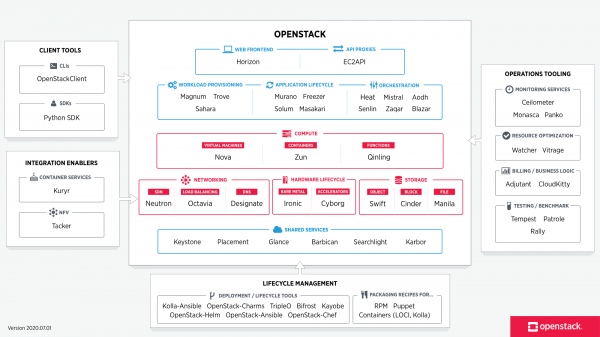
L'image est tirée de
Chaque composant d'OpenStack remplit une fonction précise. Cette architecture distribuée permet d'inclure dans la solution le jeu de composants fonctionnels dont vous avez besoin. Cependant, certaines composantes sont considérées comme des composants fondamentaux et leur suppression entraînera une inopérabilité totale ou partielle de la solution dans son ensemble. Parmi ces composants fondamentaux, on distingue :
- Tableau de bord — Interface graphique web pour gérer les services OpenStack
- Keystone — Service d'identification centralisé, qui fournit des fonctionnalités d'authentification et d'autorisation pour d'autres services, ainsi que la gestion des identifiants des utilisateurs et de leurs rôles.
- Neutron — Service réseau, assurant la connectivité entre les interfaces des différents services OpenStack (y compris la connectivité entre les VM et leur accès au monde extérieur)
- Cinder — Fournit l'accès à un stockage en bloc pour les machines virtuelles
- Nova — gestion du cycle de vie des machines virtuelles
- Glance — dépôt d'images de machines virtuelles et de snapshots
- Swift — fournit un accès à un stockage d'objets
- Ceilometer — service qui permet de collecter des télémétries et de mesurer les ressources disponibles et consommées
- Heat — orchestration basée sur des modèles pour la création et la provisionnement automatiques des ressources
Vous pouvez consulter la liste complète de tous les projets et leur fonction .
Chacune des composantes d'OpenStack est un service responsable d'une fonction spécifique et fournissant une API pour gérer cette fonction et interagir avec d'autres services du système d'exploitation cloud afin de créer une infrastructure unifiée. Par exemple, Nova gère les ressources de calcul et l'API pour accéder à la configuration de ces ressources, Glance – la gestion des images et l'API pour les gérer, Cinder – stockage en bloc et l'API pour le gérer, etc. Toutes les fonctions sont étroitement liées entre elles.
Cependant, si l'on y réfléchit, tous les services lancés dans OpenStack représentent en fin de compte une machine virtuelle (ou un conteneur) connectée au réseau. La question se pose — pourquoi avons-nous tant d'éléments ?
Passons en revue l'algorithme de création d'une machine virtuelle et de sa connexion au réseau et au stockage permanent dans OpenStack.
- Lorsque vous faites une demande de création de machine, que ce soit via Horizon (tableau de bord) ou via CLI, la première chose qui se produit est l'autorisation de votre demande par Keystone — pouvez-vous créer une machine, avez-vous le droit d'utiliser ce réseau, votre projet a-t-il suffisamment de quota, etc.
- Keystone authentifie votre demande et génère en réponse un jeton d'authentification qui sera utilisé par la suite. Une fois la réponse de Keystone reçue, la demande est envoyée à Nova (nova api).
- Nova-api vérifie la validité de votre demande en consultant Keystone, en utilisant le jeton d'authentification précédemment généré.
- Keystone procède à l'authentification et fournit, sur la base de ce jeton d'authentification, des informations sur les autorisations et les limitations.
- Nova-api crée un enregistrement de la nouvelle VM dans la base de données nova et transmet la demande de création de machine au nova-scheduler.
- Le planificateur Nova sélectionne un hôte (nœud de calcul) sur lequel la VM sera déployée en fonction des paramètres fournis, des poids et des zones. L'entrée correspondante et l'identifiant de la VM sont enregistrés dans la base de données nova.
- Ensuite, le planificateur Nova fait appel à nova-compute pour demander le déploiement d'une instance. Nova-compute interroge nova-conductor pour obtenir des informations sur les paramètres de la machine (nova-conductor est un élément de nova qui joue le rôle de serveur proxy entre nova-database et nova-compute, limitant le nombre de requêtes vers nova-database afin d'éviter des problèmes de cohérence de la base de données et de réduire la charge).
- Nova-conductor récupère les informations demandées dans nova-database et les transmet à nova-compute.
- Ensuite, nova-compute fait appel à glance pour obtenir l'ID de l'image. Glance valide la requête dans Keystone et renvoie les informations demandées.
- Nova-compute interroge neutron pour obtenir des informations sur les paramètres du réseau. De manière similaire à glance, neutron valide la requête dans Keystone, après quoi il crée une entrée dans la base de données (identifiant du port, etc.), crée une demande de création de port et renvoie les informations demandées à nova-compute.
- Nova-compute fait appel à cinder pour demander l'attribution d'un volume à la machine virtuelle. De manière similaire à glance, cinder valide la requête dans Keystone, crée une demande de création de volume et renvoie les informations demandées.
- Nova-compute fait appel à libvirt pour demander le déploiement de la machine virtuelle avec les paramètres spécifiés.
En réalité, une opération apparemment simple de création d'une machine virtuelle se transforme en un véritable tourbillon d'appels API entre les différents éléments de la plateforme cloud. Comme vous pouvez le constater, même les services précédemment mentionnés se composent également de composants plus petits, entre lesquels se produit une interaction. La création d'une machine n'est qu'une petite partie de ce que la plateforme cloud permet — il existe un service dédié à l'équilibrage du trafic, un service pour le stockage bloc, un service pour le DNS, un service pour le provisioning des serveurs bare metal, etc. Le cloud vous permet de considérer vos machines virtuelles comme un troupeau de moutons (contrairement à la virtualisation). Dans un environnement virtuel, si quelque chose arrive à la machine, vous la rétablissez à partir de sauvegardes, etc. Les applications cloud sont construites de telle manière que la machine virtuelle ne joue pas un rôle aussi important — si la machine virtuelle meurt, ce n'est pas grave : une nouvelle machine est simplement créée à partir d'un modèle, et comme on dit, l'unité ne remarque pas la perte d'un combattant. Naturellement, cela nécessite des mécanismes d'orchestration — en utilisant des modèles Heat, vous pouvez déployer sans trop de problèmes une fonction complexe composée de dizaines de réseaux et de machines virtuelles.
Il est toujours important de garder à l'esprit qu'il n'y a pas d'infrastructure cloud sans réseau — chaque élément interagit d'une manière ou d'une autre avec les autres éléments via le réseau. De plus, le cloud dispose d'un réseau absolument non statique. Évidemment, le réseau sous-jacent est encore relativement statique — de nouveaux nœuds et commutateurs ne sont pas ajoutés tous les jours, cependant, la composante overlay peut, et sera inévitablement, en constante évolution — de nouveaux réseaux seront ajoutés ou supprimés, de nouvelles machines virtuelles apparaîtront et d'anciennes disparaîtront. Et comme vous vous souvenez de la définition du cloud donnée au début de l'article — les ressources doivent être attribuées à l'utilisateur automatiquement et avec le moins (de préférence sans) d'intervention de la part du fournisseur de services. Donc, le type de fourniture de ressources réseau actuel, tel qu'il se présente dans le frontend de votre tableau de bord accessible via http/https et avec l'ingénieur réseau de garde Vasily comme backend — ce n'est pas le cloud, même avec les huit bras de Vasily.
Neutron, en tant que service réseau, fournit une API pour gérer la partie réseau de l'infrastructure cloud. Ce service assure le fonctionnement et la gestion de la partie réseau d'OpenStack en offrant un niveau d'abstraction appelé Network-as-a-Service (NaaS). Cela signifie que le réseau est une unité virtuelle mesurable, tout comme les cœurs virtuels de CPU ou la capacité de RAM.
Mais avant de passer à l'architecture de la partie réseau d'OpenStack, examinons comment ce réseau fonctionne dans OpenStack et pourquoi il est une partie importante et intégrante du cloud.
Nous avons donc deux machines virtuelles du client RED et deux machines virtuelles du client GREEN. Supposons que ces machines soient situées sur deux hyperviseurs de la manière suivante :
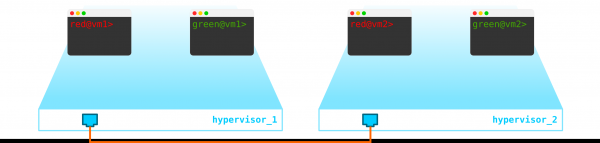
Pour l'instant, il ne s'agit que de la virtualisation de 4 serveurs et pas plus, car jusqu'à présent, tout ce que nous avons fait, c'est virtualiser 4 serveurs, les plaçant sur deux serveurs physiques. En fait, ils ne sont même pas encore connectés au réseau.
Pour créer un cloud, nous devons ajouter quelques composants. Tout d'abord, nous devons virtualiser la partie réseau — nous devons interconnecter ces 4 machines par paires, et les clients souhaitent une connexion L2. Nous pouvons bien sûr utiliser un commutateur et configurer un trunk en sa direction, puis gérer tout cela avec un bridge Linux ou, pour les utilisateurs plus avancés, Open vSwitch (nous y reviendrons). Cependant, il peut y avoir beaucoup de réseaux, et pousser constamment L2 à travers un switch n'est pas la meilleure idée — ainsi, différentes divisions, le service d'assistance, des mois d'attente pour le traitement des demandes, des semaines de dépannage — dans le monde moderne, cette approche ne fonctionne plus. Plus une entreprise comprend cela tôt, plus il lui sera facile d'avancer. C'est pourquoi nous allons allouer un réseau L3 entre les hyperviseurs par lequel nos machines virtuelles communiqueront, et nous construirons des réseaux L2 (overlay) virtuels au-dessus de ce réseau L3, dans lesquels circulera le trafic de nos machines virtuelles. Pour l'encapsulation, nous pouvons utiliser GRE, Geneve ou VxLAN. Pour l'instant, restons sur ce dernier, bien que cela ne soit pas si important.
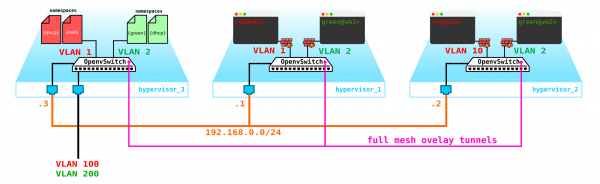
Nous devons placer le VTEP quelque part (j'espère que tout le monde est familiarisé avec la terminologie VxLAN). Comme nous avons une sortie L3 directement à partir des serveurs, rien ne nous empêche de placer le VTEP sur les serveurs eux-mêmes, et OVS (Open vSwitch) sait très bien le faire. Au final, nous avons obtenu une structure comme celle-ci :
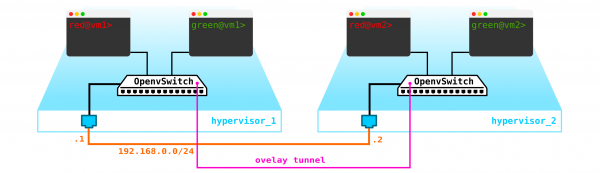
Comme le trafic entre les VM doit être séparé, les ports vers les machines virtuelles auront des numéros de VLAN différents. Le numéro de tag n'a d'importance que dans le cadre d'un seul commutateur virtuel, car lors de l'encapsulation dans VxLAN, nous pouvons le supprimer sans problème, car nous disposerons d'un VNI.
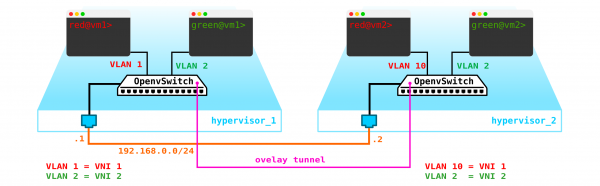
Nous pouvons maintenant créer nos machines et réseaux virtuels pour elles sans aucun problème.
Cependant, que se passe-t-il si le client a une autre machine, mais se trouve dans un autre réseau ? Nous avons besoin de routage entre les réseaux. Nous examinerons un scénario simple où un routage centralisé est utilisé — c'est-à-dire que le trafic est routé via des nœuds réseau dédiés spéciaux (en général, ils sont combinés avec des nœuds de contrôle, donc nous aurons la même chose).
En principe, rien de compliqué — nous créons une interface de bridge sur le nœud de contrôle, nous dirigeons le trafic vers celui-ci et à partir de là, nous le routons où nous en avons besoin. Mais le problème est que le client RED souhaite utiliser le réseau 10.0.0.0/24, et le client GREEN souhaite également utiliser le réseau 10.0.0.0/24. Cela signifie que nous avons un chevauchement des espaces d'adresses. De plus, les clients ne veulent pas que d'autres clients puissent être routés vers leurs réseaux internes, ce qui est logique. Pour séparer les réseaux et le trafic des clients, nous allons attribuer un namespace distinct à chacun d'eux. Un namespace est en fait une copie de la pile réseau Linux, c'est-à-dire que les clients dans le namespace RED sont complètement isolés des clients dans le namespace GREEN (ou le routage entre ces réseaux clients est autorisé via le namespace par défaut ou sur l'équipement de transport supérieur).
Nous obtenons donc le schéma suivant :
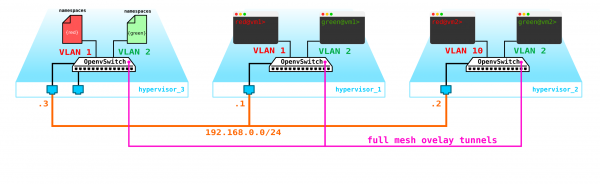
Les tunnels L2 convergent depuis tous les nœuds de calcul vers le nœud de contrôle, où se trouve l'interface L3 pour ces réseaux, chaque dans un namespace distinct pour l'isolation.
Cependant, nous avons oublié l'essentiel. La machine virtuelle doit fournir un service au client, c'est-à-dire qu'elle doit avoir au moins une interface externe à travers laquelle on peut y accéder. En d'autres termes, nous devons nous connecter au monde extérieur. Il existe différentes options. Nous allons opter pour la plus simple. Ajoutons à chaque client un réseau valable dans le réseau du fournisseur et qui ne chevauchera pas d'autres réseaux. Les réseaux peuvent aussi se chevaucher et se référer à différents VRF du côté du réseau du fournisseur. Ces réseaux vivront également dans l'espace de noms de chaque client. Cependant, ils devront tout de même sortir vers le monde extérieur via une seule interface physique (ou bond, ce qui est plus logique). Pour séparer le trafic des clients, le trafic sortant sera marqué avec une étiquette VLAN attribuée au client.
Au final, nous avons obtenu le schéma suivant :
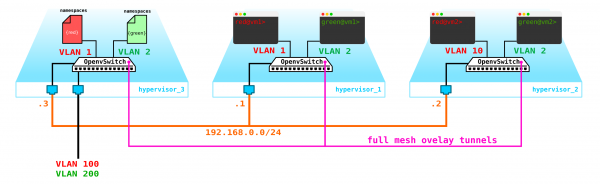
Une question légitime se pose : pourquoi ne pas créer des passerelles sur les nœuds compute eux-mêmes ? Il n'y a pas de gros problème à cela, de plus, lorsque le routeur distribué (DVR) est activé, cela fonctionnera ainsi. Dans ce scénario, nous examinons l'option la plus simple avec une passerelle centralisée, qui est utilisée par défaut dans Openstack. Pour les fonctions à forte charge, on utilisera à la fois le routeur distribué et des technologies d'accélération telles que SR-IOV et Passthrough, mais comme on dit, c'est une autre histoire. D'abord, traitons la partie de base, puis nous entrerons dans les détails.
En réalité, notre schéma est déjà opérationnel, cependant, il y a quelques nuances :
- Nous devons protéger nos machines d'une manière ou d'une autre, c'est-à-dire appliquer un filtre sur l'interface du switch côté client.
- Permettre l'obtention automatique de l'adresse IP par la machine virtuelle, afin de ne pas avoir à y entrer à chaque fois via la console et à saisir l'adresse.
Commençons par la protection des machines. Pour cela, on peut utiliser de simples iptables, pourquoi pas.
Ainsi, notre topologie est maintenant un peu plus complexe :
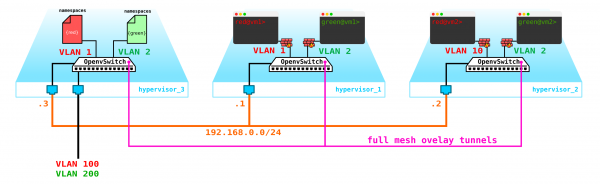
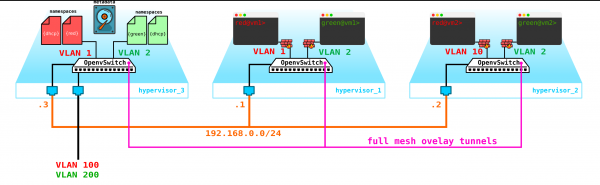
Allons plus loin. Nous devons ajouter un serveur DHCP. L'endroit idéal pour placer les serveurs DHCP pour chaque client sera la nœud de contrôle mentionnée précédemment, où se trouvent les espaces de noms :
Cependant, il y a un petit problème. Que se passe-t-il si tout redémarre et que toutes les informations de location des adresses DHCP disparaissent ? Il est logique que de nouvelles adresses soient attribuées aux machines, ce qui n'est pas très pratique. Il y a deux solutions : soit utiliser des noms de domaine et ajouter un serveur DNS pour chaque client, auquel cas l'adresse ne sera pas vraiment importante (à l'image de la partie réseau dans k8s) — mais cela pose un problème avec les réseaux externes, car dans ceux-ci, les adresses peuvent également être attribuées par DHCP — il faut donc une synchronisation entre les serveurs DNS de la plateforme cloud et le serveur DNS externe, ce qui, à mon avis, n'est pas très flexible, mais tout à fait réalisable. Soit la deuxième option — utiliser des métadonnées — c'est-à-dire conserver les informations sur l'adresse attribuée à la machine afin que le serveur DHCP sache quelle adresse attribuer à la machine si elle a déjà reçu une adresse. La deuxième option est plus simple et plus flexible, car elle permet de conserver des informations supplémentaires sur la machine. Ajoutons maintenant le schéma de l'agent des métadonnées :
Une autre question qui mérite également d'être abordée est la possibilité d'utiliser un seul réseau externe pour tous les clients, car si les réseaux externes doivent être valides dans l'ensemble du réseau, cela pose des complications — il faut constamment allouer et contrôler l'attribution de ces réseaux. La possibilité d'utiliser un réseau externe préconfiguré unique pour tous les clients serait très utile lors de la création d'un cloud public. Cela simplifierait le déploiement des machines, car nous n'aurions pas besoin de consulter la base de données des adresses et de choisir un espace d'adresses unique pour le réseau externe de chaque client. De plus, nous pouvons définir le réseau externe à l'avance et au moment du déploiement, il nous suffira d'associer les adresses externes aux machines des clients.
Et c'est là que le NAT entre en jeu : nous allons permettre aux clients de sortir vers le monde extérieur via le namespace par défaut en utilisant la traduction NAT. Cependant, cela pose un petit problème. C'est bien si le serveur client fonctionne en tant que client, c'est-à-dire qu'il initie les connexions plutôt que de les accepter. Mais dans notre cas, ce sera l'inverse. Dans ce cas, nous devons utiliser le NAT de destination pour que, lors de la réception du trafic, le nœud de contrôle comprenne que ce trafic est destiné à la machine virtuelle A du client A, et donc effectuer la traduction NAT de l'adresse externe, par exemple 100.1.1.1, vers l'adresse interne 10.0.0.1. Ainsi, bien que tous les clients utilisent le même réseau, l'isolation interne est complètement préservée. Nous devons donc mettre en place le dNAT et le sNAT sur le nœud de contrôle. L'utilisation d'un réseau unique avec des adresses flottantes ou des réseaux externes, ou les deux simultanément, dépend de ce que vous souhaitez intégrer dans le cloud. Nous n'ajouterons pas d'adresses flottantes au schéma, mais conserverons les réseaux externes déjà ajoutés auparavant — chaque client dispose de son propre réseau externe (représenté sur le schéma comme VLAN 100 et 200 sur l'interface externe).
Au final, nous avons obtenu une solution intéressante et en même temps réfléchie, possédant une certaine flexibilité mais qui ne dispose pas encore de mécanismes de tolérance aux pannes.
Tout d'abord, nous n'avons qu'un seul nœud de contrôle — sa défaillance entraînera l'effondrement de tous les systèmes. Pour remédier à ce problème, il est nécessaire de créer au moins un quorum de 3 nœuds. Ajoutons cela au schéma :
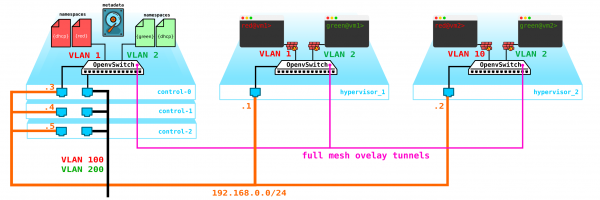
Évidemment, tous les nœuds se synchronisent et, en cas de défaillance d'un nœud actif, ses tâches seront reprises par un autre nœud.
Le problème suivant concerne les disques des machines virtuelles. Actuellement, ils sont stockés sur les hyperviseurs eux-mêmes et en cas de problème avec l'hyperviseur, nous perdons toutes les données — et avoir un RAID ici ne sera d'aucune aide si nous perdons non pas un disque, mais tout le serveur entier. Pour cela, nous avons besoin de créer un service qui servira de front-end pour un type de stockage. Quel type de stockage, peu importe, mais il doit protéger nos données contre les pannes de disques, de nœuds, et éventuellement même d'armoires entières. Il y a plusieurs options — il existe bien sûr des réseaux SAN avec Fibre Channel, mais disons-le franchement — le FC est déjà une relique du passé — l'analogue de l'E1 dans le transport — oui, je suis d'accord, il est encore utilisé, mais seulement là où il est absolument indispensable. Par conséquent, déployer volontairement un réseau FC en 2020 ne serait pas ma priorité, sachant qu'il existe d'autres alternatives plus intéressantes. Bien que chacun ait ses préférences, il pourrait y avoir des gens qui pensent que le FC, avec toutes ses limitations, est tout ce dont nous avons besoin — je ne vais pas contester, chacun a son avis. Cependant, à mon avis, la solution la plus intéressante est l'utilisation de SDS, par exemple Ceph.
Ceph permet de construire une solution hautement disponible pour le stockage de données avec une multitude d'options de reprise, allant des codes de vérification de parité (similaires à RAID 5 ou 6) à la réplication complète des données sur différents disques en tenant compte de la localisation des disques dans les serveurs, et des serveurs dans les armoires, etc.
Pour assembler Ceph, il faut encore 3 nœuds. L'interaction avec le stockage se fera également via le réseau en utilisant des services de stockage en bloc, objet et fichier. Ajoutons au schéma le stockage :
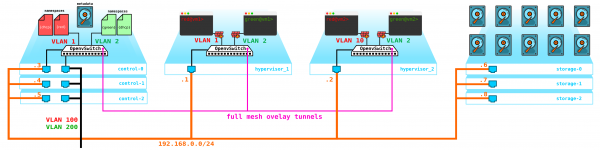
Remarque : il est possible de créer des nœuds de calcul hyperconvergés — c'est un concept qui combine plusieurs fonctions sur un même nœud — par exemple stockage + calcul — sans allouer de nœuds spéciaux pour le stockage Ceph. Nous obtiendrons un schéma de haute disponibilité, car le SDS réserve les données avec le niveau de redondance spécifié. Cependant, les nœuds hyperconvergés représentent toujours un compromis, car le nœud de stockage ne se contente pas de ne rien faire, comme cela pourrait sembler à première vue (puisqu'il n'y a pas de machines virtuelles dessus) — il utilise des ressources CPU pour maintenir le SDS (en réalité, il effectue en arrière-plan toutes les réplications, les récupérations après pannes de nœuds, de disques, etc.). Cela signifie que vous perdrez une partie de la puissance du nœud de calcul si vous le combinez avec le stockage.
Il faut bien gérer tout cela — il nous faut quelque chose qui nous permettra de créer des machines, des réseaux, des routeurs virtuels, etc. Pour cela, nous ajouterons un service au nœud de contrôle qui fera office de tableau de bord — le client pourra se connecter à ce portail via http/https et faire tout ce dont il a besoin (enfin presque).
Au final, nous avons maintenant un système de haute disponibilité. Tous les éléments de cette infrastructure doivent être gérés d'une manière ou d'une autre. Il a été mentionné précédemment qu'OpenStack est un ensemble de projets, chacun fournissant une certaine fonction. Comme nous le voyons, il y a plus que suffisamment d'éléments à configurer et à contrôler. Aujourd'hui, nous allons parler de la partie réseau.
Architecture Neutron
Dans OpenStack, Neutron est responsable de la connexion des ports des machines virtuelles au réseau L2 commun, de la gestion du trafic entre les VM se trouvant sur différents réseaux L2, ainsi que du routage vers l'extérieur, fournissant des services tels que NAT, Floating IP, DHCP, etc.
Le fonctionnement de haut niveau du service réseau (partie de base) peut être décrit comme suit.
Lors du démarrage d'une VM, le service réseau :
- Crée un port pour cette VM (ou des ports) et en informe le service DHCP ;
- Un nouvel appareil réseau virtuel est créé (via libvirt) ;
- La VM se connecte au port créé à l'étape 1 (ou aux ports) ;
Étrangement, la base du fonctionnement de Neutron repose sur des mécanismes standards connus de tous ceux qui ont un jour exploré Linux — à savoir les espaces de noms, iptables, les ponts Linux, openvswitch, conntrack, etc.
Il convient de préciser d'emblée que Neutron n'est pas un contrôleur SDN.
Neutron se compose de plusieurs composants interconnectés :
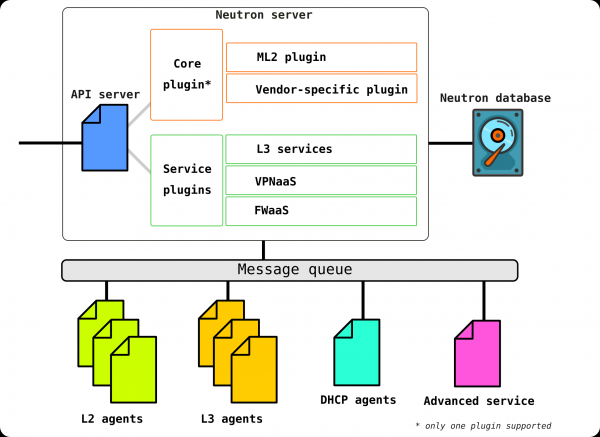
Openstack-neutron-server — est un démon qui traite les demandes des utilisateurs via l'API. Ce démon ne gère pas les connexions réseau, mais fournit les informations nécessaires à ses plug-ins, qui configurent ensuite l'élément réseau requis. Les agents Neutron sur les nœuds OpenStack s'enregistrent sur le serveur Neutron.
Le serveur Neutron est en fait une application écrite en Python, composée de deux parties :
- service REST
- Plugin Neutron (core/service)
Le service REST est destiné à recevoir des appels API des autres composants (par exemple, une demande de fourniture d'informations, etc.)
Les plug-ins sont des composants/modules logiciels qui sont appelés lors des demandes API — c'est-à-dire que l'attribution d'un service se fait à travers eux. Les plug-ins se divisent en deux types : le plug-in de service et le plug-in racine. En général, le plug-in racine est principalement responsable de la gestion de l'espace d'adressage et des connexions L2 entre les VM, tandis que les plug-ins de service fournissent des fonctionnalités supplémentaires telles que VPN ou FW.
La liste des plug-ins disponibles aujourd'hui peut être consultée par exemple
Il peut y avoir plusieurs plug-ins de service, cependant, il ne peut y avoir qu'un seul plug-in racine.
Openstack-neutron-ml2 — est le plug-in racine standard d'OpenStack. Ce plug-in a une architecture modulaire (contrairement à son prédécesseur) et configure le service réseau via les pilotes qui lui sont connectés. Nous examinerons le plug-in un peu plus tard, car il fournit en réalité la flexibilité dont dispose OpenStack dans la partie réseau. Le plug-in racine peut être remplacé (par exemple, Contrail Networking effectue un tel remplacement).
Service RPC (rabbitmq-server) — service qui gère les files d'attente et les interactions avec d'autres services OpenStack ainsi que les interactions entre les agents du service réseau.
Agents réseau — agents situés sur chaque nœud, à travers lesquels la configuration des services réseau est effectuée.
Il existe plusieurs types d'agents.
L'agent principal est le agent L2. Ces agents sont lancés sur chacun des hyperviseurs, y compris les nœuds de contrôle (plus précisément sur tous les nœuds fournissant un service quelconque aux locataires), et leur fonction principale est de connecter des machines virtuelles à un réseau L2 commun, ainsi que de générer des alertes lors de la survenue d'événements (comme la désactivation/réactivation d'un port).
Le prochain agent, tout aussi important, est l'agent L3. Par défaut, cet agent est lancé uniquement sur le nœud réseau (souvent le nœud réseau est combiné avec le nœud de contrôle) et assure le routage entre les réseaux des locataires (à la fois entre ses propres réseaux et ceux d'autres locataires, ainsi qu'un accès au monde extérieur, en fournissant NAT, ainsi qu'un service DHCP). Cependant, lors de l'utilisation de DVR (routeur distribué), la nécessité du plugin L3 se fait également sentir sur les nœuds de calcul.
L'agent L3 utilise des espaces de noms Linux pour fournir à chaque locataire un ensemble de réseaux isolés ainsi que des fonctionnalités de routeurs virtuels, qui routent le trafic et offrent des services de passerelle pour les réseaux de la couche 2.
Base de données — une base de données d'identifiants de réseaux, sous-réseaux, ports, pools, etc.
En fait, Neutron reçoit des requêtes API pour la création de toute entité réseau, authentifie la requête, et via RPC (s'il interroge un plugin ou un agent) ou REST API (s'il communique avec SDN) transmet aux agents (via des plugins) les instructions nécessaires pour organiser le service demandé.
Regardons maintenant l'installation de test (nous examinerons plus tard comment elle est déployée et ce qu'elle contient dans la partie pratique) et voyons où chaque composant est situé :
(overcloud) [stack@undercloud ~]$ openstack network agent list
+--------------------------------------+--------------------+-------------------------------------+-------------------+-------+-------+---------------------------+
| ID                                   | Type d'agent       | Hôte                                | Zone de disponibilité | Actif | État  | Binaire                   |
+--------------------------------------+--------------------+-------------------------------------+-------------------+-------+-------+---------------------------+
| 10495de9-ba4b-41fe-b30a-b90ec3f8728b | Agent Open vSwitch | overcloud-novacompute-1.localdomain | Aucun              | :-)   | EN MARCHE | neutron-openvswitch-agent |
| 1515ad4a-5972-46c3-af5f-e5446dff7ac7 | Agent L3           | overcloud-controller-0.localdomain  | nova              | :-)   | EN MARCHE | neutron-l3-agent          |
| 322e62ca-1e5a-479e-9a96-4f26d09abdd7 | Agent DHCP         | overcloud-controller-0.localdomain  | nova              | :-)   | EN MARCHE | neutron-dhcp-agent        |
| 9c1de2f9-bac5-400e-998d-4360f04fc533 | Agent Open vSwitch | overcloud-novacompute-0.localdomain | Aucun              | :-)   | EN MARCHE | neutron-openvswitch-agent |
| d99c5657-851e-4d3c-bef6-f1e3bb1acfb0 | Agent Open vSwitch | overcloud-controller-0.localdomain  | Aucun              | :-)   | EN MARCHE | neutron-openvswitch-agent |
| ff85fae6-5543-45fb-a301-19c57b62d836 | Agent Metadata     | overcloud-controller-0.localdomain  | Aucun              | :-)   | EN MARCHE | neutron-metadata-agent    |
+--------------------------------------+--------------------+-------------------------------------+-------------------+-------+-------+---------------------------+
(overcloud) [stack@undercloud ~]$ 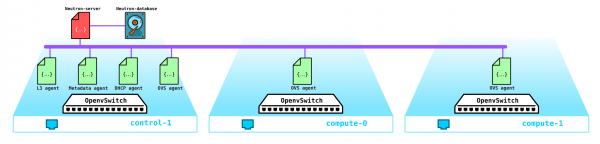
Voilà toute la structure de Neutron. Maintenant, il convient de consacrer un peu de temps au plugin ML2.
Modulo Layer 2
Comme mentionné ci-dessus, le plugin est le plugin racine standard d'OpenStack et possède une architecture modulaire.
Le prédécesseur du plugin ML2 avait une structure monolithique, ce qui ne permettait pas, par exemple, d'utiliser un mélange de plusieurs technologies dans une seule installation. Par exemple, vous ne pouviez pas utiliser à la fois openvswitch et linuxbridge simultanément — soit l'un, soit l'autre. C'est pour cette raison que le plugin ML2 a été créé avec son architecture.
ML2 a deux composantes — deux types de pilotes : les Type drivers et les Mechanism drivers.
Type drivers définissent les technologies qui seront utilisées pour organiser les connexions réseau, par exemple VxLAN, VLAN, GRE. En outre, le pilote permet d'utiliser différentes technologies. La technologie standard est l'encapsulation VxLAN pour les réseaux de type overlay et les VLAN pour les réseaux externes.
Les suivants sont des types de réseaux des Type drivers :
Plat — réseau sans balisage
VLAN — réseau balisé
Local — type de réseau spécial pour les installations de type tout-en-un (ces installations sont nécessaires soit pour les développeurs soit pour l'apprentissage)
GRE — réseau overlay utilisant des tunnels GRE
VxLAN — réseau overlay utilisant des tunnels VxLAN
Mechanism drivers déterminent les moyens qui assurent l'organisation des technologies mentionnées dans type driver — par exemple, openvswitch, sr-iov, opendaylight, OVN, etc.
Selon l'implémentation de ce pilote, soit des agents gérés par Neutron seront utilisés, soit des connexions avec un contrôleur SDN externe, qui s'occupe de toutes les questions relatives à l'organisation des réseaux L2, à la routage, etc.
Par exemple, si nous utilisons ML2 avec OVS, alors un agent L2 est installé sur chaque nœud de calcul, qui gère OVS. Cependant, si nous utilisons, par exemple, OVN ou OpenDayLight, la gestion d'OVS passe sous leur juridiction — Neutron donne des ordres au contrôleur via le plugin racine, et ce dernier exécute les instructions qui lui sont données.
Rappelons Open vSwitch
À l'heure actuelle, Open vSwitch est l'un des composants clés d'OpenStack.
Lors de l'installation d'OpenStack sans SDN supplémentaire de types Juniper Contrail ou Nokia Nuage, OVS est le principal composant réseau du cloud et, en combinaison avec iptables, conntrack, namespaces, permet d'organiser des réseaux overlay complets avec multi-location. Naturellement, ce composant peut être remplacé, par exemple, lors de l'utilisation de solutions SDN propriétaires distinctes.
OVS est un commutateur logiciel à code source ouvert, conçu pour être utilisé dans des environnements virtualisés comme un routeur virtuel de trafic.
À l'heure actuelle, OVS possède des fonctionnalités très solides, y compris des technologies telles que QoS, LACP, VLAN, VxLAN, GENEVE, OpenFlow, DPDK, etc.
Note : à l'origine, OVS n'était pas conçu comme un commutateur logiciel pour des fonctions télécom à forte charge, mais était davantage orienté vers des fonctions informatiques moins exigeantes en bande passante, telles que les serveurs WEB ou les serveurs de messagerie. Toutefois, OVS est en cours d'amélioration et les implémentations actuelles d'OVS ont considérablement amélioré ses performances et ses capacités, permettant aux opérateurs de télécommunications d'utiliser OVS pour des fonctions à haute charge, par exemple, il existe une implémentation d'OVS avec support d'accélération DPDK.
Il existe trois composants importants d'OVS à connaître :
- Module du noyau — un composant situé dans l'espace du noyau qui traite le trafic en fonction des règles reçues du contrôleur.
- vSwitch Le démon (ovs-vswitchd) est un processus lancé dans l'espace utilisateur, responsable de la programmation du module noyau, c'est-à-dire qu'il représente directement la logique de fonctionnement du commutateur.
- Serveur de base de données — une base de données locale située sur chaque hôte sur lequel OVS est exécuté, où la configuration est stockée. Grâce à ce module, les contrôleurs SDN peuvent communiquer via le protocole OVSDB.
À cela s'ajoute un ensemble d'outils de diagnostic et de gestion, tels que ovs-vsctl, ovs-appctl, ovs-ofctl, etc.
Actuellement, Openstack est largement utilisé par les opérateurs de télécommunications pour migrer des fonctions réseau telles que EPC, SBC, HLR, etc. Certaines fonctions peuvent vivre sans problème avec OVS tel qu'il est, mais par exemple, l'EPC traite le trafic des abonnés, c'est-à-dire qu'il traverse une immense quantité de trafic (actuellement, les volumes de trafic atteignent plusieurs centaines de gigabits par seconde). Évidemment, faire passer un tel trafic par l'espace noyau (car par défaut, le transfert se fait là) n'est pas la meilleure idée. C'est pourquoi OVS est souvent entièrement déployé dans l'espace utilisateur en utilisant la technologie d'accélération DPDK pour rediriger le trafic de la NIC vers l'espace utilisateur en contournant le noyau.
Remarque : pour le cloud déployé pour les fonctions de télécommunication, il est possible de rediriger le trafic de la nœud de calcul directement vers l'équipement de commutation sans passer par OVS. Pour cela, des mécanismes SR-IOV et Passthrough sont utilisés.
Comment cela fonctionne-t-il sur un modèle réel ?
Passons maintenant à la partie pratique et voyons comment tout cela fonctionne en pratique.
Pour commencer, déployons une installation Openstack simple. Comme je n'ai pas de serveur sous la main pour les expérimentations, nous allons assembler le modèle sur un seul serveur physique à partir de machines virtuelles. Oui, naturellement, une telle solution n'est pas adaptée aux objectifs commerciaux, mais pour illustrer le fonctionnement du réseau dans une installation Openstack, cela suffira largement. De plus, une telle installation est même plus intéressante à des fins pédagogiques, car il est possible de capturer le trafic, etc.
Comme nous devons voir seulement la partie de base, nous pouvons ne pas utiliser plusieurs réseaux et tout lever en utilisant seulement deux réseaux, la deuxième étant exclusivement utilisée pour accéder à l'undercloud et au serveur DNS. Nous ne toucherons pour l'instant pas aux réseaux externes — c'est un sujet pour un autre grand article.
Commençons par le début. D'abord, un peu de théorie. Nous allons installer Openstack avec l'aide de TripleO (Openstack sur Openstack). L'idée de TripleO est que nous installons Openstack en mode all-in-one (c'est-à-dire sur une seule nœud), appelé undercloud, et ensuite nous exploitons les capacités de l'Openstack déployé pour installer l'Openstack destiné à la production, appelé overcloud. L'undercloud utilisera sa capacité intégrée à gérer des serveurs physiques (bare metal) — projet Ironic — pour provisionner les hyperviseurs qui joueront les rôles de nœuds compute, control, storage. Cela signifie que nous n'utilisons aucun outil tiers pour déployer Openstack — nous déployons Openstack en utilisant la puissance d'Openstack. Au fur et à mesure de l'installation, cela deviendra beaucoup plus clair, donc ne nous attardons pas là-dessus et avançons.
Remarque : Dans cet article, pour simplifier, je n'ai pas utilisé d'isolation réseau pour les réseaux internes d'Openstack, et tout a été déployé en utilisant une seule et même réseau. Cependant, la présence ou l'absence d'isolation des réseaux n'affecte pas la fonctionnalité de base de la solution — tout fonctionnera exactement de la même manière qu'en utilisant de l'isolation, mais le trafic circulera dans un seul réseau. Pour une installation commerciale, il est naturellement nécessaire d'utiliser l'isolation avec différents VLAN et interfaces. Par exemple, le trafic de gestion du stockage Ceph et le trafic des données elles-mêmes (les appels des machines aux disques, etc.) lorsqu'ils sont isolés utilisent différentes sous-réseaux (Gestion du stockage et Stockage) et cela permet de rendre la solution plus résiliente, en séparant ce trafic, par exemple, sur différents ports, ou d'utiliser différents profils QoS pour chaque type de trafic, afin que le trafic de données ne parvienne pas à écraser le trafic de signal. Dans notre cas, ils circuleront dans le même réseau et cela ne nous limite en rien.
Remarque : Comme nous allons exécuter des machines virtuelles dans un environnement virtuel basé sur des machines virtuelles, il faut d'abord activer la virtualisation imbriquée.
Pour vérifier si la virtualisation imbriquée est activée ou non, vous pouvez procéder comme suit :
[root@hp-gen9 bormoglotx]# cat /sys/module/kvm_intel/parameters/nested
N
[root@hp-gen9 bormoglotx]#
Si vous voyez la lettre N, activez la prise en charge de la virtualisation imbriquée selon n'importe quel guide que vous trouverez en ligne, par exemple .
Nous devons construire un schéma comme celui-ci à partir de machines virtuelles :
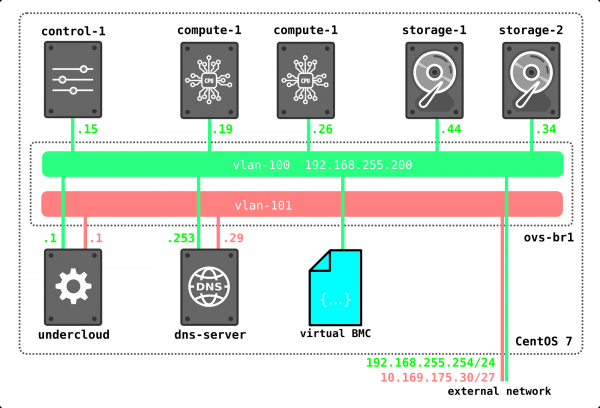
Dans mon cas, pour la connectivité des machines virtuelles faisant partie de la future installation (j'en ai 7, mais on peut se contenter de 4 si vous avez peu de ressources), j'ai utilisé OpenvSwitch. J'ai créé un pont ovs et connecté les machines virtuelles à celui-ci via des port-groups. Pour cela, j'ai créé un fichier xml de la manière suivante :
[root@hp-gen9 ~]# virsh net-dumpxml ovs-network-1

  ovs-network-1
  7a2e7de7-fc16-4e00-b1ed-4d190133af67
Ici, trois groupes de ports sont déclarés : deux access et un trunk (le dernier était nécessaire pour le serveur DNS, mais on peut s'en passer ou le faire fonctionner sur la machine hôte — c'est selon votre préférence). Ensuite, avec ce modèle, nous déclarons notre réseau via virsh net-define :
virsh net-define ovs-network-1.xml
virsh net-start ovs-network-1
virsh net-autostart ovs-network-1
Maintenant, nous modifions les configurations des ports de l'hyperviseur :
[root@hp-gen9 ~]# cat /etc/sysconfig/network-scripts/ifcfg-ens1f0
TYPE=Ethernet
NAME=ens1f0
DEVICE=ens1f0
TYPE=OVSPort
DEVICETYPE=ovs
OVS_BRIDGE=ovs-br1
ONBOOT=yes
OVS_OPTIONS="trunk=100,101,102"
[root@hp-gen9 ~]
[root@hp-gen9 ~]# cat /etc/sysconfig/network-scripts/ifcfg-ovs-br1
DEVICE=ovs-br1
DEVICETYPE=ovs
TYPE=OVSBridge
BOOTPROTO=static
ONBOOT=yes
IPADDR=192.168.255.200
PREFIX=24
[root@hp-gen9 ~]#
Remarque : dans ce scénario, l'adresse sur le port ovs-br1 ne sera pas accessible car elle n'a pas de tag VLAN. Pour corriger cela, il faut exécuter la commande sudo ovs-vsctl set port ovs-br1 tag=100. Cependant, après le redémarrage, ce tag disparaîtra (si quelqu'un sait comment le conserver, je lui en serais très reconnaissant). Mais cela n'est pas très important car cette adresse ne sera nécessaire que pendant l'installation et ne sera pas requise lorsque Openstack sera entièrement déployé.
Ensuite, nous créons la machine undercloud :
virt-install -n undercloud --description "undercloud" --os-type=Linux --os-variant=centos7.0 --ram=8192 --vcpus=8 --disk path=/var/lib/libvirt/images/undercloud.qcow2,bus=virtio,size=40,format=qcow2 --network network:ovs-network-1,model=virtio,portgroup=access-100 --network network:ovs-network-1,model=virtio,portgroup=access-101 --graphics none --location /var/lib/libvirt/boot/CentOS-7-x86_64-Minimal-2003.iso --extra-args console=ttyS0Lors de l'installation, définissez tous les paramètres nécessaires, tels que le nom de la machine, les mots de passe, les utilisateurs, les serveurs NTP, etc. Vous pouvez également configurer les ports tout de suite, mais personnellement, je préfère entrer dans la machine via la console et corriger les fichiers nécessaires après l'installation. Si vous avez déjà une image prête, vous pouvez l'utiliser ou suivre ma méthode : télécharger une image minimale de CentOS 7 et l'utiliser pour installer la VM.
Après une installation réussie, vous devriez avoir une machine virtuelle sur laquelle vous pourrez installer l'undercloud.
[root@hp-gen9 bormoglotx]# virsh list
 Id    Nom                           État
----------------------------------------------------
 6     serveur-dns                     en cours d'exécution
 62    undercloud                     en cours d'exécution
Tout d'abord, installons les outils nécessaires à l'installation :
sudo yum update -y
sudo yum install -y net-tools
sudo yum install -y wget
sudo yum install -y ipmitool
Installation de l'Undercloud
Créons l'utilisateur stack, définissons un mot de passe, ajoutons-le aux sudoers et permettons-lui d'exécuter des commandes root via sudo sans avoir à entrer de mot de passe :
useradd stack
passwd stack

echo “stack ALL=(root) NOPASSWD:ALL” > /etc/sudoers.d/stack
chmod 0440 /etc/sudoers.d/stack
Nous allons maintenant indiquer dans le fichier hosts le nom complet de l'undercloud :
vi /etc/hosts

127.0.0.1   undercloud.openstack.rnd localhost localhost.localdomain localhost4 localhost4.localdomain4
::1         localhost localhost.localdomain localhost6 localhost6.localdomain6
Ensuite, ajoutons les dépôts et installons le logiciel dont nous avons besoin :
sudo yum install -y https://trunk.rdoproject.org/centos7/current/python2-tripleo-repos-0.0.1-0.20200409224957.8bac392.el7.noarch.rpm
sudo -E tripleo-repos -b queens current
sudo -E tripleo-repos -b queens current ceph
sudo yum install -y python-tripleoclient
sudo yum install -y ceph-ansible
Remarque : si vous ne prévoyez pas d'installer ceph, vous n'avez pas besoin d'entrer les commandes liées à ceph. J'ai utilisé la version Queens, mais vous pouvez utiliser n'importe quelle autre version qui vous plaît.
Ensuite, copions le fichier de configuration undercloud dans le répertoire personnel de l'utilisateur stack :
cp /usr/share/instack-undercloud/undercloud.conf.sample ~/undercloud.confNous devons maintenant modifier ce fichier pour l'adapter à notre installation.
Au début du fichier, il faut ajouter les lignes suivantes :
vi undercloud.conf
[DEFAULT]
undercloud_hostname = undercloud.openstack.rnd
local_ip = 192.168.255.1/24
network_gateway = 192.168.255.1
undercloud_public_host = 192.168.255.2
undercloud_admin_host = 192.168.255.3
undercloud_nameservers = 192.168.255.253
generate_service_certificate = false
local_interface = eth0
local_mtu = 1450
network_cidr = 192.168.255.0/24
masquerade = true
masquerade_network = 192.168.255.0/24
dhcp_start = 192.168.255.11
dhcp_end = 192.168.255.50
inspection_iprange = 192.168.255.51,192.168.255.100
scheduler_max_attempts = 10
Alors, examinons les paramètres :
undercloud_hostname — le nom complet du serveur undercloud, qui doit correspondre à l'entrée sur le serveur DNS
local_ip – adresse locale de l'undercloud vers le réseau de provisioning
network_gateway – cette même adresse locale, qui agira en tant que passerelle pour accéder au monde extérieur pendant l'installation des nœuds overcloud, coïncide également avec l'IP locale
undercloud_public_host – adresse de l'API externe, attribuez n'importe quelle adresse libre du réseau de provisioning
undercloud_admin_host adresse de l'API interne, attribuez n'importe quelle adresse libre du réseau de provisioning
undercloud_nameservers – serveur DNS
generate_service_certificate – cette ligne est très importante dans cet exemple, car si elle n'est pas définie sur false, vous obtiendrez une erreur lors de l'installation, le problème est décrit dans le bugtracker Red Hat
local_interface interface dans le réseau de provisioning. Cette interface sera reconfigurée lors du déploiement de l'undercloud, donc l'undercloud doit avoir deux interfaces - une pour y accéder, l'autre pour le provisioning
local_mtu – MTU. Étant donné que nous avons un laboratoire de test et que le MTU est de 1500 sur les ports du commutateur OVS, il est nécessaire de le définir à 1450 pour que les paquets encapsulés dans VxLAN passent
network_cidr – réseau de provisioning
masquerade – utilisation de NAT pour accéder au réseau externe
masquerade_network – réseau qui sera soumis au NAT
dhcp_start – adresse de départ de la plage d'adresses, à partir de laquelle les adresses seront attribuées aux nœuds lors du déploiement de l'overcloud
dhcp_end – adresse de fin de la plage d'adresses, à partir de laquelle les adresses seront attribuées aux nœuds lors du déploiement de l'overcloud
inspection_iprange – plage d'adresses nécessaires pour effectuer une introspection (ne doit pas se chevaucher avec la plage mentionnée ci-dessus)
scheduler_max_attempts – nombre maximum de tentatives d'installation de l'overcloud (doit être supérieur ou égal au nombre de nœuds)
Après que le fichier a été décrit, vous pouvez donner la commande pour déployer l'undercloud :
openstack undercloud install
La procédure prend de 10 à 30 minutes selon votre matériel. Vous devriez finalement voir cette sortie :
vi undercloud.conf
2020-08-13 23:13:12,668 INFO:
#############################################################################
Installation de l'undercloud terminée.

Le fichier contenant les mots de passe de cette installation est situé à
/home/stack/undercloud-passwords.conf.

Il y a aussi un fichier stackrc à /home/stack/stackrc.

Ces fichiers sont nécessaires pour interagir avec les services OpenStack et doivent être sécurisés.

#############################################################################
Cette sortie indique que vous avez réussi à installer l'undercloud et que vous pouvez maintenant vérifier l'état de l'undercloud et procéder à l'installation de l'overcloud.
Si vous regardez la sortie de ifconfig, vous verrez qu'une nouvelle interface de pont a été créée
[stack@undercloud ~]$ ifconfig
br-ctlplane: flags=4163  mtu 1450
        inet 192.168.255.1  netmask 255.255.255.0  broadcast 192.168.255.255
        inet6 fe80::5054:ff:fe2c:89e  prefixlen 64  scopeid 0x20
        ether 52:54:00:2c:08:9e  txqueuelen 1000  (Ethernet)
        RX packets 14  bytes 1095 (1.0 KiB)
        RX errors 0  dropped 0  overruns 0  frame 0
        TX packets 20  bytes 1292 (1.2 KiB)
        TX errors 0  dropped 0 overruns 0  carrier 0  collisions 0
Ce nouvel interface sera désormais utilisé pour le déploiement de l'overcloud.
Comme on peut le voir dans la sortie ci-dessous, tous les services sont sur un seul nœud :
(undercloud) [stack@undercloud ~]$ openstack host list
+--------------------------+-----------+----------+
| Nom d'hôte               | Service   | Zone     |
+--------------------------+-----------+----------+
| undercloud.openstack.rnd | conductor | internal |
| undercloud.openstack.rnd | scheduler | internal |
| undercloud.openstack.rnd | compute   | nova     |
+--------------------------+-----------+----------+
Ci-dessous la configuration réseau de l'undercloud :
(undercloud) [stack@undercloud ~]$ python -m json.tool /etc/os-net-config/config.json
{
    "network_config": [
        {
            "addresses": [
                {
                    "ip_netmask": "192.168.255.1/24"
                }
            ],
            "members": [
                {
                    "dns_servers": [
                        "192.168.255.253"
                    ],
                    "mtu": 1450,
                    "name": "eth0",
                    "primary": "true",
                    "type": "interface"
                }
            ],
            "mtu": 1450,
            "name": "br-ctlplane",
            "ovs_extra": [
                "br-set-external-id br-ctlplane bridge-id br-ctlplane"
            ],
            "routes": [],
            "type": "ovs_bridge"
        }
    ]
}
(undercloud) [stack@undercloud ~]$
Installation de l'overcloud
Actuellement, nous n'avons que l'undercloud, et nous manquons de nœuds pour construire l'overcloud. Par conséquent, la première étape consiste à déployer les machines virtuelles nécessaires. Lors du déploiement, l'undercloud installera le système d'exploitation et les logiciels nécessaires sur les machines de l'overcloud — c'est-à-dire que nous n'avons pas besoin de déployer complètement une machine, mais simplement de créer un disque (ou des disques) pour elle et de définir ses paramètres — ce qui signifie que nous obtenons en fait un serveur nu sans système d'exploitation installé.
Nous allons dans le dossier avec les disques de nos machines virtuelles et créons des disques de la taille nécessaire :
cd /var/lib/libvirt/images/
qemu-img create -f qcow2 -o preallocation=metadata control-1.qcow2 60G
qemu-img create -f qcow2 -o preallocation=metadata compute-1.qcow2 60G
qemu-img create -f qcow2 -o preallocation=metadata compute-2.qcow2 60G
qemu-img create -f qcow2 -o preallocation=metadata storage-1.qcow2 160G
qemu-img create -f qcow2 -o preallocation=metadata storage-2.qcow2 160G
Étant donné que nous agissons en tant que root, nous devons changer le propriétaire de ces disques pour éviter des problèmes de droits :
[root@hp-gen9 images]# ls -lh
total 5.8G
drwxr-xr-x. 2 qemu qemu 4.0K 13 août 16:15 backups
-rw-r--r--. 1 root root  61G 14 août 03:07 compute-1.qcow2
-rw-r--r--. 1 root root  61G 14 août 03:07 compute-2.qcow2
-rw-r--r--. 1 root root  61G 14 août 03:07 control-1.qcow2
-rw-------. 1 qemu qemu  41G 14 août 03:03 dns-server.qcow2
-rw-r--r--. 1 root root 161G 14 août 03:07 storage-1.qcow2
-rw-r--r--. 1 root root 161G 14 août 03:07 storage-2.qcow2
-rw-------. 1 qemu qemu  41G 14 août 03:07 undercloud.qcow2
[root@hp-gen9 images]#
[root@hp-gen9 images]#
[root@hp-gen9 images]# chown qemu:qemu \/var\/lib\/libvirt\/images\/*.qcow2
[root@hp-gen9 images]# ls -lh
total 5.8G
drwxr-xr-x. 2 qemu qemu 4.0K 13 août 16:15 backups
-rw-r--r--. 1 qemu qemu  61G 14 août 03:07 compute-1.qcow2
-rw-r--r--. 1 qemu qemu  61G 14 août 03:07 compute-2.qcow2
-rw-r--r--. 1 qemu qemu  61G 14 août 03:07 control-1.qcow2
-rw-------. 1 qemu qemu  41G 14 août 03:03 dns-server.qcow2
-rw-r--r--. 1 qemu qemu 161G 14 août 03:07 storage-1.qcow2
-rw-r--r--. 1 qemu qemu 161G 14 août 03:07 storage-2.qcow2
-rw-------. 1 qemu qemu  41G 14 août 03:08 undercloud.qcow2
[root@hp-gen9 images]#
Remarque : si vous n'avez pas l'intention d'installer ceph dans un but d'apprentissage, ne créez pas moins de 3 nœuds avec au moins deux disques et indiquez dans le modèle que des disques virtuels vda, vdb, etc. seront utilisés.
Parfait, maintenant nous devons définir toutes ces machines :
virt-install --name control-1 --ram 32768 --vcpus 8 --os-variant centos7.0 --disk path=\/var\/lib\/libvirt\/images\/control-1.qcow2,device=disk,bus=virtio,format=qcow2 --noautoconsole --vnc  --network network:ovs-network-1,model=virtio,portgroup=access-100 --network network:ovs-network-1,model=virtio,portgroup=trunk-1 --dry-run --print-xml > \/tmp\/control-1.xml

virt-install --name storage-1 --ram 16384 --vcpus 4 --os-variant centos7.0 --disk path=\/var\/lib\/libvirt\/images\/storage-1.qcow2,device=disk,bus=virtio,format=qcow2 --noautoconsole --vnc  --network network:ovs-network-1,model=virtio,portgroup=access-100 --dry-run --print-xml > \/tmp\/storage-1.xml

virt-install --name storage-2 --ram 16384 --vcpus 4 --os-variant centos7.0 --disk path=\/var\/lib\/libvirt\/images\/storage-2.qcow2,device=disk,bus=virtio,format=qcow2 --noautoconsole --vnc  --network network:ovs-network-1,model=virtio,portgroup=access-100 --dry-run --print-xml > \/tmp\/storage-2.xml

virt-install --name compute-1 --ram 32768 --vcpus 12 --os-variant centos7.0 --disk path=\/var\/lib\/libvirt\/images\/compute-1.qcow2,device=disk,bus=virtio,format=qcow2 --noautoconsole --vnc  --network network:ovs-network-1,model=virtio,portgroup=access-100 --dry-run --print-xml > \/tmp\/compute-1.xml

virt-install --name compute-2 --ram 32768 --vcpus 12 --os-variant centos7.0 --disk path=\/var\/lib\/libvirt\/images\/compute-2.qcow2,device=disk,bus=virtio,format=qcow2 --noautoconsole --vnc  --network network:ovs-network-1,model=virtio,portgroup=access-100 --dry-run --print-xml > \/tmp\/compute-2.xml
À la fin, les commandes --print-xml > \/tmp\/storage-1.xml créent un fichier xml décrivant chaque machine dans le dossier \/tmp\, si vous ne l'ajoutez pas, vous ne pourrez pas définir les machines virtuelles.
Maintenant, nous devons définir toutes ces machines dans virsh :
virsh define --file /tmp/control-1.xml
virsh define --file /tmp/compute-1.xml
virsh define --file /tmp/compute-2.xml
virsh define --file /tmp/storage-1.xml
virsh define --file /tmp/storage-2.xml

[root@hp-gen9 ~]# virsh list --all
 Id    Name                           État
----------------------------------------------------
 6     dns-server                     en cours d'exécution
 64    undercloud                     en cours d'exécution
 -     compute-1                      arrêté
 -     compute-2                      arrêté
 -     control-1                      arrêté
 -     storage-1                      arrêté
 -     storage-2                      arrêté

[root@hp-gen9 ~]#
Maintenant, un petit détail — tripleO utilise IPMI pour gérer les serveurs pendant l'installation et l'introspection.
L'introspection est le processus d'inspection du matériel afin d'obtenir ses paramètres nécessaires pour le provisionnement ultérieur des nœuds. L'introspection est effectuée à l'aide d'ironic — un service conçu pour travailler avec des serveurs bare metal.
Mais ici se pose un problème — si pour les serveurs physiques, IPMI est un port séparé (ou un port partagé, mais ce n'est pas l'essentiel), les machines virtuelles n'ont pas de tels ports. Ici, nous avons un outil appelé vbmc — une utility qui permet d'émuler un port IPMI. Ce détail mérite une attention particulière, notamment pour ceux qui souhaitent mettre en place un tel laboratoire sur un hyperviseur ESXi — je ne sais pas s'il existe un analogue à vbmc, c'est donc une question à considérer avant de tout déployer.
Installation de vbmc :
yum install python2-virtualbmcSi votre système d'exploitation ne trouve pas le paquet, ajoutez le dépôt :
yum install -y https://www.rdoproject.org/repos/rdo-release.rpmMaintenant, configurons l'outil. Ici, tout est incroyablement basique. Il est logique que la liste vbmc ne comporte aucun serveur.
[root@hp-gen9 ~]# vbmc list

[root@hp-gen9 ~]#
Pour qu'ils apparaissent, il faut les déclarer manuellement comme suit :
[root@hp-gen9 ~]# vbmc add control-1 --port 7001 --username admin --password admin
[root@hp-gen9 ~]# vbmc add storage-1 --port 7002 --username admin --password admin
[root@hp-gen9 ~]# vbmc add storage-2 --port 7003 --username admin --password admin
[root@hp-gen9 ~]# vbmc add compute-1 --port 7004 --username admin --password admin
[root@hp-gen9 ~]# vbmc add compute-2 --port 7005 --username admin --password admin
[root@hp-gen9 ~]#
[root@hp-gen9 ~]# vbmc list
+-------------+--------+---------+------+
| Nom de domaine | Statut | Adresse | Port |
+-------------+--------+---------+------+
| compute-1   | hors ligne   | ::      | 7004 |
| compute-2   | hors ligne   | ::      | 7005 |
| control-1   | hors ligne   | ::      | 7001 |
| storage-1   | hors ligne   | ::      | 7002 |
| storage-2   | hors ligne   | ::      | 7003 |
+-------------+--------+---------+------+
[root@hp-gen9 ~]#
Je pense que la syntaxe de la commande est claire sans explications. Cependant, pour l'instant, toutes nos sessions sont à l'état DOWN. Pour qu'elles passent à l'état UP, il est nécessaire de les activer :
[root@hp-gen9 ~]# vbmc start control-1
2020-08-14 03:15:57,826.826 13149 INFO VirtualBMC [-] Instance vBMC pour le domaine control-1 démarré
[root@hp-gen9 ~]# vbmc start storage-1
2020-08-14 03:15:58,316.316 13149 INFO VirtualBMC [-] Instance vBMC pour le domaine storage-1 démarré
[root@hp-gen9 ~]# vbmc start storage-2
2020-08-14 03:15:58,851.851 13149 INFO VirtualBMC [-] Instance vBMC pour le domaine storage-2 démarré
[root@hp-gen9 ~]# vbmc start compute-1
2020-08-14 03:15:59,307.307 13149 INFO VirtualBMC [-] Instance vBMC pour le domaine compute-1 démarré
[root@hp-gen9 ~]# vbmc start compute-2
2020-08-14 03:15:59,712.712 13149 INFO VirtualBMC [-] Instance vBMC pour le domaine compute-2 démarré
[root@hp-gen9 ~]#
[root@hp-gen9 ~]#
[root@hp-gen9 ~]# vbmc list
+-------------+---------+---------+------+
| Nom du domaine | Statut  | Adresse | Port |
+-------------+---------+---------+------+
| compute-1   | en cours d'exécution | ::      | 7004 |
| compute-2   | en cours d'exécution | ::      | 7005 |
| control-1   | en cours d'exécution | ::      | 7001 |
| storage-1   | en cours d'exécution | ::      | 7002 |
| storage-2   | en cours d'exécution | ::      | 7003 |
+-------------+---------+---------+------+
[root@hp-gen9 ~]#
Le dernier détail — il est nécessaire de corriger les règles du pare-feu (ou de le désactiver complètement) :
firewall-cmd --zone=public --add-port=7001/udp --permanent
firewall-cmd --zone=public --add-port=7002/udp --permanent
firewall-cmd --zone=public --add-port=7003/udp --permanent
firewall-cmd --zone=public --add-port=7004/udp --permanent
firewall-cmd --zone=public --add-port=7005/udp --permanent
firewall-cmd --reload
Maintenant, connectons-nous à l'undercloud et vérifions que tout fonctionne. L'adresse de la machine hôte — 192.168.255.200, sur l'undercloud nous avons ajouté le paquet ipmitool lors de la préparation du déploiement :
[stack@undercloud ~]$ ipmitool -I lanplus -U admin -P admin -H 192.168.255.200 -p 7001 power status
L'alimentation du châssis est éteinte
[stack@undercloud ~]$ ipmitool -I lanplus -U admin -P admin -H 192.168.255.200 -p 7001 power on
Contrôle de l'alimentation du châssis : Up/On
[stack@undercloud ~]$

[root@hp-gen9 ~]# virsh list
 Id    Nom                           État
----------------------------------------------------
 6     dns-server                     en cours d'exécution
 64    undercloud                     en cours d'exécution
 65    control-1                      en cours d'exécution
Comme vous pouvez le voir, nous avons réussi à démarrer le nœud de contrôle via vbmc. Maintenant, éteignons-le et passons à l'étape suivante :
[stack@undercloud ~]$ ipmitool -I lanplus -U admin -P admin -H 192.168.255.200 -p 7001 power off
Contrôle de l'alimentation du châssis : Down/Off
[stack@undercloud ~]$ ipmitool -I lanplus -U admin -P admin -H 192.168.255.200 -p 7001 power status
L'alimentation du châssis est éteinte
[stack@undercloud ~]$

[root@hp-gen9 ~]# virsh list --all
 Id    Nom                           État
----------------------------------------------------
 6     dns-server                     en cours d'exécution
 64    undercloud                     en cours d'exécution
 -     compute-1                      éteint
 -     compute-2                      éteint
 -     control-1                      éteint
 -     storage-1                      éteint
 -     storage-2                      éteint

[root@hp-gen9 ~]#
La prochaine étape consiste à réaliser l'introspection des nœuds sur lesquels l'overcloud sera installé. Pour cela, nous devons préparer un fichier json décrivant nos nœuds. Notez que contrairement à l'installation sur des serveurs nus, le fichier indique le port sur lequel vbmc est lancé pour chacune des machines.
[root@hp-gen9 ~]# virsh domiflist --domain control-1
Interface  Type       Source     Model       MAC
-------------------------------------------------------
-          network    ovs-network-1 virtio      52:54:00:20:a2:2f
-          network    ovs-network-1 virtio      52:54:00:3f:87:9f

[root@hp-gen9 ~]# virsh domiflist --domain compute-1
Interface  Type       Source     Model       MAC
-------------------------------------------------------
-          network    ovs-network-1 virtio      52:54:00:98:e9:d6

[root@hp-gen9 ~]# virsh domiflist --domain compute-2
Interface  Type       Source     Model       MAC
-------------------------------------------------------
-          network    ovs-network-1 virtio      52:54:00:6a:ea:be

[root@hp-gen9 ~]# virsh domiflist --domain storage-1
Interface  Type       Source     Model       MAC
-------------------------------------------------------
-          network    ovs-network-1 virtio      52:54:00:79:0b:cb

[root@hp-gen9 ~]# virsh domiflist --domain storage-2
Interface  Type       Source     Model       MAC
-------------------------------------------------------
-          network    ovs-network-1 virtio      52:54:00:a7:fe:27
Remarque : il y a deux interfaces sur le nœud de contrôle, mais dans ce cas, cela n'a pas d'importance. Pour cette installation, une seule suffit.
Préparons maintenant le fichier JSON. Nous devons indiquer l'adresse MAC du port par lequel le provisioning sera effectué, les paramètres des nœuds, leur attribuer des noms et indiquer comment accéder à l'IPMI :
{
    "nodes":[
        {
            "mac":[
                "52:54:00:20:a2:2f"
            ],
            "cpu":"8",
            "memory":"32768",
            "disk":"60",
            "arch":"x86_64",
            "name":"control-1",
            "pm_type":"pxe_ipmitool",
            "pm_user":"admin",
            "pm_password":"admin",
            "pm_addr":"192.168.255.200",
            "pm_port":"7001"
        },
        {
            "mac":[
                "52:54:00:79:0b:cb"
            ],
            "cpu":"4",
            "memory":"16384",
            "disk":"160",
            "arch":"x86_64",
            "name":"storage-1",
            "pm_type":"pxe_ipmitool",
            "pm_user":"admin",
            "pm_password":"admin",
            "pm_addr":"192.168.255.200",
            "pm_port":"7002"
        },
        {
            "mac":[
                "52:54:00:a7:fe:27"
            ],
            "cpu":"4",
            "memory":"16384",
            "disk":"160",
            "arch":"x86_64",
            "name":"storage-2",
            "pm_type":"pxe_ipmitool",
            "pm_user":"admin",
            "pm_password":"admin",
            "pm_addr":"192.168.255.200",
            "pm_port":"7003"
        },
        {
            "mac":[
                "52:54:00:98:e9:d6"
            ],
            "cpu":"12",
            "memory":"32768",
            "disk":"60",
            "arch":"x86_64",
            "name":"compute-1",
            "pm_type":"pxe_ipmitool",
            "pm_user":"admin",
            "pm_password":"admin",
            "pm_addr":"192.168.255.200",
            "pm_port":"7004"
        },
        {
            "mac":[
                "52:54:00:6a:ea:be"
            ],
            "cpu":"12",
            "memory":"32768",
            "disk":"60",
            "arch":"x86_64",
            "name":"compute-2",
            "pm_type":"pxe_ipmitool",
            "pm_user":"admin",
            "pm_password":"admin",
            "pm_addr":"192.168.255.200",
            "pm_port":"7005"
        }
    ]
}
Nous devons maintenant préparer les images pour Ironic. Pour cela, téléchargeons-les via wget et installons :
(undercloud) [stack@undercloud ~]$ sudo wget https://images.rdoproject.org/queens/delorean/current-tripleo-rdo/overcloud-full.tar --no-check-certificate
(undercloud) [stack@undercloud ~]$ sudo wget https://images.rdoproject.org/queens/delorean/current-tripleo-rdo/ironic-python-agent.tar --no-check-certificate
(undercloud) [stack@undercloud ~]$ ls -lh
total 1.9G
-rw-r--r--. 1 stack stack 447M Aug 14 10:26 ironic-python-agent.tar
-rw-r--r--. 1 stack stack 1.5G Aug 14 10:26 overcloud-full.tar
-rw-------. 1 stack stack  916 Aug 13 23:10 stackrc
-rw-r--r--. 1 stack stack  15K Aug 13 22:50 undercloud.conf
-rw-------. 1 stack stack 2.0K Aug 13 22:50 undercloud-passwords.conf
(undercloud) [stack@undercloud ~]$ mkdir images/
(undercloud) [stack@undercloud ~]$ tar -xpvf ironic-python-agent.tar -C ~/images/
ironic-python-agent.initramfs
ironic-python-agent.kernel
(undercloud) [stack@undercloud ~]$ tar -xpvf overcloud-full.tar -C ~/images/
overcloud-full.qcow2
overcloud-full.initrd
overcloud-full.vmlinuz
(undercloud) [stack@undercloud ~]$
(undercloud) [stack@undercloud ~]$ ls -lh images/
total 1.9G
-rw-rw-r--. 1 stack stack 441M Aug 12 17:24 ironic-python-agent.initramfs
-rwxr-xr-x. 1 stack stack 6.5M Aug 12 17:24 ironic-python-agent.kernel
-rw-r--r--. 1 stack stack  53M Aug 12 17:14 overcloud-full.initrd
-rw-r--r--. 1 stack stack 1.4G Aug 12 17:18 overcloud-full.qcow2
-rwxr-xr-x. 1 stack stack 6.5M Aug 12 17:14 overcloud-full.vmlinuz
(undercloud) [stack@undercloud ~]$
Téléchargement des images dans l'undercloud :
(undercloud) [stack@undercloud ~]$ openstack overcloud image upload --image-path ~/images/
L'image "overcloud-full-vmlinuz" a été téléchargée.
+--------------------------------------+------------------------+-------------+---------+--------+
|                  ID                  |          Nom           | Format de disque |   Taille  | Statut |
+--------------------------------------+------------------------+-------------+---------+--------+
| c2553770-3e0f-4750-b46b-138855b5c385 | overcloud-full-vmlinuz |     aki     | 6761064 | actif |
+--------------------------------------+------------------------+-------------+---------+--------+
L'image "overcloud-full-initrd" a été téléchargée.
+--------------------------------------+-----------------------+-------------+----------+--------+
|                  ID                  |          Nom          | Format de disque |   Taille   | Statut |
+--------------------------------------+-----------------------+-------------+----------+--------+
| 949984e0-4932-4e71-af43-d67a38c3dc89 | overcloud-full-initrd |     ari     | 55183045 | actif |
+--------------------------------------+-----------------------+-------------+----------+--------+
L'image "overcloud-full" a été téléchargée.
+--------------------------------------+----------------+-------------+------------+--------+
|                  ID                  |      Nom      | Format de disque |    Taille    | Statut |
+--------------------------------------+----------------+-------------+------------+--------+
| a2f2096d-c9d7-429a-b866-c7543c02a380 | overcloud-full |    qcow2    | 1487475712 | actif |
+--------------------------------------+----------------+-------------+------------+--------+
L'image "bm-deploy-kernel" a été téléchargée.
+--------------------------------------+------------------+-------------+---------+--------+
|                  ID                  |       Nom       | Format de disque |   Taille  | Statut |
+--------------------------------------+------------------+-------------+---------+--------+
| e413aa78-e38f-404c-bbaf-93e582a8e67f | bm-deploy-kernel |     aki     | 6761064 | actif |
+--------------------------------------+------------------+-------------+---------+--------+
L'image "bm-deploy-ramdisk" a été téléchargée.
+--------------------------------------+-------------------+-------------+-----------+--------+
|                  ID                  |        Nom       | Format de disque |    Taille   | Statut |
+--------------------------------------+-------------------+-------------+-----------+--------+
| 5cf3aba4-0e50-45d3-929f-27f025dd6ce3 | bm-deploy-ramdisk |     ari     | 461759376 | actif |
+--------------------------------------+-------------------+-------------+-----------+--------+
(undercloud) [stack@undercloud ~]$
Vérifions que toutes les images ont été téléchargées
(undercloud) [stack@undercloud ~]$ openstack image list
+--------------------------------------+------------------------+--------+
| ID                                   | Nom                    | Statut |
+--------------------------------------+------------------------+--------+
| e413aa78-e38f-404c-bbaf-93e582a8e67f | bm-deploy-kernel       | actif |
| 5cf3aba4-0e50-45d3-929f-27f025dd6ce3 | bm-deploy-ramdisk      | actif |
| a2f2096d-c9d7-429a-b866-c7543c02a380 | overcloud-full         | actif |
| 949984e0-4932-4e71-af43-d67a38c3dc89 | overcloud-full-initrd  | actif |
| c2553770-3e0f-4750-b46b-138855b5c385 | overcloud-full-vmlinuz | actif |
+--------------------------------------+------------------------+--------+
(undercloud) [stack@undercloud ~]$
Un dernier détail — il faut ajouter le serveur DNS :
(undercloud) [stack@undercloud ~]$ openstack subnet list
+--------------------------------------+-----------------+--------------------------------------+------------------+
| ID                                   | Name            | Network                              | Subnet           |
+--------------------------------------+-----------------+--------------------------------------+------------------+
| f45dea46-4066-42aa-a3c4-6f84b8120cab | ctlplane-subnet | 6ca013dc-41c2-42d8-9d69-542afad53392 | 192.168.255.0/24 |
+--------------------------------------+-----------------+--------------------------------------+------------------+
(undercloud) [stack@undercloud ~]$ openstack subnet show f45dea46-4066-42aa-a3c4-6f84b8120cab
+-------------------+-----------------------------------------------------------+
| Field             | Value                                                     |
+-------------------+-----------------------------------------------------------+
| allocation_pools  | 192.168.255.11-192.168.255.50                             |
| cidr              | 192.168.255.0/24                                          |
| created_at        | 2020-08-13T20:10:37Z                                      |
| description       |                                                           |
| dns_nameservers   |                                                           |
| enable_dhcp       | True                                                      |
| gateway_ip        | 192.168.255.1                                             |
| host_routes       | destination='169.254.169.254/32', gateway='192.168.255.1' |
| id                | f45dea46-4066-42aa-a3c4-6f84b8120cab                      |
| ip_version        | 4                                                         |
| ipv6_address_mode | None                                                      |
| ipv6_ra_mode      | None                                                      |
| name              | ctlplane-subnet                                           |
| network_id        | 6ca013dc-41c2-42d8-9d69-542afad53392                      |
| prefix_length     | None                                                      |
| project_id        | a844ccfcdb2745b198dde3e1b28c40a3                          |
| revision_number   | 0                                                         |
| segment_id        | None                                                      |
| service_types     |                                                           |
| subnetpool_id     | None                                                      |
| tags              |                                                           |
| updated_at        | 2020-08-13T20:10:37Z                                      |
+-------------------+-----------------------------------------------------------+
(undercloud) [stack@undercloud ~]$
(undercloud) [stack@undercloud ~]$ neutron subnet-update f45dea46-4066-42aa-a3c4-6f84b8120cab --dns-nameserver 192.168.255.253
neutron CLI est obsolète et sera supprimé à l'avenir. Utilisez plutôt l'interface en ligne de commande openstack.
Sous-réseau mis à jour : f45dea46-4066-42aa-a3c4-6f84b8120cab
(undercloud) [stack@undercloud ~]$
Nous pouvons maintenant donner la commande d'inspection :
(undercloud) [stack@undercloud ~]$ openstack overcloud node import --introspect --provide inspection.json
Workflow Mistral tripleo.baremetal.v1.register_or_update démarré. ID d'exécution : d57456a3-d8ed-479c-9a90-dff7c752d0ec
Attente de messages sur la file 'tripleo' sans timeout.


5 nœuds déplacés avec succès vers l'état "gérable".
Nœud UUID b4b2cf4a-b7ca-4095-af13-cc83be21c4f5 enregistré avec succès
Nœud UUID b89a72a3-6bb7-429a-93bc-48393d225838 enregistré avec succès
Nœud UUID 20a16cc0-e0ce-4d88-8f17-eb0ce7b4d69e enregistré avec succès
Nœud UUID bfc1eb98-a17a-4a70-b0b6-6c0db0eac8e8 enregistré avec succès
Nœud UUID 766ab623-464c-423d-a529-d9afb69d1167 enregistré avec succès
Attente de la fin de l'introspection...
Workflow Mistral tripleo.baremetal.v1.introspect démarré. ID d'exécution : 6b4d08ae-94c3-4a10-ab63-7634ec198a79
Attente de messages sur la file 'tripleo' sans timeout.
Introspection du nœud b89a72a3-6bb7-429a-93bc-48393d225838 complétée. Statut : SUCCÈS. Erreurs : Aucune
Introspection du nœud 20a16cc0-e0ce-4d88-8f17-eb0ce7b4d69e complétée. Statut : SUCCÈS. Erreurs : Aucune
Introspection du nœud bfc1eb98-a17a-4a70-b0b6-6c0db0eac8e8 complétée. Statut : SUCCÈS. Erreurs : Aucune
Introspection du nœud 766ab623-464c-423d-a529-d9afb69d1167 complétée. Statut : SUCCÈS. Erreurs : Aucune
Introspection du nœud b4b2cf4a-b7ca-4095-af13-cc83be21c4f5 complétée. Statut : SUCCÈS. Erreurs : Aucune
5 nœuds ont été introspectés avec succès.
Workflow Mistral tripleo.baremetal.v1.provide démarré. ID d'exécution : f5594736-edcf-4927-a8a0-2a7bf806a59a
Attente de messages sur la file 'tripleo' sans timeout.
5 nœuds déplacés avec succès vers l'état "disponible".
(undercloud) [stack@undercloud ~]$
Comme on peut le voir dans la sortie, tout s'est terminé sans erreurs. Vérifions que tous les nœuds sont en état disponible :
(undercloud) [stack@undercloud ~]$ openstack baremetal node list
+--------------------------------------+-----------+---------------+-------------+--------------------+-------------+
| UUID                                 | Nom       | UUID de l'instance | État de l'alimentation | État de provisionnement | Maintenance |
+--------------------------------------+-----------+---------------+-------------+--------------------+-------------+
| b4b2cf4a-b7ca-4095-af13-cc83be21c4f5 | control-1 | Aucune        | éteint      | disponible         | Faux        |
| b89a72a3-6bb7-429a-93bc-48393d225838 | storage-1 | Aucune        | éteint      | disponible         | Faux        |
| 20a16cc0-e0ce-4d88-8f17-eb0ce7b4d69e | storage-2 | Aucune        | éteint      | disponible         | Faux        |
| bfc1eb98-a17a-4a70-b0b6-6c0db0eac8e8 | compute-1 | Aucune        | éteint      | disponible         | Faux        |
| 766ab623-464c-423d-a529-d9afb69d1167 | compute-2 | Aucune        | éteint      | disponible         | Faux        |
+--------------------------------------+-----------+---------------+-------------+--------------------+-------------+
(undercloud) [stack@undercloud ~]$
Si les nœuds sont dans un autre état, généralement gérable, cela indique qu'il y a un problème et qu'il faut consulter les logs pour comprendre pourquoi. Gardez à l'esprit que dans ce scénario, nous utilisons la virtualisation et qu'il pourrait y avoir des bogues liés à l'utilisation de machines virtuelles ou de vbmc.
Ensuite, nous devons indiquer quel nœud va exécuter quelle fonction — c'est-à-dire spécifier le profil avec lequel le nœud sera déployé :
(undercloud) [stack@undercloud ~]$ openstack overcloud profiles list
+--------------------------------------+-----------+-----------------+-----------------+-------------------+
| UUID du nœud                        | Nom du nœud | État de provisionnement | Profil actuel | Profils possibles |
+--------------------------------------+-----------+-----------------+-----------------+-------------------+
| b4b2cf4a-b7ca-4095-af13-cc83be21c4f5 | control-1 | disponible       | Aucun           |                   |
| b89a72a3-6bb7-429a-93bc-48393d225838 | storage-1 | disponible       | Aucun           |                   |
| 20a16cc0-e0ce-4d88-8f17-eb0ce7b4d69e | storage-2 | disponible       | Aucun           |                   |
| bfc1eb98-a17a-4a70-b0b6-6c0db0eac8e8 | compute-1 | disponible       | Aucun           |                   |
| 766ab623-464c-423d-a529-d9afb69d1167 | compute-2 | disponible       | Aucun           |                   |
+--------------------------------------+-----------+-----------------+-----------------+-------------------+
(undercloud) [stack@undercloud ~]$ openstack flavor list
+--------------------------------------+---------------+------+------+-----------+-------+-----------+
| ID                                   | Nom          |  RAM | Disque | Éphémère | VCPUs | Est public |
+--------------------------------------+---------------+------+------+-----------+-------+-----------+
| 168af640-7f40-42c7-91b2-989abc5c5d8f | swift-storage | 4096 |   40 |         0 |     1 | Vrai      |
| 52148d1b-492e-48b4-b5fc-772849dd1b78 | baremetal     | 4096 |   40 |         0 |     1 | Vrai      |
| 56e66542-ae60-416d-863e-0cb192d01b09 | contrôle      | 4096 |   40 |         0 |     1 | Vrai      |
| af6796e1-d0c4-4bfe-898c-532be194f7ac | block-storage | 4096 |   40 |         0 |     1 | Vrai      |
| e4d50fdd-0034-446b-b72c-9da19b16c2df | compute       | 4096 |   40 |         0 |     1 | Vrai      |
| fc2e3acf-7fca-4901-9eee-4a4d6ef0265d | ceph-storage  | 4096 |   40 |         0 |     1 | Vrai      |
+--------------------------------------+---------------+------+------+-----------+-------+-----------+
(undercloud) [stack@undercloud ~]$
Définissons un profil pour chaque nœud :
openstack baremetal node set --property capabilities='profile:control,boot_option:local' b4b2cf4a-b7ca-4095-af13-cc83be21c4f5
openstack baremetal node set --property capabilities='profile:ceph-storage,boot_option:local' b89a72a3-6bb7-429a-93bc-48393d225838
openstack baremetal node set --property capabilities='profile:ceph-storage,boot_option:local' 20a16cc0-e0ce-4d88-8f17-eb0ce7b4d69e
openstack baremetal node set --property capabilities='profile:compute,boot_option:local' bfc1eb98-a17a-4a70-b0b6-6c0db0eac8e8
openstack baremetal node set --property capabilities='profile:compute,boot_option:local' 766ab623-464c-423d-a529-d9afb69d1167
Vérifions que nous avons fait tout correctement :
(undercloud) [stack@undercloud ~]$ openstack overcloud profiles list
+--------------------------------------+-----------+-----------------+-----------------+-------------------+
| Node UUID                            | Node Name | Provision State | Current Profile | Possible Profiles |
+--------------------------------------+-----------+-----------------+-----------------+-------------------+
| b4b2cf4a-b7ca-4095-af13-cc83be21c4f5 | control-1 | disponible      | control         |                   |
| b89a72a3-6bb7-429a-93bc-48393d225838 | storage-1 | disponible      | ceph-storage    |                   |
| 20a16cc0-e0ce-4d88-8f17-eb0ce7b4d69e | storage-2 | disponible      | ceph-storage    |                   |
| bfc1eb98-a17a-4a70-b0b6-6c0db0eac8e8 | compute-1 | disponible      | compute         |                   |
| 766ab623-464c-423d-a529-d9afb69d1167 | compute-2 | disponible      | compute         |                   |
+--------------------------------------+-----------+-----------------+-----------------+-------------------+
(undercloud) [stack@undercloud ~]$
Si tout est correct, lançons la commande pour déployer overcloud :
openstack overcloud deploy --templates --control-scale 1 --compute-scale 2 --ceph-storage-scale 2 --control-flavor control --compute-flavor compute --ceph-storage-flavor ceph-storage --libvirt-type qemuDans une installation réelle, des modèles personnalisés seront naturellement utilisés, ce qui compliquerait considérablement le processus, car il faudrait expliquer chaque modification dans le modèle. Comme mentionné précédemment, une installation simple nous suffira pour voir comment cela fonctionne.
Remarque : la variable —libvirt-type qemu est nécessaire ici, car nous allons utiliser la virtualisation imbriquée. Sinon, vos machines virtuelles ne démarreront pas.
Maintenant, vous avez environ une heure, voire plus (cela dépend des capacités du matériel), et il ne vous reste plus qu'à espérer qu'après ce délai, vous verrez le message suivant :
2020-08-14 08:39:21Z [overcloud]: CREATE_COMPLETE  Stack CREATE completed successfully

 Stack overcloud CREATE_COMPLETE

Hôte 192.168.255.21 introuvable dans /home/stack/.ssh/known_hosts
Workflow Mistral tripleo.deployment.v1.get_horizon_url démarré. ID d'exécution : fcb996cd-6a19-482b-b755-2ca0c08069a9
Point de terminaison Overcloud : http://192.168.255.21:5000/
URL du tableau de bord Overcloud Horizon : http://192.168.255.21:80/dashboard
Fichier rc Overcloud : /home/stack/overcloudrc
Overcloud déployé
(undercloud) [stack@undercloud ~]$
Vous avez maintenant une version presque complète d'OpenStack, sur laquelle vous pouvez apprendre, faire des expériences, etc.
Vérifions que tout fonctionne correctement. Dans le répertoire personnel de l'utilisateur stack, il y a deux fichiers — l'un stackrc (pour gérer undercloud) et l'autre overcloudrc (pour gérer overcloud). Ces fichiers doivent être spécifiés comme source, car ils contiennent les informations nécessaires pour l'authentification.
(undercloud) [stack@undercloud ~]$ openstack server list
+--------------------------------------+-------------------------+--------+-------------------------+----------------+--------------+
| ID                                   | Nom                     | Statut | Réseaux                | Image          | Type         |
+--------------------------------------+-------------------------+--------+-------------------------+----------------+--------------+
| fd7d36f4-ce87-4b9a-93b0-add2957792de | overcloud-controller-0  | ACTIF  | ctlplane=192.168.255.15 | overcloud-full | contrôle     |
| edc77778-8972-475e-a541-ff40eb944197 | overcloud-novacompute-1 | ACTIF  | ctlplane=192.168.255.26 | overcloud-full | calculer     |
| 5448ce01-f05f-47ca-950a-ced14892c0d4 | overcloud-cephstorage-1 | ACTIF  | ctlplane=192.168.255.34 | overcloud-full | stockage ceph |
| ce6d862f-4bdf-4ba3-b711-7217915364d7 | overcloud-novacompute-0 | ACTIF  | ctlplane=192.168.255.19 | overcloud-full | calculer     |
| e4507bd5-6f96-4b12-9cc0-6924709da59e | overcloud-cephstorage-0 | ACTIF  | ctlplane=192.168.255.44 | overcloud-full | stockage ceph |
+--------------------------------------+-------------------------+--------+-------------------------+----------------+--------------+
(undercloud) [stack@undercloud ~]$
(undercloud) [stack@undercloud ~]$ source overcloudrc
(overcloud) [stack@undercloud ~]$
(overcloud) [stack@undercloud ~]$ openstack project list
+----------------------------------+---------+
| ID                               | Nom     |
+----------------------------------+---------+
| 4eed7d0f06544625857d51cd77c5bd4c | admin   |
| ee1c68758bde41eaa9912c81dc67dad8 | service |
+----------------------------------+---------+
(overcloud) [stack@undercloud ~]$
(overcloud) [stack@undercloud ~]$
(overcloud) [stack@undercloud ~]$ openstack network agent list
+--------------------------------------+--------------------+-------------------------------------+-------------------+-------+-------+---------------------------+
| ID                                   | Type d'agent        | Hôte                                | Zone de disponibilité | Actif | État  | Binaire                   |
+--------------------------------------+--------------------+-------------------------------------+-------------------+-------+-------+---------------------------+
| 10495de9-ba4b-41fe-b30a-b90ec3f8728b | agent Open vSwitch  | overcloud-novacompute-1.localdomain | Aucun             | :-)   | EN MARCHE | neutron-openvswitch-agent |
| 1515ad4a-5972-46c3-af5f-e5446dff7ac7 | agent L3            | overcloud-controller-0.localdomain  | nova              | :-)   | EN MARCHE | neutron-l3-agent          |
| 322e62ca-1e5a-479e-9a96-4f26d09abdd7 | agent DHCP          | overcloud-controller-0.localdomain  | nova              | :-)   | EN MARCHE | neutron-dhcp-agent        |
| 9c1de2f9-bac5-400e-998d-4360f04fc533 | agent Open vSwitch  | overcloud-novacompute-0.localdomain | Aucun             | :-)   | EN MARCHE | neutron-openvswitch-agent |
| d99c5657-851e-4d3c-bef6-f1e3bb1acfb0 | agent Open vSwitch  | overcloud-controller-0.localdomain  | Aucun             | :-)   | EN MARCHE | neutron-openvswitch-agent |
| ff85fae6-5543-45fb-a301-19c57b62d836 | agent de métadonnées | overcloud-controller-0.localdomain  | Aucun             | :-)   | EN MARCHE | neutron-metadata-agent    |
+--------------------------------------+--------------------+-------------------------------------+-------------------+-------+-------+---------------------------+
(overcloud) [stack@undercloud ~]$
Dans mon installation, il reste un dernier petit détail à ajouter — créer une route sur le contrôleur, car la machine avec laquelle je travaille se trouve dans un autre réseau. Pour cela, connectez-vous à control-1 avec le compte heat-admin et ajoutez la route.
(undercloud) [stack@undercloud ~]$ ssh heat-admin@192.168.255.15
Dernière connexion : ven. 14 août 2020 09:47:40 depuis 192.168.255.1
[heat-admin@overcloud-controller-0 ~]$
[heat-admin@overcloud-controller-0 ~]$
[heat-admin@overcloud-controller-0 ~]$ sudo ip route add 10.169.0.0/16 via 192.168.255.254
Et maintenant, vous pouvez accéder à l'horizon. Toutes les informations — adresses, identifiant et mot de passe — se trouvent dans le fichier /home/stack/overcloudrc. Le schéma final est le suivant :
À propos, dans notre installation, les adresses des machines étaient attribuées via DHCP et comme vous le voyez, elles sont données de manière aléatoire. Vous pouvez dans le modèle définir rigidement quelle adresse doit être attachée à quelle machine lors du déploiement, si nécessaire.
Comment le trafic circule-t-il entre les machines virtuelles ?
Dans cet article, nous examinerons trois options pour le passage du trafic
- Deux machines sur un même hyperviseur dans un même réseau L2
- Deux machines sur des hyperviseurs différents dans un même réseau L2
- Deux machines dans des réseaux différents (routage entre les réseaux)
Nous examinerons les cas sortant vers le monde extérieur via un réseau externe, en utilisant des adresses flottantes, ainsi que le routage distribué la prochaine fois, pour l'instant concentrons-nous sur le trafic interne.
Pour vérifier, construisons un tel schéma :
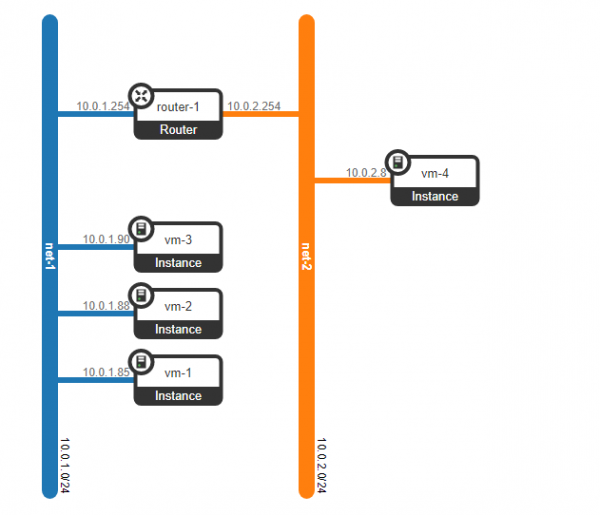
Nous avons créé 4 machines virtuelles — 3 dans un même réseau L2 — net-1, et 1 autre dans le réseau net-2
(overcloud) [stack@undercloud ~]$ nova list --tenant 5e18ce8ec9594e00b155485f19895e6c
+--------------------------------------+------+----------------------------------+--------+------------+-------------+-----------------+
| ID                                   | Nom  | ID de locataire                  | Statut | État de la tâche | État d'alimentation | Réseaux        |
+--------------------------------------+------+----------------------------------+--------+------------+-------------+-----------------+
| f53b37b5-2204-46cc-aef0-dba84bf970c0 | vm-1 | 5e18ce8ec9594e00b155485f19895e6c | ACTIF  | -          | En cours d'exécution | net-1=10.0.1.85 |
| fc8b6722-0231-49b0-b2fa-041115bef34a | vm-2 | 5e18ce8ec9594e00b155485f19895e6c | ACTIF  | -          | En cours d'exécution | net-1=10.0.1.88 |
| 3cd74455-b9b7-467a-abe3-bd6ff765c83c | vm-3 | 5e18ce8ec9594e00b155485f19895e6c | ACTIF  | -          | En cours d'exécution | net-1=10.0.1.90 |
| 7e836338-6772-46b0-9950-f7f06dbe91a8 | vm-4 | 5e18ce8ec9594e00b155485f19895e6c | ACTIF  | -          | En cours d'exécution | net-2=10.0.2.8  |
+--------------------------------------+------+----------------------------------+--------+------------+-------------+-----------------+
(overcloud) [stack@undercloud ~]$
Voyons sur quels hyperviseurs sont situées les machines créées :
(overcloud) [stack@undercloud ~]$ nova show f53b37b5-2204-46cc-aef0-dba84bf970c0 | egrep "hypervisor_hostname|instance_name|hostname"
| OS-EXT-SRV-ATTR:hostname             | vm-1                                                     |
| OS-EXT-SRV-ATTR:hypervisor_hostname  | overcloud-novacompute-0.localdomain                      |
| OS-EXT-SRV-ATTR:instance_name        | instance-00000001                                        |
(overcloud) [stack@undercloud ~]$ nova show fc8b6722-0231-49b0-b2fa-041115bef34a | egrep "hypervisor_hostname|instance_name|hostname"
| OS-EXT-SRV-ATTR:hostname | vm-2 |
| OS-EXT-SRV-ATTR:hypervisor_hostname | overcloud-novacompute-1.localdomain |
| OS-EXT-SRV-ATTR:instance_name | instance-00000002 |(overcloud) [stack@undercloud ~]$ nova show 3cd74455-b9b7-467a-abe3-bd6ff765c83c | egrep "hypervisor_hostname|instance_name|hostname"
| OS-EXT-SRV-ATTR:hostname | vm-3 |
| OS-EXT-SRV-ATTR:hypervisor_hostname | overcloud-novacompute-0.localdomain |
| OS-EXT-SRV-ATTR:instance_name | instance-00000003 |(overcloud) [stack@undercloud ~]$ nova show 7e836338-6772-46b0-9950-f7f06dbe91a8 | egrep "hypervisor_hostname|instance_name|hostname"
| OS-EXT-SRV-ATTR:hostname | vm-4 |
| OS-EXT-SRV-ATTR:hypervisor_hostname | overcloud-novacompute-1.localdomain |
| OS-EXT-SRV-ATTR:instance_name | instance-00000004 | (overcloud) [stack@undercloud ~]$
Les machines vm-1 et vm-3 sont situées sur compute-0, tandis que les machines vm-2 et vm-4 se trouvent sur le nœud compute-1.
De plus, un routeur virtuel a été créé pour permettre le routage entre les réseaux spécifiés :
(overcloud) [stack@undercloud ~]$ openstack router list  --project 5e18ce8ec9594e00b155485f19895e6c
+--------------------------------------+----------+--------+-------+-------------+-------+----------------------------------+
| ID                                   | Name     | Status | State | Distributed | HA    | Project                          |
+--------------------------------------+----------+--------+-------+-------------+-------+----------------------------------+
| 0a4d2420-4b9c-46bd-aec1-86a1ef299abe | router-1 | ACTIVE | UP    | False       | False | 5e18ce8ec9594e00b155485f19895e6c |
+--------------------------------------+----------+--------+-------+-------------+-------+----------------------------------+
(overcloud) [stack@undercloud ~]$
Le routeur dispose de deux ports virtuels, qui agissent comme des passerelles pour les réseaux :
(overcloud) [stack@undercloud ~]$ openstack router show 0a4d2420-4b9c-46bd-aec1-86a1ef299abe | grep interface
| interfaces_info         | [{"subnet_id": "2529ad1a-6b97-49cd-8515-cbdcbe5e3daa", "ip_address": "10.0.1.254", "port_id": "0c52b15f-8fcc-4801-bf52-7dacc72a5201"}, {"subnet_id": "335552dd-b35b-456b-9df0-5aac36a3ca13", "ip_address": "10.0.2.254", "port_id": "92fa49b5-5406-499f-ab8d-ddf28cc1a76c"}] |
(overcloud) [stack@undercloud ~]$
Mais avant de voir comment le trafic circule, examinons ce que nous avons pour le moment sur le nœud de contrôle (qui est également un nœud réseau) et sur le nœud compute. Commençons par le nœud compute.
[heat-admin@overcloud-novacompute-0 ~]$ sudo ovs-vsctl show
[heat-admin@overcloud-novacompute-0 ~]$ sudo sudo ovs-appctl dpif/show
system@ovs-system: hit:3 missed:3
  br-ex:
    br-ex 65534/1: (interne)
    phy-br-ex 1/none: (patch: peer=int-br-ex)
  br-int:
    br-int 65534/2: (interne)
    int-br-ex 1/none: (patch: peer=phy-br-ex)
    patch-tun 2/none: (patch: peer=patch-int)
  br-tun:
    br-tun 65534/3: (interne)
    patch-int 1/none: (patch: peer=patch-tun)
    vxlan-c0a8ff0f 3/4: (vxlan: egress_pkt_mark=0, key=flow, local_ip=192.168.255.19, remote_ip=192.168.255.15)
    vxlan-c0a8ff1a 2/4: (vxlan: egress_pkt_mark=0, key=flow, local_ip=192.168.255.19, remote_ip=192.168.255.26)
[heat-admin@overcloud-novacompute-0 ~]$
Actuellement, il y a trois ponts OVS sur le nœud — br-int, br-tun, br-ex. Comme nous le voyons, il y a un ensemble d'interfaces entre eux. Pour simplifier la perception, représentons toutes ces interfaces sur un schéma et voyons ce que cela donne.
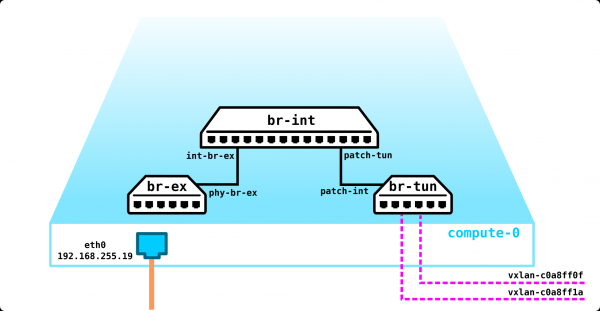
Il est visible sur les adresses où les tunnels VxLAN sont établis qu'un tunnel est sur compute-1 (192.168.255.26) et l'autre sur control-1 (192.168.255.15). Mais ce qui est le plus intéressant, c'est que br-ex n'a pas d'interfaces physiques, et si l'on regarde quelles règles sont configurées, il est clair que ce pont ne peut actuellement que rejeter du trafic.
[heat-admin@overcloud-novacompute-0 ~]$ ifconfig eth0
gcan0: flags=4163  mtu 1450
        inet 192.168.255.19  netmask 255.255.255.0  broadcast 192.168.255.255
        inet6 fe80::5054:ff:fe6a:eabe  prefixlen 64  scopeid 0x20
        ether 52:54:00:6a:ea:be  txqueuelen 1000  (Ethernet)
        RX packets 2909669  bytes 4608201000 (4.2 GiB)
        RX errors 0  dropped 0  overruns 0  frame 0
        TX packets 1821057  bytes 349198520 (333.0 MiB)
        TX errors 0  dropped 0 overruns 0  carrier 0  collisions 0

[heat-admin@overcloud-novacompute-0 ~]$
Comme on peut le voir dans la sortie, l'adresse est directement attachée au port physique et non à l'interface de pont virtuel.
[heat-admin@overcloud-novacompute-0 ~]$  sudo ovs-appctl fdb/show br-ex
 port  VLAN  MAC                Age
[heat-admin@overcloud-novacompute-0 ~]$  sudo ovs-ofctl dump-flows br-ex
 cookie=0x9169eae8f7fe5bb2, duration=216686.864s, table=0, n_packets=303, n_bytes=26035, priority=2,in_port="phy-br-ex" actions=drop
 cookie=0x9169eae8f7fe5bb2, duration=216686.887s, table=0, n_packets=0, n_bytes=0, priority=0 actions=NORMAL
[heat-admin@overcloud-novacompute-0 ~]$
Selon la première règle, tout ce qui vient du port phy-br-ex doit être rejeté.
En réalité, il n'y a pas d'autre source de trafic pour ce pont que via cette interface (connexion avec br-int), et à en juger par les rejets, le pont a déjà reçu du trafic BUM.
Cela signifie que le trafic de ce nœud ne peut sortir que par un tunnel VxLAN et pas autrement. Cependant, si vous activez le DVR, la situation changera, mais nous verrons cela une autre fois. En utilisant l'isolation réseau, par exemple avec des VLAN, vous aurez plusieurs interfaces L3 dans le VLAN 0 au lieu d'une seule. Cependant, le trafic VxLAN sortira du nœud de la même manière, mais encapsulé également dans un VLAN dédié.
Nous avons compris le nœud de calcul, passons au nœud de contrôle.
[heat-admin@overcloud-controller-0 ~]$ sudo ovs-appctl dpif/show
system@ovs-system: hit:930491 missed:825
  br-ex:
    br-ex 65534/1: (interne)
    eth0 1/2: (système)
    phy-br-ex 2/none: (patch: peer=int-br-ex)
  br-int:
    br-int 65534/3: (interne)
    int-br-ex 1/none: (patch: peer=phy-br-ex)
    patch-tun 2/none: (patch: peer=patch-int)
  br-tun:
    br-tun 65534/4: (interne)
    patch-int 1/none: (patch: peer=patch-tun)
    vxlan-c0a8ff13 3/5: (vxlan: egress_pkt_mark=0, key=flow, local_ip=192.168.255.15, remote_ip=192.168.255.19)
    vxlan-c0a8ff1a 2/5: (vxlan: egress_pkt_mark=0, key=flow, local_ip=192.168.255.15, remote_ip=192.168.255.26)
[heat-admin@overcloud-controller-0 ~]$
En fait, on peut dire que tout est pareil, cependant, l'adresse IP n'est plus sur l'interface physique mais sur le pont virtuel. Cela a été fait car ce port est le port par lequel le trafic sortira vers l'extérieur.
[heat-admin@overcloud-controller-0 ~]$ ifconfig br-ex
br-ex: flags=4163  mtu 1450
        inet 192.168.255.15  netmask 255.255.255.0  broadcast 192.168.255.255
        inet6 fe80::5054:ff:fe20:a22f  prefixlen 64  scopeid 0x20
        ether 52:54:00:20:a2:2f  txqueuelen 1000  (Ethernet)
        RX packets 803859  bytes 1732616116 (1.6 GiB)
        RX errors 0  dropped 63  overruns 0  frame 0
        TX packets 808475  bytes 121652156 (116.0 MiB)
        TX errors 0  dropped 0 overruns 0  carrier 0  collisions 0

[heat-admin@overcloud-controller-0 ~]$
[heat-admin@overcloud-controller-0 ~]$ sudo ovs-appctl fdb/show br-ex
 port  VLAN  MAC                Age
    3   100  28:c0:da:00:4d:d3   35
    1     0  28:c0:da:00:4d:d3   35
    1     0  52:54:00:98:e9:d6    0
LOCAL     0  52:54:00:20:a2:2f    0
    1     0  52:54:00:2c:08:9e    0
    3   100  52:54:00:20:a2:2f    0
    1     0  52:54:00:6a:ea:be    0
[heat-admin@overcloud-controller-0 ~]$
Ce port est lié au pont br-ex et, étant donné qu'il n'a pas de balises VLAN, ce port est un port de tronc sur lequel tous les VLAN sont autorisés. Actuellement, le trafic sort sans balise, comme l'indique l'ID VLAN 0 dans la sortie ci-dessus.
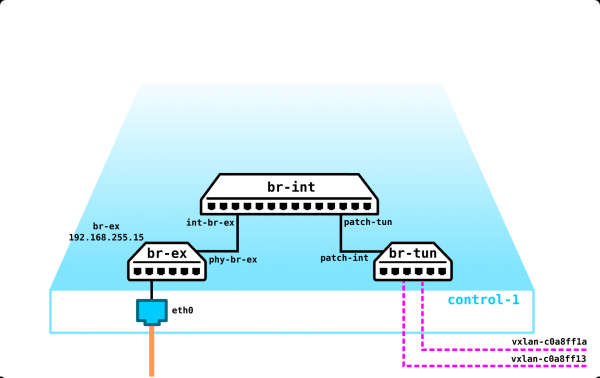
Tout le reste est actuellement similaire au nœud de calcul : les mêmes ponts, les mêmes tunnels menant vers deux nœuds de calcul.
Nous ne traiterons pas des nœuds de stockage dans cet article, mais pour comprendre, il est nécessaire de dire que la partie réseau de ces nœuds est d'une banalité désarmante. Dans notre cas, il n'y a qu'un seul port physique (eth0) auquel est attribuée une adresse IP, et c'est tout. Il n'y a pas de tunnels VxLAN, de ponts de tunnels, etc. — il n'y a pas d'ovs en général, car cela n'a pas de sens. Lors de l'utilisation de l'isolation des réseaux, ce nœud disposera de deux interfaces (ports physiques, bonds, ou simplement deux VLAN — peu importe — cela dépend de ce que vous souhaitez) — une pour la gestion, une autre pour le trafic (écriture sur le disque VM, lecture depuis le disque, etc.).
Nous avons compris ce que nous avons sur les nœuds en l'absence de tout service. Maintenant, lançons 4 machines virtuelles et voyons comment le schéma décrit ci-dessus va changer — nous devrions voir apparaître des ports, des routeurs virtuels, etc.
Pour l'instant, notre réseau ressemble à ceci :
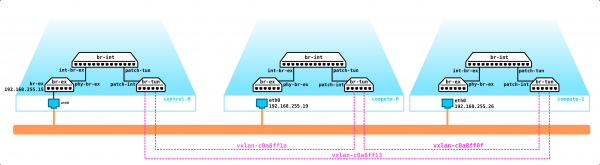
Nous avons deux machines virtuelles sur chaque nœud de calcul. Prenons l'exemple de compute-0 pour voir comment tout est configuré.
[heat-admin@overcloud-novacompute-0 ~]$ sudo virsh list
 Id    Name                           State
----------------------------------------------------
 1     instance-00000001              running
 3     instance-00000003              running

[heat-admin@overcloud-novacompute-0 ~]$
La machine n'a qu'une seule interface virtuelle — tap95d96a75-a0 :
[heat-admin@overcloud-novacompute-0 ~]$ sudo virsh domiflist instance-00000001
Interface  Type       Source     Model       MAC
-------------------------------------------------------
tap95d96a75-a0 bridge     qbr95d96a75-a0 virtio      fa:16:3e:44:98:20

[heat-admin@overcloud-novacompute-0 ~]$
Cette interface est connectée au pont Linux :
[heat-admin@overcloud-novacompute-0 ~]$ sudo brctl show
bridge name     bridge id               STP enabled     interfaces
docker0         8000.0242904c92a8       no
qbr5bd37136-47          8000.5e4e05841423       no              qvb5bd37136-47
                                                        tap5bd37136-47
qbr95d96a75-a0          8000.de076cb850f6       no              qvb95d96a75-a0
                                                        tap95d96a75-a0
[heat-admin@overcloud-novacompute-0 ~]$
Comme on peut le voir dans la sortie, il n'y a que deux interfaces dans le pont — tap95d96a75-a0 et qvb95d96a75-a0.
Il convient de s'attarder un peu sur les types de dispositifs réseau virtuels dans OpenStack :
vtap — interface virtuelle attachée à une instance (VM)
qbr — pont Linux
qvb et qvo — paire vEth connectée au pont Linux et au pont Open vSwitch
br-int, br-tun, br-vlan — ponts Open vSwitch
patch-, int-br-, phy-br- — interfaces patch Open vSwitch, reliant les ponts
qg, qr, ha, fg, sg — ports Open vSwitch utilisés par les dispositifs virtuels pour se connecter à OVS
Comme vous le comprenez, si nous avons dans le bridge un port qvb95d96a75-a0 qui est une paire vEth, il doit y avoir un côté correspondant qui devrait logiquement s'appeler qvo95d96a75-a0. Voyons quels ports sont présents sur OVS.
[heat-admin@overcloud-novacompute-0 ~]$ sudo sudo ovs-appctl dpif/show
system@ovs-system: hit:526 missed:91
  br-ex:
    br-ex 65534/1: (interne)
    phy-br-ex 1/none: (patch: peer=int-br-ex)
  br-int:
    br-int 65534/2: (interne)
    int-br-ex 1/none: (patch: peer=phy-br-ex)
    patch-tun 2/none: (patch: peer=patch-int)
    qvo5bd37136-47 6/6: (système)
    qvo95d96a75-a0 3/5: (système)
  br-tun:
    br-tun 65534/3: (interne)
    patch-int 1/none: (patch: peer=patch-tun)
    vxlan-c0a8ff0f 3/4: (vxlan: egress_pkt_mark=0, key=flow, local_ip=192.168.255.19, remote_ip=192.168.255.15)
    vxlan-c0a8ff1a 2/4: (vxlan: egress_pkt_mark=0, key=flow, local_ip=192.168.255.19, remote_ip=192.168.255.26)
[heat-admin@overcloud-novacompute-0 ~]$
Comme nous le voyons, le port se trouve dans br-int. Br-int joue le rôle de commutateur, terminant les ports des machines virtuelles. En plus de qvo95d96a75-a0, on voit dans la sortie le port qvo5bd37136-47. C'est le port de la deuxième machine virtuelle. Au final, notre schéma ressemble maintenant à ceci :
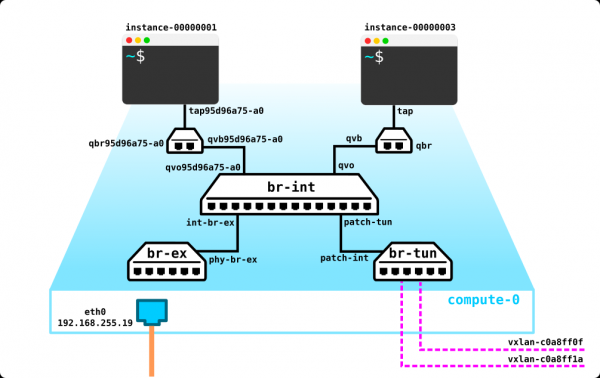
La question qui devrait immédiatement intéresser le lecteur attentif est : pourquoi un bridge linux entre le port de la machine virtuelle et le port OVS ? En fait, pour protéger la machine, on utilise des groupes de sécurité, qui ne sont rien d'autre que des iptables. OVS ne fonctionne pas avec iptables, c'est pourquoi un tel "bricolage" a été inventé. Cependant, cela devient obsolète — la solution conntrack arrive dans les nouvelles versions.
Ainsi, en fin de compte, le schéma ressemble à ceci :
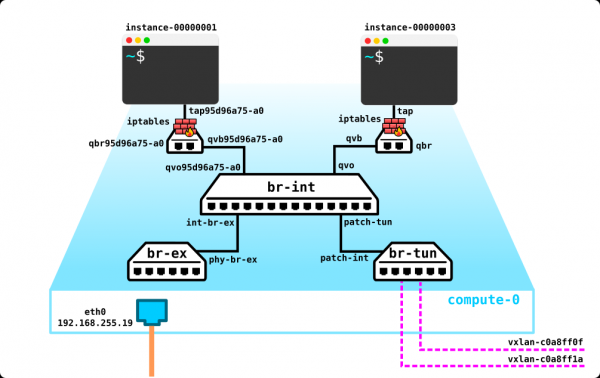
Deux machines sur un même hyperviseur dans un même réseau L2
Étant donné que ces deux VM se trouvent dans le même réseau L2 et sur le même hyperviseur, le trafic entre elles passera logiquement par br-int, car les deux machines seront dans le même VLAN :
[heat-admin@overcloud-novacompute-0 ~]$ sudo virsh domiflist instance-00000001
Interface  Type       Source     Model       MAC
-------------------------------------------------------
tap95d96a75-a0 bridge     qbr95d96a75-a0 virtio      fa:16:3e:44:98:20

[heat-admin@overcloud-novacompute-0 ~]$
[heat-admin@overcloud-novacompute-0 ~]$
[heat-admin@overcloud-novacompute-0 ~]$ sudo virsh domiflist instance-00000003
Interface  Type       Source     Model       MAC
-------------------------------------------------------
tap5bd37136-47 bridge     qbr5bd37136-47 virtio      fa:16:3e:83:ad:a4

[heat-admin@overcloud-novacompute-0 ~]$
[heat-admin@overcloud-novacompute-0 ~]$
[heat-admin@overcloud-novacompute-0 ~]$ sudo ovs-appctl fdb/show br-int
 port  VLAN  MAC                Age
    6     1  fa:16:3e:83:ad:a4    0
    3     1  fa:16:3e:44:98:20    0
[heat-admin@overcloud-novacompute-0 ~]$
Deux machines sur des hyperviseurs différents dans un même réseau L2
Voyons maintenant comment le trafic va circuler entre deux machines dans le même réseau L2, mais situées sur différents hyperviseurs. Pour être honnête, il ne changera pas beaucoup, le trafic entre les hyperviseurs passera simplement par un tunnel vxlan. Examinons cela par l'exemple.
Adresses des machines virtuelles entre lesquelles nous allons surveiller le trafic :
[heat-admin@overcloud-novacompute-0 ~]$ sudo virsh domiflist instance-00000001
Interface  Type       Source     Model       MAC
-------------------------------------------------------
tap95d96a75-a0 bridge     qbr95d96a75-a0 virtio      fa:16:3e:44:98:20

[heat-admin@overcloud-novacompute-0 ~]$
[heat-admin@overcloud-novacompute-1 ~]$ sudo virsh domiflist instance-00000002
Interface  Type       Source     Model       MAC
-------------------------------------------------------
tape7e23f1b-07 bridge     qbre7e23f1b-07 virtio      fa:16:3e:72:ad:53

[heat-admin@overcloud-novacompute-1 ~]$
Regardons la table de transfert dans br-int sur compute-0 :
[heat-admin@overcloud-novacompute-0 ~]$  sudo ovs-appctl fdb/show br-int | grep fa:16:3e:72:ad:53
    2     1  fa:16:3e:72:ad:53    1
[heat-admin@overcloud-novacompute-0 ~]
Le trafic doit aller au port 2 — vérifions quel port c'est :
[heat-admin@overcloud-novacompute-0 ~]$ sudo ovs-ofctl show br-int | grep addr
 1(int-br-ex): addr:7e:7f:28:1f:bd:54
 2(patch-tun): addr:0a:bd:07:69:58:d9
 3(qvo95d96a75-a0): addr:ea:50:9a:3d:69:58
 6(qvo5bd37136-47): addr:9a:d1:03:50:3d:96
 LOCAL(br-int): addr:1a:0f:53:97:b1:49
[heat-admin@overcloud-novacompute-0 ~]$
C'est patch-tun — c'est-à-dire l'interface dans br-tun. Vérifions ce qui se passe avec le paquet sur br-tun :
[heat-admin@overcloud-novacompute-0 ~]$ sudo ovs-ofctl dump-flows br-tun | grep fa:16:3e:72:ad:53
 cookie=0x8759a56536b67a8e, duration=1387.959s, table=20, n_packets=1460, n_bytes=138880, hard_timeout=300, idle_age=0, hard_age=0, priority=1,vlan_tci=0x0001/0x0fff,dl_dst=fa:16:3e:72:ad:53 actions=load:0->NXM_OF_VLAN_TCI[],load:0x16->NXM_NX_TUN_ID[],output:2
[heat-admin@overcloud-novacompute-0 ~]$
Le paquet est encapsulé dans VxLAN et envoyé au port 2. Vérifions où mène le port 2 :
[heat-admin@overcloud-novacompute-0 ~]$ sudo ovs-ofctl show br-tun | grep addr
 1(patch-int): addr:b2:d1:f8:21:96:66
 2(vxlan-c0a8ff1a): addr:be:64:1f:75:78:a7
 3(vxlan-c0a8ff0f): addr:76:6f:b9:3c:3f:1c
 LOCAL(br-tun): addr:a2:5b:6d:4f:94:47
[heat-admin@overcloud-novacompute-0 ~]$
C'est un tunnel vxlan sur compute-1 :
[heat-admin@overcloud-novacompute-0 ~]$ sudo ovs-appctl dpif/show | egrep vxlan-c0a8ff1a
    vxlan-c0a8ff1a 2/4: (vxlan: egress_pkt_mark=0, key=flow, local_ip=192.168.255.19, remote_ip=192.168.255.26)
[heat-admin@overcloud-novacompute-0 ~]$
Allons sur compute-1 et voyons ce qui se passe avec le paquet :
[heat-admin@overcloud-novacompute-1 ~]$ sudo ovs-appctl fdb/show br-int | egrep fa:16:3e:44:98:20
    2     1  fa:16:3e:44:98:20    1
[heat-admin@overcloud-novacompute-1 ~]$
Le MAC est présent dans la table de transfert br-int sur compute-1, et comme on peut le voir dans la sortie ci-dessus, il est visible via le port 2, qui est le port en direction de br-tun :
[heat-admin@overcloud-novacompute-1 ~]$ sudo ovs-ofctl show br-int | grep addr
 1(int-br-ex): addr:8a:d7:f9:ad:8c:1d
 2(patch-tun): addr:46:cc:40:bd:20:da
 3(qvoe7e23f1b-07): addr:12:78:2e:34:6a:c7
 4(qvo3210e8ec-c0): addr:7a:5f:59:75:40:85
 LOCAL(br-int): addr:e2:27:b2:ed:14:46
Et ensuite, vérifions ce qu'il y a dans br-int sur compute-1, il y a le MAC de destination :
[heat-admin@overcloud-novacompute-1 ~]$ sudo ovs-appctl fdb/show br-int | egrep fa:16:3e:72:ad:53
    3     1  fa:16:3e:72:ad:53    0
[heat-admin@overcloud-novacompute-1 ~]$
Donc, le paquet reçu ira au port 3, derrière lequel se trouve la machine virtuelle instance-00000003.
Tout le charme du déploiement d'OpenStack pour l'apprentissage sur une infrastructure virtuelle réside dans notre capacité à capturer le trafic entre les hyperviseurs et à voir ce qui se passe avec lui. C'est ce que nous allons faire maintenant, nous allons lancer tcpdump sur le port vnet en direction de compute-0 :
[root@hp-gen9 bormoglotx]# tcpdump -vvv -i vnet3
tcpdump: listening on vnet3, link-type EN10MB (Ethernet), capture size 262144 bytes

*****************omitted*******************

04:39:04.583459 IP (tos 0x0, ttl 64, id 16868, offset 0, flags [DF], proto UDP (17), length 134)
    192.168.255.19.39096 > 192.168.255.26.4789: [no cksum] VXLAN, flags [I] (0x08), vni 22
IP (tos 0x0, ttl 64, id 8012, offset 0, flags [DF], proto ICMP (1), length 84)
    10.0.1.85 > 10.0.1.88: ICMP echo request, id 5634, seq 16, length 64
04:39:04.584449 IP (tos 0x0, ttl 64, id 35181, offset 0, flags [DF], proto UDP (17), length 134)
    192.168.255.26.speedtrace-disc > 192.168.255.19.4789: [no cksum] VXLAN, flags [I] (0x08), vni 22
IP (tos 0x0, ttl 64, id 59124, offset 0, flags [none], proto ICMP (1), length 84)
    10.0.1.88 > 10.0.1.85: ICMP echo reply, id 5634, seq 16, length 64

*****************omitted*******************
La première ligne montre que le paquet avec l'adresse 10.0.1.85 va à l'adresse 10.0.1.88 (trafic ICMP), enveloppé dans un paquet VxLAN avec vni 22 et le paquet provient de l'hôte 192.168.255.19 (compute-0) vers l'hôte 192.168.255.26 (compute-1). Nous pouvons vérifier que le VNI correspond à celui indiqué dans ovs.
Revenons à cette ligne actions=load:0->NXM_OF_VLAN_TCI[],load:0x16->NXM_NX_TUN_ID[],output:2. 0x16 est le vni en base hexadécimale. Convertissons ce nombre en base 10 :
16 = 6*16^0+1*16^1 = 6+16 = 22Cela signifie que le vni correspond à la réalité.
La deuxième ligne montre le trafic inverse, et il n'est pas nécessaire de l'expliquer car tout est clair.
Deux machines dans des réseaux différents (routage entre les réseaux)
Le dernier cas pour aujourd'hui est le routage entre les réseaux au sein d'un même projet en utilisant un routeur virtuel. Nous examinons un cas sans DVR (nous le traiterons dans un autre article), donc le routage se fait sur le nœud réseau. Dans notre cas, le nœud réseau n'est pas séparé en une entité distincte et se trouve sur le nœud de contrôle.
Pour commencer, vérifions que le routage fonctionne :
$ ping 10.0.2.8
PING 10.0.2.8 (10.0.2.8): 56 data bytes
64 bytes from 10.0.2.8: seq=0 ttl=63 time=7.727 ms
64 bytes from 10.0.2.8: seq=1 ttl=63 time=3.832 ms
^C
--- 10.0.2.8 ping statistics ---
2 packets transmitted, 2 packets received, 0% packet loss
round-trip min/avg/max = 3.832/5.779/7.727 ms
Étant donné que dans ce cas le paquet doit aller vers la passerelle et y être routé, nous devons connaître l'adresse MAC de la passerelle, pour cela nous allons consulter la table ARP dans l'instance :
$ arp
host-10-0-1-254.openstacklocal (10.0.1.254) at fa:16:3e:c4:64:70 [ether]  on eth0
host-10-0-1-1.openstacklocal (10.0.1.1) at fa:16:3e:e6:2c:5c [ether]  on eth0
host-10-0-1-90.openstacklocal (10.0.1.90) at fa:16:3e:83:ad:a4 [ether]  on eth0
host-10-0-1-88.openstacklocal (10.0.1.88) at fa:16:3e:72:ad:53 [ether]  on eth0
Maintenant, voyons où le trafic avec la destination (10.0.1.254) fa:16:3e:c4:64:70 doit être envoyé.
[heat-admin@overcloud-novacompute-0 ~]$ sudo ovs-appctl fdb/show br-int | egrep fa:16:3e:c4:64:70
    2     1  fa:16:3e:c4:64:70    0
[heat-admin@overcloud-novacompute-0 ~]$
Regardons vers où va le port 2 :
[heat-admin@overcloud-novacompute-0 ~]$ sudo ovs-ofctl show br-int | grep addr
 1(int-br-ex): addr:7e:7f:28:1f:bd:54
 2(patch-tun): addr:0a:bd:07:69:58:d9
 3(qvo95d96a75-a0): addr:ea:50:9a:3d:69:58
 6(qvo5bd37136-47): addr:9a:d1:03:50:3d:96
 LOCAL(br-int): addr:1a:0f:53:97:b1:49
[heat-admin@overcloud-novacompute-0 ~]$
Tout a du sens, le trafic va vers br-tun. Voyons dans quel tunnel vxlan il sera englobé :
[heat-admin@overcloud-novacompute-0 ~]$ sudo ovs-ofctl dump-flows br-tun | grep fa:16:3e:c4:64:70
 cookie=0x8759a56536b67a8e, duration=3514.566s, table=20, n_packets=3368, n_bytes=317072, hard_timeout=300, idle_age=0, hard_age=0, priority=1,vlan_tci=0x0001/0x0fff,dl_dst=fa:16:3e:c4:64:70 actions=load:0->NXM_OF_VLAN_TCI[],load:0x16->NXM_NX_TUN_ID[],output:3
[heat-admin@overcloud-novacompute-0 ~]$
Le troisième port est un tunnel vxlan :
[heat-admin@overcloud-controller-0 ~]$ sudo ovs-ofctl show br-tun | grep addr
 1(patch-int): addr:a2:69:00:c5:fa:ba
 2(vxlan-c0a8ff1a): addr:86:f0:ce:d0:e8:ea
 3(vxlan-c0a8ff13): addr:72:aa:73:2c:2e:5b
 LOCAL(br-tun): addr:a6:cb:cd:72:1c:45
[heat-admin@overcloud-controller-0 ~]$
Qui se connecte à la nœud principale :
[heat-admin@overcloud-controller-0 ~]$ sudo sudo ovs-appctl dpif/show | grep vxlan-c0a8ff1a
    vxlan-c0a8ff1a 2/5: (vxlan: egress_pkt_mark=0, key=flow, local_ip=192.168.255.15, remote_ip=192.168.255.26)
[heat-admin@overcloud-controller-0 ~]$
Le trafic est arrivé à la nœud principale, il nous faut donc y accéder et voir comment se fera le routage.
Comme vous vous en souvenez, la nœud principale avait exactement la même configuration que la nœud de calcul — les mêmes trois ponts, sauf que br-ex avait un port physique par lequel la nœud pouvait envoyer du trafic à l'extérieur. La création d'instances a modifié la configuration sur les nœuds de calcul — des ponts Linux, des iptables et des interfaces ont été ajoutés. La création de réseaux et d'un routeur virtuel a également eu un impact sur la configuration de la nœud principale.
Il est donc évident que l'adresse MAC de la passerelle doit être dans la table de transfert de br-int sur la nœud principale. Vérifions qu'elle y figure et où elle pointe :
[heat-admin@overcloud-controller-0 ~]$ sudo ovs-appctl fdb/show br-int | grep fa:16:3e:c4:64:70
    5     1  fa:16:3e:c4:64:70    1
[heat-admin@overcloud-controller-0 ~]$
[heat-admin@overcloud-controller-0 ~]$  sudo ovs-ofctl show br-int | grep addr
 1(int-br-ex): addr:2e:58:b6:db:d5:de
 2(patch-tun): addr:06:41:90:f0:9e:56
 3(tapca25a97e-64): addr:fa:16:3e:e6:2c:5c
 4(tap22015e46-0b): addr:fa:16:3e:76:c2:11
 5(qr-0c52b15f-8f): addr:fa:16:3e:c4:64:70
 6(qr-92fa49b5-54): addr:fa:16:3e:80:13:72
 LOCAL(br-int): addr:06:de:5d:ed:44:44
[heat-admin@overcloud-controller-0 ~]$
La MAC est visible depuis le port qr-0c52b15f-8f. Si nous revenons à la liste des ports virtuels dans OpenStack, ce type de port est utilisé pour connecter divers dispositifs virtuels à OVS. Plus précisément, qr est un port vers le routeur virtuel, qui est présenté sous forme de namespace.
Voyons quels namespaces existent sur le serveur :
[heat-admin@overcloud-controller-0 ~]$ sudo  ip netns
qrouter-0a4d2420-4b9c-46bd-aec1-86a1ef299abe (id: 2)
qdhcp-7d541e74-1c36-4e1d-a7c4-0968c8dbc638 (id: 1)
qdhcp-67a3798c-32c0-4c18-8502-2531247e3cc2 (id: 0)
[heat-admin@overcloud-controller-0 ~]$
Au total, il y a trois instances. Mais d'après leurs noms, on peut deviner leur objectif. Nous reviendrons plus tard sur les instances avec l'ID 0 et 1, mais pour l'instant, nous nous intéressons à l'espace de noms qrouter-0a4d2420-4b9c-46bd-aec1-86a1ef299abe :
[heat-admin@overcloud-controller-0 ~]$ sudo  ip netns exec qrouter-0a4d2420-4b9c-46bd-aec1-86a1ef299abe ip route
10.0.1.0/24 dev qr-0c52b15f-8f proto kernel scope link src 10.0.1.254
10.0.2.0/24 dev qr-92fa49b5-54 proto kernel scope link src 10.0.2.254
[heat-admin@overcloud-controller-0 ~]$
Dans cet espace de noms, deux interfaces internes ont été créées précédemment. Les deux ports virtuels ont été ajoutés à br-int. Vérifions l'adresse MAC du port qr-0c52b15f-8f, car le trafic, d'après l'adresse MAC de destination, était destiné à cette interface.
[heat-admin@overcloud-controller-0 ~]$ sudo  ip netns exec qrouter-0a4d2420-4b9c-46bd-aec1-86a1ef299abe ifconfig qr-0c52b15f-8f
qr-0c52b15f-8f: flags=4163  mtu 1450
        inet 10.0.1.254  netmask 255.255.255.0  broadcast 10.0.1.255
        inet6 fe80::f816:3eff:fec4:6470  prefixlen 64  scopeid 0x20
        ether fa:16:3e:c4:64:70  txqueuelen 1000  (Ethernet)
        RX packets 5356  bytes 427305 (417.2 KiB)
        RX errors 0  dropped 0  overruns 0  frame 0
        TX packets 5195  bytes 490603 (479.1 KiB)
        TX errors 0  dropped 0 overruns 0  carrier 0  collisions 0

[heat-admin@overcloud-controller-0 ~]$
Cela signifie qu'ici, tout fonctionne selon les règles de la routage standard. Étant donné que le trafic est destiné à l'hôte 10.0.2.8, il devrait sortir par le deuxième interface qr-92fa49b5-54 et passer par le tunnel vxlan vers le nœud de calcul :
[heat-admin@overcloud-controller-0 ~]$ sudo  ip netns exec qrouter-0a4d2420-4b9c-46bd-aec1-86a1ef299abe arp
Address                  HWtype  HWaddress           Flags Mask            Iface
10.0.1.88                ether   fa:16:3e:72:ad:53   C                     qr-0c52b15f-8f
10.0.1.90                ether   fa:16:3e:83:ad:a4   C                     qr-0c52b15f-8f
10.0.2.8                 ether   fa:16:3e:6c:ad:9c   C                     qr-92fa49b5-54
10.0.2.42                ether   fa:16:3e:f5:0b:29   C                     qr-92fa49b5-54
10.0.1.85                ether   fa:16:3e:44:98:20   C                     qr-0c52b15f-8f
[heat-admin@overcloud-controller-0 ~]$
Tout est logique, pas de surprises. Regardons d'où on voit l'adresse MAC de l'hôte 10.0.2.8 dans br-int :
[heat-admin@overcloud-controller-0 ~]$ sudo ovs-appctl fdb/show br-int | grep fa:16:3e:6c:ad:9c
    2     2  fa:16:3e:6c:ad:9c    1
[heat-admin@overcloud-controller-0 ~]$
[heat-admin@overcloud-controller-0 ~]$ sudo ovs-ofctl show br-int | grep addr
 1(int-br-ex): addr:2e:58:b6:db:d5:de
 2(patch-tun): addr:06:41:90:f0:9e:56
 3(tapca25a97e-64): addr:fa:16:3e:e6:2c:5c
 4(tap22015e46-0b): addr:fa:16:3e:76:c2:11
 5(qr-0c52b15f-8f): addr:fa:16:3e:c4:64:70
 6(qr-92fa49b5-54): addr:fa:16:3e:80:13:72
 LOCAL(br-int): addr:06:de:5d:ed:44:44
[heat-admin@overcloud-controller-0 ~]$
Comme il se doit, le trafic passe dans br-tun, voyons dans quel tunnel le trafic ira ensuite :
[heat-admin@overcloud-controller-0 ~]$ sudo ovs-ofctl dump-flows br-tun | grep fa:16:3e:6c:ad:9c
 cookie=0x2ab04bf27114410e, duration=5346.829s, table=20, n_packets=5248, n_bytes=498512, hard_timeout=300, idle_age=0, hard_age=0, priority=1,vlan_tci=0x0002/0x0fff,dl_dst=fa:16:3e:6c:ad:9c actions=load:0->NXM_OF_VLAN_TCI[],load:0x63->NXM_NX_TUN_ID[],output:2
[heat-admin@overcloud-controller-0 ~]$
[heat-admin@overcloud-controller-0 ~]$ sudo ovs-ofctl show br-tun | grep addr
 1(patch-int): addr:a2:69:00:c5:fa:ba
 2(vxlan-c0a8ff1a): addr:86:f0:ce:d0:e8:ea
 3(vxlan-c0a8ff13): addr:72:aa:73:2c:2e:5b
 LOCAL(br-tun): addr:a6:cb:cd:72:1c:45
[heat-admin@overcloud-controller-0 ~]$
[heat-admin@overcloud-controller-0 ~]$ sudo sudo ovs-appctl dpif/show | grep vxlan-c0a8ff1a
    vxlan-c0a8ff1a 2/5: (vxlan: egress_pkt_mark=0, key=flow, local_ip=192.168.255.15, remote_ip=192.168.255.26)
[heat-admin@overcloud-controller-0 ~]$
Le trafic passe dans le tunnel vers compute-1. Et sur compute-1, c'est simple : depuis br-tun, le paquet passe dans br-int et ensuite vers l'interface de la machine virtuelle.
[heat-admin@overcloud-controller-0 ~]$ sudo sudo ovs-appctl dpif/show | grep vxlan-c0a8ff1a
    vxlan-c0a8ff1a 2/5: (vxlan: egress_pkt_mark=0, key=flow, local_ip=192.168.255.15, remote_ip=192.168.255.26)
[heat-admin@overcloud-controller-0 ~]$
[heat-admin@overcloud-novacompute-1 ~]$ sudo ovs-appctl fdb/show br-int | grep fa:16:3e:6c:ad:9c
    4     2  fa:16:3e:6c:ad:9c    1
[heat-admin@overcloud-novacompute-1 ~]$ sudo ovs-ofctl show br-int | grep addr
 1(int-br-ex): addr:8a:d7:f9:ad:8c:1d
 2(patch-tun): addr:46:cc:40:bd:20:da
 3(qvoe7e23f1b-07): addr:12:78:2e:34:6a:c7
 4(qvo3210e8ec-c0): addr:7a:5f:59:75:40:85
 LOCAL(br-int): addr:e2:27:b2:ed:14:46
[heat-admin@overcloud-novacompute-1 ~]$
Vérifions que c'est bien la bonne interface :
[heat-admin@overcloud-novacompute-1 ~]$ brctl show
bridge name     bridge id               STP enabled     interfaces
docker0         8000.02429c001e1c       no
qbr3210e8ec-c0          8000.ea27f45358be       no              qvb3210e8ec-c0
                                                        tap3210e8ec-c0
qbre7e23f1b-07          8000.b26ac0eded8a       no              qvbe7e23f1b-07
                                                        tape7e23f1b-07
[heat-admin@overcloud-novacompute-1 ~]$
[heat-admin@overcloud-novacompute-1 ~]$ sudo virsh domiflist instance-00000004
Interface  Type       Source     Model       MAC
-------------------------------------------------------
tap3210e8ec-c0 bridge     qbr3210e8ec-c0 virtio      fa:16:3e:6c:ad:9c

[heat-admin@overcloud-novacompute-1 ~]$
En fait, nous avons suivi le chemin complet du paquet. Je pense que vous avez remarqué que le trafic passait par plusieurs tunnels vxlan et sortait avec des VNI différents. Voyons quels sont ces VNI, puis faisons un dump sur le port de la nœud de contrôle et vérifions que le trafic fonctionne comme décrit ci-dessus.
Donc, le tunnel vers compute-0 a les actions suivantes : actions=load:0->NXM_OF_VLAN_TCI[],load:0x16->NXM_NX_TUN_ID[],output:3. Nous allons convertir 0x16 en décimal :
0x16 = 6*16^0+1*16^1 = 6+16 = 22Le tunnel vers compute-1 a le VNI suivant : actions=load:0->NXM_OF_VLAN_TCI[],load:0x63->NXM_NX_TUN_ID[],output:2. Convertissons 0x63 en décimal :
0x63 = 3*16^0+6*16^1 = 3+96 = 99Voyons maintenant le dump :
[root@hp-gen9 bormoglotx]# tcpdump -vvv -i vnet4
tcpdump: écoute sur vnet4, type de liaison EN10MB (Ethernet), taille de capture 262144 octets

*****************omitted*******************

04:35:18.709949 IP (tos 0x0, ttl 64, id 48650, offset 0, flags [DF], proto UDP (17), length 134)
    192.168.255.19.41591 > 192.168.255.15.4789: [no cksum] VXLAN, flags [I] (0x08), vni 22
IP (tos 0x0, ttl 64, id 49042, offset 0, flags [DF], proto ICMP (1), length 84)
    10.0.1.85 > 10.0.2.8: demande d'écho ICMP, id 5378, seq 9, length 64
04:35:18.710159 IP (tos 0x0, ttl 64, id 23360, offset 0, flags [DF], proto UDP (17), length 134)
    192.168.255.15.38983 > 192.168.255.26.4789: [no cksum] VXLAN, flags [I] (0x08), vni 99
IP (tos 0x0, ttl 63, id 49042, offset 0, flags [DF], proto ICMP (1), length 84)
    10.0.1.85 > 10.0.2.8: demande d'écho ICMP, id 5378, seq 9, length 64
04:35:18.711292 IP (tos 0x0, ttl 64, id 43596, offset 0, flags [DF], proto UDP (17), length 134)
    192.168.255.26.42588 > 192.168.255.15.4789: [no cksum] VXLAN, flags [I] (0x08), vni 99
IP (tos 0x0, ttl 64, id 55103, offset 0, flags [none], proto ICMP (1), length 84)
    10.0.2.8 > 10.0.1.85: réponse d'écho ICMP, id 5378, seq 9, length 64
04:35:18.711531 IP (tos 0x0, ttl 64, id 8555, offset 0, flags [DF], proto UDP (17), length 134)
    192.168.255.15.38983 > 192.168.255.19.4789: [no cksum] VXLAN, flags [I] (0x08), vni 22
IP (tos 0x0, ttl 63, id 55103, offset 0, flags [none], proto ICMP (1), length 84)
    10.0.2.8 > 10.0.1.85: réponse d'écho ICMP, id 5378, seq 9, length 64

*****************omitted*******************
Le premier paquet est un paquet vxlan de l'hôte 192.168.255.19 (compute-0) vers l'hôte 192.168.255.15 (control-1) avec vni 22, contenant un paquet ICMP de l'hôte 10.0.1.85 vers l'hôte 10.0.2.8. Comme nous l'avons calculé précédemment, le vni correspond à ce que nous avons vu dans les sorties.
Le deuxième paquet est un paquet vxlan de l'hôte 192.168.255.15 (control-1) vers l'hôte 192.168.255.26 (compute-1) avec vni 99, contenant un paquet ICMP de l'hôte 10.0.1.85 vers l'hôte 10.0.2.8. Comme nous l'avons calculé précédemment, le vni correspond à ce que nous avons vu dans les sorties.
Les deux paquets suivants constituent le trafic retour de 10.0.2.8 à 10.0.1.85.
Donc, au final, nous avons une telle structure pour le nœud de contrôle :
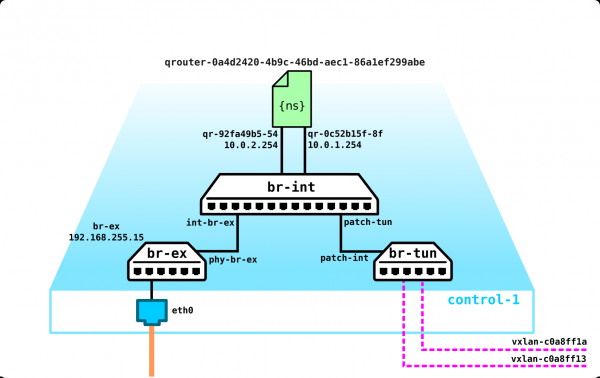
On dirait que c'est tout ? Nous avons oublié deux namespaces :
[heat-admin@overcloud-controller-0 ~]$ sudo  ip netns
qrouter-0a4d2420-4b9c-46bd-aec1-86a1ef299abe (id: 2)
qdhcp-7d541e74-1c36-4e1d-a7c4-0968c8dbc638 (id: 1)
qdhcp-67a3798c-32c0-4c18-8502-2531247e3cc2 (id: 0)
[heat-admin@overcloud-controller-0 ~]$
Comme nous l'avons mentionné concernant l'architecture de la plateforme cloud — il serait bon que les machines reçoivent des adresses automatiquement du serveur DHCP. Ce sont donc deux serveurs DHCP pour nos deux réseaux 10.0.1.0/24 et 10.0.2.0/24.
Vérifions que c'est le cas. Dans ce namespace, il y a seulement une adresse — 10.0.1.1 — l'adresse du serveur DHCP lui-même, qui est également inclus dans br-int :
[heat-admin@overcloud-controller-0 ~]$ sudo ip netns exec qdhcp-67a3798c-32c0-4c18-8502-2531247e3cc2 ifconfig
lo: flags=73  mtu 65536
        inet 127.0.0.1  netmask 255.0.0.0
        inet6 ::1  prefixlen 128  scopeid 0x10
        loop  txqueuelen 1000  (Local Loopback)
        RX packets 1  bytes 28 (28.0 B)
        RX errors 0  dropped 0  overruns 0  frame 0
        TX packets 1  bytes 28 (28.0 B)
        TX errors 0  dropped 0 overruns 0  carrier 0  collisions 0

tapca25a97e-64: flags=4163  mtu 1450
        inet 10.0.1.1  netmask 255.255.255.0  broadcast 10.0.1.255
        inet6 fe80::f816:3eff:fee6:2c5c  prefixlen 64  scopeid 0x20
        ether fa:16:3e:e6:2c:5c  txqueuelen 1000  (Ethernet)
        RX packets 129  bytes 9372 (9.1 KiB)
        RX errors 0  dropped 0  overruns 0  frame 0
        TX packets 49  bytes 6154 (6.0 KiB)
        TX errors 0  dropped 0 overruns 0  carrier 0  collisions 0
Voyons si des processus contenant le nom qdhcp-67a3798c-32c0-4c18-8502-2531247e3cc2 sont en cours d'exécution sur le nœud de contrôle :
[heat-admin@overcloud-controller-0 ~]$ ps -aux | egrep qdhcp-7d541e74-1c36-4e1d-a7c4-0968c8dbc638
root      640420  0.0  0.0   4220   348 ?        Ss   11:31   0:00 dumb-init --single-child -- ip netns exec qdhcp-7d541e74-1c36-4e1d-a7c4-0968c8dbc638 /usr/sbin/dnsmasq -k --no-hosts --no-resolv --pid-file=/var/lib/neutron/dhcp/7d541e74-1c36-4e1d-a7c4-0968c8dbc638/pid --dhcp-hostsfile=/var/lib/neutron/dhcp/7d541e74-1c36-4e1d-a7c4-0968c8dbc638/host --addn-hosts=/var/lib/neutron/dhcp/7d541e74-1c36-4e1d-a7c4-0968c8dbc638/addn_hosts --dhcp-optsfile=/var/lib/neutron/dhcp/7d541e74-1c36-4e1d-a7c4-0968c8dbc638/opts --dhcp-leasefile=/var/lib/neutron/dhcp/7d541e74-1c36-4e1d-a7c4-0968c8dbc638/leases --dhcp-match=set:ipxe,175 --local-service --bind-dynamic --dhcp-range=set:subnet-335552dd-b35b-456b-9df0-5aac36a3ca13,10.0.2.0,static,255.255.255.0,86400s --dhcp-option-force=option:mtu,1450 --dhcp-lease-max=256 --conf-file= --domain=openstacklocal
heat-ad+  951620  0.0  0.0 112944   980 pts/0    S+   18:50   0:00 grep -E --color=auto qdhcp-7d541e74-1c36-4e1d-a7c4-0968c8dbc638
[heat-admin@overcloud-controller-0 ~]$
Il existe un tel processus et, en nous basant sur les informations fournies dans la sortie ci-dessus, nous pouvons par exemple vérifier ce qui est actuellement loué :
[heat-admin@overcloud-controller-0 ~]$ cat /var/lib/neutron/dhcp/7d541e74-1c36-4e1d-a7c4-0968c8dbc638/leases
1597492111 fa:16:3e:6c:ad:9c 10.0.2.8 host-10-0-2-8 01:fa:16:3e:6c:ad:9c
1597491115 fa:16:3e:76:c2:11 10.0.2.1 host-10-0-2-1 *
[heat-admin@overcloud-controller-0 ~]$
En fin de compte, nous obtenons cet ensemble de services sur le nœud de contrôle :
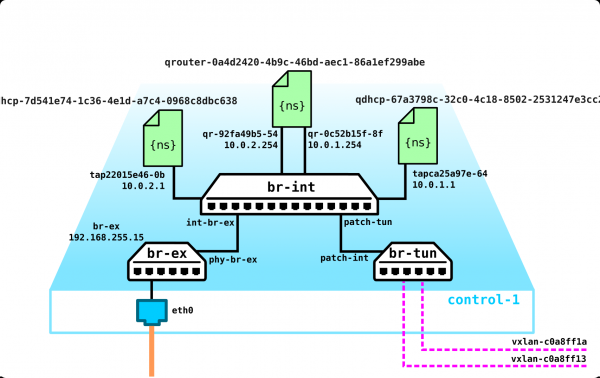
Gardez à l'esprit qu'il ne s'agit que de 4 machines, 2 réseaux internes et un routeur virtuel... En ce moment, nous n'avons pas de réseaux externes, ni de nombreux projets, chacun avec ses propres réseaux (qui se croisent), et notre routeur distribué est désactivé. Pour finir, dans notre banc d'essai, il n'y avait qu'un seul nœud de contrôle (pour la tolérance aux pannes, un quorum de trois nœuds est nécessaire). Il est logique que dans le commerce, tout soit « un peu » plus compliqué, mais avec cet exemple simple, nous comprenons comment cela devrait fonctionner. Que vous ayez 3 ou 300 namespaces, c'est important, mais en ce qui concerne le fonctionnement de l'ensemble de la structure, cela ne changera pas beaucoup... enfin, tant que vous ne branchez pas un SDN de fournisseur. Mais c'est une toute autre histoire.
J'espère que cela a été intéressant. Si vous avez des remarques ou des ajouts, ou si j'ai clairement menti (je suis humain et mon opinion sera toujours subjective) - faites-moi savoir ce qu'il faut corriger ou ajouter - nous corrigerons ou ajouterons tout.
En conclusion, j'aimerais dire quelques mots sur la comparaison d'OpenStack (tant en version vanilla qu'en version fournisseur) avec la solution cloud de VMWare - j'ai reçu cette question trop souvent ces dernières années, et j'en suis déjà fatigué à vrai dire, mais néanmoins. À mon avis, il est très difficile de comparer ces deux solutions, mais il est clair que les inconvénients existent dans les deux options, et en choisissant l'une d'elles, il faut peser le pour et le contre.
Si OpenStack est une solution dirigée par la communauté, VMWare a le droit de faire uniquement ce qu'elle souhaite (lisez : ce qui lui est avantageux), et c'est logique - car c'est une entreprise commerciale qui est habituée à gagner de l'argent grâce à ses clients. Mais il y a un grand mais - vous pouvez quitter OpenStack, par exemple de Nokia, et facilement passer à une solution de Juniper (Contrail Cloud), mais il vous sera difficile de quitter VMWare. Pour moi, ces deux solutions se comparent ainsi : OpenStack (version fournisseur) est une simple cage dans laquelle vous êtes enfermé, mais vous avez la clé et vous pouvez sortir à tout moment. VMWare - c'est une cage en or, la clé de la cage appartient au propriétaire et elle vous coûtera très cher.
Je ne fais la promotion ni du premier produit ni du second — vous choisissez ce dont vous avez besoin. Mais si je devais faire un tel choix, je prendrais les deux solutions — VMWare pour le cloud IT (charges légères, gestion facile), OpenStack d'un quelconque fournisseur (Nokia et Juniper proposent de très bonnes solutions clés en main) — pour le cloud Telecom. Je ne commencerais pas à utiliser OpenStack pour du pur IT — c'est comme tirer avec un canon sur un moineau, mais je ne vois pas d'autres contre-indications à son utilisation que la redondance. Cependant, utiliser VMWare dans le telecom — c'est comme transporter des gravats dans un Ford Raptor — c'est beau à voir, mais le conducteur doit faire 10 trajets au lieu d'un.
À mon avis, le plus grand inconvénient de VMWare est sa fermeture totale — l'entreprise ne vous donne aucune information sur le fonctionnement de vSAN par exemple ou ce qui se passe dans le noyau de l'hyperviseur — cela ne les avantage tout simplement pas — donc vous ne deviendrez jamais un expert en VMWare — sans le soutien du fournisseur, vous êtes condamné (je rencontre souvent des experts en VMWare qui sont totalement déconcertés par des questions basiques). Pour moi, VMWare est comme acheter une voiture avec un capot verrouillé — oui, il se peut que vous ayez des spécialistes capables de changer une courroie de distribution, mais seul celui qui vous a vendu la solution peut ouvrir le capot. Personnellement, je n'aime pas les solutions dans lesquelles je ne peux pas mettre les mains. Vous direz que vous n'aurez peut-être pas à aller sous le capot. Oui, c'est possible, mais je vous regarderai quand vous devrez assembler une grande fonction dans le cloud avec 20-30 machines virtuelles, 40-50 réseaux, la moitié d'entre eux voulant sortir, et l'autre moitié demandant une accélération SR-IOV, sinon vous devrez encore ajouter quelques dizaines de ces machines — sinon, il n'y aura pas assez de performance.
Il existe d'autres points de vue, donc c'est à vous de décider ce qu'il faut choisir et surtout — vous êtes responsable de votre choix par la suite. C'est juste mon avis — celui d'une personne qui a vu et touché au moins 4 produits — Nokia, Juniper, Red Hat et VMWare. Donc, j'ai des éléments de comparaison.
Source : habr.com
