

Auteur : Sergey Lukyanchikov, ingénieur consultant pour InterSystems
Défis des calculs AI/ML en temps réel
Commençons par des exemples tirés de l'expérience en Data Science d'InterSystems :
- Un portail client « surchargé » est connecté à un système de recommandation en ligne. Une restructuration des promotions à l'échelle du réseau de vente au détail est prévue (par exemple, au lieu d'une ligne de promotions « plate », une matrice « segment-tactique » sera appliquée). Que se passe-t-il avec les mécanismes de recommandation ? Que se passe-t-il avec la transmission et la mise à jour des données dans le mécanisme de recommandation (le volume des données d'entrée a augmenté de 25 000 fois) ? Que se passe-t-il avec la génération de recommandations (nécessité d'une réduction millénaire du seuil de filtrage des règles de recommandation en raison de l'augmentation millénaire de leur nombre et de leur « assortiment ») ?
- Il existe un système de surveillance de la probabilité de développement de défauts dans les nœuds de l'équipement. Le système de surveillance a été connecté à un SCADA, transmettant des milliers de paramètres du processus technologique chaque seconde. Que se passe-t-il avec le système de surveillance, qui fonctionnait auparavant sur des « échantillons manuels » (est-il capable de fournir une surveillance de probabilité chaque seconde) ? Que se passera-t-il si un nouveau bloc de plusieurs centaines de colonnes avec des lectures de capteurs, récemment intégrées au SCADA, apparaît dans les données d'entrée (sera-t-il nécessaire d'arrêter le système de surveillance et pour combien de temps pour inclure dans l'analyse des données des nouveaux capteurs) ?
- Un ensemble de mécanismes AI/ML a été créé (recommandation, surveillance, prévision), utilisant les résultats du travail des uns et des autres. Combien d'heures-hommes sont nécessaires chaque mois pour adapter le fonctionnement de cet ensemble aux changements dans les données d'entrée ? Quel est le ralentissement total dans le soutien du processus de prise de décision managériale par cet ensemble (fréquence d'apparition dans celui-ci d'informations de soutien par rapport à la fréquence d'apparition de nouvelles données d'entrée) ?
En résumé, à partir de ces exemples et de nombreux autres, nous avons formulé les défis qui se posent lors du passage à des mécanismes d'apprentissage automatique et d'intelligence artificielle en temps réel :
- Sommes-nous satisfaits de l'agilité de création et d'adaptation (à la situation changeante) des développements AI/ML dans notre entreprise ?
- Dans quelle mesure nos solutions IA/ML soutiennent-elles la gestion des entreprises en temps réel ?
- Nos solutions IA/ML sont-elles capables de s'adapter de manière autonome (sans développeurs) aux changements des données et des pratiques de gestion des entreprises ?
Notre article est une vue d'ensemble détaillée des capacités de la plateforme InterSystems IRIS en matière de support universel pour le déploiement de mécanismes IA/ML, l'intégration de solutions IA/ML et l'apprentissage (test) de solutions IA/ML sur des flux de données intenses. Nous aborderons les études de marché, des exemples pratiques de solutions IA/ML et les aspects conceptuels de ce que nous appelons dans cet article la plateforme IA/ML en temps réel.
Que révèlent les enquêtes : applications en temps réel
Résultats , réalisée auprès d'environ 800 professionnels de l'IT en 2019 par Lightbend, parle d'elle-même :
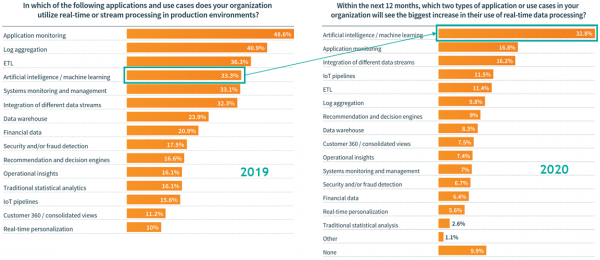
Figure 1 : Principaux consommateurs de données en temps réel
Citant des extraits clés du rapport sur les résultats de cette enquête dans notre traduction :
« … Les tendances de popularité des outils d'intégration de flux de données et, en même temps, du soutien aux calculs dans des conteneurs, offrent une réponse synergiques à la demande du marché pour des solutions efficaces plus réactives, rationnelles et dynamiques. Les flux de données permettent de transmettre des informations plus rapidement que les données par paquets traditionnelles. Cela s'ajoute à la possibilité d'appliquer des méthodes de calcul de manière agile, telles que les recommandations basées sur l'IA/ML, créant des avantages concurrentiels grâce à une augmentation de la satisfaction de la clientèle. La course à la réactivité affecte également tous les rôles dans la paradigm DevOps – augmentant l'efficacité du développement et du déploiement des applications. … Huit cent quatre professionnels de l'IT ont fourni des informations sur l'utilisation des flux de données dans leurs organisations. Les répondants étaient principalement situés dans des pays occidentaux (41% en Europe et 37% en Amérique du Nord) et étaient pratiquement répartis de manière égale entre les petites, moyennes et grandes entreprises. …
L'intelligence artificielle n'est pas un engouement. Cinquante-huit pour cent de ceux qui utilisent déjà le traitement des flux de données dans des applications AI/ML productives confirment que leur utilisation dans AI/ML connaîtra la plus forte augmentation l'année prochaine (comparé à d'autres applications).
- Selon la majorité des personnes interrogées, l'utilisation des flux de données dans les scénarios AI/ML connaîtra la plus forte augmentation l'année prochaine.
- L'application dans AI/ML augmentera non seulement grâce à des types de scénarios relativement nouveaux, mais aussi grâce à des scénarios traditionnels, où l'utilisation des données en temps réel devient de plus en plus intensive.
- En plus de AI/ML, le niveau d'enthousiasme parmi les utilisateurs de pipelines de données IoT est impressionnant - 48 % de ceux qui ont déjà intégré des données IoT affirment que la mise en œuvre de scénarios basés sur ces données connaîtra une croissance significative dans un avenir proche. … »
Cette enquête intéressante montre que la perception des scénarios d'apprentissage automatique et d'intelligence artificielle en tant que leaders de la consommation de flux de données est déjà « à l'horizon ». Mais une autre observation importante devient la perception de AI/ML en temps réel à travers l'optique DevOps : ici, on peut déjà commencer à parler de la transformation de la culture encore dominante du « AI/ML jetable avec un ensemble de données entièrement accessible ».
Le concept de plateforme AI/ML en temps réel
Une des applications typiques de AI/ML en temps réel est la gestion des processus technologiques en production. À partir de cet exemple et en tenant compte des réflexions précédentes, nous allons formuler le concept de plateforme AI/ML en temps réel.
L'utilisation de l'intelligence artificielle et de l'apprentissage automatique dans la gestion des processus technologiques présente plusieurs caractéristiques :
- Les données concernant l'état du processus technologique arrivent de manière intensive : à une grande fréquence et sur un large éventail de paramètres (jusqu'à des dizaines de milliers de valeurs de paramètres transmises par seconde depuis le système de contrôle-commande).
- Les données sur l'identification des défauts, sans parler des données sur leur évolution, sont en revanche rares et irrégulières, caractérisées par une typologie insuffisante des défauts et leur localisation dans le temps (souvent représentées par des enregistrements sur papier).
- D'un point de vue pratique, pour l'apprentissage et l'application des modèles, seul est disponible une « fenêtre de pertinence » des données d'origine, qui reflète la dynamique du processus technologique sur une période glissante raisonnable, se terminant par les dernières valeurs lues des paramètres du processus.
Ces caractéristiques nous obligent, en plus de la réception et du traitement de base en temps réel d'un « signal d'entrée à large bande » intense provenant du processus technologique, à effectuer (parallèlement) l'application, l'apprentissage et le contrôle de la qualité des résultats des modèles AI/ML – également en mode temps réel. Le « cadre » que nos modèles « voient » dans la fenêtre de pertinence change constamment – et avec lui, la qualité des résultats des modèles AI/ML, entraînés sur l'un des « cadres » dans le passé. En cas de détérioration de la qualité des résultats des modèles AI/ML (par exemple : la valeur de l'erreur de classification « alarme-norme » dépasse certaines limites que nous avons définies), un réapprentissage des modèles sur un « cadre » plus pertinent doit être automatiquement lancé – et le choix du moment pour déclencher le réapprentissage des modèles doit prendre en compte à la fois la durée de l'apprentissage lui-même et la dynamique de détérioration de la qualité du travail de la version actuelle des modèles (étant donné que les versions actuelles des modèles continuent à être appliquées tant que les modèles sont en cours d'apprentissage, et avant que leurs versions « réentraînées » ne soient formées).
InterSystems IRIS possède des capacités clés de plateforme pour le fonctionnement des solutions AI/ML dans la gestion des processus technologiques en temps réel. Ces capacités peuvent être classées en trois groupes principaux :
- Déploiement continu (Continuous Deployment/Delivery, CD) de nouveaux mécanismes AI/ML adaptés ou existants dans une solution productive opérant en temps réel sur la plateforme InterSystems IRIS.
- Intégration continue (Continuous Integration, CI) des flux de données entrants du processus technologique, des files d'attente de données pour l'application/l'apprentissage/le contrôle de la qualité des mécanismes AI/ML et des échanges de données/code/contrôles avec les environnements de modélisation mathématique, orchestrés en temps réel par la plateforme InterSystems IRIS.
- L'apprentissage continu (auto-) des mécanismes IA/ML est effectué dans des environnements de modélisation mathématique, en utilisant des données, du code et des interventions de gestion (« décisions prises »), transmises par la plateforme InterSystems IRIS.
La classification des capacités des plateformes en relation avec l'apprentissage automatique et l'intelligence artificielle selon ces groupes n'est pas accidentelle. Citons la méthodologie de l'entreprise Google, qui sous-tend la base conceptuelle de cette classification, dans notre traduction :
«… Le concept populaire de DevOps couvre le développement et l'exploitation de systèmes d'information à grande échelle. Les avantages de l'adoption de ce concept sont la réduction de la durée des cycles de développement, l'accélération du déploiement des développements et la flexibilité de la planification des versions. Pour obtenir ces avantages, DevOps suppose l'adoption, au minimum, de deux pratiques :
- Intégration Continue (CI)
- Livraison Continue (CD)
Ces pratiques sont également applicables aux plateformes IA/ML – afin d'assurer une construction fiable et performante de solutions IA/ML productives.
Les plateformes IA/ML se distinguent des autres systèmes d'information par les aspects suivants :
- Compétences de l'équipe : lors de la création d'une solution IA/ML, l'équipe comprend généralement des data scientists ou des experts « académiques » dans le domaine de l'analyse des données, qui effectuent l'analyse des données, le développement et la validation des modèles. Ces membres de l'équipe peuvent ne pas être des développeurs professionnels de code productif.
- Développement : les mécanismes IA/ML sont par nature expérimentaux. Pour résoudre une tâche de la manière la plus efficace, il est nécessaire d'explorer différentes combinaisons de variables d'entrée, d'algorithmes, de méthodes de modélisation et de paramètres de modèle. La complexité de ce processus réside dans le suivi de « ce qui a fonctionné / ce qui n'a pas fonctionné », en garantissant la reproductibilité des épisodes, et en généralisant les développements pour des déploiements répétés.
- Tests : les tests des mécanismes IA/ML nécessitent un large éventail de tests, plus que la plupart des autres développements. En plus des tests unitaires et d'intégration standards, la validité des données et la qualité des résultats de l'application du modèle sur les ensembles d'apprentissage et les ensembles de contrôle sont également testées.
- Déploiement : le déploiement des solutions IA/ML ne se limite pas aux services prédictifs utilisant un modèle entraîné une fois. Les solutions IA/ML sont construites autour de pipelines multi-étapes, exécutant un apprentissage automatisé et une application des modèles. Le déploiement de tels pipelines implique l'automatisation d'actions non triviales, traditionnellement effectuées manuellement par des data scientists, afin de permettre l'entraînement et le test des modèles.
- Productivité : les mécanismes IA/ML peuvent souffrir de problèmes de performance non seulement en raison d'une programmation inefficace, mais également à cause de la nature en constante évolution des données d'entrée. Autrement dit, la performance des mécanismes IA/ML peut se dégrader pour un plus large éventail de raisons que celle des développements classiques. Cela entraîne la nécessité de surveiller (en temps réel) les performances de nos mécanismes IA/ML, ainsi que d'envoyer des alertes ou de rejeter des résultats lorsque les indicateurs de performance ne sont pas conformes aux attentes.
Les plateformes IA/ML ressemblent aux autres systèmes d'information en ce sens que les deux nécessitent une intégration continue du code avec contrôle de version, des tests unitaires, des tests d'intégration, et un déploiement continu des développements. Cependant, dans le cas de l'IA/ML, il existe plusieurs différences importantes :
- L'intégration continue (CI) ne se limite plus à tester et valider le code des composants déployés – elle inclut également le test et la validation des données et des modèles IA/ML.
- La livraison/deploiement continu (CD) ne se limite pas à l'écriture et aux publications de paquets ou de services, mais implique une plateforme pour la composition, l'entraînement et l'application des solutions IA/ML.
- L'entraînement continu (CT) – un nouvel élément [note de l'auteur de l'article : nouvel élément par rapport au concept traditionnel de DevOps, où le CT est généralement le test continu] qui est propre aux plateformes IA/ML et qui est responsable de la gestion autonome des mécanismes d'apprentissage et d'application des modèles IA/ML. ...
Nous pouvons constater que l'apprentissage automatique et l'intelligence artificielle, travaillant sur des données en temps réel, nécessitent un ensemble d'outils et de compétences plus large (de la développement de code à l'orchestration d'environnements de modélisation mathématique), une intégration plus étroite entre toutes les domaines fonctionnels et thématiques, ainsi qu'une organisation plus efficace des ressources humaines et machines.
Scénario en temps réel : reconnaissance du développement des défauts dans les pompes de nutrition
Pour continuer avec l'exemple du domaine de la gestion des processus technologiques, examinons une tâche spécifique (déjà mentionnée au début) : il est nécessaire d'assurer en temps réel le suivi du développement des défauts dans les pompes sur la base du flux des valeurs de paramètres du processus technologique et des rapports du personnel de maintenance concernant les défauts identifiés.
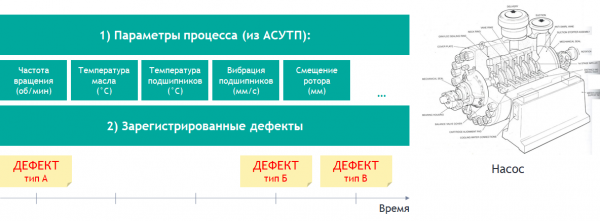
Figure 2 Formulation de la tâche de suivi du développement des défauts
Une des caractéristiques de la plupart des tâches formulées de cette manière en pratique est que la régularité et l'opportunité de la réception des données (Système de Contrôle Automatisé des Processus Technologiques) doivent être considérées dans le contexte de l'épisodicité et de l'irrégularité de l'apparition (et de l'enregistrement) de défauts de différents types. En d'autres termes : les données du Système de Contrôle Automatic des Processus Technologiques arrivent une fois par seconde, précises et exactes, tandis que les défauts sont enregistrés avec un crayon chimique en indiquant la date dans un cahier général dans l'atelier (par exemple : « 12.01 - fuite dans le couvercle du 3ème roulement »).
Ainsi, on peut compléter la formulation de la tâche avec cette contrainte importante : il y a une « étiquette » de défaut d'un type spécifique que nous avons essentiellement une seule (c'est-à-dire qu'un exemple de défaut de ce type est représenté par des données du Système de Contrôle Automatisé des Processus Technologiques à une date spécifique - et nous n'avons pas d'autres exemples de défaut de ce type). Cette contrainte nous fait immédiatement sortir du cadre de l'apprentissage automatique classique (apprentissage supervisé), qui nécessite de nombreuses « étiquettes ».
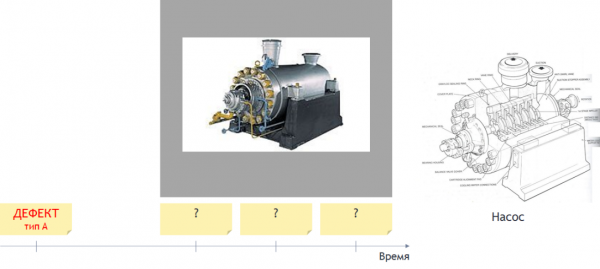
Figure 3 Précision de la tâche de suivi du développement des défauts
Pouvons-nous d'une certaine manière «cloner» la seule «étiquette» à notre disposition ? Oui, nous le pouvons. L'état actuel de la pompe est caractérisé par un degré de similitude avec les défauts enregistrés. Même sans utiliser des méthodes quantitatives, au niveau de la perception visuelle, en observant la dynamique des valeurs des données provenant de l'ACS, nous pouvons déjà tirer de nombreuses conclusions :
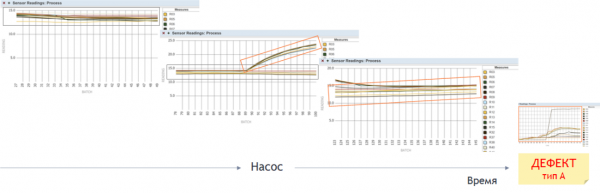
Figure 4 Dynamique de l'état de la pompe en fonction de l'étiquette du défaut d'un type donné
Mais la perception visuelle (pour l'instant) n'est pas le générateur d'étiquettes le plus adapté dans notre scénario en évolution rapide. Nous allons évaluer la similitude de l'état actuel de la pompe avec les défauts enregistrés à l'aide d'un test statistique.
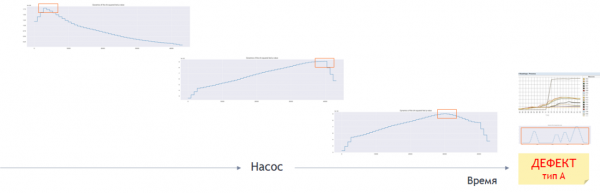
Figure 5 Application du test statistique aux données entrantes en fonction de l'étiquette du défaut
Le test statistique détermine la probabilité que les enregistrements contenant les valeurs des paramètres du processus technologique dans le «flux-packet» obtenu de l'ACS soient similaires aux enregistrements de l'étiquette du défaut d'un certain type. La valeur de probabilité calculée à la suite de l'application du test statistique (indice de similitude statistique) est transformée en une valeur de 0 ou 1, devenant une «étiquette» pour l'apprentissage automatique dans chaque enregistrement spécifique du paquet étudié. Autrement dit, après le traitement du nouveau paquet d'enregistrements de l'état de la pompe par le test statistique, nous avons la possibilité (a) d'ajouter ce paquet à l'échantillon d'apprentissage pour former le modèle AI/ML et (b) de contrôler la qualité du travail de la version actuelle du modèle lors de son application à ce paquet.
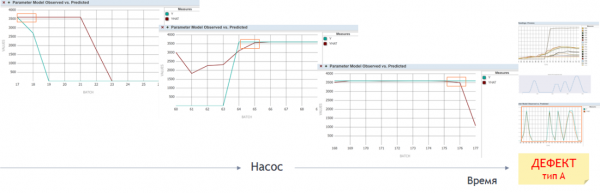
Figure 6 Application du modèle d'apprentissage automatique aux données entrantes en fonction de l'étiquette du défaut
Lors de l'un de nos précédents Nous montrons et expliquons comment la plateforme InterSystems IRIS permet de réaliser tout mécanisme AI/ML sous forme de processus métier continuellement exécutés, assurant le contrôle de la validité des résultats de modélisation et adaptant les paramètres des modèles. Lors de la réalisation du prototype de notre scénario avec les pompes, nous utilisons toute la fonctionnalité présentée lors du webinaire InterSystems IRIS – en implémentant dans le processus d'analyse de notre solution non pas l'apprentissage supervisé classique, mais plutôt l'apprentissage par renforcement (reinforcement learning), contrôlant automatiquement l'échantillonnage pour l'apprentissage des modèles. L'ensemble d'apprentissage comprend des enregistrements sur lesquels un "consensus de détection" apparaît après l'application à la fois du test statistique et de la version actuelle du modèle – c'est-à-dire que le test statistique (après transformation de l'indice de similarité à 0 ou 1) et le modèle ont donné un résultat de 1 sur ces enregistrements. Lors du nouvel apprentissage du modèle, lors de sa validation (le modèle réappris est appliqué à son propre ensemble d'apprentissage, après application préalable du test statistique), les enregistrements qui, après traitement par le test statistique, n'ont pas maintenu le résultat de 1 (en raison de la présence constante dans l'ensemble d'apprentissage des enregistrements de l'ancienne "étiquette" de défaut), sont supprimés de l'ensemble d'apprentissage, et la nouvelle version du modèle est formée sur l'"étiquette" de défaut ainsi que sur les enregistrements "retenus" du flux.
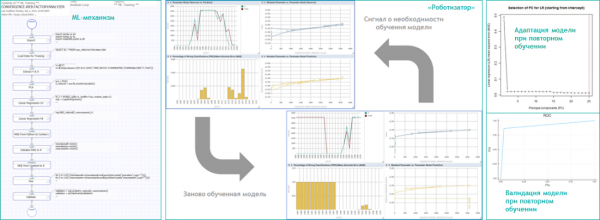
Figure 7 Robotisation des calculs AI/ML dans InterSystems IRIS
Dans le cas où il y aurait un besoin d'un certain "deuxième avis" sur la qualité de la détection obtenue lors des calculs locaux dans InterSystems IRIS, un processus-conseiller est créé pour effectuer l'apprentissage-appliqué des modèles sur un ensemble de données de contrôle en utilisant des services cloud (comme Microsoft Azure, Amazon Web Services, Google Cloud Platform, etc.) :
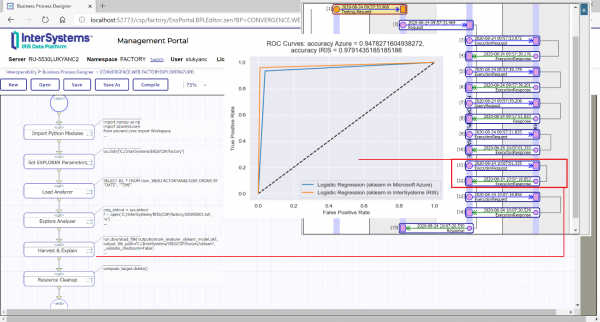
Figure 8 "Deuxième avis" de Microsoft Azure sous l'orchestration d'InterSystems IRIS
Le prototype de notre scénario dans InterSystems IRIS est réalisé sous la forme d'un système agent de processus analytiques, interagissant avec l'objet d'équipement (la pompe), les environnements de modélisation mathématique (Python, R et Julia), et assurant l'auto-apprentissage de tous les mécanismes AI/ML impliqués – sur des flux de données en temps réel.
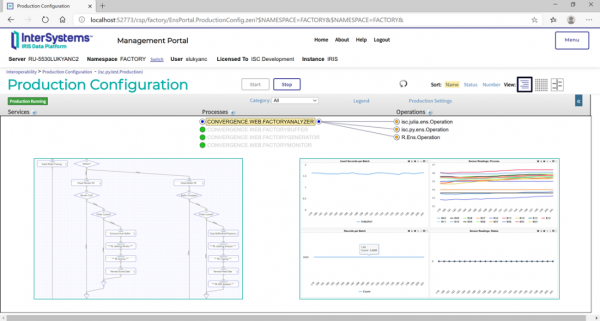
Figure 9 Fonctionnalité principale de la solution AI/ML en temps réel dans InterSystems IRIS
Le résultat pratique du travail de notre prototype :
- Échantillon de défaut détecté par le modèle (12 janvier) :
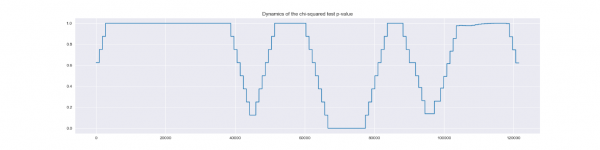
- Défaut en développement détecté par le modèle, non compris dans l'échantillon (11 septembre, le défaut a été constaté par l'équipe de réparation seulement deux jours plus tard – le 13 septembre) :
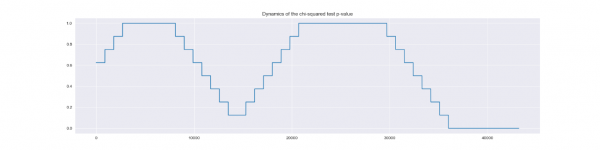
La simulation sur des données réelles, contenant plusieurs épisodes du même défaut, a montré que notre solution, mise en œuvre sur la plateforme InterSystems IRIS, permet d'identifier le développement de défauts de ce type plusieurs jours avant leur détection par l'équipe de réparation.
InterSystems IRIS – plateforme universelle de calculs AI/ML en temps réel
La plateforme InterSystems IRIS facilite le développement, le déploiement et l'exploitation de solutions sur des données en temps réel. InterSystems IRIS est capable d'effectuer simultanément un traitement transactionnel et analytique des données ; de maintenir des vues de données synchronisées selon plusieurs modèles (y compris relationnel, hiérarchique, orienté objet et documentaire) ; de servir de plateforme d'intégration pour un large éventail de sources de données et d'applications individuelles ; et de fournir une analyse avancée en temps réel sur des données structurées et non structurées. InterSystems IRIS offre également des mécanismes pour appliquer des outils analytiques externes, permettant une combinaison flexible de déploiement dans le cloud et sur des serveurs locaux.
Les applications construites sur la plateforme InterSystems IRIS sont implantées dans divers secteurs, aidant les entreprises à réaliser des économies significatives à long terme et à court terme, en améliorant la prise de décision et en éliminant les « écarts » entre l'événement, l'analyse et l'action.
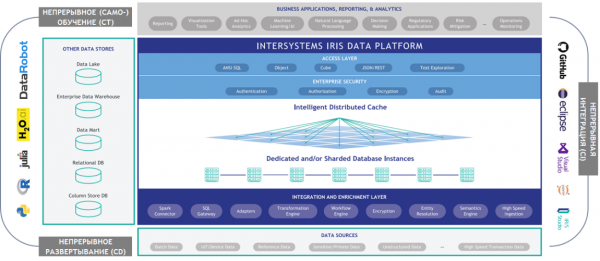
Figure 10 Architecture d'InterSystems IRIS dans le contexte de l'AI/ML en temps réel
Comme le diagramme précédent, le diagramme ci-dessous combine un nouveau « système de coordonnées » (CD/CI/CT) avec le schéma des flux d'informations entre les éléments de travail de la plateforme. La visualisation commence par le macro-mécanisme CD et se poursuit avec les macro-mécanismes CI et CT.
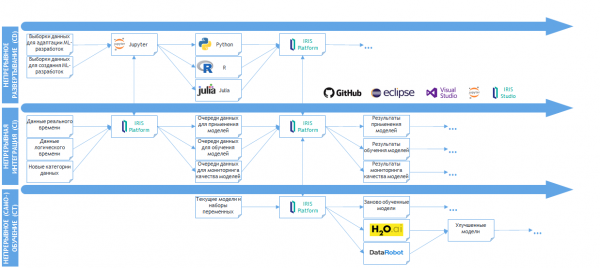
Figure 11 Schéma des flux d'informations entre les éléments AI/ML de la plateforme InterSystems IRIS
Le mécanisme CD dans InterSystems IRIS : les utilisateurs de la plateforme (développeurs de solutions AI/ML) adaptent les développements AI/ML existants et/ou créent de nouveaux en utilisant un éditeur de code spécialisé pour les mécanismes AI/ML : Jupyter (nom complet : Jupyter Notebook ; de plus, pour plus de commodité, les documents créés dans cet éditeur sont parfois également appelés ainsi). Dans Jupyter, le développeur a la possibilité d'écrire, de déboguer et de s'assurer du bon fonctionnement (y compris avec des graphiques) d'un développement AI/ML spécifique avant son déploiement dans InterSystems IRIS. Il est évident que le développement ainsi créé ne bénéficiera que d'un débogage de base (car, en particulier, Jupyter ne fonctionne pas avec des flux de données en temps réel) – c'est tout à fait normal, car le principal résultat du développement dans Jupyter devient la confirmation du bon fonctionnement d'un mécanisme AI/ML particulier (affichant le résultat attendu sur un ensemble de données). De manière similaire, un mécanisme déjà intégré à la plateforme (voir les macro-mécanismes suivants) peut nécessiter un « retour » à l'état « pré-platforme » avant d'être débogué dans Jupyter (lecture des données à partir de fichiers, travail avec les données via xDBC au lieu de tables, interaction directe avec les globals – des tableaux multidimensionnels de données InterSystems IRIS – etc.).
Un aspect important de l'implémentation de CD précisément dans InterSystems IRIS : une intégration bidirectionnelle a été réalisée entre la plateforme et Jupyter, permettant de transférer dans la plateforme (et par la suite de traiter dans la plateforme) du contenu dans les langages Python, R et Julia (les trois étant des langages de programmation dans les environnements open-source de modélisation mathématique correspondants). Ainsi, les développeurs de contenu AI/ML ont la possibilité d'effectuer un « déploiement continu » de ce contenu dans la plateforme, en travaillant dans leur éditeur habituel Jupyter, avec les bibliothèques familières disponibles dans Python, R, Julia, et en réalisant un débogage de base (si nécessaire) en dehors de la plateforme.
Nous passons au macro-mécanisme CI dans InterSystems IRIS. Le diagramme illustre le macroprocessus de travail du « robot en temps réel » (un ensemble de structures de données, de processus métiers et des fragments de code orchestrés dans les langages mathématiques et en ObjectScript – le langage natif de développement d'InterSystems IRIS). La tâche de ce macroprocessus est de maintenir les files de données nécessaires au bon fonctionnement des mécanismes AI/ML (basés sur les flux de données transmis à la plateforme en temps réel), de décider de la séquence d'application et de la 'gamme' de mécanismes AI/ML (également appelés « algorithmes mathématiques », « modèles », etc. – pouvant être désignés différemment selon les spécificités de mise en œuvre et les préférences terminologiques), et de garder à jour les structures de données pour l'analyse des résultats des mécanismes AI/ML (cubes, tableaux, tableaux multidimensionnels de données, etc. – pour les rapports, les tableaux de bord, etc.).
Un aspect important de l'implémentation de CI spécifiquement dans InterSystems IRIS : une intégration bidirectionnelle est mise en œuvre entre la plateforme et les environnements de modélisation mathématique, permettant d'exécuter le contenu hébergé sur la plateforme dans les langages Python, R et Julia dans leurs environnements respectifs, tout en obtenant les résultats d'exécution en retour. Cette intégration s'effectue à la fois en « mode terminal » (c'est-à-dire que le contenu AI/ML est formulé comme du code en ObjectScript effectuant des appels aux environnements mathématiques), et en « mode processus métier » (c'est-à-dire que le contenu AI/ML est formulé comme un processus métier à l'aide d'un éditeur graphique, ou parfois avec Jupyter, ou à l'aide d'un IDE – IRIS Studio, Eclipse, Visual Studio Code). La disponibilité des processus métiers pour édition dans Jupyter est reflétée par la liaison entre IRIS au niveau CI et Jupyter au niveau CD. Un examen plus détaillé de l'intégration avec les environnements de modélisation mathématique sera présenté par la suite. À ce stade, il convient de noter qu'il y a toutes les raisons de confirmer la présence dans la plateforme de tous les outils nécessaires à la mise en œuvre de l'« intégration continue » des développements AI/ML (provenant du « déploiement continu ») dans des solutions AI/ML en temps réel.
Et le principal macro-mécanisme : CT. Sans lui, il n'est pas possible d'avoir des plateformes AI/ML (même si « temps réel » sera implémenté via CD/CI). L'essence de CT est le travail de la plateforme avec les « artefacts » d'apprentissage automatique et d'intelligence artificielle directement dans les sessions de travail des environnements de modélisation mathématique : modèles, tableaux de distributions, vecteurs-matrices, couches de réseaux de neurones, etc. Ce « travail » consiste, dans la plupart des cas, à créer les artefacts mentionnés dans les environnements (dans le cas des modèles, par exemple, « création » consiste à définir la spécification du modèle et à ajuster ses paramètres – ce qu'on appelle l'« entraînement » du modèle), à les appliquer (pour les modèles : calculer à l'aide de ces artefacts des valeurs « modélisées » des variables cibles – prévisions, appartenance à une catégorie, probabilité d'occurrence d'un événement, etc.) et à perfectionner les artefacts déjà créés et appliqués (par exemple, redéfinir l'ensemble des variables d'entrée du modèle en fonction des résultats d'application – dans le but d'améliorer la précision des prévisions, par exemple). Un point clé pour comprendre le rôle de CT est son « abstraction » des réalités CD et CI : CT implémentera tous les artefacts en s'orientant sur la spécificité computationnelle et mathématique de la solution AI/ML dans le cadre des possibilités offertes par les environnements spécifiques. La responsabilité de « fournir les données d'entrée » et de « livrer les résultats » incombera à CD et CI.
Un aspect important de l'implémentation de CT dans InterSystems IRIS : en utilisant l'intégration mentionnée ci-dessus avec des environnements de modélisation mathématique, la plateforme a la capacité d'extraire des artefacts des sessions de travail gérées dans ces environnements et (ce qui est le plus important) de les transformer en objets de données de la plateforme. Par exemple, une table de distribution qui vient d'être créée dans une session de travail Python peut être (sans arrêter la session en Python) transférée sur la plateforme sous forme, par exemple, d'un global (tableau multidimensionnel de données InterSystems IRIS) – et utilisée pour des calculs dans un autre mécanisme AI/ML (déjà mis en œuvre dans un autre langage – par exemple, R) – ou dans une table virtuelle. Un autre exemple : parallèlement au « mode de fonctionnement normal » du modèle (dans une session de travail Python), « auto-ML » est effectué sur ses données d'entrée : sélection automatique des meilleures variables d'entrée et valeurs de paramètres. Et avec l'apprentissage « normal », le modèle productif en temps réel reçoit également une « proposition d'optimisation » de sa spécification – dans laquelle l'ensemble des variables d'entrée est modifié, les valeurs des paramètres changent (non pas en raison de l'apprentissage en Python, mais en raison de l'apprentissage d'une « version alternative » de lui-même, par exemple, dans la pile H2O), permettant à la solution AI/ML globale de faire face de manière autonome aux changements inattendus dans la nature des données d'entrée et des phénomènes modélisés.
Explorons plus en détail les fonctionnalités AI/ML de la plateforme InterSystems IRIS, à travers un exemple de prototype existant.
Dans le diagramme ci-dessous, sur la partie gauche de la diapositive se trouve une partie du processus métier implémentant le traitement des scripts en Python et R. Au centre, des logs visuels d'exécution de certains de ces scripts, respectivement en Python et en R. Juste après, des exemples de contenu dans les deux langages, transmis pour exécution dans leurs environnements respectifs. À droite, des visualisations basées sur les résultats de l'exécution des scripts. Les visualisations en haut sont réalisées sur IRIS Analytics (les données sont récupérées de Python vers la plateforme de données InterSystems IRIS et affichées sur le dashboard via les outils de la plateforme), et celles en bas sont créées directement dans la session de travail R et exportées au format graphique. Un aspect important : le fragment présenté dans le prototype est responsable de l'apprentissage du modèle (classification des états de l'équipement) à partir des données en temps réel provenant du processus simulateur d'équipement, à la demande du processus de surveillance de la qualité de classification observée lors de l'application du modèle. Nous parlerons ensuite de l'implémentation de la solution AI/ML sous la forme d'un ensemble de processus interconnectés (agents).
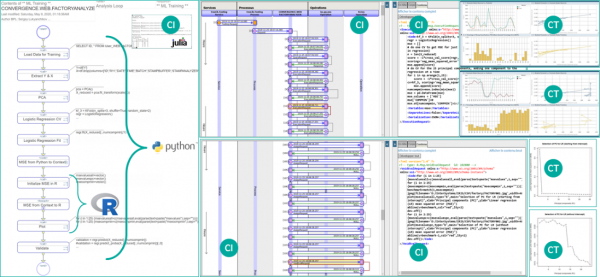
Figure 12 Interaction avec Python, R et Julia dans InterSystems IRIS
Les processus de plateforme (également appelés « processus métier », « processus d'analyse », « pipelines », etc., selon le contexte) sont principalement modifiables dans l'éditeur graphique des processus métier au sein de la plateforme, de telle manière qu'à la fois le diagramme de flux et le mécanisme AI/ML correspondant (le code source) sont créés simultanément. En parlant de la création d'un mécanisme AI/ML, nous impliquons dès le départ l'hybridité (au sein d'un même processus) : le contenu dans les langages de modélisation mathématique coexiste avec le contenu en SQL (y compris des extensions de ), en InterSystems ObjectScript, avec d'autres langages pris en charge. De plus, le processus de la plateforme offre des possibilités très larges pour le « rendu » sous forme de fragments hiérarchiquement imbriqués (comme visible dans l'exemple de l'illustration ci-dessous), ce qui permet d'organiser efficacement même un contenu très complexe, sans jamais « sortir » du format graphique (dans les méthodes/classes/procédures « non graphiques », etc.). C'est-à-dire que, si nécessaire (ce que l'on prévoit dans la plupart des projets), l'entièreté de la solution AI/ML peut être implémentée dans un format graphique auto-documenté. Nous notons que dans la partie centrale de l'illustration ci-dessous, où un « niveau d'imbrication » plus élevé est présenté, il est visible que, en plus du travail sur l'apprentissage du modèle (à l'aide de Python et R), une analyse de la courbe ROC du modèle entraîné est ajoutée, permettant d'évaluer visuellement (et aussi computationnellement) la qualité de l'apprentissage – et cette analyse est réalisée dans le langage Julia (exécutée, respectivement, dans l'environnement Julia).
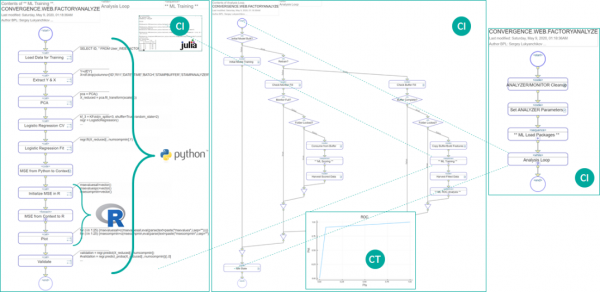
Figure 13 Environnement visuel de composition des solutions AI/ML dans InterSystems IRIS
Comme mentionné précédemment, le développement initial et (dans certains cas) l'adaptation des mécanismes AI/ML déjà implémentés dans la plateforme sera/peut être réalisée en dehors de la plateforme dans l'éditeur Jupyter. Dans l'illustration ci-dessous, nous voyons un exemple d'adaptation d'un processus de plateforme existant (celui-même que sur l'illustration ci-dessus) – voici comment cela apparaît dans Jupyter pour le fragment qui est responsable de l'apprentissage du modèle. Le contenu en langage Python est accessible pour l'édition, le débogage et la sortie graphique directement dans Jupyter. Des modifications (si nécessaire) peuvent être effectuées avec une synchronisation instantanée dans le processus de la plateforme, y compris dans sa version productive. De la même manière, un nouveau contenu peut être transféré vers la plateforme (un nouveau processus de plateforme est automatiquement généré).
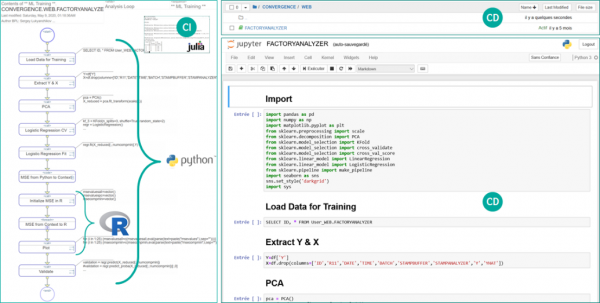
Figure 14 Utilisation de Jupyter Notebook pour l'édition du mécanisme AI/ML dans la plateforme InterSystems IRIS
L'adaptation du processus de plateforme peut se faire non seulement au format graphique ou portable, mais également dans un format « total » d'IDE (Environnement de Développement Intégré). Les IDE concernés sont IRIS Studio (le studio natif IRIS), Visual Studio Code (l'extension InterSystems IRIS pour VSCode) et Eclipse (le plugin Atelier). Dans certains cas, l'utilisation simultanée de ces trois IDE par une équipe de développeurs est possible. Le diagramme ci-dessous montre un exemple d'édition du même processus dans IRIS Studio, Visual Studio Code et Eclipse. Tout le contenu est accessible pour l'édition : Python/R/Julia/SQL, ObjectScript et le processus métier.
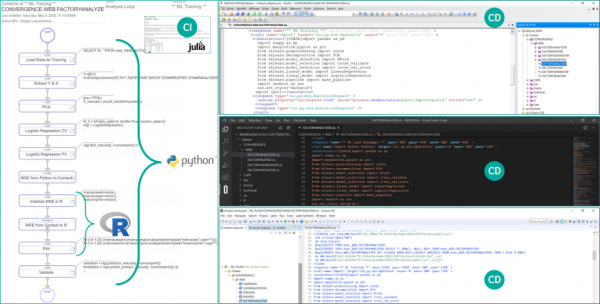
Figure 15 Développement du processus métier InterSystems IRIS dans différents IDE
Il convient de mentionner spécifiquement les outils de description et d'exécution des processus métier InterSystems IRIS en Business Process Language (BPL). Le BPL permet d'utiliser dans les processus métier des « composants d'intégration prêts à l'emploi » (activités) – ce qui justifie pleinement d'affirmer qu'InterSystems IRIS réalise une « intégration continue ». Les composants prêts à l'emploi des processus métier (activités et leurs interrelations) constituent un puissant accélérateur de construction des solutions AI/ML. Et pas seulement pour la construction : grâce aux activités et aux liens entre elles, un « couche managériale autonome » émerge, capable de prendre des décisions en fonction de la situation, en temps réel.
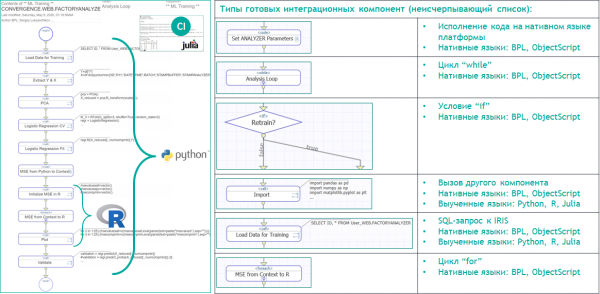
Figure 16 Composants prêts à l'emploi des processus métier pour l'intégration continue (CI) sur la plateforme InterSystems IRIS
Le concept de systèmes multi-agents est solidement établi dans la robotique, et la plateforme InterSystems IRIS le supporte organiquement à travers le construct « produit-processus ». En plus des possibilités illimitées pour « garnir » chaque processus du fonctionnel nécessaire pour la solution globale, doter le système de processus de plateforme de la propriété « d'agent » permet de créer des solutions efficaces pour des phénomènes modélisés extrêmement instables (comportement de systèmes sociaux/biologiques, processus technologiques partiellement observables, etc.).
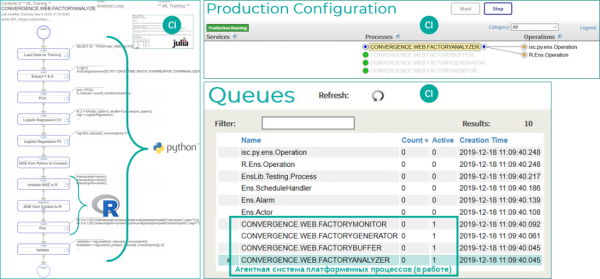
Figure 16 Fonctionnement d'une solution AI/ML sous la forme d'un système agent de processus métier dans InterSystems IRIS
Nous poursuivons notre examen d'InterSystems IRIS par un récit sur l'utilisation pratique de la plateforme pour résoudre toute une classe de problèmes en temps réel (une introduction assez détaillée à certaines des meilleures pratiques de l'IA/ML sur InterSystems IRIS figure dans l'un de nos précédents articles). ).
Sur les « traces chaudes » du diagramme précédent, ci-dessous se trouve un diagramme plus détaillé du système d'agents. Le diagramme illustre le même prototype, montrant les quatre processus-agents : GENERATOR – gère la création des données par les capteurs d'équipement, BUFFER – gère les files d'attente de données, ANALYZER – réalise l'apprentissage automatique proprement dit, MONITOR – contrôle la qualité de l'apprentissage automatique et signale la nécessité d'une nouvelle formation du modèle.
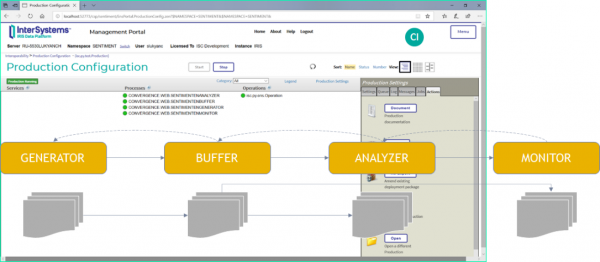
Figure 17 Composition de la solution AI/ML sous forme de système d'agents de processus métier dans InterSystems IRIS.
Le diagramme ci-dessous illustre le fonctionnement autonome d'un autre prototype robotisé (reconnaissance de la tonalité émotionnelle des textes) sur une période de temps. En haut – l'évolution du score de qualité de formation du modèle (la qualité augmente), en bas – la dynamique du score de qualité d'application du modèle et les faits de réentraînement (bandes rouges). Comme on peut le voir, la solution s'est efficacement et de manière autonome auto-formée, et fonctionne à un niveau de qualité défini (les valeurs du score de qualité ne descendent pas en dessous de 80 %).
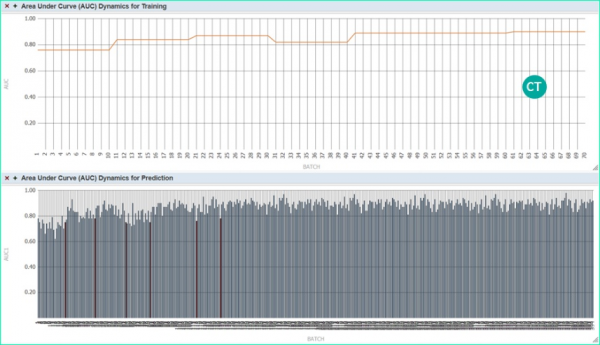
Figure 18 Apprentissage continu (auto-) sur la plateforme InterSystems IRIS.
Nous avons également mentionné l'« auto-ML » précédemment, mais le diagramme ci-dessous montre l'application de cette fonctionnalité en détail au moyen d'un autre prototype. Le schéma graphique d'un fragment de processus métier montre l'activité qui déclenche la modélisation dans la pile H2O, ainsi que les résultats de cette modélisation (la dominance évidente du modèle obtenu sur les modèles « faits à la main », selon le diagramme comparatif des courbes ROC, ainsi que l'identification automatisée des « variables les plus influentes » parmi celles disponibles dans le jeu de données d'origine). Un point important ici est le gain de temps et de ressources d'experts réalisé grâce à l'« auto-ML » : ce que notre processus sur la plateforme effectue en trente secondes (trouver et entraîner le modèle optimal) peut prendre aux experts de une semaine à un mois.
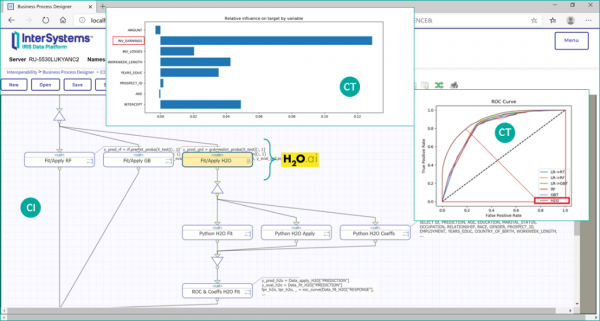
Figure 19 Intégration de l'« auto-ML » dans la solution AI/ML sur la plateforme InterSystems IRIS
Le diagramme ci-dessous atténue légèrement le suspense, mais il constitue une bonne façon de clore notre récit sur les classes de problèmes résolus en temps réel : nous rappelons qu'avec toutes les capacités de la plateforme InterSystems IRIS, l'entraînement des modèles sous sa gestion n'est pas obligatoire. La plateforme peut recevoir de l'extérieur une spécification de modèle PMML, entraînée dans un outil qui n'est pas sous la gestion de la plateforme – et appliquer ce modèle en temps réel dès son importation. . Il est important de noter que tous les artefacts AI/ML ne peuvent pas être réduits à une spécification PMML, même si la plupart des artefacts les plus courants le permettent. Ainsi, la plateforme InterSystems IRIS a une « boucle ouverte » et ne signifie pas une « servitude platformique » pour les utilisateurs.
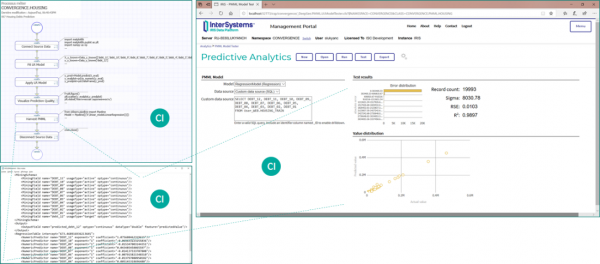
Figure 20 Intégration de l'« auto-ML » dans la solution AI/ML sur la plateforme InterSystems IRIS
Énumérons les avantages supplémentaires de la plateforme InterSystems IRIS (pour des raisons de clarté, en ce qui concerne la gestion des processus technologiques) qui revêtent une grande importance lors de l'automatisation de l'intelligence artificielle et de l'apprentissage automatique en temps réel :
- Outils d'intégration avancés avec toutes les sources et consommateurs de données (SCS/SCADA, équipements, maintenance, ERP, etc.)
- Intégré pour le traitement transactionnel-analytique haute performance (Hybrid Transaction/Analytical Processing, HTAP) de tout volume de données des processus technologiques
- Outils de développement pour le déploiement continu de mécanismes AI/ML de solutions en temps réel basées sur Python, R, Julia
- Processus d'affaires adaptatifs pour l'intégration continue et l'auto-apprentissage des mécanismes AI/ML de solutions en temps réel
- Outils intégrés de Business Intelligence pour la visualisation des données des processus technologiques et des résultats du fonctionnement des solutions AI/ML
- pour la livraison des résultats des solutions AI/ML dans les systèmes de contrôle commandés et de supervision (SCADA), systèmes d'information et d'analyse, envoi d'alertes, etc.
Les solutions AI/ML sur la plateforme InterSystems IRIS s'intègrent facilement dans l'infrastructure informatique existante. La plateforme InterSystems IRIS garantit une haute fiabilité des solutions AI/ML grâce à la prise en charge de configurations tolérantes aux pannes et de récupération après sinistre, ainsi qu'un déploiement flexible dans des environnements virtuels, sur des serveurs physiques, dans des clouds privés et publics, et des conteneurs Docker.
Ainsi, InterSystems IRIS est une plateforme polyvalente pour le calcul AI/ML en temps réel. La polyvalence de notre plateforme est confirmée par l'absence pratique de limites de facto sur la complexité des calculs implémentables, la capacité d'InterSystems IRIS à combiner (en temps réel) le traitement de scénarios de divers secteurs, et l'adaptabilité exceptionnelle de toutes les fonctions et mécanismes de la plateforme aux besoins spécifiques des utilisateurs.
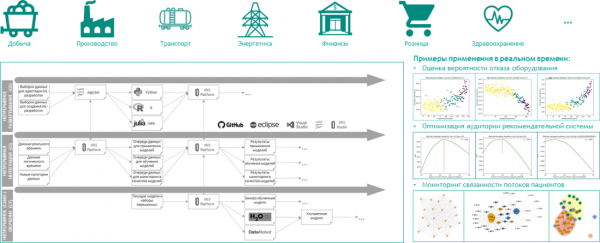
Figure 21 InterSystems IRIS — plateforme polyvalente pour les calculs AI/ML en temps réel
Pour une interaction plus concrète avec ceux de nos lecteurs qui sont intéressés par le matériel présenté ici, nous vous recommandons de ne pas vous limiter à sa lecture et de continuer le dialogue "en direct". Nous serons heureux de vous aider à formuler des scénarios AI/ML en temps réel adaptés aux spécificités de votre entreprise, de réaliser un prototypage collaboratif sur la plateforme InterSystems IRIS, et de développer et mettre en pratique une feuille de route pour l'intégration de l'intelligence artificielle et de l'apprentissage automatique dans vos processus de production et de gestion. L'adresse e-mail de notre groupe d'experts AI/ML est .
Source : habr.com
