

– Ah, aucun abri ne résistera à l'impact d'une météorite. Mais vous avez, comme tout le monde, un plan de secours, donc vous pouvez être tranquille.
Stanislas Lem, « Les Journaux des étoiles d'Ijon Tichý »
La sauvegarde consiste à conserver une copie des données quelque part en dehors de leur emplacement principal de stockage.
L'objectif principal de la sauvegarde est la récupération des données après leur perte. À cet égard, on entend souvent dire que si une réplique de la base de données existe, il est toujours possible de récupérer les données, et que la sauvegarde n'est pas nécessaire. En réalité, la sauvegarde permet de résoudre au moins trois problèmes qui ne peuvent pas être résolus par une réplique, et on ne peut même pas initialiser une réplique sans sauvegarde.
Tout d'abord, une sauvegarde permet de restaurer des données après une erreur logique. Par exemple, un comptable a supprimé un groupe d'écritures ou un administrateur de base de données a détruit un espace de table. Ces deux opérations sont parfaitement légitimes du point de vue de la base de données, et le processus de réplication les reproduira dans la base de données répliquée.
Deuxièmement, les SGBD modernes sont des logiciels très fiables, mais il arrive parfois que des structures internes de la base de données se corrompent, rendant l'accès aux données impossible. Ce qui est particulièrement frustrant, c'est que ce type de défaillance survient généralement sous une forte charge ou lors de l'installation d'une mise à jour. Cependant, tant une forte charge qu'une mise à jour régulière indiquent que la base de données n'est en aucun cas un environnement de test, et que les données qu'elle contient sont précieuses.
Enfin, la troisième tâche qui nécessite une sauvegarde est le clonage de la base, par exemple, à des fins de test.
La sauvegarde des bases de données repose d'une manière ou d'une autre sur l'un des deux principes suivants :
- Extraction des données suivie d'un enregistrement dans un format arbitraire ;
- Instantané de l'état des fichiers de la base de données et enregistrement des journaux.
Examinons ces principes et les outils qui les mettent en œuvre plus en détail.
Extraction des données
Dans l'ensemble d'outils fournis avec tout SGBD, il y a nécessairement des outils pour l'extraction et le chargement des données. Les données sont enregistrées soit dans un format texte, soit dans un format binaire spécifique au SGBD. Le tableau ci-dessous contient une liste de ces outils :
Format binaire
Format texte
Oracle
DataPump Export/DataPump Import
Export/Import
SQL*Plus/SQL*Loader
PostgreSQL
pg_dump, pg_dumpall/pg_restore
pg_dump, pg_dumpall/psql
Microsoft SQL Server
bcp
bcp
DB2
unload/load
unload/load
MySQL
mysqldump, mysqlpump/mysql, mysqlimport
MongoDB
mongodump/mongorestore
mongoexport/mongoimport
Cassandra
nodetool snapshot/sstableloader
cqlsh
Le format texte est bon car il peut être édité ou même créé par des programmes externes, tandis que le format binaire est bon car il permet de charger et décharger les données plus rapidement en économisant des ressources sur la conversion des formats.
Malgré la simplicité et l'évidence de l'idée de décharger des données, cette méthode est rarement utilisée pour sauvegarder des bases de données industrielles chargées. Voici les raisons pour lesquelles le déchargement ne convient pas à une sauvegarde complète :
- Le processus de déchargement impose une charge significative sur le système source ;
- Le déchargement prend beaucoup de temps – au moment de la fin du déchargement, il sera déjà obsolète ;
- Il est pratiquement impossible d'effectuer un déchargement cohérent de l'ensemble de la base de données sous une forte charge, car le SGBD doit conserver une image de son état au moment du début du déchargement. Plus il y a de transactions effectuées depuis le début du déchargement, plus le volume de l'image (copies obsolètes des données dans PostgreSQL, espace undo dans Oracle, tempdb dans Microsoft SQL Server, etc.) est important ;
- Le déchargement conserve la structure logique des données, mais ne conserve pas leur structure physique – les paramètres de stockage physique des tables, les index, etc.
Néanmoins, le déchargement a ses avantages :
- Haute sélectivité : il est possible de décharger des tables spécifiques, des champs spécifiques et même des lignes spécifiques ;
- Les données déchargées peuvent être chargées dans une base de données d'une autre version, et si le déchargement est effectué au format texte, alors dans une autre base de données.
Ainsi, le déchargement est principalement utilisé pour des tâches telles que la sauvegarde de petites tables (par exemple, des répertoires) ou la distribution de jeux de données avec la prochaine version de l'application.
Le méthode la plus commune de sauvegarde des bases de données est la copie des fichiers de la base.
Sauvegarde « froide » des fichiers de la base de données
L'idée évidente est d'arrêter la base de données et de copier tous ses fichiers. Cette sauvegarde est appelée « froide ». C'est une méthode extrêmement fiable et simple, mais elle présente deux inconvénients évidents :
- Depuis une sauvegarde « froide », il est possible de restaurer uniquement l'état de la base de données tel qu'il était au moment de l'arrêt ; les transactions effectuées après le redémarrage de la base ne seront pas incluses dans la sauvegarde « froide ».
- Toutes les bases de données ne disposent pas nécessairement d'une fenêtre technologique pendant laquelle la base peut être arrêtée.
Cependant, si la sauvegarde « froide » vous convient, il est important de se souvenir que
- la copie « froide » doit parfois inclure les journaux. Les méthodes pour déterminer quels journaux doivent être inclus dans la sauvegarde « froide » varient selon chaque SGBD. Par exemple, dans Oracle, il est nécessaire de copier ce que l'on appelle les redo logs en ligne, c'est-à-dire un certain nombre de fichiers journaux dans un répertoire spécial, même lorsque la base est correctement arrêtée. Dans PostgreSQL, il faut conserver tous les journaux à partir du journal contenant le dernier point de contrôle, dont les informations sont stockées dans le fichier de contrôle.
- Le répertoire de la base de données peut contenir des fichiers assez volumineux d'espaces de tables temporaires qui ne doivent pas forcément être inclus dans la sauvegarde. D'ailleurs, cette remarque est également valable pour la sauvegarde « chaude ».
Sauvegarde « chaude » des fichiers
La plupart des sauvegardes des bases de données modernes sont réalisées en copiant les fichiers de la base de données sans arrêter la base. Plusieurs problèmes peuvent se poser à cet égard :
- Au moment où le processus de copie commence, le contenu de la base de données peut ne pas correspondre au contenu des fichiers, car une partie des informations est dans le cache et n'a pas encore été écrite sur le disque.
- Pendant la copie, le contenu de la base peut changer. Si des structures de données modifiables sont utilisées, le contenu des fichiers change, et si des structures immuables sont utilisées, l'ensemble des fichiers change : de nouveaux fichiers apparaissent tandis que les anciens sont supprimés.
- Étant donné que l'écriture de données dans la base et la lecture des fichiers de la base de données ne sont pas synchronisées, le programme de sauvegarde peut lire une page incorrecte, où une moitié proviendra de l'ancienne version de la page et l'autre moitié de la nouvelle.
Pour qu'une sauvegarde soit cohérente, chaque SGBD dispose d'une commande qui signale le début du processus de sauvegarde. Syntaxiquement, cette commande peut varier :
- dans Oracle, il s'agit d'une commande distincte ALTER DATABASE/TABLESPACE BEGIN BACKUP ;
- dans PostgreSQL, il s'agit de la fonction pg_start_backup();
- Dans Microsoft SQL Server et DB2, la préparation pour la sauvegarde est effectuée implicitement lors de l'exécution de la commande BACKUP DATABASE.
- Dans MySQL Enterprise, Cassandra et MongoDB, la préparation est effectuée implicitement par des utilitaires externes - mysqlbackup, OpsCenter et Ops Manager respectivement.
Malgré les différences syntaxiques, le processus de préparation à la sauvegarde est identique.
Voici à quoi ressemble la préparation à la sauvegarde dans les SGBD avec des structures de disque évolutives, c'est-à-dire dans tous les systèmes relationnels traditionnels sur disque :
- Le moment de début de la sauvegarde est enregistré ; la sauvegarde devra inclure les journaux de la base de données à partir de ce moment.
- Un point de contrôle est réalisé, ce qui signifie que toutes les modifications apportées aux pages de données avant le moment enregistré sont écrites sur le disque. Cela garantit que les journaux avant le début de la sauvegarde ne seront pas nécessaires lors de la restauration.
- Un mode de journalisation spécial est activé : si une page de données a été modifiée pour la première fois après avoir été chargée depuis le disque, alors au lieu d'enregistrer dans le journal les modifications de la page, la base enregistrera la page entière. Lors de l'exécution de la procédure préparatoire, toutes les pages sont expulsées sur le disque, et donc lors de la première modification, le bloc sera toujours enregistré dans le journal dans son intégralité. Mais si durant la sauvegarde, la page est à nouveau expulsée sur le disque, alors sa modification suivante entraînera également l'apparition dans le journal d'une copie complète de la page. Cela garantit que si, par inadvertance, la page de données devient incorrecte lors de la copie de fichier, l'application du journal la rendra correcte à nouveau.
- Les modifications des en-têtes de fichiers de données sont bloquées, c'est-à-dire la partie de celui-ci, les modifications de laquelle ne sont pas reflétées dans les journaux. Cela garantit que l'en-tête sera copié correctement, et ensuite les journaux seront appliqués correctement au fichier de données.
Une fois que toutes les procédures ci-dessus ont été exécutées, il est possible de copier les fichiers de données à l'aide du système d'exploitation, tels que cp, rsync et autres. L'activation du mode de sauvegarde réduit les performances de la base de données : d'une part, le volume des journaux augmente, et d'autre part, en cas d'échec pendant la sauvegarde, la restauration sera plus longue car les en-têtes des fichiers de données ne sont pas mis à jour. Plus la sauvegarde est rapide, mieux c'est pour la base de données, c'est pourquoi il est approprié d'utiliser des outils tels que les snapshots du système de fichiers ou le déchirement de miroir (BCV) dans le tableau de stockage. Certaines SGBD (Oracle, PostgreSQL) laissent à l'administrateur la possibilité de choisir la méthode de copie, tandis que d'autres (Microsoft SQL Server) fournissent une interface pour intégrer leurs propres outils de sauvegarde avec les mécanismes des systèmes de fichiers ou des dispositifs de stockage.
À la fin de la sauvegarde, il est nécessaire de remettre la base de données dans un état normal. Dans Oracle, cela se fait avec la commande ALTER DATABASE/TABLESPACE END BACKUP, dans PostgreSQL avec l'appel de la fonction pg_stop_backup(), et dans d'autres bases, via des sous-programmes internes des commandes appropriées ou de services externes.
Voici à quoi ressemble le diagramme temporel du processus de sauvegarde :
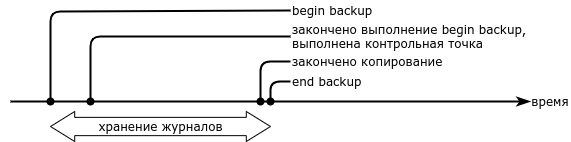
- La préparation de la sauvegarde (begin backup) prend du temps, parfois considérable. Même si des volumes miroirs ou des systèmes de fichiers avec des capacités de snapshot sont utilisés, le processus de sauvegarde ne sera pas instantané.
- Avec les fichiers de données, il est nécessaire de conserver les journaux à partir du moment du début de la préparation de la sauvegarde jusqu'au moment de la restitution de la base à son état normal.
- Il est possible de restaurer à partir de cette sauvegarde au moment du retour de la base à son état normal. La restauration à un moment antérieur n'est pas possible.
Pour les bases de données utilisant des structures de données immuables (snapshots de mémoire, arbres LSM), la situation est plus simple. La préparation de la sauvegarde consiste en plusieurs étapes :
- Les données de la mémoire sont écrites sur disque.
- Une liste des fichiers inclus dans la sauvegarde est enregistrée. Tant que le processus de sauvegarde n'est pas terminé, la base est interdite de supprimer ces fichiers, même s'ils ne sont plus nécessaires.
À la fin de la sauvegarde, la base avec des structures immuables peut de nouveau supprimer les fichiers inutiles.
Récupération à un point
La sauvegarde permet de restaurer l'état de la base de données au moment où la commande de retour du mode de sauvegarde a été terminée. Cependant, une panne nécessitant une récupération peut survenir à tout moment. La tâche de restauration de l'état de la base de données à un moment donné s'appelle « récupération à un point » (point-in-time recovery).
Pour garantir cette possibilité, il est nécessaire de conserver les journaux de la base de données à partir du moment où la sauvegarde est terminée, et durant le processus de restauration, continuer à appliquer les journaux à la copie restaurée. Une fois la base de données restaurée à partir de la sauvegarde au moment de la fin de la copie, l'état de la base (des fichiers et des pages mises en cache) est garantis comme étant correct, donc un mode spécial de journalisation n'est pas nécessaire. En appliquant les journaux jusqu'au moment voulu, on peut obtenir l'état de la base de données à n'importe quel moment.
Si la vitesse de restauration de la sauvegarde est limitée uniquement par la bande passante du disque, la vitesse d'application des journaux est généralement limitée par la performance du processeur. Si des modifications se produisent parallèlement dans la base de données principale, alors à la récupération, toutes les modifications s'effectuent de manière séquentielle – dans l'ordre de lecture à partir du journal. Ainsi, le temps de restauration dépend linéairement de la distance entre le point de récupération et le point de fin de la sauvegarde. C'est pourquoi il est souvent nécessaire de faire des sauvegardes complètes – au moins une fois par semaine pour des bases avec une faible charge transactionnelle et jusqu'à une sauvegarde quotidienne pour des bases à forte charge.
Sauvegarde incrémentielle
Pour accélérer la récupération à un point, il serait souhaitable de pouvoir effectuer des sauvegardes aussi souvent que possible, tout en ne prenant pas trop de place sur les disques et en ne surchargeant pas la base avec des tâches de sauvegarde.
La solution à ce problème est la sauvegarde incrémentielle, c'est-à-dire la copie uniquement des pages de données qui ont changé depuis la dernière sauvegarde.
La sauvegarde incrémentielle n'a de sens que pour les SGBD utilisant des structures de données modifiables.
L'incrément peut être calculé à partir d'une sauvegarde complète (sauvegarde cumulative) ou de n'importe quelle copie précédente (sauvegarde différentielle).
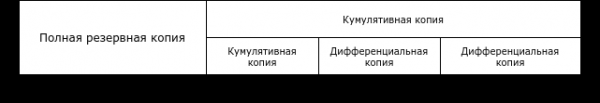
Malheureusement, il n'existe pas de terminologie uniforme, et différents fabricants utilisent différents termes :
Différentielle
Cumulative
Oracle
Différentielle
Cumulative
PostgresPro
Incrémental
—
Microsoft SQL Server
—
Différentielle
IBM DB2
Delta
Incrémental
En présence de copies incrémentielles, le processus de restauration à un point donné est le suivant :
- la dernière sauvegarde complète, effectuée avant le moment de la restauration, est restaurée ;
- les copies incrémentielles sont restaurées par-dessus la copie complète ;
- les journaux sont appliqués depuis le début de la sauvegarde jusqu'au point de restauration.
La présence d'une copie cumulative accélère le processus de restauration. Par exemple, pour restaurer l'état de la base à un point entre T3 et T4, il faut restaurer deux copies incrémentielles, alors que pour restaurer à un point après T4, il suffit d'une seule.
Il est évident qu'une copie cumulative occupe moins d'espace qu'un ensemble de plusieurs copies différentielles, car certaines pages ont changé plusieurs fois, et chaque copie incrémentielle contient sa version de la page.
Il existe trois méthodes pour créer une copie incrémentielle :
- créer une copie complète et calculer la différence avec la précédente copie complète ;
- analyser les journaux, établir une liste des pages modifiées et sauvegarder les pages figurant dans la liste ;
- demander les pages modifiées dans la base de données.
La première méthode économise de l'espace disque, mais ne résout pas le problème de la réduction de la charge sur la base de données. De plus, si nous avons une sauvegarde complète, il est inutile de la transformer en incrémentielle, car la restauration de la copie complète est plus rapide que celle de la précédente copie complète et de l'incrément. Pour économiser de l'espace disque avec cette approche, il vaut mieux s'en remettre à des composants spécifiques avec des mécanismes de déduplication intégrés. Cela peut inclure des systèmes de stockage spécialisés (EMC DataDomain, HPE StorageWorks VLS, toute la gamme NetApp), ainsi que des produits logiciels (ZFS, Veritas NetBackup PureFile, Dé-duplication de données de Windows Server).
La deuxième et la troisième méthode se distinguent par leur mécanisme de détermination de la liste des pages modifiées. L'analyse des journaux est plus gourmande en ressources, et pour cela, il est nécessaire de connaître la structure des fichiers journaux. Interroger directement la base sur les pages qui ont changé est le moyen le plus simple, mais cela nécessite que le noyau du SGBD dispose d'une fonctionnalité de suivi des blocs modifiés (block change tracking).
La fonctionnalité de sauvegarde incrémentielle a été introduite pour la première fois dans le logiciel Oracle Recovery Manager (RMAN), disponible avec la version Oracle 8i. Oracle a immédiatement mis en œuvre le suivi des blocs modifiés, éliminant ainsi le besoin d'analyser les journaux.
PostgreSQL ne suit pas les blocs modifiés, c'est pourquoi l'outil pg_probackup, développé par la société russe Postgres Professional, détermine les pages modifiées en analysant les journaux. Cependant, la société fournit aussi le SGBD PostgresPro, qui inclut l'extension ptrack permettant de suivre les modifications des pages. En utilisant pg_probackup avec le SGBD PostgresPro, l'outil interroge la base sur les pages modifiées, tout comme le fait RMAN.
Microsoft SQL Server, tout comme Oracle, suit les pages modifiées, mais la commande BACKUP ne permet de réaliser que des sauvegardes complètes et cumulatives.
DB2 offre la possibilité de suivre les pages modifiées, mais cela est désactivé par défaut. Une fois activé, DB2 permet de réaliser des sauvegardes complètes, différentielles et cumulatives.
Un aspect important qui distingue les outils décrits dans cette section (à l'exception de pg_probackup) des outils de sauvegarde de fichiers est qu'ils demandent des images de pages à la base de données, plutôt que de lire les données directement sur le disque. L'inconvénient de cette approche est une légère surcharge supplémentaire sur la base. Toutefois, cet inconvénient est largement compensé par le fait que la page lue est toujours correcte, évitant ainsi la nécessité d'activer un mode de journalisation spécial pendant la sauvegarde.
Il est important de rappeler que la présence de sauvegardes incrémentales ne supprime pas l'exigence de disposer de journaux pour une récupération à un moment précis. C'est pourquoi, dans les bases de données industrielles, les journaux sont continuellement écrits sur un support externe, tandis que des sauvegardes, complètes et/ou incrémentales, sont créées selon un calendrier.
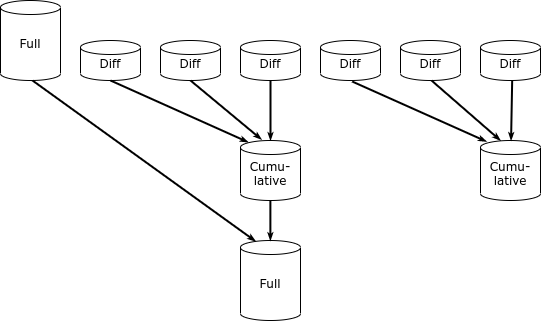
La meilleure réalisation à ce jour de l'idée de sauvegarde incrémentale est le système logiciel et matériel (en termes d'Oracle - système conçu) Zero Data Loss Recovery Appliance - une solution spécialisée d'Oracle pour la sauvegarde de sa propre base de données. Le système est un cluster serveurs avec un grand volume de disques, sur lesquels est installée une version modifiée du logiciel Recovery Manager et peut fonctionner à la fois avec d'autres systèmes logiciels et matériels d'Oracle (Database Appliance, Exadata, SPARC Supercluster) et avec des bases Oracle sur une infrastructure traditionnelle. Contrairement à un RMAN 'classique', le ZDLRA met en œuvre le concept d'« incrément permanent » (incremental forever). Le système crée une seule fois une copie complète de la base de données, puis ne réalise que des copies incrémentales. Des modules supplémentaires RMAN permettent de regrouper les copies, créant ainsi de nouvelles copies complètes à partir des copies incrémentales.
À l'honneur des développeurs russes, il convient de noter que pg_probackup sait également regrouper les copies incrémentales.
Contrairement à de nombreuses questions similaires, la question de savoir 'quel est le meilleur mode de sauvegarde' a une réponse claire - c'est la meilleure utilitaire native à la base de données utilisée, qui permet la sauvegarde incrémentale.
Pour l'administrateur de base de données, les questions de choix d'une stratégie de sauvegarde et d'intégration des outils de sauvegarde de bases de données dans l'infrastructure d'entreprise sont beaucoup plus importantes. Mais ces questions dépassent le cadre de cet article.
Source : habr.com
