

Introduction
Il y a quelque temps, on m'a confié la tâche de développer un cluster tolérant aux pannes pour , fonctionnant dans plusieurs centres de données, interconnectés par fibre optique dans une même ville, et capable de résister à la défaillance (par exemple, une coupure de courant) d'un centre de données. Pour le logiciel responsable de la tolérance aux pannes, j'ai choisi , car c'est la solution officielle de RedHat pour créer des clusters tolérants aux pannes. Elle est appréciée car RedHat en assure le support, et c'est une solution universelle (modulaire). Grâce à elle, il sera possible d'assurer la tolérance aux pannes non seulement pour PostgreSQL, mais aussi pour d'autres services, que ce soit en utilisant des modules standards ou en les créant pour des besoins spécifiques.
À cette solution, une question légitime s'est posée : dans quelle mesure un cluster tolérant aux pannes sera-t-il réellement tolérant aux pannes ? Pour le découvrir, j'ai développé un banc d'essai qui simule diverses pannes sur les nœuds du cluster, attend la reprise du fonctionnement, restaure le nœud défaillant et continue le test en boucle. Au départ, ce projet s'appelait hapgsql, mais avec le temps, je me suis lassé d'un nom comportant si peu de voyelles. J'ai donc commencé à nommer les bases de données tolérantes aux pannes (et l'IP flottante qui les désigne) krogan (un personnage d'un jeu vidéo qui a tous ses organes vitaux doublés), tandis que les nœuds, les clusters et le projet lui-même s'appellent tuchanka (la planète habitée par les krogan).
Actuellement, la direction a autorisé . Le README sera bientôt traduit en anglais (car les principaux utilisateurs devraient être les développeurs de Pacemaker et PostgreSQL), et j'ai décidé de présenter la vieille version russe du README (en partie) sous la forme de cet article.
Les clusters sont déployés sur des machines virtuelles . Au total, 12 machines virtuelles seront déployées (pour un total de 36GiB), qui formeront 4 clusters tolérants aux pannes (différentes options). Les deux premiers clusters sont composés de deux serveurs PostgreSQL, situés dans différents centres de données, et d'un serveur général witness c quorum device (situé sur une machine virtuelle bon marché dans un troisième centre de données), qui résout l'incertitude 50%/50%, en donnant sa voix à l'une des parties. Le troisième cluster se compose de trois centres de données : un maître, deux esclaves, sans quorum device. Le quatrième cluster se compose de quatre serveurs PostgreSQL, deux par centre de données : un maître et les autres en tant que répliques, et utilise aussi witness c quorum device. Le quatrième supporte la défaillance de deux serveurs ou d'un centre de données. Cette solution peut être, si nécessaire, étendue à un plus grand nombre de répliques.
Service de temps précis est également reconfiguré pour la résilience, mais utilise la méthode du ntpd (mode orphelin). Le serveur principal witness sert de serveur NTP central, distribuant son temps à tous les clusters, synchronisant ainsi tous les serveurs entre eux. Si witness tombe en panne ou se retrouve isolé, l'un des serveurs du cluster commencera alors à distribuer son temps (au sein du cluster). Un cache aux proxy HTTP a également été configuré sur witness, permettant aux autres machines virtuelles d'accéder aux dépôts Yum. En réalité, des services tels que le temps précis et le proxy seront probablement hébergés sur des serveurs dédiés, et dans cette configuration, ils sont placés sur witness uniquement pour économiser sur le nombre de machines virtuelles et l'espace.
Versions
v0. Fonctionne avec CentOS 7 et PostgreSQL 11 sur VirtualBox 6.1.
Structure des clusters
Tous les clusters sont destinés à être hébergés dans plusieurs centres de données, regroupés dans un réseau plat et doivent résister à la défaillance ou à l'isolement d'un centre de données. Par conséquent, est impossible utiliser pour se protéger contre le split-brain la technologie standard Pacemaker, appelée STONITH (Shoot The Other Node In The Head) ou fencing. Son principe : si les nœuds dans le cluster commencent à soupçonner qu'un nœud est défectueux, qu'il ne répond pas ou se comporte de manière incorrecte, ils le déconnectent de force via des dispositifs « externes », par exemple, une carte de gestion IPMI ou un UPS. Mais cela ne fonctionnera que dans les cas où, en cas de défaillance unique d'un serveur, l'IPMI ou l'UPS continuent de fonctionner. Ici, une protection contre une défaillance beaucoup plus catastrophique est prévue, lorsque tout le centre de données tombe en panne (par exemple, manque d'alimentation). Et dans un tel cas, tous les dispositifs stonith(IPMI, UPS, etc.) ne fonctionneront également pas.
Au lieu de cela, le système repose sur l'idée de quorum. Tous les nœuds ont une voix, et seuls ceux qui voient plus de la moitié de tous les nœuds peuvent fonctionner. Ce nombre, « moitié+1 », s'appelle quorum. Si le quorum n'est pas atteint, le nœud décide qu'il est en isolation réseau et doit désactiver ses ressources, c'est-à-dire que c'est une sorte de protection contre le split-brain. Si le logiciel responsable de ce comportement ne fonctionne pas, un watchdog, par exemple basé sur IPMI, doit intervenir.
Si le nombre de nœuds est pair (cluster dans deux centres de données), une incertitude appelée peut survenir 50%/50% (fifty-fifty), lorsque l'isolation réseau divise le cluster exactement en deux. C'est pourquoi, pour un nombre pair de nœuds, on ajoute quorum device — un démon peu exigeant qui peut être exécuté sur la machine virtuelle la moins chère dans le troisième centre de données. Il donne sa voix à l'un des segments (qu'il voit), et ainsi résout l'incertitude 50%/50%. Le serveur sur lequel sera exécuté le dispositif de quorum, je l'ai appelé witness (terminologie de repmgr, que j'ai aimée).
Les ressources peuvent être transférées d'un endroit à un autre, par exemple, des serveurs défectueux aux serveurs fonctionnels, ou sur ordre des administrateurs système. Pour que les clients sachent où se trouvent les ressources dont ils ont besoin (où se connecter ?), on utilise IP flottants (IP flottant). Ce sont des IP que Pacemaker peut déplacer d'un nœud à l'autre (tout est dans un réseau plat). Chacun d'eux symbolise une ressource (service) et sera là où il faut se connecter pour accéder à ce service (dans notre cas, la BD).
Tuchanka1 (schéma avec compression)
Structure
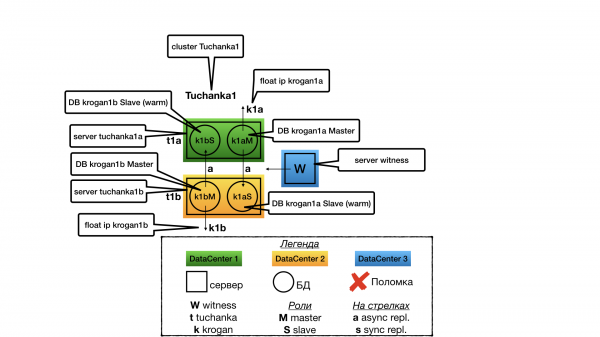
L'idée était d'avoir de nombreuses petites bases de données avec une faible charge, pour lesquelles il n'est pas rentable de maintenir un serveur esclave dédié en mode hot standby pour des transactions en lecture seule (aucune nécessité de gaspiller des ressources de cette manière).
Dans chaque centre de données, il y a un serveur. Sur chaque serveur, il y a deux instances PostgreSQL (dans la terminologie PostgreSQL, elles sont appelées clusters, mais pour éviter toute confusion, je vais les nommer instances (par analogie avec d'autres bases de données), et je n'appellerai clusters que les clusters Pacemaker). Une instance fonctionne en mode maître, et c'est la seule qui fournit des services (seule elle reçoit l'IP flottante). La deuxième instance fonctionne comme esclave pour le deuxième centre de données, et elle ne fournira des services que si son maître tombe en panne. Étant donné que la plus grande partie du temps, seul un des deux instances (le maître) fournira des services (traitera les requêtes), toutes les ressources serveur sont optimisées pour le maître (de la mémoire est allouée pour le cache shared_buffers, etc.), mais de manière à ce que la deuxième instance dispose également de suffisamment de ressources (même si c'est pour un fonctionnement sous-optimisé via le cache du système de fichiers) en cas de défaillance de l'un des centres de données. L'esclave ne fournit pas de services (ne traite pas les requêtes read only) lors du fonctionnement normal du cluster, afin qu'il n'y ait pas de conflit de ressources avec le maître sur la même machine.
Dans le cas de deux nœuds, la tolérance aux pannes n'est possible que par réplication asynchrone, car en réplication synchrone, la défaillance de l'esclave entraînera l'arrêt du maître.
Défaillance du témoin
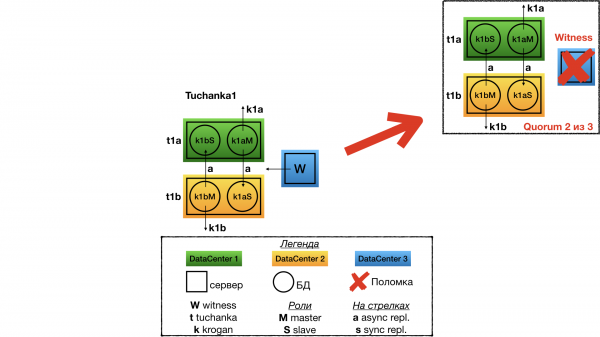
Défaillance du témoin (quorum device) je ne considérerai que le cluster Tuchanka1, pour tous les autres, ce sera la même histoire. En cas de défaillance du témoin dans la structure du cluster, rien ne changera, tout continuera à fonctionner comme avant. Mais le quorum sera égal à 2 sur 3, et donc toute défaillance ultérieure sera fatale pour le cluster. Il faudra de toute façon réparer rapidement.
Défaillance de Tuchanka1
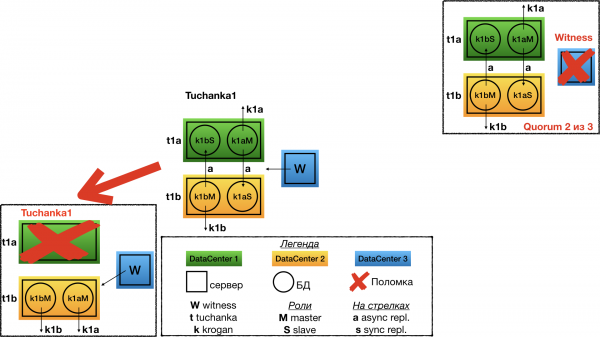
Défaillance de l'un des centres de données pour Tuchanka1. Dans ce cas witness elle donne sa voix au deuxième nœud dans le deuxième centre de données. Là, l'ancien esclave devient maître, de sorte que deux maîtres fonctionnent sur un serveur et que leurs deux IP flottantes pointent vers eux.
Tuchanka2 (classique)
Structure
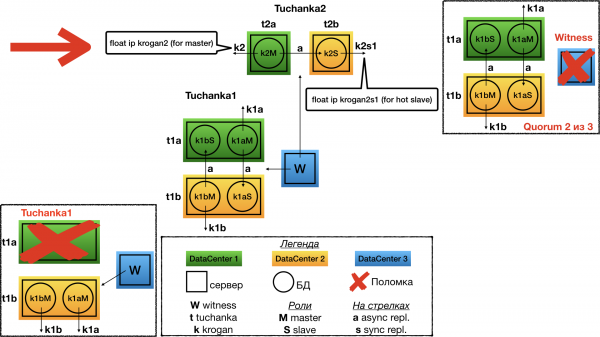
Schéma classique de deux nœuds. Sur l'un fonctionne le maître, sur l'autre l'esclave. Les deux peuvent traiter des requêtes (l'esclave uniquement en lecture), donc les deux possèdent une IP flottante : krogan2 — sur le maître, krogan2s1 — sur l'esclave. La tolérance aux pannes sera présente tant pour le maître que pour l'esclave.
Dans le cas de deux nœuds, la tolérance aux pannes n'est possible que par réplication asynchrone, car en réplication synchrone, la défaillance de l'esclave entraînera l'arrêt du maître.
Défaillance de Tuchanka2
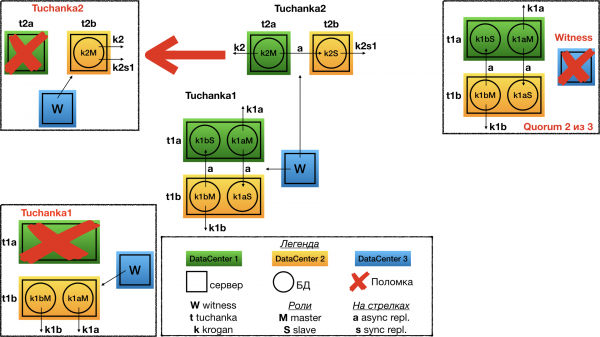
En cas de défaillance de l'un des centres de données witness vote pour le second. Sur le seul centre de données fonctionnel, un master sera déployé, qui recevra les deux IP flottants : celle du master et celle de l'esclave. Il va de soi que l'instance doit être configurée de manière à disposer de ressources suffisantes (limites de connexion, etc.) pour accepter simultanément toutes les connexions et requêtes provenant des deux IP flottantes, master et esclave. Cela signifie qu'en conditions normales, elle doit avoir une marge suffisante par rapport aux limites.
Tuchanka4 (beaucoup d'esclaves)
Structure
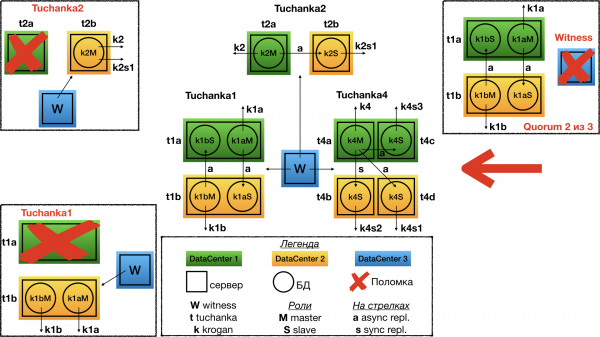
C'est déjà un autre extrême. Il existe des bases de données qui reçoivent un nombre considérable de requêtes en lecture seule (c'est typiquement le cas des sites à fort trafic). Tuchanka4 est une situation où le nombre d'esclaves peut être de trois ou plus pour traiter ces requêtes, mais sans être trop nombreux. Avec un nombre très élevé d'esclaves, il faudra inventer un système de réplication hiérarchique. Dans le cas minimal (sur l'image), il y a deux serveurs dans chacun des deux centres de données, chacun ayant une instance PostgreSQL.
Une autre particularité de ce schéma est qu'il est déjà possible d'organiser une réplication synchrone. Elle est configurée pour répliquer, autant que possible, vers un autre centre de données, et non vers une réplique dans le même centre de données que le master. Tant le master que chaque esclave ont une IP flottante. Idéalement, il faudrait équilibrer les requêtes entre les esclaves d'une manière quelconque. sql proxy, par exemple, du côté client. Différents types de clients peuvent nécessiter différents types sql proxy, et seuls les développeurs clients savent qui a besoin de quoi. Cette fonctionnalité peut être mise en œuvre soit par un démon externe, soit par une bibliothèque cliente (pool de connexions), etc. Tout cela dépasse le cadre d'un cluster de bases de données tolérant aux pannes (la tolérance aux pannes SQL proxy peut être réalisée indépendamment, en même temps que la tolérance aux pannes du client).
Panne de Tuchanka4
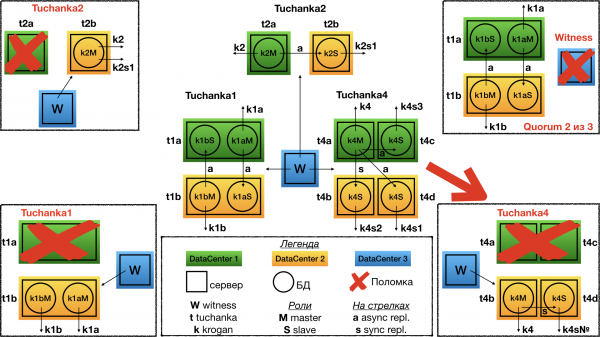
En cas de panne d'un centre de données (c'est-à-dire de deux serveurs), le témoin vote pour le second. En conséquence, dans le second centre de données, deux serveurs fonctionnent : sur l'un se trouve le master, qui reçoit l'IP flottante du master (pour les requêtes en lecture-écriture) ; et sur le second serveur, un esclave fonctionne avec une réplication synchrone, sur lequel figure l'une des IP flottantes des esclaves (pour les requêtes en lecture seule).
La première chose à noter est que tous les IP flottants des esclaves ne seront pas opérationnels, mais seulement un. Et pour travailler correctement avec celui-ci, il sera nécessaire que sql proxy tous les requêtes étaient redirigées vers le seul float IP restant ; sinon sql proxy il est possible de lister tous les float IP des esclaves dans l'URL de connexion séparés par des virgules. Dans ce cas, la connexion se fera au premier IP de travail, comme c'est configuré dans le système de test automatisé. Il est possible qu'avec d'autres bibliothèques, par exemple JDBC, cela ne fonctionne pas et que cela nécessite libpq La connexion sera établie au premier IP fonctionnel, ce qui est mis en place dans le système de tests automatisés. Il est possible que cela ne fonctionne pas avec d'autres bibliothèques, comme JDBC, et qu’un sql proxy. Cela a été réalisé car les float IP des esclaves ont l'interdiction de se lever simultanément sur un même serveur, afin qu'ils soient uniformément répartis sur les serveurs esclaves si plusieurs d'entre eux sont en fonctionnement.
Deuxièmement : même en cas de défaillance du centre de données, la réplication synchrone sera maintenue. Et même si un second échec se produit, c'est-à-dire que l'un des deux serveurs du centre de données restant tombe en panne, le cluster, bien qu'il ne fournisse plus de services, conservera néanmoins des informations sur toutes les transactions validées pour lesquelles il a donné une confirmation de commit (il n'y aura pas de perte d'informations en cas de second échec).
Tuchanka3 (3 centres de données)
Structure
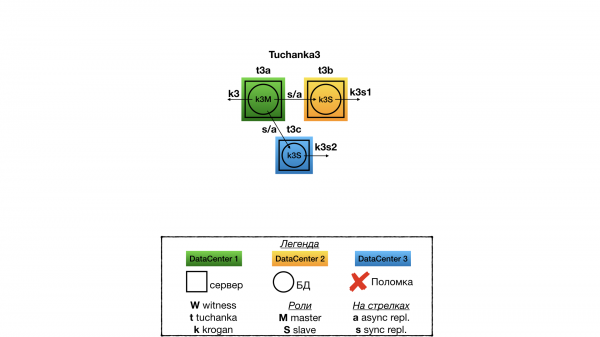
C'est un cluster pour une situation où il y a trois centres de données fonctionnels, chacun avec un serveur de base de données opérationnel. Dans ce cas quorum device n'est pas nécessaire. Dans un centre de données, fonctionne le maître, dans les deux autres - les esclaves. La réplication est synchrone, de type ANY (esclave1, esclave2), c'est-à-dire que le client recevra une confirmation de commit lorsque l'un des esclaves répondra en premier qu'il a accepté le commit. Un float IP est désigné pour le maître et deux pour les esclaves. Contrairement à Tuchanka4, tous les trois float IP sont tolérants aux pannes. Pour équilibrer les requêtes SQL en lecture seule, on peut utiliser sql proxy (avec une redondance externe), ou attribuer un float IP esclave à la moitié des clients et l'autre à l'autre moitié.
Défaillance de Tuchanka3
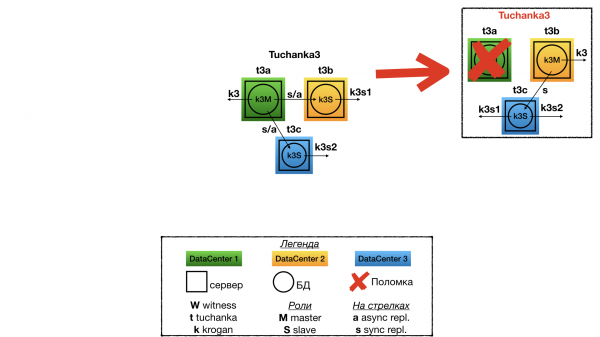
En cas de défaillance de l'un des centres de données, deux restent. Dans l'un se trouve le maître et le float IP du maître, dans l'autre - un esclave et les deux float IP esclaves (l'instance doit avoir au moins deux fois la capacité des ressources pour accepter toutes les connexions des deux float IP esclaves). Entre le maître et l'esclave, il y a une réplication synchrone. De plus, le cluster conservera des informations sur les transactions validées et confirmées (il n'y aura pas de perte d'informations) en cas de destruction de deux centres de données (s'ils sont détruits non simultanément).
Je n'ai pas inclus de description détaillée de la structure des fichiers et du déploiement. Si quelqu'un souhaite expérimenter, vous pouvez tout lire dans le README. Je ne fournis que la description du test automatique.
Système de test automatique
Pour tester la résilience des clusters en simulant diverses pannes, un système de test automatique a été créé. Il est lancé par un script. test/failure. Le script peut accepter en paramètres les numéros des clusters que vous souhaitez tester. Par exemple, cette commande :
test/failure 2 3testera uniquement le deuxième et le troisième cluster. Si aucun paramètre n'est spécifié, tous les clusters seront testés. Tous les clusters sont testés en parallèle, et le résultat est affiché dans le panneau tmux. Tmux utilise un serveur tmux dédié, il est donc possible de lancer le script à partir du tmux par défaut, ce qui donnera un tmux imbriqué. Je recommande d'utiliser le terminal dans une grande fenêtre avec une petite police. Avant de commencer les tests, toutes les machines virtuelles sont restaurées à un snapshot au moment de la fin du script. configuration.
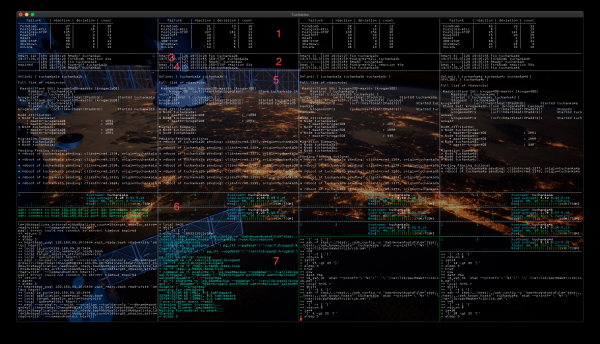
Le terminal est divisé en colonnes correspondant au nombre de clusters testés, qui est par défaut (sur la capture d'écran) quatre. Je détaillerai le contenu des colonnes à titre d'exemple pour Tuchanka2. Les panneaux sur la capture d'écran sont numérotés :
- Ici sont affichées les statistiques des tests. Colonnes :
- failure — le nom du test (fonction dans le script) qui simule une panne.
- reaction — la moyenne en secondes du temps que le cluster a mis pour retrouver sa fonctionnalité. Cela est mesuré depuis le début de l'exécution du script simulating la panne, jusqu'à ce que le cluster rétablisse sa fonctionnalité et soit capable de continuer à fournir des services. Si le temps est très court, par exemple six secondes (ce qui peut arriver dans des clusters avec plusieurs esclaves (Tuchanka3 et Tuchanka4)), cela signifie que la panne est survenue sur un esclave asynchrone et n'a pas du tout affecté la fonctionnalité, il n'y a pas eu de changement d'état du cluster.
- deviation — indique la dispersion (précision) de la valeur reaction avec la méthode de la « déviation standard ».
- count — combien de fois ce test a été effectué.
- Un journal succinct permet d'évaluer ce que le cluster fait actuellement. Il affiche le numéro d'itération (test), un horodatage et le nom de l'opération. Une durée d'exécution trop longue (> 5 minutes) indique un problème.
- heart (cœur) — temps actuel. Pour une évaluation visuelle de la performance maître dans sa table, le temps actuel est constamment enregistré en utilisant le float IP du maître. En cas de succès, le résultat est affiché dans ce panneau.
- battement (pouls) — «temps actuel», qui a été précédemment enregistré par le script heart dans le maître, est maintenant lu depuis l'esclave via son float IP. Permet d'évaluer visuellement la performance de l'esclave et la réplication. Dans Tuchanka1, il n'y a pas d'esclaves avec float IP (pas d'esclaves offrant des services), mais il y a deux instances (DB), donc ici il sera affiché que battement, et heart la deuxième instance.
- Surveillance de l'état du cluster à l'aide de l'outil
pcs mon. Montre la structure, la répartition des ressources entre les nœuds et d'autres informations utiles. - Ici, le monitoring système de chaque machine virtuelle du cluster est affiché. Il peut y avoir plusieurs panneaux — autant de machines virtuelles que le cluster. Deux graphiques Charge CPU (dans les VM avec deux processeurs), nom de la machine virtuelle, Charge système (appelé Load Average, car il est moyenné sur 5, 10 et 15 minutes), données sur les processus et répartition de la mémoire.
- Traçage du script effectuant les tests. En cas de panne — arrêt soudain ou boucle d'attente infinie — ici vous pourrez voir la raison de ce comportement.
Le test est effectué en deux étapes. D'abord, le script parcourt toutes les variétés de tests, choisissant aléatoirement la machine virtuelle à laquelle appliquer ce test. Ensuite, un cycle de test infini est exécuté, où les machines virtuelles et la panne sont choisies aléatoirement à chaque fois. L'arrêt soudain du script de test (panneau inférieur) ou une boucle d'attente infinie pour quelque chose (> 5 minutes de temps d'exécution d'une opération, visible dans le traçage) indique qu'un des tests sur ce cluster a échoué.
Chaque test est composé des opérations suivantes :
- Lancer la fonction émulant une panne.
- Prêt ? — en attente de la restauration de la performance du cluster (lorsque tous les services sont fournis).
- Affiche le temps d'attente pour la restauration du cluster (reaction).
- Réparer — le cluster est «réparé». Après quoi, il doit revenir à un état entièrement fonctionnel et prêt pour une prochaine panne.
Voici la liste des tests avec descriptions de ce qu'ils font :
- ForkBomb: crée "Out of memory" avec une fork-bomb.
- OutOfSpace: le disque dur est plein. Mais le test est plutôt symbolique, étant donné la charge insignifiante créée lors des tests, la saturation du disque dur ne provoque généralement pas de défaillance de PostgreSQL.
- Postgres-KILL: tue PostgreSQL avec la commande
killall -KILL postgres. - Postgres-STOP: suspend PostgreSQL avec la commande
killall -STOP postgres. - PowerOff: «coupe l'alimentation» de la machine virtuelle avec la commande
VBoxManage controlvm "machine virtuelle" poweroff. - Réinitialiser: redémarre la machine virtuelle avec la commande
VBoxManage controlvm "machine virtuelle" reset. - SBD-STOP: suspend le démon SBD avec la commande
killall -STOP sbd. - ShutDown: envoie une commande à la machine virtuelle via SSH
systemctl poweroff, le système termine correctement son opération. - UnLink: isolation réseau, commande
VBoxManage controlvm "machine virtuelle" setlinkstate1 off.
Fin des tests soit avec la commande standard tmux "kill-window" Ctrl-b &, soit avec la commande "detach-client" Ctrl-b d: dans ce cas, les tests se terminent, tmux se ferme, les machines virtuelles s'arrêtent.
Problèmes identifiés lors des tests
Actuellement, le démon watchdog sbd gère l'arrêt des démons observés, mais ne gère pas leur blocage. Et, par conséquent, il y a des défaillances non gérées qui entraînent uniquement des blocages Corosync et Pacemaker, mais qui ne provoquent pas de suspension sbd. Pour vérifier Corosync il existe déjà , accepté dans la branche master. Ils ont promis (dans PR#83) qu'il y aurait quelque chose de similaire pour Pacemaker, j'espère que d'ici RedHat 8 cela sera fait. Mais de telles «défaillances» sont théoriques, faciles à simuler artificiellement avec par exemple,
killall -STOP corosync, mais ne se rencontrent jamais dans la réalité.Il y a Pacemaker dans la version pour CentOS 7 le paramètre sync_timeout au quorum deviceest mal défini, ce qui entraîne , sur lequel le maître aurait dû déménager. Cela a été corrigé par augmentation sync_timeout au quorum device lors du déploiement (dans le script
setup/setup1). Ce correctif n'a pas été accepté par les développeurs Pacemaker, à la place, ils ont promis de retravailler l'infrastructure de telle manière (dans un avenir incertain), que ce délai soit calculé automatiquement.Si lors de la configuration de la base de données, il est indiqué que dans
LC_MESSAGES(messages textuels) Unicode peut être utilisé, par exemple,ru_RU.UTF-8, alors lors du démarrage postgres dans un environnement où la locale n'est pas UTF-8, par exemple, dans un environnement vide (ici pacemaker+pgsqlms(paf) démarre postgres), alors . Les développeurs de PostgreSQL n'ont pas réussi à se mettre d'accord sur la manière de traiter cette situation. Cela se contourne, il faut définirLC_MESSAGES=en_US.UTF-8lors de la configuration (création) d'une instance de base de données.Si wal_receiver_timeout est défini (par défaut à 60s), lors du test PostgreSQL-STOP sur le maître dans les clusters tuchanka3 et tuchanka4, La réplication y est synchrone, donc non seulement l'esclave, mais aussi le nouveau maître est arrêté. Cela peut être contourné en définissant wal_receiver_timeout=0 lors de la configuration de PostgreSQL.
J'ai observé de temps en temps un blocage de la réplication dans le test ForkBomb (saturation de la mémoire). Je n'ai rencontré cela que dans les clusters tuchanka3 et tuchanka4, où, en raison de la réplication synchrone, le maître se bloquait. Le problème se résolvait de lui-même après un certain temps (environ deux heures). Des recherches supplémentaires sont nécessaires pour le corriger. Les symptômes ressemblent à un ancien bug causé par une autre raison, mais avec des conséquences similaires.
L'image du krogan est prise de avec l'autorisation de l'auteur :
Source : habr.com
