

Au cours des six derniers mois, j'ai travaillé à la création d'un système de lutte contre la fraude (activités frauduleuses, fraude, etc.) sans aucune infrastructure initiale. Les idées que nous avons trouvées et mises en œuvre dans notre système nous aident aujourd'hui à détecter de nombreuses fraudes et à les analyser. Dans cet article, je voudrais aborder les principes que nous avons suivis et ce que nous avons fait pour atteindre l'état actuel de notre système, sans entrer dans les détails techniques.
Principes de notre système
Lorsque vous entendez des termes comme « automatique » et « fraude », vous commencez probablement à penser à l'apprentissage automatique, Apache Spark, Hadoop, Python, Airflow et d'autres technologies de l'écosystème Apache Foundation et du domaine de la science des données. Je pense qu'il y a un aspect de l'utilisation de ces outils qui est généralement omis : ils nécessitent des conditions préalables spécifiques dans votre système d'entreprise avant de pouvoir être utilisés. En résumé, vous avez besoin d'une plateforme de données d'entreprise qui comprend un lac de données et un entrepôt. Mais que faire si vous n'avez pas cette plateforme, et que vous devez encore développer cette pratique ? Les principes suivants, dont je parle ci-dessous, nous ont aidés à atteindre un moment où nous pouvons nous concentrer sur l'amélioration de nos idées, plutôt que sur la recherche d'une solution fonctionnelle. Cela dit, ce n'est pas un « plateau » pour le projet. De nombreuses choses restent à faire du point de vue technologique et produit.
Principe 1 : valeur commerciale avant tout
Au cœur de tous nos efforts, nous avons mis en avant la « valeur commerciale ». Dans l'ensemble, tout système d'analyse automatique appartient au groupe des systèmes complexes avec un haut niveau d'automatisation et de complexité technique. Créer une solution complète prendra beaucoup de temps si vous la concevez de zéro. Nous avons décidé de donner la priorité à la valeur commerciale, suivie par la complétude technologique. Dans la pratique, cela signifie que nous ne considérons pas les technologies de pointe comme une dogme. Nous choisissons la technologie qui fonctionne le mieux pour nous à ce moment-là. Avec le temps, il se peut que nous devions réimplémenter certains modules. C'est le compromis que nous avons accepté.
Principe 2 : Intelligence augmentée
Je parie que la plupart des gens qui ne sont pas profondément impliqués dans le développement de solutions d'apprentissage automatique peuvent penser que remplacer les humains est l'objectif. En réalité, les solutions d'apprentissage automatique sont loin d'être parfaites et le remplacement n'est possible que dans certains domaines. Nous avons abandonné cette idée dès le départ pour plusieurs raisons : des données déséquilibrées sur l'activité frauduleuse et l'impossibilité de fournir une liste exhaustive de fonctionnalités pour les modèles d'apprentissage automatique. En revanche, nous avons opté pour une alternative avec une intelligence augmentée. C'est un concept alternatif d'intelligence artificielle qui se concentre sur le rôle d'assistance de l'IA, soulignant le fait que les technologies cognitives sont destinées à améliorer l'intelligence humaine, et non à la remplacer. [1]
En tenant compte de cela, le développement d'une solution complète d'apprentissage automatique dès le départ nécessiterait un effort énorme, retardant ainsi la création de valeur pour notre entreprise. Nous avons décidé de construire un système avec un aspect d'apprentissage automatique croissant de manière itérative sous la direction de nos experts en la matière. La partie complexe du développement d'un tel système est qu'il doit fournir à nos analystes des cas non seulement en termes de savoir si c'est une activité frauduleuse ou non. En général, toute anomalie dans le comportement des clients est un cas suspect que les spécialistes doivent enquêter et répondre d'une manière ou d'une autre. Seule une partie de ces cas enregistrés peut réellement être classée comme fraude.
Principe 3 : la plateforme d'analyses approfondies
La partie la plus complexe de notre système est le contrôle des flux de travail de manière transverse. Les analystes et les développeurs doivent facilement accéder à des ensembles de données passées avec toutes les métriques utilisées pour l'analyse. De plus, la plateforme de données doit offrir un moyen simple d'ajouter de nouvelles métriques aux ensembles de données existants. Les processus que nous créons, qui ne sont pas seulement des processus logiciels, doivent permettre de recalculer facilement les périodes passées, d'ajouter de nouvelles métriques et de modifier les prévisions de données. Nous pourrions y parvenir en accumulant toutes les données générées par notre système de production. Dans ce cas, les données deviendraient progressivement une entrave. Nous devrions conserver un volume croissant de données inutilisées et les protéger. Dans un tel scénario, les données deviendraient de moins en moins pertinentes avec le temps, mais nécessiteraient néanmoins nos efforts pour leur gestion. Pour nous, l'accumulation de données n'avait pas de sens, et nous avons décidé d'adopter une autre approche. Nous avons choisi d'organiser des entrepôts de données en temps réel autour des entités cibles que nous souhaitons classifier et de ne conserver que les données permettant de vérifier les périodes les plus récentes et pertinentes. La complexité de ces efforts réside dans le fait que notre système est hétérogène, avec plusieurs entrepôts de données et modules logiciels nécessitant une planification minutieuse pour un fonctionnement cohérent.
Concepts constructifs de notre système
Nous avons quatre composants principaux dans notre système : le système d'ingestion, le système de calcul, le système d'analyse BI et le système de suivi. Chacun d'eux a un objectif isolé spécifique, et nous les maintenons isolés en suivant certaines approches de développement.
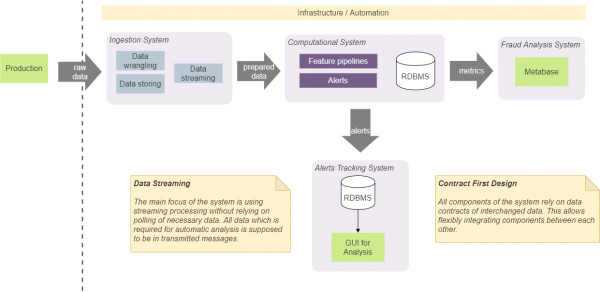
Conception basée sur des contrats
Tout d'abord, nous avons convenu que les composants devaient s'appuyer uniquement sur des structures de données spécifiques (contrats) qui leur sont transmises. Cela facilite l'intégration entre eux sans imposer une composition (et un ordre) précis des composants. Par exemple, dans certains cas, cela nous permet d'intégrer directement le système de réception avec le système de suivi des alertes. Dans ce cas, cela se fera conformément au contrat convenu pour les alertes. Cela signifie que les deux composants seront intégrés à l'aide d'un contrat qui peut être utilisé par tout autre composant. Nous ne vont pas ajouter un contrat supplémentaire pour ajouter des alertes au système de suivi depuis le système d'entrée. Une telle approche nécessite d'utiliser un nombre minimal de contrats prédéfinis et simplifie le système et les communications. En substance, nous utilisons une approche appelée « Contract First Design » et l'appliquons aux contrats de flux de données. [2]
Streaming partout
La sauvegarde et la gestion de l'état dans le système conduiront inévitablement à des complications dans sa mise en œuvre. En général, l'état doit être accessible depuis n'importe quel composant, il doit être cohérent et fournir la valeur la plus actuelle pour tous les composants, et il doit être fiable avec des valeurs correctes. De plus, la présence d'appels à un stockage permanent pour obtenir le dernier état augmentera le nombre d'opérations d'entrée-sortie et la complexité des algorithmes utilisés dans nos pipelines en temps réel. Pour cette raison, nous avons décidé d'éliminer, autant que possible, le stockage de l'état de notre système. Cette approche nécessite d'inclure toutes les données nécessaires dans le bloc de données transmis (message). Par exemple, si nous devons calculer le nombre total de certaines observations (le nombre d'opérations ou de cas ayant des caractéristiques spécifiques), nous le calculons en mémoire et générons un flux de telles valeurs. Les modules dépendants utiliseront le partitionnement et le regroupement pour scinder le flux par entités et traiter les dernières valeurs. Cette approche a éliminé la nécessité d'un stockage permanent sur disque pour de telles données. Notre système utilise Kafka comme courtier de messages, et il peut être utilisé comme base de données avec KSQL. [3] Cependant, son utilisation lierait fortement notre solution à Kafka, et nous avons décidé de ne pas l'utiliser. L'approche que nous avons choisie permet de remplacer Kafka par un autre courtier de messages sans nécessité de changements internes majeurs dans le système.
Ce concept ne signifie pas que nous n'utilisons pas de stockages sur disque et de bases de données. Pour vérifier et analyser les performances du système, nous devons stocker sur disque une partie significative des données qui représentent divers indicateurs et états. Un point important ici est que les algorithmes en temps réel ne dépendent pas de telles données. Dans la plupart des cas, nous utilisons les données sauvegardées pour une analyse autonome, le débogage et le suivi de cas spécifiques et de résultats générés par le système.
Problèmes de notre système
Il y a certains problèmes que nous avons résolus jusqu'à un certain niveau, mais ils nécessitent des solutions plus réfléchies. Pour l'instant, j'aimerais simplement les mentionner ici, car chaque point mérite un article à part entière.
- Nous devons encore définir les processus et politiques qui contribuent à l'accumulation de données significatives et pertinentes pour notre analyse automatique, la détection et l'exploration de données.
- L'intégration des résultats d'analyse par un humain dans le processus de réglage automatique du système pour sa mise à jour avec les dernières données. Cela implique non seulement la mise à jour de notre modèle, mais aussi la mise à jour des processus et l'amélioration de notre compréhension des données.
- Trouver un équilibre entre une approche déterministe IF-ELSE et le ML. Quelqu'un a dit : « Le ML est un outil pour les désespérés ». Cela signifie que vous voulez utiliser le ML lorsque vous ne comprenez plus comment optimiser et améliorer vos algorithmes. D'autre part, l'approche déterministe ne permet pas de détecter des anomalies qui n'ont pas été anticipées.
- Nous avons besoin d'un moyen simple de vérifier nos hypothèses ou corrélations entre les métriques des données.
- Le système doit avoir plusieurs niveaux de résultats vrais positifs. Les cas de fraude ne représentent qu'une partie de tous les cas qui peuvent être considérés comme positifs pour le système. Par exemple, les analystes veulent recevoir tous les cas suspects pour vérification, et seule une petite partie d'entre eux est une fraude. Le système doit fournir efficacement à ces analystes tous les cas, qu'il s'agisse de fraude réelle ou simplement d'un comportement suspect.
- La plateforme de données doit permettre d'obtenir des ensembles de données pour des périodes passées avec des calculs créés et calculés à la volée.
- Le déploiement simple et automatique de l'un des composants du système dans au moins trois environnements différents : de production, expérimental (bêta) et pour les développeurs.
- Et enfin, mais non des moindres, nous devons créer une vaste plateforme de vérification des performances, sur laquelle nous pourrons analyser nos modèles. [4]
Liens
Source : habr.com
