

Nous avons pensé à la création d'un système de surveillance lors de la formation des équipes produit. Il est devenu clair que notre domaine — l'exploitation — n'entre pas du tout dans ces équipes. Pourquoi ?
Le fait est que toutes nos équipes sont construites autour de systèmes d'information distincts, de microservices et de frontaux, donc elles ne voient pas l'état général de toute la santé du système. Par exemple, elles peuvent ne pas savoir comment une petite partie dans un back-end profond influence la partie frontale. Leur champ d’intérêt est limité aux systèmes avec lesquels leur système est intégré. Si une équipe et son service A ne sont presque pas liés au service B, alors ce service est pratiquement invisible pour l'équipe.
Notre équipe, pour sa part, travaille avec des systèmes qui sont fortement intégrés les uns aux autres : il existe de nombreuses connexions entre eux, c'est une infrastructure assez vaste. Et le bon fonctionnement de toutes ces systèmes (dont nous avons, soit dit en passant, un nombre considérable) dépend du fonctionnement de la boutique en ligne.
Ainsi, notre département ne fait partie d'aucune équipe, mais se situe un peu à l'écart. Dans toute cette histoire, notre tâche est de comprendre dans son ensemble comment fonctionnent les systèmes d'information, leur fonctionnalité, leurs intégrations, les logiciels, le réseau, le matériel, et comment tout cela est interconnecté.
La plateforme sur laquelle fonctionnent nos boutiques en ligne se présente comme suit :
- front
- middle-office
- back-office
Quoique nous le souhaitions, il n'existe pas de situation où tous les systèmes fonctionnent de manière fluide et impeccable. C'est, encore une fois, dû au nombre de systèmes et d'intégrations : dans notre cas, certains incidents sont inévitables, malgré la qualité des tests. Notamment à la fois à l'intérieur d'un système particulier et en ce qui concerne leur intégration. Il est nécessaire de surveiller l'état de l'ensemble de la plateforme de manière globale, et non pas seulement d'une partie séparée.
Idéalement, la surveillance de la santé de l'ensemble de la plateforme doit être automatisée. Nous en sommes donc arrivés à la surveillance comme étant une partie inévitable de ce processus. Au départ, elle était construite uniquement pour la partie frontale, tandis que des systèmes de surveillance propres par couches existent et existent chez les réseaux, les administrateurs logiciels et matériels. Tous ces acteurs ne suivaient la surveillance qu'à leur niveau, sans avoir une compréhension globale.
Par exemple, si une machine virtuelle tombe, dans la plupart des cas, seul l'administrateur responsable du matériel et de la machine virtuelle en est informé. L'équipe frontale a seulement remarqué que l'application était tombée, mais n'avait pas d'informations sur l'échec de la machine virtuelle. L'administrateur peut savoir qui est le client et avoir une idée de ce qui tourne actuellement sur cette machine virtuelle, à condition qu'il s'agisse d'un projet important. Pour les projets plus petits, il ne le sait probablement pas. Quoi qu'il en soit, l'administrateur doit se rendre chez le propriétaire, demander ce qui se passait sur cette machine, ce qui doit être restauré et ce qui doit être changé. Et si quelque chose de vraiment sérieux se casse, cela commence à tourner en rond — car personne ne voit le système dans son ensemble.
En fin de compte, de telles histoires éparpillées affectent l'ensemble du front-end, les utilisateurs et notre fonction commerciale principale — les ventes en ligne. Comme nous ne faisons pas partie des équipes et nous occupons de l'exploitation de toutes les applications e-commerce au sein du magasin en ligne, nous avons pris en charge la création d'un système de surveillance complet de la plateforme e-commerce.
La structure du système et la pile
Nous avons commencé par distinguer plusieurs couches de surveillance pour nos systèmes, à travers lesquelles nous devrons collecter des métriques. Et tout cela devait être intégré, ce que nous avons fait à la première étape. À présent, à ce stade, nous travaillons sur la collecte des métriques de la plus haute qualité à travers toutes nos couches, afin d'établir une corrélation et de comprendre comment les systèmes s'influencent mutuellement.
L'absence de surveillance intégrée aux premières étapes du lancement des applications (puisque nous avons commencé à la construire lorsque la plupart des systèmes étaient déjà en exploitation) a entraîné un endettement technique important en ce qui concerne la configuration de la surveillance de l'ensemble de la plateforme. Nous ne pouvions pas nous permettre de nous concentrer sur la configuration de la surveillance d'un seul SI et d'en développer les détails, car les autres systèmes resteraient sans surveillance pendant un certain temps. Pour résoudre ce problème, nous avons déterminé une liste des métriques les plus essentielles pour évaluer l'état du système d'information par couches et avons commencé à les implémenter.
C'est pourquoi nous avons décidé de manger l'éléphant morceau par morceau.
Notre système se compose de :
- matériel ;
- système d'exploitation ;
- logiciel ;
- Composants d'interface dans l'application de surveillance;
- métriques commerciales;
- applications d'intégration;
- sécurité de l'information;
- réseau;
- équilibreur de charge.
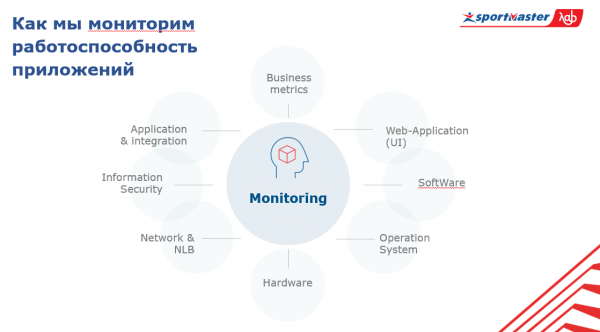
Au cœur de ce système se trouve la surveillance elle-même. Pour avoir une vue d'ensemble de l'état de l'ensemble du système, il est nécessaire de savoir ce qui se passe avec les applications à tous ces niveaux et à travers l'ensemble des nombreuses applications.
Donc, parlons de la pile.
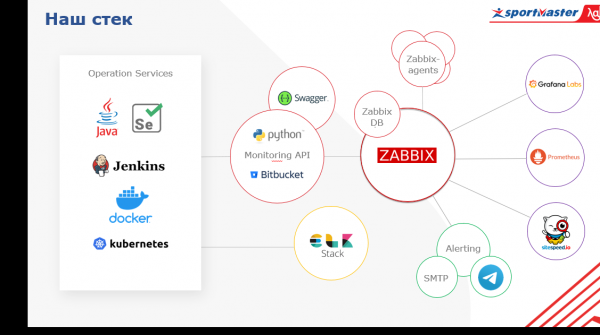
Nous utilisons des logiciels open source. Au centre, nous avons Zabbix, que nous utilisons principalement comme système d'alerte. Tout le monde sait qu'il est parfait pour surveiller l'infrastructure. Que signifie-t-on ici ? Cela concerne précisément les métriques de bas niveau que possède chaque entreprise ayant son propre centre de données (et Sportmaster a ses propres centres de données) — température du serveur, état de la mémoire, RAID, métriques des équipements réseau.
Nous avons intégré Zabbix avec la messagerie Telegram et Microsoft Teams, largement utilisées dans les équipes. Zabbix couvre le niveau du réseau réel, du matériel et partiellement du logiciel, mais ce n'est pas une panacée. Nous enrichissons ces données avec certains autres services. Par exemple, au niveau du matériel, nous nous connectons directement via API dans notre système de virtualisation et récupérons les données.
En outre, en plus de Zabbix, nous utilisons Prometheus, qui permet de surveiller les métriques dans des applications en environnement dynamique. Cela signifie que nous pouvons obtenir des métriques de l'application via un point de terminaison HTTP et ne pas nous soucier de quelles métriques charger ou non. Sur la base de ces données, nous pouvons élaborer des requêtes analytiques.
Les sources de données pour les autres couches, par exemple, les métriques commerciales, se divisent en trois composantes.
Tout d'abord, ce sont des systèmes commerciaux externes, Google Analytics, nous collectons des métriques à partir des journaux. De là, nous obtenons des données sur les utilisateurs actifs, les conversions et tout ce qui est lié aux affaires. Deuxièmement, c'est le système de surveillance de l'interface utilisateur. Il convient d'en parler plus en détail.
Nous avons commencé par des tests manuels et cela a évolué vers des tests automatisés de fonctionnalités et d'intégrations. C'est à partir de cela que nous avons mis en place la surveillance, en ne conservant que les fonctionnalités principales et en nous appuyant sur des marqueurs qui sont aussi stables que possible et ne changent pas souvent avec le temps.
La nouvelle structure des équipes implique que toutes les activités liées aux applications reposent sur des équipes produits, donc nous avons cessé de nous concentrer uniquement sur les tests. À la place, nous avons transformé les tests en surveillance de l'interface utilisateur, développée en Java, Selenium et Jenkins (utilisé comme système de lancement et de génération de rapports).
Nous avions beaucoup de tests, mais finalement, nous avons décidé de nous concentrer sur les métriques globales. Et s'il y avait trop de tests spécifiques, il serait difficile de maintenir l'actualité des données. Chaque nouvelle version risquerait de casser tout le système, et nous ne ferions que le réparer. C'est pourquoi nous nous sommes concentrés sur des éléments vraiment fondamentaux qui changent peu, et nous surveillons seulement ceux-ci.
Enfin, en troisième lieu, la source des données est un système de journalisation centralisé. Pour les journaux, nous utilisons Elastic Stack, et ensuite nous pouvons intégrer ces données dans notre système de surveillance des métriques commerciales. De plus, notre propre service Monitoring API, développé en Python, interroge les services via API et récupère les données dans Zabbix.
Un autre attribut incontournable de la surveillance est la visualisation. La nôtre est construite sur Grafana. Parmi d'autres systèmes de visualisation, elle se distingue par le fait qu'il est possible de visualiser des métriques provenant de différentes sources de données sur le tableau de bord. Nous pouvons rassembler des métriques globales d'une boutique en ligne, par exemple, le nombre de commandes passées ces dernières heures, provenant de la base de données, des métriques de performance du système d'exploitation sur lequel la boutique en ligne fonctionne, venant de Zabbix, ainsi que des métriques des instances de cette application, provenant de Prometheus. Et tout cela sera sur un seul tableau de bord. Clair et accessible.
Je soulignerai la sécurité : nous sommes actuellement en train de peaufiner un système que nous allons par la suite intégrer à un système de surveillance global. À mon avis, les principaux problèmes auxquels le e-commerce est confronté dans le domaine de la sécurité de l'information sont liés aux bots, aux parseurs et aux attaques par force brute. Il est crucial de surveiller cela, car cela peut avoir un impact critique tant sur le fonctionnement de nos applications que sur notre réputation d'un point de vue commercial. Avec la pile choisie, nous couvons ces problématiques avec succès.
Un autre point important est que le niveau des applications est collecté par Prometheus. Ce dernier est également intégré à Zabbix. De plus, nous utilisons sitespeed, un service qui nous permet de surveiller des paramètres tels que la vitesse de chargement de notre page, les goulets d'étranglement, le rendu de la page, le chargement des scripts, etc. Ce service est aussi intégré par API. Ainsi, nos métriques sont collectées dans Zabbix, et nous y recevons également des alertes. Tous les alertes sont actuellement envoyées par les méthodes principales (pour l'instant, il s'agit de l'email et de Telegram, nous avons également récemment connecté MS Teams). Nous prévoyons d'améliorer l'alerte pour qu'elle fonctionne avec des bots intelligents comme service, fournissant des informations de surveillance à toutes les équipes produit intéressées.
Pour nous, il est important d'avoir des métriques non seulement pour les systèmes d'information individuels, mais aussi des métriques globales sur toute l'infrastructure utilisée par les applications : clusters serveurs physiques, sur lesquels tournent des machines virtuelles, des équilibrateurs de charge, des Network Load Balancers, le réseau lui-même, et l'utilisation des canaux de communication. De plus, nous avons des métriques concernant nos propres data centers (nous en avons plusieurs et l'infrastructure est de taille considérable).
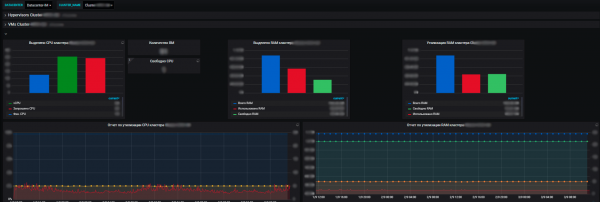
Les avantages de notre système de surveillance sont qu'il nous permet de voir l'état de fonctionnement de tous les systèmes, d'évaluer leur impact les uns sur les autres et sur les ressources communes. En fin de compte, cela nous permet de planifier les ressources, ce qui fait également partie de notre responsabilité. Nous gérons les ressources serveur — un pool dans le cadre de l'e-commerce, nous mettons en service et retirons du service de nouveaux équipements, nous achetons du matériel supplémentaire, réalisons un audit de l'utilisation des ressources, etc. Chaque année, les équipes planifient de nouveaux projets, développent leurs systèmes, et il est important pour nous de leur fournir des ressources.
Et grâce aux métriques, nous pouvons voir la tendance de la consommation des ressources par nos systèmes d'information. Nous pouvons déjà planifier certaines choses sur cette base. Au niveau de la virtualisation, nous collectons des données et voyons les informations sur la quantité de ressources disponibles par data center. À l'intérieur du data center, nous pouvons voir à la fois l'utilisation et la répartition réelle, la consommation des ressources. Cela concerne aussi bien des serveurs standalone que des machines virtuelles et des clusters de serveurs physiques, sur lesquels toutes ces machines virtuelles fonctionnent efficacement.
Perspectives
Nous avons actuellement le noyau du système prêt dans son ensemble, mais il reste encore suffisamment d'éléments sur lesquels nous devons travailler. Au minimum, il s'agit de la couche de sécurité de l'information, mais il est également important d'accéder au réseau, de développer l'alerte et de résoudre le problème de la corrélation. Nous avons de nombreuses couches et systèmes, avec encore de nombreuses métriques à chaque couche. Cela ressemble à une matriochka à la puissance d'une matriochka.
Notre objectif est, en fin de compte, de créer des alertes pertinentes. Par exemple, si un problème se produit avec la partie matérielle, encore une fois, avec la machine virtuelle, et qu'il y avait une application importante, et que le service n'était pas du tout redondant. Nous découvrirons que la machine virtuelle est tombée en panne. Ensuite, les métriques commerciales commenceront à alerter : les utilisateurs ont disparu, il n'y a pas de conversions, l'interface UI n'est pas disponible, les logiciels et services sont également tombés.
Avec un tel scénario, nous obtiendrons du spam d'alertes, ce qui ne correspond pas au format d'un bon système de surveillance. La question de la corrélation se pose. Par conséquent, idéalement, notre système de surveillance devrait dire : « Les gars, votre machine physique est tombée, et avec elle, cette application et ces métriques », à l'aide d'une seule alerte au lieu de nous inonder de centaines d'alertes. Il doit signaler l'essentiel - la cause, ce qui favorise la rapidité de résolution du problème grâce à sa localité.
Notre système d'alerte et le traitement des alertes sont construits autour d'un service d'assistance téléphonique disponible 24 heures sur 24. Toutes les alertes que nous considérons comme essentielles et qui figurent sur notre liste de contrôle y sont transmises. Chaque alerte doit obligatoirement comporter une description : ce qui s'est passé, ce que cela signifie en réalité, sur quoi cela a un impact. Et aussi un lien vers le tableau de bord et des instructions sur ce qu'il faut faire dans ce cas.
Voilà pour les exigences en matière de construction d'alerte. Ensuite, la situation peut évoluer dans deux directions : soit il y a un problème et il doit être résolu, soit il y a eu une panne dans le système de surveillance. Quoi qu'il en soit, il faut y aller et comprendre ce qui se passe.
En moyenne, nous recevons actuellement environ une centaine d'alertes par jour, cela en tenant compte du fait que la corrélation des alertes n'est pas encore correctement configurée. Et si des travaux techniques doivent être effectués et que nous devons désactiver quelque chose de manière forcée, leur nombre augmente de plusieurs fois.
En plus de surveiller les systèmes que nous exploitons et de collecter des métriques que nous considérons comme importantes, le système de surveillance permet de collecter des données pour les équipes produits. Elles peuvent influencer la composition des métriques dans les systèmes d'information que nous surveillons.
Un de nos collègues peut venir et demander d'ajouter une métrique qui pourrait être utile à la fois pour nous et pour l'équipe. Ou, par exemple, l'équipe peut estimer que les métriques de base que nous avons ne sont pas suffisantes et qu'elle doit suivre quelque chose de spécifique. Dans Grafana, nous créons un espace pour chaque équipe et donnons des droits d'administrateur. De plus, si l'équipe a besoin de tableaux de bord mais ne sait pas comment les créer, nous les aidons.
Comme nous sommes en dehors du flux de création de valeur de l'équipe, de ses versions et de sa planification, nous finissons par arriver à ce que les versions de tous les systèmes soient sans couture et puissent être déployées quotidiennement sans nécessiter notre approbation. Et il est important pour nous de suivre ces versions, car elles peuvent potentiellement affecter le fonctionnement de l'application et causer des dysfonctionnements, ce qui est critique. Pour la gestion des versions, nous utilisons Bamboo, d'où nous obtenons des données via l'API et pouvons voir quelles versions sont sorties et leur statut dans quels systèmes d'information. Et le plus important — à quel moment. Nous superposons les marqueurs de versions sur les métriques critiques, ce qui est visuellement très révélateur en cas de problème.
Ainsi, nous pouvons voir la corrélation entre les nouvelles versions et les problèmes qui surviennent. L'idée principale est de comprendre comment le système fonctionne à tous les niveaux, de localiser rapidement le problème et de le corriger rapidement. Car il est souvent vrai que le plus de temps est dépensé non pas à résoudre le problème, mais à en trouver la cause.
À l'avenir, nous souhaitons nous concentrer sur la proactivité dans ce domaine. Idéalement, nous aimerions être informés à l'avance d'un problème imminent, plutôt que de le découvrir après coup, afin de pouvoir en prévenir l'apparition plutôt que de devoir le résoudre. Il arrive parfois que le système de surveillance déclenche de fausses alertes, qu'il s'agisse d'une erreur humaine ou de modifications apportées à l'application. Nous travaillons sur cela, nous ajustons le système, et nous essayons d'avertir les utilisateurs qui l'utilisent avec nous avant toute manipulation du système de surveillance, ou de mener ces opérations pendant les fenêtres techniques.
Ainsi, le système a été lancé et fonctionne avec succès depuis le début du printemps… et génère des profits tout à fait réels. Bien sûr, ce n'est pas sa version finale, nous allons encore intégrer de nombreuses fonctionnalités utiles. Mais pour le moment, avec un si grand nombre d'intégrations et d'applications, l'automatisation de la surveillance est en réalité indispensable.
Si vous surveillez également de grands projets avec un nombre important d'intégrations, n'hésitez pas à écrire dans les commentaires quelle solution miracle vous avez trouvée pour cela.
Source : habr.com
