

Discutons pourquoi les outils CI et CI sont en réalité deux choses différentes.
Quel problème CI cherche-t-il à résoudre, d'où vient l'idée, quelles sont les dernières validations prouvant son efficacité, comment savoir si vous appliquez réellement une pratique et non juste un Jenkins installé.
L'idée de faire une présentation sur l'intégration continue est née il y a un an, lorsque je passais des entretiens de recherche d'emploi. J'ai discuté avec 10-15 entreprises, et une seule a pu répondre clairement à ce qu'est le CI et expliquer comment elles ont compris qu'elles n'en avaient pas. Les autres disaient des absurdités incompréhensibles sur Jenkins 🙂 Eh bien, nous avons Jenkins, il fait des builds, donc c'est du CI ! Dans ma présentation, je vais essayer d'expliquer ce qu'est réellement l'intégration continue et pourquoi Jenkins et des outils similaires ont une relation très limitée avec cela.
Alors, qu'est-ce qui vient généralement à l'esprit lorsque l'on évoque le CI ? La plupart des gens penseront à Jenkins, Gitlab CI, Travis, etc.
Même si nous faisons une recherche sur Google, ces outils nous seront présentés.
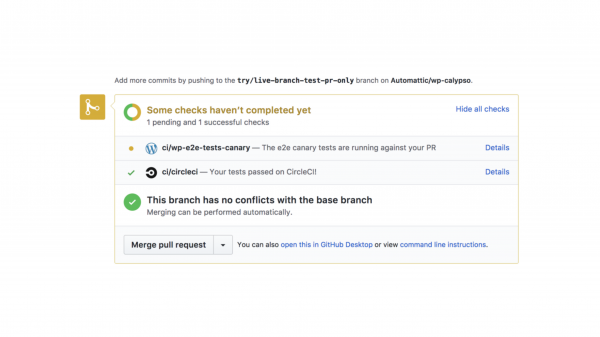
Si vous demandez aux personnes qui s'y connaissent, dès qu'elles énumèrent les outils, elles vous diront que le CI est lorsque, dans une Pull Request pour un commit, une build est effectuée et que des tests sont exécutés.
L'intégration continue, ce n'est pas une question d'outils, ni de builds avec des tests dans une branche ! L'intégration continue est une pratique d'intégration très fréquente de nouveau code et pour l'appliquer, il n'est pas du tout nécessaire de se lancer dans des Jenkins, des GitLabs, etc.
Avant de comprendre à quoi ressemble un CI complet, plongeons d'abord dans le contexte des personnes qui l'ont inventé et ressentons la douleur qu'elles ont tenté de résoudre.
Et ils ont cherché à résoudre la douleur du travail d'équipe !
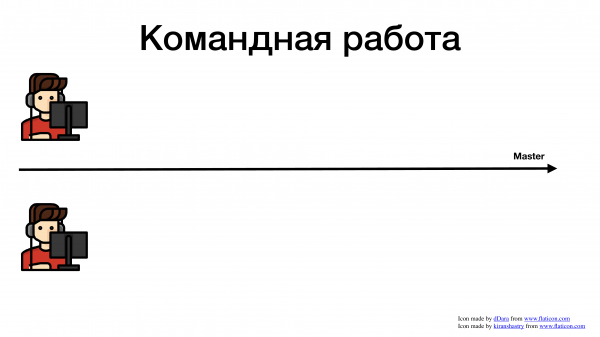
Regardons des exemples des difficultés rencontrées par les développeurs lors du développement en équipe. Nous avons un projet, une branche master dans git et deux développeurs.
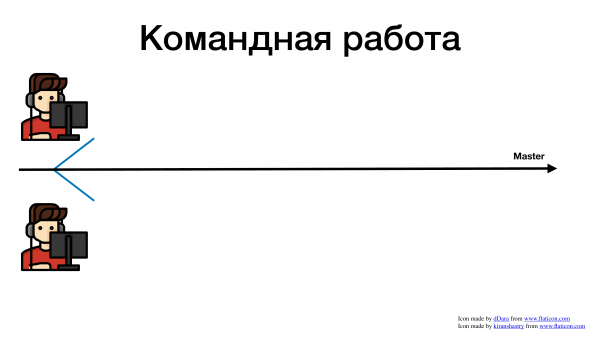
Et ils ont commencé à travailler comme tout le monde en a l'habitude. Ils ont pris une tâche dans JIRA, créé une branche feature et ont commencé à écrire du code.
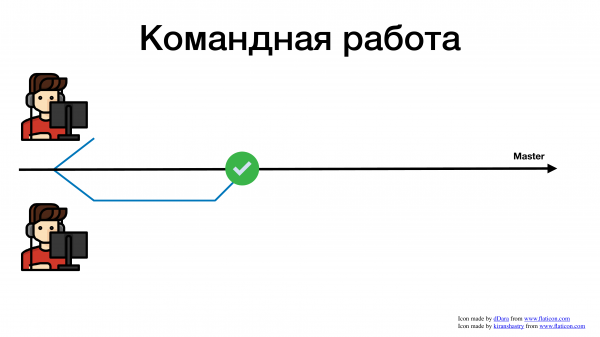
L'un a terminé sa fonctionnalité plus rapidement et l'a fusionnée dans master.
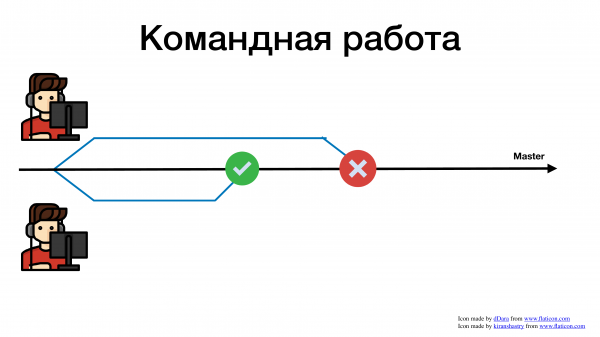
Le second a besoin de plus de temps, il a fusionné plus tard et a rencontré un conflit. Maintenant, au lieu d'écrire les fonctionnalités nécessaires au business, le développeur consacre son temps et ses efforts à résoudre des conflits.
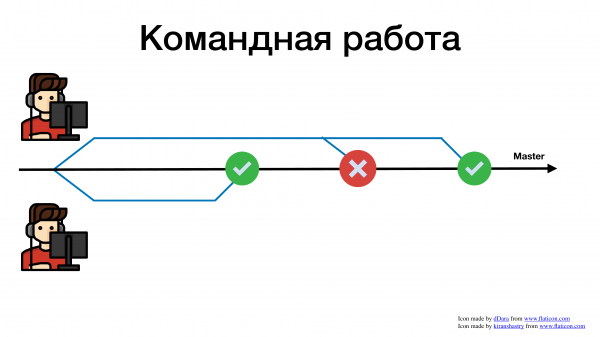
Plus il est difficile d'intégrer votre fonctionnalité dans le master, plus nous perdons de temps. Et c'est un exemple assez simple que j'ai présenté. C'est un cas où il n'y a que 2 développeurs. Imaginez maintenant si 10, 15 ou 100 personnes dans l'entreprise écrivent dans le même dépôt. Vous perdrez la tête à résoudre tous ces conflits.
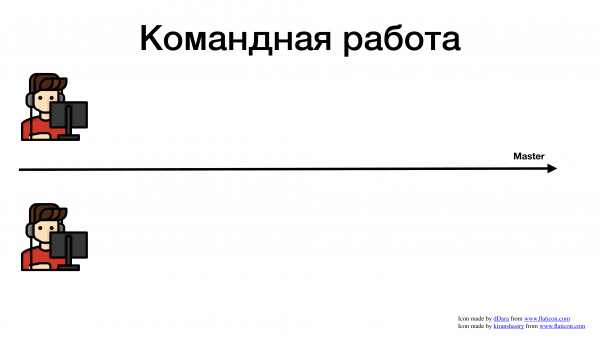
Il y a un autre cas légèrement différent. Nous avons un master et plusieurs développeurs qui travaillent sur quelque chose.
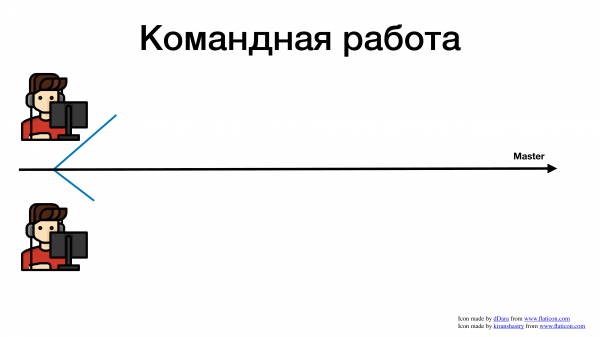
Ils ont créé une branche chacun.
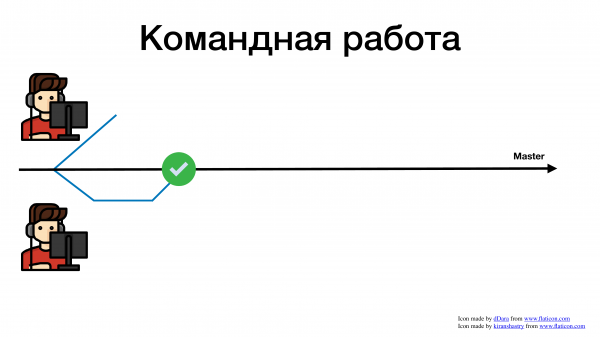
L'un d'eux a fait un merge, tout va bien, il a terminé sa tâche.
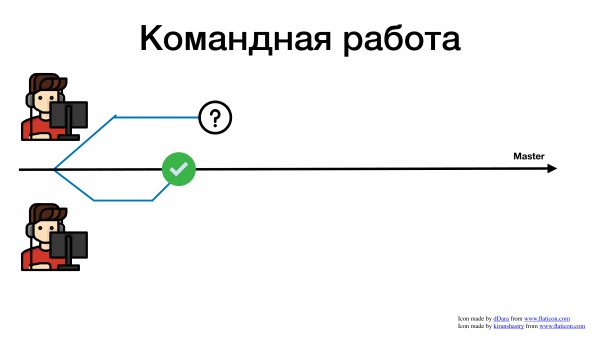
Entre-temps, le deuxième développeur a également terminé sa tâche. Supposons qu'il l'a soumise pour révision. Dans de nombreuses entreprises, il y a cette pratique de la révision. D'une part, c'est une bonne et utile pratique, d'autre part, cela nous ralentit souvent. Nous ne plongerons pas dans ce sujet, mais voici un excellent exemple de ce à quoi peut conduire une histoire tortueuse de révision. Vous avez soumis une demande de tirage pour révision. Le développeur n'a plus rien à faire. Que commence-t-il à faire ? Il commence à prendre d'autres tâches.
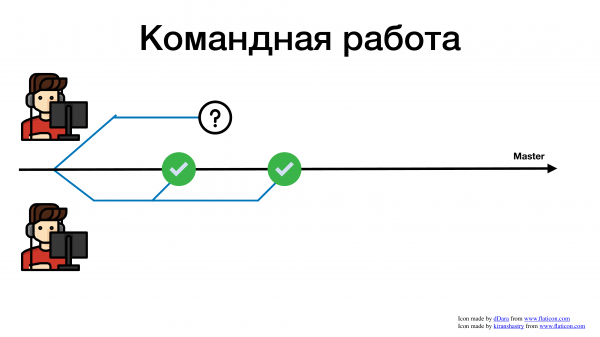
Pendant ce temps, le deuxième développeur a également travaillé sur autre chose.
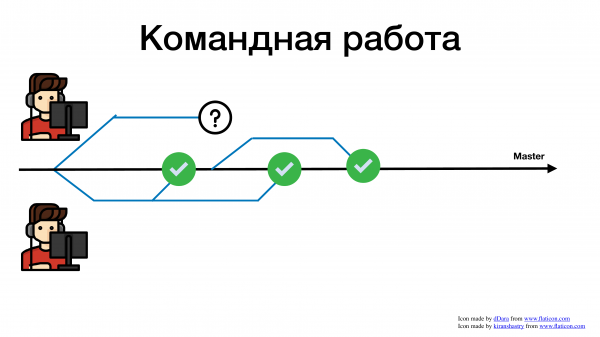
Le premier a terminé une troisième tâche.
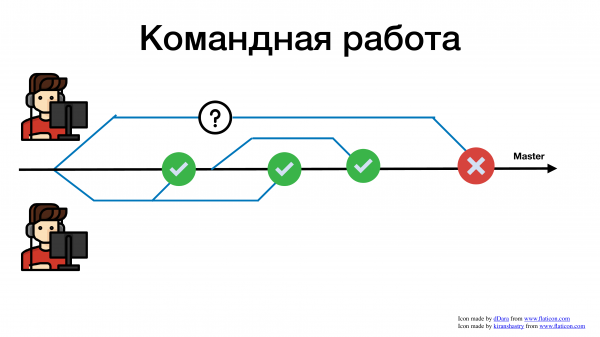
Et après un certain temps, sa révision a été approuvée, et il essaie de faire un merge. Et que se passe-t-il ? Il rencontre un grand nombre de conflits. Pourquoi ? Parce que pendant que sa demande de tirage était en révision, beaucoup de choses ont déjà changé dans le code.
En plus de cette histoire de conflits, il y a une question de communication. Tant que votre branche est en révision, tant qu'elle attend quelque chose, tant que vous peinez à terminer la fonctionnalité, vous cessez de suivre les changements dans la base de code de votre service. Peut-être que ce que vous essayez de résoudre maintenant a déjà été résolu hier, et vous pourriez réutiliser une méthode. Mais vous ne le verrez pas, car vous travaillez toujours avec une branche obsolète. Et cette branche obsolète conduit toujours à devoir résoudre des conflits de merge.
Ainsi, si nous travaillons en équipe, c'est-à-dire que ce n'est pas une seule personne qui fouille dans le dépôt, mais 5 à 10 personnes, alors plus nous tardons à ajouter notre code dans le master, plus nous souffrons du fait qu'à la fin, quelque chose doit être fusionné. Plus nous avons de conflits, et plus nous travaillons avec une version ancienne, plus nous aurons de problèmes.
Faire quelque chose ensemble, c'est douloureux ! Nous nous gênerons toujours les uns les autres.
Ce problème a été soulevé il y a plus de 20 ans. La première mention de la pratique de l'Intégration Continue que j'ai trouvée se situe dans le cadre de la programmation extrême.
La programmation extrême est le premier cadre agile. La page est apparue en 1996. L'idée était d'utiliser certaines pratiques de programmation, de planification et d'autres, afin que le développement soit le plus flexible possible, pour que nous puissions réagir plus rapidement à des changements ou aux exigences de nos clients. Ils ont commencé à s'en rendre compte il y a 24 ans, que si vous faites quelque chose pendant longtemps et à l'écart, vous y passez plus de temps à cause des conflits.
Maintenant, nous allons analyser le terme « Intégration Continue » mot par mot. Si l'on traduit littéralement, cela donne une intégration continue. Mais à quel point est-elle continue n'est pas très clair, elle est en réalité plutôt intermittente. Et dans quelle mesure l'intégration est-elle évidente également ?
C'est pourquoi je vous présente maintenant des citations de la programmation extrême. Nous allons examiner les deux mots séparément.
Intégration — Comme je l'ai déjà dit, nous visons à ce que chaque ingénieur travaille avec la version de code la plus récente, afin qu'il tente d'ajouter son code aussi souvent que possible dans la branche principale, pour que ce soient de petites branches. Parce que si elles sont grandes, nous pouvons facilement rester bloqués pendant une semaine à cause des conflits de fusion. Surtout si nous avons un cycle de développement long, comme le modèle en cascade, où le développeur parts pendant un mois pour réaliser une grande fonctionnalité. Et il peut se retrouver bloqué longtemps au stade de l'intégration.
L'intégration, c'est quand nous prenons notre branche et l'intégrons avec la branche principale, nous la fusionnons. Il existe une version ultime où nous développons en faisant directement des commits dans la branche principale sans créer de branches supplémentaires.
En résumé, l'intégration consiste à prendre son code et à le fusionner dans la branche principale.
Que signifie le mot « continu », qu'est-ce qui est appelé continuité ? La pratique implique que le développeur cherche à intégrer son code le plus rapidement possible. C'est son objectif lors de l'exécution de toute tâche : faire en sorte que son code apparaisse dans la branche principale le plus vite possible. Dans un monde idéal, les développeurs feraient cela toutes les quelques heures. C'est-à-dire que vous prenez une petite tâche, vous la fusionnez dans la branche principale. Tout va bien. Vous aspirez à cela. Et vous devez le faire de manière continue. Dès que vous avez fait quelque chose, vous l'intégrez immédiatement dans la branche principale.
Et le développeur qui fait quelque chose est responsable de ce qu'il a fait pour que cela fonctionne et ne casse rien. C'est ici qu'apparaît généralement l'histoire des tests. Nous voulons exécuter certains tests sur notre engagement, sur notre fusion, pour nous assurer que cela fonctionne. Et c'est ici que Jenkins peut vraiment vous aider.
Mais concernant les histoires : faisons en sorte que les changements soient petits, que les tâches soient petites, et essayons de fusionner la tâche dans la branche principale immédiatement – c'est là que Jenkins ne vous aidera pas. Parce que Jenkins ne vous aidera qu'à exécuter les tests.
Vous pouvez vous en passer. Cela ne vous dérangera absolument pas. Parce que l'objectif de la pratique est de se fusionner le plus souvent possible, afin de ne pas perdre beaucoup de temps sur des conflits futurs.
Imaginons que nous sommes en 2020, pour une raison quelconque, sans Internet. Et nous travaillons localement. Nous n'avons pas Jenkins. C'est normal. Vous pouvez tout de même créer une branche locale. Vous y avez écrit du code. Vous avez réalisé une tâche en 3-4 heures. Vous passez à la branche principale, faites un git pull, fusionnez votre branche. C'est fait. Si vous faites cela souvent – félicitations, vous avez l'Intégration Continue !
Quelles sont les preuves dans le monde moderne indiquant que cela vaut la peine de dépenser des efforts ? Parce qu'en général, c'est compliqué. Si vous essayez de travailler ainsi, vous comprendrez que vous devez traiter une certaine planification, vous passerez plus de temps à décomposer les tâches. Parce que si vous faites man..., vous ne pourrez pas fusionner rapidement et, par conséquent, vous vous retrouverez dans l'embarras. Vous n'aurez plus de pratique.
Et cela va coûter cher. Il ne sera pas possible de travailler avec l'intégration continue dès demain. Vous allez tous mettre beaucoup de temps à vous habituer, beaucoup de temps à apprendre à décomposer les tâches, beaucoup de temps à vous habituer à revoir votre pratique de révision, si vous en avez une. Parce que notre objectif est que cela soit fusionné aujourd'hui. Et si vous passez trois jours à faire une révision, alors vous avez des problèmes et l'intégration continue ne fonctionne pas.
Mais avons-nous des preuves concrètes en ce moment qui nous disent qu'il est judicieux d'investir dans cette pratique ?
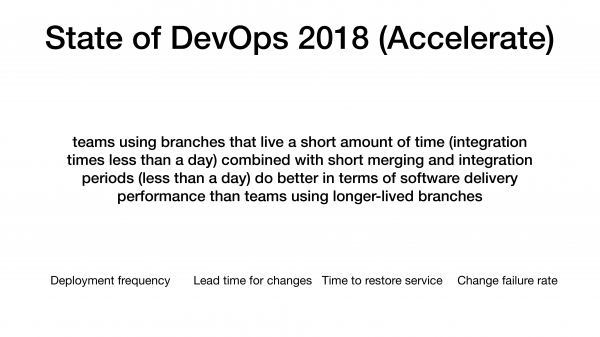
La première chose qui m'est venue à l'esprit est l'État du DevOps. C'est une étude que les gars réalisent depuis 7 ans. Ils le font maintenant en tant qu'organisation indépendante, mais sous Google.
Et leur étude de 2018 a montré une corrélation entre les entreprises qui essaient d'utiliser des branches à courte durée de vie, qui s'intègrent rapidement, qui s'intègrent fréquemment, elles ont de bien meilleurs indicateurs de performance IT.
Quels sont ces indicateurs ? Ce sont 4 métriques qu'ils recueillent auprès de toutes les entreprises dans leurs sondages : fréquence de déploiement, délai pour les changements, temps de restauration du service, taux d'échec des changements.
Et tout d'abord, il y a cette corrélation, nous savons que les entreprises qui fusionnent souvent ont des métriques bien meilleures. Et ils classifient les entreprises en plusieurs catégories : les entreprises lentes, qui produisent lentement, les performers moyens, les performers élevés et l'élite. L'élite comprend Netflix, Amazon, qui sont très rapides, font tout rapidement, avec élégance et qualité.
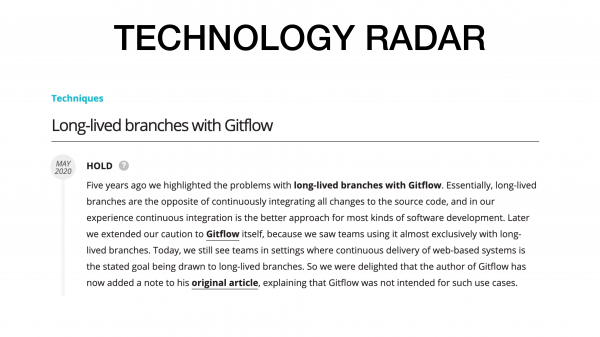
Une autre histoire, qui s'est produite il y a à peine un mois. Le Technology Radar a publié un excellent article sur Gitflow. Gitflow se distingue des autres en ce sens que ses branches vivent longtemps. Il y a des branches de version qui vivent longtemps, des branches de fonctionnalités qui vivent également longtemps. Cette pratique a été placée en HOLD dans le Technology Radar. Pourquoi ? Parce que les gens rencontrent des difficultés d'intégration.
Si votre branche vit très longtemps, elle commence à prendre du retard, nous commençons à passer plus de temps à y apporter un changement.
Récemment, l'auteur de Gitflow a déclaré que si vous aspirez à l'intégration continue, si vous souhaitez effectuer des mises à jour aussi souvent que possible, alors Gitflow est une mauvaise idée. Il a également mentionné dans un article séparé que si vous avez un backend où vous pouvez faire cela, Gitflow est superflu pour vous, car il vous ralentira et causera des problèmes d'intégration.
Cela ne signifie pas que Gitflow est mauvais et qu'il ne faut pas l'utiliser. Il est adapté à d'autres cas. Par exemple, lorsque vous devez maintenir plusieurs versions d'un service ou d'une application, c'est-à-dire lorsque vous devez fournir un support sur une période prolongée.
Mais si vous parlez à des personnes qui maintiennent de tels services, vous entendrez beaucoup de plaintes sur le fait que cette version était 3.2, qui a été publiée il y a 4 mois, et que ce correctif n'y figurait pas, et maintenant, pour l'intégrer, il faut apporter beaucoup de modifications. Et les voilà de nouveau bloqués, et ils passent une semaine à essayer de fusionner une nouvelle fonctionnalité.
Comme Alexander Kovalev l'a justement noté dans le chat, la corrélation n'est pas équivalente à la causalité. C'est vrai. C'est-à-dire qu'il n'y a pas de lien direct selon lequel si vous avez une intégration continue, alors toutes les métriques seront excellentes, non. Mais il existe une corrélation positive, c'est-à-dire que si l'un est vrai, l'autre est probablement également vrai. Ce n'est pas un fait, mais c'est fort probable. Ce n'est qu'une corrélation.
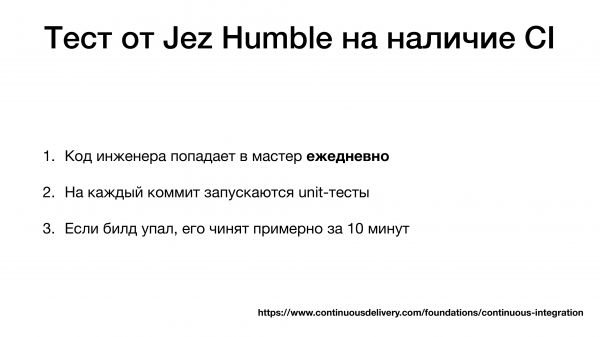
On dirait que nous faisons déjà quelque chose, que nous fusionnons déjà, mais comment savoir si nous avons réellement l'intégration continue et que nous fusionnons suffisamment souvent ?
Jez Humble est l'auteur du Handbook, Accelerate, du site Continuous Delivery et du livre « Continuous Delivery ». Il propose un test comme celui-ci :
- Le code de l'ingénieur est intégré dans la branche principale chaque jour.
- Pour chaque commit, vous exécutez des tests unitaires.
- Si le build dans la branche principale échoue, il est réparé environ 10 minutes.
Il propose d'utiliser ce test pour s'assurer que vous avez bien cette pratique.
Je trouve cela un peu discutable. C'est-à-dire que si vous pouvez réparer en 10 minutes, cela signifie que vous avez une intégration continue, ce qui semble un peu étrange, à mon avis, mais cela a un sens. Pourquoi ? Parce que si vous fusionnez souvent, cela signifie que vos changements sont petits. Si un petit changement entraîne la rupture de la compilation principale, vous pourrez trouver l'exemple rapidement, car le changement est minime. Vous avez réalisé une petite fusion, qui a modifié 20-30 lignes. Par conséquent, vous pouvez rapidement comprendre la cause, car les changements sont minuscules, vous avez une très petite zone de recherche du problème.
Et même si notre production s'effondre après la mise en ligne, si nous avons la pratique de l'intégration continue, il est beaucoup plus facile d'agir, car les changements sont minuscules. Oui, cela affectera la planification. Cela sera douloureux. Et probablement, la chose la plus difficile dans cette pratique est de s'habituer à décomposer les tâches, c'est-à-dire comment faire en sorte de prendre quelque chose et de le réaliser en quelques heures tout en passant en revue, si vous en avez une. La révision est une douleur à part.
Les tests unitaires sont simplement des assistants qui vous aident à comprendre si votre intégration a réussi, si rien n'est cassé. À mon avis, ce n'est pas non plus un point obligatoire, car le sens de la pratique n'est pas là.
C'est un bref aperçu de l'intégration continue. C'est tout ce qu'il y a dans cette pratique. Je suis prêt pour vos questions.
Pour résumer brièvement encore une fois :
- L'intégration continue n'est pas Jenkins, ce n'est pas Gitlab.
- Ce n'est pas un outil, c'est une pratique qui consiste à fusionner notre code dans la branche principale aussi souvent que possible.
- Nous le faisons pour éviter la grande douleur qui survient avec les fusions à l'avenir, c'est-à-dire que nous éprouvons une petite douleur maintenant afin de ne pas en éprouver une grande plus tard. C'est tout le sens.
- Il y a une communication par le biais du code, mais je ne le vois que très rarement, mais c'est aussi pour cela qu'elle a été conçue.
Questions
Que faire avec des tâches non décomposées ?
Décomposer. Quel est le problème ? Pouvez-vous donner un exemple d'une tâche qui ne peut pas être décomposée ?
Il existe des tâches qui sont impossibles à décomposer au sens propre, par exemple, celles qui nécessitent une expertise très approfondie et qui peuvent réellement prendre plusieurs mois pour aboutir à un résultat acceptable.
Si je te comprends bien, il y a une grande et complexe tâche dont le résultat ne sera visible que dans un mois?
Oui, c'est exact. Oui, le résultat ne pourra être évalué au plus tôt qu'au bout d'un mois.
Bien. En général, ce n'est pas un problème. Pourquoi ? Parce que dans ce cas, quand nous parlons de branches, nous ne parlons pas d'une branche avec une fonctionnalité. Les fonctionnalités peuvent être grandes et complexes. Elles peuvent toucher un grand nombre de composants. Et, peut-être, nous ne pouvons pas les réaliser entièrement dans une seule branche. C'est normal. Nous devons juste découper cette histoire. Si la fonctionnalité n'est pas entièrement prête, cela ne signifie pas que certaines parties de son code ne peuvent pas être fusionnées. Par exemple, tu as ajouté une migration et il y a des étapes à l'intérieur de la fonctionnalité. Tu as, par exemple, une étape – faire la migration, ajouter une nouvelle méthode. Et tu peux déjà fusionner ces éléments quotidiennement.
Bien. Quel est alors le sens de cela?
Quel est l'intérêt de fusionner de petites choses chaque jour?
Oui.
S'il y en a un qui te casse quelque chose, tu le vois tout de suite. Tu as un petit morceau qui a cassé quelque chose, il est plus facile de le corriger. L'idée est que fusionner une petite partie maintenant est beaucoup plus simple que de fusionner quelque chose de grand dans quelques semaines. Et le troisième aspect est que d'autres ingénieurs travailleront avec la version actuelle du code. Ils verront qu'il y a eu des migrations ajoutées ici, et qu'il y a une nouvelle méthode qui pourrait également les intéresser. Tout le monde pourra voir ce qui se passe dans ton code. C'est précisément pour ces trois raisons que cette pratique est mise en œuvre.
Merci, la question est réglée !
(Oleg Soroka) Puis-je ajouter quelque chose ? Tu as tout à fait raison, je ne veux qu'ajouter une phrase.
D'accord.
Avec l'intégration continue, le code est fusionné dans la branche principale non pas lorsque la fonctionnalité est complètement prête, mais lorsque le build cesse d'être cassé. Et vous pouvez commettre dans la branche principale autant de fois que vous le souhaitez chaque jour. Deuxième aspect – si pour une raison quelconque vous ne pouvez pas décomposer une tâche mensuelle en tâches d'au moins trois jours, je ne parle même pas de trois heures, cela signifie que vous avez un énorme problème. Et le fait que vous n'ayez pas d'intégration continue est le moindre de ces problèmes. Cela signifie que vous avez des problèmes d'architecture et que vos pratiques d'ingénierie sont au niveau zéro. Parce que même si c'est de la recherche, il faut en tout cas la formuler sous forme d'hypothèses ou de cycles.
Nous avons parlé de 4 métriques qui distinguent les entreprises performantes de celles en difficulté. Il faut d'abord atteindre ces 4 métriques. Si une tâche moyenne prend un mois, je me concentrerais d'abord sur cette métrique. Je viserais d'abord à réduire ce délai à 3 jours. Une fois cela fait, je commencerais à penser à l'Intégration Continue.
Ai-je bien compris que tu penses qu'il n'est pas encore utile d'investir dans des pratiques d'ingénierie si n'importe quelle tâche prend un mois ?
Tu as l'Intégration Continue. Et il y a un aspect où, en 10 minutes, tu peux soit corriger un problème soit le rétablir. Imagine, tu as déployé quelque chose. En fait, tu as même un déploiement continu, tu l'as mis en production et tu as remarqué seulement après que quelque chose n'allait pas. Et tu dois le rétablir, mais ta base de données a déjà migré. La structure de ta base de données est maintenant à la version suivante, en plus, une sauvegarde a eu lieu et des données y ont déjà été enregistrées.
Et quelle est ton alternative ? Si tu reverts le code, il ne peut plus fonctionner avec cette base de données mise à jour.
La base n'avance que vers l'avant, oui.
Les personnes ayant de mauvaises pratiques d'ingénierie n'ont probablement pas non plus lu ce gros livre sur… Que faire avec une sauvegarde ? Si tu te rétablis à partir d'une sauvegarde, cela signifie que tu perds les données accumulées pendant cette période. Par exemple, tu as travaillé trois heures avec la nouvelle version de la base de données, des utilisateurs se sont inscrits. Si tu reviens à une ancienne sauvegarde, car la nouvelle version ne fonctionne pas avec la structure, tu as donc perdu ces utilisateurs. Et ils ne sont pas contents, ils se plaignent.
Pour maîtriser l'ensemble des pratiques soutenant l'intégration continue et la livraison continue, il ne suffit pas d'apprendre simplement à écrire… D'abord, il peut y en avoir beaucoup trop, ce qui serait impraticable. De plus, il existe de nombreuses autres pratiques, comme la pratique scientifique. Il y a une pratique que GitHub a popularisée à un moment donné. C'est lorsque tu exécutes à la fois du code ancien et du nouveau code. C'est quand tu as une fonctionnalité inachevée qui peut renvoyer une certaine valeur : soit comme fonction, soit comme API Rest. Tu exécutes à la fois le nouveau code et l'ancien code, et tu compares la différence entre les deux. Et s'il y a une différence, tu enregistres cet événement. Ainsi, tu sais que ta nouvelle fonctionnalité est prête à être mise en œuvre au-dessus de l'ancienne, si tu n'as pas eu de divergence entre ces deux-là pendant un certain temps.
Il existe des centaines de telles pratiques. Je te suggérerais de commencer par le développement transbase. Ce n'est pas entièrement basé sur l'intégration continue, mais les pratiques sont les mêmes, l'un ne peut pas bien vivre sans l'autre.
Tu as mentionné le développement transbase comme exemple, où l'on peut observer des pratiques, ou tu proposes aux gens de commencer à utiliser le développement transbase ?
Regarder, car ils ne pourront pas l'utiliser. Pour pouvoir l'utiliser, il faut lire beaucoup de choses. Et lorsque la question se pose : « Que faire avec une fonctionnalité qui prend un mois ? », cela signifie qu'il n'a pas lu sur le développement transbase. Je ne le conseillerais pas pour le moment. Je conseillerais de se concentrer exclusivement sur le thème de la bonne façon d'architecturer la décomposition de grandes tâches en tâches plus petites. C'est là l'essence de la décomposition.
La décomposition est un des outils de l'architecte. Nous faisons d'abord l'analyse, puis la décomposition, ensuite la synthèse, puis l'intégration. Et ainsi, tout se met en place. Et il faut encore progresser vers l'intégration continue à travers la décomposition. Des questions se posent à la première étape, alors que nous parlons déjà de la quatrième étape, c'est-à-dire que plus tu fais souvent d'intégration, mieux c'est. Il est encore un peu tôt pour le faire, il serait bon de commencer par découper ton monolithe.
Il faut dessiner plusieurs flèches et carrés sur un schéma. On ne peut pas dire que je vais montrer l'architecture de la nouvelle application en présentant un seul carré avec un bouton vert pour l'application à l'intérieur. De toute façon, il y aura plus de carrés et de flèches. Dans n'importe quel schéma que j'ai vu, il y en avait plus d'un. Et la décomposition est déjà effectuée même au niveau de la représentation graphique. Ainsi, les carrés peuvent être indépendants. Sinon, j'ai de grandes questions à poser à l'architecte.
Il y a une question du chat : « Si la révision est obligatoire et prend longtemps, un jour ou plus ? ».
Vous avez des problèmes avec la pratique. Une révision ne devrait pas prendre un jour ou plus. C'est une histoire similaire à la question précédente, juste un peu plus douce. Si la révision prend un jour, cela signifie probablement qu'il s'agit d'une révision d'un changement très important. Donc, il faut la rendre plus petite. Dans le développement transbase, que Oleg a recommandé, il existe une méthode appelée révision continue. Le principe est que nous faisons des pull requests délibérément très petites, car nous cherchons à fusionner constamment et par petites touches. Ainsi, une pull request modifie une seule abstraction ou 10 lignes. Grâce à cela, la révision ne prend que quelques minutes.
Si la révision prend un jour ou plus, cela signifie que quelque chose ne va pas. Premièrement, il se peut que vous ayez des problèmes avec l'architecture. Ou alors c'est un gros morceau de code, disons 1 000 lignes, par exemple. Ou votre architecture est tellement complexe qu'une personne ne peut pas la comprendre. C'est un problème à part, mais il faudra aussi le résoudre. Peut-être que la révision n'est même pas nécessaire. Il faut aussi y réfléchir. La révision est cette chose qui vous freine. Elle a ses avantages en général, mais il faut comprendre pourquoi vous le faites. Est-ce pour vous un moyen de transmettre rapidement des informations, un moyen d'établir des normes internes ou quoi ? Pourquoi avez-vous besoin de cela ? Parce que la révision doit être soit très rapide, soit complètement annulée. C'est comme le développement transbase - une belle histoire, mais seulement pour des équipes matures.
Concernant les 4 métriques, je recommanderais plutôt de les prendre, afin de comprendre où cela mène. Regarder les chiffres, voir l'image, à quel point tout cela est mauvais.
(Dmitri) Je suis prêt à discuter de cela avec toi. Les chiffres et les métriques, c'est super, les pratiques, c'est génial. Mais il faut comprendre si cela est nécessaire pour l'entreprise. Il existe des entreprises qui n'ont pas besoin d'un rythme de changement aussi rapide. Je connais des sociétés où il est impossible de faire des changements toutes les 15 minutes. Et ce n'est pas parce qu'elles sont mauvaises. C'est juste leur cycle de vie. Et pour réaliser la fonctionnalité des branches, la fonctionnalité toggle, il faut des connaissances approfondies.
C'est compliqué. Si tu souhaites lire plus en détail l'histoire sur la fonctionnalité toggle, je te recommande vivement. . Et il y a un excellent article de Martin Fowler sur les fonctionnalités toggle : les types, les cycles de vie, etc. La fonctionnalité toggle, c'est complexe.
Et tu n'as toujours pas répondu à la question : « Jenkins est-il nécessaire ou non ? »
Jenkins n'est en réalité nécessaire dans aucun cas. Pour être sérieux, des outils comme Jenkins et GitLab vous apporteront du confort. Vous verrez si la construction a réussi ou non. Ils peuvent vous aider, mais ils ne vous garantiront pas la pratique. Ils vous fourniront juste un petit rond — Ok, pas Ok. Et ça, si vous écrivez encore des tests, parce que s'il n'y a pas de tests, c'est presque inutile. Par conséquent, c'est nécessaire parce que c'est plus pratique, mais en gros, on peut vivre sans, vous ne perdrez pas beaucoup.
C'est-à-dire que si vous avez des pratiques, cela signifie que vous n'en avez pas besoin ?
Exactement. Je recommande le test de Jez Humble. J'ai un avis mitigé sur le dernier point. Mais globalement, si vous avez trois choses : vous fusionnez constamment, vous exécutez des tests sur les commits dans la branche maîtresse, vous réparez rapidement le build dans la branche maîtresse, alors peut-être que vous n'avez besoin de rien d'autre.
En attendant les questions des participants, j'ai une question. Nous avons parlé du code produit. As-tu utilisé cela pour du code d'infrastructure ? Est-ce le même code, a-t-il les mêmes principes et le même cycle de vie, ou y a-t-il d'autres cycles de vie et principes ? D'habitude, quand on parle de Continuous Integration et Development, tout le monde oublie qu'il existe aussi du code d'infrastructure. Et cela prend de plus en plus d'importance dernièrement. Devrait-on y appliquer toutes ces règles ?
Ce n'est même pas question de devoir, ce serait super, car cela simplifierait la vie. Dès que nous travaillons avec du code, pas avec des scripts en bash, mais avec un code normal.
Attends, attends, un script en bash, c'est aussi du code. Ne touche pas à mon vieux amour.
D'accord, je ne vais pas piétiner tes souvenirs. J'ai une aversion personnelle envers bash. Il se casse de manière laide et effrayante tout le temps. Et il tombe souvent de manière imprévisible, c'est pourquoi je ne l'aime pas beaucoup. Mais bien, supposons que tu aies du code en bash. Peut-être que je ne m'y connais pas bien et qu'il existe de bons frameworks de test. Je ne suis tout simplement pas au courant. Et nous avons les mêmes avantages.
Dès que nous travaillons avec l'infrastructure comme du code, nous rencontrons les mêmes problèmes que les développeurs. Il y a quelques mois, j'ai été confronté à une situation où un collègue m'a envoyé un pull request de 1 000 lignes en bash. Et tu te retrouves à passer 4 heures en révision. Les problèmes sont les mêmes. C'est toujours du code. Et c'est toujours un travail collaboratif. Nous sommes coincés avec le pull request et nous rencontrons les mêmes conflits de fusion du même bash, par exemple.
Je suis actuellement très actif sur cette notion de programmation d'infrastructure de la manière la plus esthétique possible. J'ai intégré Pulumi dans l'infrastructure. C'est de la programmation pure. C'est encore plus agréable car j'ai toutes les possibilités du langage de programmation, c'est-à-dire que j'ai créé de jolis toggles avec les mêmes if, et tout est en ordre. Donc, ma modification est déjà dans la branche principale. Tout le monde peut le voir. D'autres ingénieurs sont au courant. Cela a déjà eu un impact. Mais en même temps, cela ne s'est pas activé pour toutes les infrastructures. Cela s'est activé pour mes environnements de test, par exemple. Donc, pour répondre à ta question une fois de plus, oui, cela nous simplifie la vie en tant qu'ingénieurs travaillant avec du code.
Y a-t-il d'autres questions ?
J'ai une question. Je veux poursuivre la discussion avec Oleg. Dans l'ensemble, je pense que tu as raison : si une tâche prend un mois, c'est qu'il y a un problème d'architecture, un problème d'analyse, de décomposition, de planification, etc. Mais j'ai le sentiment que si tu commences à essayer de vivre selon l'intégration continue, tu vas commencer à corriger les douleurs liées à la planification, car tu ne peux pas vraiment y échapper.
(Oleg) Oui, c'est tout à fait ça. En termes d'effort, cette pratique est comparable à toute autre pratique sérieuse qui change la culture. La chose la plus difficile à surmonter, ce sont les habitudes, en particulier les mauvaises habitudes. Et si la mise en œuvre de cette pratique nécessite un changement sérieux des habitudes des personnes autour de vous : développeurs, direction, chef de production, alors vous pouvez vous attendre à des surprises.
Quelles surprises peuvent survenir ? Supposons que vous ayez décidé de faire plus souvent des intégrations. Et pour les intégrations, vous avez d'autres éléments, par exemple, des artefacts. Et dans votre entreprise, il y a une politique stipulant que chaque artefact doit être enregistré d'une manière ou d'une autre dans un système de stockage d'artefacts. Cela prend un certain temps. La personne doit cocher que, en tant que manager de version, elle a testé cet artefact pour qu'il soit prêt à être déployé en production. Si cela prend 5-10-15 minutes, mais que vous faites des déploiements une fois par semaine, alors consacrer une demi-heure chaque semaine n'est pas une grande charge.
Si vous effectuez une intégration continue 10 fois par jour, alors il faut multiplier 10 fois par 30 minutes. Cela dépasse le temps de travail de ce manager de version. Il finit simplement par être fatigué de le faire. Il y a des coûts constants associés à certaines pratiques. Voilà tout.
Il vous faut donc soit annuler cette règle, pour ne plus vous engager dans des absurdités, c'est-à-dire ne pas valider manuellement la conformité de quelque chose. Vous devez compter entièrement sur un ensemble de tests automatisés de préparation.
Et si vous avez besoin d'une approbation de quelqu'un pour que le responsable signe, et que vous n'entrez pas en production sans avoir le feu vert de Vasya, etc. – toutes ces absurdités se mettent en travers des pratiques. Parce que si certaines activités sont liées comme une charge, alors tout se multiplie par 100. Par conséquent, le changement sera souvent mal reçu par tout le monde. Car il est difficile de corriger les habitudes des gens.
Lorsque quelqu'un effectue un travail habituel, il le fait pratiquement sans y penser. La charge cognitive est égale à zéro. Il réalise simplement des tâches préétablies, il a déjà une check-list dans la tête, il l'a faite mille fois. Et dès que vous arrivez et lui dites : « Abandonnons cette pratique et mettons en œuvre une nouvelle dès lundi », cela devient une lourde charge cognitive pour lui. Et cela arrive immédiatement pour tout le monde.
C'est donc la chose la plus simple, mais il est vrai que tout le monde ne peut pas se permettre ce luxe. C'est toujours comme ça que je procède. Si un nouveau projet démarre, on y intègre généralement toutes les pratiques non éprouvées. Tant que le projet est jeune, nous ne risquons pas grand-chose. Il n'y a pas encore de production, donc il n'y a rien à casser. C'est une opportunité d'expérimentation. Cette approche fonctionne. Cependant, toutes les entreprises n'ont pas la possibilité de lancer souvent de tels projets. Bien que cela semble un peu étrange, car actuellement c'est la transformation digitale, et tout le monde doit mener des expériences pour rester compétitif.
Ici, tu fais face au fait que tu dois d'abord comprendre ce que tu dois faire. Le monde n'est pas parfait et la production non plus.
Oui, ces choses sont interconnectées.
Les entreprises n'ont pas toujours conscience qu'elles doivent aller dans telle ou telle direction.
Il existe des situations où aucun changement n'est possible. Cela se produit lorsque la pression sur l'équipe est plus forte. L'équipe est déjà en burn-out. Elle n'a aucun temps libre pour des expériences. Ils passent leurs journées à développer des fonctionnalités. Et la direction en veut toujours plus. Dans cette situation, aucun changement n'est envisageable. L'équipe ne peut recevoir que l'instruction de faire demain ce qu'ils ont fait hier, juste en produisant un peu plus de fonctionnalités. Aucun passage à d'autres pratiques n'est possible dans ce sens. C'est une situation classique où il n'y a pas de temps pour aiguiser la hache, il faut couper du bois, donc on coupe avec une hache émoussée. Il n'y a pas de conseils simples ici.
(Dmitry) Je vais lire une précision du chat : « Mais il faut une large couverture de tests à différents niveaux. Combien de temps est consacré aux tests ? Ça coûte cher et ça prend beaucoup de temps. »
(Oleg) C'est une idée reçue classique. Il doit y avoir suffisamment de tests pour que vous ayez vous-même confiance. L'intégration continue n'est pas quelque chose où vous devez d'abord avoir 100 % de tests avant de commencer à l'appliquer. L'intégration continue réduit votre charge cognitive car chaque modification que vous voyez est tellement évidente que vous comprenez si cela va casser quelque chose ou non, même sans tests. Vous pouvez rapidement le tester mentalement car ce sont de petites modifications. Même si vous n'avez que des testeurs manuels, c'est plus simple pour eux. Vous déployez et dites : « Regarde, rien n'est cassé ? ». Ils vérifient et disent : « Non, rien n'est cassé ». Parce que le testeur sait où regarder. Un de vos commits est lié à un fragment de code. Et cela exploite un comportement spécifique.
Là, tu as bien embellit.
(Dmitry) Je ne suis pas d'accord ici. Il existe une pratique – le développement dirigé par les tests, qui va précisément sauver de cela.
(Oleg) Voilà, je n'en étais pas encore là. La première illusion est que vous devez écrire 100 % de tests ou ne pas vous occuper de l'intégration continue. C'est faux. Ce sont deux pratiques parallèles. Et elles ne dépendent pas directement l'une de l'autre. Votre couverture de tests doit être optimale. Optimale signifie que vous êtes vous-même convaincu que la qualité du maître, après votre commit, vous permet de cliquer avec confiance sur le bouton « Déployer » un vendredi soir dans un état d'ivresse. Comment y parvenez-vous ? Grâce à la révision, à la couverture, à un bon monitoring.
Un bon monitoring est indistinguable des tests. Si vous exécutez vos tests une fois en pré-prod, alors ils vérifient vos scénarios utilisateur une seule fois, c'est tout. Mais si vous les exécutez en boucle infinie, alors c'est votre système de monitoring déployé, qui teste tout en permanence – cela a-t-il échoué ou non. Dans ce cas, la différence ne réside que dans le caractère unique ou répétitif. Un très bon ensemble de tests …, exécutés indéfiniment, c'est du monitoring. Et le bon monitoring doit être ainsi.
Et donc, la manière dont vous atteindrez cet état où vous déployez un vendredi soir et rentrez chez vous, c'est une autre question. Peut-être que vous êtes juste un aventurier audacieux.
Retournons un peu en arrière sur l’intégration continue. Nous nous sommes un peu éloignés vers une autre pratique complexe.
Et la deuxième illusion est que le MVP, on dit qu'il faut le faire rapidement, donc les tests ne sont pas du tout nécessaires. Ce n'est pas tout à fait ça. En fait, lorsque vous rédigez une user story pour le MVP, vous pouvez soit la développer à l'aveuglette, c'est-à-dire que vous avez entendu qu'il y a une user story, et vous vous précipitez à la coder, soit travailler selon le TDD. Et selon le TDD, comme montre la pratique, cela ne prend pas plus de temps ; les tests sont en fait un effet secondaire. La pratique du TDD ne consiste pas à tester. Malgré le fait que cela s'appelle le développement piloté par les tests, il ne s'agit pas de tests. C'est en fait plutôt une approche architecturelle. C'est une manière d'écrire précisément ce qui est nécessaire et de ne pas écrire ce qui ne l'est pas. Cette pratique se concentre sur la prochaine itération de votre réflexion en matière de création de l'architecture de l'application.
Il n'est donc pas si facile de se débarrasser de ces illusions. MVP et tests ne s'opposent pas. Au contraire, si vous réalisez un MVP selon la pratique du TDD, vous le ferez mieux et plus rapidement que si vous n'appliquez aucune méthode, en agissant à l'aveuglette.
C'est une pensée très peu évidente et complexe. Quand on entend que maintenant je vais encore écrire des tests et que je vais faire quelque chose plus rapidement, ça semble totalement inapproprié.
(Dmitry) Beaucoup de gens, quand ils parlent de MVP, c'est parce qu'ils n'ont pas envie d'écrire quelque chose de correct. Et ce sont quand même des choses différentes. Ne transformez pas le MVP en quelque chose de mauvais qui ne fonctionne pas.
Oui, oui, tu as raison.
Et puis soudainement le MVP en prod.
Pour toujours.
Et le TDD semble très inhabituel quand on entend que vous écrivez des tests et que vous apparemment effectuez plus de travail. Cela semble très étrange, mais en réalité, cela se fait plus rapidement et de manière plus élégante. Quand vous écrivez un test, vous réfléchissez déjà beaucoup aux types de code et à la façon dont il sera appelé, ainsi qu'au comportement que nous attendons de lui. Vous ne dites pas simplement que vous avez écrit une fonction qui fait quelque chose. D'abord, vous pensez que c'est sous certaines conditions, elle sera appelée de cette manière. Vous le couvrez avec des tests et à partir de là, vous comprenez à quoi ressembleront les interfaces dans votre code. Cela a un impact très fort sur l'architecture. Votre code devient automatiquement plus modulaire, car vous essayez d'abord de comprendre comment vous allez le tester, et seulement ensuite vous l'écrivez.
Avec TDD, j'ai eu une expérience où, à un moment donné, j'ai engagé un mentor en Ruby alors que j'étais encore développeur Ruby. Il m'a dit : « Commençons à travailler avec TDD ». Et je me suis dit : « Oh non, maintenant il faut encore écrire quelque chose de plus ». Nous avons convenu que pendant deux semaines, j'écrirais tout le code fonctionnel en Python en suivant TDD. Au bout de deux semaines, je me suis rendu compte que je ne voulais plus revenir en arrière. Après deux semaines à essayer de l'appliquer partout, j'ai constaté à quel point il était devenu plus facile de réfléchir. Mais ce n'est pas évident, donc je recommande à tout le monde que si vous pensez que TDD est compliqué, long et superflu, essayez de vous y tenir pendant deux semaines. Pour moi, deux semaines ont suffi.
(Dmitri) Nous pouvons développer cette idée du point de vue de l'exploitation de l'infrastructure. Avant de lancer quelque chose de nouveau, nous réalisons une surveillance, puis nous lançons. Dans ce cas, notre surveillance devient un test normal. Et il y a le développement par la surveillance. Mais presque tout le monde dit que c'est long, que ça les ennuie, qu'ils ont fait un brouillon temporaire. Si nous avons réalisé une bonne surveillance, nous comprenons l'état du système CI. Et dans le système CI, il y a beaucoup de surveillance. Nous comprenons l'état du système, nous savons ce qu'il y a à l'intérieur. Et pendant le développement, nous réalisons précisément un système qui parvienne à l'état désiré.
Ces pratiques sont connues depuis longtemps. Nous en avons discuté il y a environ 4 ans. Mais en 4 ans, pratiquement rien n'a changé.
Sur cette note, je propose de mettre fin à la discussion officielle.
Vidéo (insérée comme élément multimédia, mais apparemment non fonctionnelle) :
Source : habr.com
