

Bonjour.
J'ai décidé de partager ma découverte — le fruit de réflexions, d'essais et d'erreurs.
En fin de compte : ce n'est pas vraiment une découverte, bien sûr — tout cela devrait être connu depuis longtemps par ceux qui s'occupent du traitement statique des données et de l'optimisation de divers systèmes, pas nécessairement des SGBD.
Et : oui, on sait, ils écrivent des articles intéressants sur leurs recherches, (UPD.: dans les commentaires, ils ont mentionné un projet très intéressant : )
D'un autre côté : à première vue, je ne vois pas de mention large ou de diffusion de cette approche sur Internet, parmi les spécialistes IT, DBA.
Donc, au cœur du sujet.
Supposons que nous avons une tâche : configurer un système de service pour traiter un certain travail.
Concernant ce travail — il est connu : de quoi il s'agit, comment la qualité de ce travail est mesurée et quel est le critère pour évaluer cette qualité.
Supposons également qu'il est plus ou moins connu : comment le travail est effectivement effectué dans (ou avec) ce système de service.
"Plus ou moins" — cela signifie qu'il y a une possibilité de préparer (ou de trouver quelque part) un outil, un utilitaire, un service capable de synthétiser et de fournir au système une charge de test suffisamment adéquate à ce qui sera en production, dans des conditions suffisamment proches de celles de la production.
Et, disons que l'on connaît l'ensemble des paramètres d'ajustement de ce système de service, que l'on peut utiliser pour régler ce système, en termes de productivité.
Et, quel est le problème — il n'y a pas de compréhension suffisamment complète de ce système de service, celle qui permettrait de régler expertement ce système pour la charge future, sur cette plateforme et d'obtenir la productivité requise.
Eh bien. C'est presque toujours le cas.
Que peut-on faire à ce sujet ?
Eh bien, la première chose qui me vient à l'esprit : consulter la documentation de ce système. Comprendre — quels sont les intervalles acceptables pour les valeurs des paramètres d'ajustement. Et, par exemple, en utilisant la méthode du gradient, ajuster les valeurs des paramètres du système lors des tests.
C'est-à-dire, donner au système une certaine configuration, sous la forme d'un ensemble concret de valeurs de ses paramètres de réglage.
Soumettre une charge de test à l'aide de cet utilitaire, générateur de charge.
Et observer le temps de réponse — ou la métrique de qualité du travail du système.
Une deuxième pensée pourrait être que — cela prend beaucoup de temps.
Donc, c'est-à-dire : si le nombre de paramètres de configuration est élevé, si les plages de valeurs que nous parcourons sont larges, si chaque test de charge prend beaucoup de temps, alors : oui, cela peut prendre un temps inacceptable.
Eh bien, ici on peut comprendre et se souvenir.
On peut savoir que, dans l'ensemble des valeurs des paramètres de configuration du système de service, il y a un vecteur, comme une séquence de certaines valeurs.
À chaque vecteur correspondant, toutes choses étant égales par ailleurs (en ce sens qu'il ne concerne pas ce vecteur), il y a une certaine valeur de métrique – un indicateur de la qualité du fonctionnement du système sous une charge de test.
C'est-à-dire.
Désignons le vecteur de configuration du système comme  , où
 ; où
 — le nombre de paramètres de configuration du système, combien il y en a, ces paramètres.
Et la valeur de la métrique correspondant à ce  nous le désignerons comme
 , ce qui nous donne une fonction :

Eh bien, alors : tout se résume immédiatement à, dans mon cas : presque oubliés depuis des bancs de l'université, les algorithmes de recherche d'extrêmes de fonction.
D'accord, mais ici se pose une question organisationnelle et pratique : quel algorithme utiliser exactement.
- Dans le sens – pour coder le moins possible soi-même.
- Et pour que ça fonctionne, c'est-à-dire qu'il trouve l'extrême (s'il existe), au moins – plus rapidement que la descente de coordonnées.
Le premier point indique qu'il faut se tourner vers des environnements où de tels algorithmes sont déjà implémentés et existent, sous une forme utilisable dans le code.
Eh bien, je connais python et cran-r
Le deuxième point signifie qu'il faut lire sur les algorithmes eux-mêmes, quels sont, quelles sont leurs exigences, particularités de fonctionnement.
Et ce qu'ils peuvent donner, il peut y avoir des effets secondaires utiles, soit directement à partir de l'algorithme lui-même.
Ou ils peuvent être obtenus à partir des résultats du travail de l'algorithme.
Cela dépend beaucoup des conditions d'entrée.
Par exemple, si, pour une raison quelconque, il est nécessaire d'obtenir le résultat plus rapidement, eh bien, il faut se tourner vers des algorithmes de descente de gradient, en choisissant l'un d'eux.
Ou, si le temps n'est pas si important, on peut par exemple utiliser des méthodes d'optimisation stochastique, comme un algorithme génétique.
Je propose d'examiner le fonctionnement de cette approche, pour le choix de la configuration du système, en utilisant un algorithme génétique, lors du prochain, disons : travail de laboratoire.
Données d'entrée :
- Considérons qu'il existe, en tant que système de service :
oracle xe 18c - Admettons qu'il gère l'activité transactionnelle et l'objectif : obtenir une bande passante maximale pour la base de données, en transactions/seconde.
- Les transactions peuvent être très diverses, selon leur nature de traitement des données et le contexte d’exécution.
Convenons que ce sont des transactions qui ne traitent pas un grand nombre de données tabulaires.
De ce sens, elles ne génèrent pas de données d'undo plus que de redo et ne traitent pas un grand pourcentage de lignes dans de grandes tables.
Ce sont des transactions qui modifient une ligne dans une table de taille relativement importante, avec un petit nombre d'index sur cette table.
Dans ce cas, la productivité de la base de données dans le traitement des transactions sera, avec réserve, déterminée par la qualité du traitement des données redo.
La réserve — si nous parlons précisément des paramètres de la base de données.
Parce que, de manière générale, il peut y avoir, par exemple, des verrous transactionnels entre les sessions SQL, à cause du design de l'interaction utilisateur avec les données tabulaires et/ou le modèle tabulaire.
Qui, bien sûr, aura un impact négatif sur la métrique tps et ce sera un facteur exogène, relativement à la base de données : c’est ainsi que le modèle tabulaire et l'usage des données ont été conçus de sorte à entraîner des blocages.
Par conséquent, pour la pureté de l'expérience, nous allons exclure ce facteur, je préciserai comment exactement ci-dessous.
- Supposons, pour la clarté, que 100 % des commandes SQL envoyées à la base de données : ce sont des commandes DML.
Les caractéristiques de l'interaction utilisateur avec la base de données restent les mêmes lors des tests.
À savoir : le nombre de sessions SQL, les données tabulaires, la manière dont les sessions SQL interagissent avec ces données. - La base de données fonctionne en
FORCE LOGGING,ARCHIVELOGmodes. Le mode Flashback est désactivé, au niveau de la base de données. - Les redo-logs : sont situés dans un système de fichiers séparé, sur un "disque" distinct ;
Le reste de la partie physique de la base de données : dans un autre système de fichiers, sur un "disque" séparé :
Plus de détails sur la structure de la composante physique de la base de données de laboratoire.
SQL> select status||' '||name from v$controlfile;
 /db/u14/oradata/XE/control01.ctl
SQL> select GROUP#||' '||MEMBER from v$logfile;
1 /db/u02/oradata/XE/redo01_01.log
2 /db/u02/oradata/XE/redo02_01.log
SQL> select FILE_ID||' '||TABLESPACE_NAME||' '||round(BYTES/1024/1024,2)||' '||FILE_NAME as col from dba_data_files;
4 UNDOTBS1 2208 /db/u14/oradata/XE/undotbs1_01.dbf
2 SLOB 128 /db/u14/oradata/XE/slob01.dbf
7 USERS 5 /db/u14/oradata/XE/users01.dbf
1 SYSTEM 860 /db/u14/oradata/XE/system01.dbf
3 SYSAUX 550 /db/u14/oradata/XE/sysaux01.dbf
5 MONITOR 128 /db/u14/oradata/XE/monitor.dbf
SQL> !cat /proc/mounts | egrep "/db/u[0-2]"
/dev/vda1 /db/u14 ext4 rw,noatime,nodiratime,data=ordered 0 0
/dev/mapper/vgsys-ora_redo /db/u02 xfs rw,noatime,nodiratime,attr2,nobarrier,inode64,logbsize=256k,noquota 0 0
Initialement, j'avais l'intention d'utiliser le SGBD transactionnel sous ces conditions de charge.
Il a une caractéristique remarquable, je cite l'auteur :
Au cœur de SLOB se trouve la « méthode SLOB ». La méthode SLOB vise à tester des plateformes
sans contention d'application. On ne peut pas atteindre des performances maximales du matériel
en utilisant du code applicatif qui est, par exemple, lié à des verrouillages applicatifs ou même
au partage de blocs de base de données Oracle. C'est exact : il existe une surcharge lors du partage de données
dans des blocs de données ! Mais SLOB — dans son déploiement par défaut — est immunisé contre cette contention.
Cette déclaration : c'est vrai, c'est ainsi.
Il est pratique de réguler le degré de parallélisme des sessions SLOB, c'est la clé -t pour le lancement de l'outil runit.sh de la suite SLOB.
On régule le pourcentage des commandes DML, parmi le nombre de requêtes envoyées au SGBD, chaque session de requête, avec le paramètre UPDATE_PCT.
Séparément et très commodément : SLOB lui-même, avant et après la session de charge — prépare les snapshots statspack ou AWR (ce qui est configuré pour être préparé).
Cependant, il s'est avéré que SLOB il ne prend pas en charge les sessions SLOB d'une durée inférieure à 30 secondes.
Nous avons donc d'abord codé ma version rustique du générateur de charge, puis il est resté opérationnel.
Je vais préciser pour le générateur de charge — ce qu'il fait et comment, pour plus de clarté.
Essentiellement, le générateur de charge ressemble à ceci :
Code du travailleur
function dotx()
{
local v_period="$2"
[ -z "v_period" ] && v_period="0"
source "/home/oracle/testingredotrace/config.conf"

$ORACLE_HOME/bin/sqlplus -S system/${v_system_pwd} << __EOF__
whenever sqlerror exit failure
set verify off
set echo off
set feedback off

define wnum="$1"
define period="$v_period"
set appinfo worker_&&wnum

declare
 v_upto number;
 v_key  number;
 v_tots number;
 v_cts  number;
begin
 select max(col1) into v_upto from system.testtab_&&wnum;
 SELECT (( SYSDATE - DATE '1970-01-01' ) * 86400 ) into v_cts FROM DUAL;
 v_tots := &&period + v_cts;
 while v_cts <= v_tots
 loop
  v_key:=abs(mod(dbms_random.random,v_upto));
  if v_key=0 then
   v_key:=1;
  end if;
  update system.testtab_&&wnum t
  set t.object_name=translate(dbms_random.string('a', 120), 'abcXYZ', '158249')
  where t.col1=v_key
  ;
  commit;
  SELECT (( SYSDATE - DATE '1970-01-01' ) * 86400 ) into v_cts FROM DUAL;
 end loop;
end;
/

exit
__EOF__
}
export -f dotx
Les travailleurs sont lancés de cette manière :
Lancement des travailleurs
echo "début du test, durée : ${TEST_DURATION}" >> "$v_logfile"
for((i=1;i> "$v_logfile"
 dotx "$i" "${TEST_DURATION}" &
done
echo "attente..." >> "$v_logfile"
wait
Les tables pour les workers sont préparées comme suit :
Création des tables
function createtable() {
source "\/home\/oracle\/testingredotracе\/config.conf"
$ORACLE_HOME\/bin\/sqlplus -S system\/${v_system_pwd} << __EOF__
whenever sqlerror continue
set verify off
set echo off
set feedback off

define wnum="$1"
define ts_name="slob"

begin
 execute immediate 'drop table system.testtab_&&wnum';
exception when others then null;
end;
\/\n
create table system.testtab_&&wnum tablespace &&ts_name as
select rownum as col1, t.*
from sys.dba_objects t
where rownum> "$v_logfile"
C'est-à-dire qu'une table distincte est créée pour chaque worker (pratiquement : une session SQL distincte dans la base de données), avec laquelle le worker travaille.
Cela permet d'éviter les blocages transactionnels entre les sessions SQL des workers.
Chaque worker effectue la même tâche avec sa propre table, toutes les tables sont identiques.
Tous les workers réalisent leur travail pendant la même durée.
Et ce pendant une période suffisamment longue pour que, par exemple, un changement de journal se produise, et pas qu'une seule fois.
Ainsi, des coûts et des effets associés apparaissent.
Dans mon cas, j'ai configuré la durée de travail des workers à 8 minutes.
Un extrait du rapport statspack, décrivant le fonctionnement de la base de données sous charge.
Base de données    ID DB    Instance     Num Inst  Heure de démarrage   Version     RAC
~~~~~~~~ ----------- ------------ -------- --------------- ----------- ---
          2929910313 XE                  1 07-sep-20 23:12 18.0.0.0.0  NON

Nom de l'hôte             Plateforme                CPU Cores Sockets   Mémoire (Go)
~~~~ ---------------- ---------------------- ----- ----- ------- ------------
     billing.izhevsk1 Linux x86 64 bits           2     2       1         15.6

Instantané       ID Snap     Heure Snap      Sessions Curs/Sess Commentaire
~~~~~~~~    ---------- ------------------ -------- --------- ------------------
Début Snap:       1630 07-sep-20 23:12:27       55        .7
  Fin Snap:       1631 07-sep-20 23:20:29       62        .6
   Écoulé:       8.03 (min) Av Act Sess:       8.4
   Temps DB:      67.31 (min)      CP DB:      15.01 (min)

Taille des caches            Début        Fin
~~~~~~~~~~~       ---------- ----------
    Cache tampon:     1,392M              Taille de bloc Std:         8K
     Pool partagé:       288M                  Tampon journal:   103,424K

Profil de charge              Par seconde    Par transaction    Par exécution    Par appel
~~~~~~~~~~~~      ------------------  ----------------- ----------- -----------
      Temps DB(s):                8.4                0.0        0.00        0.20
       CPU DB(s):                1.9                0.0        0.00        0.04
       Taille de redémarrage:        7,685,765.6              978.4
   Lectures logiques:           60,447.0                7.7
   Changements de blocs:           47,167.3                6.0
  Lectures physiques:                8.3                0.0
 Écritures physiques:              253.4                0.0
      Appels utilisateurs:               42.6                0.0
          Analyses:               23.2                0.0
     Analyses difficiles:                1.2                0.0
W/A Mo traité:                1.0                0.0
          Connexions:                0.5                0.0
        Exécutions:           15,756.5                2.0
       Rétrogradations:                0.0                0.0
    Transactions:            7,855.1
Revenons à la présentation du travail de laboratoire.
Nous allons, toutes choses égales par ailleurs, faire varier les valeurs de certains paramètres de la base de données de laboratoire :
- Taille des groupes de journaux de la base de données. Plage de valeurs : [32, 1024] Mo ;
- Nombre de groupes de journaux de la base de données. Plage de valeurs : [2,32];
log_archive_max_processesplage de valeurs : [1,8];commit_loggingdeux valeurs sont autorisées :batch|immediate;commit_waitdeux valeurs sont autorisées :wait|nowait;log_bufferplage de valeurs : [2,128] Mo.log_checkpoint_timeoutplage de valeurs : [60,1200] secondesdb_writer_processesplage de valeurs : [1,4]undo_retentionplage de valeurs : [30;300] secondestransactions_per_rollback_segmentplage de valeurs : [1,8]disk_asynch_iodeux valeurs sont autorisées :true|false;filesystemio_optionsles valeurs suivantes sont autorisées :none|setall|directIO|asynch;db_block_checkingles valeurs suivantes sont autorisées :OFF|LOW|MEDIUM|FULL;db_block_checksumles valeurs suivantes sont autorisées :OFF|TYPICAL|FULL;
Une personne ayant de l'expérience dans la gestion des bases de données Oracle peut clairement déjà indiquer — quelles valeurs doivent être définies pour les paramètres et leurs valeurs acceptables afin d'obtenir une plus grande productivité de la base de données, pour le travail avec les données spécifiées dans le code applicatif ci-dessus.
Mais.
Le sens de ce travail de laboratoire est de montrer que l'algorithme d'optimisation, lui-même, et relativement rapidement, nous le précisé.
Il ne reste plus qu'à consulter la documentation sur le système configurable, juste assez pour déterminer quels paramètres et dans quels intervalles les modifier.
Mais aussi : coder le code qui réalisera le travail avec le système configurable de l'algorithme d'optimisation choisi.
Ainsi, parlons maintenant du code.
J'ai mentionné ci-dessus que cran-r, c'est-à-dire : toutes les manipulations avec le système configurable sont orchestrées sous la forme d'un script R.
La tâche proprement dite, analyse, choix par rapport à la valeur de la métrique, vecteurs d'état du système : c'est le package GA ()
Le package, dans ce cas, ne convient pas vraiment, car il s'attend à des tâches pour les vecteurs (chromosomes, si nous parlons du vocabulaire du package) sous la forme de nombres à virgule flottante.
Et mon vecteur, composé des valeurs des paramètres de réglage : ce sont 14 valeurs — entiers et chaînes de caractères.
Le problème, bien sûr, est facilement contourné en attribuant aux valeurs de chaîne certains nombres spécifiques.
Ainsi, au final, le principal morceau du script R ressemble à ceci :
Appel de GA::ga
cat( "", file=v_logfile, sep="n", append=F)

pSize = 10
elitism_value=1
pmutation_coef=0.8
pcrossover_coef=0.1
iterations=50

gam=GA::ga(type="real-valued", fitness=evaluate,
lower=c(32,2, 1,1,1,2,60,1,30,1,0,0, 0,0), upper=c(1024,32, 8,10,10,128,800,4,300,8,10,40, 40,30),
popSize=pSize,
pcrossover = pcrossover_coef,
pmutation = pmutation_coef,
maxiter=iterations,
run=4,
keepBest=T)
cat( "La session GA est terminée" , file=v_logfile, sep="n", append=T)
gam@solution
Ici, à l'aide des lower et upper attributs de la sous-programme ga on définit, en substance, le domaine de recherche, à l'intérieur duquel sera effectuée la recherche d'un vecteur (ou de vecteurs) pour lesquels la valeur maximale de la fonction de fitness sera obtenue.
La sous-programme ga réalise la recherche en maximisant la fonction de fitness.
Ainsi, dans ce cas, il faut que la fonction de fitness, considérant le vecteur comme un ensemble de valeurs pour certains paramètres du SGBD, obtienne une métrique du SGBD.
C'est-à-dire : combien, avec ce réglage du SGBD et cette charge sur le SGBD : le SGBD traite des transactions par seconde.
En d'autres termes, il faut que, à l'intérieur de la fonction de fitness, une telle multitude soit effectuée :
- Traitement du vecteur d'entrée de nombres — le transformer en valeurs pour les paramètres du SGBD.
- Tentative de création d'un nombre spécifié de groupes redo, de taille spécifiée. De plus, la tentative : peut échouer.
Les groupes de journaux déjà existants dans le SGBD, en quantité et en taille déterminées, doivent être supprimés pour la clarté de l'expérience. - En cas de succès du point précédent : assignation d'une base de valeurs pour les paramètres de configuration (encore une fois : un échec peut se produire).
- En cas de succès du point précédent : arrêter le SGBD, redémarrer le SGBD afin que les nouvelles valeurs des paramètres prennent effet. (encore une fois : un échec peut se produire).
- En cas de succès du point précédent : effectuer un test de charge. obtenir des métriques du SGBD.
- Ramener le SGBD à son état initial, c'est-à-dire supprimer les groupes de journaux supplémentaires et restaurer la configuration initiale du SGBD.
Code de la fonction de fitness
évaluer = fonction(p_par) {
v_module = "évaluer"
v_métrique = 0
opn = NULL
opn$rg_size = round(p_par[1], digit = 0)
opn$rg_count = round(p_par[2], digit = 0)
opn$log_archive_max_processes = round(p_par[3], digit = 0)
opn$commit_logging = "BATCH"
si (round(p_par[4], digit = 0) > 5) {
 opn$commit_logging = "IMMEDIATE"
}
opn$commit_logging = paste("'", opn$commit_logging, "'", sep = "")

opn$commit_wait = "WAIT"
si (round(p_par[5], digit = 0) > 5) {
 opn$commit_wait = "NOWAIT"
}
opn$commit_wait = paste("'", opn$commit_wait, "'", sep = "")

opn$log_buffer = paste(round(p_par[6], digit = 0), "m", sep = "")
opn$log_checkpoint_timeout = round(p_par[7], digit = 0)
opn$db_writer_processes = round(p_par[8], digit = 0)
opn$undo_retention = round(p_par[9], digit = 0)
opn$transactions_per_rollback_segment = round(p_par[10], digit = 0)
opn$disk_asynch_io = "true"
si (round(p_par[11], digit = 0) > 5) {
 opn$disk_asynch_io = "false"
}

opn$filesystemio_options = "none"
si (round(p_par[12], digit = 0) > 10 && round(p_par[12], digit = 0)  20 && round(p_par[12], digit = 0)  30) {
 opn$filesystemio_options = "asynch"
}

opn$db_block_checking = "OFF"
si (round(p_par[13], digit = 0) > 10 && round(p_par[13], digit = 0)  20 && round(p_par[13], digit = 0)  30) {
 opn$db_block_checking = "FULL"
}

opn$db_block_checksum = "OFF"
si (round(p_par[14], digit = 0) > 10 && round(p_par[14], digit = 0)  20) {
 opn$db_block_checksum = "FULL"
}

v_vector = paste(round(p_par[1], digit = 0), round(p_par[2], digit = 0), round(p_par[3], digit = 0), round(p_par[4], digit = 0), round(p_par[5], digit = 0), round(p_par[6], digit = 0), round(p_par[7], digit = 0), round(p_par[8], digit = 0), round(p_par[9], digit = 0), round(p_par[10], digit = 0), round(p_par[11], digit = 0), round(p_par[12], digit = 0), round(p_par[13], digit = 0), round(p_par[14], digit = 0), sep = ";")
cat(paste(v_module, " essaie d'évaluer le vecteur : ", v_vector, sep = ""), file = v_logfile, sep = "n", append = T)

rc = make_additional_rgroups(opn)
si (rc != 0) {
 cat(paste(v_module, "make_additional_rgroups a échoué", sep = ""), file = v_logfile, sep = "n", append = T)
 return (0)
}

v_rc = 0
rc = set_db_parameter("log_archive_max_processes", opn$log_archive_max_processes)
si (rc != 0) { v_rc = 1 }
rc = set_db_parameter("commit_logging", opn$commit_logging)
si (rc != 0) { v_rc = 1 }
rc = set_db_parameter("commit_wait", opn$commit_wait)
si (rc != 0) { v_rc = 1 }
rc = set_db_parameter("log_buffer", opn$log_buffer)
si (rc != 0) { v_rc = 1 }
rc = set_db_parameter("log_checkpoint_timeout", opn$log_checkpoint_timeout)
si (rc != 0) { v_rc = 1 }
rc = set_db_parameter("db_writer_processes", opn$db_writer_processes)
si (rc != 0) { v_rc = 1 }
rc = set_db_parameter("undo_retention", opn$undo_retention)
si (rc != 0) { v_rc = 1 }
rc = set_db_parameter("transactions_per_rollback_segment", opn$transactions_per_rollback_segment)
si (rc != 0) { v_rc = 1 }
rc = set_db_parameter("disk_asynch_io", opn$disk_asynch_io)
si (rc != 0) { v_rc = 1 }
rc = set_db_parameter("filesystemio_options", opn$filesystemio_options)
si (rc != 0) { v_rc = 1 }
rc = set_db_parameter("db_block_checking", opn$db_block_checking)
si (rc != 0) { v_rc = 1 }
rc = set_db_parameter("db_block_checksum", opn$db_block_checksum)
si (rc != 0) { v_rc = 1 }

si (rc != 0) {
 cat(paste(v_module, " ne peut pas démarrer la db avec ce vecteur de paramètres", sep = ""), file = v_logfile, sep = "n", append = T)
 rc = stop_db("immediate")
 rc = create_spfile()
 rc = start_db("")
 rc = remove_additional_rgroups(opn)
 return (0)
}

rc = stop_db("immediate")
rc = start_db("")
si (rc != 0) {
 cat(paste(v_module, " ne peut pas démarrer la db avec ce vecteur de paramètres", sep = ""), file = v_logfile, sep = "n", append = T)
 rc = stop_db("abort")
 rc = create_spfile()
 rc = start_db("")
 rc = remove_additional_rgroups(opn)
 return (0)
}

rc = run_test()
v_métrique = getmetric()

rc = stop_db("immediate")
rc = create_spfile()
rc = start_db("")
rc = remove_additional_rgroups(opn)

cat(paste("résultat : ", v_métrique, " ", v_vector, sep = ""), file = v_logfile, sep = "n", append = T)
return (v_métrique)
}
Ainsi, tout le travail : est effectué dans la fonction de fitness.
sous-programme ga, effectue le traitement des vecteurs, ou plus précisément — des chromosomes.
Dans lequel, ce qui nous intéresse le plus : la sélection des chromosomes avec des gènes pour lesquels la fonction de fitness produit de grandes valeurs.
C'est, en fait, le processus de recherche du meilleur ensemble de chromosomes dans un espace de recherche N-dimensionnel.
Une explication très claire et détaillée , avec des exemples de code R, sur le fonctionnement de l'algorithme génétique.
Je voudrais noter deux points techniques distincts.
Appels auxiliaires, de la fonction evaluate, par exemple pour l'arrêt et le démarrage, la définition de la valeur d'un paramètre de SGBD, sont effectués sur la base de cran-r la fonction system2
Avec laquelle : un certain script bash ou une commande est déjà appelé.
Par exemple :
set_db_parameter
set_db_parameter=function(p1, p2) {
v_module="set_db_parameter"
v_cmd="/home/oracle/testingredotracе/set_db_parameter.sh"
v_args=paste(p1," ",p2,sep="")

x=system2(v_cmd, args=v_args, stdout=T, stderr=T, wait=T)
if ( length(attributes(x)) > 0 ) {
 cat(paste(v_module," failed with: ",attributes(x)$status," ",v_cmd," ",v_args,sep=""), file=v_logfile, sep="n", append=T)
 return (attributes(x)$status)
}
else {
 cat(paste(v_module," ok: ",v_cmd," ",v_args,sep=""), file=v_logfile, sep="n", append=T)
 return (0)
}
}
Le deuxième point — la ligne de la evaluate fonction, en conservant la valeur spécifique de la métrique et le vecteur de configuration correspondant, dans le fichier journal :
cat( paste("result: ",v_metric," ",v_vector,sep="") , file=v_logfile, sep="n", append=T)C'est important, car à partir de cet ensemble de données, il sera possible d'obtenir des informations supplémentaires sur quel des composants du vecteur de configuration a un impact plus ou moins important sur la valeur de la métrique.
C'est-à-dire : il sera possible de réaliser une analyse d'importance des attributs.
Alors, que peut-il en résulter.
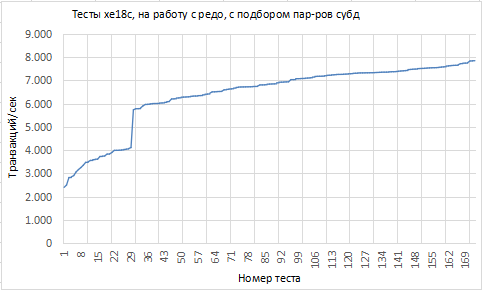
Sous forme de graphique, si l'on classe les tests par ordre croissant de la métrique, cela donne :
Certaines données correspondant aux valeurs extrêmes de la métrique :
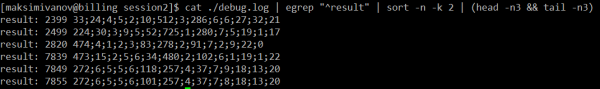
Ici, sur la capture d'écran des résultats, je précise : les valeurs du vecteur de configuration — données en termes de code de la fonction de fitness, et non en termes de liste de nombres / plages de valeurs des paramètres, qui ont été formulées plus haut dans le texte.
Eh bien, beaucoup ou peu, ~8 000 tps : c'est une question distincte.
Dans le cadre de ce travail de laboratoire — ce chiffre n'est pas essentiel, ce qui compte c'est la dynamique, comment cette valeur change.
La dynamique est ici bonne.
Il est évident qu'au moins un facteur influence significativement la valeur de la métrique, l'algorithme ga, parcourant les vecteurs-chromosomes : a été abordé.
Vu la dynamique plutôt vive des valeurs de la courbe, il y a au moins un autre facteur qui, bien que de moindre importance, influence également.
Ici, une attribute-importance analyse est nécessaire pour comprendre : quels attributs (dans ce cas, les composants du vecteur de réglage) et à quel point ils influencent la valeur de la métrique.
Et avec cette information : comprendre quels facteurs étaient touchés par les changements des attributs significatifs.
Exécuter attribute-importance peut se faire de différentes manières.
Pour ces objectifs, j'aime l'algorithme randomForest du même nom du package R ()
randomForest, comme je comprends son fonctionnement global et son approche pour évaluer l'importance des attributs en particulier, construit un certain modèle de dépendance de la variable de réponse par rapport aux attributs.
Dans notre cas, la variable de réponse est la métrique obtenue des SGBD lors des tests de charge : tps;
Et les attributs sont les composants du vecteur de réglage.
Alors randomForest il évalue l'importance de chaque attribut du modèle par deux chiffres : %IncMSE qui montre comment la présence/absence de cet attribut dans le modèle change la qualité de MSE de ce modèle (Mean Squared Error) ;
Et IncNodePurity est un nombre qui indique à quel point, par les valeurs de cet attribut, le jeu de données d'observation peut être divisé de manière à ce qu'une partie contienne des données avec une seule valeur de la métrique expliquée, et l'autre soit avec une autre valeur de la métrique.
En d'autres termes : à quel point c'est un attribut classifiant (l'explication en russe la plus claire sur randomForest que j'ai vue) ).
Code R de type ouvrier pour traiter un jeu de données avec les résultats des tests de charge :
x=NULL
v_data_file=paste('tmp/data1.dat',sep="")
x=read.table(v_data_file, header = TRUE, sep = ";", dec=",", quote = ""'", stringsAsFactors=FALSE)
colnames(x)=c('metric','rgsize','rgcount','lamp','cmtl','cmtw','lgbffr','lct','dbwrp','undo_retention','tprs','disk_async_io','filesystemio_options','db_block_checking','db_block_checksum')

idxTrain=sample(nrow(x),as.integer(nrow(x)*0.7))
idxNotTrain=which(! 1:nrow(x) %in% idxTrain )
TrainDS=x[idxTrain,]
ValidateDS=x[idxNotTrain,]

library(randomForest)
#mtry=as.integer( sqrt(dim(x)[2]-1) )
rf=randomForest(metric ~ ., data=TrainDS, ntree=40, mtry=3, replace=T, nodesize=2, importance=T, do.trace=10, localImp=F)
ValidateDS$predicted=predict(rf, newdata=ValidateDS[,colnames(ValidateDS)!="metric"], type="response")
sum((ValidateDS$metric-ValidateDS$predicted)^2)
rf$importance
On peut ajuster manuellement les hyperparamètres de l'algorithme et, en se basant sur la qualité du modèle, choisir un modèle plus précis pour faire des prédictions sur le jeu de données de validation.
On peut écrire une fonction pour ce travail (d'ailleurs — encore une fois, sur un certain algorithme d'optimisation).
On peut utiliser le package R caret, peu importe.
Ainsi, dans ce cas, le résultat pour évaluer l'importance des attributs est le suivant :
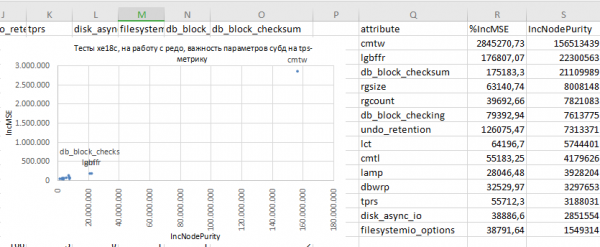
Donc, nous pouvons commencer à des réflexions globales :
- Il s'avère que le paramètre le plus significatif, dans ces conditions de test, est
commit_wait
Techniquement, il définit le mode d'exécution des opérations d'entrée-sortie pour l'écriture des données redo, depuis le journal tampon de la base de données, dans le groupe de journaux actuel : synchrone ou asynchrone.
Valeurnowaitdans lequel on obtient pratiquement une augmentation verticale et multiplicative de la métrique TPS : c'est l'activation du mode asynchrone IO dans les groupes redo.
La question est séparée : faut-il ou non faire ainsi dans la base de données en production. Ici, je me limite à constater : c'est un facteur significatif. - Il est logique que la taille du journal tampon de la base de données s'avère un facteur significatif.
Plus la taille du journal tampon est petite, moins sa capacité de mise en mémoire tampon est grande, plus souvent surviennent des saturations et/ou l'incapacité d'allouer de l'espace libre pour un lot de nouvelles données redo.
Et donc : des délais liés à l'allocation d'espace dans le journal tampon et/ou au vidage des données redo de celui-ci vers les groupes redo.
Ces délais, bien sûr, doivent affecter et influencent la capacité de traitement des transactions de la base de données. - Paramètre
db_block_checksum: eh bien, c'est aussi, en général, clair — le traitement des transactions conduit à la formation de blocs dirty dans le cache tampon de la base de données.
Qui, en cas de vérification des sommes de contrôle des blocs de données activée, doit être traité par la base — calculer ces sommes de contrôle à partir du corps du bloc de données et les comparer avec celles écrites dans l'en-tête du bloc de données : correspondent/ne correspondent pas.
Ce type de travail, encore une fois, ne peut qu'allonger le traitement des données, et par conséquent, le paramètre et le mécanisme qui définit ce paramètre s'avèrent significatifs.
C'est pourquoi le fournisseur propose, dans la documentation concernant ce paramètre, différentes valeurs (de ce paramètre) et note que oui, il y aura un impact, mais voilà, différentes valeurs, jusqu'à "désactivé", et un impact différent, vous pouvez choisir.
Et la conclusion globale.
L'approche, en général, s'avère tout à fait opérationnelle.
Elle permet tout à fait, dans les premières étapes de test de charge d'un certain système de service, de choisir sa (du système) configuration optimale sous charge sans avoir à s'intéresser particulièrement aux spécificités de réglage du système sous charge.
Mais ne l'exclut pas complètement — ne serait-ce qu'au niveau de la compréhension : il est nécessaire de connaître les "boutons de réglage" et les plages de rotation acceptables de ces boutons.
Ensuite, la méthode peut rapidement trouver la configuration optimale du système.
Et il est possible, au terme des tests, d'obtenir des informations sur la nature de la relation entre les métriques de qualité du fonctionnement du système et les valeurs des paramètres configurables du système.
Cela devrait bien sûr favoriser l'émergence d'une compréhension approfondie du système, de son fonctionnement, au moins — sous cette charge.
Pratiquement, cela représente un échange de coûts pour comprendre le système configurable, contre les coûts de préparation de tels tests de fonctionnement du système.
Je souligne que dans cette approche, le degré d'adéquation des tests du système par rapport aux conditions de fonctionnement qu'il aura en production est critique.
Merci de votre attention et de votre temps.
Source : habr.com
