

Beaucoup pensent qu'il suffit de migrer l'application vers Kubernetes (soit avec Helm, soit manuellement) pour que tout soit parfait. Mais ce n'est pas si simple.
Commande J'ai traduit l'article de l'ingénieur DevOps Julian Gindi. Il explique les pièges auxquels son entreprise a été confrontée lors de la migration, afin que vous ne tombiez pas dans les mêmes erreurs.
Étape un : configuration des demandes de pods et des limites
Commençons par la configuration d'un environnement propre dans lequel nos pods fonctionneront. Kubernetes gère parfaitement le plan de déploiement des pods et le traitement des états d'échec. Mais il s'avère que le planificateur ne peut parfois pas placer un pod s'il a du mal à évaluer combien de ressources il lui faut pour fonctionner correctement. C'est là que les demandes de ressources et les limites entrent en jeu. Il y a beaucoup de débats sur la meilleure façon de régler les demandes et les limites. Parfois, il semble que c'est plutôt un art qu'une science. Voici notre approche.
Demandes de pod (pod requests) — c'est la valeur principale utilisée par le planificateur pour le placement optimal du pod.
De : à l'étape de filtrage, un ensemble de nœuds est déterminé où le pod peut être planifié. Par exemple, le filtre PodFitsResources vérifie si les ressources d'un nœud sont suffisantes pour satisfaire les demandes spécifiques de ressources du pod.
Nous utilisons les demandes d'applications de manière à pouvoir évaluer combien de ressources en réalité l'application a besoin pour fonctionner normalement. Ainsi, le planificateur pourra placer les nœuds de manière réaliste. Au départ, nous souhaitions établir des demandes avec une marge de sécurité pour garantir une quantité suffisante de ressources pour chaque pod, mais nous avons remarqué que le temps de planification augmentait considérablement, et certains pods n'étaient tout simplement pas entièrement planifiés, comme s'ils n'avaient pas reçu de demandes de ressources.
Dans ce cas, le planificateur « expulsait » souvent des pods et ne pouvait pas les replanifier car le plan de contrôle n'avait aucune idée de combien de ressources l'application nécessiterait, ce qui est un élément clé de l'algorithme de planification.
Limites de pod (pod limits) — ce sont des contraintes plus strictes pour le pod. Cela représente le volume maximal de ressources que le cluster attribuera au conteneur.
Encore une fois, de : si une limite de mémoire de 4 Go est configurée pour le conteneur, kubelet (et l'environnement d'exécution du conteneur) l'appliquera de manière stricte. L'environnement d'exécution n'autorise pas le conteneur à utiliser plus que la limite de ressources définie. Par exemple, lorsque le processus dans le conteneur essaie d'utiliser plus que la mémoire autorisée, le noyau du système terminee ce processus avec une erreur « out of memory » (OOM).
Un conteneur peut toujours utiliser plus de ressources que ce qui est spécifié dans la demande de ressources, mais il ne peut jamais dépasser la limite définie. Ce chiffre est difficile à établir correctement, mais il est très important.
Idéalement, nous voulons que les demandes de ressources du pod changent au cours du cycle de vie du processus, sans interférer avec d'autres processus dans le système — tel est l'objectif de la définition des limites.
Malheureusement, je ne peux pas vous donner d'instructions spécifiques sur les valeurs à définir, mais nous adherons nous-mêmes aux règles suivantes :
- En utilisant un outil de test de charge, nous modélisons un niveau de trafic de base et observons l'utilisation des ressources du pod (mémoire et processeur).
- Nous définissons les demandes du pod à une valeur arbitrairement basse (avec une limite de ressources environ 5 fois supérieure à la valeur des demandes) et observons. Lorsque les demandes sont à un niveau trop bas, le processus ne peut pas démarrer, ce qui entraîne souvent des erreurs mystérieuses à l'exécution en Go.
Je tiens à souligner que des limites de ressources plus élevées compliquent la planification, car le pod a besoin d'un nœud cible avec suffisamment de ressources disponibles.
Imaginez un scénario où vous avez un serveur Web léger avec une très haute limite de ressources, disons 4 Go de mémoire. Il est probable que ce processus doive être mis à l'échelle horizontalement et chaque nouveau module devra être planifié sur un nœud avec au moins 4 Go de mémoire disponible. Si un tel nœud n'existe pas, le cluster devra introduire un nouveau nœud pour gérer ce pod, ce qui peut prendre un certain temps. Il est important d'obtenir une différence minimale entre les demandes de ressources et les limites, afin d'assurer un dimensionnement rapide et fluide.
Étape deux : configuration des tests de Liveness et Readiness
C'est un autre sujet délicat qui est souvent discuté dans la communauté Kubernetes. Il est essentiel de bien comprendre les tests de vivacité (Liveness) et de préparation (Readiness), car ils offrent un mécanisme pour assurer le bon fonctionnement des logiciels et minimiser le temps d'arrêt. Cependant, ils peuvent avoir un impact sérieux sur les performances de votre application s'ils ne sont pas correctement configurés. Voici un bref résumé de ce que sont ces deux types de contrôles.
Vivacité indique si le conteneur fonctionne. Si elle échoue, le kubelet tue le conteneur, et une politique de redémarrage est activée. Si le conteneur n'est pas équipé de test de vivacité, l'état par défaut sera un succès, comme indiqué dans .
Les tests de vivacité doivent être peu coûteux, c'est-à-dire ne pas consommer beaucoup de ressources, car ils s'exécutent fréquemment et doivent informer Kubernetes que l'application est en marche.
Si vous configurez le paramètre pour qu'il s'exécute chaque seconde, cela ajoutera une requête par seconde, alors gardez à l'esprit que des ressources supplémentaires seront nécessaires pour traiter ce trafic.
Dans notre entreprise, les tests de vivacité vérifient les composants principaux de l'application, même si les données (par exemple d'une base de données distante ou d'un cache) ne sont pas complètement accessibles.
Nous avons configuré une endpoint "liveness" dans les applications, qui renvoie simplement le code de réponse 200. Cela indique que le processus est en cours d'exécution et capable de traiter des requêtes (mais pas encore le trafic).
Test Préparation indique si le conteneur est prêt à répondre aux requêtes. Si le test de préparation échoue, le contrôleur de points de terminaison supprime l'adresse IP du pod des points de terminaison de tous les services associés au pod. Cela est également mentionné dans la documentation Kubernetes.
Les tests de préparation consomment plus de ressources, car ils doivent atteindre le backend de manière à montrer la disponibilité de l'application pour recevoir des requêtes.
Il y a beaucoup de débats dans la communauté sur la nécessité d'accéder directement à la base de données. Compte tenu des frais généraux (les vérifications sont effectuées fréquemment, mais peuvent être ajustées), nous avons décidé que pour certaines applications, la disponibilité pour traiter le trafic ne doit être comptabilisée qu'après vérification que des enregistrements sont retournés par la base de données. Des tests de disponibilité bien conçus ont permis d'assurer un niveau de disponibilité plus élevé et d'éliminer les temps d'arrêt lors du déploiement.
Si vous décidez de faire une requête à la base de données pour vérifier la disponibilité de l'application, assurez-vous qu'elle soit aussi économique que possible. Prenons cette requête :
SELECT small_item FROM table LIMIT 1Voici un exemple de la façon dont nous configurons ces deux valeurs dans Kubernetes :
livenessProbe:
 httpGet:
   path: /api/liveness
   port: http
readinessProbe:
 httpGet:
   path: /api/readiness
   port: http  periodSeconds: 2
Vous pouvez ajouter certains paramètres de configuration supplémentaires :
initialDelaySeconds— combien de secondes s'écoulent entre le démarrage du conteneur et le début des tests.periodSeconds— l'intervalle d'attente entre les exécutions des tests.timeoutSeconds— le nombre de secondes après lesquelles un pod est considéré comme défaillant. Un temps d'attente normal.failureThreshold— le nombre d'échecs des tests avant qu'un signal de redémarrage ne soit envoyé au pod.successThreshold— le nombre de tests réussis avant qu'un pod ne passe à l'état de disponibilité (après une défaillance, lorsque le pod redémarre ou se rétablit).
Étape trois : configuration des politiques réseau par défaut du pod
Dans Kubernetes, la topographie réseau est « plate », par défaut tous les pods interagissent directement les uns avec les autres. Dans certains cas, cela peut être indésirable.
Un problème de sécurité potentiel réside dans le fait qu'un attaquant peut exploiter une seule application vulnérable pour envoyer du trafic à tous les pods dans le réseau. Comme dans de nombreux domaines de la sécurité, le principe du moindre privilège s'applique ici. Idéalement, les politiques réseau devraient spécifiquement indiquer quelles connexions entre les pods sont autorisées et lesquelles ne le sont pas.
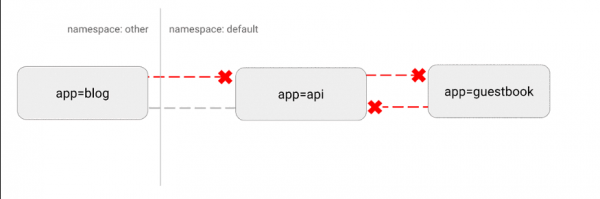
Par exemple, ci-dessous se trouve une politique simple qui interdit tout le trafic entrant pour un espace de noms spécifique :
---
apiVersion: networking.k8s.io/v1
kind: NetworkPolicy
metadata:
 name: default-deny-ingress
spec:
 podSelector: {}
 policyTypes:
   - Ingress
Visualisation de cette configuration :
(https://miro.medium.com/max/875/1*-eiVw43azgzYzyN1th7cZg.gif)
Plus de détails .
Étape quatre : comportement personnalisé à l'aide de hooks et de conteneurs init
Une de nos tâches principales a été d'assurer des déploiements sur Kubernetes sans temps d'arrêt pour les développeurs. Cela est difficile en raison du grand nombre d'options de terminaison des applications et de la libération des ressources utilisées par celles-ci.
Des difficultés particulières sont survenues avec . Nous avons remarqué que lors du déploiement séquentiel de ces pods, les connexions actives étaient interrompues avant la fin réussie.
Après de nombreuses recherches sur Internet, il est apparu que Kubernetes ne attend pas que les connexions Nginx s'épuisent avant de terminer le pod. Grâce au hook pre-stop, nous avons intégré cette fonctionnalité et complètement éliminé les temps d'arrêt :
lifecycle:
 preStop:
   exec:
     command: ["/usr/local/bin/nginx-killer.sh"]
Et voici nginx-killer.sh:
#!/bin/bash
sleep 3
PID=$(cat /run/nginx.pid)
nginx -s quit
while [ -d /proc/$PID ]; do
   echo "Waiting while shutting down nginx..."
   sleep 10
done
Une autre approche extrêmement utile est l'utilisation de conteneurs init pour traiter le démarrage d'applications spécifiques. Cela est particulièrement utile si vous avez un processus de migration de base de données gourmand en ressources qui doit être exécuté avant le démarrage de l'application. Pour ce processus, vous pouvez également spécifier une limite de ressources plus élevée sans définir de telle limite pour l'application principale.
Un autre schéma courant est d'accéder aux secrets dans un conteneur init, qui fournit ces identifiants au module principal, empêchant ainsi tout accès non autorisé aux secrets depuis le module principal de l'application.
Comme d'habitude, citation de la documentation: les conteneurs init exécutent en toute sécurité du code ou des utilitaires personnalisés qui, autrement, compromettraient la sécurité de l'image du conteneur de l'application. En stockant séparément les outils non essentiels, vous limitez la surface d'attaque de l'image du conteneur de l'application.
Étape cinq : configuration du noyau
Enfin, nous allons aborder une technique plus avancée.
Kubernetes est une plateforme extrêmement flexible qui vous permet de déployer des charges de travail comme vous le jugez nécessaire. Nous avons une série d'applications hautement performantes qui nécessitent des ressources considérables. Après des tests de charge approfondis, nous avons découvert qu'une de ces applications avait du mal à faire face à la charge de trafic prévue lorsque les paramètres par défaut de Kubernetes étaient appliqués.
Cependant, Kubernetes permet de lancer un conteneur privilégié qui modifie les paramètres du noyau uniquement pour un pod spécifique. Voici ce que nous avons utilisé pour changer le nombre maximum de connexions ouvertes :
initContainers:
  - name: sysctl
     image: alpine:3.10
     securityContext:
         privileged: true
      command: ['sh', '-c', "sysctl -w net.core.somaxconn=32768"]
C'est une technique plus avancée qui n'est souvent pas nécessaire. Mais si votre application peine sous une forte charge, vous pouvez essayer d'ajuster certains de ces paramètres. Plus d'informations sur ce processus et sur la configuration de différentes valeurs se trouvent, comme toujours, .
En conclusion
Bien que Kubernetes puisse sembler être une solution prête à l'emploi, plusieurs étapes clés doivent être suivies pour que les applications fonctionnent sans interruption.
Tout au long de la migration vers Kubernetes, il est crucial de suivre le « cycle de test de charge » : lancez l'application, testez-la sous charge, observez les métriques et le comportement lors du scaling, ajustez la configuration sur la base de ces données, puis répétez ce cycle.
Évaluez de manière réaliste le trafic attendu et essayez de dépasser ce seuil pour voir quels composants échoueront en premier. Avec cette approche itérative, il peut suffire de quelques-unes des recommandations énumérées pour réussir. Cela peut nécessiter des ajustements plus approfondis.
Posez-vous toujours les questions suivantes :
- Combien de ressources consomment les applications et comment ce volume va-t-il changer ?
- Quelles sont les réelles exigences en matière de scalabilité ? Quel trafic en moyenne l'application traitera-t-elle ? Et qu'en est-il du trafic de pointe ?
- À quelle fréquence le service aura-t-il besoin de scaling horizontal ? Quelle vitesse est nécessaire pour mettre en service de nouveaux pods pour gérer le trafic ?
- Comment les pods se terminent-ils correctement ? Est-ce nécessaire ? Est-il possible d'effectuer un déploiement sans temps d'arrêt ?
- Comment minimiser les risques en matière de sécurité et limiter les dégâts causés par des pods compromis ? Y a-t-il des autorisations ou des accès dont certains services n'ont pas besoin ?
Kubernetes offre une plateforme incroyable qui permet d'utiliser les meilleures pratiques pour déployer des milliers de services dans un cluster. Cependant, toutes les applications sont différentes. Parfois, le déploiement nécessite un peu plus de travail.
Heureusement, Kubernetes fournit les configurations nécessaires pour atteindre tous les objectifs techniques. En utilisant une combinaison de demandes de ressources et de limites, de probes Liveness et Readiness, de conteneurs init, de politiques réseau et de configurations de noyau personnalisées, vous pouvez atteindre de hautes performances tout en assurant la résilience et la rapidité de mise à l'échelle.
Que lire d'autre :
- .
- .
- .
Source : habr.com
