

Je poursuis mon récit sur la façon de connecter Exchange et ELK (début ). Je rappelle que cette combinaison peut traiter sans hésitation un très grand nombre de journaux. Cette fois-ci, nous allons parler de la manière de faire fonctionner Exchange avec les composants Logstash et Kibana.
Logstash dans la pile ELK est utilisé pour le traitement intelligent des journaux et leur préparation à la mise en place dans Elastic sous forme de documents, à partir desquels il est facile de créer diverses visualisations dans Kibana.
Installation
Il se compose de deux étapes :
- Installation et configuration du paquet OpenJDK.
- Installation et configuration du paquet Logstash.
Installation et configuration du paquet OpenJDK
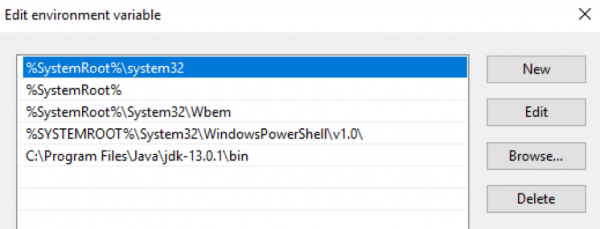
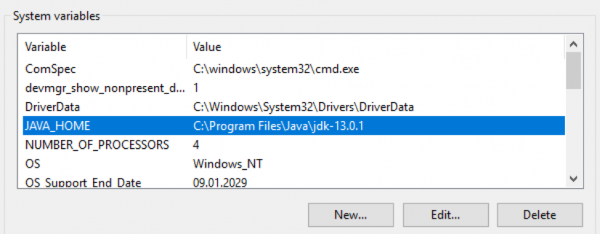
Le paquet OpenJDK doit être téléchargé et extrait dans un répertoire spécifique. Ensuite, le chemin vers ce répertoire doit être ajouté aux variables $env:Path et $env:JAVA_HOME du système d'exploitation Windows :
Vérifions la version de Java :
PS C:> java -version
openjdk version "13.0.1" 2019-10-15
OpenJDK Runtime Environment (build 13.0.1+9)
OpenJDK 64-Bit Server VM (build 13.0.1+9, mode mixte, partage)
Installation et configuration du paquet Logstash
Téléchargez le fichier archive contenant la distribution de Logstash. . L'archive doit être extraite à la racine du disque. L'extraction dans le dossier C:Program Files n'est pas recommandée, Logstash refusera de démarrer correctement. Ensuite, il est nécessaire d'apporter des modifications au fichier jvm.options qui concernent l'allocation de mémoire RAM pour le processus Java. Je recommande de spécifier la moitié de la mémoire RAM du serveur. S'il dispose de 16 Go de RAM, les clés par défaut sont :
-Xms1g
-Xmx1g
à remplacer par :
-Xms8g
-Xmx8g
En outre, il est judicieux de commenter la ligne -XX:+UseConcMarkSweepGC. Pour plus de détails sur cela . L'étape suivante consiste à créer la configuration par défaut dans le fichier logstash.conf :
input {
 stdin{}
}

filter {
}

output {
 stdout {
 codec => "rubydebug"
 }
}
Avec cette configuration, Logstash lit les données de la console, passe par un filtre vide et les renvoie à la console. L'utilisation de cette configuration permettra de vérifier le fonctionnement de Logstash. Pour cela, exécutons-le en mode interactif :
PS C:...bin> .logstash.bat -f .logstash.conf
...
[2019-12-19T11:15:27,769][INFO ][logstash.javapipeline    ][main] Pipeline démarré {"pipeline.id"=>"main"}
Le plugin stdin attend maintenant une entrée :
[2019-12-19T11:15:27,847][INFO ][logstash.agent           ] Pipelines en cours d'exécution {:count=>1, :running_pipelines=>[:main], :non_running_pipelines=>[]}
[2019-12-19T11:15:28,113][INFO ][logstash.agent           ] Logstash API endpoint démarré avec succès {:port=>9600}
Logstash a démarré avec succès sur le port 9600.
L'étape finale de l'installation : démarrer Logstash en tant que service Windows. Cela peut être fait, par exemple, à l'aide du paquet :
PS C:...bin> .nssm.exe install logstash
Le service "logstash" a été installé avec succès !
Résilience
La sécurité des journaux lors de leur transmission depuis le serveur source est assurée par le mécanisme des Files d'attente persistantes.
Comment ça fonctionne
Schéma de placement des files d'attente dans le processus de traitement des journaux : input → queue → filter + output.
Le plugin input reçoit les données de la source de journaux, les enregistre dans la file d'attente et envoie une confirmation de réception à la source.
Les messages de la file d'attente sont traités par Logstash, passent par un filtre et un plugin output. Lors de la réception d'une confirmation d'envoi du journal par l'output, Logstash supprime le journal traité de la file d'attente. Si Logstash s'arrête, tous les messages non traités et les messages pour lesquels la confirmation d'envoi n'a pas été reçue restent dans la file d'attente, et Logstash continuera leur traitement lors du prochain démarrage.
Configuration
Régulé par les clés dans le fichier C:Logstashconfiglogstash.yml :
queue.type: (valeurs possibles —persistedetmemory (par défaut)).path.queue: (chemin vers le dossier contenant les fichiers de files d'attente, qui sont par défaut stockés dans C:Logstashqueue).queue.page_capacity: (taille maximale de la page de la file d'attente, la valeur par défaut est — 64mb).queue.drain: (true/false — active/désactive l'arrêt du traitement de la file d'attente avant l'arrêt de Logstash. Je ne recommande pas de l'activer, car cela affecte directement la vitesse d'arrêt du serveur).queue.max_events: (nombre maximum d'événements dans la file d'attente, par défaut — 0 (illimité)).queue.max_bytes: (taille maximale de la file dans les octets, par défaut — 1024mb (1gb)).
Si configurés queue.max_events et queue.max_bytes, alors les messages cessent d'être acceptés dans la file d'attente lorsque la valeur de l'un de ces paramètres est atteinte. Plus d'informations sur les Files d'attente persistantes sont fournies .
Exemple d'une partie de logstash.yml, responsable de la configuration de la file d'attente :
queue.type: persisted
queue.max_bytes: 10gb
Configuration
La configuration de Logstash consiste généralement en trois parties, responsables des différentes phases de traitement des journaux entrants : la réception (section input), le parsing (section filter) et l'envoi vers Elastic (section output). Nous examinerons plus en détail chacune d'elles ci-dessous.
Input
Le flux entrant avec des journaux bruts est reçu des agents filebeat. C'est ce plugin que nous indiquons dans la section input :
input {
  beats {
    port => 5044
  }
}
Après cette configuration, Logstash commence à écouter le port 5044, et lors de la réception des journaux, les traite selon les paramètres de la section filter. Si nécessaire, le canal de réception des journaux de filebeat peut être encapsulé en SSL. Plus de détails sur les paramètres du plugin beats sont fournis .
Filter
Tous les journaux texte intéressants générés par Exchange sont au format csv avec des champs décrits dans le fichier des journaux lui-même. Pour le traitement des enregistrements csv, Logstash nous propose trois plugins : , csv et grok. Le premier est le plus , mais ne parvient à traiter que les journaux les plus simples.
Par exemple, l'enregistrement suivant sera divisé en deux (en raison de la présence d'une virgule à l'intérieur du champ), ce qui entraînera un défaut de parsing :
…,"MDB:GUID1, Mailbox:GUID2, Event:526545791, MessageClass:IPM.Note, CreationTime:2020-05-15T12:01:56.457Z, ClientType:MOMT, SubmissionAssistant:MailboxTransportSubmissionEmailAssistant",…
Il peut être utilisé pour le parsing des journaux, par exemple, IIS. Dans ce cas, la section filter peut sembler comme suit :
filter {
  if "IIS" in [tags] {
    dissect {
      mapping => {
        "message" => "%{date} %{time} %{s-ip} %{cs-method} %{cs-uri-stem} %{cs-uri-query} %{s-port} %{cs-username} %{c-ip} %{cs(User-Agent)} %{cs(Referer)} %{sc-status} %{sc-substatus} %{sc-win32-status} %{time-taken}"
      }
      remove_field => ["message"]
      add_field => { "application" => "exchange" }
    }
  }
}
La configuration de Logstash permet d'utiliser , nous pouvons donc diriger uniquement les journaux marqués du tag filebeat IIS. À l'intérieur du plugin, nous faisons correspondre les valeurs des champs avec leurs noms, supprimons le champ d'origine message, qui contenait l'enregistrement du journal, et nous pouvons ajouter un champ arbitraire qui contiendra, par exemple, le nom de l'application dont nous collectons les journaux.
Dans le cas des journaux de suivi, il vaut mieux utiliser le plugin csv, qui traite correctement les champs complexes :
filter {
  if "Tracking" in [tags] {
    csv {
      columns => ["date-time","client-ip","client-hostname","server-ip","server-hostname","source-context","connector-id","source","event-id","internal-message-id","message-id","network-message-id","recipient-address","recipient-status","total-bytes","recipient-count","related-recipient-address","reference","message-subject","sender-address","return-path","message-info","directionality","tenant-id","original-client-ip","original-server-ip","custom-data","transport-traffic-type","log-id","schema-version"]
      remove_field => ["message", "tenant-id", "schema-version"]
      add_field => { "application" => "exchange" }
    }
}
À l'intérieur du plugin, nous faisons correspondre les valeurs des champs avec leurs noms, supprimons le champ d'origine message (ainsi que les champs tenant-id et schema-version), qui contenait l'enregistrement du journal, et nous pouvons ajouter un champ arbitraire qui contiendra, par exemple, le nom de l'application dont nous collectons les journaux.
À la sortie de l'étape de filtrage, nous obtiendrons des documents presque prêts à être visualisés dans Kibana. Ce qui nous manquera sera le suivant :
- Les champs numériques seront reconnus comme du texte, ce qui empêche d'effectuer des opérations sur eux. En particulier, les champs
time-takendu journal IIS, ainsi que les champsrecipient-countettotal-bitesdu journal Tracking. - La timestamp standard du document contiendra le temps de traitement du journal, et non le temps d'écriture côté serveur.
- Champ
recipient-addresssemblent être une seule chaîne, ce qui empêche l'analyse avec le comptage des destinataires des e-mails.
Il est temps d'ajouter un peu de magie au processus de traitement des journaux.
La conversion des champs numériques
Le plugin dissect a une option convert_datatype, qui peut être utilisée pour convertir un champ texte en format numérique. Par exemple, comme suit :
dissect {
  …
  convert_datatype => { "time-taken" => "int" }
  …
}
Il convient de se rappeler que cette méthode ne s'applique que si le champ contiendra exactement une chaîne. Les valeurs nulles des champs ne sont pas traitées par cette option et entraînent une exception.
Pour les journaux de suivi, il est préférable de ne pas utiliser la méthode convert similaire, car les champs recipient-count et total-bites peuvent être vides. Pour convertir ces champs, il est préférable d'utiliser le plugin :
mutate {
  convert => [ "total-bytes", "integer" ]
  convert => [ "recipient-count", "integer" ]
}
La séparation de recipient_address en destinataires individuels
Cette tâche peut également être résolue à l'aide du plugin mutate :
mutate {
  split => ["recipient_address", ";"]
}
Modification du timestamp
Dans le cas des journaux de suivi, la tâche est très facilement résolue par le plugin , qui aidera à inscrire dans le champ timestamp la date et l'heure dans le format requis à partir du champ date-time:
date {
  match => [ "date-time", "ISO8601" ]
  timezone => "Europe/Moscow"
  remove_field => [ "date-time" ]
}
Dans le cas des journaux IIS, nous devrons fusionner les données des champs date et time à l'aide du plugin mutate, spécifier le fuseau horaire requis et placer ce timestamp dans timestamp à l'aide du plugin date :
mutate {
  add_field => { "data-time" => "%{date} %{time}" }
  remove_field => [ "date", "time" ]
}
date {
  match => [ "data-time", "YYYY-MM-dd HH:mm:ss" ]
  timezone => "UTC"
  remove_field => [ "data-time" ]
}
Sortie
La section output est utilisée pour envoyer les journaux traités à un récepteur de journaux. En cas d'envoi directement à Elastic, le plugin , où l'adresse du serveur et le modèle de nom d'indice pour l'envoi du document formé sont spécifiés :
output {
  elasticsearch {
    hosts => ["127.0.0.1:9200", "127.0.0.2:9200"]
    manage_template => false
    index => "Exchange-%{+YYYY.MM.dd}"
  }
}
Configuration finale
La configuration finale sera comme suit :
input {
  beats {
    port => 5044
  }
}

filter {
  if "IIS" in [tags] {
    dissect {
      mapping => {
        "message" => "%{date} %{time} %{s-ip} %{cs-method} %{cs-uri-stem} %{cs-uri-query} %{s-port} %{cs-username} %{c-ip} %{cs(User-Agent)} %{cs(Referer)} %{sc-status} %{sc-substatus} %{sc-win32-status} %{time-taken}"
      }
      remove_field => ["message"]
      add_field => { "application" => "exchange" }
      convert_datatype => { "time-taken" => "int" }
    }
    mutate {
      add_field => { "data-time" => "%{date} %{time}" }
      remove_field => [ "date", "time" ]
    }
    date {
      match => [ "data-time", "YYYY-MM-dd HH:mm:ss" ]
      timezone => "UTC"
      remove_field => [ "data-time" ]
    }
  }
  if "Tracking" in [tags] {
    csv {
      columns => ["date-time","client-ip","client-hostname","server-ip","server-hostname","source-context","connector-id","source","event-id","internal-message-id","message-id","network-message-id","recipient-address","recipient-status","total-bytes","recipient-count","related-recipient-address","reference","message-subject","sender-address","return-path","message-info","directionality","tenant-id","original-client-ip","original-server-ip","custom-data","transport-traffic-type","log-id","schema-version"]
      remove_field => ["message", "tenant-id", "schema-version"]
      add_field => { "application" => "exchange" }
    }
    mutate {
      convert => [ "total-bytes", "integer" ]
      convert => [ "recipient-count", "integer" ]
      split => ["recipient_address", ";"]
    }
    date {
      match => [ "date-time", "ISO8601" ]
      timezone => "Europe/Moscow"
      remove_field => [ "date-time" ]
    }
  }
}

output {
  elasticsearch {
    hosts => ["127.0.0.1:9200", "127.0.0.2:9200"]
    manage_template => false
    index => "Exchange-%{+YYYY.MM.dd}"
  }
}
Liens utiles :
Source : habr.com
